
Framework de avaliação de agentes de voz: 6 pilares explicados
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Agentes de voz precisam orquestrar uma sinfonia de ferramentas quase simultâneas. É uma dança delicada entre registrar os comentários de um cliente com Speech to Text (STT) em tempo real, assimilar o contexto e produzir uma resposta com um modelo de linguagem grande (LLM) e, depois, gerar um arquivo de áudio com um software de Text to Speech (TTS).
Com tantas partes em movimento, como avaliar com precisão o desempenho de um agente de voz?
Neste artigo, apresentamos um framework de avaliação de agentes de voz com seis pilares, que descreve exatamente o que medir ao analisar o sucesso de um agente. Também veremos por que diferentes setores devem atribuir pesos distintos a esses pilares e quais erros comuns evitar durante a avaliação.
Resumo
- Os seis principais pilares para avaliar agentes de voz são qualidade da voz TTS, qualidade da conversa, uso de ferramentas e conclusão de tarefas, inteligência, conformidade e segurança, e confiabilidade.
- As metas mais importantes para produção são um MOS de 4,3, um TSR acima de 85% e tempo até o primeiro áudio inferior a 500 ms.
- Cada setor atribui pesos diferentes aos pilares, e determinadas implantações priorizam um deles em relação aos demais.
- Erros comuns nos testes incluem avaliar apenas áudios limpos e ignorar picos de latência no P99.
- A ElevenLabs lidera nas métricas mais importantes: o Scribe v2 alcança a menor WER do mercado, de 2,2% (Artificial Analysis, junho de 2026); Flash v2.5 e Turbo v2.5 estão entre os melhores modelos em velocidade (Artificial Analysis, junho de 2026); e o ElevenAgents oferece cerca de 75 ms de latência de inferência do modelo.
O que é um framework de avaliação de agentes de voz?
Um framework de avaliação de agentes de voz com IA é um sistema estruturado que permite testar o desempenho em várias dimensões. Um framework abrangente inclui métricas para avaliar desde a fidelidade do áudio até o fluxo da conversa e a conformidade regulatória.
Diferentemente de um chatbot de texto, um agente de voz direciona cada interação por pelo menos três tecnologias integradas: reconhecimento automático de fala (ASR), que converte as palavras de um usuário em texto; um LLM, que elabora uma resposta; e um sistema TTS, que converte essa resposta novamente em áudio. Se qualquer um desses sistemas falhar, toda a experiência é prejudicada.
Essa complexidade é justamente o motivo pelo qual as empresas precisam avaliar agentes de voz antes de escolher um fornecedor e fazer a implantação. Latência adicional ou respostas imprecisas podem trazer consequências reais, como perda de clientes ou, no pior caso, multas regulatórias e danos à reputação.
Um framework para avaliar agentes de voz usa benchmarks e dados mensuráveis para definir se um agente é adequado ou não para determinados casos de uso. Do ponto de vista empresarial, poder avaliar diferentes modelos de voz permite escolher o melhor para seus clientes.
Os seis pilares que você deve avaliar em agentes de voz
Embora criar e implantar um agente de IA nunca tenha sido tão simples, os processos ativos nos bastidores são bastante complexos. Vários componentes atuam em conjunto para ouvir um usuário, entender o que ele quer, transmitir essas informações a um LLM e produzir uma resposta em áudio, realizando muitas ações quase simultâneas.
Ao buscar parceria com o melhor agente de voz possível, as empresas precisam de um framework rigoroso para usar como benchmark.
Se você tem mais interesse em ver resultados de testes, a Artificial Analysis oferece várias comparações de agentes com base em diferentes componentes. A seguir, você pode ver os resultados da comparação de velocidade entre modelos, com o ElevenLabs Turbo v2.5 e o Flash v2.5 liderando com ampla vantagem em caracteres processados por segundo.
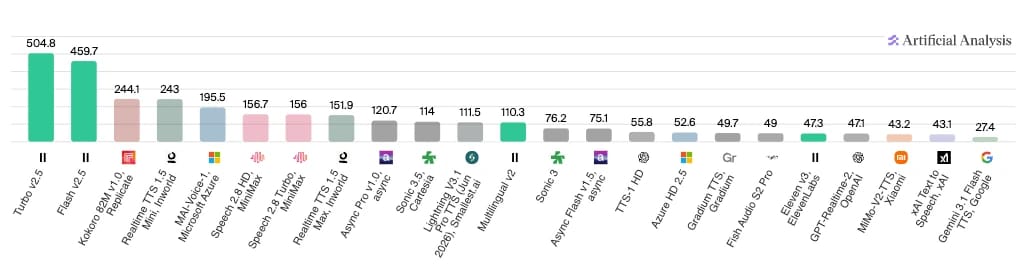
Para desenvolvedores ou empresas que desejam realizar seus próprios experimentos, estes são os seis pilares de um framework de avaliação de agentes de IA que você deve usar:
- Qualidade da voz TTS: O quão natural, clara e expressiva a fala sintetizada soa para os usuários finais. Modelos de ponta, como o Eleven v4, oferecem uma entrega expressiva e semelhante à humana em mais de 70 idiomas.
- Qualidade da conversa: Um modelo entende a fala humana, interpreta o significado e responde prontamente dentro do contexto em vários turnos de conversa?
- Uso de ferramentas: O nível em que um agente de IA conclui tarefas usando os recursos disponíveis, sem precisar de intervenção humana.
- Inteligência: O quão bem um modelo raciocina, lida com entradas inéditas e evita produzir respostas imprecisas ou alucinações.
- Conformidade e segurança: Além de todas as capacidades, agentes de voz com IA devem cumprir todos os requisitos regulatórios e de conformidade, incluindo proteções ativas.
- Confiabilidade: Componentes como tempo total de atividade e desempenho consistente sob carga determinam se um agente de IA conversacional pode escalar conforme a demanda.
Embora cada um desses pilares seja independente, eles se conectam para proporcionar uma experiência final de alta qualidade ao usuário. Por exemplo, se um modelo melhorasse a qualidade da voz, mas ainda tivesse alta latência, o cliente enfrentaria tempos de espera desconfortáveis antes de o modelo gerar a fala.
Vamos explorar cada um desses pilares de avaliação de voz IA com mais profundidade.
Qualidade da voz TTS
Começamos pela qualidade da voz, pois ela provavelmente é a primeira coisa que uma pessoa percebe ao interagir com um agente conversacional de IA. Se soar robótico ou estranho, a experiência subjetiva com o agente será consideravelmente pior.
Uma das métricas originais de avaliação, definida pelo Setor de Padronização das Telecomunicações da União Internacional de Telecomunicações (ITU-T), é o Mean Opinion Score (MOS). O MOS funciona em uma escala de 1 a 5, em que 1 é inutilizável e 5 é excelente. Por ser uma medida subjetiva, ele usa ouvintes humanos e coleta feedback após uma chamada.
Qualquer resultado abaixo de MOS 3,5 nessa escala é pouco impressionante, especialmente para os padrões atuais, e provavelmente afeta a satisfação do cliente.
Embora o MOS seja a métrica centrada em pessoas, vários requisitos técnicos contribuem para esse resultado:
- Consistência de tom e jitter: Tom e jitter são dois elementos linguísticos que as pessoas percebem naturalmente enquanto escutam. “Tom” se refere à variação da entonação ao longo da fala, como quando você eleva a voz naturalmente ao fazer uma pergunta. Jitter ocorre quando a compreensão de tom por um modelo de voz varia, impedindo-o de manter uma prosódia coerente ao longo de uma frase. A referência do setor para jitter é de 30 ms.
- Expressividade emocional: Uma voz clara e precisa ainda parece inadequada se o tom não corresponder ao registro emocional pretendido em uma frase. Sem sinais tonais precisos, ouvintes humanos terão menos conexão com agentes conversacionais de IA e os avaliarão pior. O ElevenAgents oferece expressividade quase humana para dar a cada resposta uma intenção emocional clara.
- Ruído de fundo: O ruído de fundo em agentes de voz tem duas dimensões distintas que vale avaliar. Na saída, um ruído ambiente é adicionado sutilmente às respostas para fazer os agentes soarem mais naturais. Na entrada, a filtragem de ruído de fundo na camada STT é uma opção que melhora a precisão. Ao avaliar um agente, teste ambos: verifique se o ruído ambiente soa natural e avalie a precisão do STT com o filtro de ruído ativado e desativado.
Ao calcular o MOS, busque um resultado entre 4,3 e 4,5, o que demonstra altas pontuações em todas essas categorias perceptivas. Para prever MOS em escala sem precisar de painéis humanos, você pode usar ferramentas como UTMOS e NISQA.
Qualidade da conversa
A qualidade da conversa é um pilar composto, situado entre a qualidade da voz e a conclusão de tarefas. Ela busca medir com que eficácia um agente de voz entende as necessidades de um usuário, o interrompe dentro do contexto e conduz isso até a conclusão em um diálogo com vários turnos.
A principal métrica aqui é a precisão da classificação de intenções, cuja faixa típica fica entre 85% e 92%, enquanto os melhores desempenhos superam 96%. Embora 85% possa parecer alto, isso ainda representa 15% de todo o tráfego recebido sendo categorizado incorretamente e direcionado aos recursos errados.
Os elementos técnicos que contribuem para uma alta precisão na classificação de intenções são:
- Alternância de turnos: A alternância de turnos determina quão bem um agente de voz gerencia o fluxo natural da conversa. Ela avalia se ele sabe quando ouvir, responder ou esperar mais informações. Também abrange a gestão de interrupções, quando um modelo descarta uma resposta em andamento e gera uma nova com base na entrada recente. A ElevenLabs usa um websocket multicontexto para lidar perfeitamente com essas interrupções naturais.
- Latência: Latência descreve o atraso de ponta a ponta entre o usuário terminar sua frase e o agente iniciar sua resposta em áudio. Agentes de voz prontos para produção devem buscar um tempo até o primeiro áudio inferior a 500 ms; menos de 300 ms é ainda melhor. Os modelos Flash da ElevenLabs oferecem um tempo de inferência líder no setor, de cerca de 75 ms, preparando você para ter sucesso nessa categoria.
- Taxa de fallback: A taxa de fallback mede a frequência com que um agente de IA não entende um usuário e pede esclarecimento ou repetição. Ela é, em grande parte, uma consequência da precisão do STT: se a camada de reconhecimento de fala interpretar ou representar incorretamente o que o cliente disse, o LLM recebe uma entrada corrompida. A taxa de fallback é calculada pela fórmula: Taxa de fallback (%) = (Número de fallbacks / Número total de interações) * 100.
O ElevenLabs Scribe V2 tem a menor WER, de 2,2%, na avaliação de modelos de Speech to Text da Artificial Analysis
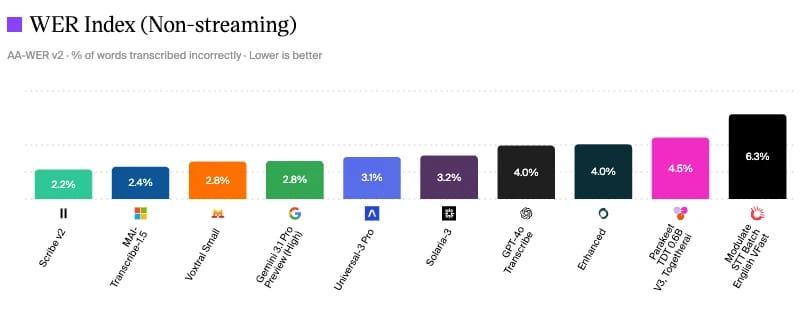
Avaliação de modelos de Speech to Text da Artificial Analysis
Uma maneira de medir a qualidade da conversa é observar os padrões de benchmark do setor para diferentes componentes. Como você pode ver, o Scribe v2 da ElevenLabs apresenta a menor taxa de erro de palavras, de 2,2%, em junho de 2026, o que significa menos interpretações incorretas, menos fallbacks e uma classificação de intenções mais precisa.
As empresas podem perceber que a qualidade da conversa também depende do workflow em que um agente de voz opera. Por exemplo, no atendimento ao cliente, outro aspecto seria a qualidade da transferência para escalonamento ou a resolução de FAQs.
Uso de ferramentas e conclusão de tarefas
Enquanto a qualidade mede como uma conversa foi percebida, a conclusão de tarefas mede se ela levou a um resultado bem-sucedido. Empresas devem dar muita atenção a essa parte do framework de avaliação de agentes de voz, pois ela está diretamente ligada aos resultados de negócio.
Uma medida de uso de ferramentas é a precisão de preenchimento de campos, que determina quão bem agentes de IA conseguem concluir tarefas relativamente rotineiras, como preencher um formulário com informações do cliente. Uma alta precisão demonstra que o agente consegue passar da conversa à ação sem perder informações no processo.
A Taxa de Sucesso de Tarefas (TSR) é uma medida percentual das tarefas de ponta a ponta concluídas com sucesso por um agente. A conclusão depende da capacidade do agente de entender uma solicitação e usar as ferramentas conectadas corretas (APIs, bancos de dados, Retrieval-Augmented Generation (RAG) e bases de conhecimento internas) para obter ajuda.
A fórmula para o TSR é:
TSR = (Tarefas totalmente concluídas / Total de tarefas tentadas) x 100
Agentes de voz prontos para produção devem buscar um TSR acima de 85%, monitorando a precisão e a confiabilidade das chamadas de ferramentas. Para evitar quedas no TSR, faça testes de regressão a cada alteração no prompt ou no modelo conectado. Mesmo um pequeno desvio pode ter consequências significativas para seu TSR.
Inteligência
A inteligência abrange o raciocínio e as capacidades mais avançadas de um agente de voz. É esse pilar que diferencia claramente uma URA (Resposta de Voz Interativa) conduzida por voz de um agente de voz IA.
As principais dimensões a avaliar incluem:
- Risco de alucinação: Alucinações, quando um agente produz informações imprecisas ou inconsistentes com documentos da empresa, são especialmente prejudiciais em voz IA, pois podem ser transmitidas com confiança. Estudos recentes sugerem que alucinações comuns prejudicam significativamente a satisfação dos clientes com agentes de voz.
- Tratamento de solicitações fora do escopo: Agentes inteligentes entendem quando uma pergunta está fora de seu domínio contextual e conseguem responder adequadamente. Em vez de alucinar uma resposta, eles recusam ou redirecionam a conversa para um território mapeado contextualmente.
- Retenção de contexto: Ao longo de vários turnos, o agente consegue acompanhar entidades e compromissos assumidos anteriormente? Sem essa capacidade, clientes podem ter de repetir informações ou receber respostas contraditórias.
- Raciocínio e lógica de múltiplas etapas: O agente consegue lidar corretamente com lógica condicional ou encadear inferências ao longo de vários turnos? Especialmente em casos de uso mais técnicos, como serviços financeiros, a capacidade de raciocinar dentro de um contexto predefinido é essencial para o sucesso.
Existem vários benchmarks de terceiros para essas dimensões e componentes. Por exemplo, o Holistic Evaluation of Language Models (HELM), de Stanford, compara o desempenho de LLMs em diferentes categorias. Para alucinações, o TruthfulQA oferece uma análise robusta da frequência com que respostas falsas aparecem.
Uma vantagem do ElevenAgents é que, diferentemente de algumas plataformas de voz que limitam você a um único modelo subjacente, é possível trocar toda a camada de LLM. Na prática, isso significa que você pode usar o modelo com melhor desempenho nos benchmarks de raciocínio para seu caso de uso específico.
Conformidade e segurança
As empresas precisam implementar proteções ativas para impedir resultados prejudiciais ou que violem políticas. Diferentemente de instruções de prompt no nível do sistema, que podem ser contornadas ou substituídas, verificações independentes de proteção operam como uma camada separada do próprio modelo. Elas avaliam as saídas antes que cheguem ao usuário e interrompem a conversa se ela entrar em território perigoso.
A auditabilidade é um requisito relacionado: agentes em produção precisam manter registros detalhados de decisões e saídas em um formato que permita revisão posterior. Sobretudo em setores fortemente regulamentados, demonstrar conformidade depois do ocorrido é tão importante quanto alcançá-la inicialmente.
As regulamentações específicas que sua empresa precisa cumprir variam conforme o setor. Alguns dos frameworks mais aplicáveis são:
- HIPAA: Para dados de saúde protegidos em contextos de saúde nos EUA.
- PCI-DSS: Para qualquer agente que lide com dados de cartões de pagamento.
- LGPD: Obrigações de privacidade de dados para a UE e empresas com clientes na UE.
Para empresas que avaliam sua postura de conformidade, a ElevenLabs possui conformidade com AICPA SOC Tipo II e LGPD, além de obter a certificação AIUC-1. A AIUC-1 é uma norma de segurança criada especificamente para agentes de IA.
Confiabilidade
A confiabilidade é o último pilar do nosso framework de avaliação de agentes de voz e abrange se um agente consegue entregar resultados consistentes em tempo real.
Ao avaliar um agente de voz, procure as seguintes características:
- Tempo de atividade: Qualquer implantação voltada ao cliente exige 99,9% de tempo de atividade para evitar indisponibilidades. Especialmente em casos de uso sempre ativos, como suporte de entrada, um tempo de atividade confiável é um fator importante.
- Degradação gradual: Devido à complexidade inerente dos agentes de voz, se um componente começar a falhar, o agente deverá lidar com essa degradação de forma gradual. Na prática, isso significa encaminhar para uma pessoa, em vez de continuar operando sob maior pressão ou retornando erros.
- Desempenho sob carga: Os testes de carga devem buscar simular pelo menos 2x a concorrência máxima esperada antes do lançamento. Testar sob alta pressão pode identificar aumentos de latência ou degradação de desempenho que só aparecem em escala.
Mesmo um modelo de alta qualidade que atende a todos os demais critérios pode ser inutilizável se não escalar conforme a demanda dos clientes. O ElevenAgents é usado por 1.000.000 de criadores e empresas líderes, demonstrando a capacidade da plataforma de oferecer implantações em escala empresarial sem comprometer os benchmarks de desempenho.
Como medir MOS para agentes de voz (passo a passo)
Se sua empresa quiser medir MOS manualmente, você precisará de um grande grupo de ouvintes humanos e de uma seleção de clipes de áudio de conversas reais. É um processo estruturado que envolve coletar feedback, calcular médias e interpretar os dados.
Veja como medir MOS para agentes de voz na prática:
- Prepare seu conjunto de teste: Selecione uma amostra representativa de saídas de áudio do seu agente, cobrindo pelo menos 100 clipes de diferentes conversas.
- Realize a sessão de avaliação: Peça aos ouvintes humanos que avaliem cada clipe em uma escala de 1 a 5 com base na qualidade da experiência de comunicação.
- Agrupe as avaliações e calcule as pontuações: Calcule a média das avaliações de cada clipe e, depois, a média de todos os clipes da amostra para obter um MOS geral. Um MOS de 4,3 ou mais indica que seu agente de voz está pronto para produção.
Embora exija muito trabalho manual, esse processo fornecerá um MOS sólido para o agente de voz escolhido. Se quiser executar o teste em escala, você pode substituir ouvintes humanos por ferramentas automatizadas como o NISQA, que prevê pontuações MOS programaticamente. É possível integrar esses sistemas aos seus pipelines ativos para monitorar o MOS continuamente ao longo do tempo.
Benchmarks de testes entre IA e humanos: FCR, AHT e CSAT
Embora calcular o MOS repetidamente ao longo do tempo seja uma forma de observar melhorias ou regressões do modelo, você pode adicionar contexto comparando-o ao desempenho humano. Ver o que pessoas realmente alcançam em funções semelhantes mostrará se seu agente de voz está operando próximo de um nível ideal.
Veja algumas métricas a considerar em benchmarks de testes entre IA e humanos.
Agentes de IA devem conseguir igualar o FCR e o CSAT de humanos, melhorando significativamente o AHT. Essa melhoria ocorre porque agentes de IA normalmente lidam com conversas mais gerais do que agentes humanos. Muitas empresas adotam um workflow em que agentes de IA são a primeira linha de atendimento e só transferem chamadas a agentes humanos quando elas são complexas demais para serem resolvidas de forma autônoma.
Dados de 2025 da Poe, uma agregadora de comparações de IA, revelam que a ElevenLabs manteve a maior capacidade geral de atender solicitações, concluindo 74,4% de todas as solicitações recebidas. Esse sucesso se traduziu em um uso que cresce rapidamente, com Eleven v3 e v2.5-Turbo representando mais de 60% das mensagens enviadas a modelos de IA ao longo do tempo.
Para uma experiência melhor, use o Eleven v4 — nosso modelo TTS mais expressivo.
Mensagens enviadas a modelos de IA ao longo do tempo, com a ElevenLabs liderando o framework de avaliação de agentes de voz da Poe
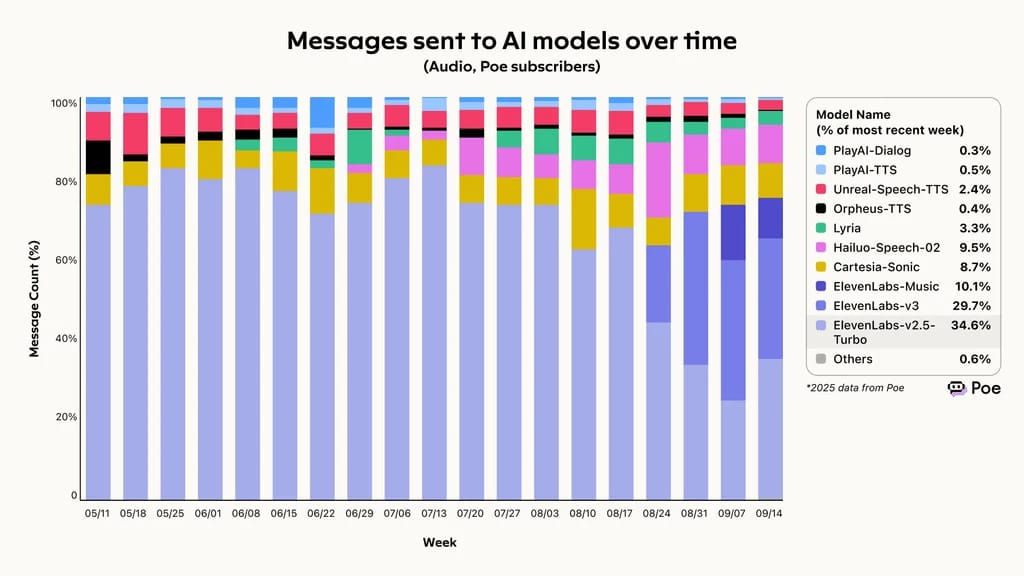
Mensagens enviadas a modelos de IA ao longo do tempo, segundo benchmark da Poe
Erros comuns ao testar agentes de voz
Ao seguir um framework de avaliação de agentes de voz, é tentador testar os melhores cenários possíveis. Na realidade, a experiência diária dos clientes que interagem com seus sistemas de voz IA não ocorre em condições ideais.
Veja três erros comuns ao testar agentes de voz e como corrigi-los:
- Testar o caminho mais fácil: Especialmente ao selecionar clipes de áudio para MOS, inclua casos de uso extremos. Clipes com ruído de fundo ou fala com sotaque são muito comuns na vida real, portanto testar apenas arquivos de áudio “limpos” resultará em uma calibração incorreta do MOS.
- Priorizar contenção em vez de resolução: Otimizar seus modelos para manter usuários dentro do sistema do agente infla as taxas de contenção sem melhorar os resultados. Se seu FCR for baixo apesar de uma alta taxa de contenção, o agente está prendendo usuários em um ciclo frustrante. Tenha práticas para permitir que usuários falem com agentes humanos caso desejem.
- Ignorar percentis de latência: Os SLAs geralmente definem a latência pelo nível P95. Embora essa métrica seja importante para oferecer uma experiência consistente à maioria dos clientes, não se esqueça de que os 5% restantes também são clientes reais. Em escala, 5% de um sistema que atende 10.000 chamadas diárias ainda representam 500 pessoas enfrentando uma conversa lenta. Use o P99 como sua principal meta de SLA, não apenas a mediana ou o P95.
Ao manter esses pontos em mente, você consegue estabelecer referências justas e representativas, em vez de trabalhar com médias idealizadas.
A importância de avaliações específicas para cada caso de uso
Embora os seis pilares mapeados neste framework orientem as áreas que você deve explorar, o peso de cada pilar dependerá do seu setor. Por exemplo, uma empresa de serviços financeiros pode priorizar conformidade e uso de ferramentas, enquanto uma marca de consumo pode usar a qualidade da voz TTS como princípio orientador.
Veja dois exemplos de avaliações específicas para casos de uso em ação e como elas podem alterar o equilíbrio entre os pilares.
Atendimento ao cliente
Em determinados setores, como centrais de atendimento, outras métricas de conclusão de tarefas, como a Resolução no Primeiro Contato (FCR), são uma parte importante da análise. Conseguir atender uma chamada recebida com sucesso sem intervenção humana reduz significativamente a demanda sobre agentes humanos de atendimento ao cliente. A McKinsey estima que centrais de atendimento que usam agentes de voz podem reduzir o volume de interações em até 50%.
Embora não seja tão importante quanto a taxa de sucesso de tarefas, outra dimensão a considerar é a taxa de contenção. Ela mede a duração total de uma chamada. Se a taxa de contenção for muito alta, mas seu FCR for baixo, seus agentes estão mantendo as pessoas na linha sem oferecer uma solução ao cliente. Na prática, isso pode se transformar em uma experiência frustrante de ficar dando voltas para o cliente.
Outras métricas a acompanhar seriam o AHT, com agentes de IA buscando resolver rapidamente problemas rotineiros. Por isso, a área de atendimento ao cliente priorizaria a qualidade da conversa, especialmente a alternância de turnos e a taxa de fallback, em vez de outras áreas.
Saúde
Saúde é um setor altamente regulamentado, com exigências rigorosas de conformidade que tornam a operação de agentes de voz extremamente delicada. A conformidade é uma preocupação central, aumentando significativamente o peso do pilar de segurança do framework, bem como da inteligência, acima de todos os demais.
Chatbots para saúde precisam lidar com agendamento de consultas, caminhos de acesso à telemedicina, triagem de sintomas e dúvidas sobre seguros. Tudo isso exige alto grau de inteligência e uso de ferramentas, refletindo novamente que as demandas específicas do setor ou da função influenciam qual pilar é mais importante.
Independentemente do setor em que sua empresa atua, entender os pilares centrais da avaliação de agentes de voz e aplicá-los de forma equilibrada ajudará você a encontrar os melhores agentes para suas necessidades.
Desenvolva com o ElevenAgents para alto desempenho e baixa latência
A plataforma que você escolhe para desenvolver influencia diretamente o desempenho dos seus agentes de voz em workflows reais. Especialmente nas interações com seus clientes, você precisa ter confiança de que seu agente terá excelência em todas as categorias.
O ElevenAgents foi criado para implantações de voz em produção, combinando TTS líder do setor com o Eleven v4, STT em tempo real por meio do Scribe v2 e uma camada de orquestração de agentes criada para escala empresarial. Cada componente foi desenvolvido para atender aos benchmarks definidos neste framework, permitindo que você entregue experiências de alta qualidade aos clientes.
Quer você esteja avaliando suas opções ou pronto para começar a desenvolver, a ElevenLabs tem um caminho para você. Explore a plataforma ElevenAgents para ver como ela se aplica ao seu caso de uso ou crie sua conta e comece a desenvolver hoje mesmo.
Perguntas frequentes sobre avaliação de agentes de voz

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.



