
Modelos de interação: Construindo diálogos naturais entre humanos e IA
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Quem já tentou interromper um agente de voz com IA no meio de uma frase sabe como é quando um sistema não foi desenvolvido para conversas humanas. O ritmo está errado, a voz parece desconectada do conteúdo e, mesmo quando a informação está correta, a interação soa estranha: não como falar com uma pessoa bem informada, mas como navegar em um software que por acaso usa palavras.
A causa dessa sensação de falta de naturalidade é estrutural. Muitos sistemas de voz com IA foram criados para lidar com turnos, e não com o fluxo real de uma conversa. Eles ouvem, processam e respondem a uma troca por vez. Isso funciona em demonstrações simples, mas deixa de funcionar quando a conversa se torna emocional e imprevisível.
Modelos de interação são sistemas de IA desenvolvidos para se comunicar por áudio e texto em tempo real, percebendo não apenas o que é dito, mas quando é dito e qual tipo de resposta emocional o momento exige. Este artigo explica o que diferencia um modelo de interação, por que isso importa para empresas que implementam voz IA e como a ElevenLabs está avançando nessa direção.
Resumo
- A maioria das soluções de voz IA falha em conversas reais porque não consegue lidar com interrupções, silêncio ou contexto que se mantém entre os turnos.
- A stack de interação da ElevenLabs foi desenvolvida para lidar com interrupções, pausas e fala sobreposta sem perder o contexto nem interromper o fluxo da conversa.
- A ElevenLabs está desenvolvendo verdadeiros modelos de interação com uma arquitetura avançada em cascata, Speech to Text (STT) e Text to Speech (TTS) desenvolvidos internamente, além de uma stack ajustada para baixa latência e conversas naturais de ida e volta.
Por que a maior parte da comunicação por voz entre humanos e IA não parece natural
A maioria das soluções de voz IA trata uma conversa como uma série de entradas e saídas discretas: o sistema espera um trecho de fala, o converte em texto, processa esse texto e responde. Isso funciona para interações de comando e resposta, mas uma conversa real não é uma sequência organizada de trocas de texto. É um diálogo contínuo, cheio de pausas e interjeições.
Remover o fluxo entre os turnos e o contexto que é mantido entre eles gera três falhas específicas:
- Ele interrompe você ou faz você esperar: O sistema não consegue diferenciar uma pausa para pensar de um turno concluído, então entra enquanto você ainda está falando ou permanece em silêncio depois que você parou. Pare para organizar os pensamentos no meio da frase e você será interrompido; conclua seu ponto e terá de esperar um momento de silêncio constrangedor.
- Ele não consegue reagir depois que começa a falar: No momento em que o sistema começa a responder, ele para de ouvir. Se você o interrompe para redirecionar a conversa, ele continua dando a resposta para uma pergunta que você já deixou para trás, porque não consegue perceber que algo mudou.
- Ele esquece ao longo da conversa: Cada turno é processado de forma isolada, então o contexto de cinco interações atrás não é levado adiante. Você acaba se repetindo ou o sistema responde como se a conversa tivesse acabado de começar.
O resultado é uma conversa que pode estar funcionalmente correta e ainda assim parecer errada.
O que os modelos de interação fazem que a voz IA tradicional não consegue fazer
Enquanto a IA de voz tradicional lida com uma interação por vez, um modelo de interação conduz a conversa inteira, acompanhando o que está sendo dito e o que precisa acontecer em seguida, tudo ao mesmo tempo. A diferença funcional é que um modelo de interação responde ao estado real da conversa.
Os modelos de interação têm:
- Resposta em tempo real: O sistema foi desenvolvido para responder no ritmo de uma conversa, com um ciclo de ponta a ponta que pode levar menos de um segundo, dependendo da configuração.
- Tratamento natural de interrupções, silêncio e sobreposição: Ele diferencia uma pausa para pensar de um turno concluído, para não interromper as pessoas nem deixar silêncios constrangedores. E, quando o cliente fala por cima dele para redirecionar a conversa, gerencia a sobreposição sem perder o contexto nem comprometer a conversa.
- Continuidade durante toda a interação: Em vez de redefinir o contexto a cada turno, o sistema leva adiante o histórico da conversa, para que o que ele diz no turno 10 reflita tudo o que aconteceu desde o primeiro turno.
- Entrega adaptativa: A voz pode ser programada para mudar de tom (mais calma, mais direta, mais acolhedora) conforme o tipo de tarefa que está realizando.
- Execução paralela de tarefas: O sistema busca informações, executa chamadas de ferramentas e continua falando ao mesmo tempo, em vez de ficar em silêncio enquanto procura algo.
O verdadeiro teste de um modelo de interação é uma ligação que está indo mal. Na gravação abaixo, um cliente liga por causa do cancelamento de um voo. Ele está tenso e precisa de uma solução rápida para o problema.
O agente reconhece imediatamente a urgência e a frustração do cliente pelas palavras que ele usa. Ele ajusta o tom, lida com a interrupção sem perder o fio da conversa e usa suas ferramentas conectadas para oferecer soluções reais para o voo cancelado. No fim, o cliente consegue uma solução sem precisar de um agente humano.
Compare isso com os agentes típicos baseados em turnos usados hoje. Esses sistemas esperariam cada pausa, responderiam com base em um tom neutro e deixariam passar completamente a frustração do cliente. Depois de algumas interações que não abordassem o que a pessoa que ligou está realmente sentindo, provavelmente seria necessário transferir a chamada para um humano, deixando o cliente ainda mais frustrado do que no início.
Como a ElevenLabs está desenvolvendo modelos de interação
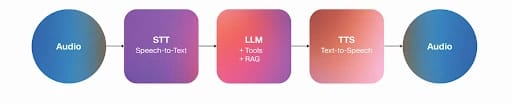
Nosso pipeline de conversa usa uma arquitetura avançada em cascata em vez de uma arquitetura integrada, de modo que, em vez de um único modelo lidar com tudo, cada etapa tem seu próprio componente especializado.
A vantagem dessa abordagem é que podemos otimizar cada etapa do pipeline de forma independente, substituindo qualquer componente por um modelo melhor sem precisar reconstruir todo o sistema. Como desenvolvemos esses componentes internamente, eles são cootimizados para transmitir contexto rico entre si. Isso significa que o pipeline continua se comportando como uma conversa coerente, e não como uma cadeia de ferramentas separadas.
Estrutura do modelo em cascata
Estrutura do modelo integrado
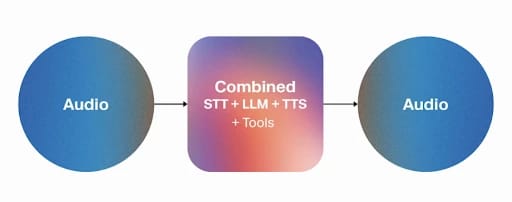
Imagens: modelos em cascata vs. integrados
Veja a tecnologia que atualmente compõe o pipeline:
- Scribe v2 em tempo real: Nosso modelo STT desenvolvido internamente transcreve fala em cerca de 150 ms em mais de 90 idiomas, lidando bem com ruído de fundo, sotaques, interrupções e eventos não verbais, como risadas e pausas. Ele também foi desenvolvido para lidar com vocabulário específico de cada domínio, de termos médicos a jargões financeiros.
- Alternância especulativa de turnos: Este sistema decide quando falar, pausar ou esperar, interpretando o fluxo da conversa em vez de depender de um limite rígido de silêncio. Melhorias no nosso modelo de detecção de atividade de voz ajudam a filtrar melhor a fala de fundo e respostas curtas, tornando a alternância de turnos mais natural.
- Eleven v3 Conversational: Um dos nossos modelos TTS mais expressivos, criado para diálogos ao vivo, com troca entre as partes. Ele mantém o tom emocional da conversa ao longo das interações, para que a forma como o agente fala na décima interação reflita tudo o que aconteceu antes.
- Modo Expressivo: Desenvolvido com base no Eleven v3 Conversational e no sistema de alternância de turnos, o Modo Expressivo controla como o agente soa em cada momento. Ele reduz a tensão quando os clientes estão frustrados, tranquiliza quando estão confusos e é direto quando é preciso ter clareza. Também interpreta tags expressivas, para que o modelo possa agir com base em indicações como [laughs], [whispers] ou [sighs] e moldar momentos específicos da entrega.
- Flash v2.5: Nosso modelo TTS de baixa latência oferece suporte a 32 idiomas e gera fala em menos de 75 ms. Quando a latência é prioridade, ele mantém o tempo de resposta dentro do ritmo natural humano.
- Speech Engine: A camada de conexão que une a stack, ligando seu servidor à nossa ElevenAPI via WebSocket, com uma conexão por conversa. Nós processamos STT e TTS enquanto seu servidor executa o LLM, para que equipes técnicas possam usar seu próprio modelo e manter a lógica de conversa em sua própria infraestrutura.
Esses modelos são aprimorados constantemente, com novas versões lançadas regularmente. Cada lançamento reduz a diferença entre falar com um software e falar com uma pessoa, com respostas mais rápidas, reconhecimento emocional mais preciso, mais idiomas e uma entrega mais fluida.
Falar enquanto pensa
Nem todas as partes de um modelo de interação precisam ser executadas em uma sequência rígida. O ElevenAgents pode continuar trabalhando em segundo plano enquanto a conversa avança, em vez de recorrer ao silêncio entre uma pergunta e uma resposta.
Alguns sistemas essenciais trabalham juntos para permitir falar e pensar simultaneamente:
- Chamadas paralelas de ferramentas: O agente pode consultar um banco de dados, executar uma ferramenta ou verificar o status de um pedido enquanto ainda está falando, para que a busca nunca pareça uma pausa na conversa.
- Timeout flexível: Se um LLM demora mais do que o esperado para gerar uma resposta, o agente diz uma breve expressão de preenchimento, como “Deixe-me pensar” ou “hmmm”, em vez de deixar um silêncio constrangedor. Timeout flexível ajuda a manter um fluxo natural de conversa e reduz a probabilidade de interrupções.
- Termos para ignorar interrupções: Em vez de usar um limite fixo de silêncio, o sistema busca interpretar o significado do que está sendo dito para perceber quando um turno realmente terminou. Da mesma forma, confirmações curtas como “ok” ou “aham” podem ser configuradas para passar sem disparar uma interrupção completa, o que significa que o agente não perde o fio da conversa toda vez que a pessoa que ligou faz uma interjeição.
Juntos, esses sistemas evitam que o agente pareça estar carregando ou processando uma resposta. Eles formam um mecanismo de conversa eficiente que preenche a lacuna de forma natural, como uma pessoa faria, enquanto processa informações e organiza os pensamentos em segundo plano.
Como uma conversa funciona de fato com a ElevenLabs
Os componentes acima não são executados um após o outro em uma linha organizada. Eles se sobrepõem. Veja como um agente da ElevenLabs lidaria com uma pessoa que pergunta: "Meu pedido já foi enviado ou ainda está sendo processado?" durante uma ligação de suporte.
- A pessoa fala: O áudio é transmitido para a ElevenLabs pela conexão WebSocket, e o Scribe começa a transcrever em tempo real, com cerca de 150 ms de atraso em relação à voz.
- O sistema interpreta o fluxo: Enquanto o Scribe ainda está transcrevendo, a alternância especulativa de turnos já avalia se a pessoa terminou de falar ou ainda está desenvolvendo o raciocínio. O trecho final "ou ainda está sendo processado?" é interpretado como uma passagem de turno, e não como uma pausa; por isso, ele aciona a próxima etapa em vez de esperar em silêncio.
- O LLM reúne o contexto e responde: A pergunta transcrita é enviada ao LLM junto do histórico da conversa, do registro do pedido recuperado dos próprios sistemas da empresa via RAG, resultados de ferramentas usadas anteriormente na chamada e o prompt do sistema. Ele analisa tudo isso e gera uma resposta baseada no pedido de quem ligou.
- O modelo TTS sintetiza a resposta: O texto se transforma em áudio natural. Se o Modo Expressivo estiver ativo, a resposta traz indicações de entrega adequadas ao momento, para que uma atualização de rotina soe simples e tranquila, em vez de monótona. Quando a latência é prioridade, o Flash realiza a síntese em menos de 75 ms.
- A resposta é transmitida de volta: O áudio começa a tocar antes que a síntese termine, para que a pessoa ouça o início da resposta enquanto o restante ainda está sendo gerado.
- O ciclo se repete: Cada novo turno leva adiante o tom, o contexto e o histórico da conversa.
Ao longo desse processo rápido, a conversa parece natural. A pessoa deixa de se adaptar à máquina: ela não fala mais devagar, não articula demais as palavras nem espera por um sinal sonoro. Ela simplesmente fala, como falaria com outra pessoa.
Implemente agentes de voz naturais em toda a sua empresa
Tudo o que descrevemos aqui já está em produção. Da arquitetura em cascata ao pipeline com latência inferior a um segundo, empresas do mundo todo já usam o ElevenAgents para conduzir conversas reais com clientes em escala.
Isso inclui ambientes regulados e de alto risco, porque a arquitetura dos nossos agentes oferece suporte a proteções, registros de auditoria e controles de conformidade. A ElevenLabs tem certificações SOC 2 Tipo II, ISO 27001, HIPAA e PCI DSS Nível 1, além do Zero Retention Mode e residência regional de dados para equipes que precisam manter os dados dentro de uma região específica.
Pronto para colocar um agente para trabalhar? Você pode criar um agente e começar a desenvolver no console ou falar com nossa equipe de vendas sobre uma implementação adaptada ao seu ambiente.
Perguntas frequentes sobre modelos de interação

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


