Modelos em Cascata vs. Fundidos: Como a arquitetura define se seu agente de voz está pronto para empresas
- Publicado
- Última atualização
OuvirOuça este artigo
A maioria das pessoas acha que agentes de voz são criados com uma arquitetura em cascata ou fusionada. Na prática, os agentes são projetados em um espectro entre as duas, com cinco arquiteturas normalmente usadas dependendo da aplicação.
A arquitetura do agente determina sua capacidade de se comportar de forma confiável em produção, adaptar-se a requisitos específicos do negócio e soar natural em uma conversa. Uma arquitetura baseada em fusão, como o modelo Realtime da OpenAI, pode soar impressionantemente realista em interações curtas. Mas, quando as equipes precisam aplicar barreiras de conformidade, depurar uma resposta com falha ou trocar por um LLM mais potente quando um for lançado no próximo mês, uma única rede fusionada oferece poucas alternativas.
Na ElevenLabs, usamos uma arquitetura avançada baseada em cascata. Aproveitamos componentes especializados para reconhecimento de fala, raciocínio e geração de fala, proporcionando altos níveis de inteligência e confiabilidade. Adicionamos prosódia contextual, otimização de baixa latência e alternância de fala inteligente para que as conversas fluam naturalmente. Construímos dessa forma porque as empresas e os governos com que trabalhamos precisam de agentes que soem realistas e sejam confiáveis em produção para tarefas complexas.
Este artigo apresenta as cinco principais arquiteturas, seus pontos fortes, onde elas falham e como pensamos sobre a base para agentes implantados em workflows críticos.
O que as equipes avaliam ao escolher uma arquitetura
As perguntas que as equipes fazem geralmente se dividem em três categorias.
Ela consegue lidar com tarefas complexas?
- Raciocínio e flexibilidade de modelos: Você pode escolher os melhores modelos para seu caso de uso, incluindo os LLMs mais avançados disponíveis, e fazer upgrades à medida que opções melhores surgirem?
- Lógica do agente: Você pode definir e controlar os fluxos de conversa, as regras de decisão e os caminhos de escalonamento que seu agente segue?
- Uso de ferramentas: A arquitetura pode oferecer suporte a chamadas de ferramentas em várias etapas e integrações com sistemas externos?
Ela vai soar e parecer humana?
- Prosódia: O agente apresenta ritmo, entonação e tom emocional naturais?
- Latência: As respostas são rápidas o suficiente para a conversa parecer natural?
- Alternância de fala: O agente sabe quando falar, pausar ou ceder a vez?
Posso confiar nela em produção?
- Confiabilidade: O agente se comporta de forma previsível e consistente ou se desvia ao longo do tempo?
- Barreiras de proteção: A arquitetura pode aplicar proteções contra respostas indesejadas ou usuários mal-intencionados?
- Transparência: A arquitetura gera saídas intermediárias ou é uma caixa-preta?
As concessões entre arquiteturas em cascata e fusionadas
As arquiteturas baseadas em cascata são criadas ao encadear componentes especializados: Speech to Text (STT), um modelo de linguagem de grande porte e Text to Speech (TTS). Cada etapa pode ser otimizada, testada e atualizada de forma independente.
Arquitetura em cascata
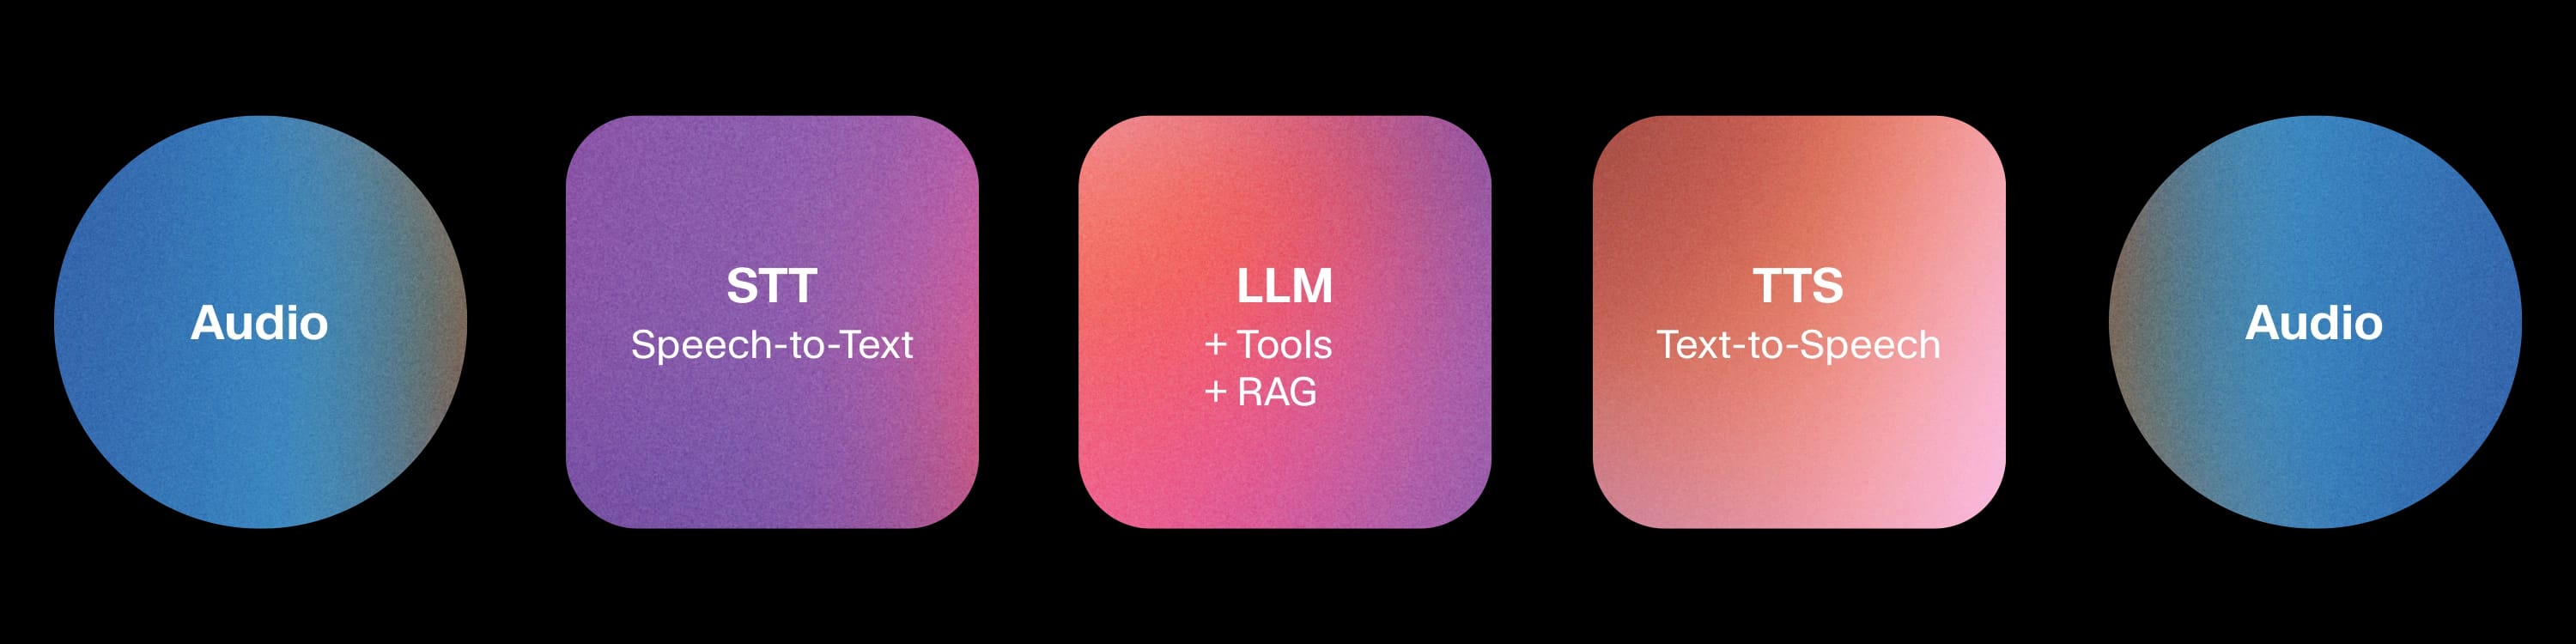
Essa modularidade é o que torna as arquiteturas em cascata a base da maioria dos agentes de nível empresarial. Cada etapa produz saídas inspecionáveis: texto legível entre o STT e o LLM, e entre o LLM e o TTS. Barreiras de proteção podem ser aplicadas na camada de texto, o mais recente LLM de ponta pode ser integrado sem modificar os modelos de fala e, quando algo falha, geralmente é possível identificar a origem da falha.
A crítica recorrente às arquiteturas em cascata é que elas perdem sinais prosódicos. A fala é reduzida a texto, e entonação, ritmo e emoção precisam ser reconstruídos na saída. Esses sinais podem ser parcialmente recuperados por meio de modelagem explícita, mas não são capturados de forma tão natural quanto nas abordagens fusionadas. Outras dimensões, como latência e alternância de fala, normalmente podem ser otimizadas para níveis de desempenho comparáveis nas duas abordagens.
Modelo fusionado
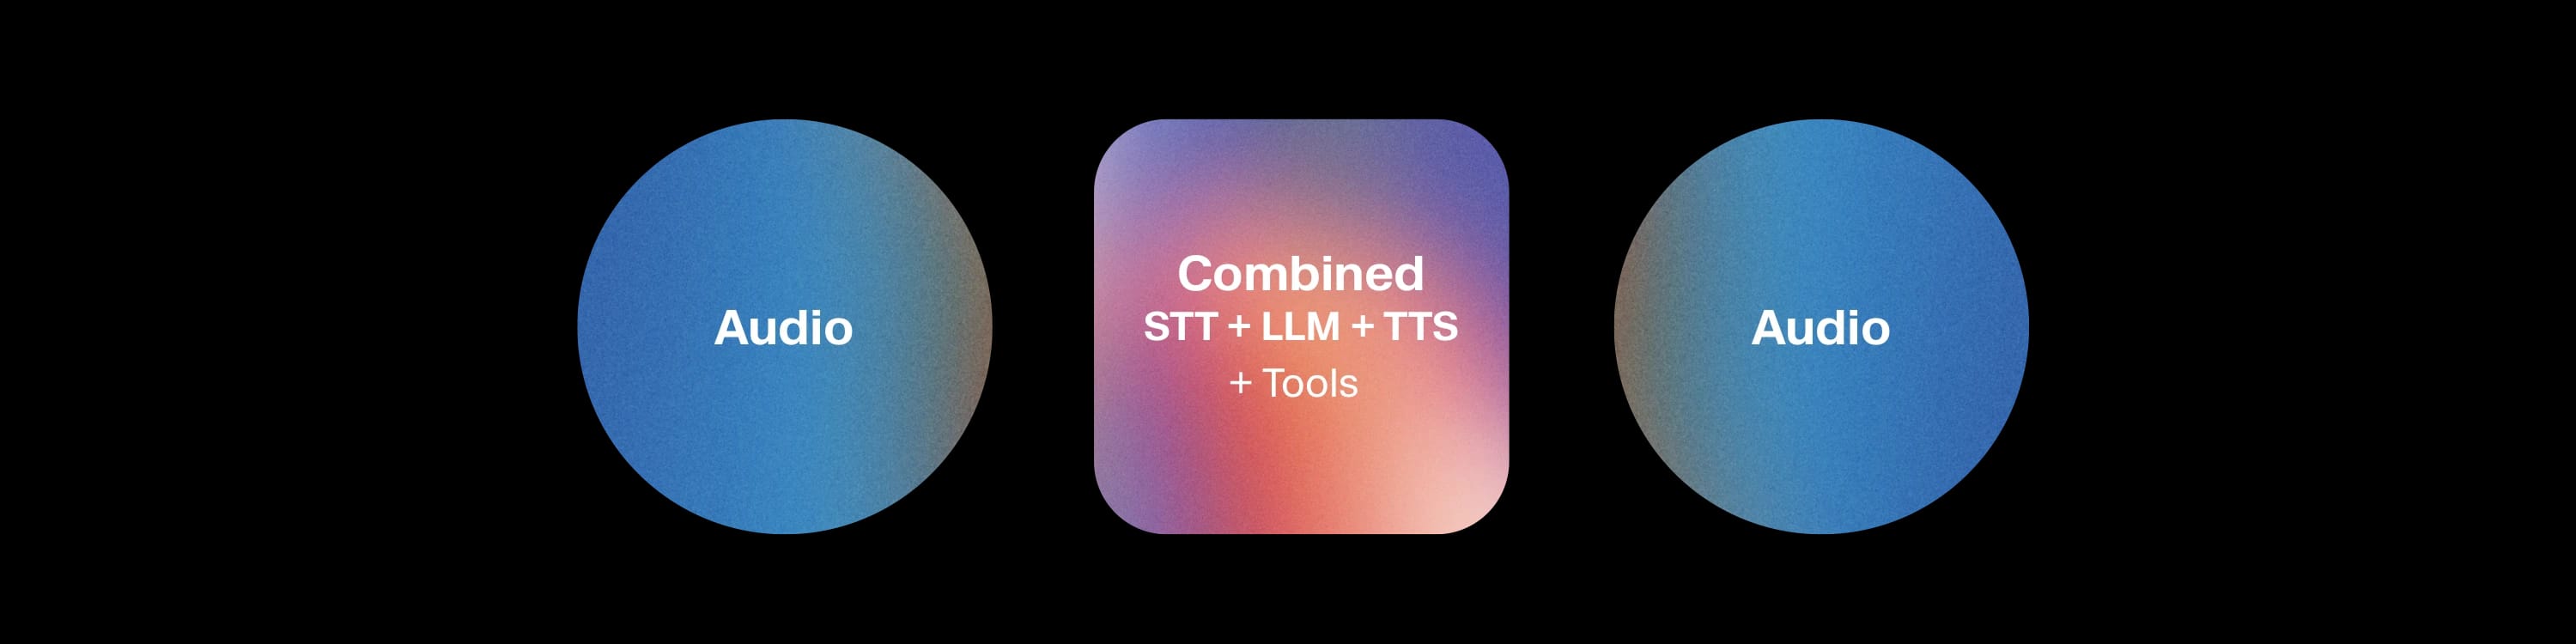
Arquiteturas fusionadas adotam uma abordagem fundamentalmente diferente. Reconhecimento, raciocínio e geração acontecem dentro de uma única rede multimodal. O áudio entra e o áudio sai, sem nenhuma camada inspecionável entre eles.
Essa ausência de etapas intermediárias é tanto o atrativo quanto a limitação. A arquitetura fusionada pode preservar sinais prosódicos naturalmente, porque a fala nunca é decomposta em texto. No entanto, há pouca capacidade de aplicar barreiras de proteção, trocar componentes individuais ou inspecionar saídas intermediárias para depuração. Também há limitações para ajustar o STT a terminologia específica de um setor ou integrar um LLM diferente para obter melhor raciocínio e chamadas de ferramentas. O sistema é uma única rede, e as equipes ficam limitadas às capacidades de raciocínio com as quais ele é disponibilizado, o que hoje significa núcleos mais leves que não conseguem se equiparar aos LLMs de ponta em tarefas complexas.
As cinco arquiteturas
1. Em cascata básica
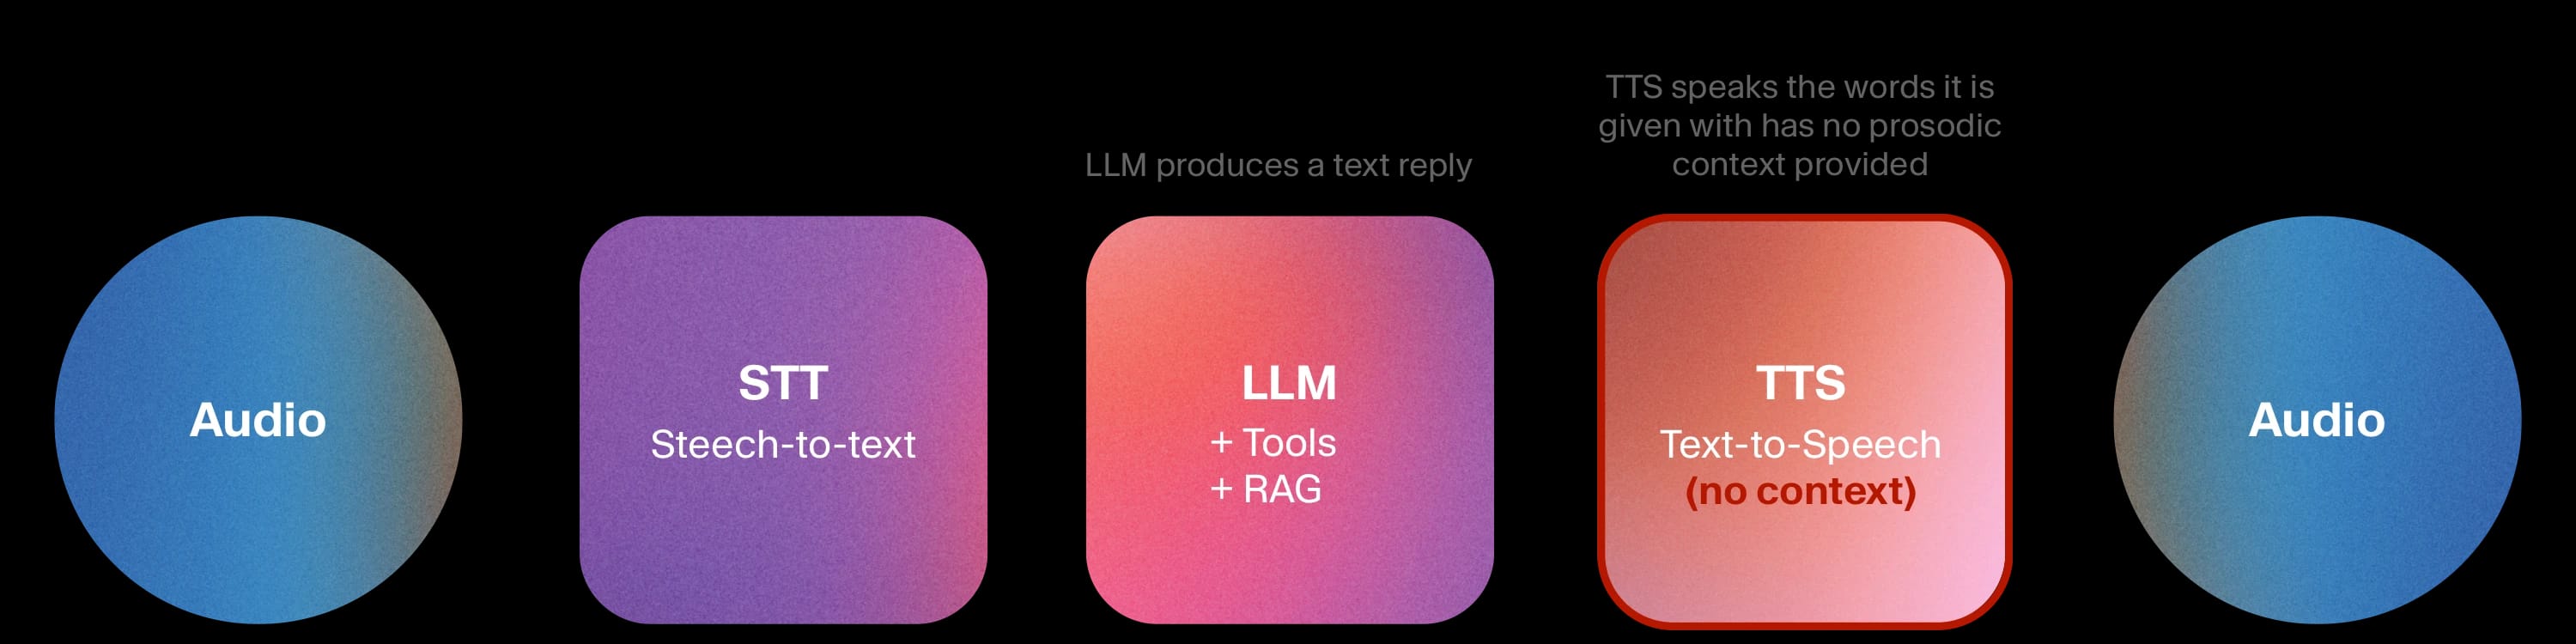
O áudio é transcrito, o LLM gera uma resposta em texto e o TTS a reproduz. Todas as etapas operam em texto simples, então você pode ver, testar e controlar tudo.
As vantagens em termos de confiança são claras: barreiras de proteção na camada de texto, fluxos de conversa determinísticos e trilhas de auditoria completas. Como o LLM é um componente independente, você pode combinar o agente com o modelo de ponta que oferecer os melhores recursos de raciocínio ou chamadas de ferramentas e atualizá-lo assim que surgir uma opção melhor. A fraqueza está na qualidade da conversa: sem TTS contextual, o agente soa funcional, mas sem profundidade. Não há adaptação emocional nem variação prosódica, o que é aceitável para informar saldos de conta, mas inadequado para lidar com um cliente frustrado.
Exemplos de casos de uso:
- Substituição de URA em telecomunicações e serviços públicos
- Atendimento de perguntas frequentes na integração de clientes de SaaS
- Notificações proativas, como confirmações de consulta, lembretes de receita e alertas de entrega, em que a consistência importa mais do que a cordialidade
2. Em cascata avançada
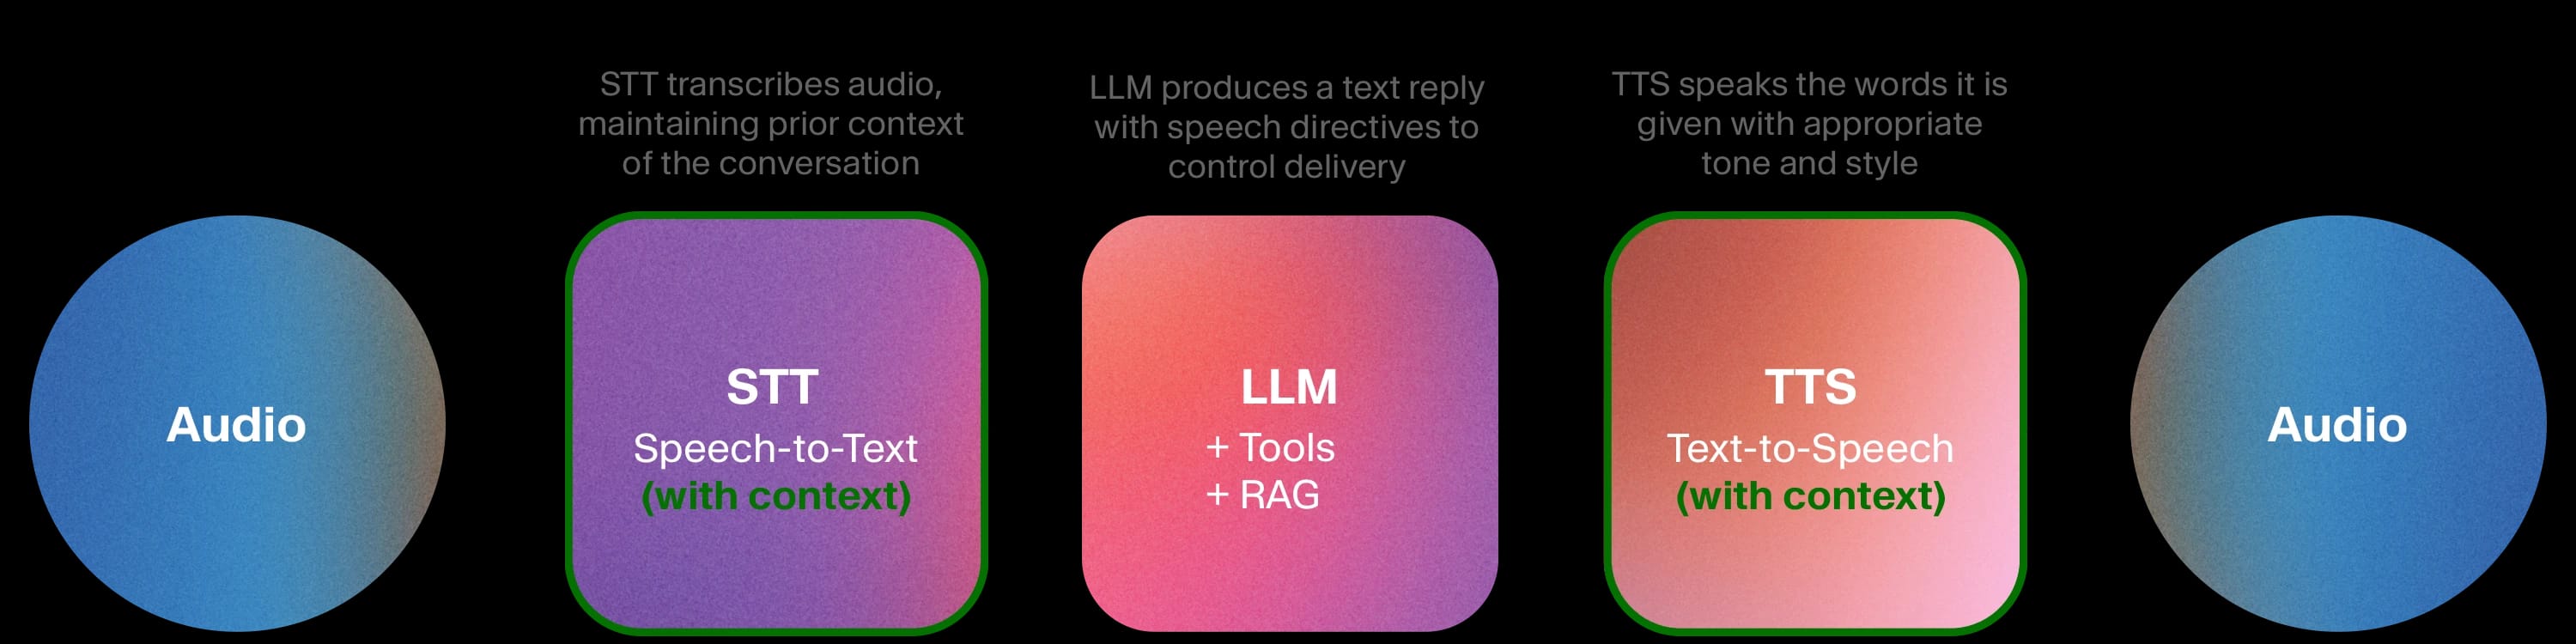
A mesma arquitetura modular, mas agora vários componentes operam com um contexto mais rico. Foi isso que criamos com o Modo Expressivo no ElevenAgents.
O modelo STT Scribe v2 Realtime produz transcrições rápidas e precisas com base no contexto anterior da conversa. A partir do texto, o LLM instrui o TTS sobre como apresentar a fala — não apenas o que dizer — com orientações como "de forma tranquilizadora", "com ênfase" e "com urgência", adaptando seu tom dinamicamente ao longo da conversa. O sistema de alternância de fala usa os mesmos sinais, permitindo que o agente determine quando responder e quando ceder a vez. Os modelos de fala ficam no mesmo stack, sem saltos de rede entre componentes, mantendo a latência baixa.
A arquitetura mantém tudo da cascata básica: transparência total, barreiras de proteção na camada de texto, possibilidade de trocar componentes, ajuste por domínio e acesso aos melhores modelos disponíveis para chamadas de ferramentas e raciocínio. Ela adiciona uma melhora significativa em prosódia, latência e alternância de fala. As equipes podem integrar um novo LLM de ponta na semana em que ele for lançado ou ajustar o STT para a área da saúde sem reconstruir nenhum outro componente.
Exemplos de casos de uso:
- Atendimento ao cliente para serviços financeiros, em que uma abordagem empática em uma ligação sobre cobrança contestada é combinada com barreiras rigorosas de conformidade e registro completo das interações
- Recepcionistas da área da saúde que fazem a triagem de ligações de pacientes com a urgência adequada, fluxos compatíveis com a HIPAA e reconhecimento de fala ajustado ao domínio para terminologia médica
- Assistentes de vendas que mantêm um tom cordial e persuasivo enquanto seguem um playbook estruturado e enviam atualizações ao CRM
3. Em cascata e fusionada híbrida
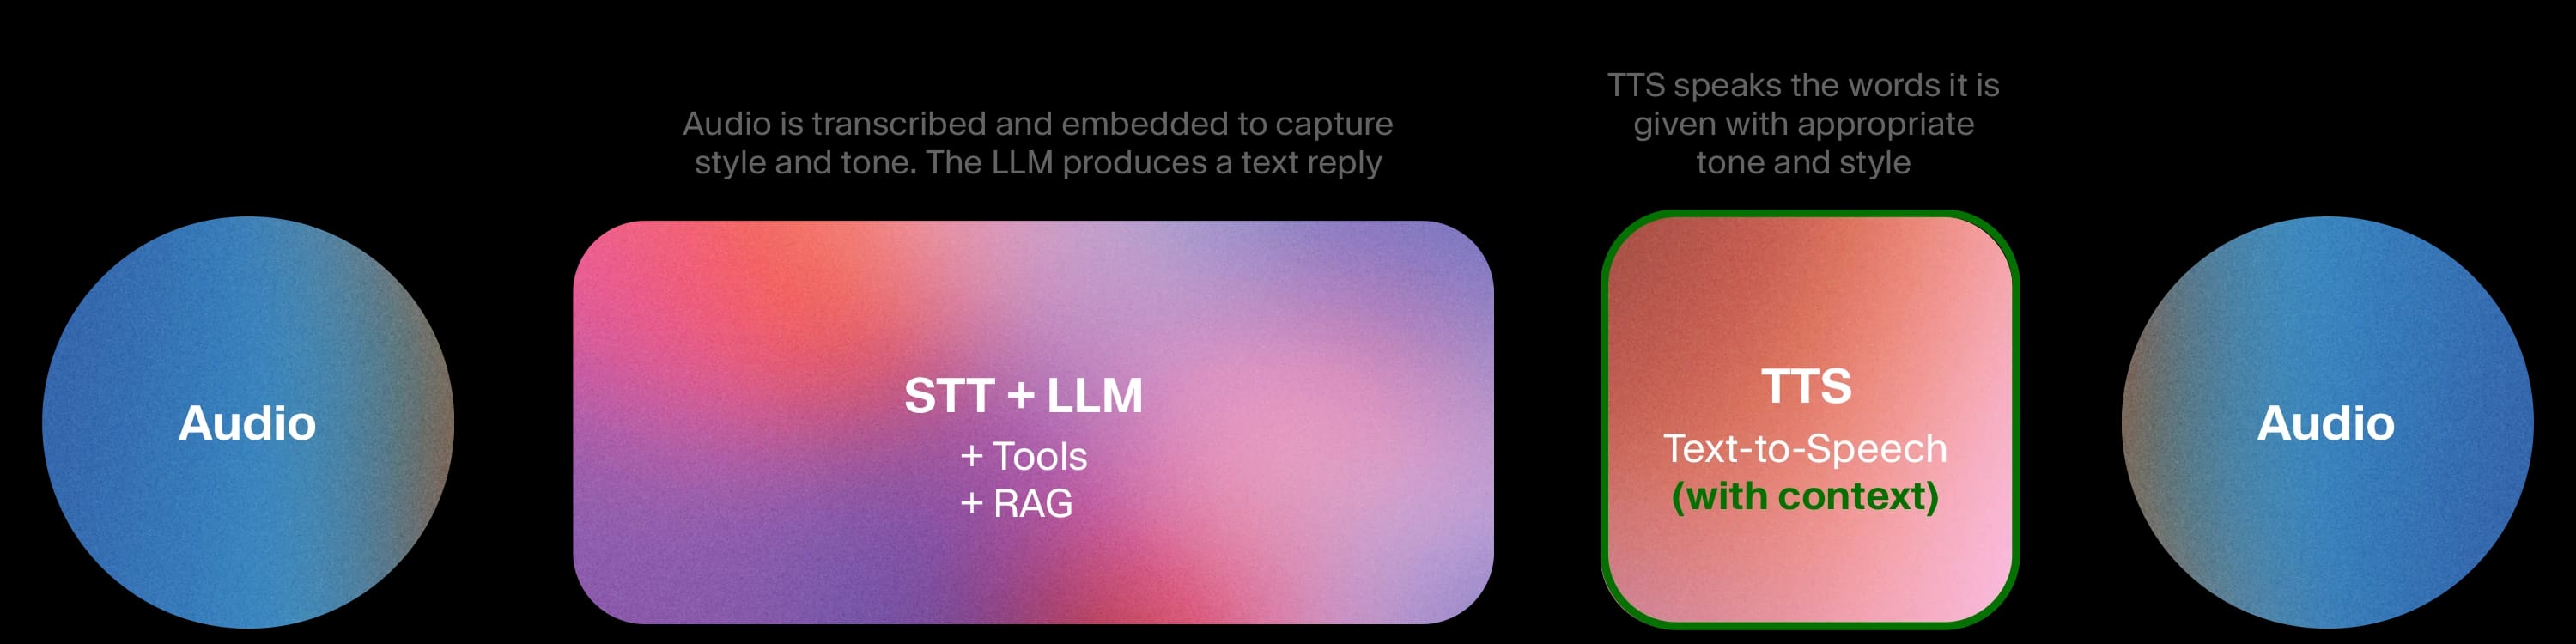
Algumas arquiteturas alimentam o LLM diretamente com características acústicas (pronúncia, emoção, tom) da fala de entrada como embeddings, em vez de primeiro convertê-la em texto. O TTS permanece modular.
Isso fornece ao LLM informações mais ricas sobre como algo foi dito, e não apenas sobre o que foi dito, o que é valioso para aplicações específicas. O bloco fusionado de ASR+LLM é mais difícil de auditar do que uma transferência de texto limpa, porque a representação intermediária é um embedding, não algo que uma pessoa possa ler. Também não é mais fácil trocar o LLM, o que limita seus recursos de raciocínio e chamadas de ferramentas ao modelo em torno do qual o bloco fusionado foi criado.
Exemplos de casos de uso:
- Aprendizado de idiomas e orientação de pronúncia, em que ouvir como um aluno fala importa tanto quanto o que ele diz
- Atendimento sensível ao tom e de baixa complexidade, em que detectar frustração importa, mas a tarefa em si é simples.
4. Fusionada sequencial
Um único modelo multimodal lida com reconhecimento, raciocínio e geração em uma única passagem, um turno por vez.
A prosódia pode ser excelente. Como a fala nunca é decomposta em texto, o modelo preserva naturalmente o ritmo, a entonação e os sinais emocionais. Conversas breves podem soar extremamente fluidas.
Mas há pouca capacidade de aplicar barreiras de proteção sem uma camada de texto, poucas saídas intermediárias para depuração e pouca flexibilidade para trocar por um LLM melhor ou ajustar o STT ao seu domínio. Os núcleos de raciocínio tendem a ser mais leves que os LLMs de ponta, portanto, chamadas de ferramentas complexas e tarefas com várias etapas são prejudicadas. Quando a tarefa exige resolver um problema complexo, a prosódia por si só não basta.
Exemplos de casos de uso:
- Companheiros pessoais, chatbots de entretenimento e aplicações em que a expressividade impulsiona o engajamento e os requisitos de conformidade são mínimos.
5. Fusionada duplex
A entrada e a saída são processadas simultaneamente, com o modelo ouvindo e falando ao mesmo tempo. Isso pode fazer com que interações breves pareçam surpreendentemente naturais, com fala realmente sobreposta e transições fluidas entre turnos.
Também é a arquitetura mais difícil de controlar, as barreiras de proteção são muito difíceis de aplicar e a sobreposição de vozes introduz erros imprevisíveis. Inspecionar, registrar ou depurar é extremamente difícil, e o sistema é em grande parte fechado, com poucas opções para trocar componentes, ajustar por domínio ou personalizar. O raciocínio e o uso de ferramentas são ainda mais limitados do que nos modelos fusionados sequenciais, porque o processamento simultâneo deixa menos capacidade para lógica complexa. E o mesmo processamento simultâneo que faz interações curtas soarem naturais torna conversas mais longas instáveis.
Exemplos de casos de uso:
- Apps experimentais de companhia, plataformas sociais de voz e demonstrações de pesquisa em que comportamentos imprevisíveis são aceitáveis.
Como escolher a arquitetura certa para seu caso de uso
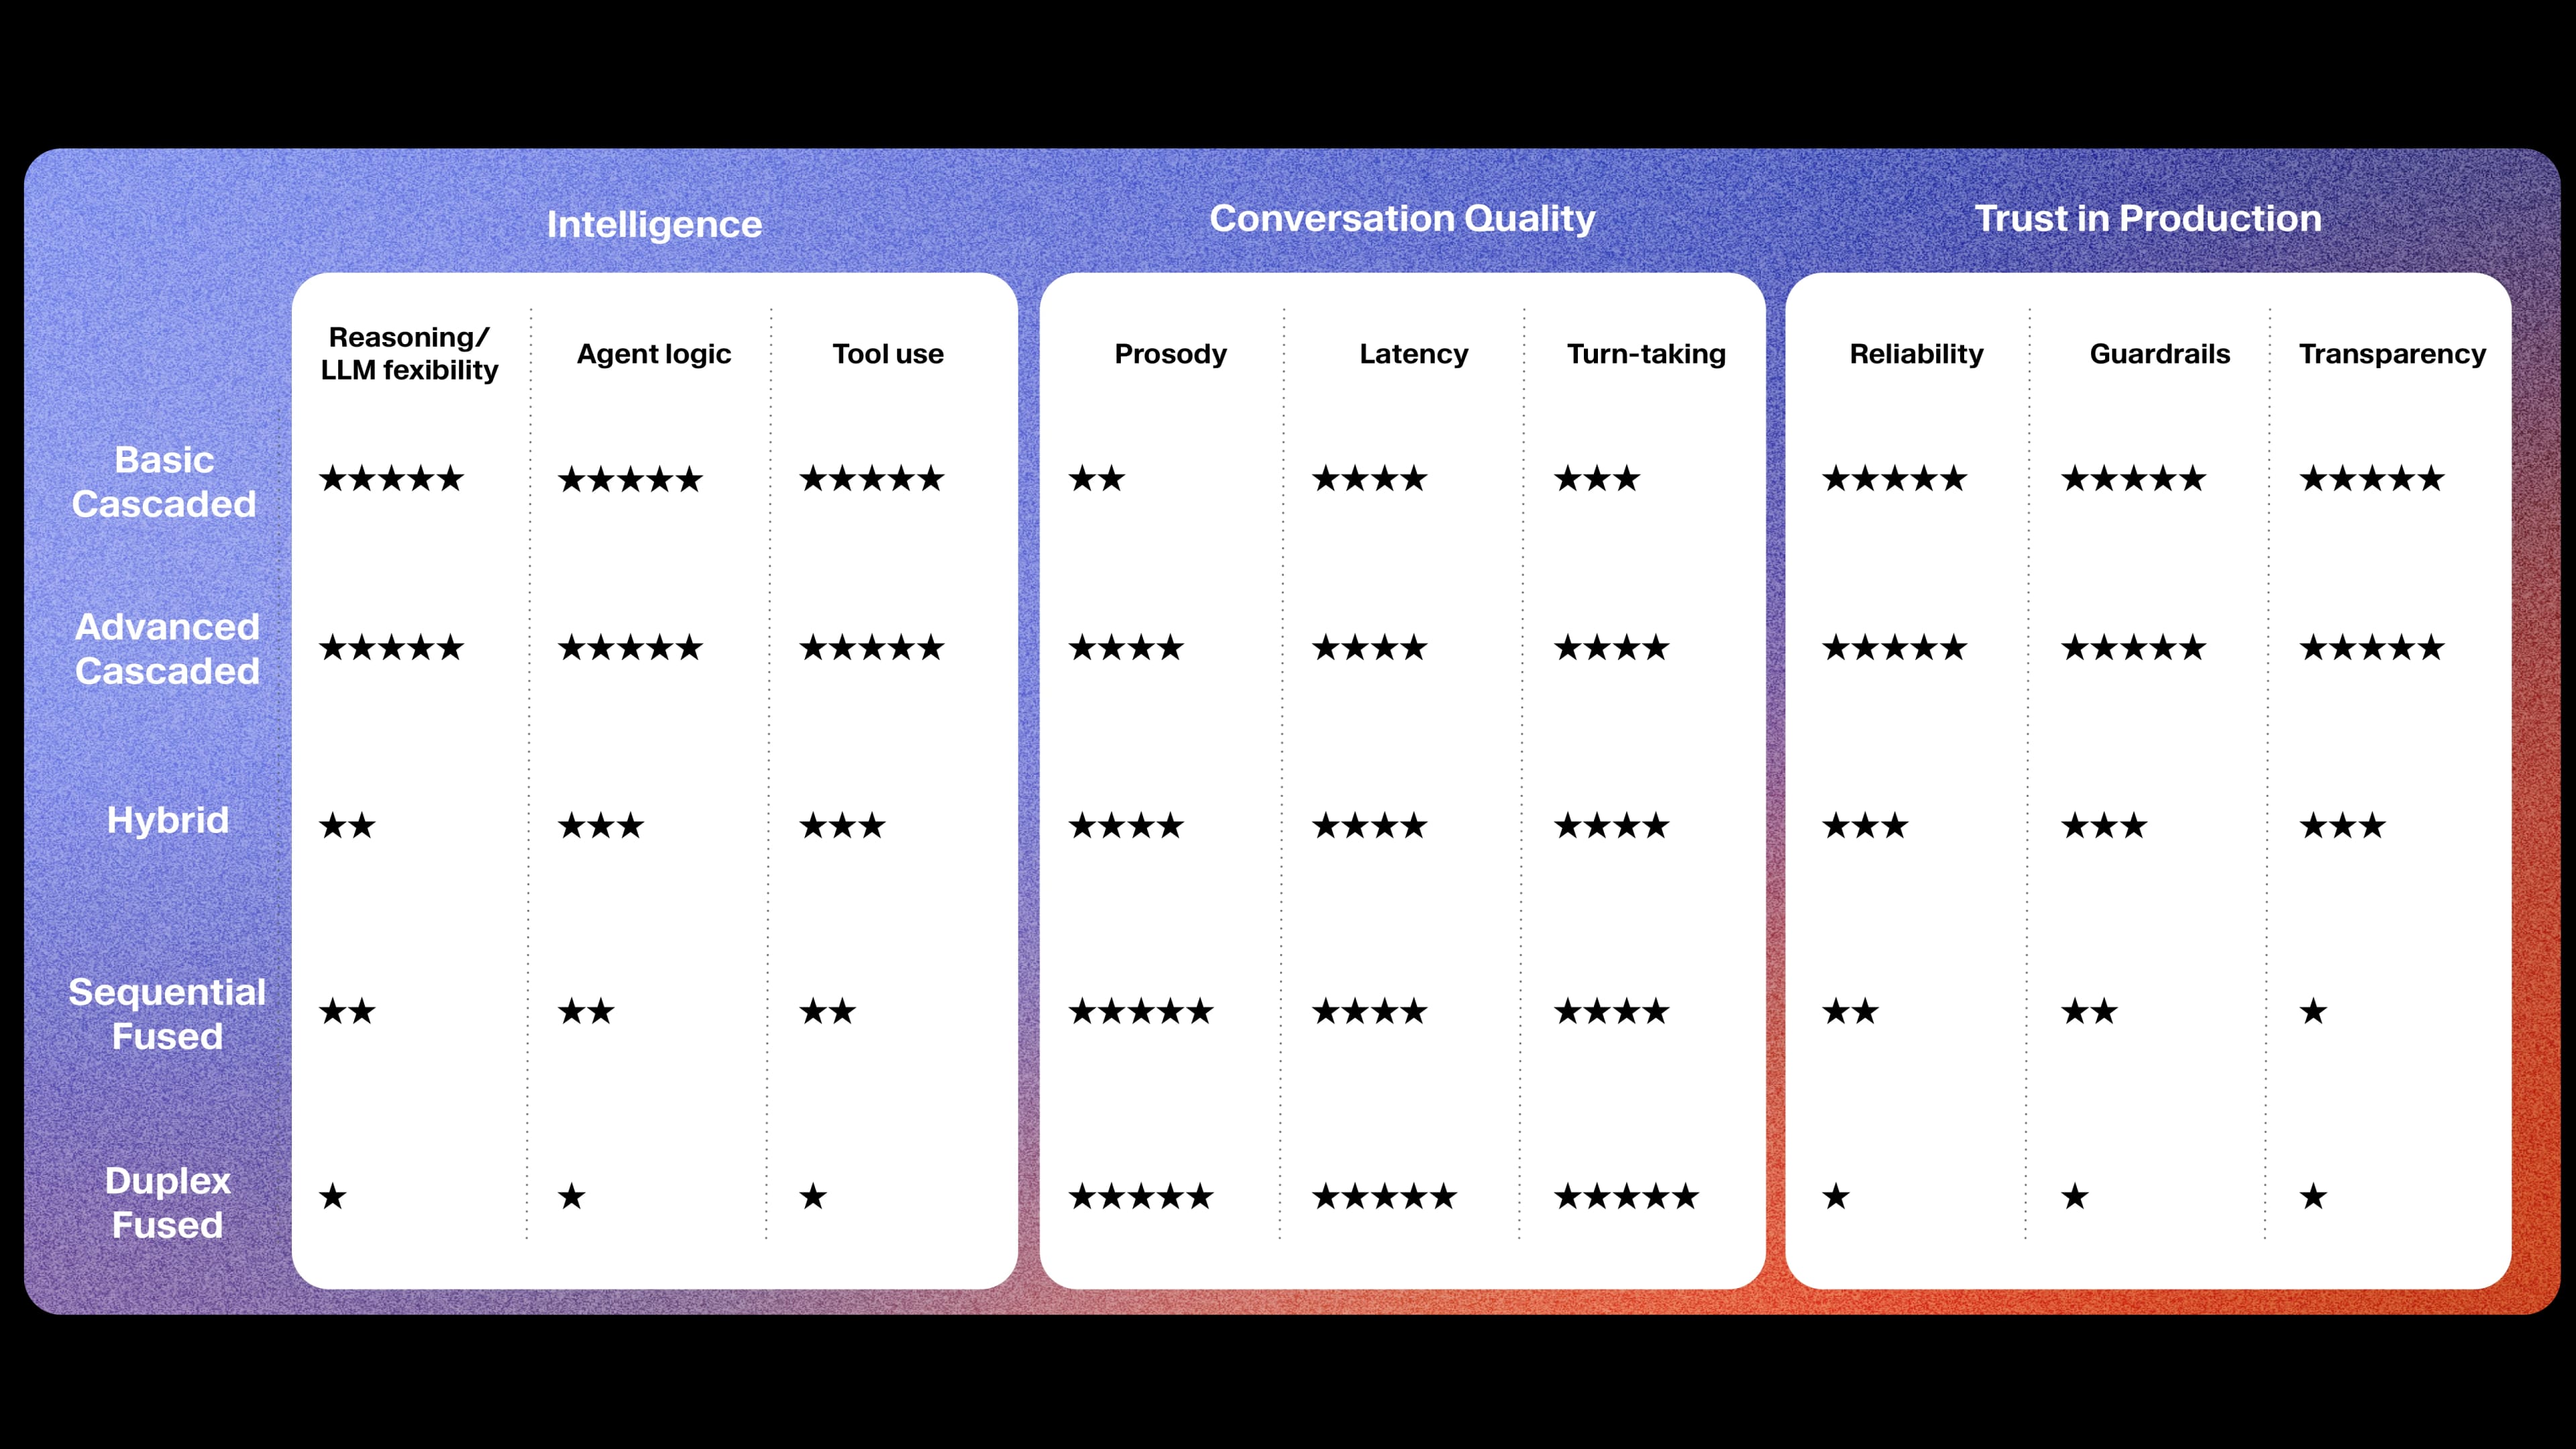
A arquitetura certa depende do que cada aplicação exige. Se você está criando uma experiência em que uma fala natural é o principal recurso, as arquiteturas fusionadas oferecem pontos fortes reais, caso você esteja disposto a abrir mão de raciocínio de ponta, barreiras de proteção e transparência. Embora os modelos fusionados liderem em prosódia, os sistemas avançados em cascata estão se aproximando a cada trimestre, enquanto os modelos fusionados não avançaram de forma significativa em raciocínio complexo ou confiança devido a limitações no nível da arquitetura.
Para a maioria das empresas e governos, a melhor arquitetura é aquela que soa muito bem e também é capaz, personalizável, confiável e pronta para implantação em escala. É por isso que escolhemos criar o ElevenAgents usando uma arquitetura avançada em cascata, com investimentos no Modo Expressivo e em modelos de ponta, cootimizados, para Speech to Text e Text to Speech. Isso permite que as equipes criem agentes com altos níveis de inteligência, confiabilidade e controle, combinados a uma fala natural e semelhante à humana.
À medida que os agentes de IA se expandem pelo atendimento ao cliente, educação, assistentes pessoais e muito mais, aqueles que tiverem sucesso serão desenvolvidos em arquiteturas adaptadas às suas aplicações específicas.