O que é detecção de atividade de voz e como ela funciona?
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
A detecção de atividade de voz classifica se frames curtos de áudio, com duração de milissegundos, contêm fala humana. Ela é usada em muitas aplicações de processamento digital de áudio, incluindo transcrição, telefonia e agentes de voz.
Neste artigo, vamos explorar o que a detecção de atividade de voz faz, o que ela não faz e como se encaixa em aplicações empresariais importantes.
Resumo
- A detecção de atividade de voz (VAD) é um componente fundamental dos workflows de áudio modernos. Ela analisa continuamente um fluxo de áudio e determina, em cada frame de áudio com duração de milissegundos, se há fala humana ou não.
- A VAD informa às ferramentas de áudio posteriores quando devem operar e quando devem aguardar. Ela é usada por LLMs, serviços de transcrição e outros pipelines empresariais de áudio.
- Os algoritmos de detecção de atividade de voz operam em um ciclo contínuo de cinco etapas: capturar o áudio, dividi-lo em frames, extrair características vocais, avaliar a probabilidade de haver fala e transmitir uma decisão aos serviços posteriores.
- Originalmente, a VAD dependia de processamento de sinais puramente matemático para determinar se havia fala ou não. Sistemas modernos baseados em IA usam redes neurais para realizar a mesma função, mas com melhor compreensão contextual de ruído de fundo e sinais semânticos.
- Os sistemas de VAD apenas classificam se um frame de áudio contém fala. Eles não informam quando alguém terminou de falar. Sistemas de endpointing usam VAD e outras ferramentas de análise heurística para decidir se um falante concluiu seu pensamento.
- Em ambientes empresariais, a VAD ajuda agentes de voz a conversar naturalmente com clientes sem interrompê-los, otimiza o uso da largura de banda de VoIP, mantém baixos os custos de transcrição com IA de Speech to Text (STT) e tem outros usos.
- Teste sistemas de VAD em condições reais. Gravações perfeitas de estúdio não são um meio eficaz para determinar suas capacidades.
O que é detecção de atividade de voz (VAD)?
A detecção de atividade de voz (VAD) é um processo de software que classifica se pequenos trechos de áudio, chamados frames, contêm fala. Os algoritmos de VAD são executados dezenas a centenas de vezes por segundo em um fluxo de áudio e retornam uma resposta binária de “sim” ou “não” sobre a detecção de fala.
Ela é usada em pipelines mais amplos de áudio digital, como telecomunicações ou transcrição de fala. Ela informa a outros sistemas posteriores, como ASR/STT, LLMs e planejadores de turno, se devem escutar ativamente o fluxo de áudio ou aguardar.
VAD não é a mesma coisa que Reconhecimento Automático de Fala (ASR). Tudo que um sistema de VAD faz é fornecer uma resposta probabilística de sim ou não sobre detectar fala. Ele não produz palavras reais. Sua função principal é informar aos sistemas posteriores se devem processar um determinado frame de áudio.
Como funcionam os algoritmos de detecção de atividade de voz?
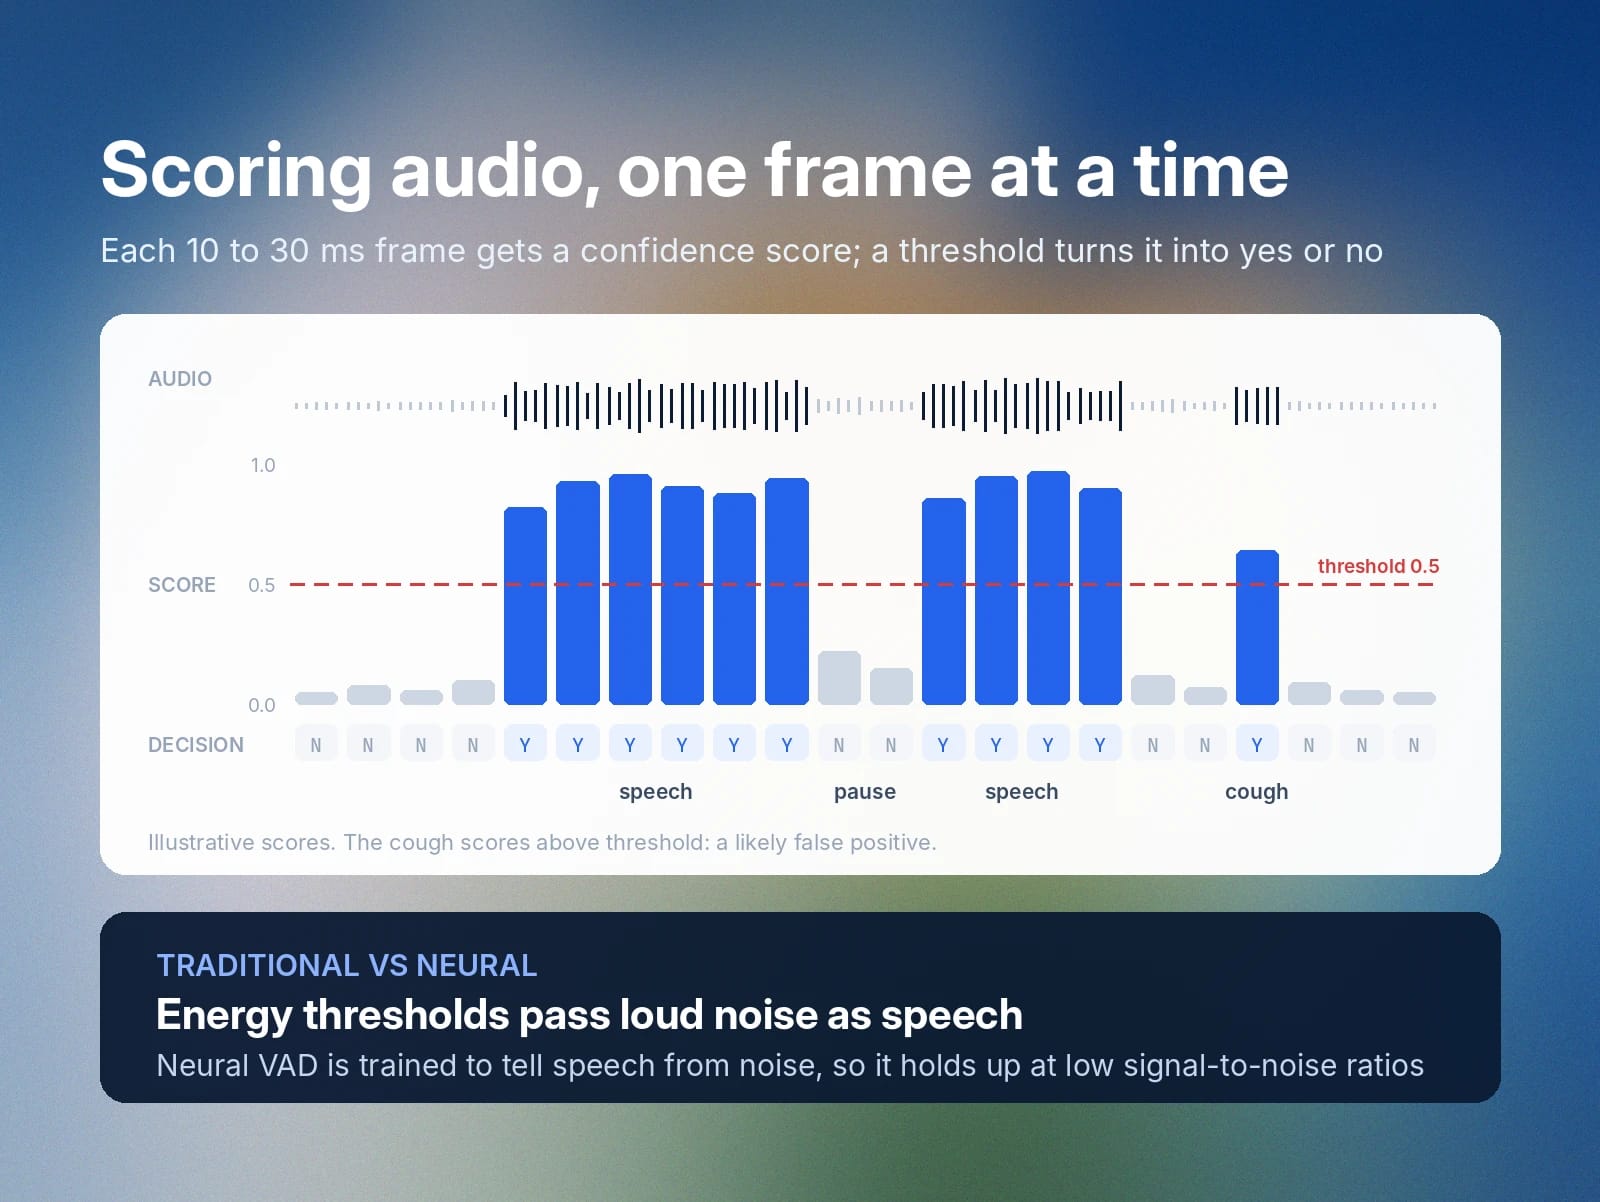
Um algoritmo de VAD é executado em um fluxo de áudio e decide se um determinado frame de áudio, geralmente de 10 a 30 milissegundos, contém fala ou não.
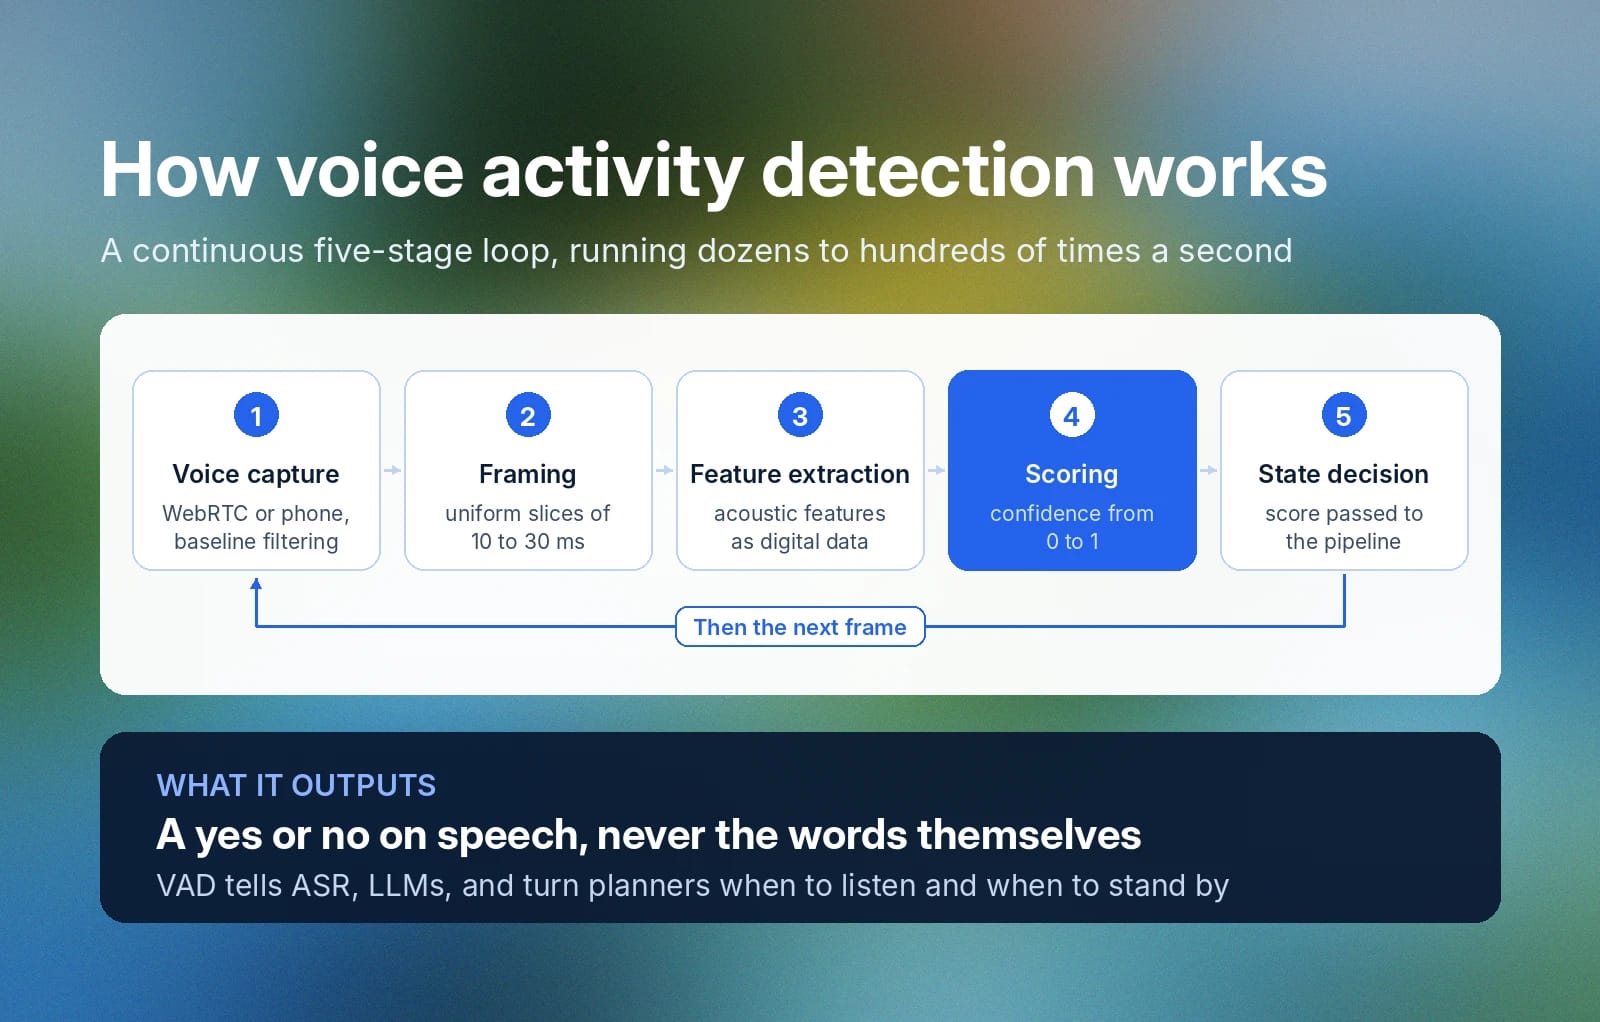
Eles operam continuamente em um ciclo de cinco etapas:
- Captura de voz: O sistema que executa a VAD recebe um fluxo de áudio via WebRTC ou telefonia e aplica filtragem básica de ruído aos dados.
- Divisão em frames: O algoritmo divide o fluxo de áudio bruto em frames uniformes.
- Extração de características: O algoritmo extrai do fluxo características acústicas que podem ser representadas matematicamente como dados digitais.
- Pontuação: O sistema processa, no algoritmo de VAD, as características extraídas de um frame para gerar uma pontuação de confiança entre 0 e 1 sobre ele conter fala (0 = “sem fala” e 1 = “fala”).
- Decisão de estado: O sistema de VAD passa a pontuação de confiança ao pipeline de áudio em que opera para que ele possa decidir como lidar com ela.
Detecção de atividade de voz tradicional vs. baseada em IA
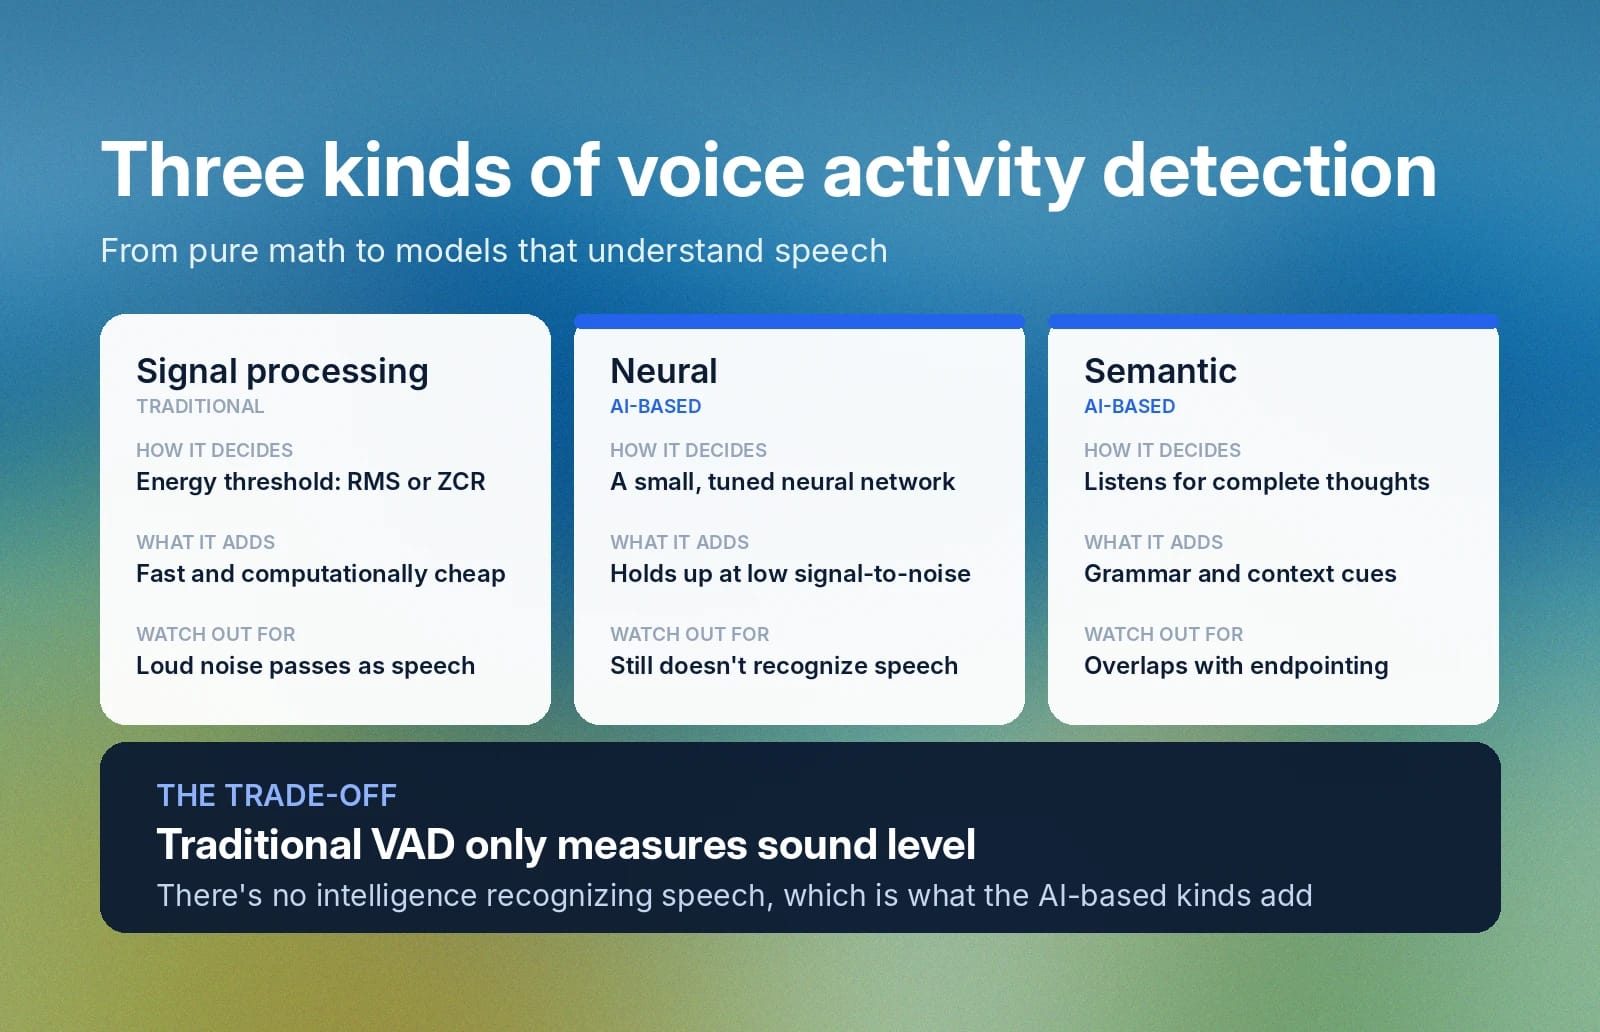
A VAD se divide em duas grandes categorias: processamento de sinais e IA.
Na VAD baseada em IA, há duas abordagens distintas, totalizando três tipos de detecção de atividade de voz.
Vamos analisar cada uma delas em mais detalhes.
VAD tradicional (processamento de sinais)
A tecnologia de VAD tradicional mede o nível de energia de um fluxo de áudio e confirma a presença de fala se ele ultrapassar determinado limite. Ela é puramente matemática, geralmente um cálculo de raiz quadrada média (RMS) ou taxa de cruzamento por zero (ZCR). Se um frame estiver acima do limite, ele é considerado fala. Se estiver abaixo, não é.
A VAD tradicional é rápida e tem baixo custo computacional, mas mede apenas o nível de som no áudio. Ruídos altos de fundo podem causar falsos positivos. Não há inteligência realmente reconhecendo a fala.
VAD baseada em IA
Há dois tipos mais recentes de VAD baseada em IA: neural e semântica. Em vez de usar um limite puramente matemático, a VAD neural usa uma rede neural pequena e altamente ajustada para determinar se um frame de áudio contém fala ou silêncio. O treinamento permite que ela entenda a diferença entre fala e ruído, por isso tem desempenho melhor que a VAD tradicional quando há uma baixa relação sinal-ruído (SNR) no fluxo de áudio — ou seja, quando há muito ruído de fundo.
A desvantagem da VAD neural é que ela ainda não reconhece a fala em si. A VAD semântica baseada em IA é uma variedade diferente que reconhece. Ela se sobrepõe ao endpointing ao escutar um fluxo de áudio em busca de pensamentos falados completos. Pode entender gramatical e contextualmente se ainda haverá mais fala.
VAD vs. endpointing
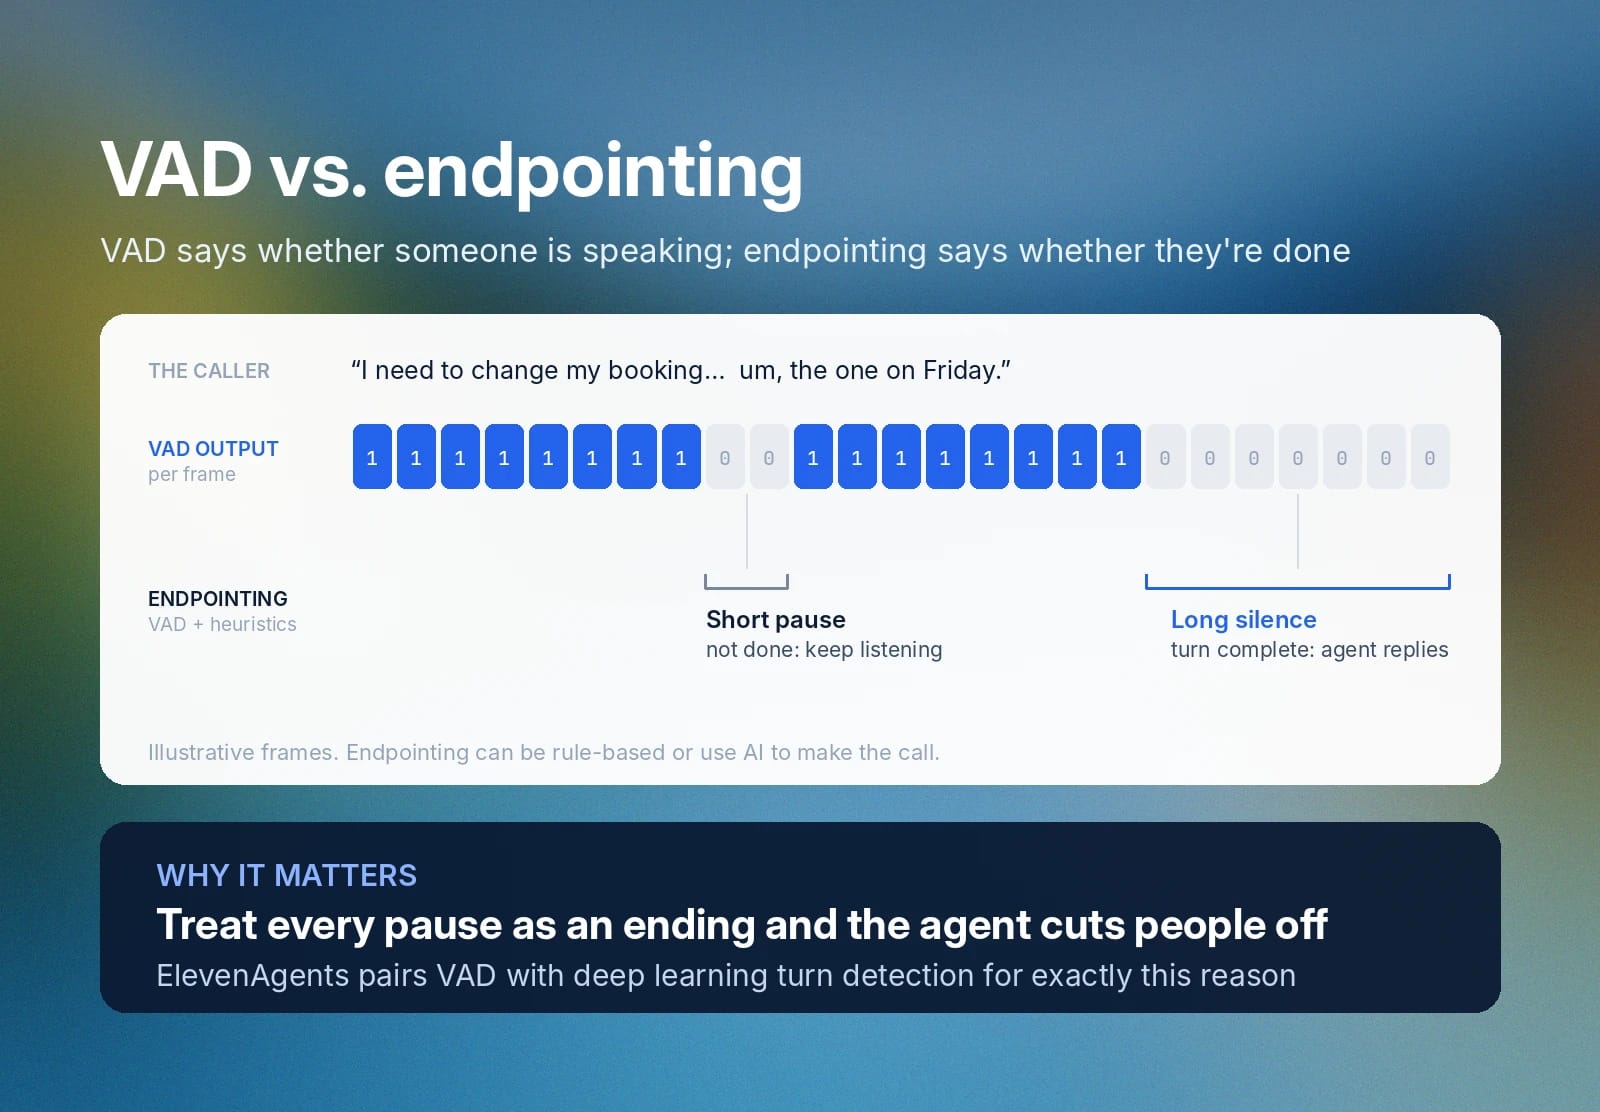
VAD e endpointing são tecnologias complementares. Um sistema de detecção de atividade de voz simplesmente decide se alguém está falando em cada frame de áudio que processa. Ele toma uma decisão binária de sim ou não e a transmite ao restante do pipeline de processamento de áudio.
Um sistema de endpointing usa a saída da VAD, combinada com análise heurística, para determinar se um falante concluiu seu pensamento. Ele pode usar processamento de sinais baseado em regras ou IA para tomar essa decisão.
Aplicações da detecção de atividade de voz em IA em tempo real
A detecção de atividade de voz é importante em vários casos de uso.
Agentes de voz autônomos e call centers
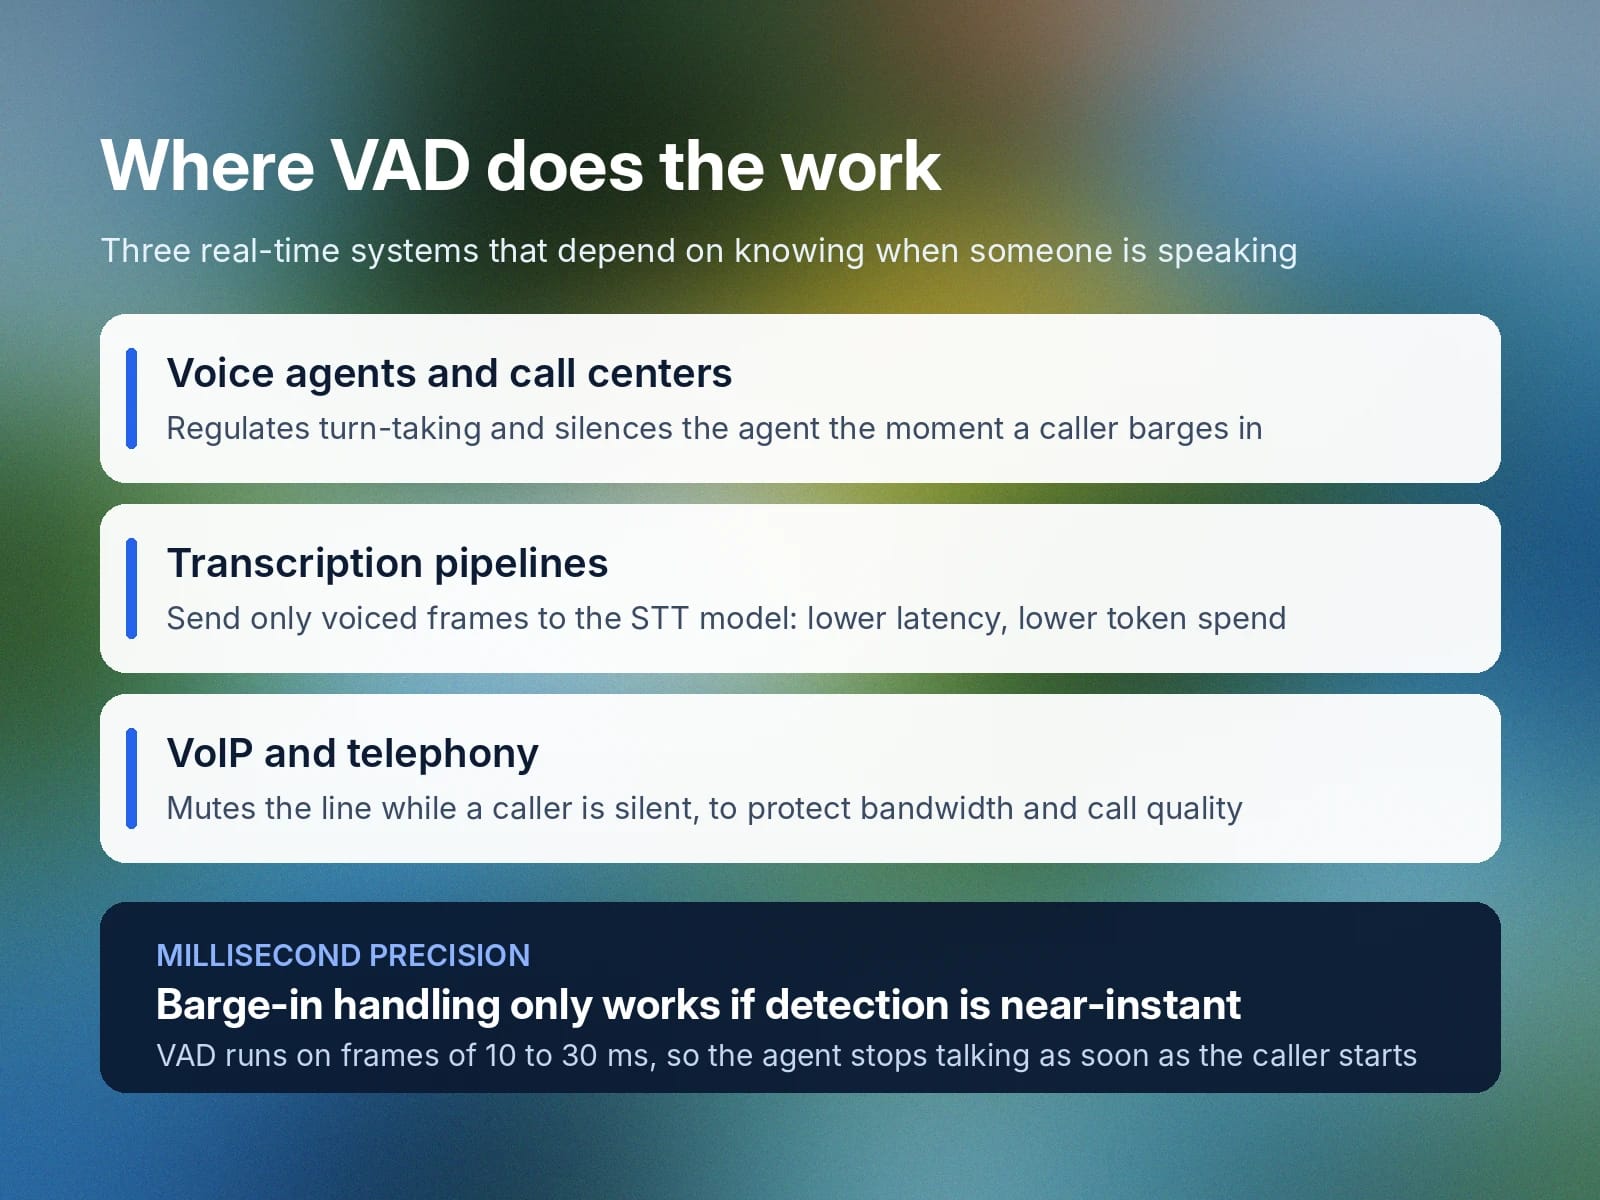
Um agente autônomo que filtra chamadas de clientes precisa saber quando é apropriado responder. Você não quer que o agente interrompa um cliente no meio da frase nem que continue falando por cima dele quando ele responde antes. A VAD ajuda a regular a alternância de turnos na conversa e a manter um fluxo natural na interação. Como opera em milissegundos, também é muito eficaz para gerenciar as interrupções dos clientes, silenciando o agente quando o cliente o interrompe.
Pipelines de transcrição
Se você usa um serviço de Speech to Text de API de transcrição, como a ElevenAPI, você pode filtrar o áudio enviado usando a detecção de atividade de voz para que o modelo processe apenas frames com fala. Isso reduz a latência de rede e, mais importante, reduz o uso de tokens no modelo de transcrição. Você não vai gastar recursos de IA com ruído de fundo.
Otimização de VoIP e telefonia
A latência também pode afetar a qualidade das chamadas em redes VoIP empresariais. Para otimizar o desempenho, esses sistemas de áudio digital silenciam temporariamente uma linha usando VAD quando quem liga não está falando.
O que torna a detecção de atividade de voz desafiadora?
A detecção de atividade de voz tradicional depende de algoritmos matemáticos para decidir se há fala. No entanto, os padrões de fala humana são complexos. As conversas costumam ser irregulares, com pausas e retomadas, e ocorrem em ambientes reais com ruído de fundo e até conversas paralelas. O principal desafio da VAD é identificar silêncio significativo em meio a áudios ruidosos.
Isso se manifesta em alguns desafios específicos.
Pausas no meio da frase
As pessoas não falam em um ritmo constante durante uma conversa inteira. Elas fazem pausas, organizam os pensamentos, reconsideram enquanto falam e perdem o fio da meada. Nenhuma dessas pausas significa que a pessoa terminou de falar. Isso geralmente é fácil de entender para ouvintes humanos, mas pode ser desafiador para softwares, até mesmo para modelos de IA mais recentes.
Quando sistemas de VAD confundem essas pausas com o fim da fala, podem cortar uma frase no meio durante uma transação ou levar um agente de voz a interromper um falante humano.
Ruído vocal
Fala baixa, consoantes finais descendentes (comuns no fim de uma frase) e características como vocal fry podem fazer com que sistemas de VAD não detectem fala legítima.
Acústica imprevisível
Ruído branco contínuo de fundo, como o de um ventilador ou de água corrente, é relativamente fácil de filtrar para sistemas de VAD. Ruídos esporádicos, como o latido de um cachorro, podem ser sinalizados como fala fantasma.
A compressão intensa de áudio reduz a faixa dinâmica e pode dificultar a diferenciação entre frames silenciosos e de fala pela VAD.
Como avaliar o desempenho da VAD
A fala humana é complexa, especialmente quando gravada em ambientes reais e dinâmicos. Gravações de áudio perfeitas não são um bom mecanismo para testar o desempenho da VAD. A precisão pura de Speech to Text também não mede diretamente a eficácia de um sistema de VAD, pois ela vem depois do que a VAD detecta.
Falsos positivos vs. falsos negativos
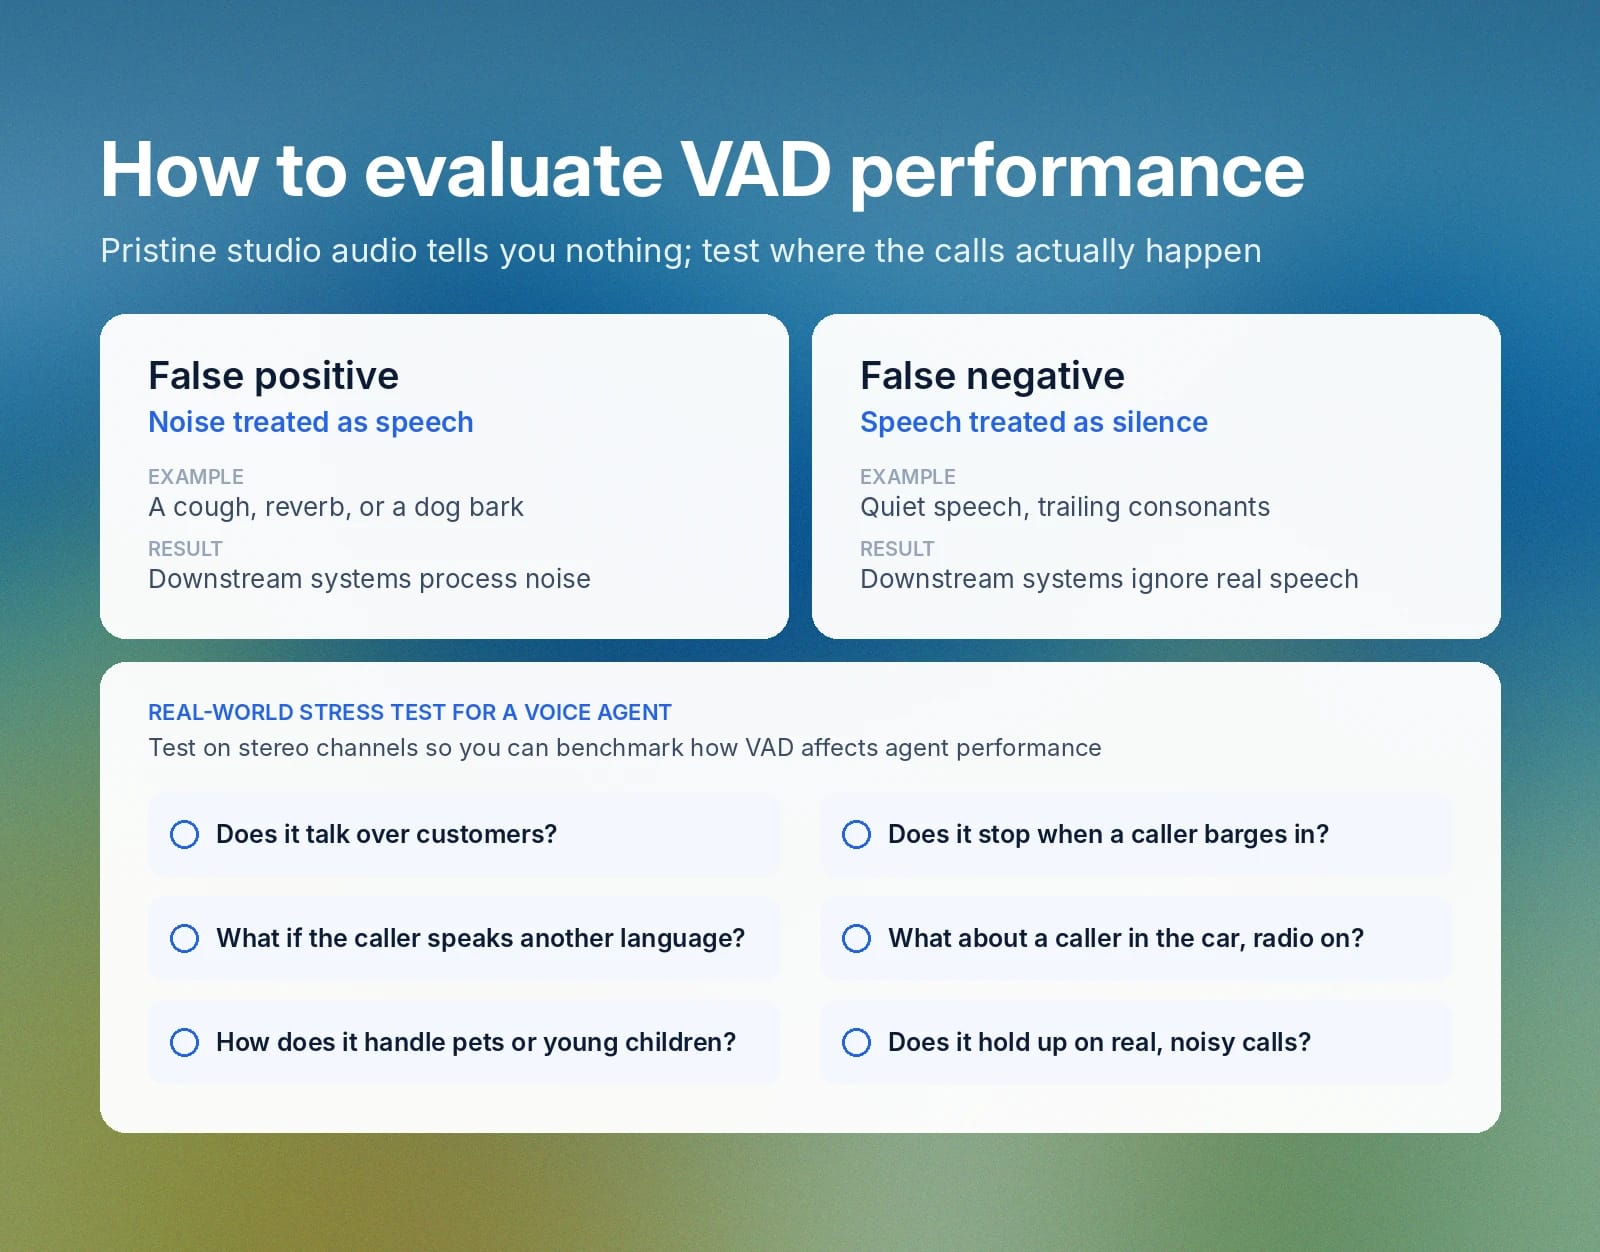
Falsos positivos de VAD são ruídos tratados como fala. Uma tosse, reverberação, latido de cachorro e qualquer outro ruído súbito de fundo podem acioná-los e ser enviados inadvertidamente como frames de fala.
Falsos negativos são falas tratadas como silêncio. A VAD instrui os serviços posteriores a ignorar frames de áudio por engano.
Testes de estresse em condições reais
Para avaliar um serviço de VAD, você precisa verificar como ele se comporta nos ambientes onde o áudio será gravado e em condições reais.
Por exemplo, se você pretende usar VAD em um agente de voz, tente testar com canais estéreo para avaliar como isso afeta o desempenho do agente. Perguntas como estas podem surgir:
- Há falsos negativos que fazem o agente falar por cima dos clientes?
- Ele impede o agente de falar quando um usuário o interrompe?
- O que acontece se quem liga falar um idioma estrangeiro?
- Como ele funciona ao ouvir pessoas ligando de ambientes reais?
- O que acontece quando um cliente liga do carro, mas não abaixa o volume do rádio?
- Como ele lida com ruídos de fundo de animais de estimação ou crianças pequenas?
Todas essas condições provavelmente ocorrerão em chamadas de clientes. A VAD precisa resistir a elas e ter bom desempenho sob pressão.
Comece a usar o ElevenAgents no atendimento ao cliente
O ElevenAgents usa um sistema híbrido de VAD e detecção de turnos por deep learning para manter as conversas com agentes fluindo de forma natural.
Comece hoje a criar um novo agente de atendimento ao cliente com o ElevenAgents. Cadastre-se para começar.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.