O Scribe v2 Medical já está disponível para todos
- Escrito por
- Min Kim
- Publicado
- Última atualização
OuvirOuça este artigo
O áudio clínico é um dos maiores desafios para o reconhecimento de fala preciso. Os nomes de medicamentos são longos, raros e fáceis de confundir (hydroxyzine e hydralazine diferem por uma sílaba ouvida incorretamente). O vocabulário é denso, com dosagens, unidades e termos de anatomia e patologia que podem surgir em rápida sequência. O impacto de um erro também é maior, pois uma falha na transcrição pode acabar no prontuário de um paciente.
Por isso, a ElevenLabs lança hoje o Scribe v2 Medical, nosso modelo de Speech to Text ajustado para áudio clínico, agora disponível de forma geral na ElevenAPI. Nas avaliações apresentadas abaixo, ele obtém consistentemente uma das menores taxas de erro de palavras (WER) entre os modelos comparados e reduz a WER em áudio clínico em aproximadamente 35% em relação ao nosso modelo Scribe v2 básico.
Modelos de uso geral são ótimos para lidar com a fala cotidiana, mas podem perder desempenho justamente onde os fluxos de trabalho clínicos mais precisam deles. Treinamos um Finetune médico do Scribe v2 voltado a nomes de medicamentos e à transcrição clínica, usando benchmarks públicos que qualquer pessoa pode reproduzir.
O Scribe v2 Medical é otimizado para casos de uso clínicos
Ditado clínico (MedDictate)
MedDictate da Corti testa a transcrição de notas clínicas ditadas, que incluem nomes de medicamentos, dosagens e unidades em sequência, em inglês, francês e alemão. Em nossa avaliação, o Scribe v2 Medical registra a menor WER geral entre os modelos testados e uma WER aproximadamente 35% menor que a do Scribe v2 básico.
Modelo
EN
FR
DE
WER geral
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (básico)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Somente em inglês (24 clipes) — o Deepgram Nova-3 Medical não oferece suporte para francês ou alemão.
Terminologia médica (MedTerm)
MedTerm também é um conjunto de dados publicado pela Corti e inclui um benchmark de terminologia clínica com 600 amostras nos mesmos três idiomas, com os termos médicos de cada amostra anotados. Essa anotação permite avaliar os modelos em duas dimensões além da WER da transcrição completa. A recuperação de termos é a porcentagem de termos médicos anotados que aparecem corretamente na transcrição (quanto maior, melhor). Term-WER é a taxa de erro apenas desses termos, ignorando a fala comum ao redor deles (quanto menor, melhor).
O Scribe v2 Medical lidera todos os modelos testados nas duas dimensões e supera todos os outros provedores nos três idiomas:
Modelo
Recuperação de termos ↑
Term-WER ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (básico)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Benchmark Eka Medical ASR
O benchmark Eka Medical ASR contém 3.619 amostras de áudio clínico em inglês — incluindo nomes isolados de medicamentos e condições, frases clínicas e conversas entre profissionais de saúde e pacientes — com anotações por termo e um ranking publicado no cartão do conjunto de dados.
Como o conjunto de dados publicado inclui modelos mais antigos, como Gemini 2.5 Flash e GPT-4o, executamos a avaliação com modelos mais recentes. O SemWER (WER semântica) avalia se o modelo captou o conteúdo correto, independentemente da formatação ("mg" e "miligramas" contam como a mesma resposta), e o kwWER (WER de palavras-chave) aplica a mesma avaliação apenas às palavras-chave médicas anotadas.
Modelo
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (básico)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
O Eka anota os termos médicos em cada amostra, o que permite avaliar os ganhos do Scribe v2 Medical em relação ao modelo básico de forma mais detalhada, considerando apenas os termos médicos. O Scribe v2 Medical comete 15% menos erros que o modelo básico (9.5% vs. 11.1%), e os ganhos são maiores quando os termos aparecem em frases clínicas completas (7.5% vs. 9.9%).
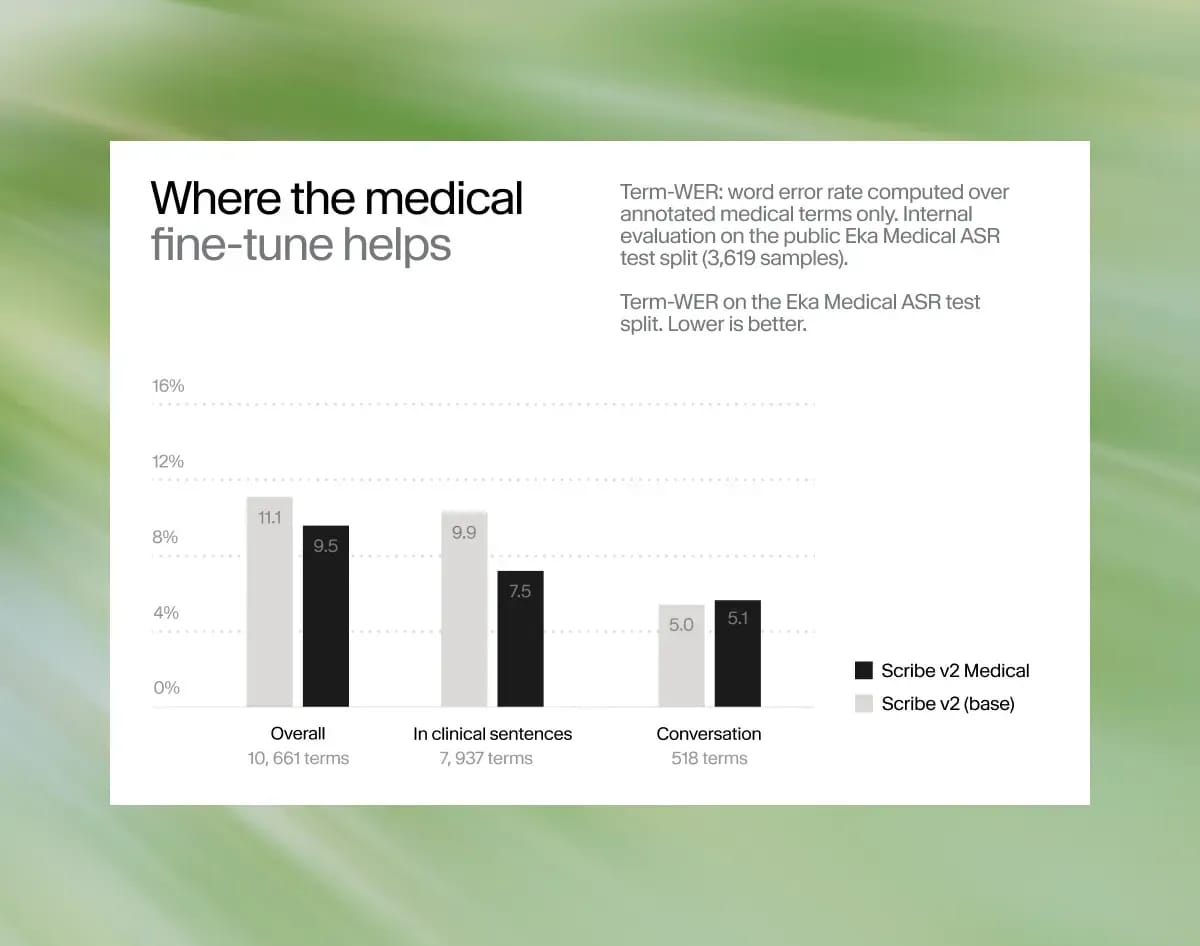
Uma ressalva desses mesmos dados é que clipes isolados de uma única palavra (o nome de um medicamento falado sem nenhum contexto ao redor) continuam sendo o caso mais difícil para todos os modelos do ranking, incluindo o Scribe v2 Medical. Ele registrou 14.3% de WER em termos isolados, contra 7.5% quando esses termos aparecem em frases. Sem contexto, uma sílaba ouvida incorretamente pode gerar falhas marcantes:
- etodolac (um AINE) → "It'll do the luck"
- levomilnacipran (um antidepressivo) → "Leave me alone now, Sephora."
- methdilazine (um anti-histamínico) → "Let's play our scene."
Uma forma de reduzir esses erros é usar prompting de termos-chave, que permite destacar nomes de medicamentos ou frases médicas para direcionar o modelo a transcrevê-los corretamente.
Clientes em produção
Nossos clientes já usam o Scribe v2 Medical em produção e observam melhorias no áudio clínico.
"Desde que migramos do Deepgram para o ElevenLabs Scribe v2 Medical, estamos vendo uma precisão muito maior na terminologia clínica, e isso mudou a forma como a equipe trabalha", disse Mendel Erlenwein, CEO e fundador da CareCo. "Quando nossos coordenadores confiam nas transcrições, eles podem passar menos tempo corrigindo notas e mais tempo ao telefone com os pacientes. Nossos pacientes seguem tratamentos complexos, e a nota que a equipe de cuidados lê precisa estar correta."
Alto desempenho em fala geral
A equipe também verificou que o Finetune médico não reduz o desempenho em outras áreas. Em 6.000 amostras de fala cotidiana não médica, derivadas do Common Voice, o Scribe v2 Medical tem o mesmo resultado do Scribe v2 básico quando arredondado: WER de 5.3% nos dois casos. Assim, com o v2 Medical, você obtém os benefícios de um modelo médico especializado sem abrir mão da precisão nesse benchmark.
Desenvolvido para informações de saúde protegidas
O Scribe v2 Medical é elegível para HIPAA para clientes empresariais com Business Associate Agreements vigentes e o Modo de retenção zero (ZRM) ativado.
Com o ZRM ativado para solicitações da API de Speech to Text, a entrada de áudio e a saída de texto são excluídas imediatamente após a conclusão de cada solicitação. A ElevenLabs não retém nenhum dos dois, e seu aplicativo recebe a resposta completa da API e controla como as transcrições são armazenadas.
Primeiros passos
O Scribe v2 Medical está disponível na API de Speech to Text. Basta informar o novo ID do modelo: scribe_v2_medical
O modelo é executado no endpoint em lote de Speech to Text.