O que é alternância de turnos na IA conversacional: um guia para conversas naturais
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Um bom atendimento ao cliente exige habilidades excepcionais de conversação. Uma das mais importantes é aprender a ouvir e saber quando falar. Caso contrário, os atendentes correm o risco de interromper clientes que já estão frustrados e talvez tenham ligado várias vezes para explicar o problema.
O mesmo padrão se aplica à alternância de turnos na IA conversacional. Os agentes precisam encontrar um equilíbrio delicado entre permanecer em silêncio tempo suficiente para deixar a pessoa falar, mas não tanto a ponto de a latência e os silêncios prejudicarem a qualidade da conversa.
Por isso, a alternância de turnos moderna exige que os modelos avaliem rapidamente a intenção da fala, em vez de usar temporizadores rígidos de silêncio. Nossa arquitetura unificada na ElevenLabs faz isso analisando continuamente o tom, o ritmo e o contexto das palavras para manter as conversas no rumo certo e com um fluxo natural.
Resumo
- As equipes de atendimento ao cliente usam agentes de voz treinados em alternância de turnos para resolver problemas rapidamente e com menos atrito.
- A alternância de turnos é importante para que os modelos determinem quando responder ou interagir, manter a vez de fala e ouvir ou permanecer em silêncio.
- Agentes de IA usam tempo adaptativo, detecção de atividade de voz e análise semântica para manter um fluxo natural de conversa.
- As equipes de engenharia acompanham a latência de resposta e as taxas de interrupção para medir o fluxo da conversa e otimizar workflows.
O que é alternância de turnos na IA conversacional?
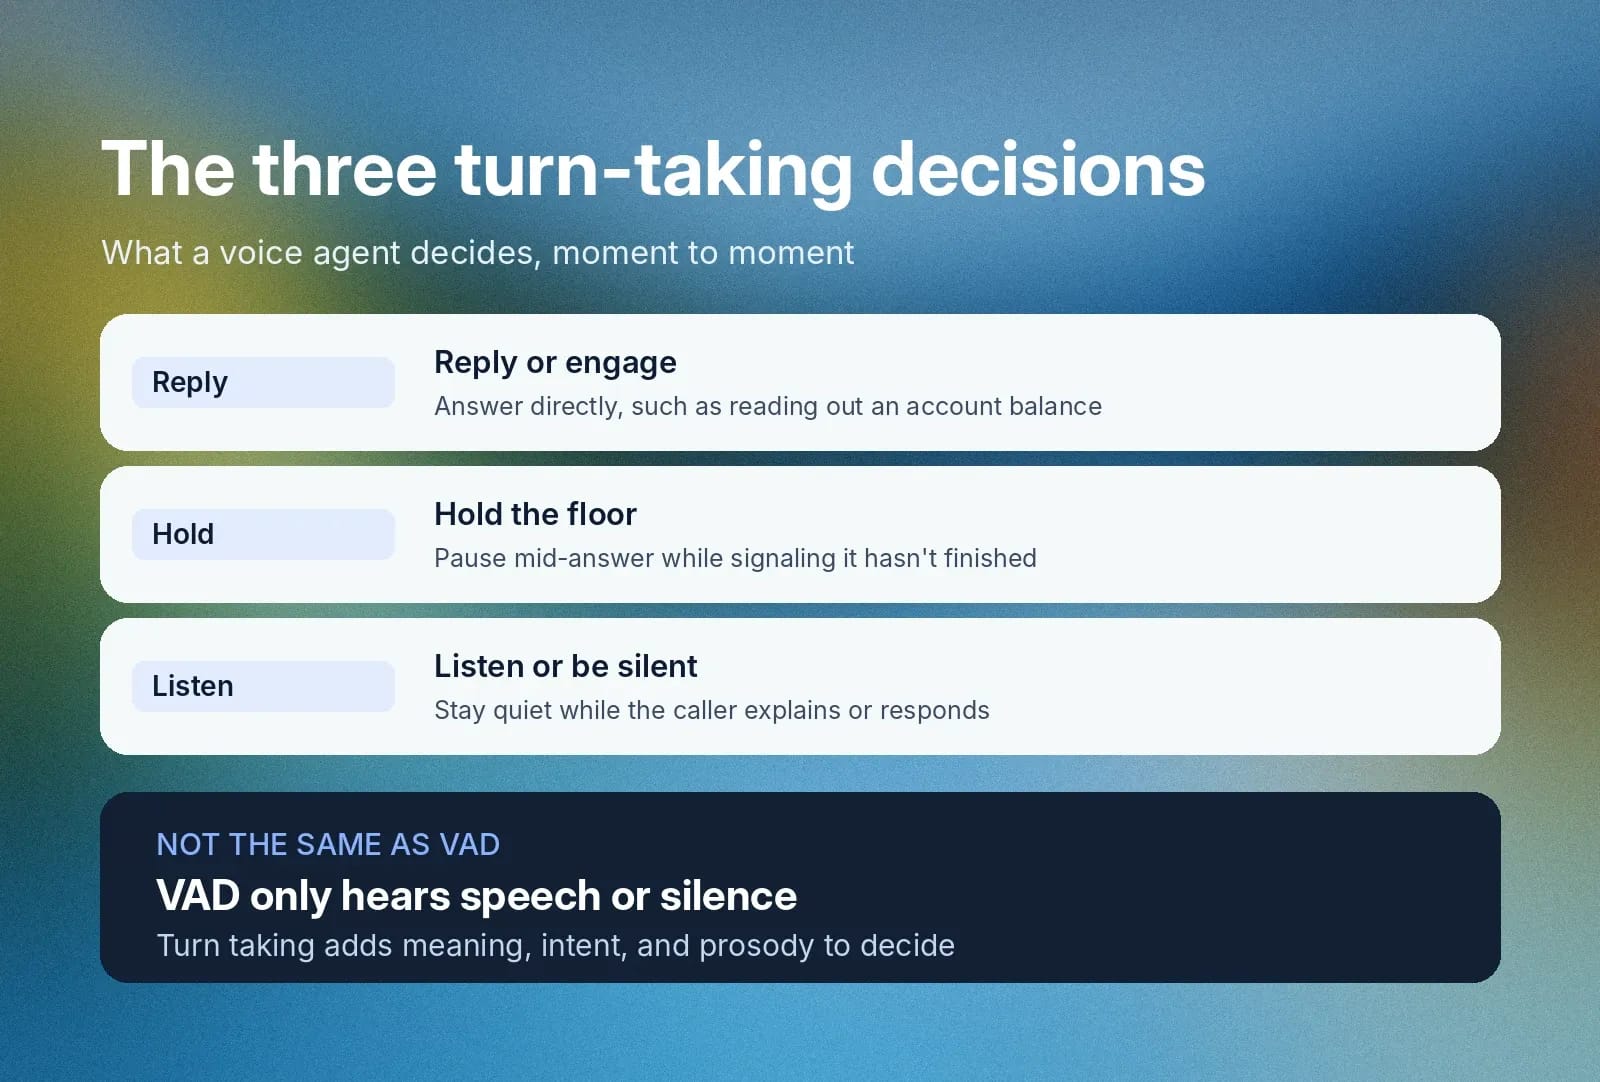
Quando modelos de IA conversacional usam alternância de turnos, eles seguem um conjunto de regras que determina o momento ideal para:
- Responder ou interagir: Nesse caso, o agente de IA responde diretamente à pergunta. Por exemplo, um cliente pergunta o saldo da conta, e o sistema responde: “O saldo da conta é de US$ 57,34.”
- Manter a vez de fala: Nesse caso, o modelo continua falando e sinaliza que ainda não terminou, mesmo quando faz uma pausa. Por exemplo, um cliente pergunta o saldo da conta, e ele responde: “Primeiro, deixe-me usar as informações que você enviou para acessar sua conta… [pause]. O saldo da conta é de US$ 57,34, mas… [pause] também vejo um pagamento pendente nesse valor. Você está ligando para saber quando esse pagamento será processado sem que seja cobrada uma multa por atraso?”
- Ouvir ou permanecer em silêncio: Nesse momento, o agente permanece em silêncio enquanto espera o cliente explicar a situação ou responder. Por exemplo, o cliente confirma que queria saber se o pagamento foi processado, pois já faz vários dias desde que o enviou. O modelo de IA responde: “Sim, vejo que já se passaram dois dias desde que você enviou o pagamento. Normalmente, o processamento leva três dias, então ele deve ser concluído até amanhã de manhã. Você não pagará multa por atraso. Precisa de ajuda com mais alguma coisa?”
A documentação para desenvolvedores costuma chamar isso de detecção de turno ou detecção de fim de turno. Sistemas que combinam detecção de atividade de voz com compreensão de linguagem para avaliar se uma pessoa terminou de falar são frequentemente descritos como VAD semântico.
Essa forma fluida de manter o diálogo com um cliente elimina mensagens rígidas no estilo walkie-talkie e torna os agentes de voz mais naturais.
Também vale observar que essa camada de decisão da IA conversacional, composta por três pontos, é diferente da detecção bruta de atividade de voz (VAD). Enquanto a VAD classifica o áudio como fala ou silêncio, a alternância de turnos considera o contexto semântico, a intenção e a prosódia além do sinal bruto. Confira nosso guia sobre VAD para entender mais a fundo como funcionam os algoritmos de detecção de fala e por que você precisa deles.
Por que a alternância natural de turnos é essencial para agentes de voz
Uma má alternância de turnos é a maneira mais rápida de irritar um cliente, especialmente quem já tem resistência a falar com bots menos avançados. Agentes de IA conversacional desatualizados falam por cima de quem liga, fazem pausas longas e constrangedoras ou não acompanham a conversa.
O ElevenAgents usa tempo adaptativo para que seus agentes automatizados mantenham um ritmo natural de troca de falas. Esse timing preciso aumenta a confiança dos clientes na capacidade do modelo. Consequentemente, também aumenta a confiança na tecnologia que você implementou e no compromisso da sua marca com a satisfação do cliente.
Ao usar Eleven v4 Turbo com ElevenAgents, os agentes têm um tempo mediano de 142 ms entre a solicitação e a fala audível.
Além disso, uma alternância de turnos bem sincronizada mantém os clientes envolvidos pelo tempo necessário para resolver o problema na primeira tentativa, sem escalar para um agente humano.
Como funciona a alternância de turnos em tempo real
A alternância de turnos em tempo real usa um pipeline em várias camadas que analisa continuamente o áudio ao vivo. Os modelos também usam uma combinação de regras para determinar as melhores ações para manter conversas fluidas. O ElevenAgents executa isso em três etapas distintas para manter cada interação responsiva e natural.
Detectar fala, silêncio e intenção
A detecção de atividade de voz interpreta e classifica fluxos de áudio recebidos como fala ou silêncio dezenas de vezes por segundo. Depois que a VAD fornece o sinal bruto, a detecção de intenção determina se a pessoa realmente parou de falar ou apenas fez uma pausa para pensar. Entre os fatores que ela pode considerar para confirmar um turno concluído estão uma entonação descendente ou uma frase sintaticamente completa. Por outro lado, ela pode identificar uma pausa temporária por uma entonação suspensa ou pelo uso de palavras de preenchimento como “hum…” ou “tipo…”
Decidir quando responder
Como atrasos na resposta podem fazer quem liga abandonar a conversa, a decisão do modelo sobre quando responder é um dos fatores mais críticos para o sucesso. Arquiteturas de voz tradicionais costumam depender de temporizadores restritivos para determinar quando uma pessoa realmente parou de falar, mas isso pode interromper quem tenta voltar a falar ou simplesmente criar um silêncio desconfortável. A alternância de turnos moderna na IA conversacional usa deep learning para compreender totalmente sinais como prosódia, ritmo de fala e palavras de preenchimento.
Gerenciar a latência de resposta entre escutar e gerar fala
Segundo uma pesquisa linguística publicada no Journal of Cognition, os intervalos entre turnos de falantes humanos duram, em média, cerca de 200 ms em diferentes culturas. Por isso, modelos que levam muito mais tempo para responder criam pausas constrangedoras. Isso gera impaciência e aumenta as taxas de abandono de chamadas.
Como lidar com interrupções, sinais de acompanhamento e fala sobreposta
Os provedores e a forma como programam seus modelos de IA conversacional determinam o quão bem os agentes lidam com interrupções, sinais de acompanhamento e fala sobreposta.
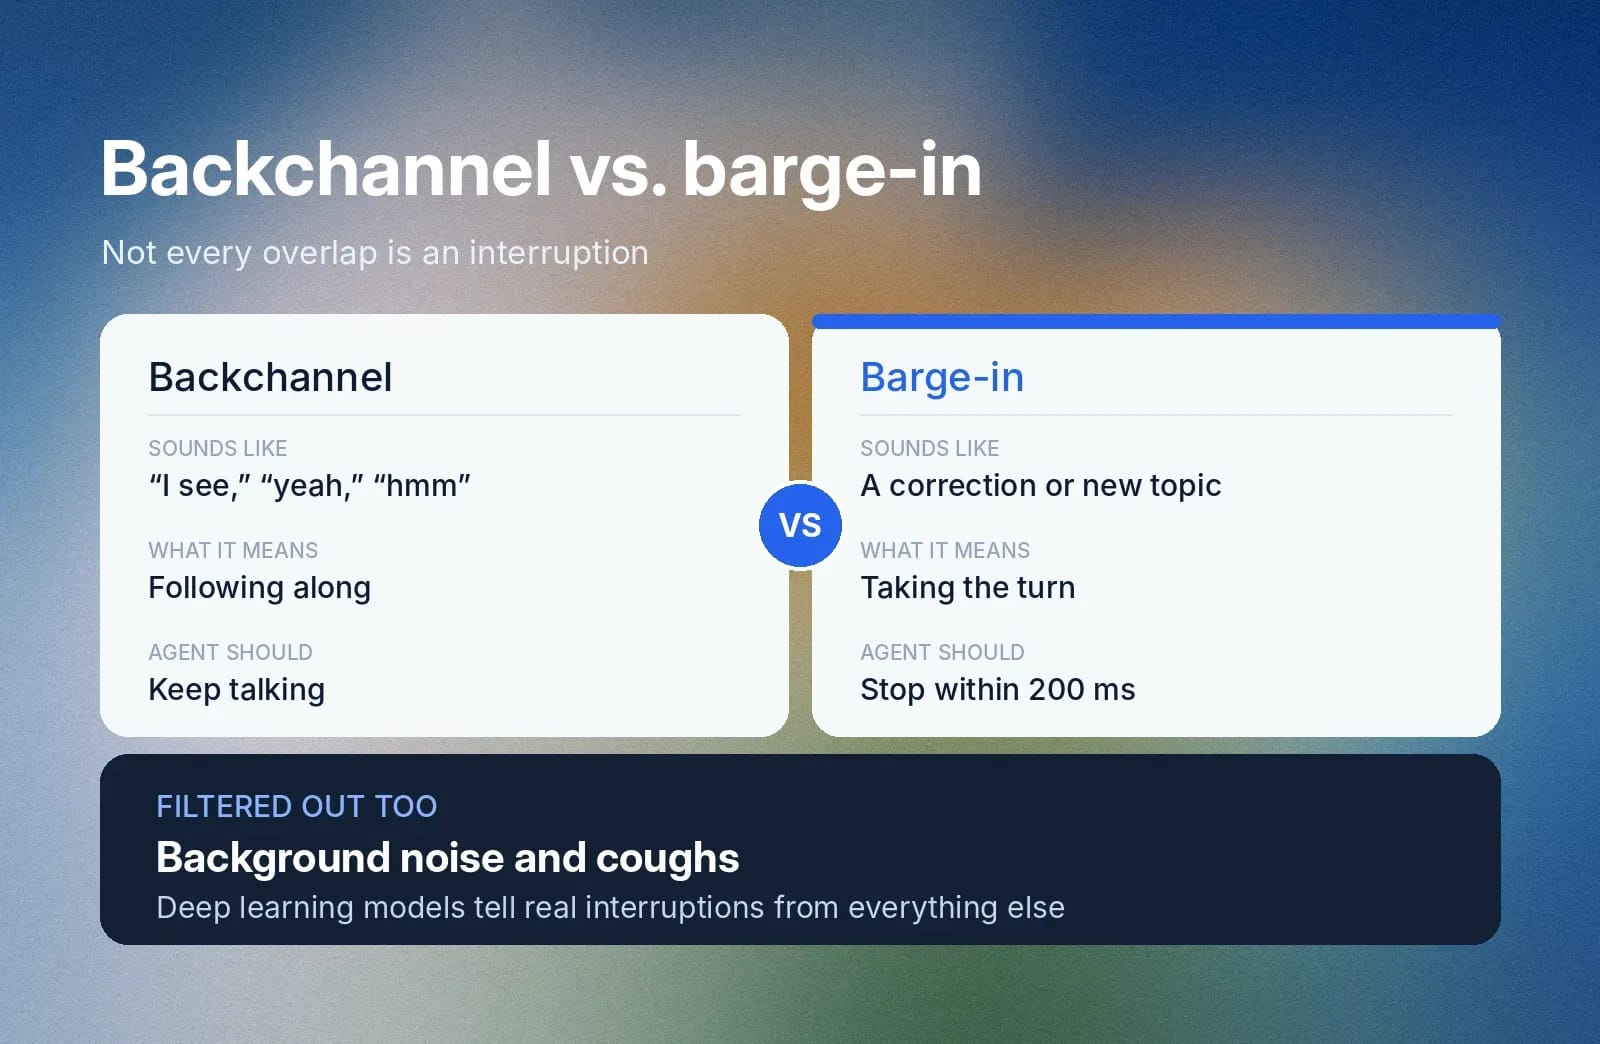
Sinais de acompanhamento ocorrem quando alguém que está ouvindo usa sons ou palavras breves de confirmação, como “entendi” ou “aham”, para mostrar que está acompanhando a conversa sem tomar a vez de fala. Um agente de voz precisa entender esses sinais para continuar falando, em vez de tratá-los como indícios de interrupção.
O ElevenAgents lida com sobreposições ao vivo cedendo a vez de fala imediatamente quando quem liga realmente interrompe. Quando alguém interrompe, por exemplo para corrigir um dado da conta ou mudar o assunto, o ElevenAgents envia um sinal de interrupção em menos de 200 ms. Isso faz o agente parar de falar no meio da frase, em vez de concluir a frase que havia planejado.
Nossos modelos de deep learning também filtram continuamente o ruído de fundo e diferenciam interrupções reais de palavras de preenchimento usadas para confirmar ou pensar. Por exemplo, um usuário que diz “entendi…” ou “hmmm…” enquanto um agente fala criou uma sobreposição de fala, mas não está tentando interromper.
Recursos como esses ajudam nossos agentes de voz a manter tempos de resposta precisos e um fluxo natural mesmo em momentos de interrupção com alta intenção.
Falhas comuns na alternância de turnos e como evitá-las
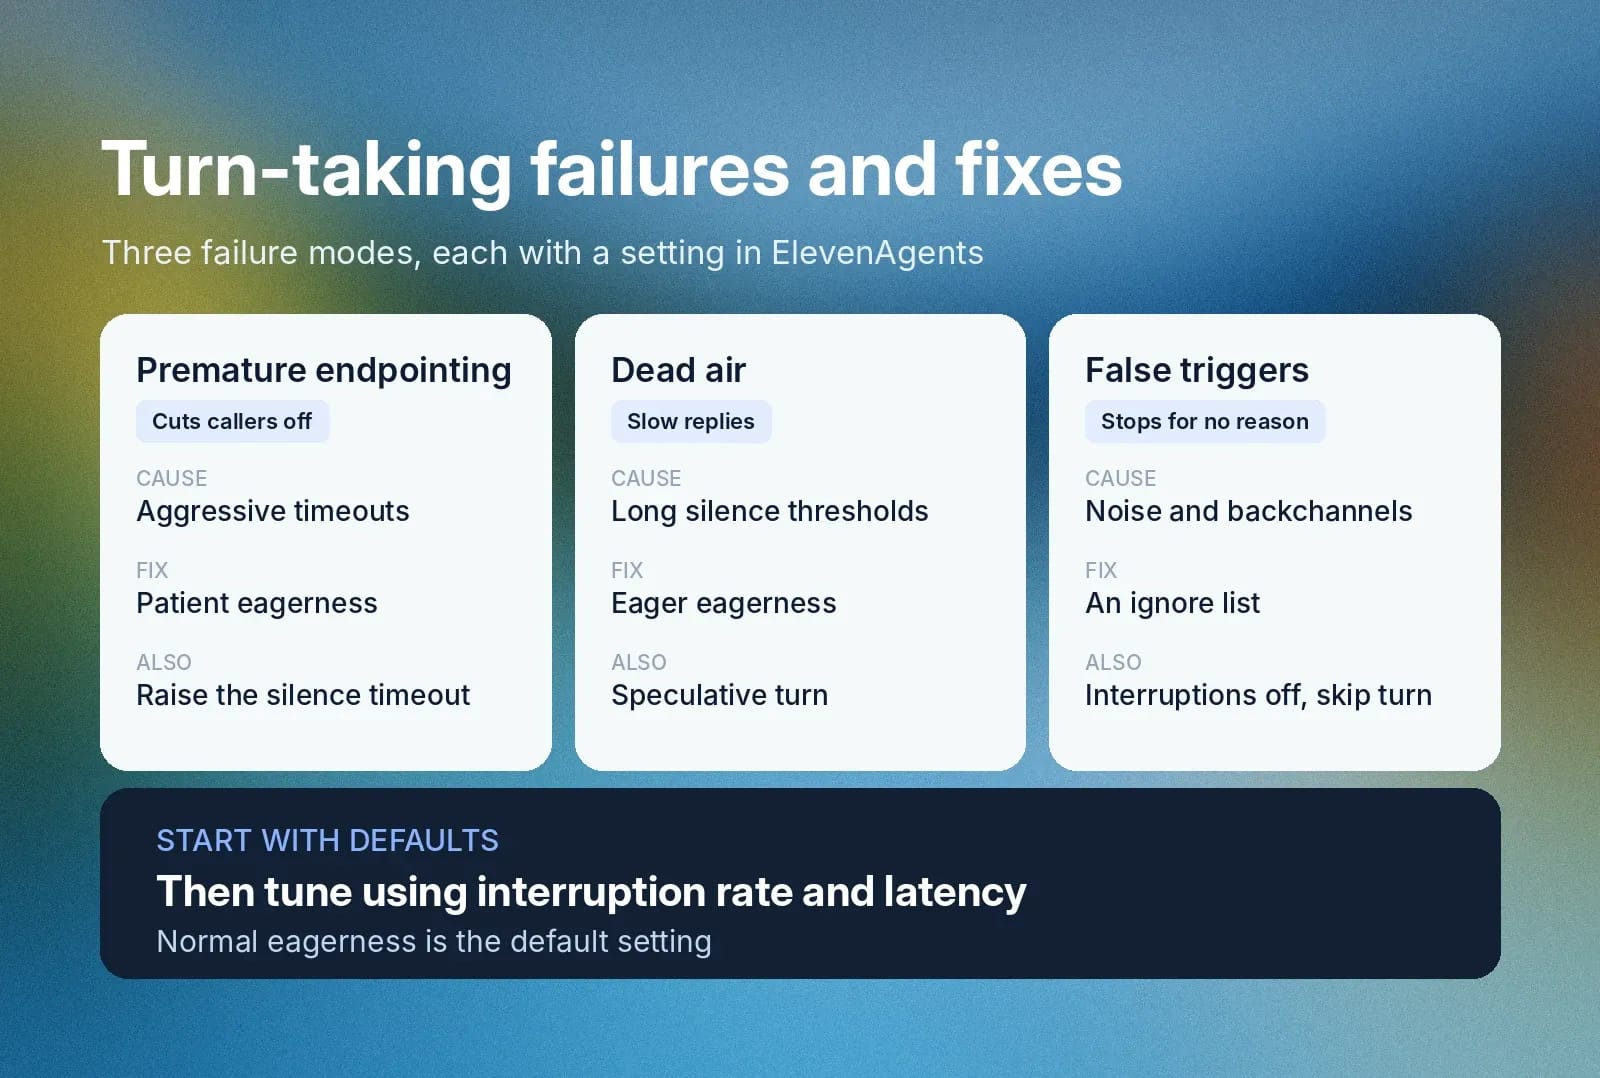
Os modelos de IA conversacional enfrentam três principais modos de falha que as equipes de engenharia precisam considerar ao configurar agentes de voz:
- Detecção prematura de fim de turno: Timeouts excessivamente agressivos podem fazer os modelos confundirem pausas no meio da frase, em que quem liga apenas queria pensar ou buscar uma informação, com turnos concluídos. Isso faz o agente de voz interromper frequentemente e frustrar os clientes.
- Silêncio e respostas atrasadas: Limites de silêncio excessivos geram pausas longas e constrangedoras que podem aumentar as taxas de abandono. Esses atrasos fazem os agentes de voz parecerem lentos e sem capacidade de resposta, afetando negativamente a experiência do cliente e a imagem da sua marca.
- Falsos acionamentos por palavras de preenchimento e ruído: Modelos mal ajustados também podem interpretar ruído ambiental, tosse e sinais de acompanhamento de quem escuta como interrupções reais. Isso faz o modelo pausar ou parar desnecessariamente quando o cliente está apenas ouvindo e não tentando interromper.
Os engenheiros podem evitar esses problemas ao implementar o ElevenAgents com modelos de linguagem contextuais. Essa abordagem adaptativa, combinada à VAD, elimina cortes indevidos, respostas lentas demais e a sensibilidade excessiva ao ruído de fundo.
Como configurar a alternância de turnos no ElevenAgents
As configurações ideais para a alternância de turnos dependem do caso de uso e das chamadas típicas que seu agente receberá. O ElevenAgents permite que as equipes ajustem cada um dos modos de falha acima nas configurações do agente.
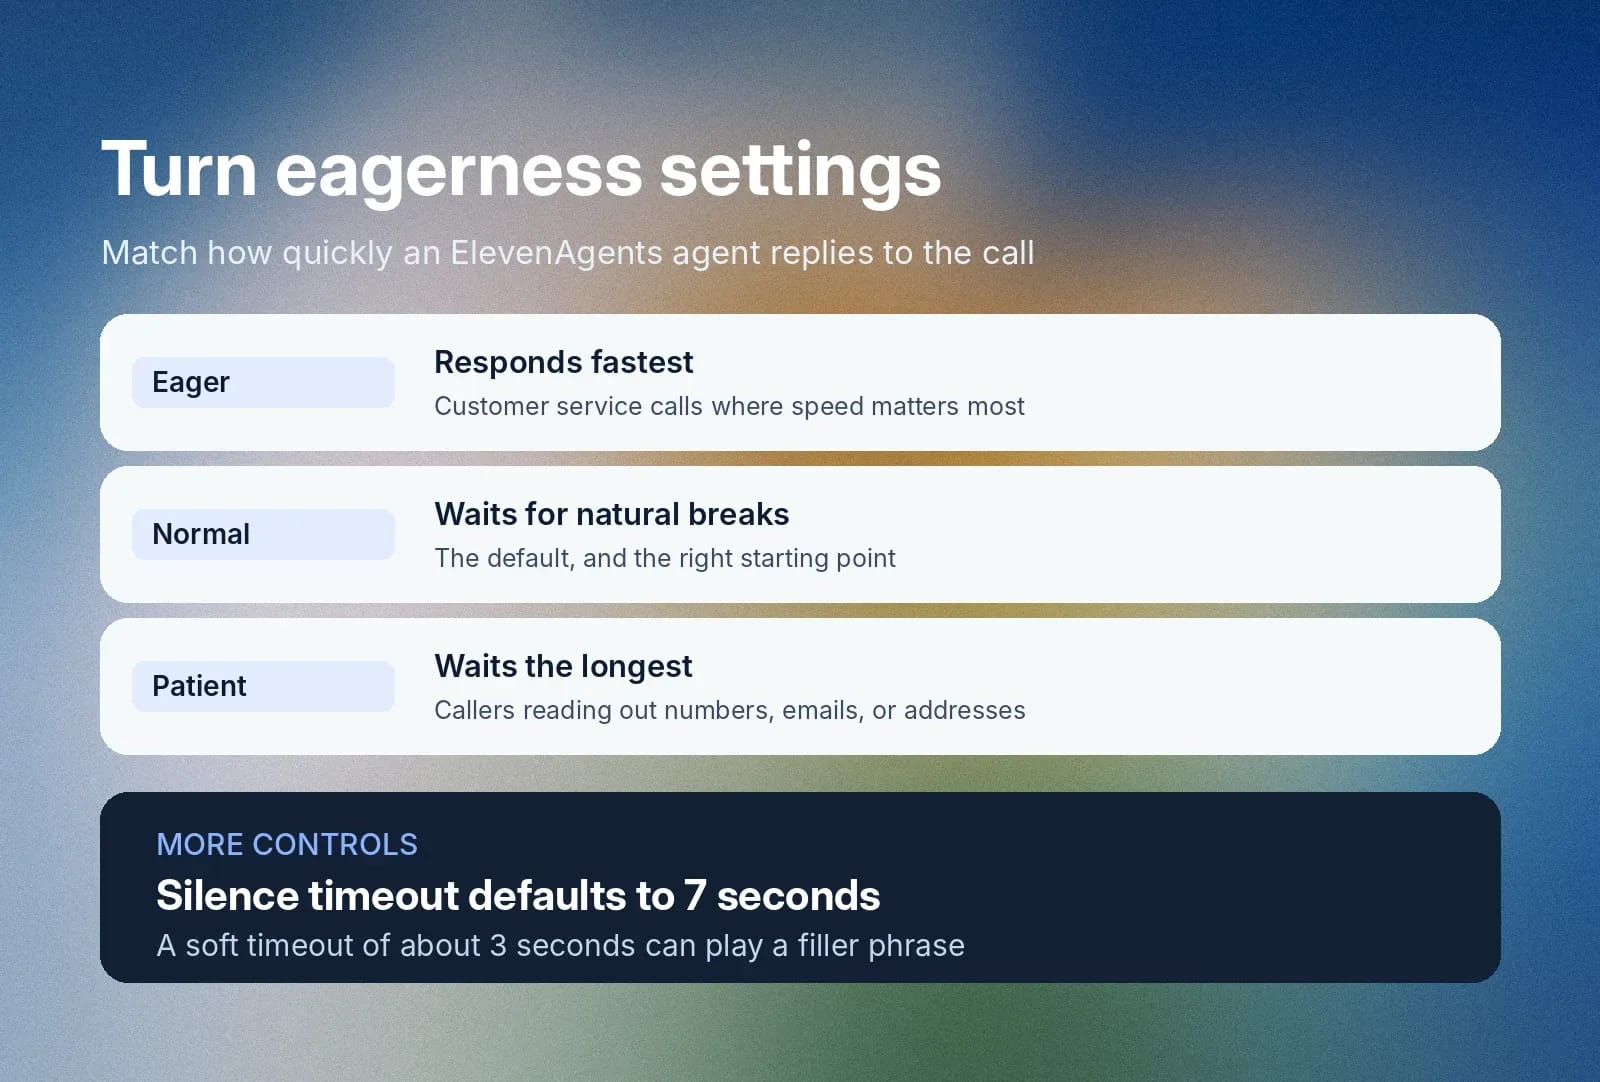
- Detecção prematura de fim de turno: Defina a disposição para assumir o turno como Patient quando quem liga estiver informando números de telefone, e-mails, endereços ou outros dados sensíveis. A disposição tem três níveis distintos. Eager responde mais rápido, Normal (padrão) espera por pausas naturais e Patient espera mais tempo. Você também pode ajustar o timeout de silêncio ao caso de uso, por exemplo, de 5 a 10 segundos para um atendimento responsivo ou de 15 a 30 segundos para avisos legais. Os intervalos padrão e recomendados variam conforme o canal e o cenário.
- Silêncio e respostas atrasadas: Use a disposição Eager em chamadas de atendimento ao cliente em que a velocidade é importante. O início especulativo de turno começa a resposta do modelo de linguagem antes de o agente ter certeza de que quem liga terminou, reduzindo a latência, mas podendo aumentar os custos de LLM. Um timeout flexível também pode reproduzir uma frase curta de preenchimento quando o modelo está lento; recomenda-se 3 segundos.
- Falsos acionamentos e interrupções indesejadas:Adicione palavras de confirmação, como “certo”, a uma lista de ignorados para que não interrompam o agente. Desative as interrupções quando cada palavra precisar ser ouvida, como na leitura de um aviso legal. O agente ainda pode transcrever o que quem liga diz e transmitir isso no próximo turno. Para frases como “me dê um minuto”, a ferramenta de pular turno mantém o agente em silêncio e pode verificar novamente após um tempo definido.
A maneira mais eficiente de usar essas configurações é combiná-las com Workflows, que permite ao agente mudar dinamicamente sua disposição para assumir o turno, por exemplo, de Normal durante uma conversa casual para Patient ao chegar a uma etapa que coleta um número de telefone. Comece com as configurações padrão e ajuste a disposição e os timeouts com base nas métricas de taxa de interrupção e latência de resposta abaixo.
Como medir a qualidade da alternância de turnos na IA conversacional
As equipes de garantia de qualidade precisam de métricas operacionais concretas para avaliar a alternância de turnos na IA conversacional. Isso exige mudar o foco da tecnologia e das configurações para o impacto real. Em outras palavras, elas precisam medir mais do que apenas o que “parece natural” e o que não parece.
A taxa de interrupção e a latência de resposta são as duas principais métricas a considerar. A taxa de interrupção mede a frequência com que o modelo corta a fala de quem liga incorretamente, enquanto a latência de resposta acompanha quanto tempo o modelo leva para responder quando uma pessoa para de falar e espera uma resposta. O ElevenAgents registra as duas métricas em todas as chamadas para que as equipes possam usar os dados para otimizar os limites da detecção de atividade de voz sem depender de revisões manuais de transcrições. Explore nosso guia sobre como medir a IA conversacional para ver uma análise completa dos frameworks de avaliação.
As equipes de QA mantêm altas taxas de precisão ao criar uma cadência estruturada para avaliar o modelo. Veja um exemplo de cronograma usado por uma equipe típica.
Atividade de avaliação
Frequência
Objetivo de QA
Monitoramento operacional
Semanal
Acompanha o desempenho em tempo real e identifica problemas de timing nos agentes de voz em operação
Análises de satisfação do usuário
Mensal
Analisa o sentimento de quem liga para ajustar as configurações de alternância de turnos
Benchmarks completos do sistema
Trimestral
Avalia a precisão de ponta a ponta, a alternância de turnos e os limites de latência de resposta
Por fim, embora as métricas automatizadas estejam disponíveis, as equipes de QA ainda devem separar alguns dados para revisões manuais. Elas podem obter dados mais precisos ao inspecionar arquivos de áudio brutos, em vez de apenas transcrições de texto. Isso porque as transcrições de texto adicionam outra camada de automação e podem não capturar erros da ferramenta de transcrição, especialmente onde há sobreposição de fala.

Comece a usar o ElevenAgents para conversas naturais por voz
Agentes de voz semelhantes aos humanos, que resolvem problemas rapidamente, reduzem custos e aumentam a eficiência operacional. Mas, para obter esses benefícios, é preciso usar modelos avançados de IA que você possa ajustar para lidar corretamente com a alternância de turnos. As equipes de engenharia conseguem isso implementando o ElevenAgents. Nossa arquitetura unificada combina detecção de atividade de voz e compreensão semântica para manter um fluxo natural de conversa e reduzir a latência.
Explore nossa documentação sobre detecção de turno no ElevenAgents para configurar uma alternância natural de turnos na sua equipe de atendimento ao cliente ou crie sua conta para começar.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.