Infraestructura de voz IA: explicación del stack de 2026
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
La infraestructura de voz IA es el conjunto de modelos, conexiones, herramientas y servicios que permite a un agente de IA escuchar una llamada, decidir qué hacer, actuar en otros sistemas y responder en voz alta. Además, con proveedores líderes como ElevenLabs, todo ocurre en una fracción de segundo.
Un agente de voz en producción funciona sobre un stack de capas que incluye reconocimiento de voz, gestión de turnos, un modelo de lenguaje de gran tamaño, orquestación, herramientas, recuperación de conocimiento, síntesis de voz, telefonía y monitorización.
Esta guía explica la arquitectura de agentes de IA que hay detrás de un agente de voz operativo. Cada sección explica qué hace una capa, por qué importa dentro de la infraestructura general y cómo la implementa ElevenAgents, con Eleven v4 como ejemplo de capa de voz.
Cómo se integra la infraestructura de voz IA
Un agente de voz convierte el audio en texto, razona a partir de esa entrada, genera una respuesta y después la transforma de nuevo en el audio que escucha el cliente. Esta cascada de acciones se compone de un sólido stack de arquitectura de agentes de IA.
Estas son las principales capas que contribuyen a la infraestructura de voz IA en 2026:
- Reconocimiento de voz: La tecnología de reconocimiento automático de voz (ASR) convierte el audio de quien llama en texto para procesarlo.
- Gestión de turnos: La gestión de turnos determina cuándo ha terminado quien llama y cuándo debe dejar de hablar el agente, lo que permite una conversación más fluida y ágil.
- Modelo(s) de lenguaje: Interpreta la petición transcrita y genera una respuesta tras recuperar el contexto necesario.
- Orquestación: Una capa de orquestación de IA dirige la conversación entre prompts, subagentes, herramientas y personas.
- Herramientas y MCP: Conectan el agente con sistemas externos, como plataformas de CRM o centros de contacto, para realizar tareas.
- Conocimiento y memoria: Aportan datos y contexto sobre quien llama mediante generación aumentada por recuperación.
- Síntesis de voz: Usa Texto a Voz para transformar la respuesta generada en texto en audio.
- Transporte y telefonía: Transportan el audio entre el agente y quien llama.
- Guardrails, pruebas y monitorización: Mantienen al agente centrado en su tarea y permiten medirlo.
En conjunto, estos componentes crean conversaciones en tiempo real entre agentes de IA y clientes que llaman.
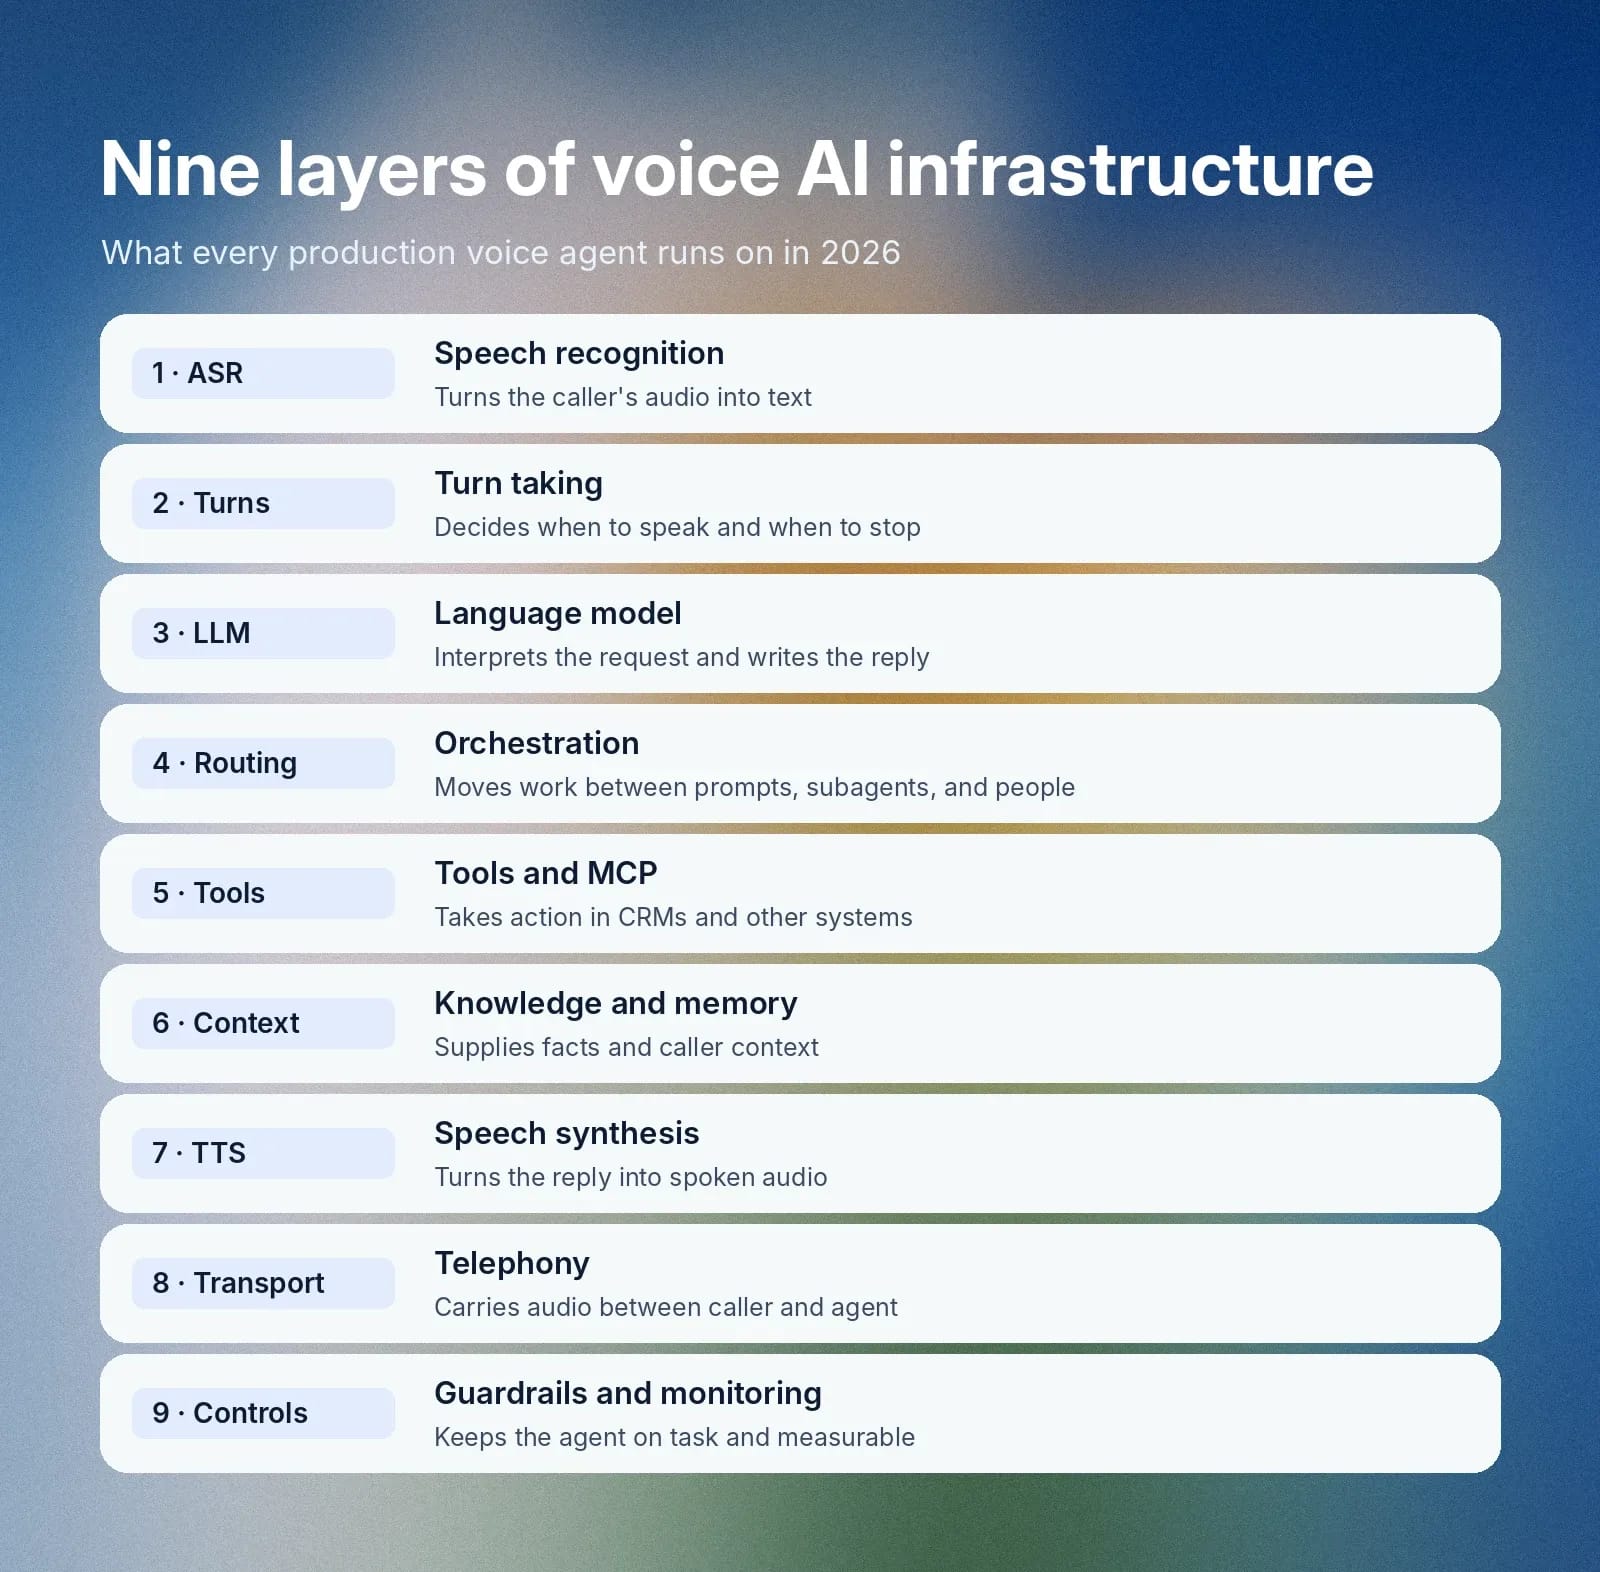
Diagrama de arquitectura de voz IA
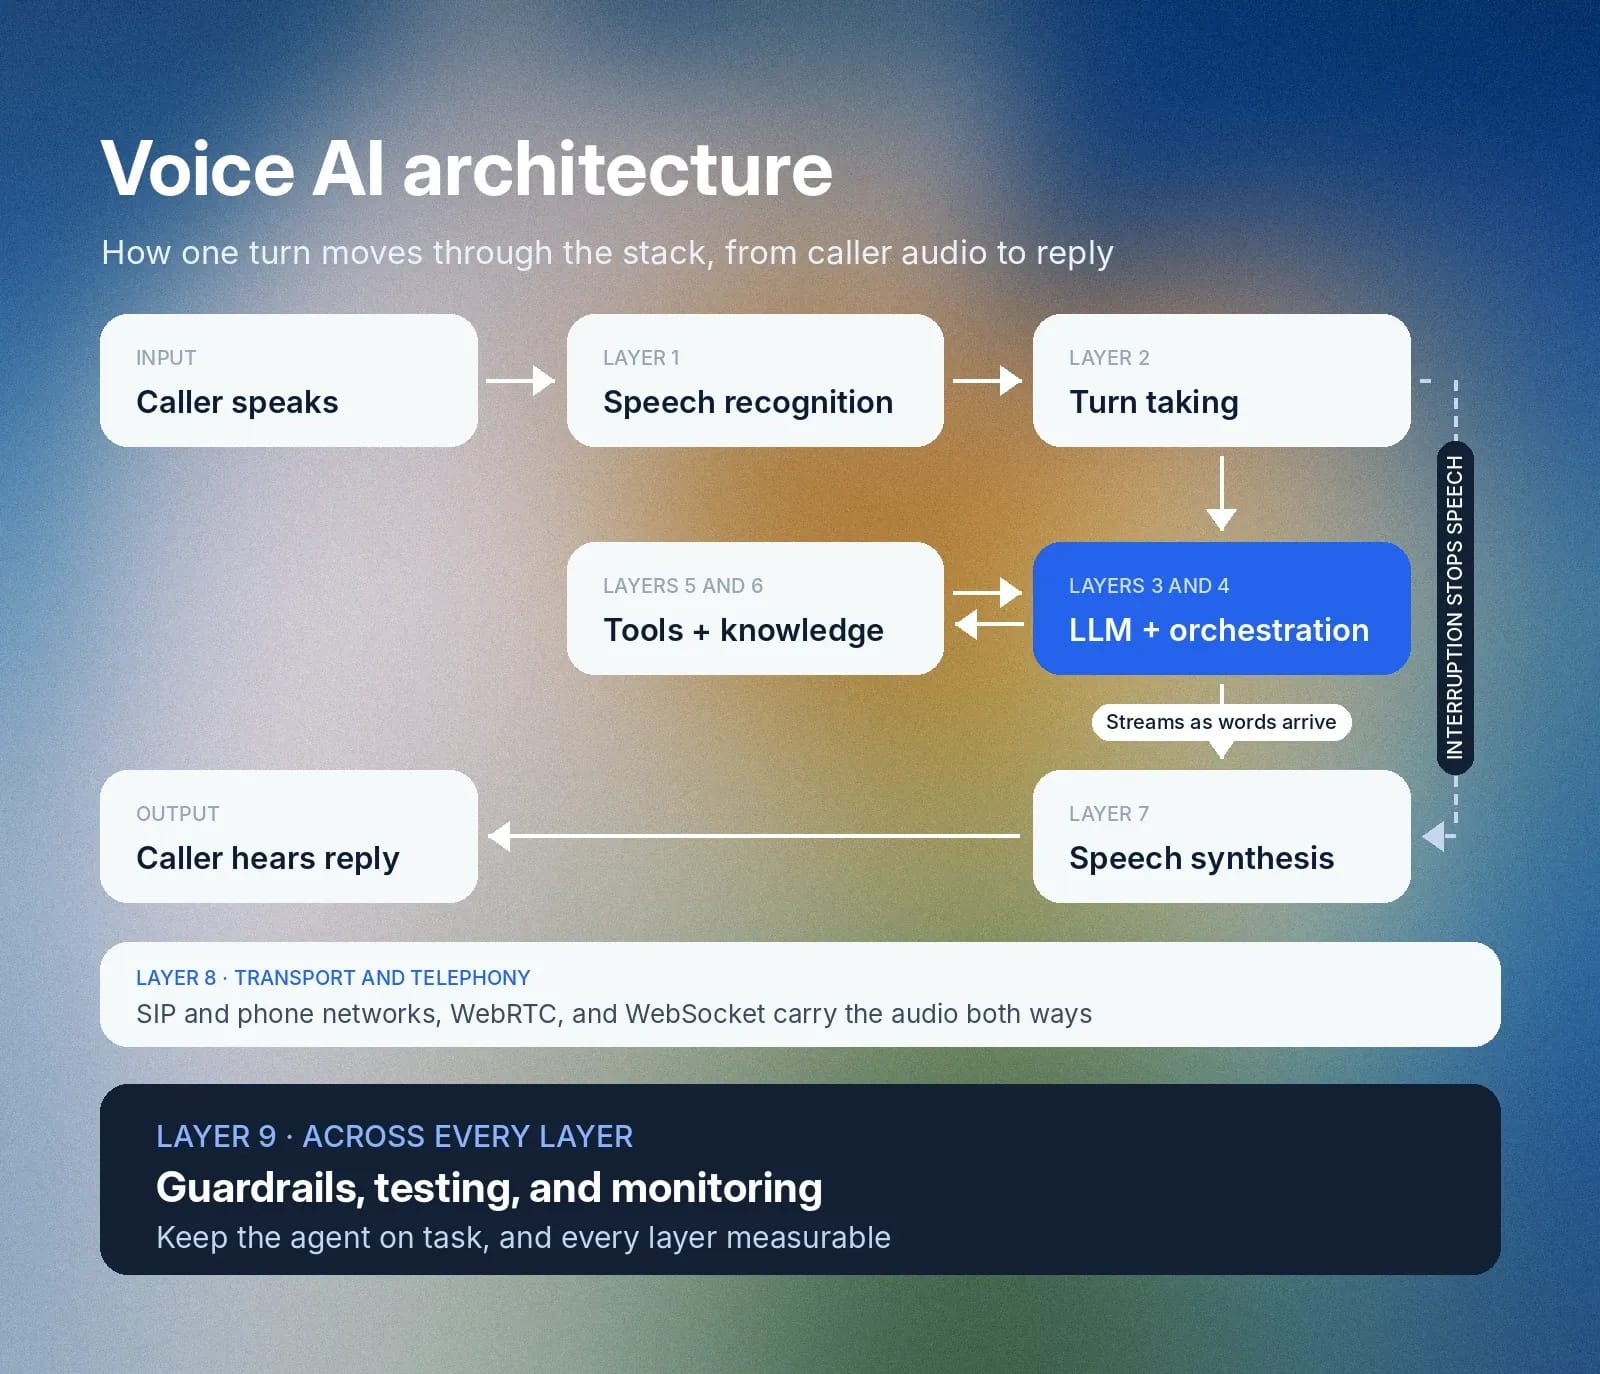
El flujo no es una línea recta. ElevenAgents empieza a hablar después de recibir «suficientes palabras y una coma» del modelo de lenguaje, por lo que el audio empieza a reproducirse antes de que exista la respuesta completa. Las llamadas a herramientas y la recuperación se ejecutan a mitad de un turno. Las interrupciones pueden llegar y el agente las gestiona de forma natural mientras genera voz.
Dos formas de crear una arquitectura de voz IA
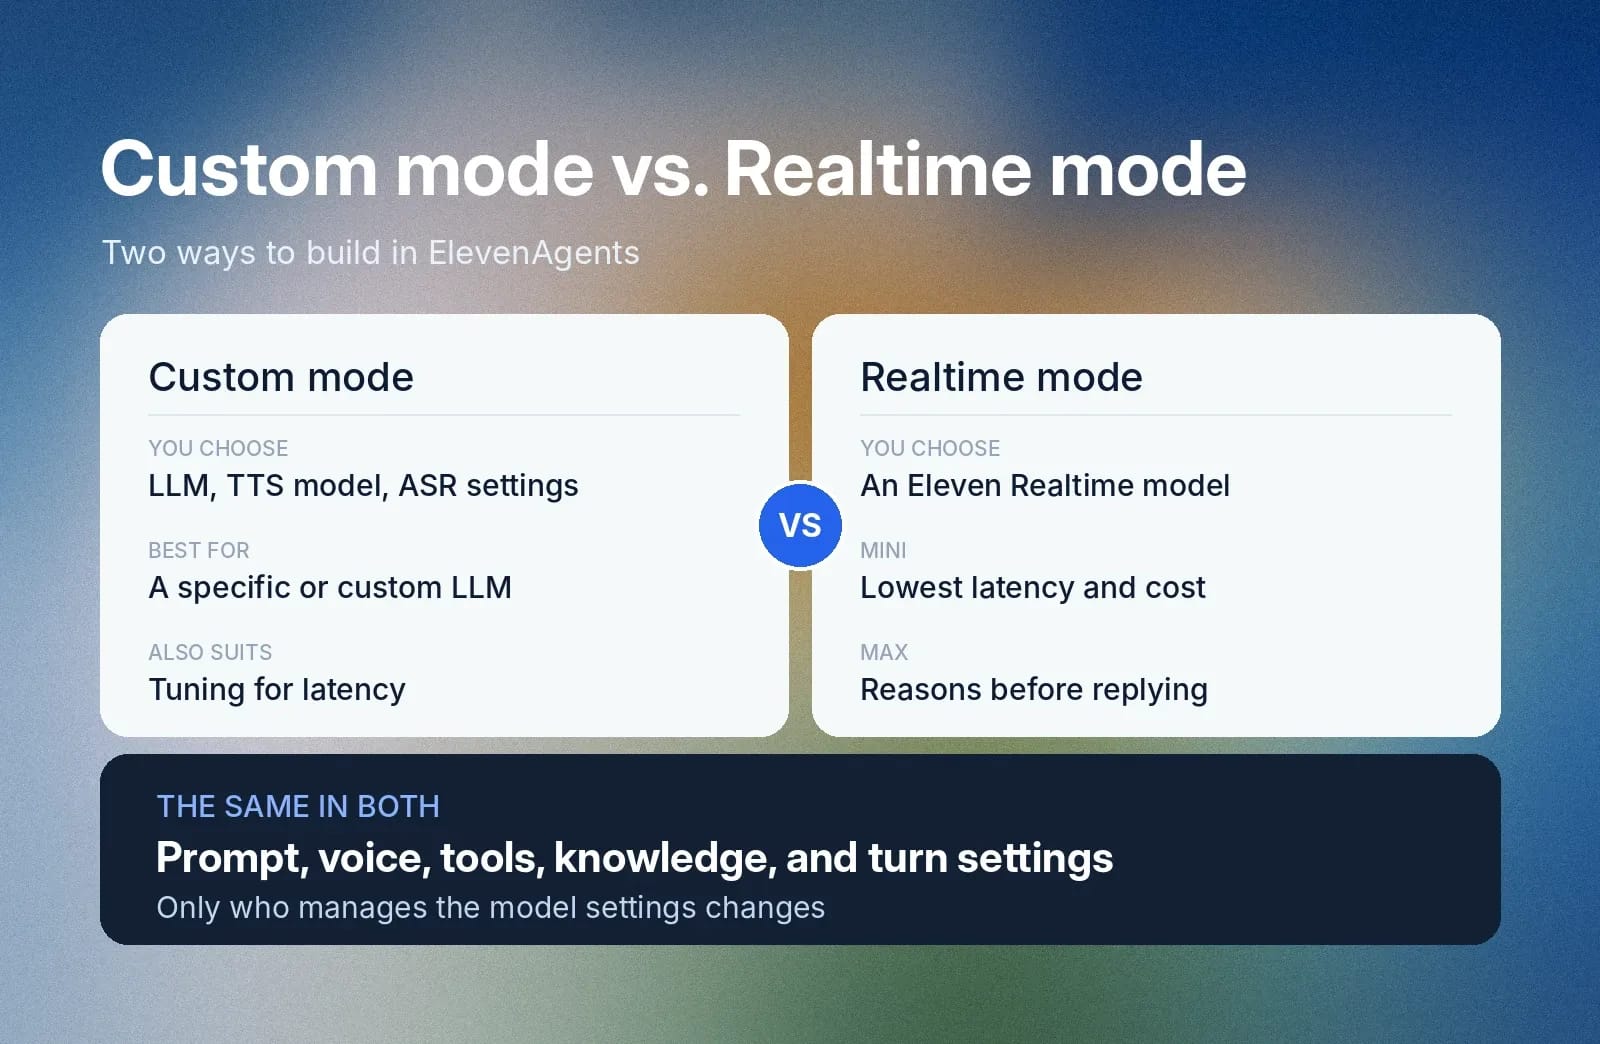
ElevenAgents admite dos modos de voz. En el modo Custom, eliges tú el modelo de lenguaje, el modelo de Texto a Voz y los ajustes de reconocimiento de voz.
En el modo Realtime, seleccionas un modelo Eleven Realtime y ElevenLabs gestiona esos ajustes por ti. Eleven Realtime v1 Mini es el predeterminado y ofrece la menor latencia y coste. Eleven Realtime v1 Max razona antes de responder, por lo que resulta adecuado para instrucciones más complejas y casos que requieren usar herramientas en varios pasos.
El prompt de sistema, la voz elegida, las herramientas, la base de conocimiento adjunta y los ajustes de turnos funcionan igual en ambos modos. El modo Custom es la mejor opción cuando necesitas un modelo de lenguaje específico, un LLM personalizado o un modelo TTS concreto (por rendimiento u optimización de latencia).
Reconocimiento de voz: convertir audio en texto
El reconocimiento de voz, también llamado ASR o voz a texto, es la primera capa del stack.
Qué hace
El modelo transcribe continuamente el audio de quien llama mientras habla. Hacerlo de forma continua permite que el resto del proceso empiece a funcionar antes de que termine la frase, reduciendo la latencia. Los modelos avanzados gestionan desde acentos marcados y distintas velocidades al hablar hasta ruido de fondo.
Por qué importa para la infraestructura de voz IA
La transcripción es posiblemente una de las capas más importantes del stack, porque cualquier error aquí se propagará al resto de etapas. ¿Entender mal una referencia de reserva? Se actúa sobre el registro de cliente equivocado. ¿Confundir el nombre de un medicamento? Un posible desastre.
En su Marco de confianza para la atención sanitaria, ElevenLabs muestra lo mucho que está en juego con una sola sílaba mal entendida: hidroxizina frente a hidralazina.
Cómo lo hace ElevenAgents
ElevenAgents usa Scribe v2 Realtime, que transcribe voz en aproximadamente 150 ms. ElevenLabs lo entrenó para entornos ruidosos, acentos diversos e identificadores como nombres, correos electrónicos e ID. En el benchmark multilingüe FLEURS de 30 idiomas, ElevenLabs registró la menor tasa de error de palabras de cualquier modelo ASR de baja latencia.
Puedes activarlo en la sección Avanzado de la configuración del agente. En el mismo informe técnico mencionado antes, ElevenLabs señala que Scribe v2 Medical supera a todos los modelos del benchmark público Eka Medical ASR, con una tasa de error de palabras del 7,0 % en el momento de publicación.
Una transcripción precisa y rápida proporciona a las capas siguientes la entrada limpia que necesitan sin añadir una latencia significativa.
Gestión de turnos: saber cuándo hablar y cuándo parar
La gestión de turnos es el conjunto de reglas que determina cuándo responde el agente y cuándo escucha. Comprender eficazmente los turnos de una conversación y actuar en consecuencia es lo que diferencia una conversación de un menú telefónico IVR tradicional.
Qué hace
Un componente de gestión de turnos aporta varias funciones a la infraestructura de voz IA:
- Detección de actividad de voz (VAD): VAD clasifica el audio entrante como voz o silencio decenas de veces por segundo.
- Detección de fin de turno: Determina si quien llama ha terminado mediante el tono, el ritmo y el contexto de las palabras.
- Interrupción: Permite que quien llama interrumpa; entonces el agente deja de hablar para que el usuario pueda continuar.
- Señales de escucha: Confirmaciones breves como «sí» que no toman el turno.
Por qué importa
Un intervalo de aproximadamente 200 ms es el intervalo típico entre interlocutores en una conversación humana. Un agente que responde demasiado pronto interrumpe a quien llama, mientras que uno que espera demasiado genera silencios que hacen que la llamada parezca fallida o poco ágil.
Por ejemplo, imagina que quien llama dice: «Quiero reservar para el viernes por la tarde, pero...» y hace una pausa. Un temporizador de silencio responde durante la pausa y se pierde la aclaración. Un modelo que interpreta las palabras y el ritmo espera, permitiendo que el usuario termine: «No puede ser entre las 15:00 y las 17:00, porque estaré ocupado».
Un agente interpreta mal la intención de quien llama y programa la reunión a una hora incorrecta. El otro, con una gestión de turnos eficaz, se asegura de evitar el intervalo indicado.
Cómo lo hace ElevenAgents
ElevenAgents ejecuta un modelo propio de gestión de turnos que analiza el tono, el ritmo y el contexto de las palabras en lugar de depender solo de temporizadores de silencio. Cuando quien llama interrumpe, la señal que detiene al agente llega en menos de 200 ms.
ElevenLabs registra una mediana de ~150 ms desde la solicitud hasta que se oye voz con Eleven v4 Turbo en ElevenAgents.
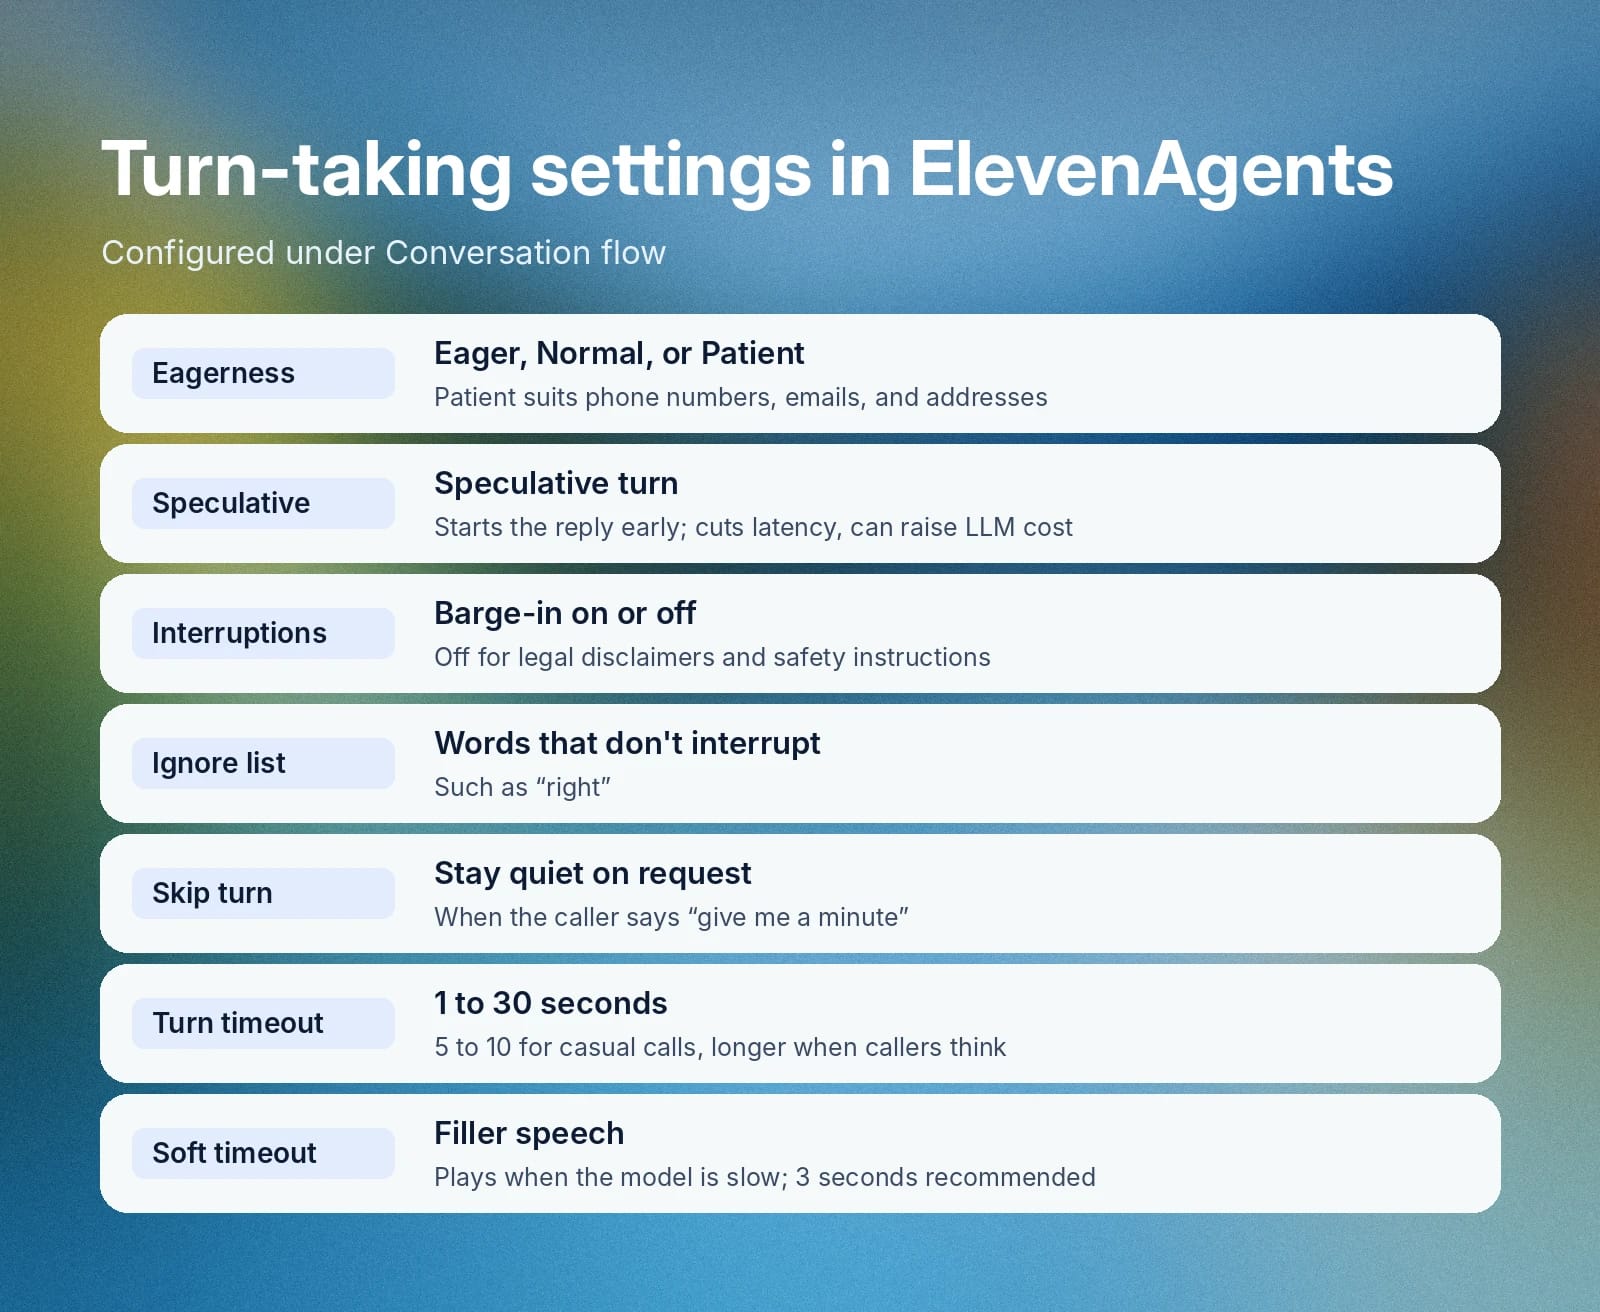
El comportamiento se puede configurar mediante Flujo de conversación:
Ajuste
Qué controla
Anticipación del turno
Anticipado responde en cuanto tiene oportunidad. Normal es el ajuste predeterminado y equilibrado. Paciente espera más y es adecuado para números de teléfono, direcciones y correos electrónicos.
Turno especulativo
Inicia la respuesta del modelo de lenguaje antes de confirmar que quien llama ha terminado. Reduce la latencia, pero puede aumentar el coste del LLM.
Interrupciones
Desactívalas cuando sea necesario escuchar cada palabra, como en avisos legales e instrucciones de seguridad.
Lista de exclusión
Palabras como «vale» que no deberían interrumpir al agente.
Herramienta para omitir turno
Mantiene al agente en silencio cuando quien llama dice «dame un minuto».
Tiempo de espera de turno
Toma el turno tras entre 1 y 30 segundos de silencio. Usa de 5 a 10 segundos para conversaciones informales y de 10 a 30 cuando quien llama necesite tiempo para pensar.
Tiempo de espera suave
Reproduce frases de relleno como «Mmm... sí» cuando el modelo va lento. El rango es de 0,5 a 8 segundos; se recomiendan 3 segundos.
Detección de entorno ruidoso
Un ajuste Enterprise que detecta voces de fondo y pide a quien llama que se mueva a un lugar más silencioso, como máximo una vez por conversación.
Los workflows pueden cambiar la anticipación del turno durante la llamada. Tu cliente también recibe un evento vad_score, una probabilidad de 0 a 1 de que el usuario esté hablando.
Una gestión de turnos bien ajustada determina si quien llama percibe al agente como atento o brusco. Para saber más sobre estos conceptos, consulta nuestra guía completa sobre gestión de turnos.
El modelo de lenguaje: razonar y generar la respuesta
El modelo de lenguaje de gran tamaño (LLM) es la capa de razonamiento. Lee la transcripción, las instrucciones y la conversación hasta el momento, y después redacta la respuesta o decide llamar a una herramienta.
Qué hace
Un bot de voz basado en guiones reconoce un número limitado de comandos. Un LLM interpreta peticiones formuladas de muchas formas distintas, mantiene el contexto entre turnos y decide cuándo recuperar información o transferir la conversación.
Por qué importa
Los modelos difieren en profundidad de razonamiento, velocidad y coste. En una conversación de voz en directo, el tiempo de respuesta importa tanto como la calidad de la respuesta; por eso, la elección del modelo es una decisión de latencia y de coste.
Cómo lo hace ElevenAgents
ElevenAgents te ofrece una interfaz para modelos de Google, OpenAI y Anthropic, además de modelos abiertos alojados por ElevenLabs. También puedes conectar tu propio LLM especificando una ruta de API y guardando las credenciales como secretos. ElevenLabs repercute los costes de LLM de terceros a la tarifa publicada por el proveedor, sin margen.
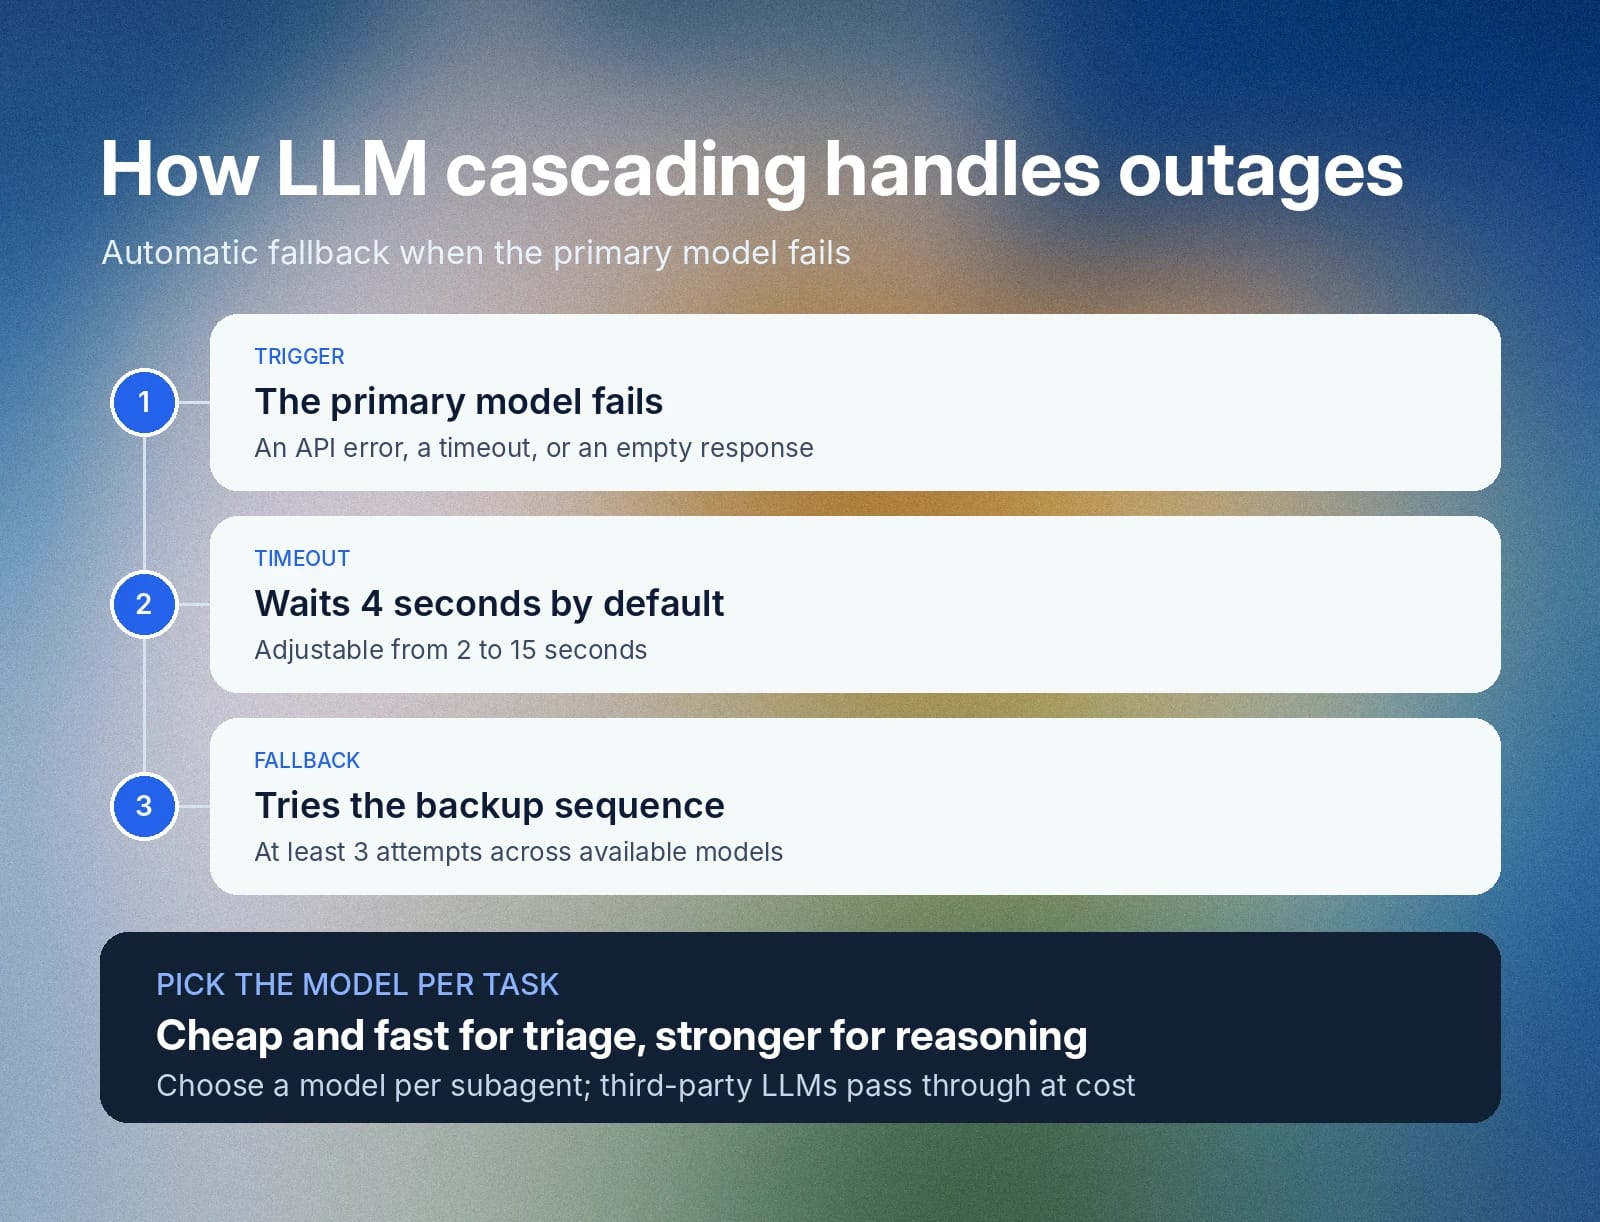
Puedes elegir el modelo para cada subagente. El manual para agentes conversacionales empresariales, volumen 2, recomienda reservar los modelos de mayor rendimiento para el razonamiento complejo y usar modelos más económicos y de baja latencia para tareas como la clasificación de intención y las preguntas frecuentes.
Los proveedores tienen interrupciones de servicio. La cascada de LLM las gestiona: si el modelo principal devuelve un error de API, agota el tiempo de espera o envía una respuesta vacía, ElevenAgents prueba una secuencia de respaldo. El tiempo de espera predeterminado entre el principal y el respaldo es de 4 segundos, ajustable de 2 a 15 segundos, y el sistema realiza al menos 3 intentos con los modelos disponibles.
Un LLM personalizado usado como modelo principal se reintenta a sí mismo al menos 3 veces, salvo que definas tu propio orden de respaldo. El modelo adecuado para cada tarea mantiene al agente rápido y asequible.
Orquestación: dirigir el trabajo entre agentes y personas
La orquestación de agentes coordina los prompts, subagentes, herramientas y personas implicados en completar una tarea. Decide qué sucede después en cada momento de la llamada.
Qué hace
Un único agente con un prompt largo se vuelve difícil de gestionar a medida que se acumulan responsabilidades. La orquestación divide el trabajo en etapas, cada una con sus propias instrucciones, modelo y herramientas, y desplaza a quien llama entre ellas.
Por qué importa
Los prompts más pequeños son más fáciles de probar y más económicos de ejecutar porque cada interacción carga menos texto. Dividir un flujo permite que un modelo económico gestione el triaje y las preguntas frecuentes, y transfiera a un modelo más potente solo cuando una solicitud lo requiera.
Cómo lo hace ElevenAgents
Los workflows de ElevenAgents son un editor visual para gráficos de conversación ramificados.
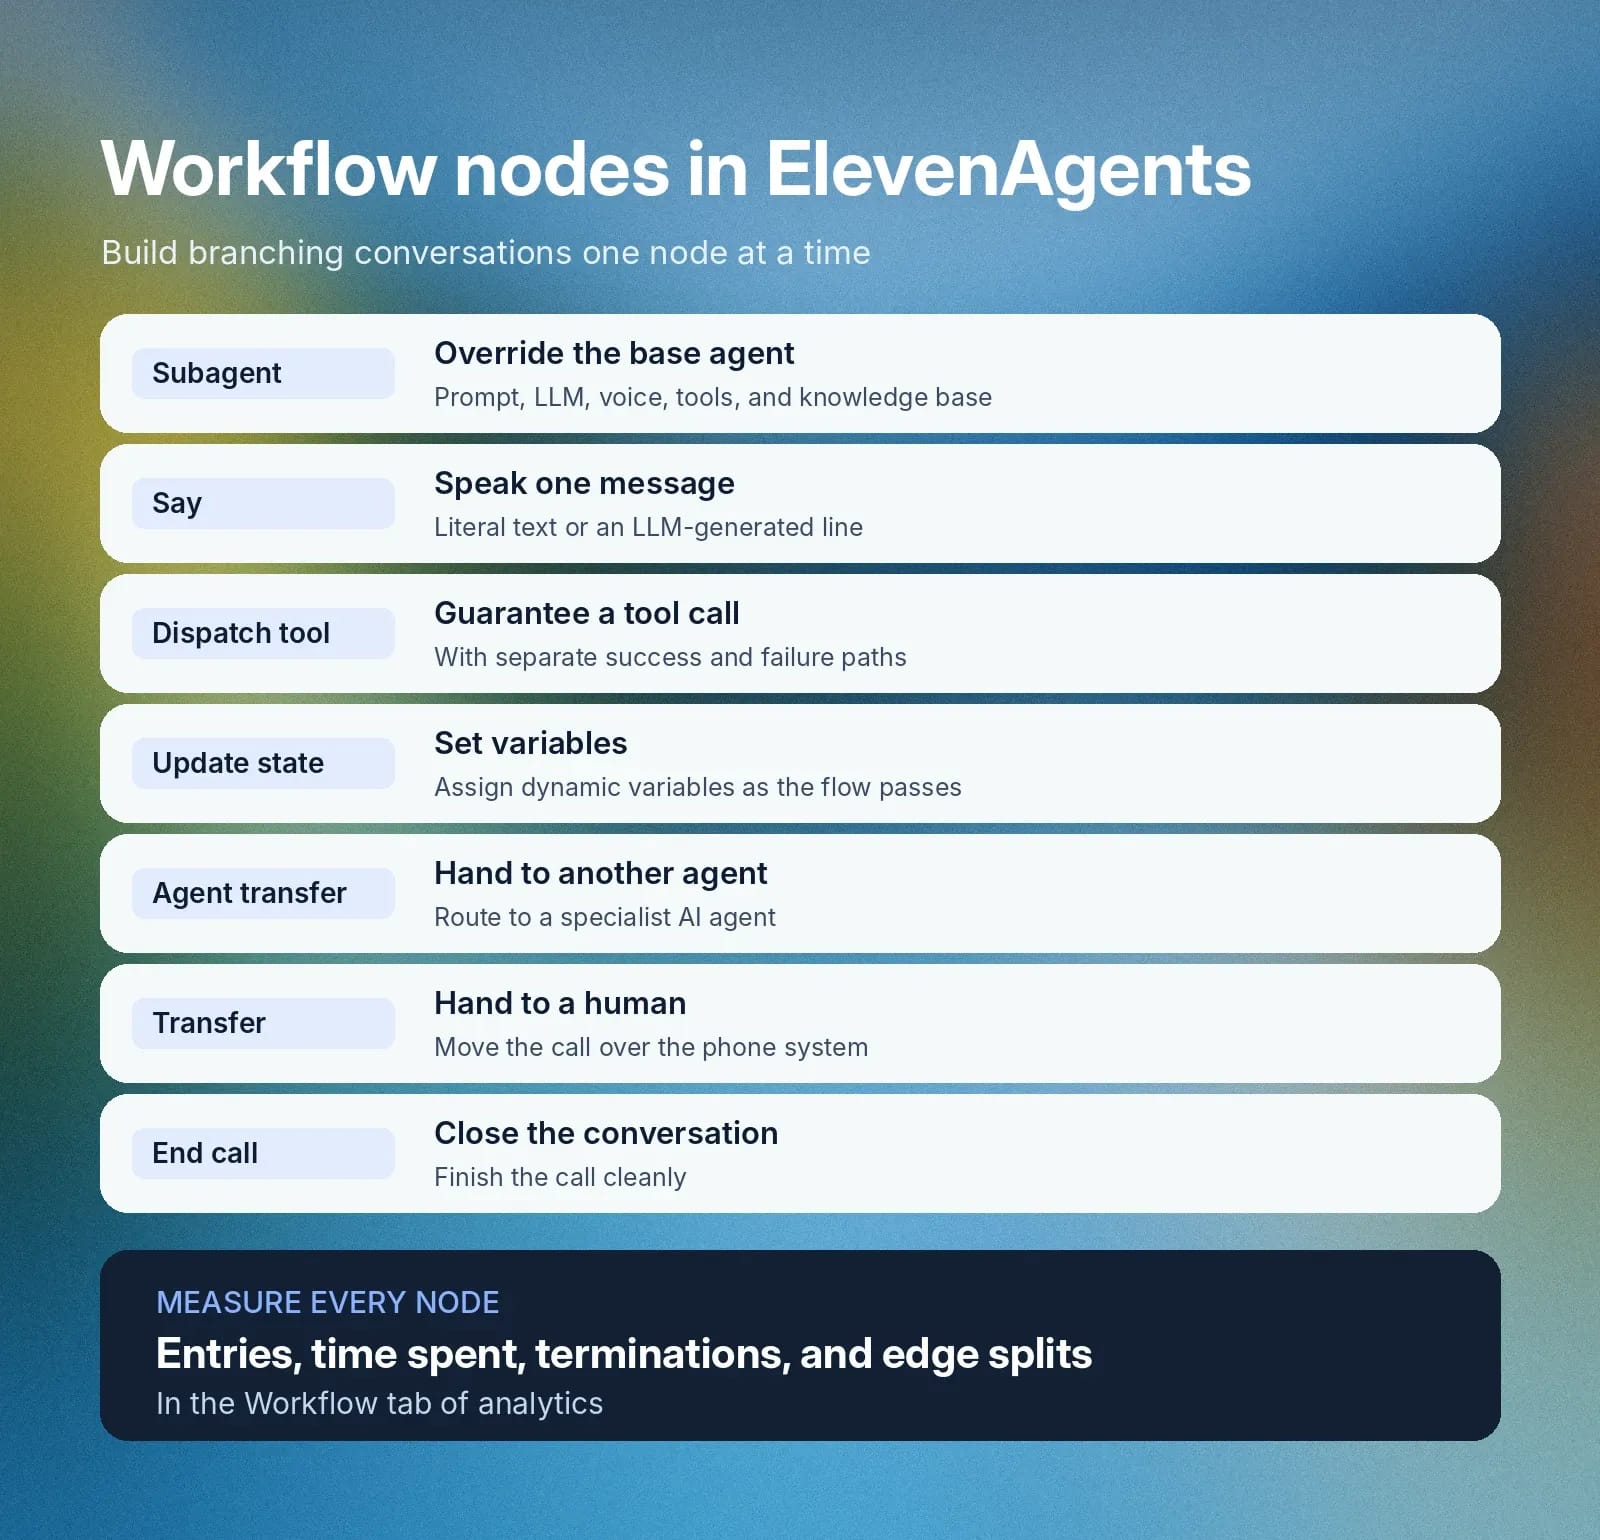
Los nodos son:
- Subagente: Modifica o anula el agente base, incluido su prompt, LLM, voz, herramientas y base de conocimiento.
- Decir: Pronuncia un mensaje, ya sea texto literal o una frase generada por un LLM.
- Herramienta de envío: Un paso dedicado que garantiza una llamada a herramienta, con rutas independientes de éxito y error.
- Actualizar estado: Asigna variables dinámicas a medida que avanza el flujo.
- Transferencia de agente: Pasa la llamada a otro agente.
- Transferir a número: Pasa la llamada del agente de IA a una persona a través del sistema telefónico.
- Finalizar llamada: Cierra la conversación.
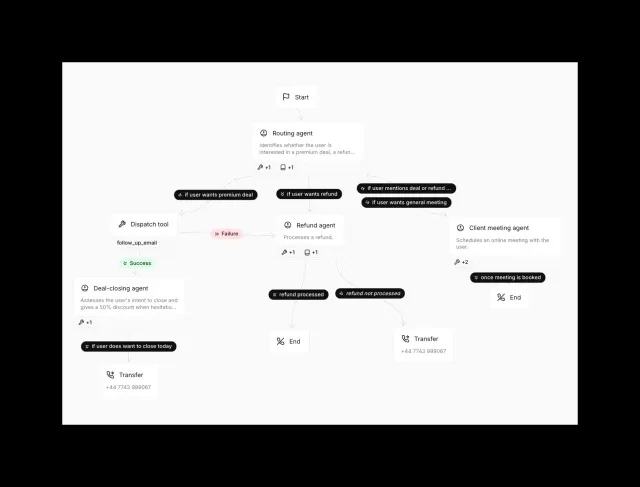
Las conexiones entre nodos contienen condiciones en lenguaje natural que el LLM evalúa en tiempo real. Un flujo de soporte puede empezar con un subagente de enrutamiento con un modelo rápido, enviar preguntas de facturación a un subagente de facturación con un modelo más potente y terminar con un nodo de transferencia a número cuando quien llama pide hablar con una persona. Tras el lanzamiento, la pestaña Workflow de analíticas muestra entradas, tiempo medio empleado, finalizaciones y distribución de conexiones de cada nodo.
La orquestación convierte un único agente en un sistema que puedes diseñar, medir y mejorar nodo a nodo.
Herramientas y MCP: permitir que el agente actúe
La llamada a funciones, también llamada llamada a herramientas, permite a un agente solicitar acciones a software externo que has conectado a tu stack tecnológico.
Convierte una interfaz de preguntas y respuestas en un sistema de IA agéntica capaz de completar trabajo e interactuar con otras herramientas en tu nombre.
Qué hace
Imagina que quien llama pide cambiar su cita de mañana al viernes. El agente recupera la reserva, comprueba la disponibilidad del viernes, actualiza el sistema de programación y confirma el cambio. Cada paso es una llamada a herramienta que realiza una acción.
Por qué importa
Las herramientas son donde las conversaciones producen resultados. Cada herramienta necesita entradas y salidas claras, y el agente debe saber si una llamada se ha realizado correctamente antes de comunicárselo a quien llama.
Cómo lo hace ElevenAgents
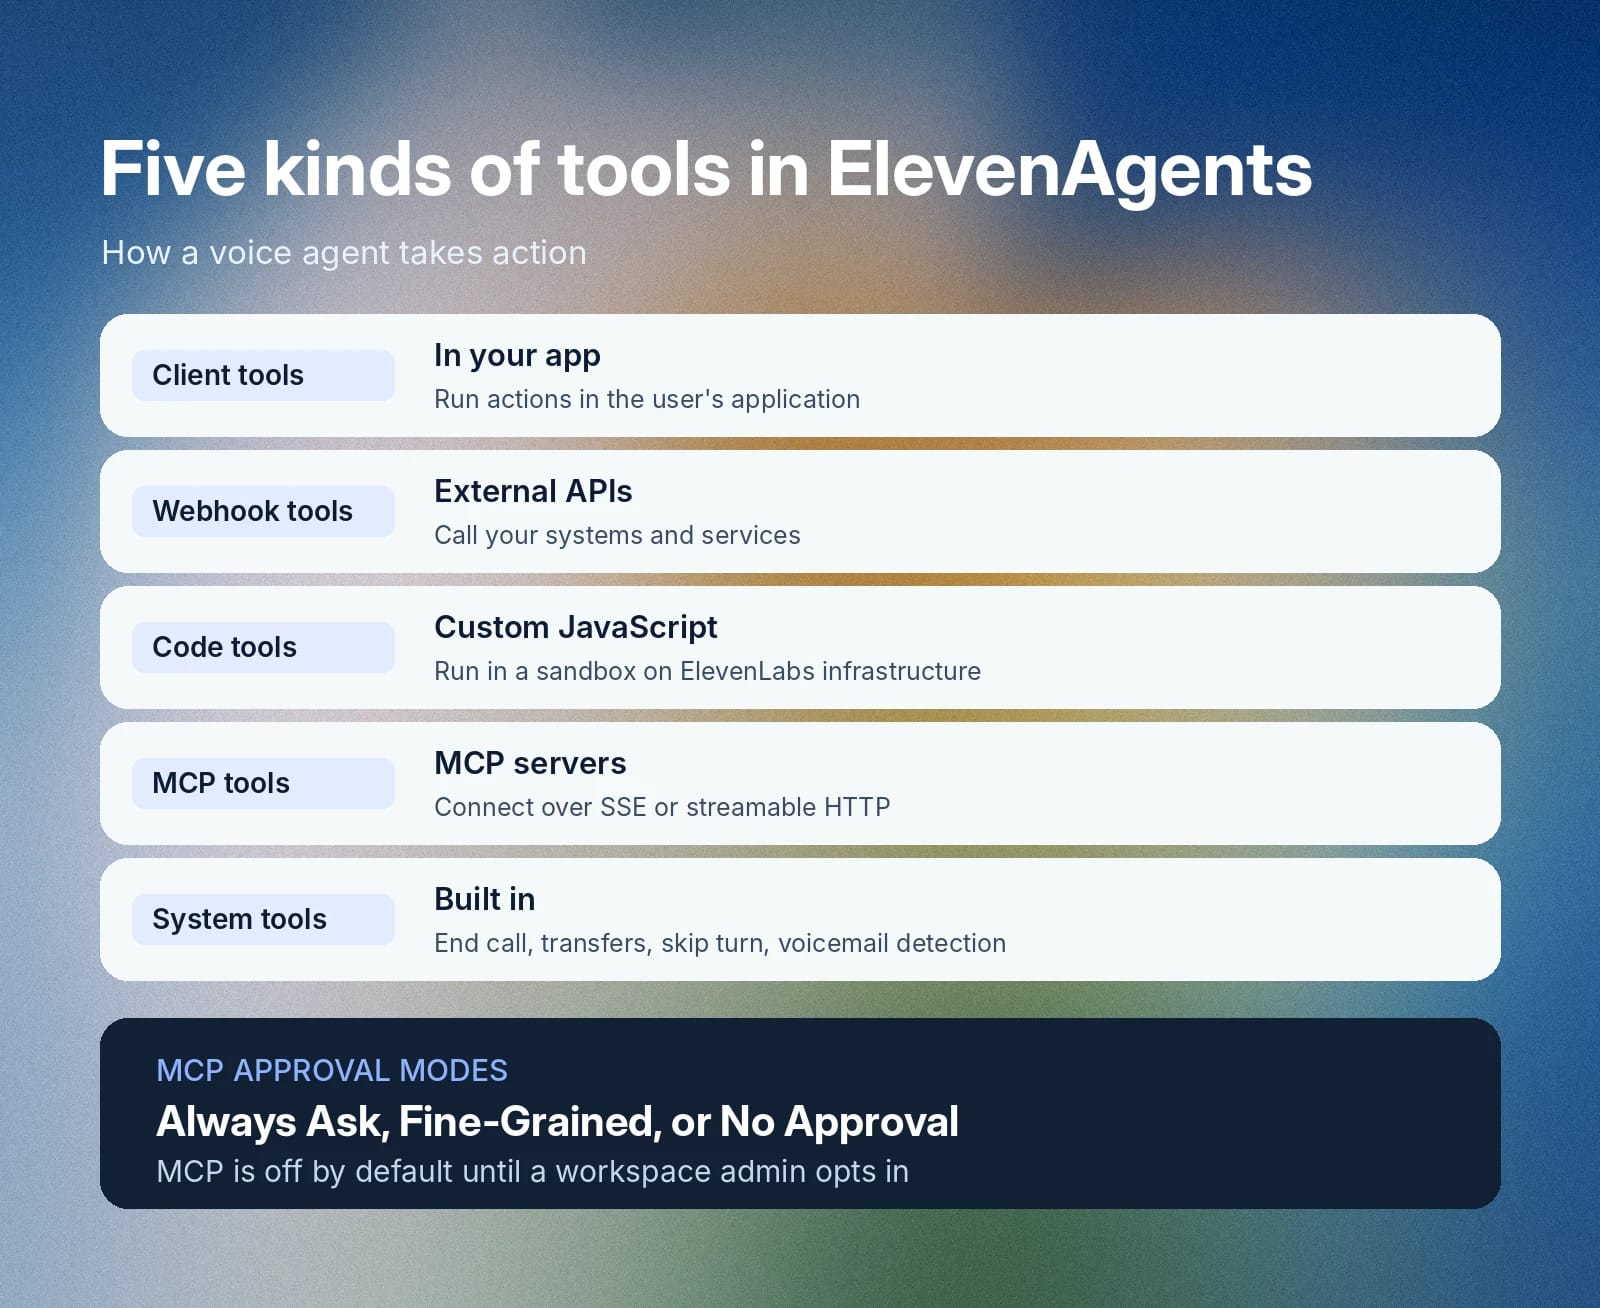
ElevenAgents admite herramientas de cliente que se ejecutan en la aplicación del usuario, herramientas webhook que llaman a API externas, herramientas de código que ejecutan JavaScript personalizado en un entorno aislado de la infraestructura de ElevenLabs, herramientas MCP y herramientas integradas del sistema.
Las herramientas del sistema incluyen finalizar llamada, detección de idioma, transferencia de agente, transferencia a número, omitir turno, reproducir tono de teclado y detección de buzón de voz. Puedes añadir audio ambiente mientras se ejecuta una herramienta y controlar si quien llama puede interrumpir durante la ejecución.
El Model Context Protocol (MCP) es un estándar abierto sobre cómo las aplicaciones proporcionan contexto y herramientas a los modelos de lenguaje. ElevenAgents se conecta a servidores MCP mediante SSE y HTTP transmisible. Los administradores del espacio de trabajo deben activarlo primero, ya que MCP está desactivado de forma predeterminada en todos los espacios de trabajo. Después eliges un modo de aprobación para cada servidor: preguntar siempre, aprobación granular de herramientas o sin aprobación.
Los eventos de cliente como client_tool_call y mcp_tool_call informan de la actividad de las herramientas, y los eventos MCP indican cuatro estados: cargando, esperando aprobación, correcto y error. Las herramientas fiables proporcionan al agente capacidad de actuar en el mundo real, y unas reglas de aprobación claras mantienen esa capacidad bajo control.
Conocimiento y memoria: datos y contexto de quien llama
La generación aumentada por recuperación (RAG) proporciona al agente datos procedentes de tu propio contenido, como una base de datos interna o un registro más amplio del historial de clientes. La memoria y la personalización le aportan contexto sobre quien llama, lo que permite a tu agente mejorar la personalización y la utilidad para tu negocio.
Qué hace
Un modelo de lenguaje tiene una fecha límite de entrenamiento y no puede acceder a tu documentación ni a tus registros. RAG busca en una base de conocimiento para cada consulta, recupera los pasajes más relevantes y se los proporciona al modelo para aportarle el contexto adicional necesario para una respuesta útil.
Los datos de personalización indican al agente quién llama y qué es relevante para esa persona.
Por qué importa
Basar las respuestas en contenido aprobado mantiene su precisión. La velocidad de recuperación también importa, ya que cada milisegundo que añade es otro milisegundo que esperan tus clientes. Las funciones de personalización también evitan que quien llama tenga que repetir información en distintas llamadas, pues tus agentes tendrán los registros del CRM disponibles al inicio de cada sesión.
Cómo lo hace ElevenAgents
Añades documentos a la base de conocimiento como archivos (PDF, DOCX, TXT, MD, HTML o EPUB, de hasta 20 MB cada uno), URL o texto pegado. Un documento usa el contexto completo cuando su texto extraído cabe en el prompt, hasta unos 300.000 caracteres. Los documentos más grandes usan RAG. La recuperación puede ejecutarse en cada turno o bajo demanda, y el modo de uso predeterminado es Auto, que usa RAG cuando está activado y el documento está indexado.
ElevenLabs trabaja directamente en la velocidad de recuperación. Su artículo de ingeniería, Cómo redujimos la latencia de RAG, documenta una reducción de la latencia mediana de RAG de 326 ms a 155 ms mediante modelos autoalojados en infraestructura que ElevenLabs ya opera.
Para el contexto de quien llama, ElevenAgents usa variables dinámicas escritas como {{ var_name }}, que completan mensajes, prompts de sistema y herramientas. Para las llamadas entrantes a través de Twilio, troncal SIP, WhatsApp y SMS, ElevenAgents puede obtener datos de inicio de tu servidor antes de que comience la conversación. Tu servidor busca a quien llama mediante caller_id y devuelve las variables, por ejemplo desde tu CRM, en una respuesta de hasta 256 KB. Tras la llamada, los webhooks posteriores a la llamada entregan resultados de evaluación y datos extraídos a tus sistemas externos.
Juntas, la recuperación y la personalización proporcionan al agente tanto los datos correctos como el contexto de la persona adecuada.
Síntesis de voz: dar voz al agente
Texto a Voz (TTS) transforma la respuesta del modelo de lenguaje en audio hablado. Es la capa que realmente escucha quien llama.
Qué hace
El modelo convierte texto en audio con un ritmo natural y una entonación emocional. En una llamada en directo transmite el audio en fragmentos para que la reproducción empiece antes de generar la respuesta completa.
Por qué importa
La latencia y la entonación determinan cómo valora quien llama la conversación. Para el trabajo en tiempo real importan dos cifras: el tiempo para generar audio y el tiempo hasta que quien llama oye el primer sonido. Los nombres, los nombres de medicamentos y los términos técnicos también necesitan una pronunciación correcta, o quien llama perderá confianza en el agente.
Cómo Eleven v4 potencia la capa de voz
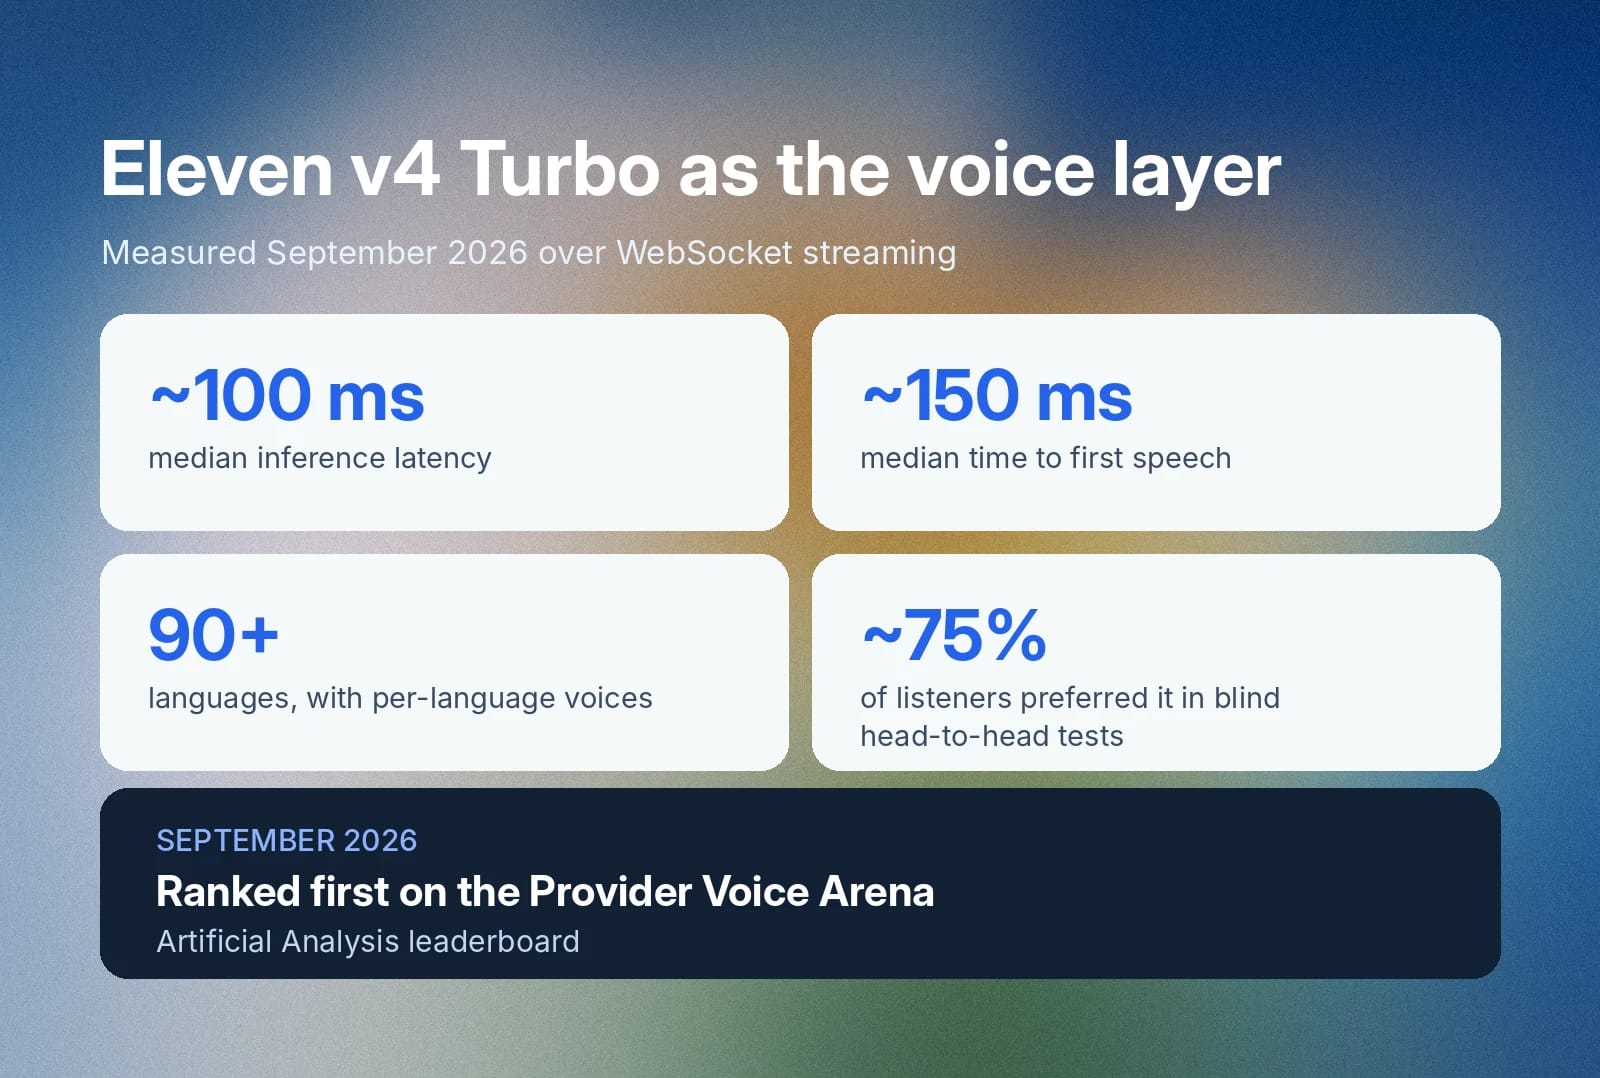
Eleven v4 es el modelo de Texto a Voz más expresivo de ElevenLabs hasta la fecha, creado sobre una arquitectura totalmente nueva. Eleven v4 Turbo es la variante de baja latencia para usos en tiempo real, como los agentes, optimizada junto con ElevenAgents como un único sistema.
Eleven v4 Turbo
Cifra
Latencia mediana de inferencia
Unos 100 ms
Tiempo mediano hasta la primera voz
Unos 150 ms
Idiomas
90+
ElevenLabs midió las cifras de latencia en septiembre de 2026 mediante transmisión por WebSocket y sin incluir la latencia de red. Eleven v4 ocupó el primer puesto en la clasificación Provider Voice Arena de Artificial Analysis en septiembre de 2026*, y cerca del 75 % de oyentes lo prefirió en pruebas a ciegas**.
* Artificial Analysis, clasificación Provider Voice Arena, sept. de 2026
** Basado en pruebas de preferencia de usuarios comparativas frente a Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS y Google Gemini 3.8 Flash TTS.
Eleven v4 admite etiquetas de audio insertadas, como [laughs] para la entonación, y compatibilidad con fonemas IPA para la pronunciación. En los agentes sanitarios, ese control de pronunciación incluye términos médicos. ElevenAgents añade controles a nivel de agente. La compatibilidad con varias voces permite a un agente cambiar de voz en conversaciones con varios personajes. La velocidad va de 0,7x a 1,2x. Cada idioma adicional puede usar su propia voz. Los diccionarios de pronunciación aceptan notación IPA o CMU para palabras específicas.
Un primer sonido rápido y una voz precisa y expresiva hacen que el agente parezca un interlocutor.
Telefonía y transporte: conectar el agente con quien llama
La capa de transporte lleva el audio entre quien llama y el agente. Según el canal de telefonía que uses, cambiarán las integraciones que incluyas aquí en tu infraestructura de voz IA.
Qué hace
Las llamadas telefónicas viajan por una red telefónica y SIP, mientras que las conversaciones en navegadores y apps viajan por WebRTC o WebSocket. Un widget de sitio web integra la conexión del navegador en una interfaz lista para usar.
Por qué importa
Cada canal tiene necesidades de configuración y restricciones de audio diferentes, así que decide pronto qué canales usarás. Una implementación centrada en teléfono necesita trunking y gestión de números. Una implementación en un producto necesita un SDK.
Cómo lo hace ElevenAgents
- Trunking SIP: Conecta tu sistema telefónico directamente con ElevenLabs, tanto para llamadas entrantes como salientes. Funciona con Twilio, Vonage, Sinch, Infobip, Telnyx y otros proveedores estándar. La señalización se ejecuta mediante TCP en el puerto 5060 o TLS 1.2 o superior en el puerto 5061, y el audio usa G.711 o G.722. Calcula al menos 100 Kbps por llamada. Los límites de llamadas simultáneas dependen de tu nivel de suscripción y quien llama espera cuando se activa la cola de llamadas.
- Integración nativa con Twilio: Importa un número de Twilio adquirido para llamadas entrantes y salientes. Los ID de llamada verificados funcionan solo para llamadas salientes.
- Llamadas por lotes: Sube una lista de destinatarios CSV o XLS, y cada columna adicional se convierte en una variable dinámica. Puedes ejecutarlas inmediatamente o programar el inicio. Los lotes usan el menor valor entre el 50 % del límite de simultaneidad de tu espacio de trabajo o el 70 % del límite de simultaneidad de tu agente, dejando capacidad para llamadas entrantes.
- WebRTC y WebSocket: Los SDK usan WebRTC para voz y WebSocket para conversaciones solo de texto de forma predeterminada. Los agentes privados se autentican con una URL firmada o un token de conversación creado en tu servidor. La ruta de WebSocket es wss://api.elevenlabs.io/v1/convai/conversation.
- SDK: Python, JavaScript, React, React Native, Swift, Kotlin y Unity.
- Widget: Añade el elemento <elevenlabs-convai> a una página. Admite modos de solo voz, voz más texto y chat, y el agente puede mostrar respuestas rápidas y carruseles.
Un agente puede atender por teléfono, web, WhatsApp, SMS y correo electrónico, lo que permite a los equipos crear una vez e implementar en todos los canales.
Guardrails: mantener al agente centrado en la tarea
Los guardrails son controles que mantienen el comportamiento de un agente dentro de límites definidos. Funcionan junto con la fundamentación, pues un guardrail limita lo que dice un agente sin garantizar que los datos que hay detrás sean correctos. Los guardrails se ejecutan en paralelo a las conversaciones del agente y ayudan a mantener las conversaciones de tus agentes de IA conformes y precisas.
Qué hace
ElevenAgents aplica guardrails en tres niveles. El prompt de sistema establece el comportamiento permitido y no permitido, idealmente bajo un encabezado # Guardrails. La validación de entradas de usuario filtra los mensajes para detectar inyección de prompts. La validación de respuestas comprueba cada respuesta antes de entregarla.
Por qué importa
Un agente que se desvía del tema o inventa una política erosiona la confianza rápidamente. Un agente de atención al cliente debe recuperar la política de reembolsos de una fuente aprobada antes de responder, y un guardrail aplica ese límite.
Cómo lo hace ElevenAgents
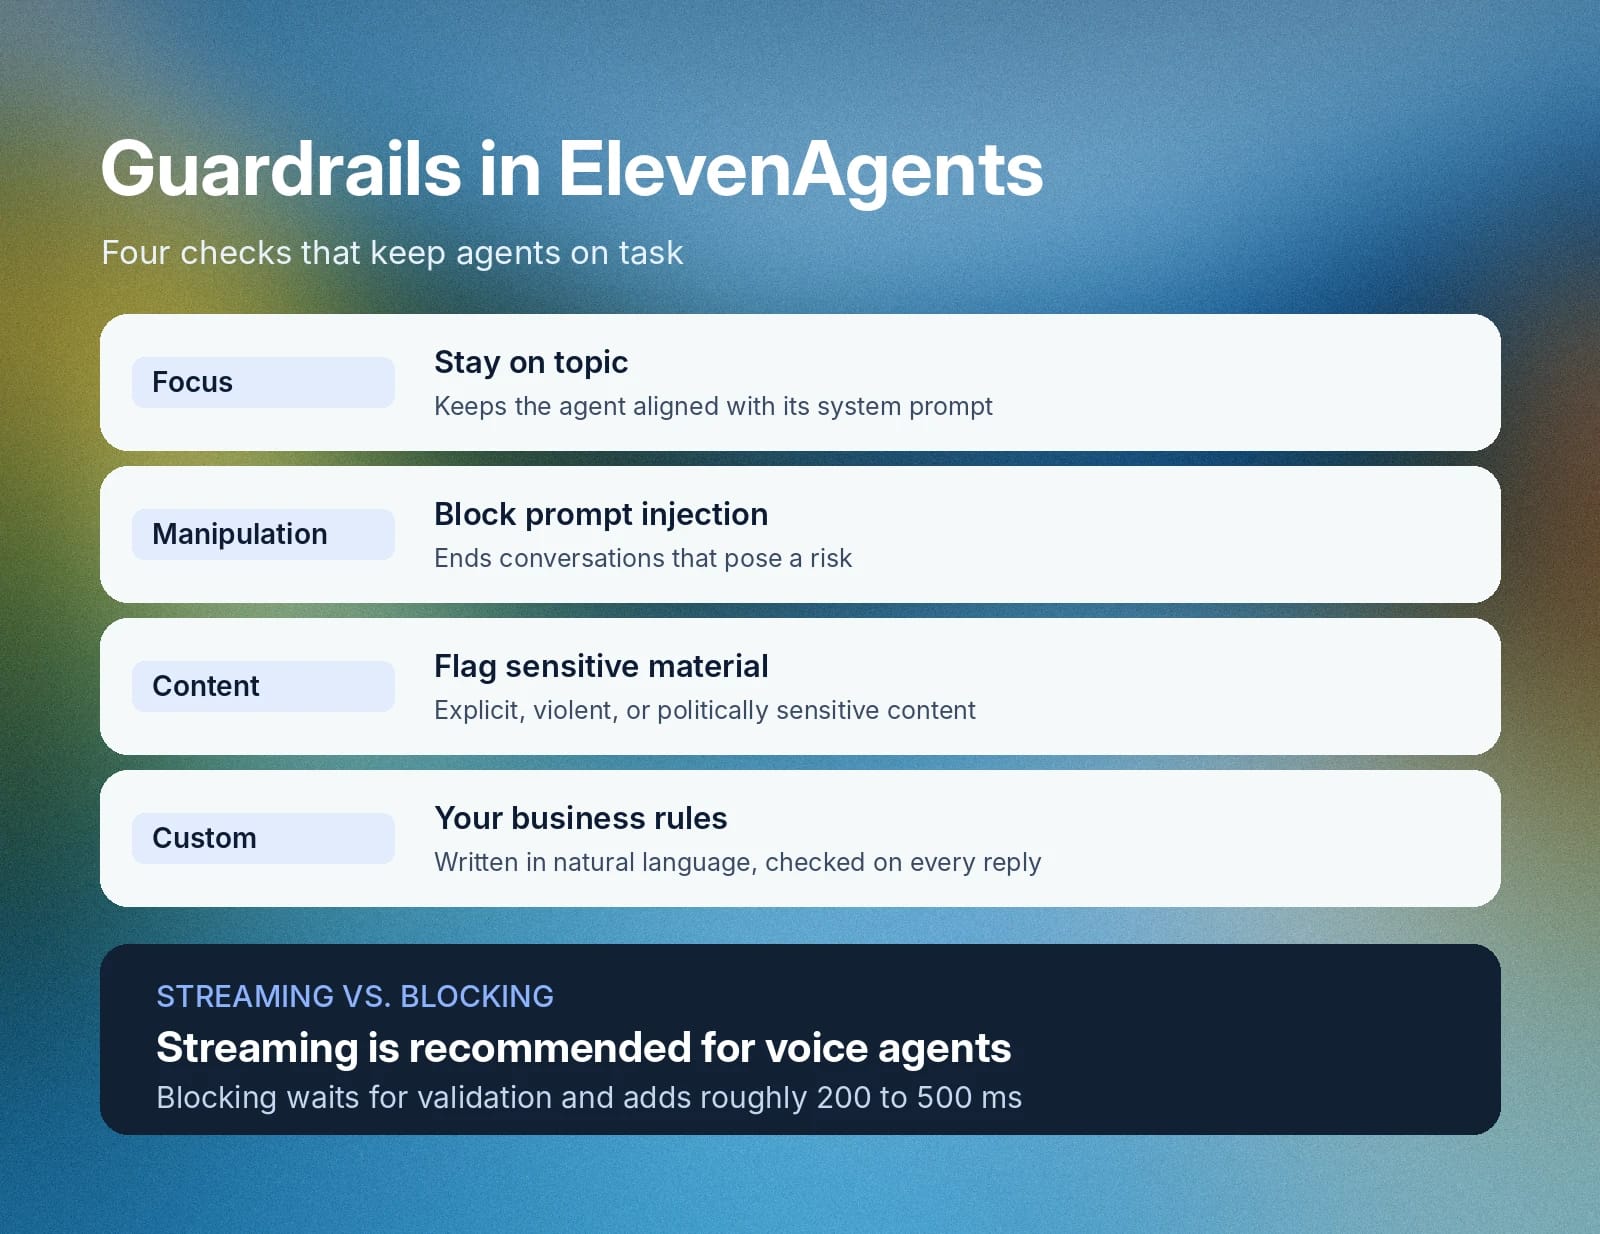
ElevenAgents presentó Guardrails 2.0 en septiembre de 2026. Con este nuevo sistema, estas son algunas de las configuraciones que ayudan a que los guardrails funcionen de forma eficaz:
- Enfoque: Mantiene al agente centrado en el tema y alineado con su prompt de sistema.
- Manipulación: Detecta la inyección de prompts y finaliza las conversaciones que plantean un riesgo.
- Contenido: Señala categorías como material sexualmente explícito, violento o políticamente sensible.
- Personalizado: Reglas de negocio que redactas en lenguaje natural y se evalúan en cada respuesta.
El modo de ejecución decide el equilibrio entre rendimiento y latencia. El modo de transmisión permite que la respuesta comience antes de completar la comprobación, de modo que pueden reproducirse menos de 500 ms de audio antes de que un bloqueo finalice la llamada; ElevenLabs lo recomienda para agentes de voz. El modo de bloqueo espera la validación y añade aproximadamente entre 200 y 500 ms.
Cuando se activa un guardrail personalizado, la acción puede finalizar la llamada o reintentar la respuesta hasta tres veces con los comentarios que redactes. Tu cliente puede escuchar el evento guardrail_triggered.
Los guardrails en capas, con un perfil de latencia elegido, mantienen un comportamiento predecible sin ralentizar cada respuesta.
Pruebas y experimentos: demostrar que el agente funciona
Las pruebas verifican un agente antes del lanzamiento. Los experimentos verifican cambios con tráfico real después del lanzamiento.
Qué hace
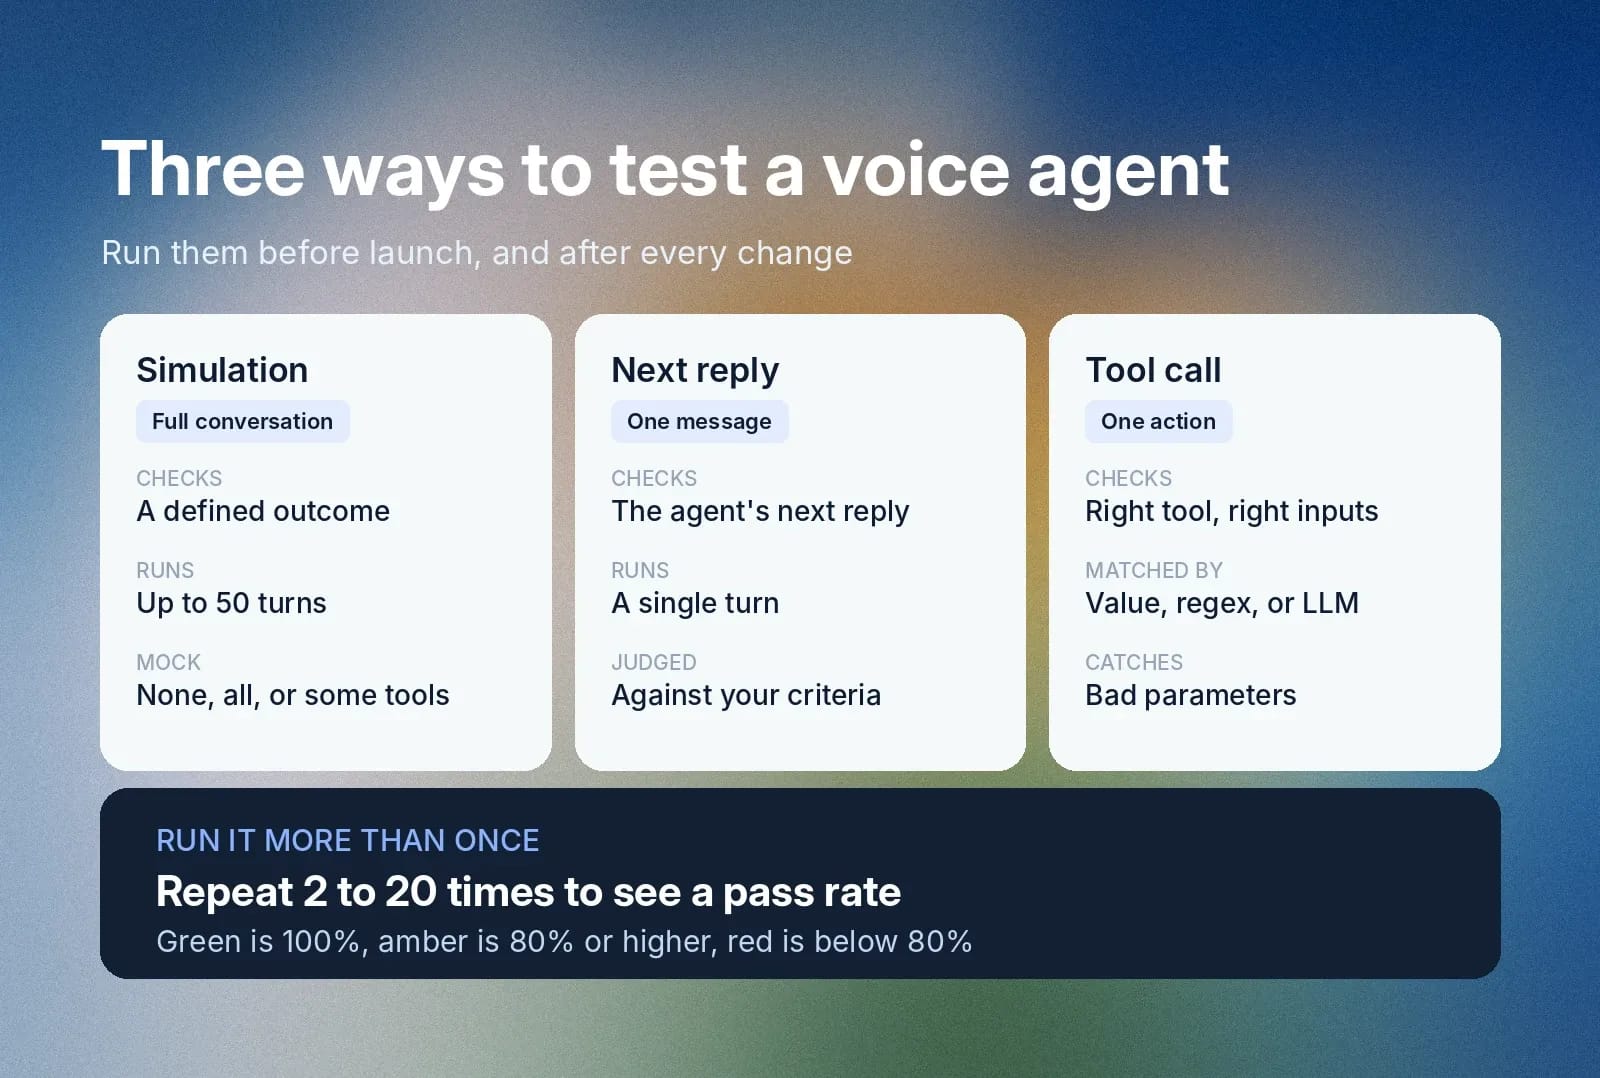
ElevenAgents tiene tres tipos de pruebas de agente. La simulación ejecuta una conversación completa con un usuario simulado y comprueba si alcanza un resultado definido, con hasta 50 turnos (5 de forma predeterminada). Las pruebas Next Reply evalúan únicamente el siguiente mensaje del agente según tus criterios. Las pruebas Tool Call verifican que el agente use la herramienta adecuada con los parámetros correctos, comparando el valor exacto, regex o la evaluación de un LLM. En las simulaciones puedes simular ninguna herramienta, todas o solo algunas.
Por qué importa
Una única ejecución satisfactoria demuestra que un agente puede tener éxito. Ejecutar pruebas repetidamente muestra con qué frecuencia lo hará. La API acepta repeat_count de 2 a 20 y los resultados muestran una tasa de éxito. El verde significa el 100 %, el ámbar el 80 % o más, y el rojo menos del 80 %. Los fallos se agrupan por motivo. Los prompts, modelos, workflows e integraciones cambian el comportamiento, por lo que las pruebas continúan después del lanzamiento.
Cómo funcionan los experimentos
Los experimentos son pruebas A/B basadas en el versionado de agentes. Creas una rama de tu configuración, cambias una variable, como el prompt de sistema, workflow, voz, herramientas, base de conocimiento o ajustes de LLM, y diriges una parte del tráfico real a la variante. ElevenLabs recomienda empezar con entre el 5 y el 10 %.
El enrutamiento es determinista según el ID de conversación, por lo que un usuario concreto permanece en la misma rama y los porcentajes deben sumar el 100 %. CARS24, cliente de ElevenLabs, aumentó el tráfico al 5 %, 10 %, 20 %, 50 % y 100 %, manteniendo cada fase dos días, tal y como se describe en el informe.
Las pruebas previas al lanzamiento y los experimentos en directo convierten juntos los cambios en mejoras medibles.
Observabilidad: medir lo que ocurre en producción
La observabilidad es la capacidad de ver qué hizo el agente, cómo rindió y, si surge el caso, dónde falló. Un agente que funciona en una prueba puede comportarse de forma distinta con personas reales, por lo que una observabilidad completa y un registro auditable son imprescindibles.
Qué hace
El análisis de conversaciones puntúa cada llamada. La evaluación de éxito aplica criterios que defines para el logro de objetivos y la calidad, y la recopilación de datos extrae campos estructurados como datos de contacto y tipo de incidencia. El panel de analíticas añade volumen de llamadas, duración, coste, tasas de error y latencia. Las llamadas activas se actualizan en tiempo real y las alertas se activan cuando aumentan las tasas de error.
Por qué importa
Sin monitorización, una llamada deficiente es una anécdota. Con ella, puedes ver qué nodo, herramienta o modelo provocó el problema.
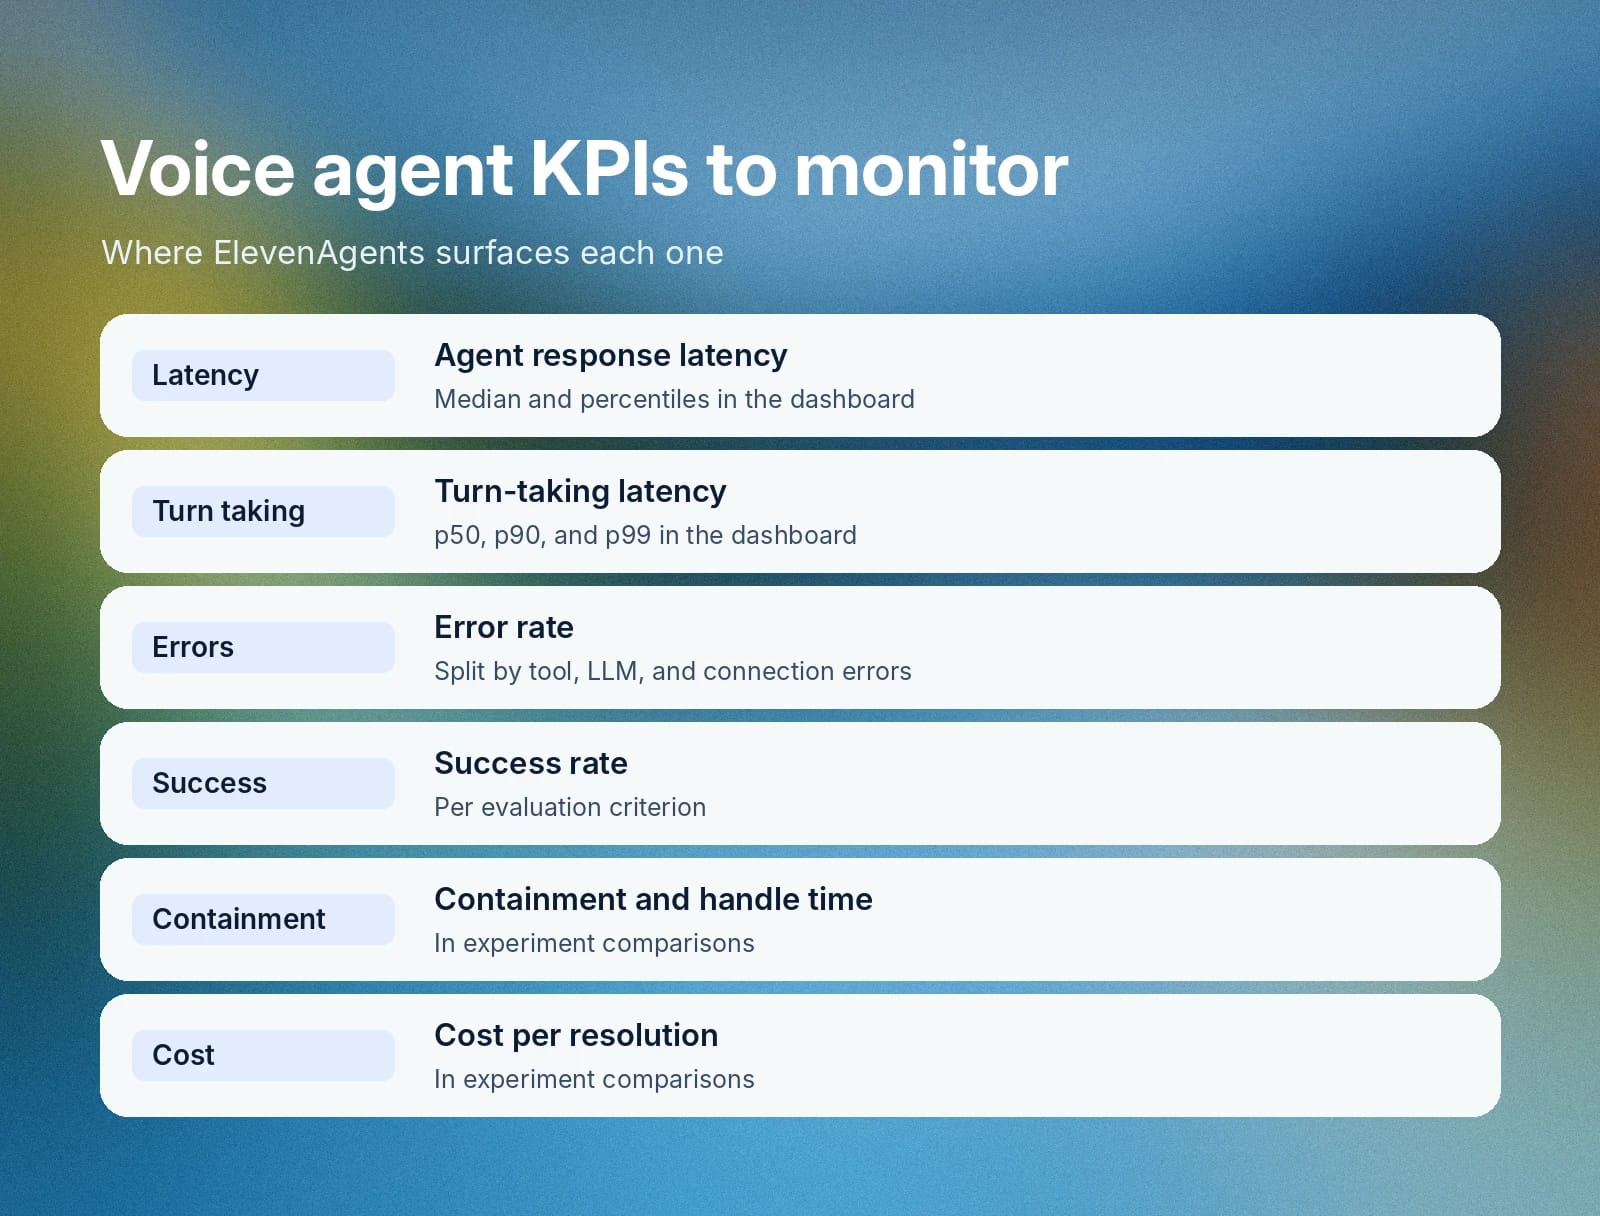
KPI
Qué indica
Dónde lo muestra ElevenAgents
Latencia de respuesta del agente
Cuánto esperan quienes llaman una respuesta
Panel de analíticas, mediana y percentiles
Latencia de gestión de turnos
Con qué rapidez toma el agente su turno
Panel de analíticas, p50, p90 y p99
Tasa de errores
Proporción de conversaciones con errores
Panel, desglosado por errores de herramientas, LLM y conexión
Tasa de éxito
Logro del objetivo por criterio
Criterios de evaluación, con tasas de éxito, fallo y resultado desconocido
Tasa de contención y tiempo de gestión
Llamadas resueltas sin intervención humana y duración de la llamada
Comparaciones de experimentos
Coste por resolución
Cuánto cuesta cada conversación resuelta
Comparaciones de experimentos
Elige las métricas más útiles para la tarea concreta que tienes en mente. Un agente de soporte se centra en la resolución y la escalación, mientras que un agente saliente se centraría principalmente en la conexión y la finalización.
Escala, fiabilidad y transferencia a personas
La infraestructura de voz IA debe ofrecer resultados tanto si hablas con 5 clientes como con 500.000. Incluso a gran volumen, estos componentes deben resistir y poder escalar a personas cuando sea necesario.
Qué hace
La escala implica admitir muchas conversaciones simultáneas en reconocimiento de voz, inferencia de LLM, síntesis de voz, integraciones y telefonía. La fiabilidad implica que cada una de esas dependencias tenga una ruta de fallo definida. La transferencia implica una vía clara hacia una persona.
Aunque no son estrictamente componentes de la infraestructura de voz IA, todos son partes esenciales de lo que en la práctica constituye un buen sistema.
Por qué importa
Un sistema que gestiona diez llamadas de prueba puede comportarse de forma diferente con diez mil. Una herramienta de reservas que agota el tiempo de espera no debe llevar al agente a confirmar una reserva que nunca se realizó. Quien llama y pide hablar con una persona debe llegar a ella con el contexto intacto, normalmente mediante una transferencia asistida.
Cómo lo hace ElevenAgents
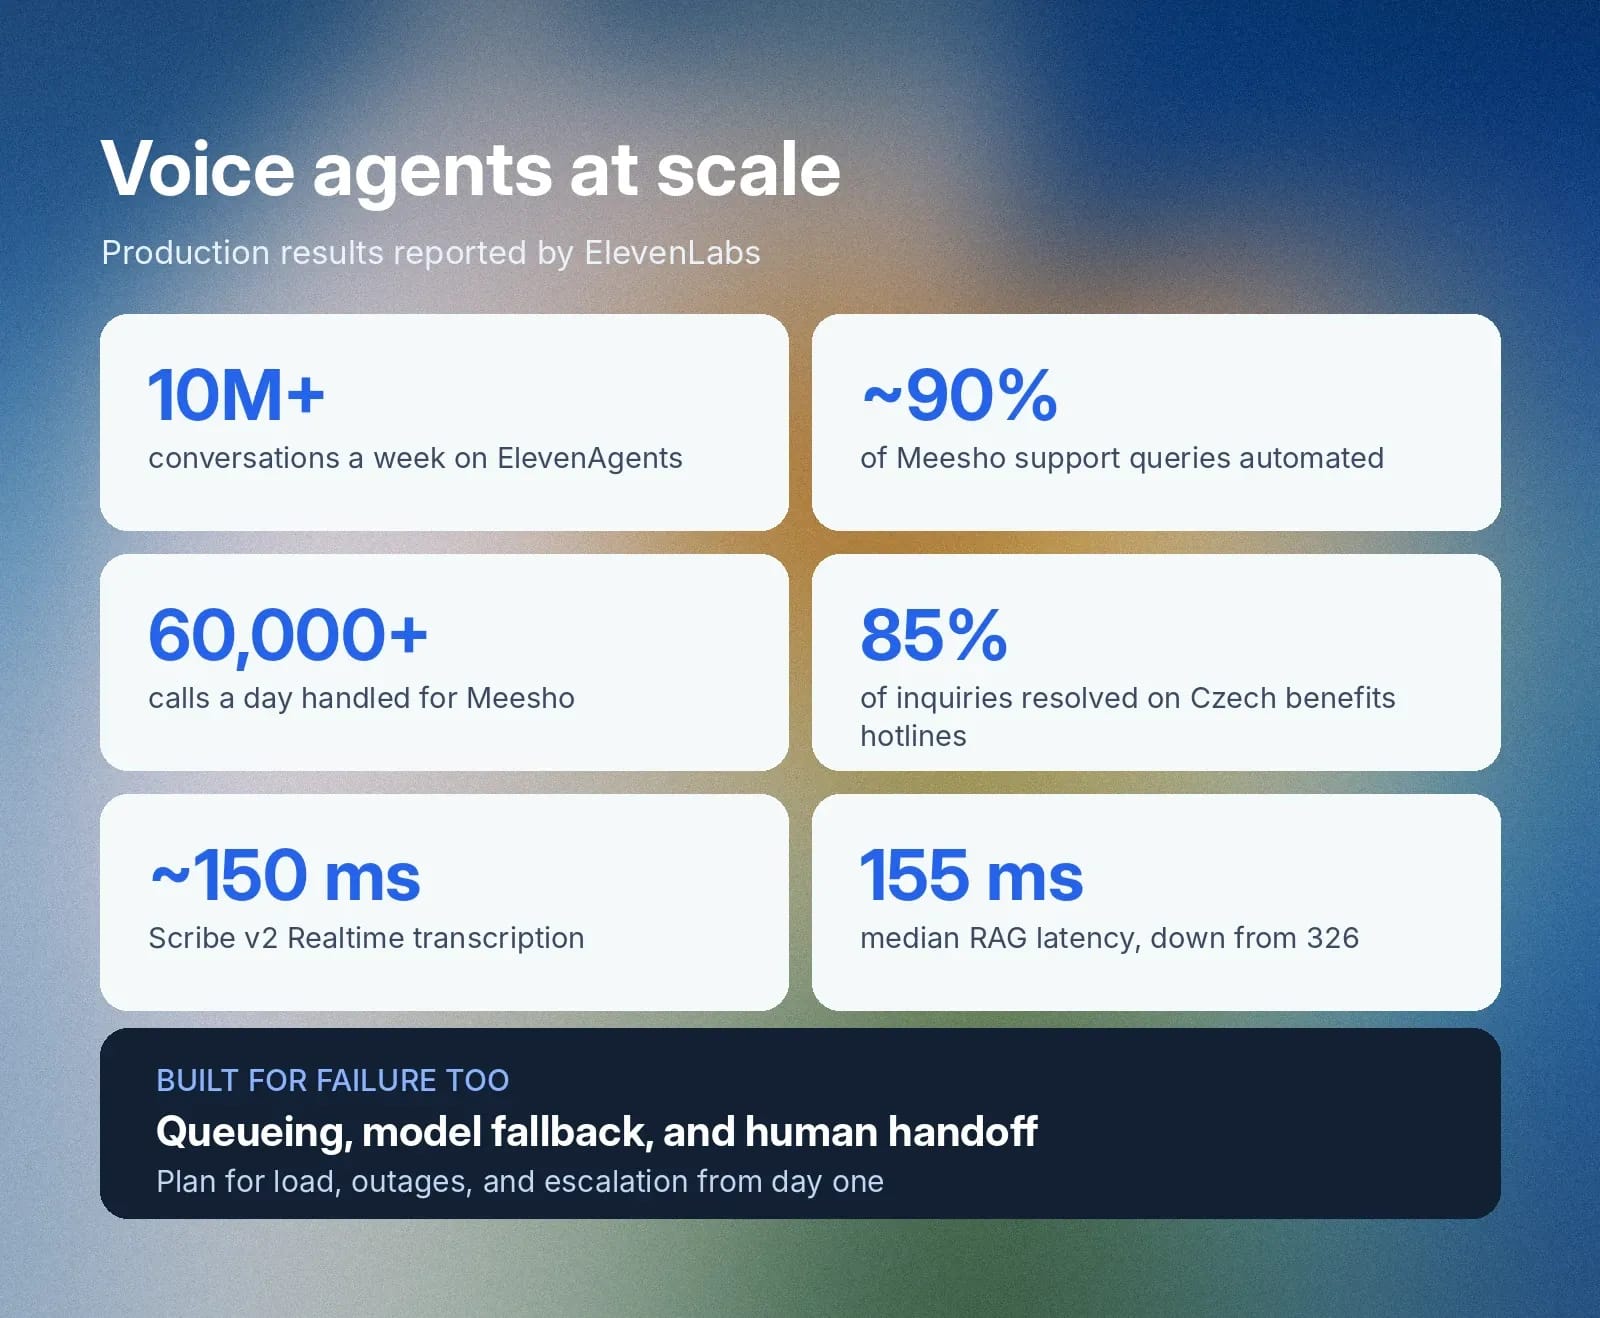
Los límites de simultaneidad dependen del nivel de suscripción, y la cola de llamadas retiene a quienes llaman cuando se alcanza un límite. La cascada de LLM cubre las interrupciones de servicio de los modelos. Los nodos de transferencia a número, la herramienta de sistema de transferencia a número y la transferencia de agente cubren la transferencia, y los criterios de evaluación pueden decidir cuándo escalar. Los periodos de silencio se facturan al 5 % de la tarifa habitual por minuto.
ElevenLabs informa de resultados de producción a escala. ElevenAgents impulsa más de 10 millones de conversaciones por semana. Meesho automatiza aproximadamente el 90 % de las consultas de soporte en más de 60.000 llamadas diarias, según el informe Building Enterprise-grade Voice Agents. En la República Checa, los agentes impulsados por ElevenLabs gestionan unas 5.000 llamadas diarias en líneas nacionales de prestaciones y resuelven de forma autónoma el 85 % de las consultas, según el informe State of Conversational Agents in Government.
Planificar desde el principio la carga, los fallos y la transferencia es lo que distingue una demo de una implementación.
Qué buscar en una infraestructura de voz IA lista para producción en 2026
Usa esta lista de comprobación para evaluar cualquier plataforma de voz IA según tus requisitos.
- Reconocimiento de voz: transcripciones precisas para tus idiomas, acentos y calidad de audio, incluidos nombres e identificadores.
- Gestión de turnos: comportamiento configurable al final del turno, interrupción y un tiempo de respuesta a interrupciones medido.
- Elección de modelo: un LLM seleccionable por agente o subagente, una opción de LLM personalizado y respaldo automático.
- Orquestación: workflows de varios pasos y enrutamiento entre agentes especializados.
- Herramientas: webhooks, herramientas de cliente, compatibilidad con MCP y controles de aprobación.
- Conocimiento: tus propios documentos, con una latencia de recuperación que puedas medir.
- Personalización: datos de quien llama disponibles antes de pronunciar la primera palabra.
- Voz: poco tiempo hasta la primera voz y control de la pronunciación y la expresividad.
- Canales: teléfono, web, móvil y mensajería, con SDK y una API.
- Guardrails: límites de comportamiento configurables con un coste de latencia conocido.
- Pruebas: conversaciones simuladas, comprobaciones de llamadas a herramientas y ejecuciones repetidas.
- Experimentos y analíticas: pruebas A/B, latencia por percentiles y desglose de errores.
- Escala y transferencia: simultaneidad, colas y escalación a personas documentadas.
Los principales sistemas de agentes de voz IA, como ElevenAgents, te ofrecen todos estos componentes en una sola plataforma.
Empieza hoy mismo contactando con el equipo o crea tus propios sistemas de agentes de IA registrándote para obtener una cuenta.
Preguntas frecuentes sobre infraestructura de voz IA

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.