¿Qué es el reconocimiento automático de voz (ASR)?
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
En 1952, el sistema de reconocimiento de voz más avanzado del mundo podía entender exactamente 9 palabras.
Unos 75 años después, el reconocimiento automático de voz (ASR) transcribe decenas de idiomas en tiempo real e impulsa desde los asistentes de voz de tu teléfono hasta los subtítulos que aparecen en vídeos en directo.
Esta guía explora la tecnología que salvó la distancia entre la versión de 1952 y las actuales: qué es el ASR, cómo convierte la voz en texto y cómo sigue evolucionando hoy en día.
Resumen:
- ASR significa reconocimiento automático de voz, la tecnología que convierte el audio hablado en texto escrito.
- La primera forma de ASR apareció en 1952, y los sistemas de aprendizaje profundo alcanzaron niveles comparables a los humanos a finales de la década de 2010.
- El ASR moderno utiliza redes neuronales integrales entrenadas con millones de horas de audio.
- La tasa de error de palabras (WER) es la métrica estándar de precisión, pero la latencia, la calidad de la diarización y la comprensión contextual también influyen en el ASR para producción.
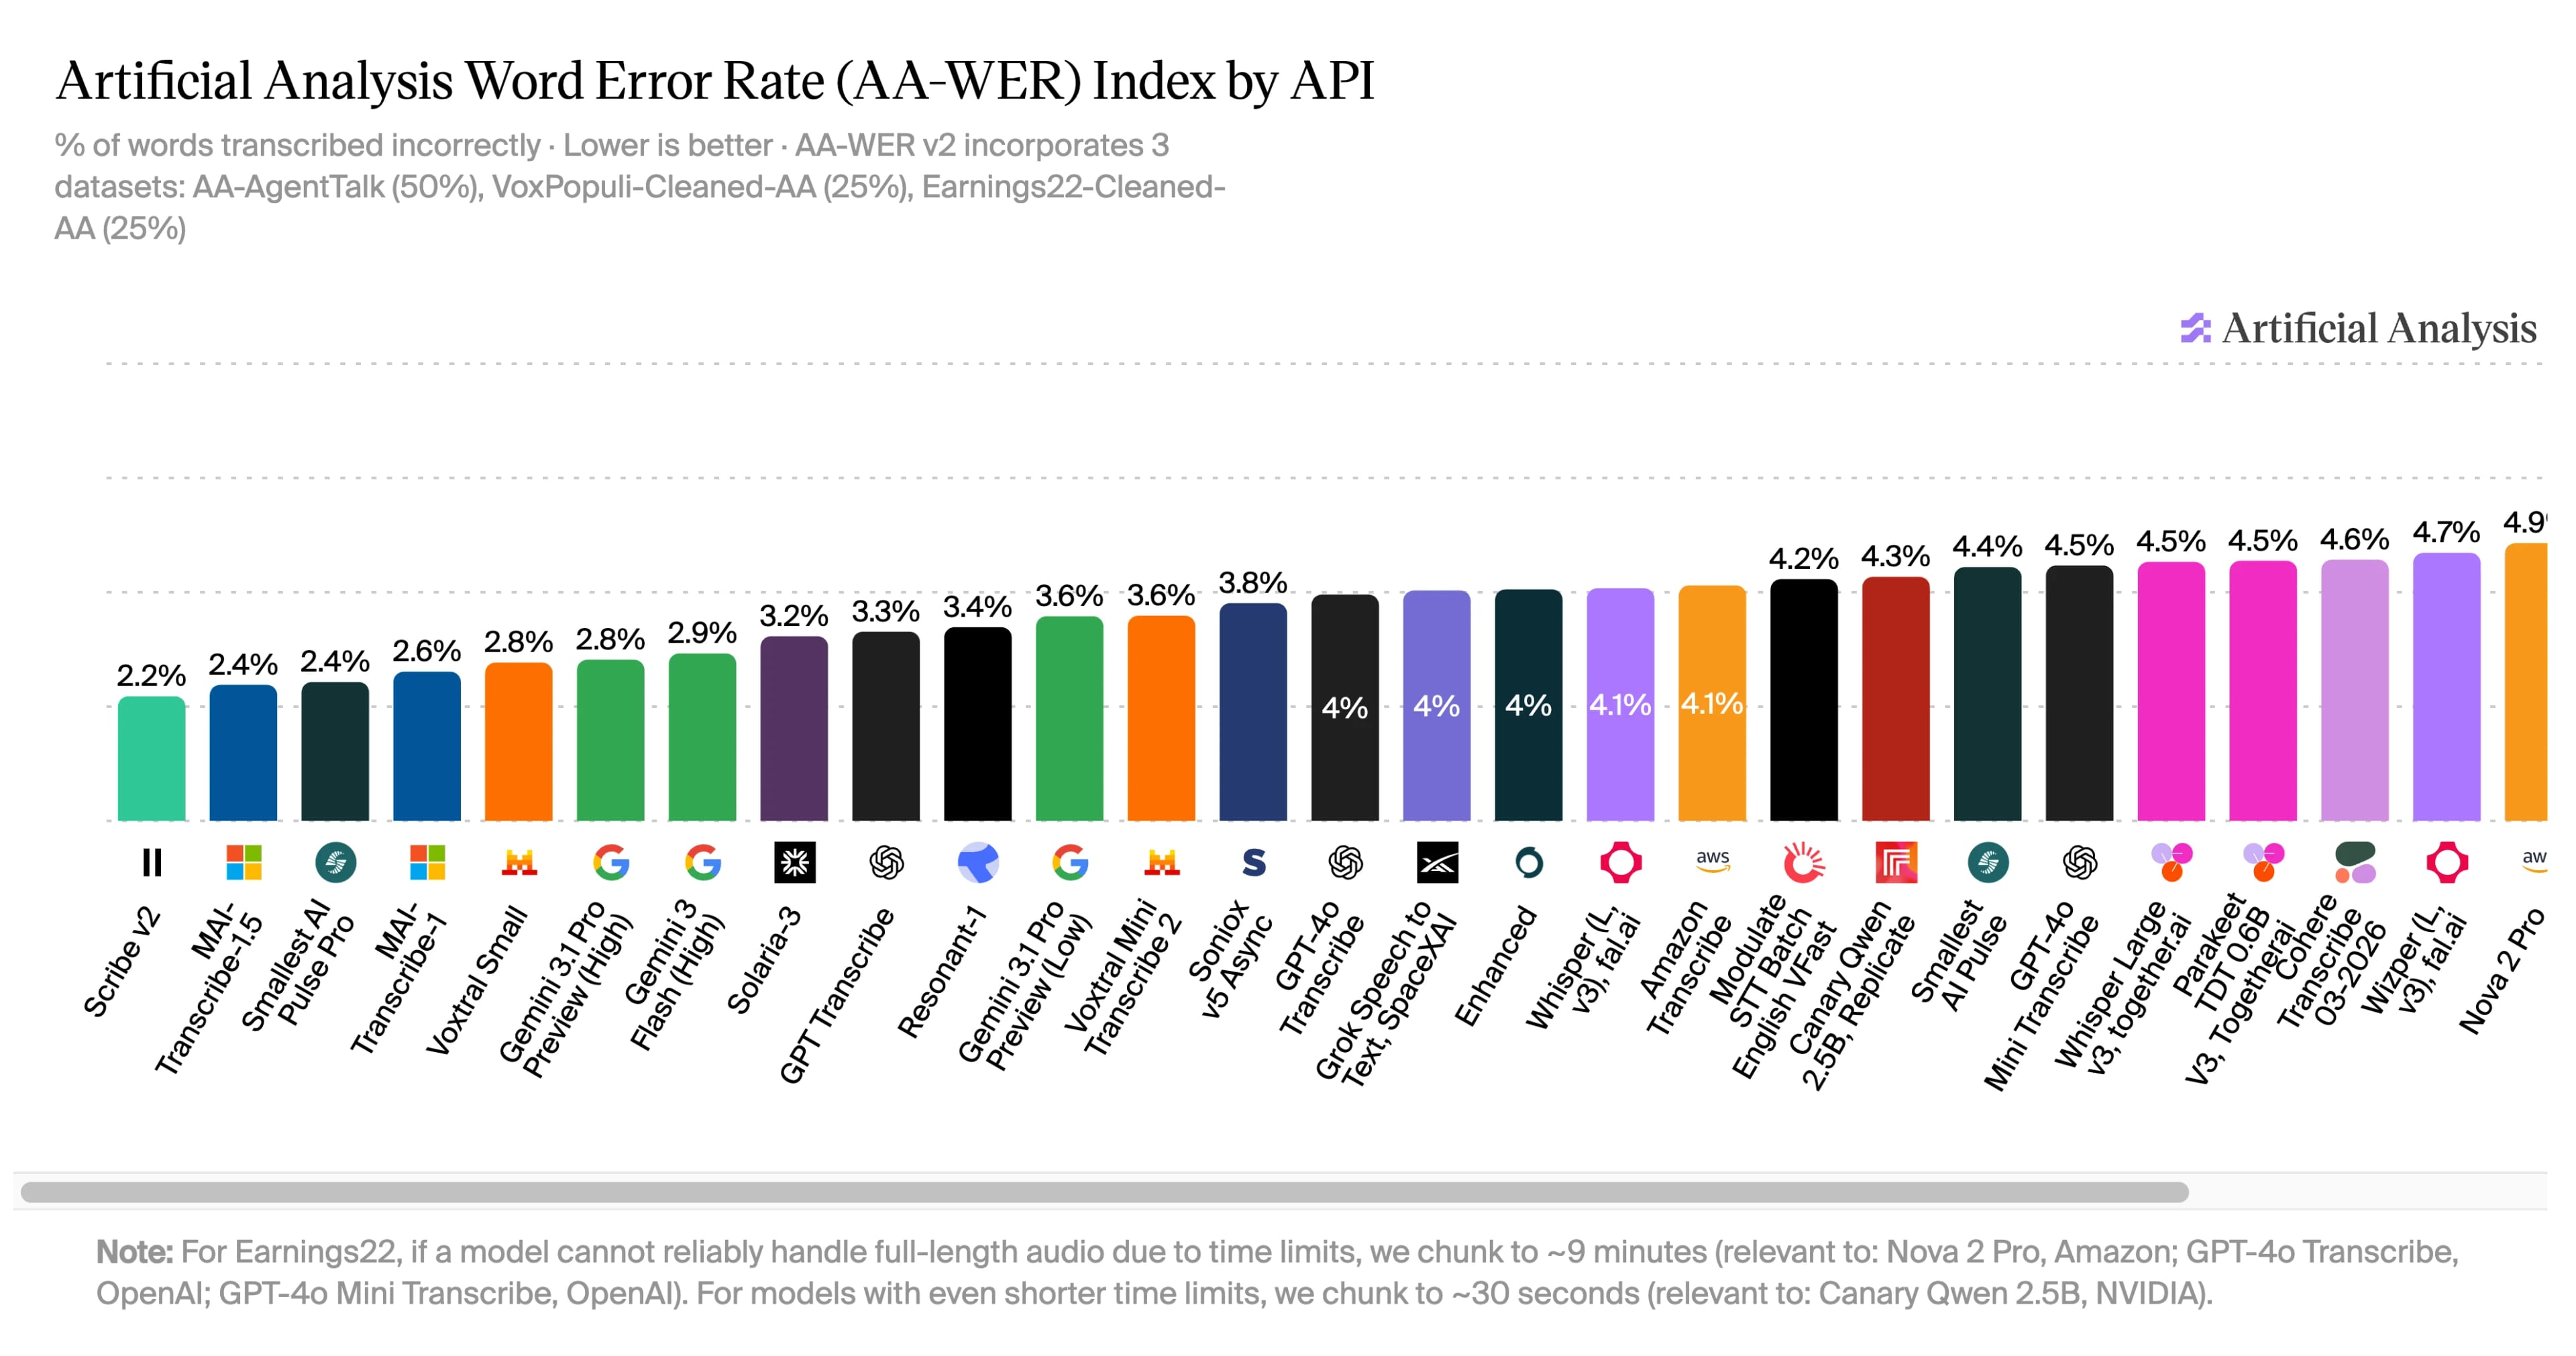
- ElevenAPI ofrece a desarrolladores ASR listo para producción, evaluado de forma independiente por Artificial Analysis con una tasa de error de palabras del 2,2 %, la más baja de su índice (julio de 2026).
¿Qué es el reconocimiento automático de voz (ASR)?
El reconocimiento automático de voz, conocido habitualmente por sus siglas ASR, describe un software que escucha la voz humana y la convierte en texto preciso y legible por máquinas. También se conoce como Voz a Texto y reconocimiento de voz, o incluso, en ocasiones, reconocimiento de voz por ordenador.
El ASR se ha vuelto tan habitual que quizá interactúes con él a diario sin darte cuenta. Cada vez que dictas un mensaje, haces una pregunta a un asistente de voz, lees subtítulos durante un vídeo en directo o navegas por un sistema telefónico de respuesta de voz interactiva, estás usando ASR.
Aunque Voz a Texto y ASR se usan a menudo como sinónimos —y están estrechamente relacionados—, no son exactamente lo mismo. El ASR es la tecnología que identifica qué se dice, mientras que STT es la aplicación de esa tecnología como herramienta. El software de reconocimiento de voz se apoya en el ASR e identifica quién ha dicho una palabra concreta, lo que constituye la base de las capacidades de diarización de hablantes.
Son diferencias pequeñas, pero conviene entenderlas si quieres integrar sistemas de ASR/STT/reconocimiento de voz en tus aplicaciones o sitio web.
Breve historia de la tecnología de reconocimiento automático de voz
La tecnología de reconocimiento automático de voz es mucho más antigua de lo que la mayoría cree, pues sus primeras versiones se remontan a la década de 1950. En los más de 70 años desde su creación, el ASR ha pasado por varias etapas importantes que han sentado, en gran medida, las bases de sus avances históricos.
Estas son las principales etapas por las que ha pasado la tecnología ASR:
- 1952 y el primer ASR: En 1952, Bell Laboratories desarrolló el Automatic Digit Recognizer, conocido como AUDREY, para entender los dígitos del uno al nueve. La herramienta solo tenía una precisión aproximada del 90 % y únicamente funcionaba si la usaba su inventor, por lo que era extremadamente limitada. Aunque estaba muy lejos de las capacidades modernas actuales, el simple hecho de reconocer del 1 al 9 ya era impresionante.
- De las décadas de 1960 y 1970 al vocabulario creciente del ASR: En las décadas siguientes, laboratorios de todo el mundo, incluidos IBM, University College London y NEC en Japón, lograron crear modelos similares a AUDREY en distintos contextos. Raj Reddy, un estudiante de posgrado indio en Stanford, desarrolló un reconocedor de vocales para su proyecto de doctorado, sentando las bases del reconocimiento de voz continuo sin necesidad de hacer pausas entre palabras. DARPA (Defense Advanced Research Projects Agency) financió investigaciones durante este periodo que dieron lugar a Beam Search, un método de construcción y descodificación de frases que fue fundamental para reconocer más de 1000 palabras en 1976.
- De la década de 1980 a principios de la de 2010: avances estadísticos: En 1987, un estudiante de Raj Reddy —que entonces trabajaba como profesor— combinó los modelos ocultos de Markov con Beam Search, lo que permitió crear ASR que no requerían entrenamiento con una única persona. Este avance redujo radicalmente el tiempo de entrenamiento de los sistemas de reconocimiento de voz. Dragon Systems lanzó en 1997 el primer ASR disponible comercialmente, llamado NaturallySpeaking Preferred. Podía reconocer 100 palabras por minuto y tuvo buenas ventas.
- La era moderna y el aprendizaje profundo: En la década de 2010, investigadores demostraron que una única red neuronal entrenada de extremo a extremo con audio y transcripciones superaba a un flujo de trabajo puramente estadístico. Con la llegada de las redes neuronales profundas, los sistemas ASR alcanzaron un rendimiento casi humano, con tasas de error de entre el 5 % y el 10 %. En esta época, asistentes de voz como Alexa y Siri llegaron al mercado.
Desde entonces, el ASR no ha dejado de ganar precisión y de extenderse. En julio de 2026, la investigación independiente de Artificial Analysis identificó a Scribe v2 de ElevenLabs como el modelo líder del sector, con una tasa de error de palabras (WER) de solo el 2,2 %.
¿Cómo funciona el ASR? Fundamentos de la tecnología de Voz a Texto
El ASR captura una muestra de audio, la convierte en una representación numérica y utiliza un modelo entrenado para predecir la secuencia de palabras más probable que representan esos datos. El ASR moderno realiza este proceso integral en tiempo real y lo completa en menos de un segundo.
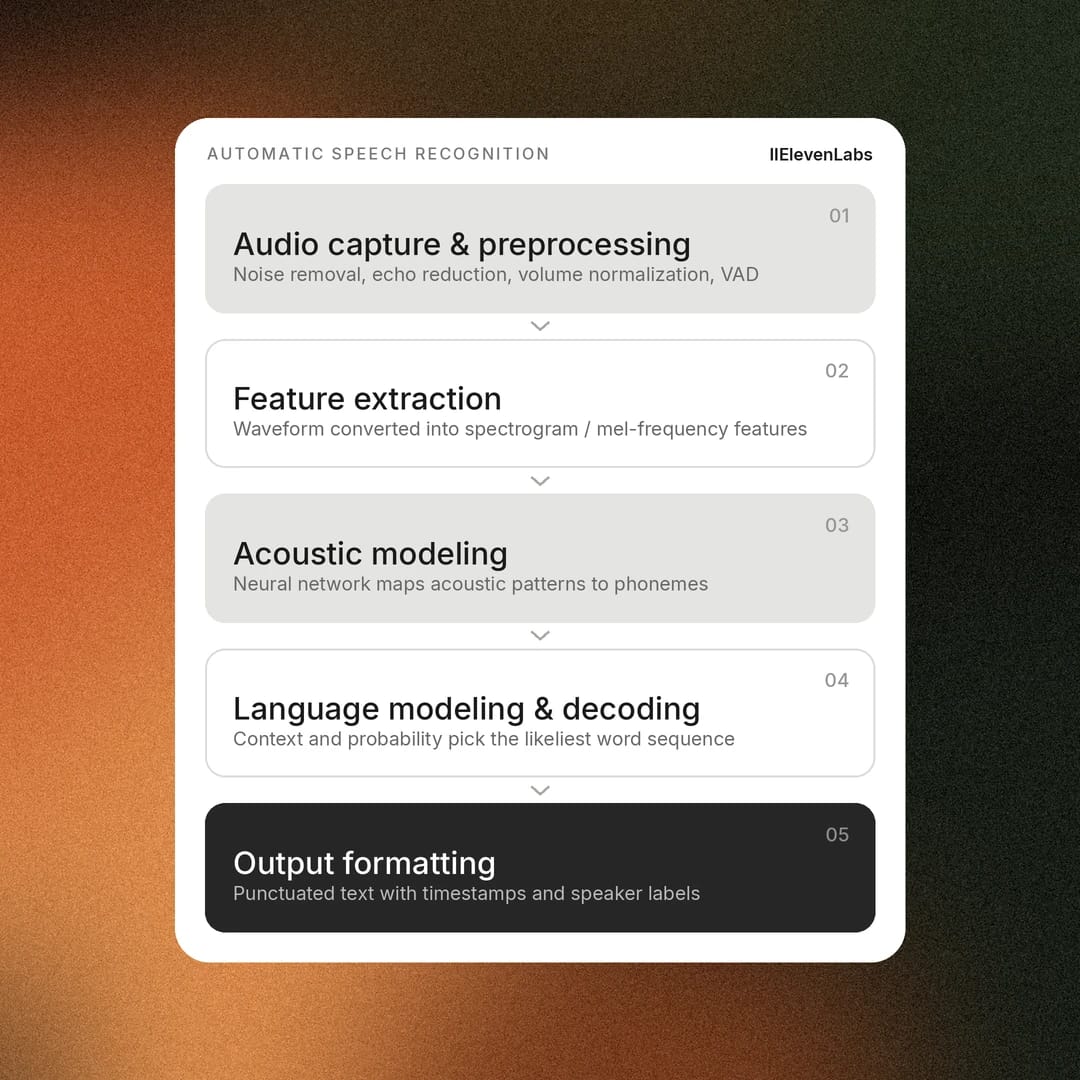
Un flujo de trabajo de ASR consta de cinco etapas principales:
- Captura y preprocesamiento de audio: El sistema graba la señal de audio, elimina el ruido de fondo, reduce el eco y normaliza los niveles de volumen para mejorar la consistencia. Según el modelo, puede usar detección de actividad de voz (VAD) para distinguir la voz del silencio o los sonidos de fondo antes de iniciar la transcripción.
- Extracción de características: El audio se convierte en una representación numérica, normalmente un espectrograma o características de frecuencia Mel, que resalta con precisión las frecuencias y patrones de la voz humana. Este paso transforma esencialmente una forma de onda sin procesar en datos que un modelo de aprendizaje automático puede procesar de forma eficaz.
- Modelado acústico: Una red neuronal analiza las características del paso anterior y predice fonemas u otras unidades del habla, aprendiendo la relación entre los patrones acústicos y el lenguaje hablado. Los modelos modernos integrales suelen realizar este paso junto con la comprensión del lenguaje, en lugar de tratarlo como una etapa completamente independiente.
- Modelado y descodificación del lenguaje: A continuación, el sistema pondera qué secuencias de palabras son más probables según reglas como la gramática, el contexto y la probabilidad matemática. Los dos últimos factores son fundamentales, ya que la transcripción IPA (Alfabeto Fonético Internacional) de dos frases puede ser similar aunque su contexto sea completamente distinto. Por ejemplo, «Recognize Speech» y «Wreck a nice peach» pueden sonar igual, pero significan cosas completamente diferentes. Si la precisión no basta para decidirlo, el contexto ayudará al sistema a determinar cuál es la correcta.
- Formato de salida: Tras decidir qué contiene la voz, se transcribe el texto final con puntuación y mayúsculas. Los metadatos adicionales, como las marcas de tiempo a nivel de palabra y las etiquetas de hablante, permiten crear transcripciones más detalladas.
A lo largo de estas etapas principales, el modelo transforma los datos de audio entrantes en una transcripción escrita.
Sistemas híbridos tradicionales frente a ASR integral con aprendizaje profundo
Aunque el flujo anterior describe cómo funciona el ASR, hay dos enfoques tecnológicos posibles para la parte central de ese proceso.
Los sistemas heredados encadenan varios componentes: un modelo léxico que codifica cómo se pronuncian las palabras, un modelo acústico que asigna fonemas al audio y un modelo de lenguaje que predice secuencias probables de palabras. Cada componente requiere experiencia humana para desarrollarse, desde lingüistas que elaboran diccionarios de pronunciación hasta anotadores que alinean cada palabra con su posición exacta en el audio.
El aprendizaje profundo integral reúne todos estos componentes en una única red neuronal. La red asigna el audio directamente al texto y comprende implícitamente la pronunciación, la acústica y las estadísticas de probabilidad del lenguaje a partir de millones de horas de audio y transcripciones emparejados.
Veamos las diferencias entre los enfoques tradicionales y modernos de la tecnología ASR.
Cómo se mide la precisión del ASR: referencias de tasa de error de palabras (WER)
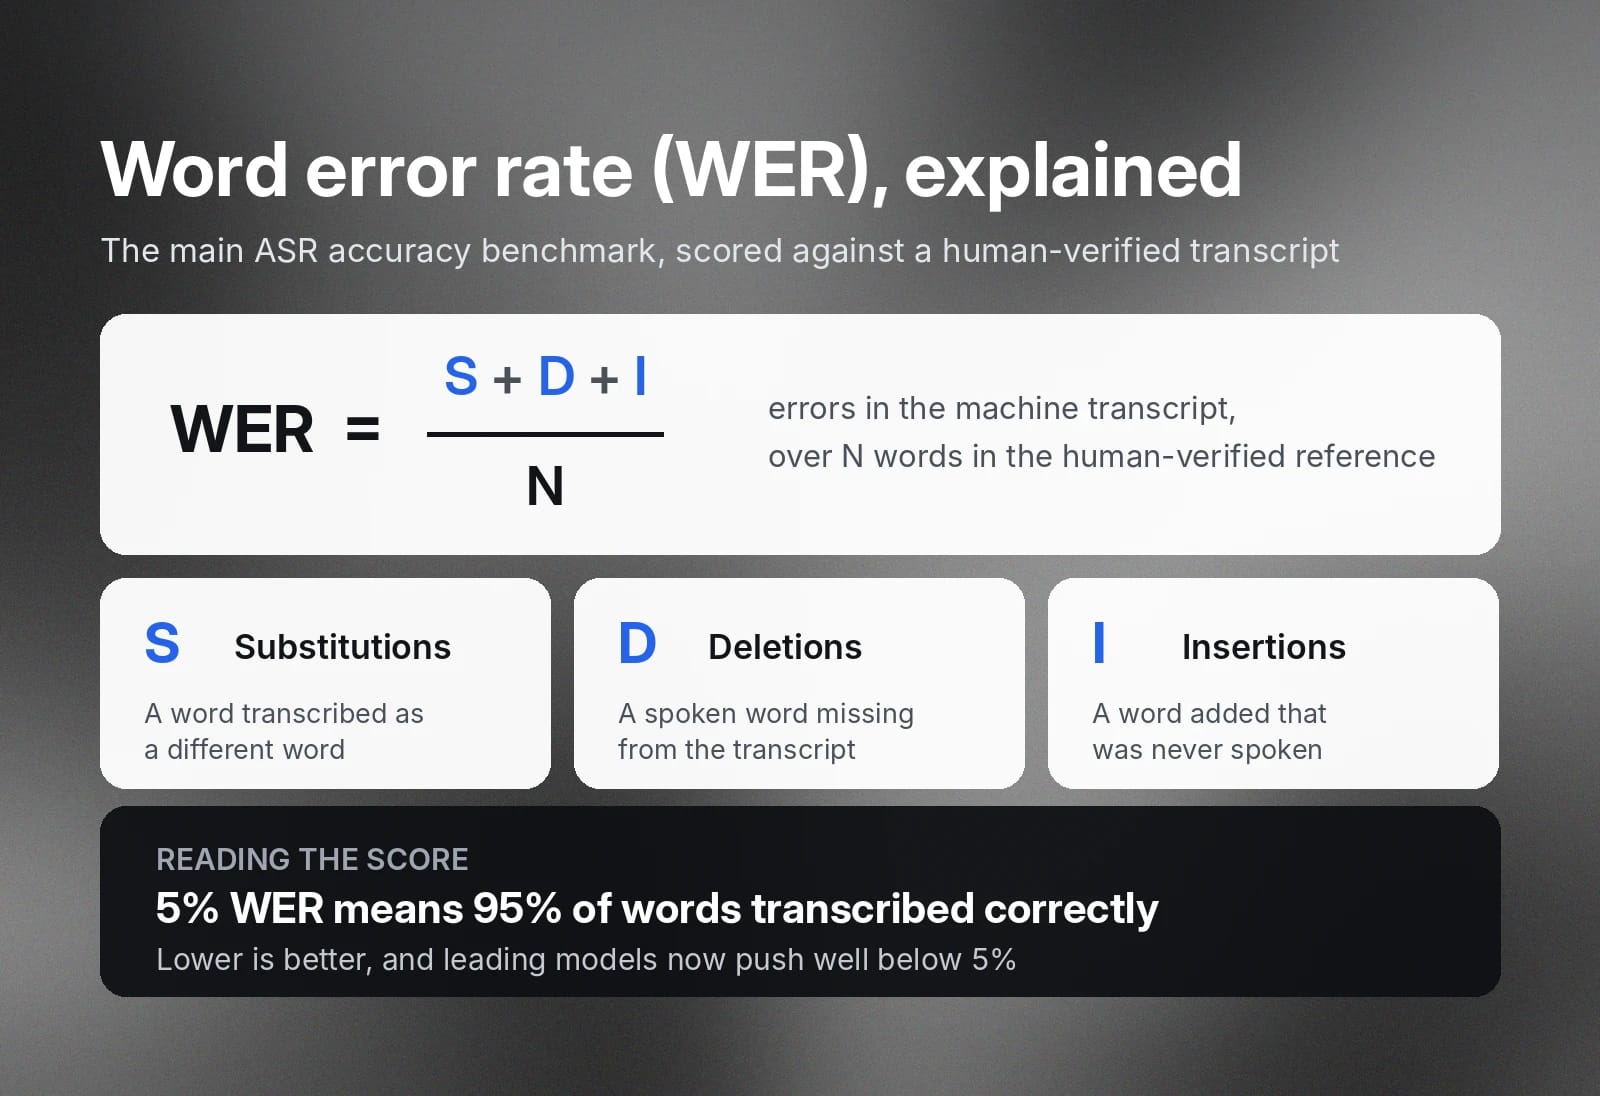
En todos los flujos de trabajo de Voz a Texto y ASR, la tasa de error de palabras (WER) es la principal métrica de precisión que usan las empresas. Compara una transcripción generada por ASR con una versión verificada por una persona. Hay tres errores principales que considerar: sustituciones, eliminaciones e inserciones.
La fórmula de WER divide el total de errores entre el número de palabras de la transcripción de referencia. Un WER del 5 % significaría que el sistema pudo transcribir correctamente el 95 % del texto; la mayoría de los modelos líderes ya están muy por debajo del 5 % y se acercan a la perfección.
Aunque el WER es una referencia útil, también hay que tener en cuenta otros factores para determinar la eficacia de una herramienta ASR:
- Precisión del formato: ¿Puede el sistema dar formato correctamente a cadenas no estándar? Por ejemplo, ¿muestra una cantidad monetaria como $1,225 o la escribe como «mil doscientos veinticinco dólares»?
- Latencia: Aunque la precisión es importante, una herramienta deja de ser útil si tarda varios minutos en generar una transcripción sencilla. Por muy precisa que sea, debe equilibrarlo con una latencia baja para ser útil.
- Robustez: Incluso en casos como acentos marcados o entornos ruidosos, la precisión del modelo no debería reducirse significativamente.
- Calidad de la diarización: Los casos de uso con varias personas dependen de atribuir cada palabra al hablante correcto. Poder identificar a distintos hablantes y etiquetarlos correctamente contribuye al ASR, especialmente en sectores con muchas intervenciones, como los tribunales.
Para más información, consulta nuestra guía completa sobre la tasa de error de palabras.
Principales ventajas del ASR para las empresas modernas
Se prevé que el mercado mundial del reconocimiento de voz y habla supere los 23.110 millones de dólares en 2030. La tasa de crecimiento anual compuesta del 19,1 % del mercado refleja lo extendida que está esta tecnología en los dispositivos comerciales. Todos los teléfonos móviles modernos incluyen un teclado de dictado y un asistente de voz, la mayoría de los coches nuevos responden a comandos de voz y los altavoces o asistentes inteligentes ya están presentes en hogares de todo el mundo.
Interactuar con la tecnología mediante la voz ya es una vía habitual para clientes de todo tipo. Para las empresas, el ASR abarca desde la transcripción de llamadas de clientes hasta la asistencia a agentes de voz, integrándose en los procesos e impulsando la productividad.
Estas son algunas de las principales ventajas del ASR para las empresas modernas:
- Introducción de datos y documentación más rápidas: Hace más de 10 años, Stanford publicó un estudio que demostraba que la tecnología de reconocimiento de voz era casi tres veces más rápida que escribir con un teclado y mantenía una tasa de error menor. Para la gran mayoría de personas, el ASR permitirá documentar más rápido los flujos de trabajo de transcripción y la toma de notas mediante voz.
- Menores costes operativos: En muchos casos de uso que antes dependían de horas de toma de notas manual, la tecnología ASR reduce radicalmente el coste de las transcripciones de alta calidad. Los procesos judiciales, centros de contacto, clínicas sanitarias y reuniones de empresa ya pueden contar con sistemas ASR precisos que generan notas detalladas y transcripciones completas de conversaciones con diarización.
- Mayor accesibilidad: La Organización Mundial de la Salud prevé que 2500 millones de personas vivirán con algún tipo de pérdida auditiva en 2050. Los subtítulos en tiempo real que ofrecen las herramientas ASR avanzadas pueden hacer que las reuniones y los medios digitales sean accesibles para usuarios.
- Datos de voz consultables: Cuando transcribes voz automáticamente con ASR, cada interacción entre cliente y empresa queda registrada por completo. Cada llamada de ventas, solicitud de soporte, llamada con clientes potenciales o reunión se convierte en un texto consultable y auditable. Especialmente en la era de la IA, poder recuperar contexto en un formato legible por máquinas puede ayudar a crear amplias bases de conocimiento. Ya sea por funcionalidad o por cumplimiento normativo, esto ayuda a mantener la información visible.
- Experiencias de cliente siempre disponibles: El ASR proporciona una de las tecnologías fundamentales para agentes de voz, facilitando casos de soporte automatizado que resuelven llamadas de clientes 24/7/365.
El reconocimiento automático de voz predomina en la tecnología por sus numerosos beneficios y por la amplitud de los casos de uso que admite. Tanto si trabajas en medicina como si quieres transcribir llamadas de clientes para analizar su opinión, el ASR es una tecnología fundamental que incorporarás y utilizarás.
Aplicaciones populares del ASR en todos los sectores
El reconocimiento automático de voz es una tecnología central en innumerables flujos de trabajo y productos. Ha alcanzado tal nivel de implantación que muchas veces usuarios ni siquiera piensan en cómo se integra en la tecnología que usan.
Aquí tienes un resumen de algunos casos de uso populares del ASR en todo el mundo.
Atención al cliente y centros de contacto
Los centros de contacto adoptaron pronto el ASR para transcribir llamadas con fines de control de calidad y cumplimiento normativo. Hoy, el ASR puede funcionar en tiempo real para ofrecer sugerencias a agentes durante la conversación y convertir miles de interacciones con clientes en datos que los equipos pueden analizar.
Medios y entretenimiento
Las cadenas y plataformas de streaming pueden usar ASR para generar subtítulos de conversaciones humanas a una escala imposible de igualar para transcriptores humanos. Permite la transcripción en tiempo real y hace que las bibliotecas de vídeo y audio sean completamente consultables.
Sanidad
El personal clínico dedica una parte sorprendente de su jornada a la documentación y al registro de historiales. El ASR ayuda a recuperar ese tiempo y ofrece a profesionales médicos una plataforma de STT médico a la que pueden dictar sus notas en tiempo real.
Reuniones virtuales
Las plataformas de reuniones suelen ofrecer alguna forma de toma de notas digital para transcribir las conversaciones mientras ocurren, de modo que nadie tiene que elegir entre participar y tomar notas. Servicios como Google Meet incluso envían esas transcripciones con los puntos de acción destacados tras cada reunión, lo que ayuda a crear un índice de información consultable.
Legal y cumplimiento normativo
En los entornos jurídicos, registrar con precisión qué se dijo y quién lo dijo es un requisito fundamental en los tribunales. Los bufetes de abogados utilizan plataformas ASR para transcribir reuniones, audiencias, llamadas de clientes y sesiones judiciales con marcas de tiempo precisas para futuras consultas.
Educación
El profesorado universitario puede proporcionar una transcripción grabada de sus clases para ayudar al alumnado a conservar un registro de las sesiones a las que ha asistido. Para comprender y memorizar información, estudiantes tendrán un recurso completo del que partir.
El lugar del ASR en el flujo de trabajo de un agente de voz
El ASR es una parte habitual de diversos despliegues tecnológicos. En la tecnología de agentes de voz, es la primera de tres etapas más amplias que se ejecutan en un ciclo continuo.
- Escuchar (ASR): El agente captura los flujos de audio entrantes y convierte la voz en texto en tiempo real. El ASR moderno procesa el audio continuamente a medida que llega, filtra el ruido de fondo, gestiona interrupciones, genera transcripciones parciales e identifica cuándo habla cada persona.
- Pensar (modelo de lenguaje): Un modelo de lenguaje de gran tamaño interpreta la transcripción, comprende la intención del usuario, recupera información de herramientas y bases de conocimiento conectadas, mantiene el contexto conversacional y determina la respuesta o acción más adecuada.
- Hablar (Texto a Voz): Un modelo de Texto a Voz convierte la respuesta generada por el LLM en audio natural y expresivo. Los sistemas TTS modernos pueden ajustar el ritmo, la entonación, la emoción y el énfasis mientras transmiten el audio generado a quien llama, sin tener que esperar a la respuesta completa.
La latencia conversacional se acumula en cada una de estas etapas. Para reducirla, el ASR en streaming comienza a emitir palabras en cuanto se pronuncian, en lugar de esperar a que termine una intervención. ElevenAgents aplica este estándar a los agentes de voz en tiempo real y contribuye a crear una experiencia de agente muy eficiente.
Desafíos del ASR y evolución de la tecnología
Aunque la tecnología ASR ha avanzado mucho desde sus orígenes en 1952, aún persisten diversos desafíos que pueden reducir su precisión.
Estos son algunos de los problemas que las herramientas ASR siguen encontrando hoy:
- Acentos y dialectos: Los datos de entrenamiento disponibles suelen concentrarse en unos pocos idiomas y acentos, lo que dificulta el trabajo de las herramientas ASR con acentos menos comunes o idiomas hablados por menos personas. La solución son conjuntos de datos de entrenamiento amplios y diversos.
- Ruido de fondo y hablantes superpuestos: Los entornos con volúmenes variables o ruido de fondo intenso hacen más difícil identificar las palabras individuales de una grabación. Los hablantes que se solapan pueden tener un efecto similar y reducir la precisión de una transcripción ASR.
- Vocabulario específico de un sector: Los campos con jerga o siglas específicas necesitarán diccionarios y referencias propios del sector para mejorar la precisión. La medicina y el derecho son dos ámbitos en los que las herramientas ASR necesitarán ayuda adicional o formación especializada.
- Privacidad y seguridad: En muchas jurisdicciones, los datos de voz se consideran datos personales. Las empresas necesitan políticas de retención claras y salvaguardas para proteger el tratamiento de los datos de voz y garantizar el cumplimiento de normativas más amplias.
Al trabajar con tecnología ASR, una consideración más amplia es el equilibrio entre latencia y precisión. Algunos casos de uso deben encontrar un punto medio, mientras que ámbitos como la medicina probablemente prioricen la precisión por encima de todo.
Empieza con ElevenAPI para integrar ASR listo para producción
ElevenAPI incorpora reconocimiento automático de voz listo para producción a tu producto mediante Scribe v2, el modelo de Voz a Texto de ElevenLabs. Scribe v2 ofrece marcas de tiempo por palabra, diarización de hablantes, etiquetado de eventos de audio y la precisión y fiabilidad necesarias para aplicaciones en tiempo real.
Explora la página de Voz a Texto de ElevenLabs para más información o crea una cuenta gratuita para poner en marcha una API en minutos.
Preguntas frecuentes sobre ASR

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.