
Tutorial de reconocimiento de voz en Python: del archivo de audio a la transcripción
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Incorporar funciones de reconocimiento de voz a una app de Python solía ser complicado. Desarrolladores de Python tenían que programar todo el proceso de transcripción, incluido el preprocesamiento de audio, la extracción de características y la integración del modelo. Además, los equipos de ingeniería se enfrentaban a la gestión de audio de bajo nivel, una calidad de transcripción insuficiente y retrasos entre las palabras habladas y los subtítulos en directo.
Los avances en los modelos de audio y los SDK de reconocimiento de voz han cambiado esta situación.
En este tutorial sobre reconocimiento de voz con Python, aprenderás a integrar los modelos de audio de Voz a Texto de ElevenLabs en tu proyecto de Python para crear aplicaciones de transcripción listas para uso comercial.
Resumen
- Los modelos comerciales de Voz a Texto ofrecen funciones como la diarización de hablantes, marcas de tiempo por palabra y prompting de términos clave, de las que carecen los modelos básicos de reconocimiento de voz.
- ElevenAPI incorpora funciones de reconocimiento de voz a tu código de Python con Scribe v2 y Scribe v2 Realtime.
- Desarrolladores pueden instalar habilidades de ElevenLabs en una plataforma de programación con IA para generar código de Python preciso a partir de la documentación oficial de la API.
- Puedes probar la API de ElevenLabs gratis antes de suscribirte a un plan de pago para desarrollo comercial.
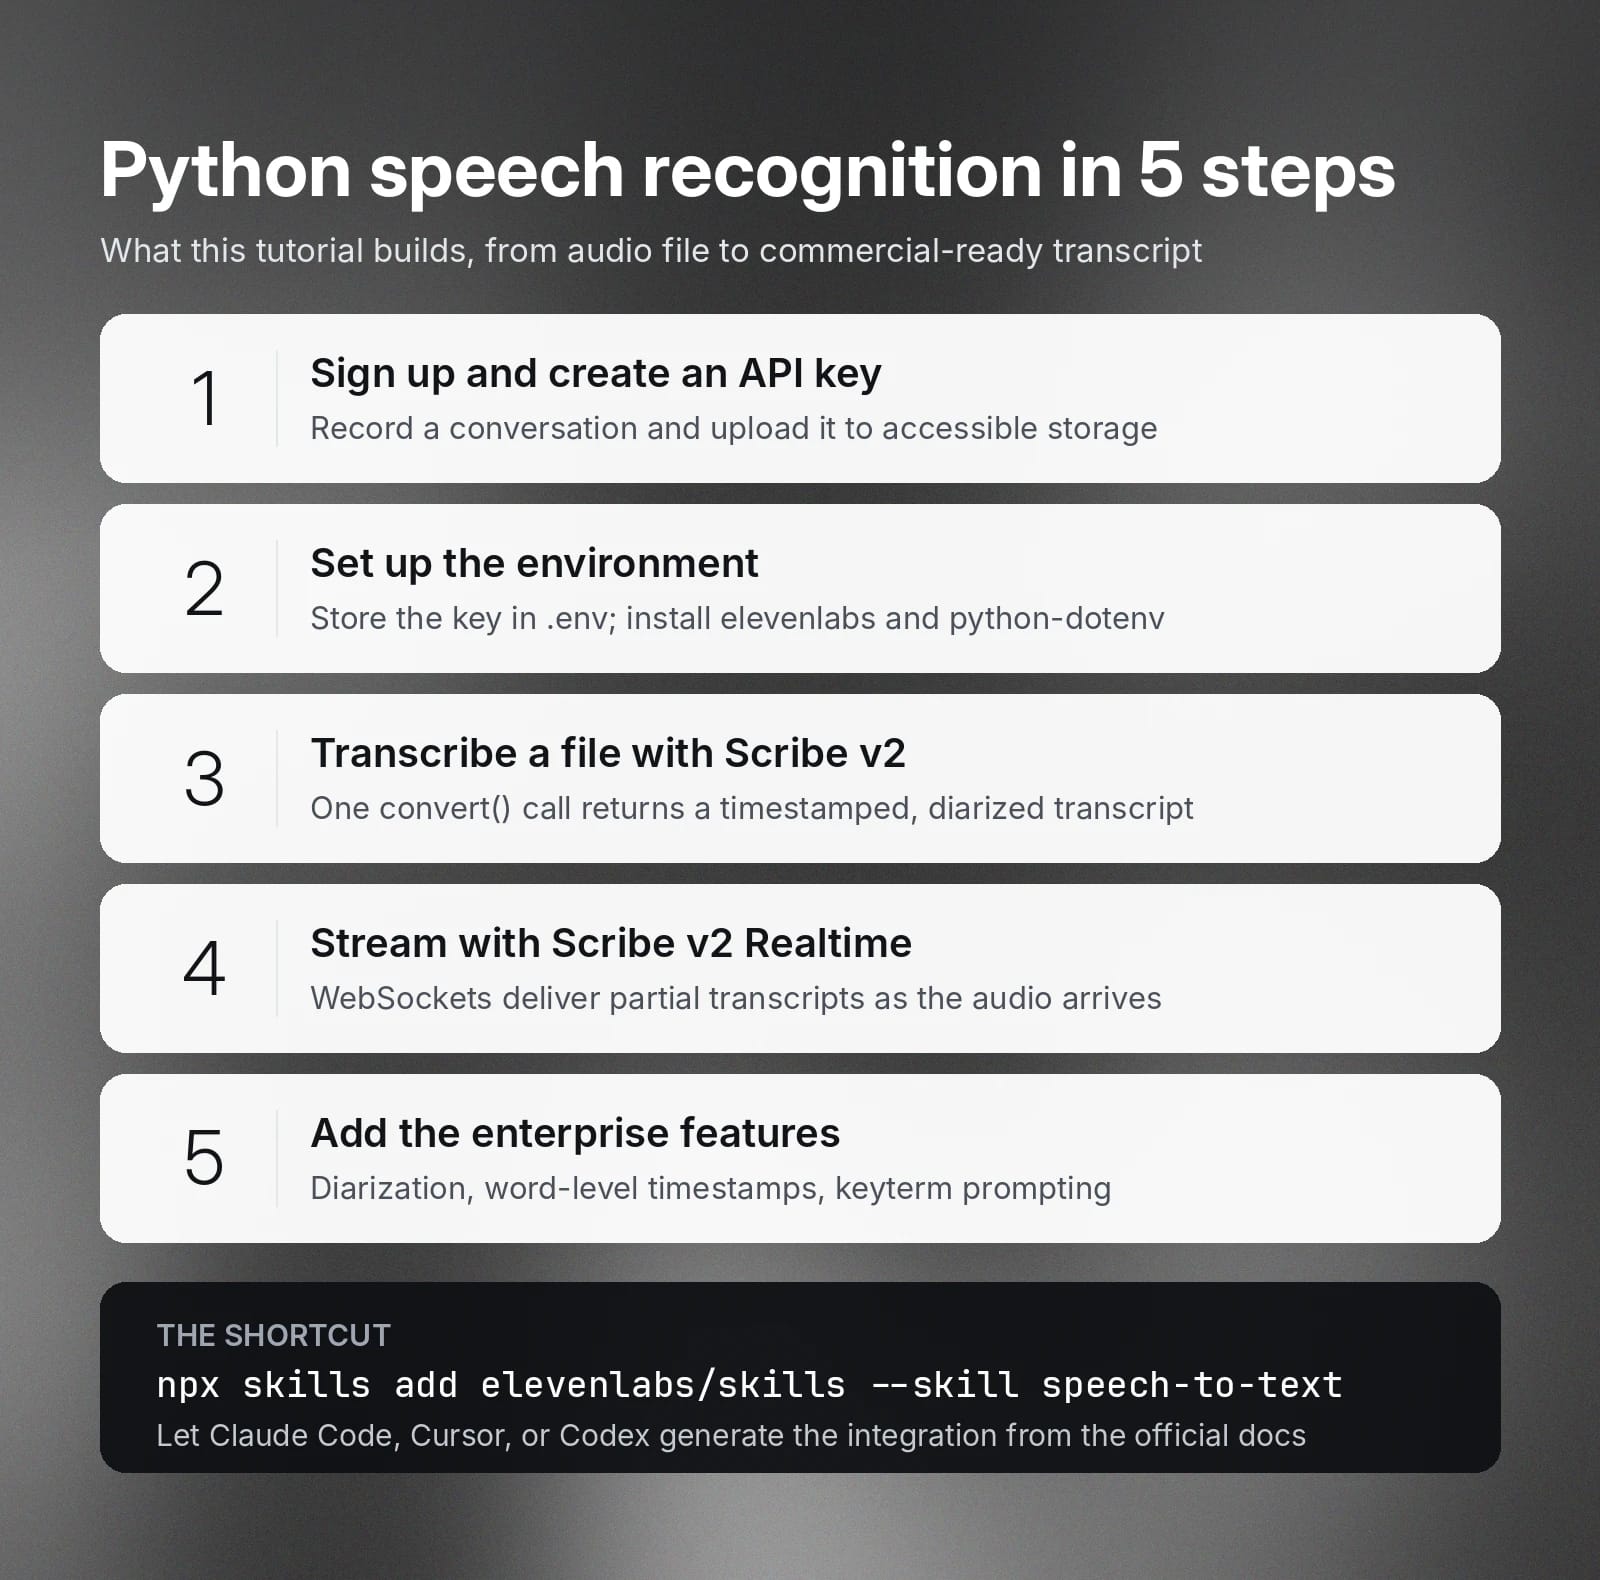
Qué abarca este tutorial sobre reconocimiento de voz con Python
Este tutorial abarca los requisitos previos, la integración de la API y funciones avanzadas de transcripción que te ayudan a crear una app de reconocimiento de voz con Python para casos de uso empresariales.
El reconocimiento de voz ha madurado en los últimos años, especialmente porque los modelos de lenguaje grandes y las redes neuronales de aprendizaje profundo han cambiado la forma en que desarrolladores de Python usan los SDK de transcripción. Aunque muchos tutoriales muestran cómo crear aplicaciones básicas de transcripción, pocos incluyen las funciones que necesita un producto listo para uso comercial.
Hemos escrito este tutorial para cubrir esa necesidad.
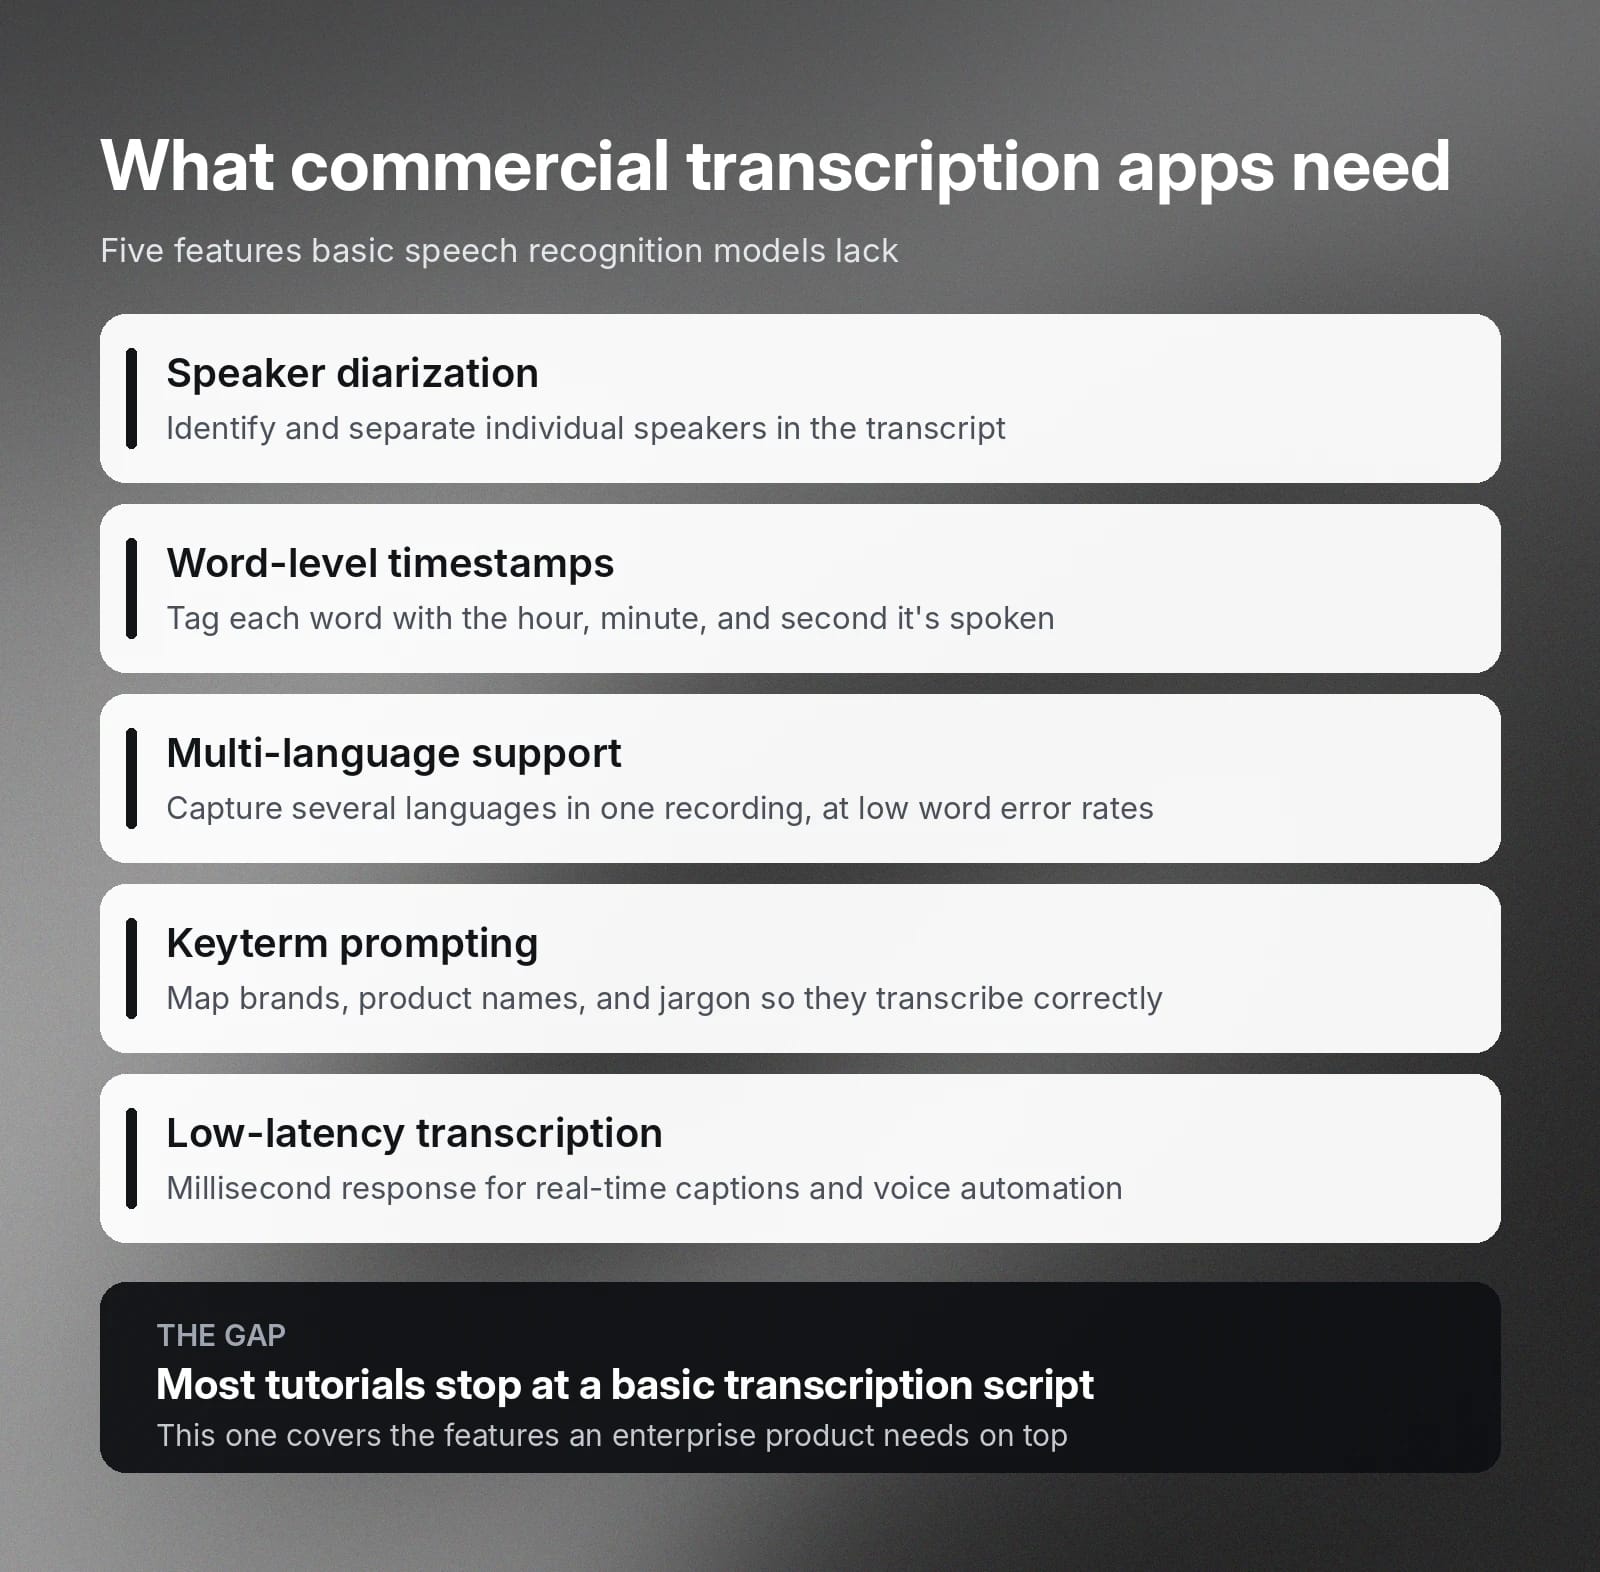
Por ejemplo, muchas soluciones empresariales de transcripción requieren estas funciones:
- Diarización de hablantes: La capacidad de identificar y separar a cada hablante en la transcripción.
- Marca de tiempo: Etiquetar con precisión cada palabra con las horas, minutos y segundos relativos en los que se pronuncia.
- Compatibilidad con varios idiomas: Captura intervenciones en distintos idiomas dentro de una misma grabación o transmisión en directo con bajas tasas de error por palabra.
- Prompting de términos clave: Asignar palabras especiales, como marcas, nombres de productos y términos técnicos, para evitar errores ortográficos en las transcripciones.
- Transcripción de baja latencia: Una respuesta de voz a texto en milisegundos que impulsa aplicaciones de transcripción en tiempo real.
Nota: Este tutorial va más allá de generar scripts personales sencillos para aficiones o proyectos personales. No incluye la lógica de aplicación creada sobre la integración de la API de Voz a Texto, ya que varía según cada negocio.
Requisitos previos para integrar el reconocimiento de voz con Python
Hemos diseñado este tutorial en torno a ElevenAPI, una API de ElevenLabs lista para producción que simplifica la interacción con modelos de voz en tu código. Con ElevenAPI, tienes acceso a Scribe v2 y Scribe v2 Realtime, nuestros modelos de voz líderes para transcripción por lotes y en directo.
En lugar de acceder directamente a los modelos de Voz a Texto de ElevenLabs, envías grabaciones de audio, transmisiones en directo y argumentos mediante llamadas a la API. Después, el modelo de audio convierte los datos de audio en texto. Al terminar, recibes las transcripciones en el código o mediante un webhook.
Para empezar, sigue estos pasos de preparación.
- Regístrate en ElevenLabs.
- Crea tu clave de API.
- Graba una conversación y súbela a un almacenamiento de acceso público.
Cuando estés listo, pasa a la siguiente sección.
Configura tu entorno
Antes de integrar los modelos de ElevenLabs, configura tu entorno de Python para proteger tu clave de API de ElevenLabs. Como con todas las claves de API, te recomendamos guardarla como variable de entorno (un secreto gestionado) en el archivo .env.
Cuando haces una llamada a la API, pasas la variable de entorno. Así evitas exponer accidentalmente la clave de API al realizar solicitudes a la API a través de una red pública.
A continuación, ejecuta un comando de Bash para instalar elevenlabs, el SDK de ElevenLabs, en tu entorno de Python. El SDK te permite acceder a varios modelos de voz. En este caso, puedes elegir entre Scribe v2 y Scribe v2 Realtime.
También tendrás que instalar python-dotenv, que permite que tu código de Python acceda a las variables de entorno almacenadas en el archivo .env.
Escribe tu primer script de transcripción
Una vez que hayas configurado el entorno de Python, podrás transcribir el archivo de audio con ElevenLabs Scribe v2.
ElevenLabs Scribe v2 es un modelo de reconocimiento de voz líder en el sector que te permite transcribir archivos de audio a gran escala. Detecta fonemas con gran precisión incluso cuando la grabación contiene un nivel considerable de ruido de fondo. Para transcribir audio, envías la grabación al modelo mediante la API de ElevenLabs y recuperas la transcripción completada.
A continuación tienes un fragmento de código de Python que convierte un archivo de audio en una transcripción con marcas de tiempo y diarización.
El código carga las bibliotecas necesarias, que proporcionan las funciones que necesita. También carga en el entorno del programa las variables de entorno que declaraste.
Después, crea un cliente de ElevenLabs con la clave de API almacenada en la variable de entorno. A continuación, descarga el archivo de audio y lo convierte en datos binarios.
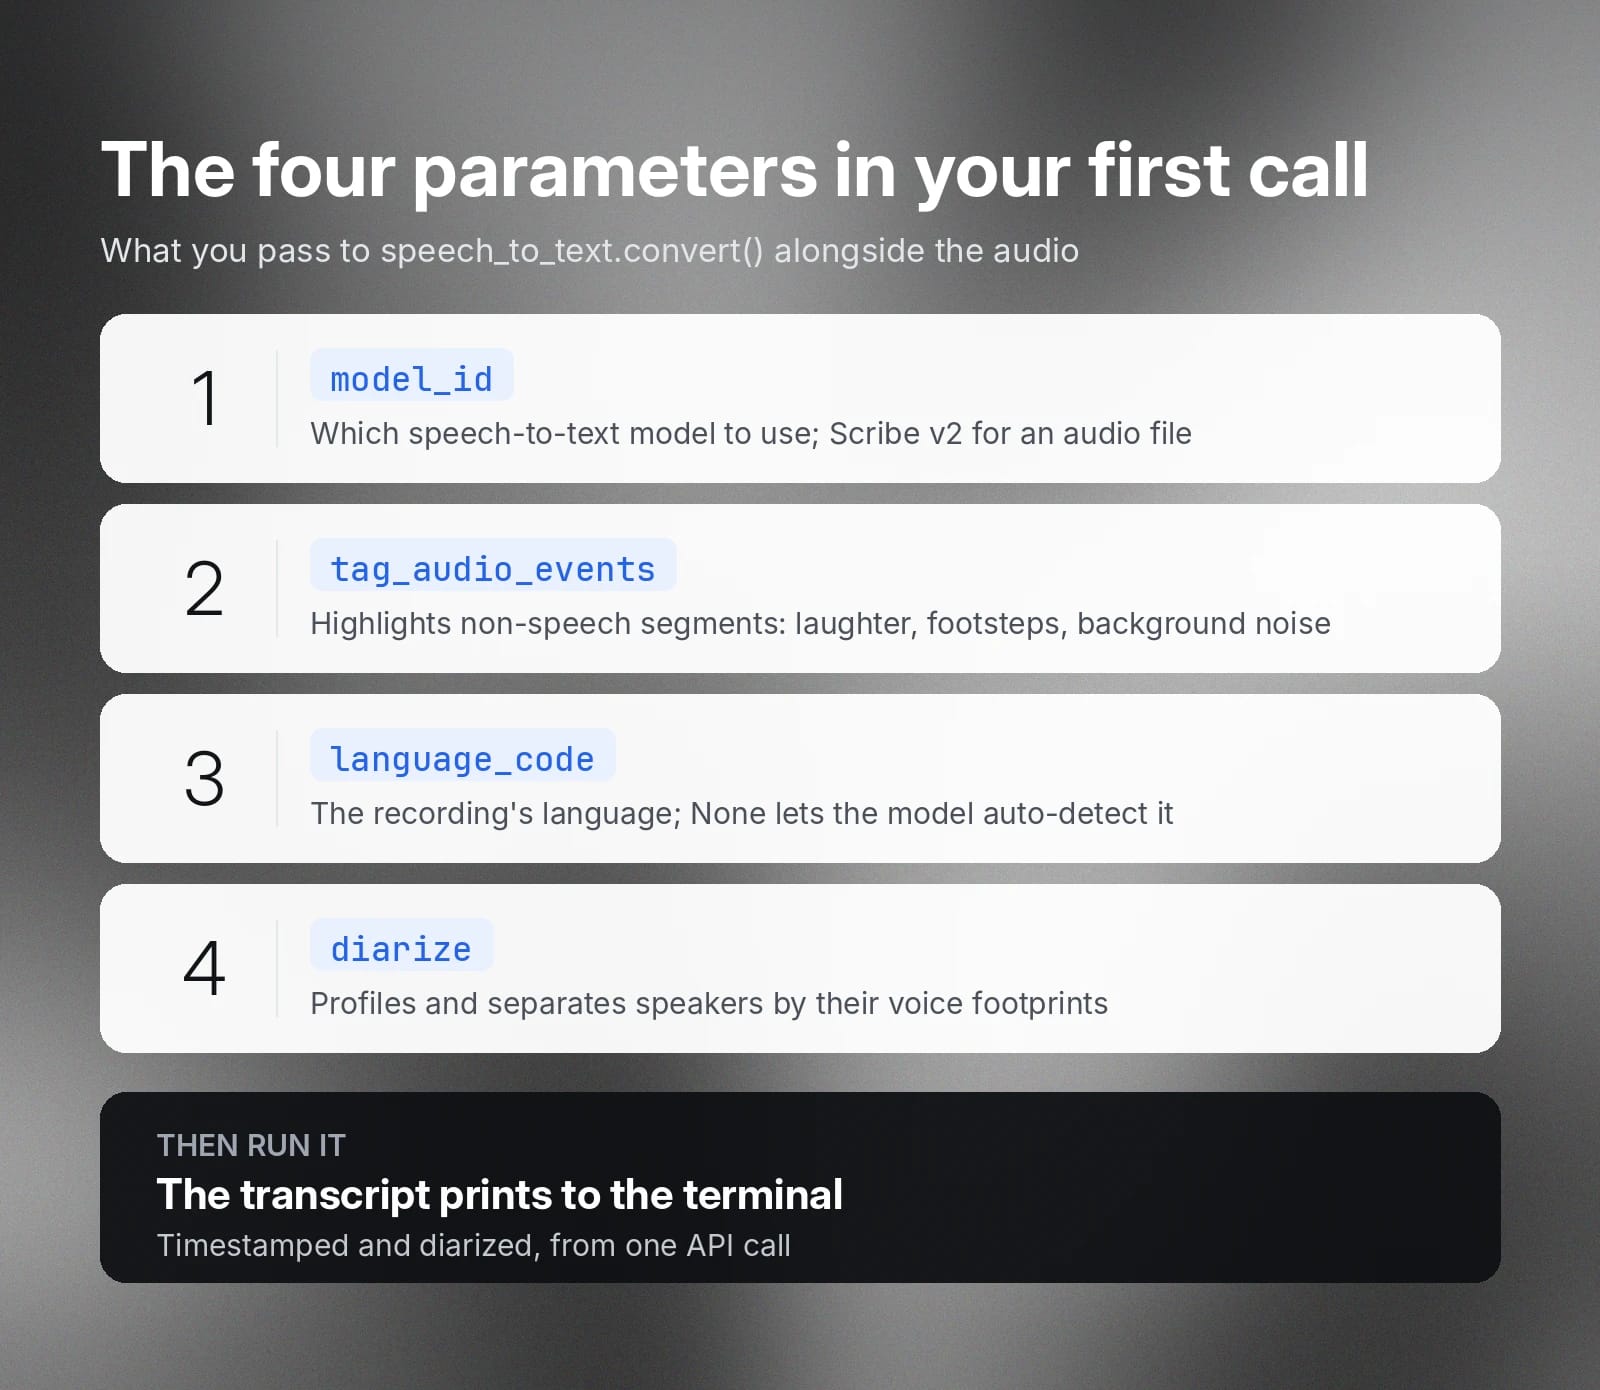
Cuando tengas los datos de audio sin procesar, los envías a la API de ElevenLabs junto con varios parámetros.
- model_id indica el modelo de voz a texto que quieres usar. Como envías un archivo de audio, Scribe v2 es la mejor opción.
- tag_audio_events te permite destacar segmentos que no contienen voz, como risas, pasos y otros ruidos de fondo.
- language_code representa el idioma de las conversaciones del archivo de grabación. Cuando se establece en None, el modelo detectará automáticamente el idioma.
- diarize indica si quieres que el modelo identifique y separe a los distintos hablantes según las características de sus voces.
Por último, ejecuta el código y verás el audio transcrito en la terminal.
Reconocimiento de voz en streaming con Python
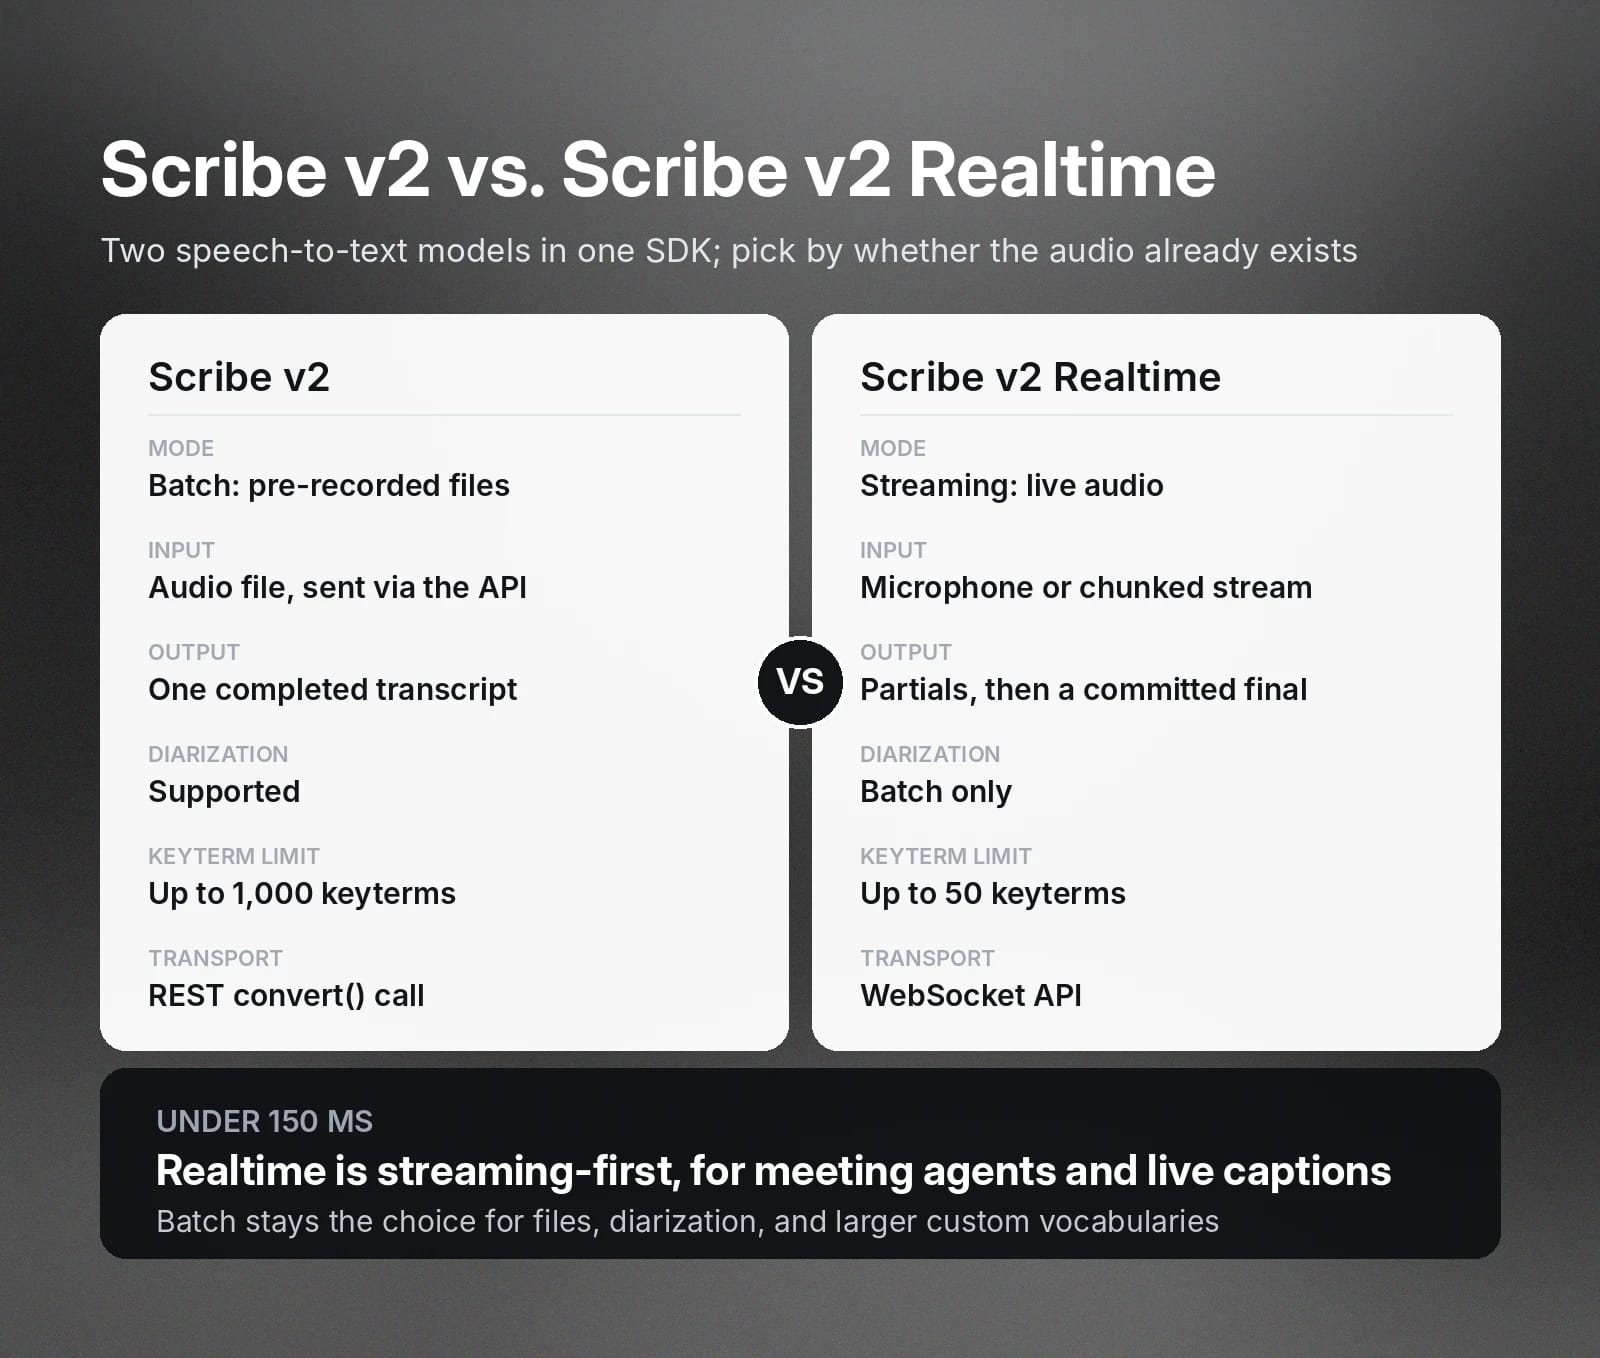
El ejemplo anterior trata la transcripción por lotes, adecuada para archivos pregrabados. Sin embargo, ElevenLabs también ofrece API que te permiten crear reconocimiento de voz en streaming. A diferencia del procesamiento por lotes, este modo ejecuta el reconocimiento de voz en tiempo real para generar transcripciones mientras tiene lugar la conversación.
Para ello, conectas tu código de Python con el modelo Scribe v2 Realtime mediante la API de WebSocket.
Scribe v2 Realtime ofrece una arquitectura centrada en el streaming con una latencia de transcripción inferior a 150 ms. Puedes usar Scribe v2 Realtime para crear aplicaciones como agentes para reuniones, herramientas de accesibilidad y automatización activada por voz. El modelo devuelve una transcripción parcial mientras procesa el flujo de audio. Solo devuelve la transcripción final cuando el código confirma un segmento de audio, de forma automática o manual.
Según la fuente de audio y el tipo de aplicación, integrarás el reconocimiento de voz con la API de ElevenLabs en el lado del servidor o del cliente.
- Streaming del lado del cliente te permite transmitir directamente desde el micrófono o mediante flujos de audio divididos manualmente en fragmentos.
- Streaming del lado del servidor dirige los datos de audio desde una URL o una fuente de audio al modelo de voz.
El streaming tanto del lado del cliente como del servidor te permite usar un workflow asíncrono. En lugar de consultar la API continuamente, usa WebSockets para gestionar los resultados. En tu código, debes crear controladores que reciban transcripciones parciales y finalizadas.
Más allá: diarización, marcas de tiempo y vocabulario personalizado
Además del reconocimiento automático de voz, los modelos de Voz a Texto de ElevenLabs admiten diarización, marcas de tiempo y vocabulario personalizado.
- Diarización: Solo la transcripción por lotes admite la diarización de hablantes. Activas la diarización estableciendo el argumento diarize. Sin embargo, la transcripción multicanal, un modo dentro de la transcripción por lotes, no admite diarización.
- Marcas de tiempo: Al realizar una transcripción por lotes, puedes elegir entre marcas de tiempo por palabra o por carácter. Para ello, establece el parámetro timestamps_granularity al usar el método convert.
- Vocabulario personalizado: Tanto la transcripción en tiempo real como por lotes admiten prompting de términos clave. Esta función orienta al modelo para transcribir términos clave específicos que incluyes en una lista. Scribe v2 Realtime admite hasta 50 términos clave, mientras que Scribe v2 admite 1000.
Usa la habilidad de ElevenLabs en asistentes de programación con IA
Los asistentes de programación con IA aceleran el desarrollo. Si usas herramientas como Claude Code, Cursor, Codex u otras herramientas de programación con IA similares, puedes añadir habilidades de ElevenLabs al entorno de programación.
Solo tienes que ejecutar este comando en la terminal de tu plataforma:
El agente de programación con IA descargará la habilidad de voz a texto del repositorio de GitHub de ElevenLabs y la instalará en el directorio local de habilidades. Esto te permite generar automáticamente código de Python para reconocimiento de voz a partir de la documentación oficial de ElevenLabs, en lugar de escribir desde cero toda la integración de la API.
Una vez instalada, puedes generar código de Python para reconocimiento de voz simplemente describiendo de forma conversacional lo que debe hacer. A partir de la descripción, el asistente de programación genera automáticamente código con la habilidad de voz a texto, el modelo correcto y los parámetros adecuados.
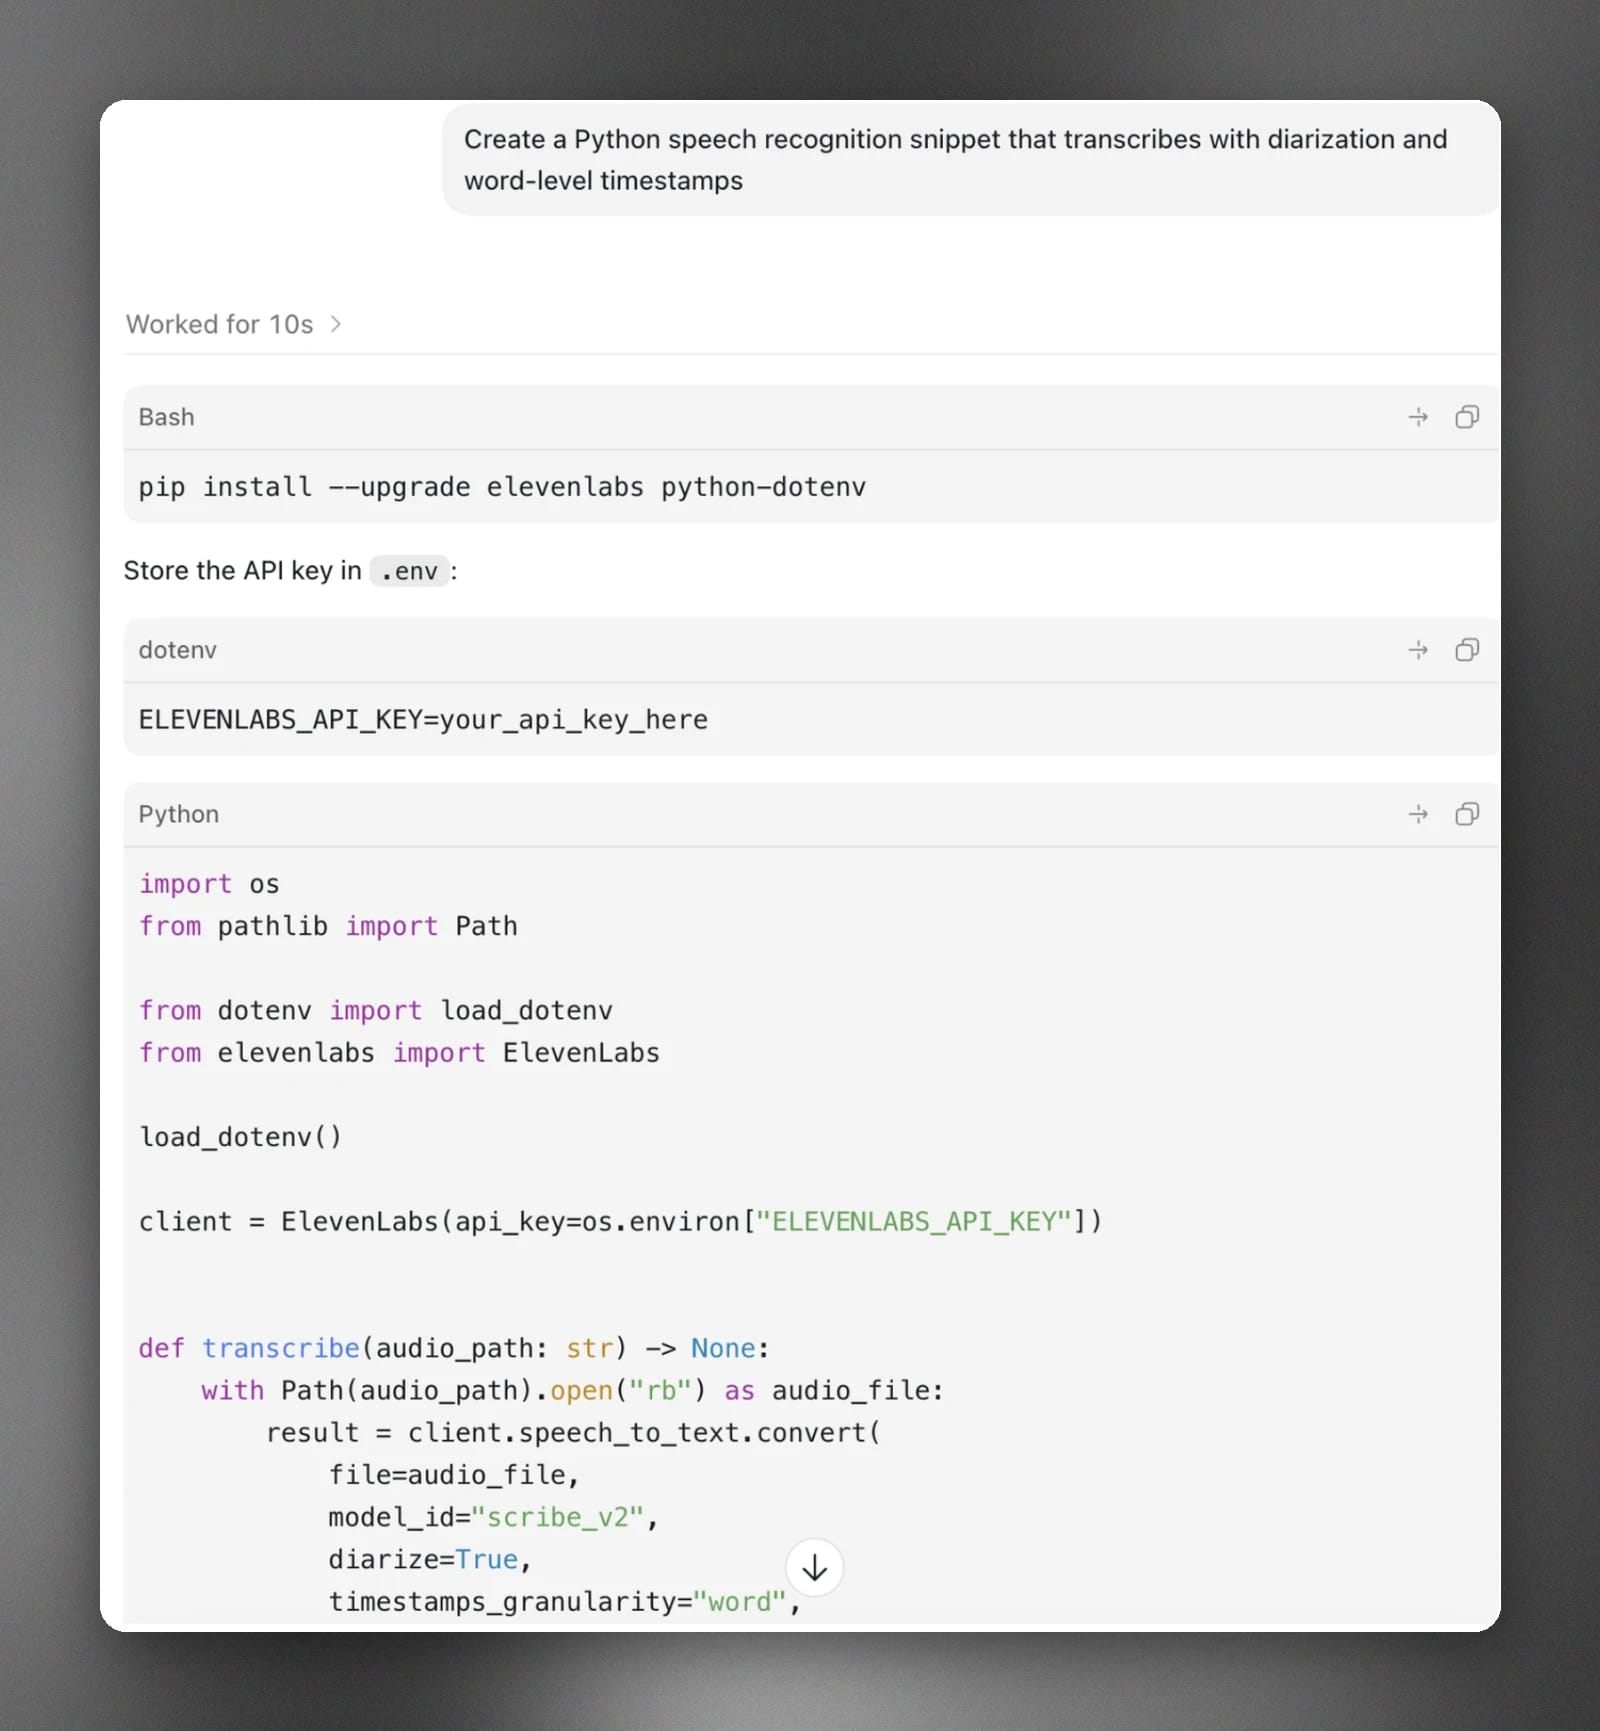
Por ejemplo, si escribes «Crea un fragmento de Python para reconocimiento de voz que transcriba con diarización y marcas de tiempo por palabra» en Codex, obtendrás un fragmento similar al de abajo.
Empieza a usar ElevenAPI para el reconocimiento de voz
ElevenAPI te permite acceder a modelos avanzados de Voz a Texto para crear aplicaciones de reconocimiento de voz en Python.
Al usar ElevenAPI, evitas escribir código de integración desde cero, algo que retrasa la innovación de producto. En su lugar, utilizas SDK que ofrecen servicios de Voz a Texto que cumplen requisitos de nivel comercial, como prompting de términos clave, diarización y marcas de tiempo.
Obtén tu clave de API de ElevenLabs ahora y consulta nuestra documentación oficial para aprender cómo funciona la API.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


