Transcripción en tiempo real frente a por lotes: diferencias clave
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
Al elegir un modelo de transcripción con IA, tienes dos opciones: transcripción en tiempo real o por lotes. Ambas convierten voz en texto, pero funcionan de forma distinta.
La transcripción en tiempo real procesa el audio a medida que se produce, mientras que la transcripción por lotes procesa una grabación de audio completa cuando ha terminado. Aunque la transcripción en tiempo real ofrece resultados instantáneos, la transcripción por lotes suele ser más precisa.
En esta guía, compararemos la transcripción en tiempo real y por lotes para ayudarte a elegir el modelo adecuado para tu próximo proyecto. Explicaremos cómo funciona cada modelo, sus ventajas e inconvenientes y sus casos de uso habituales.
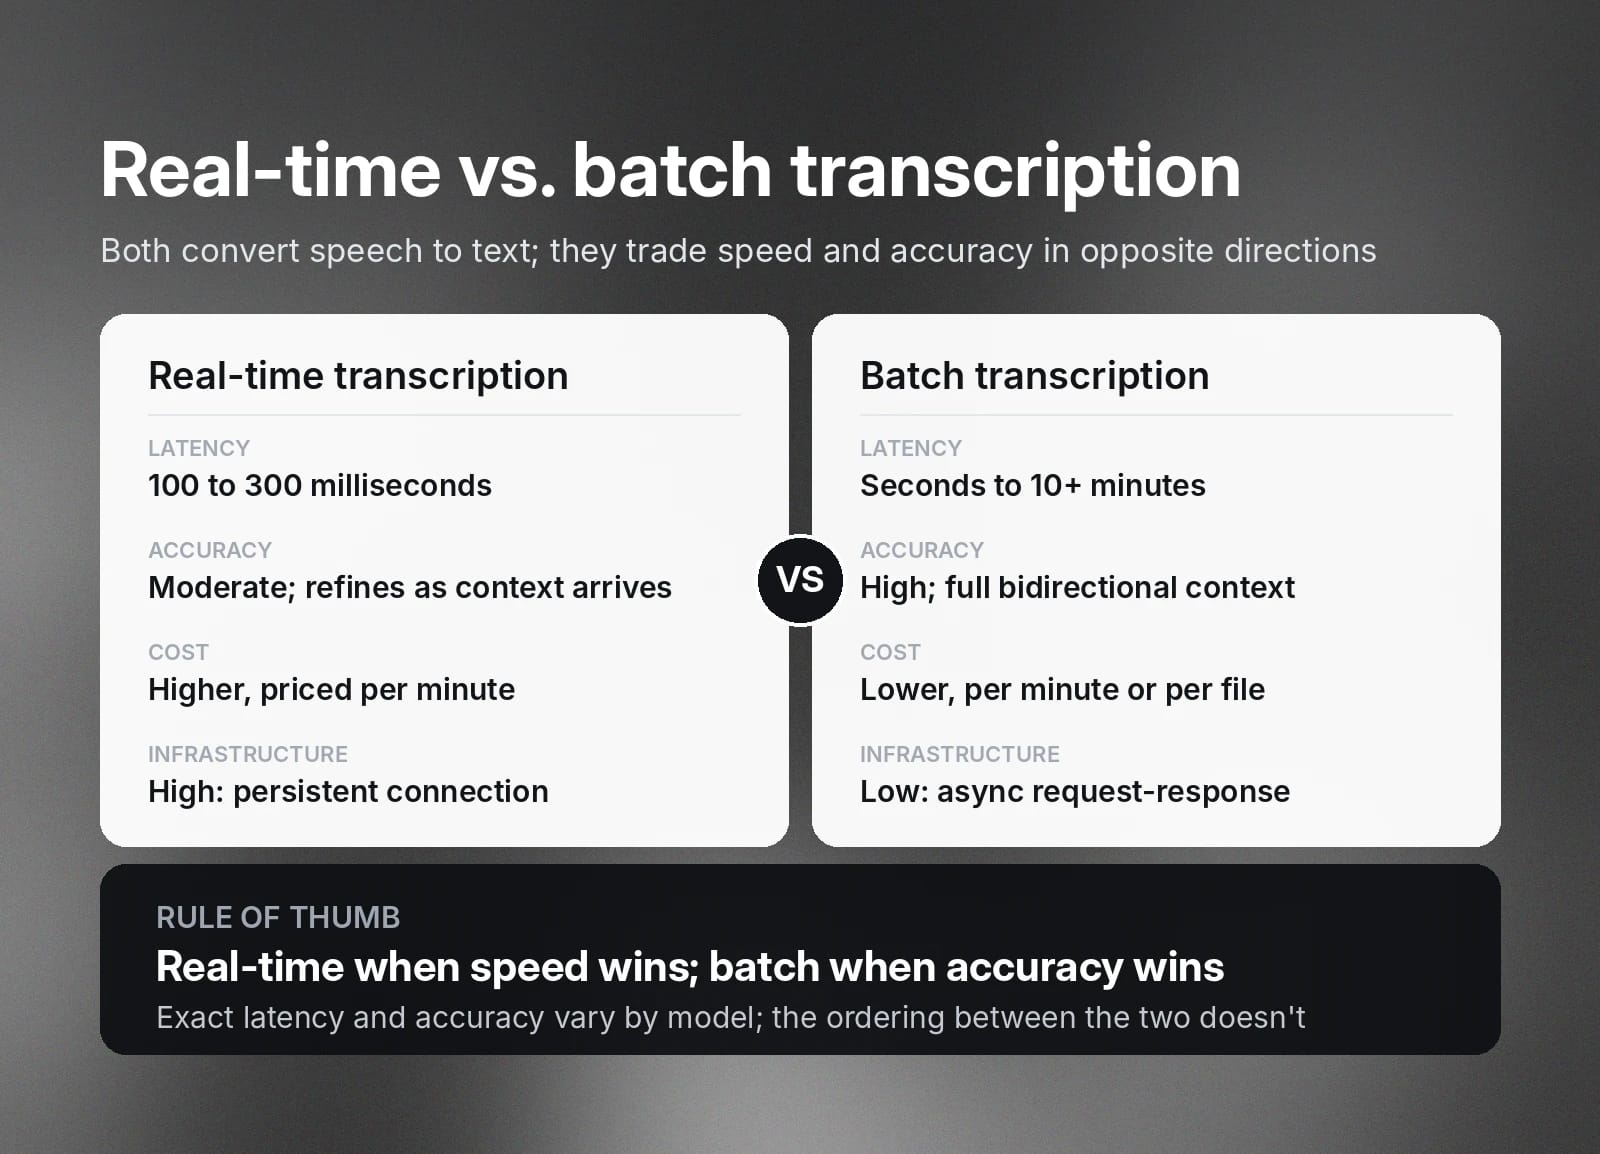
Resumen
- La transcripción en tiempo real procesa el audio a medida que se produce.
- La transcripción por lotes procesa un archivo de audio completo de una sola vez.
- La transcripción en tiempo real es más rápida, pero la transcripción por lotes es más precisa porque el modelo cuenta con contexto bidireccional de todo el archivo de audio.
- La transcripción en tiempo real es ideal para aplicaciones como agentes de voz en directo, subtítulos de vídeo en directo o notas de reuniones, donde la velocidad importa más que la precisión.
- La transcripción por lotes es más precisa y rentable para transcribir audio en grandes cantidades una vez grabado.
¿Qué es la transcripción en tiempo real en STT?
La transcripción en tiempo real ocurre cuando un modelo de voz a texto (STT) convierte el audio en texto escrito a medida que se produce. También se conoce como transcripción en streaming.
Con la transcripción en tiempo real, el modelo STT procesa el audio en pequeños fragmentos. El texto escrito está disponible apenas unos milisegundos después de pronunciarse las palabras. A medida que avanza la conversación, el modelo STT recopila más datos y contexto, y usa esta información para refinar la transcripción.
Esta modalidad de transcripción funciona mejor cuando la velocidad importa más que la precisión. Por ejemplo, estos modelos hacen que las transmisiones de audio y vídeo sean más accesibles con subtítulos en tiempo real. Otro caso de uso habitual son las plataformas de toma de notas en tiempo real.
¿Qué es la transcripción por lotes en STT?
La transcripción por lotes convierte una grabación de audio completa de voz a texto de una sola vez, una vez que termina la grabación. El proceso puede durar desde unos segundos hasta más de 10 minutos, según la duración y complejidad de la grabación.
Los modelos de transcripción por lotes usan el contexto de toda la grabación mientras trabajan. Disponer del contexto completo ayuda al modelo a interpretar con precisión fragmentos con lenguaje complejo, ruido de fondo o interrupciones. Los modelos de transcripción por lotes también añaden puntuación y formato, algo con lo que algunos modelos en tiempo real pueden tener dificultades.
La transcripción por lotes funciona mejor cuando la precisión es la máxima prioridad. Muchas organizaciones usan modelos por lotes para transcribir entrevistas largas, reuniones o pódcasts para sus archivos.
Cómo las arquitecturas por lotes y de streaming determinan la transcripción
Al comparar el procesamiento por lotes y en streaming para la transcripción, ambos modelos emplean procesos fundamentalmente distintos que afectan al resultado final.
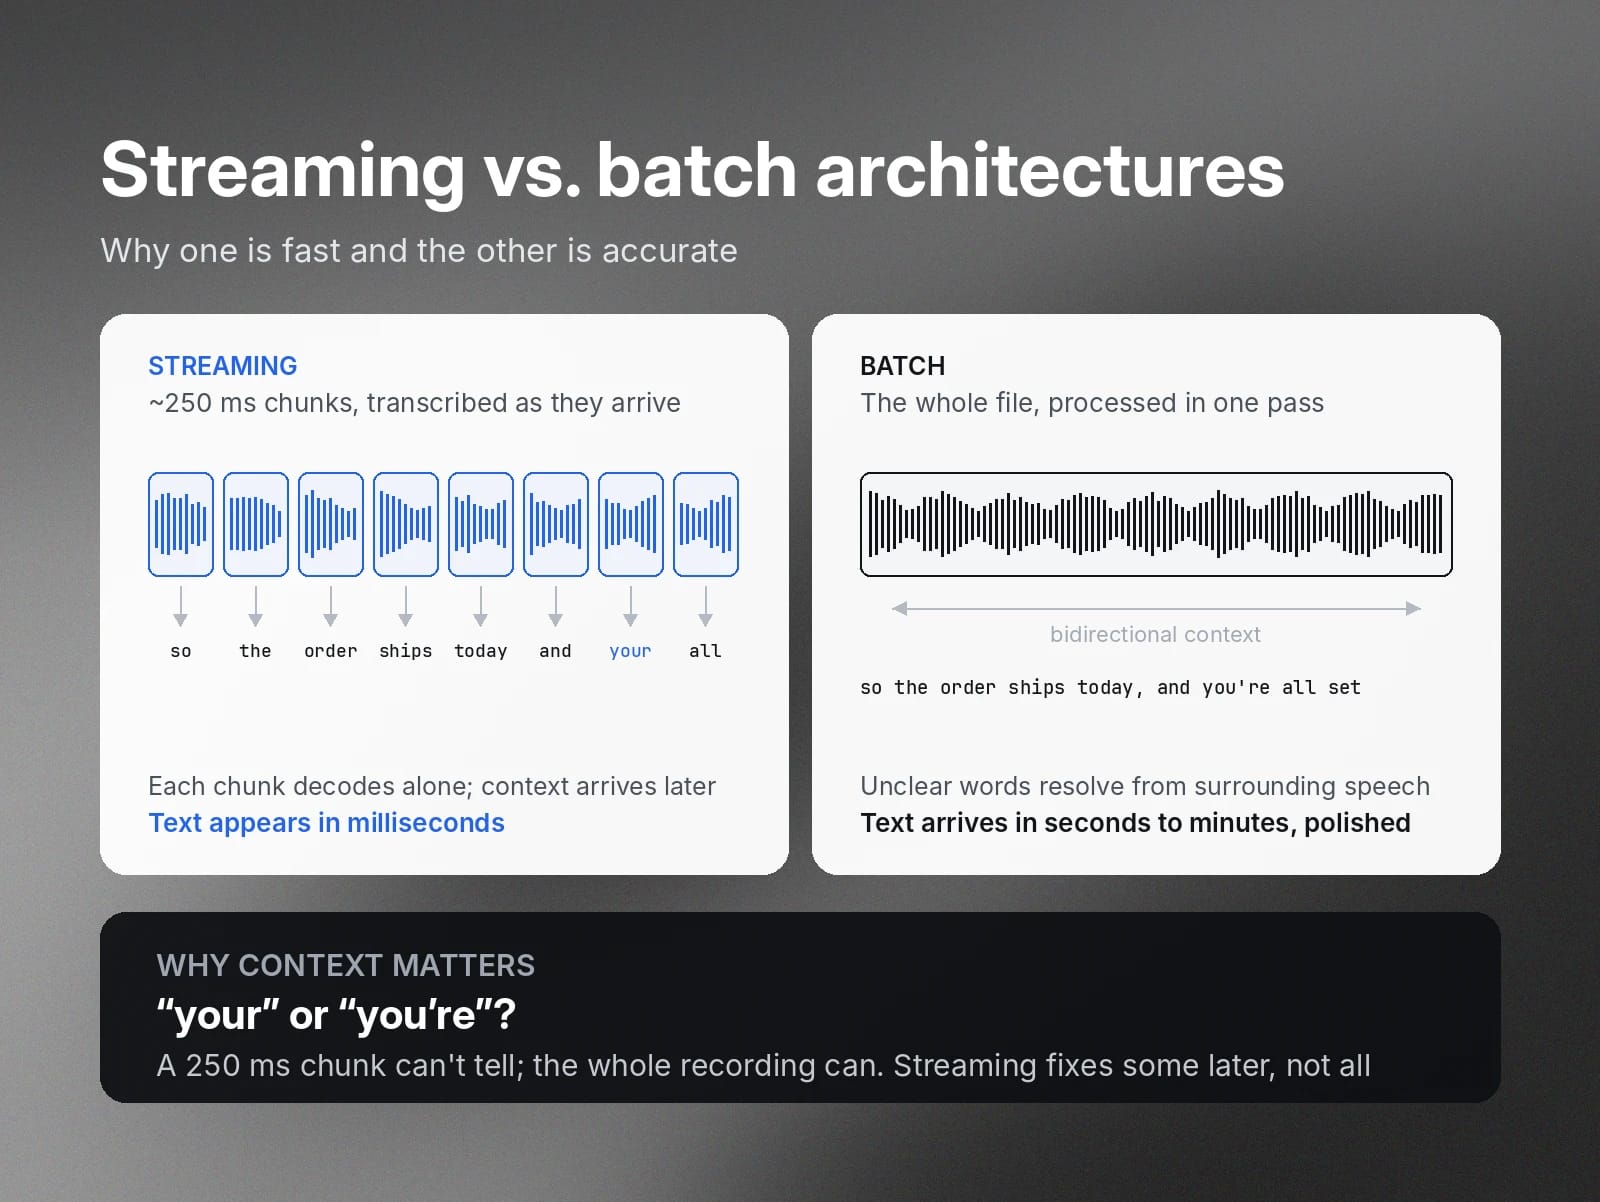
Los modelos de transcripción en streaming dividen el audio en fragmentos y transcriben cada uno a medida que se produce. Estos fragmentos son muy pequeños, normalmente de unos 250 milisegundos o menos. Al procesar el audio en este formato, el modelo de transcripción puede trabajar rápido y hacer que el texto aparezca apenas unos segundos después de producirse el audio.
Como estos fragmentos de audio son tan pequeños, el modelo de Voz a Texto no cuenta con el contexto completo de la conversación, lo que puede provocar errores. Por ejemplo, el modelo de transcripción podría confundir «valla» con «vaya».
Un modelo de transcripción en tiempo real corregirá algunos de estos errores a medida que continúe la conversación y el contexto se aclare. Sin embargo, normalmente no hay suficiente tiempo ni contexto para corregir todos los errores, por lo que la transcripción final no siempre es 100 % precisa.
Por otro lado, los modelos de transcripción por lotes procesan todo el archivo de audio de una sola vez. Esto significa que el modelo de transcripción tiene contexto bidireccional de la conversación, que usa para resolver palabras o frases poco claras. Cuando algo no está claro en el archivo de audio, el modelo analiza las palabras anteriores y posteriores para determinar qué se dijo y transcribirlo con precisión.
Este contexto adicional hace que los modelos de transcripción por lotes sean más lentos que los modelos de transcripción en tiempo real. Sin embargo, el resultado final es mucho más preciso y pulido.
Características clave de los modelos de transcripción en tiempo real y por lotes: latencia, precisión y coste
Tanto los modelos en tiempo real como los modelos por lotes son eficaces para la transcripción: todo depende del tipo de proyecto en el que trabajes. Algunos proyectos requieren resultados instantáneos, mientras que otros necesitan altos niveles de precisión.
Estos son los factores que debes tener en cuenta al elegir entre transcripción en tiempo real y por lotes:
Transcripción en tiempo real | Transcripción por lotes | |
Latencia | De 100 a 300 milisegundos | Desde segundos hasta más de 10 minutos, según la duración del archivo |
Precisión | Moderada | Alta |
Coste | Alto, con precio por minuto | Moderado, con precio por minuto o por archivo |
Complejidad de la infraestructura | Alta, requiere conexión continua y equilibrio de carga | Baja, usa una estructura asíncrona de solicitud-respuesta |
Las cifras exactas de latencia y precisión varían según el modelo de transcripción específico que uses. Sin embargo, la transcripción en tiempo real es siempre más rápida, mientras que la transcripción por lotes es más precisa.
La transcripción en tiempo real cuesta más que la transcripción por lotes porque requiere una infraestructura más compleja y tiene mayores costes operativos. Los modelos en tiempo real necesitan una conexión continua para mantener su velocidad y tardan más en configurarse y mantenerse que los modelos por lotes.
Los modelos en tiempo real merecen la inversión para garantizar la accesibilidad durante conversaciones en directo. Sin embargo, usar transcripción por lotes ahorra dinero y tiempo de configuración en proyectos donde la velocidad no es prioritaria.
Comparativa de API de transcripción en tiempo real y por lotes: elige la mejor opción para tu proyecto
Antes de empezar un nuevo proyecto de transcripción, tendrás que evaluar las ventajas e inconvenientes de los modelos por lotes y en tiempo real para ver cuál se adapta mejor a tus objetivos. Así es el proceso de decisión en tres situaciones reales.
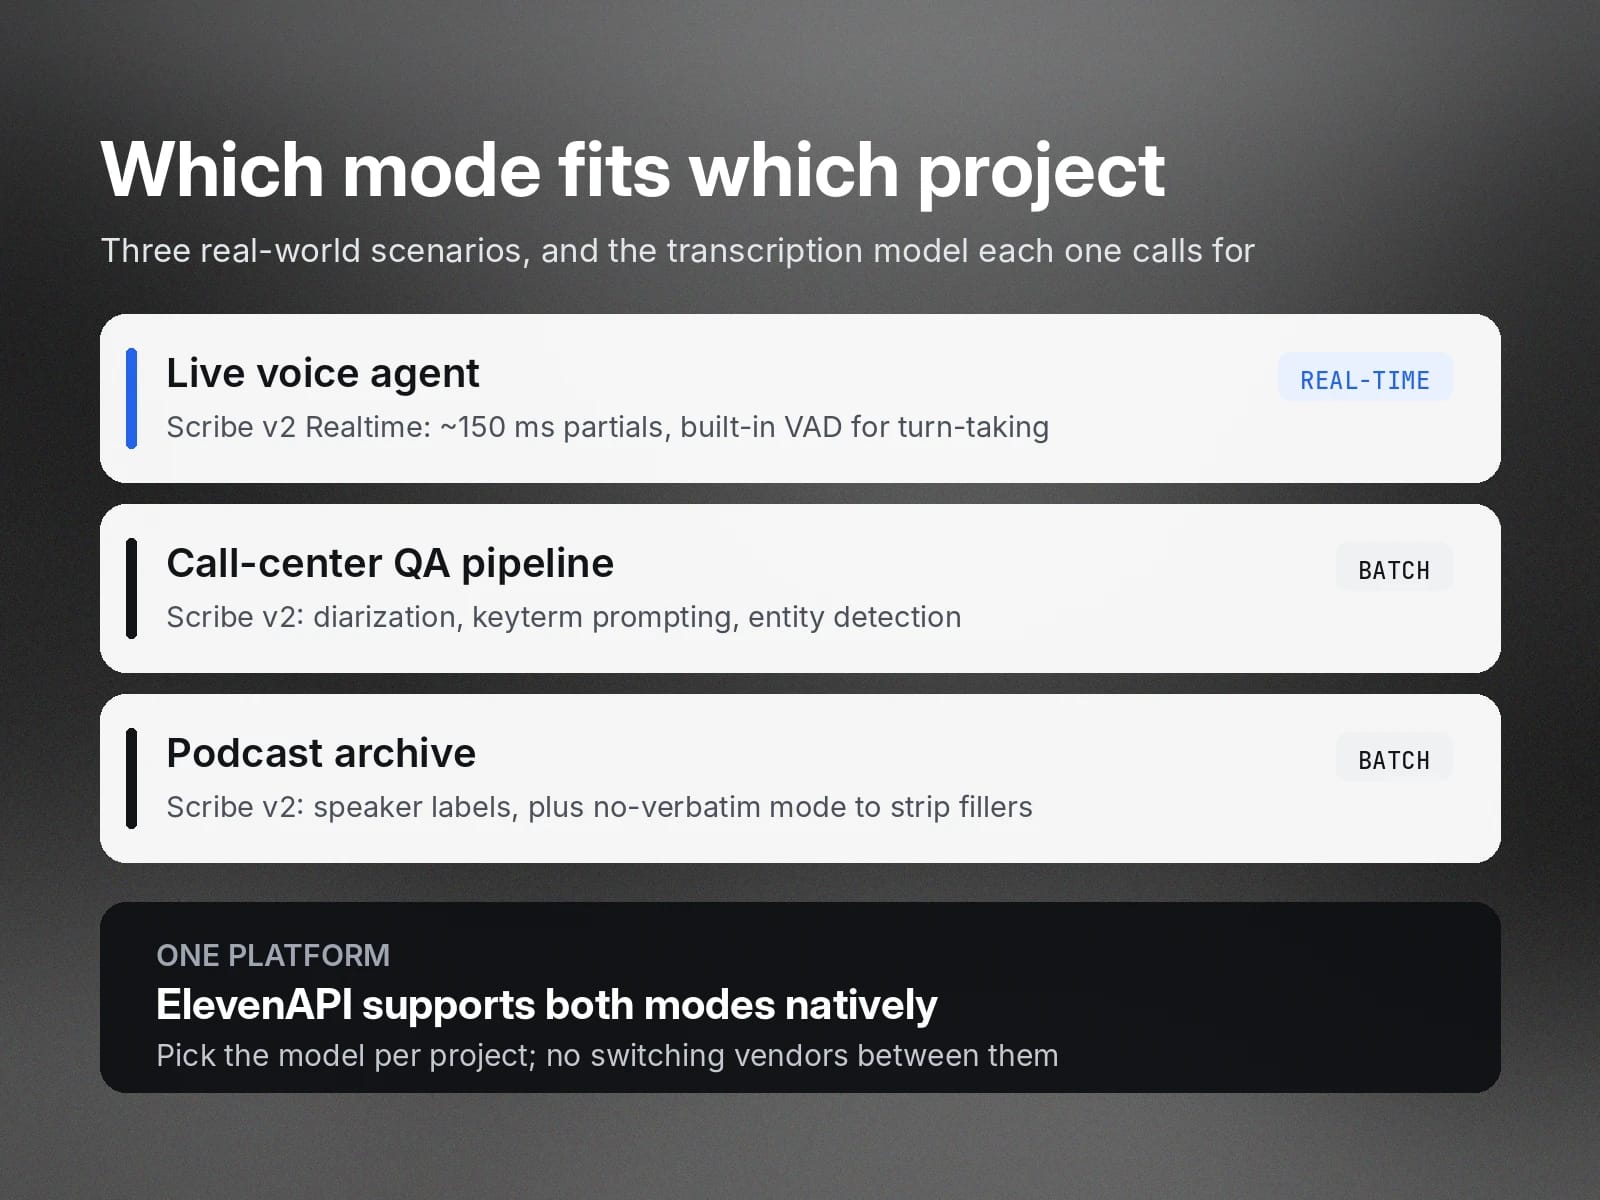
Agente de voz en directo: Transcripción en tiempo real
Los modelos de IA conversacional en directo requieren una transcripción casi instantánea para garantizar la accesibilidad, especialmente al gestionar retos operativos complejos o de atención al cliente.
Un modelo en tiempo real, como Scribe v2 Realtime, ofrece la baja latencia necesaria para mantener conversaciones fluidas y naturales. Scribe v2 Realtime proporciona transcripciones parciales en aproximadamente 150 milisegundos.
Los modelos de transcripción para agentes de voz en directo también requieren una gestión precisa de los turnos de palabra. Esto significa que deben poder detectar cuándo un usuario ha empezado o terminado de hablar y responder de inmediato. Una gestión eficaz de los turnos de palabra y las interrupciones ayuda a evitar que la transcripción se quede atrás respecto a la conversación.
Los modelos de transcripción en tiempo real priorizan una gestión precisa de los turnos de palabra para ofrecer resultados rápidos. Por ejemplo, Scribe v2 Realtime incorpora Detección de Actividad de Voz, por lo que segmenta automáticamente la transcripción cuando detecta silencio entre participantes.
Proceso de control de calidad de un centro de llamadas: Transcripción por lotes
La precisión es clave al realizar controles de calidad, así que un modelo de transcripción por lotes como Scribe v2 es la opción más adecuada en este caso.
Las transcripciones de centros de llamadas suelen contener nombres únicos y detalles específicos del sector. Si no se transcriben correctamente, resulta difícil para analistas determinar si una llamada ha tenido éxito o no. Dado que los modelos por lotes procesan toda la grabación de una vez, disponen del contexto necesario para una transcripción y un formato precisos.
Scribe v2 cuenta con varias funciones para mejorar la precisión de la transcripción. La diarización de hablantes garantiza que agentes y clientes estén siempre correctamente identificados, incluso cuando hablan a la vez. El prompting de términos clave proporciona al modelo nombres de marcas y términos del sector de antemano para que los transcriba con precisión.
Las transcripciones de centros de llamadas también pueden contener información sensible que debe ocultarse, como números de la Seguridad Social y de tarjetas de crédito. Scribe v2 cuenta con detección de entidades para localizar estos datos sensibles y marcar su momento exacto, de modo que puedas eliminarlos.
Archivo de pódcasts: Transcripción por lotes
Al crear un archivo de pódcasts, necesitas transcripciones pulidas que tu equipo y tu audiencia puedan consultar en cualquier momento. La precisión y un formato limpio son esenciales en este caso, por lo que la transcripción por lotes es la opción adecuada.
Con la transcripción por lotes, obtienes transcripciones precisas con identificación de hablantes y diarización en todos tus archivos de pódcasts. Scribe v2 también cuenta con el modo sin literalidad, que elimina automáticamente muletillas, tartamudeos y repeticiones. Así dedicarás menos tiempo a la edición manual y podrás crear tu archivo de pódcasts más rápido.
ElevenAPI admite de forma nativa los modos en tiempo real y por lotes. Si gestionas varios proyectos de transcripción a la vez, puedes usar ElevenAPI para administrarlos todos desde la misma plataforma. Solo tienes que elegir el modelo adecuado para cada proyecto, sin la molestia de cambiar constantemente entre proveedores de servicios.
Modelos de transcripción híbridos: unir el tiempo real y los lotes
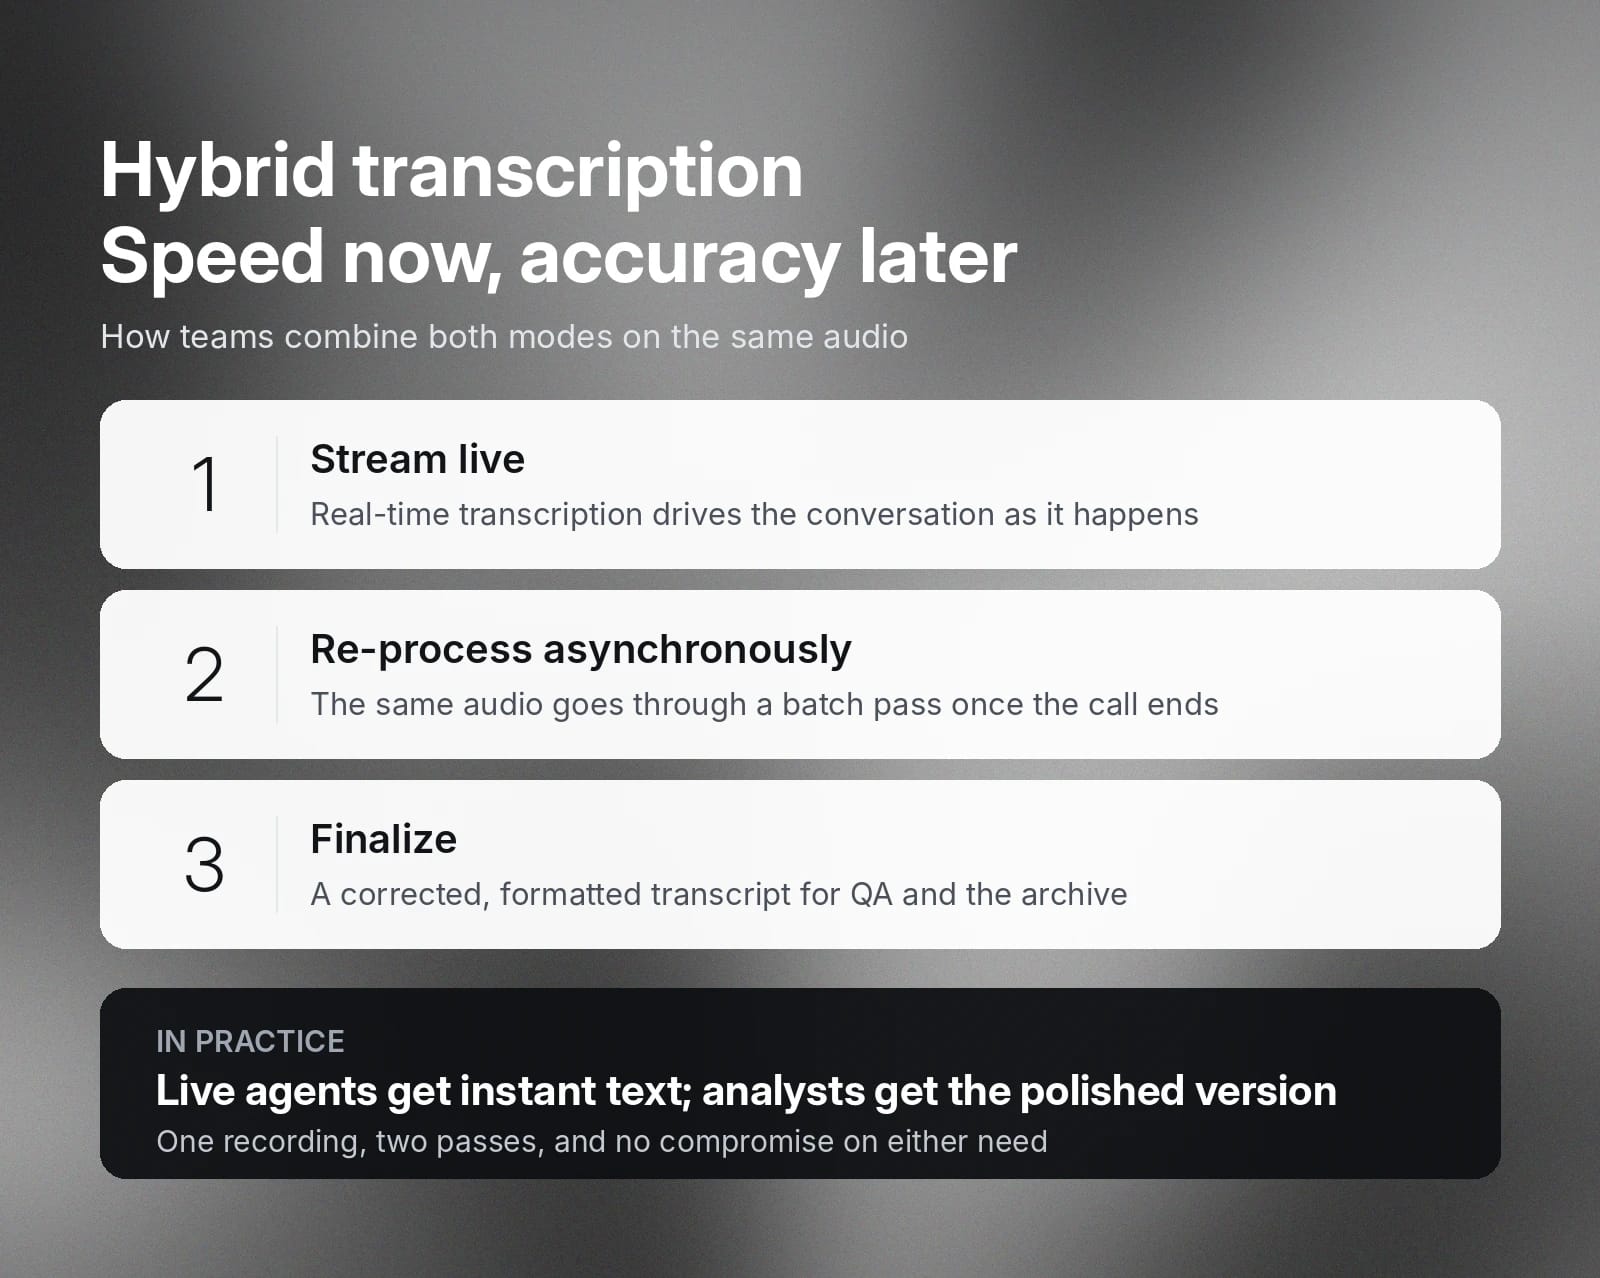
Las arquitecturas de transcripción híbridas combinan modelos en tiempo real y por lotes para equilibrar velocidad y precisión.
Por ejemplo, un equipo de atención al cliente podría usar un modelo híbrido para obtener resultados inmediatos durante conversaciones en directo y, después, pulir la transcripción para el control de calidad y el archivo. Los agentes en directo usan transcripción en tiempo real y luego envían la transcripción inicial a un modelo por lotes para reprocesarla de forma asíncrona.
Así funciona este flujo:
Empieza con ElevenAPI y crea soluciones de transcripción flexibles
ElevenAPI ofrece modelos en tiempo real y por lotes para obtener transcripciones rápidas y precisas en más de 90 idiomas. Los modelos de transcripción líderes del sector de ElevenAPI ofrecen resultados precisos incluso con audio de baja calidad, ruido de fondo o acentos marcados.
ElevenAPI ofrece modelos en tiempo real y por lotes para obtener transcripciones rápidas y precisas compatibles con más de 90 idiomas. Scribe v2 ofrece una precisión de transcripción líder del sector, y Scribe v2 Realtime ofrece una precisión excepcional para casos de uso en directo. Ambos proporcionan resultados fiables incluso con audio de baja calidad, ruido de fondo o acentos marcados.
Ambos modelos están disponibles en la misma plataforma para ayudarte a crear una arquitectura de transcripción que se adapte a tus necesidades. Explora la API de Voz a Texto de ElevenLabs para verla en acción o crea una clave de API para empezar.



