
¿Qué es la diarización de hablantes? Cómo funciona y casos de uso
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
La diarización de hablantes toma un flujo de audio con un número desconocido de hablantes y genera una línea de tiempo de segmentos etiquetados: hablante A de 0:00 a 0:42, hablante B de 0:42 a 1:15 y hablante A de nuevo a partir de 1:15. El sistema no sabe quiénes son los hablantes, pero sabe que son personas distintas y mantiene sus etiquetas coherentes durante toda la grabación.
Este proceso es lo que hace utilizable el audio con varios hablantes. Las notas de reuniones, la analítica de centros de llamadas, las transcripciones de entrevistas, la edición de pódcasts y los registros legales dependen no solo de saber qué se dijo, sino también de quién lo dijo.
Esta guía explica cómo funciona la diarización, en qué se diferencia de técnicas relacionadas como la segmentación y la identificación, qué herramientas de código abierto la gestionan y cómo medir si un sistema de diarización funciona correctamente.
Resumen
- La diarización de hablantes segmenta una grabación de audio según quién habla y genera turnos de hablante etiquetados sin identificar a nadie por su nombre.
- La diarización de hablantes se diferencia de la segmentación de hablantes, que detecta cuándo cambian los hablantes, y de la identificación de hablantes, que asocia voces con nombres reales.
- El rendimiento de la diarización se mide con la tasa de error de diarización (DER) para la precisión general y la tasa de error de Jaccard (JER) para comprobar que esa precisión se mantiene en todos los hablantes.
¿Qué es la diarización de hablantes y cómo funciona?
La diarización de hablantes es el proceso de dividir un flujo de audio en segmentos según quién está hablando. Una transcripción con diarización de hablantes etiqueta cada segmento de audio con una identidad de hablante. En pocas palabras, responde a la pregunta: «¿Quién habló y cuándo?».
La transcripción sin procesar de una reunión te da las palabras, mientras que una transcripción diarizada te indica que el hablante 1 hizo la pregunta, el hablante 2 la respondió y el hablante 3 interrumpió a mitad de camino.
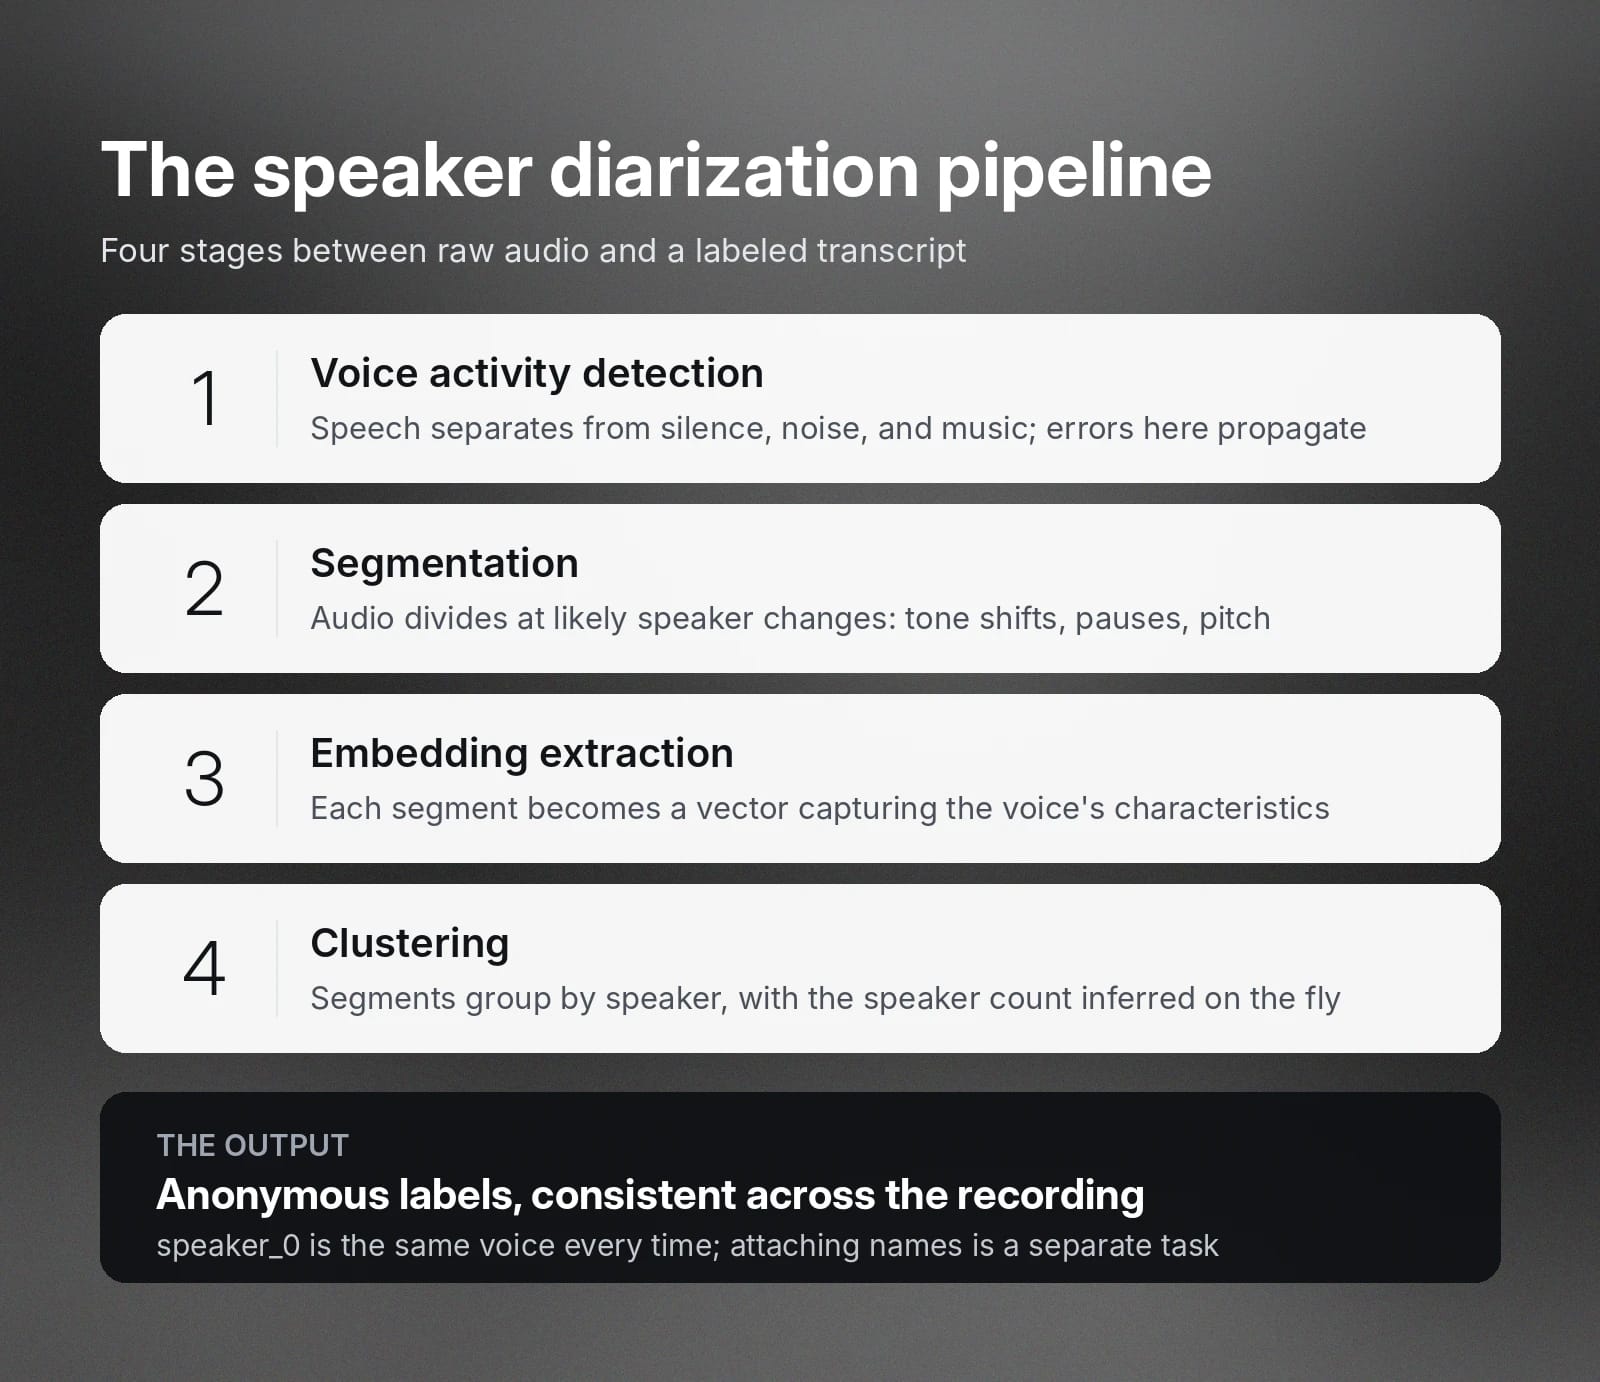
La mayoría de sistemas de diarización de hablantes siguen un flujo de trabajo de cuatro etapas:
Veamos estas etapas con más detalle.
Detección de actividad de voz (VAD)
La detección de actividad de voz separa el habla de todo lo demás: silencio, ruido de fondo, música o clics de teclado. Solo los segmentos de audio que contienen habla real pasan a la siguiente etapa.
Cualquier error en esta etapa se propagará al resto de etapas.
Segmentación
Después, esos segmentos que contienen habla se dividen en puntos donde es probable que cambie el hablante, por ejemplo, ante un cambio en el tono de voz, una pausa entre turnos o un cambio en el patrón de entonación. La mayoría de sistemas detectan estos puntos de cambio directamente comparando las características acústicas a ambos lados de un límite candidato.
Algunas herramientas de segmentación dividen el audio en ventanas cortas y uniformes, como fragmentos de dos segundos, y después recurren a la etapa de agrupación para fusionar las ventanas adyacentes que pertenecen al mismo hablante.
Extracción de embeddings
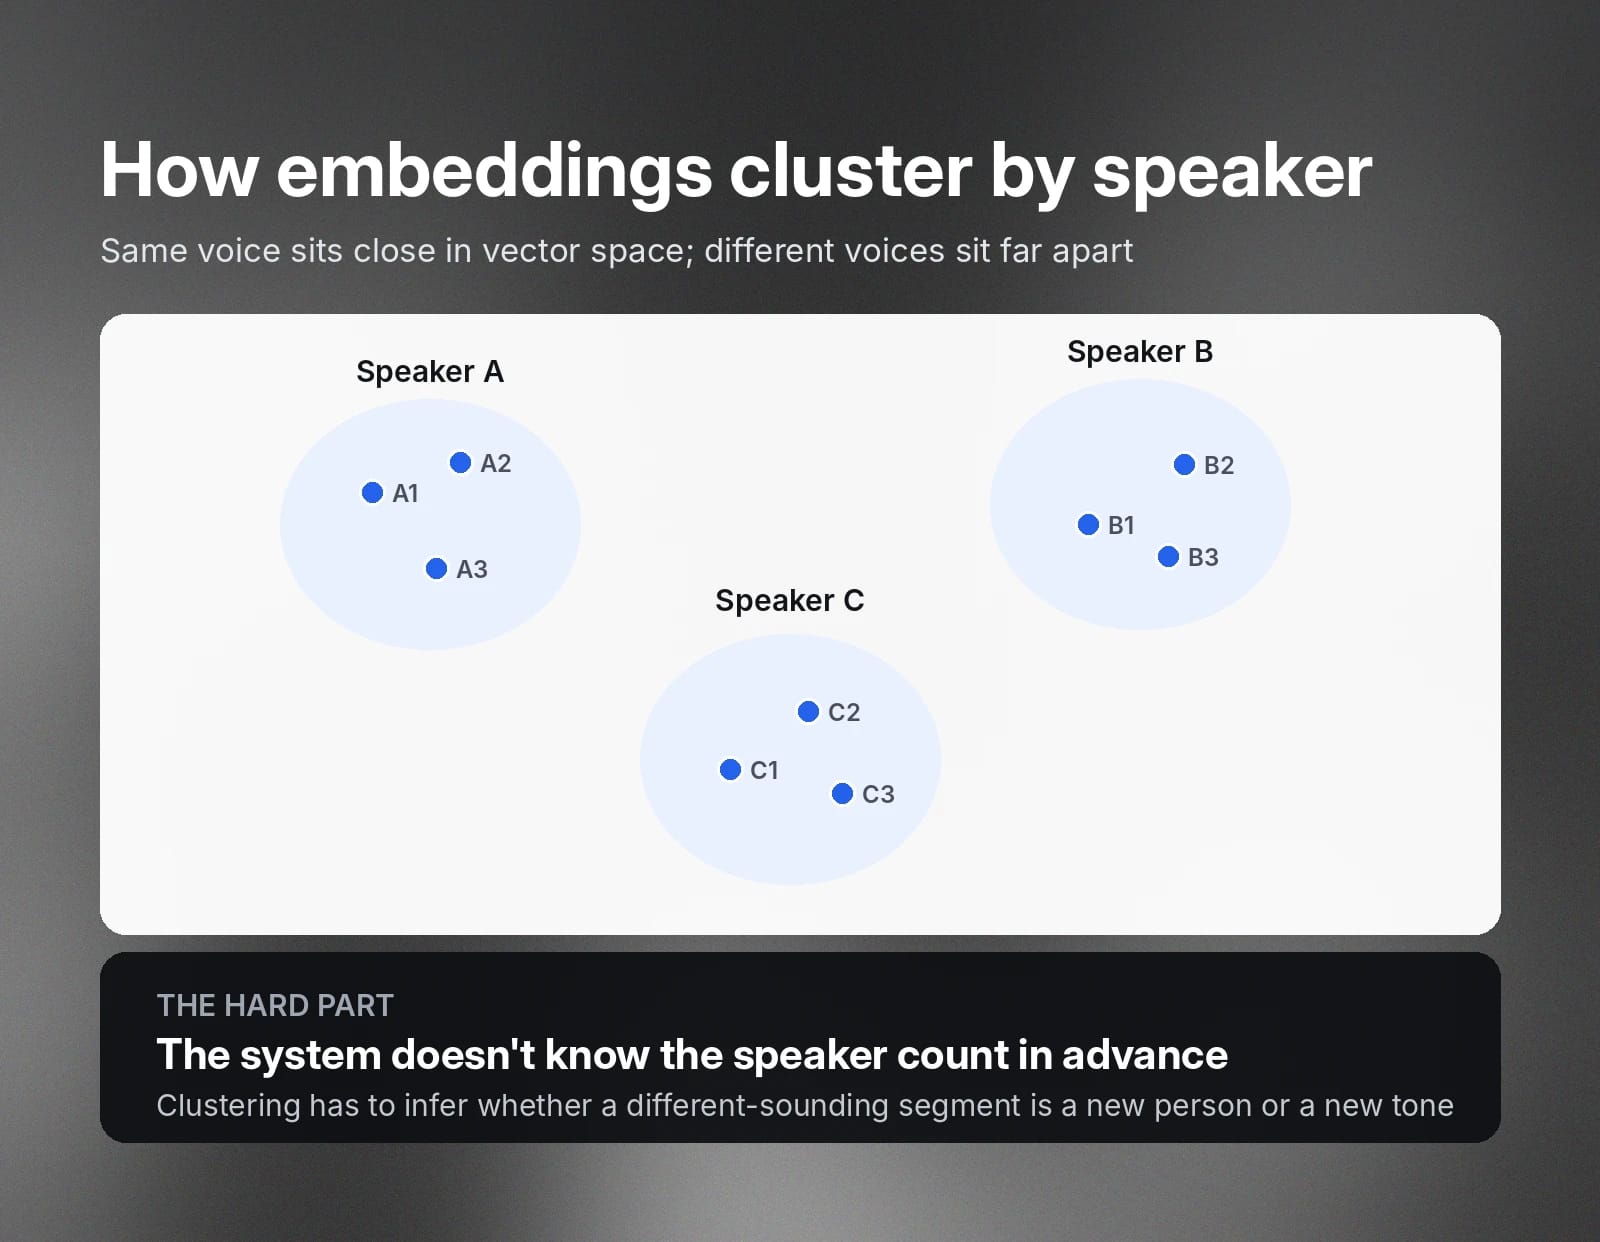
Cada segmento de habla se convierte en un embedding de hablante, es decir, un vector numérico que recoge las características vocales de quien habla en ese segmento. Los embeddings del mismo hablante se agrupan cerca unos de otros en el espacio vectorial, mientras que los embeddings de hablantes distintos se sitúan más lejos.
Agrupación
Después, los embeddings se agrupan para que los segmentos del mismo hablante compartan una etiqueta. Normalmente, el sistema no conoce de antemano el número de hablantes, por lo que el algoritmo de agrupación debe inferirlo y decidir si ese segmento que suena ligeramente distinto corresponde a un hablante nuevo o a la misma persona hablando con un tono diferente.
El resultado es un conjunto de etiquetas de hablante asociadas a intervalos de tiempo, normalmente junto con una transcripción. Por ejemplo, una transcripción diarizada de una llamada entre dos personas sería así:
- [speaker_0] Gracias por llamar. ¿En qué puedo ayudarte?
- [speaker_1] Hola, llamo por mi factura del mes pasado.
- [speaker_0] Claro, déjame buscarla.
Las etiquetas son anónimas y coherentes internamente. Speaker_0 es la misma voz cada vez que aparece, pero el sistema no sabe que speaker_0 se llama Fergal. Asociar identidades reales es una tarea distinta, que explicamos a continuación.
Diferencias clave entre la segmentación y la identificación de hablantes
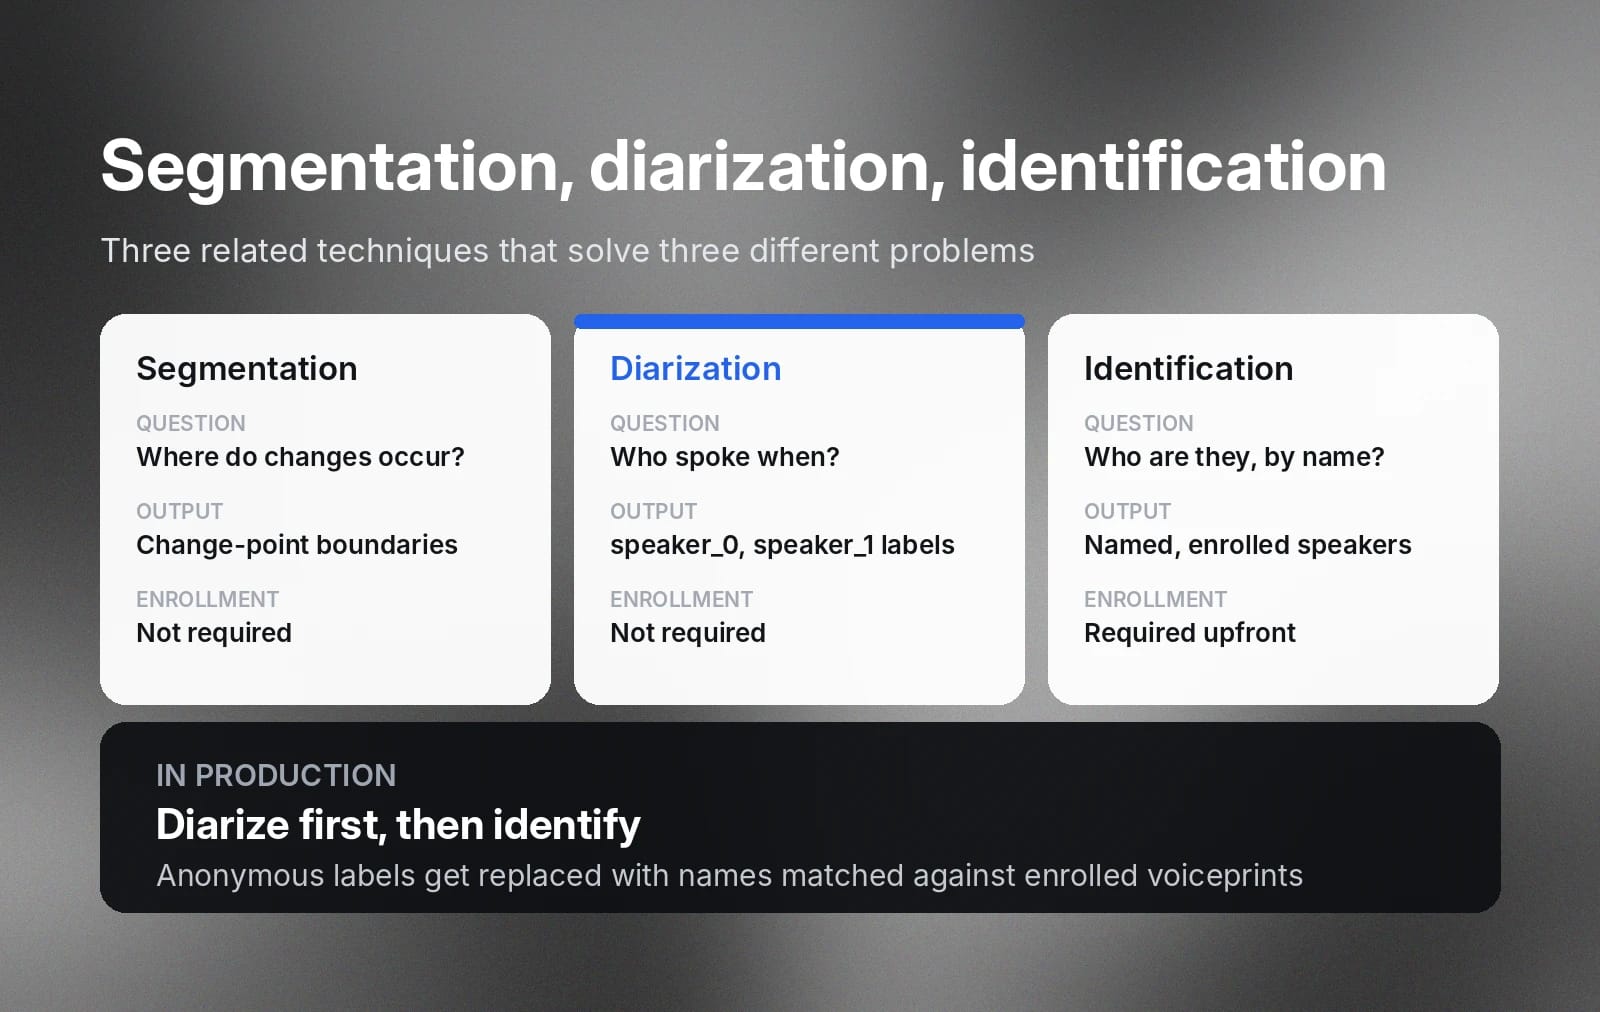
La segmentación y la identificación de hablantes se solapan estrechamente con la diarización, por lo que las tres suelen confundirse entre sí.
Cada una resuelve un problema ligeramente distinto, así que es importante entender la diferencia al evaluar herramientas.
Como explicamos antes, la segmentación de hablantes es una etapa dentro de la diarización que se produce al principio del flujo de trabajo. Detecta los límites en los que el hablante cambia de una voz a otra, sin asignar etiquetas. La segmentación te indica que se produjo un cambio en 0:42. La diarización va un paso más allá agrupando los segmentos resultantes y generando un resultado totalmente etiquetado, para que sepas que la voz de 1:15 es la misma que habló al principio de la grabación.
La identificación de hablantes es una capacidad independiente de la diarización, pero se combina con ella con frecuencia. La identificación determina quiénes son realmente esos hablantes. Un sistema de identificación compara voces con huellas vocales registradas y utiliza una referencia de hablantes conocidos para devolver identidades. Tras la identificación, speaker_0 y speaker_1 pasan a ser «Fergal» y «Eric».
Muchos productos combinan estas herramientas para generar una transcripción final más completa. Una herramienta de reuniones puede hacerlo automáticamente —incluso obteniendo datos de textos como el nombre que alguien ha configurado en Teams o Meet— para atribuir por nombre las aportaciones de cada asistente sin revisión manual.
Herramientas y bibliotecas populares de código abierto para la diarización de hablantes
Las herramientas de código abierto para la diarización de hablantes merecen la pena cuando necesitas control, flexibilidad o implementación local. La mejor opción depende del tipo de audio que gestiones —llamadas telefónicas, reuniones, pódcasts o retransmisiones—, de tus requisitos de latencia y del tiempo de ingeniería que puedas invertir.
Estas son algunas de las opciones más populares.
Pyannote.audio
Pyannote.audio es un kit de herramientas basado en PyTorch diseñado específicamente para la diarización de hablantes y una de las opciones de código abierto más utilizadas. Ofrece flujos preentrenados que cubren toda la pila de diarización, incluidos VAD, segmentación, embeddings y agrupación, junto con los componentes para entrenar o ajustar modelos con tus propios datos.
Sus modelos preentrenados se distribuyen a través de Hugging Face y se usan habitualmente como capa de diarización en proyectos de transcripción más grandes.
WhisperX
WhisperX combina Whisper de OpenAI ASR con diarización y alineación forzada. Por sí solo, Whisper genera buenas transcripciones, pero no asigna etiquetas de hablante y sus marcas de tiempo son solo aproximadas. WhisperX añade alineación de marcas de tiempo a nivel de palabra e integra diarización basada en pyannote para generar transcripciones en las que cada palabra incluye tanto una marca de tiempo precisa como una etiqueta de hablante.
NVIDIA NeMo
NVIDIA NeMo incluye diarización como parte de su marco más amplio de IA conversacional. Ofrece modelos de diarización entrenables, incluidos enfoques integrales que gestionan el habla superpuesta, y está diseñado para equipos que crean sistemas de voz personalizados a gran escala sobre infraestructura GPU.
Cada una de estas herramientas requiere gestionar la infraestructura de diarización, incluido el despliegue, escalado, monitorización y las actualizaciones de modelos. Para equipos que no quieren asumir esa carga operativa, las API gestionadas de diarización de voz ofrecen una alternativa más sencilla. Pueden integrarse con flujos de trabajo existentes o gestionar toda la canalización de diarización, por lo que son adecuadas para casos de uso en producción, como la analítica de atención al cliente, la transcripción de reuniones y el procesamiento de pódcasts.
Diarización en tiempo real: retos y casos de uso
La diarización en tiempo real es considerablemente más difícil que la diarización de una grabación finalizada, porque el sistema debe tomar decisiones con un contexto incompleto.
Un sistema offline ve la grabación completa antes de tomar una decisión. Puede comparar una voz en el minuto 2 con una voz en el minuto 40 y decidir con seguridad que pertenecen al mismo hablante, porque tiene ambos momentos disponibles a la vez. Un sistema en tiempo real no tiene ese privilegio: debe etiquetar el habla en cuanto llega, sin acceso a lo que se dirá después y con pocas o ninguna posibilidad de revisar una decisión una vez tomada.
La ausencia de contexto futuro hace que tres problemas concretos sean mucho más difíciles de resolver en tiempo real:
- Latencia frente a precisión: Sin la capacidad de revisar toda la conversación, cumplir plazos de respuesta más ajustados perjudica directamente a la precisión.
- Habla superpuesta: Cuando varias personas hablan a la vez, un sistema que pudiera reprocesar el audio podría separarlas. Un sistema en tiempo real debe forzarlo a una única etiqueta o recurrir sobre la marcha a modelos especializados que detecten solapamientos.
- Intervenciones cortas: Un «sí» o «adelante» rápido apenas proporciona al sistema voz suficiente con la que trabajar y, sin contexto cercano en el que apoyarse, debe asignar una etiqueta de inmediato.
A pesar de esta dificultad, algunas aplicaciones no pueden esperar a que termine una grabación. Los subtítulos en directo para reuniones y retransmisiones necesitan etiquetas de hablante mientras las personas hablan. El software para centros de llamadas que ofrece orientación a agentes durante una llamada necesita saber qué palabras usa el cliente en tiempo real. Los agentes de voz que gestionan llamadas con varios participantes deben seguir quién pregunta qué sin demora. En cada caso, un sistema ligeramente menos preciso pero inmediato es mejor que uno más preciso pero con retraso.
Para cargas de trabajo que no requieren realmente etiquetas en tiempo real, como la analítica, la revisión de cumplimiento normativo y la generación de transcripciones, la diarización por lotes sigue siendo la mejor opción porque es mucho más precisa.
Cómo evaluar el rendimiento de la diarización de hablantes
Hay dos métricas fundamentales para medir la precisión de la diarización: la tasa de error de diarización (DER), que recoge la precisión general, y la tasa de error de Jaccard (JER), que comprueba si esa precisión se mantiene para todos los hablantes.
La DER calcula específicamente la fracción del tiempo total de habla que se atribuye incorrectamente. Combina tres tipos de errores:
- Falsa alarma de habla: El sistema etiquetó un segmento como habla cuando nadie estaba hablando.
- Habla omitida: Alguien estaba hablando, pero el sistema lo etiquetó como silencio.
- Confusión de hablantes: Se detectó habla, pero se atribuyó al hablante equivocado.
DER = (falsa alarma + habla omitida + confusión de hablantes) / duración total del habla
Una DER del 10 % significa que los errores equivalen a una décima parte del tiempo total de habla, repartidos entre esos tres tipos. Cuanto menor, mejor; las puntuaciones solo son comparables si se miden con los mismos datos y en las mismas condiciones. La DER varía enormemente según la calidad del audio, el número de hablantes y el grado de solapamiento de la grabación.
La tasa de error de Jaccard (JER) mide la precisión de la diarización para cada hablante por separado y después calcula la media de todos los resultados. Para cada hablante de referencia, el evaluador empareja la etiqueta de hablante más próxima del sistema y compara el tiempo en que se solapan correctamente con el tiempo total asignado a cualquiera de los dos hablantes.
Por ejemplo, imagina una reunión de 60 minutos en la que el hablante A habla durante 50 minutos y el hablante B durante 10. Un sistema de diarización etiqueta correctamente 48 de los 50 minutos del hablante A, pero solo 4 de los 10 minutos del hablante B. Su DER general puede seguir pareciendo relativamente buena porque la mayor parte de la reunión corresponde al hablante A. La JER hace que el mal resultado del hablante B cuente por igual, porque evalúa al hablante A y al hablante B de forma independiente antes de calcular la media de sus puntuaciones.
JER_hablante = 1 - (solapamiento_correcto / (tiempo_ref + tiempo_sis - solapamiento_correcto))
La JER final es la media de esas tasas de error por hablante:
JER = (1 / N) * Σ[JER_hablante_i] para i = 1..N
Hacer seguimiento tanto de la DER como de la JER ofrece una imagen más completa de la precisión de la diarización: la DER mide la precisión general y la JER indica si esa precisión se mantiene en todos los participantes, incluidas las personas que hablan con menos frecuencia.
Pruebas con audio representativo de producción
Al evaluar un sistema de diarización de hablantes, calcula tanto la DER como la JER con audio que se ajuste a tus condiciones reales de implementación: tu número habitual de hablantes, la calidad de tu audio y el nivel de conversación cruzada.
Las puntuaciones de referencia publicadas pueden medirse con conjuntos de datos limpios y controlados, como grabaciones de Studio, que rara vez se parecen a grabaciones reales de llamadas o reuniones en directo. Un sistema que obtiene buenos resultados en pruebas de referencia puede seguir rindiendo mucho peor con audio real ruidoso y con solapamientos. Haz pruebas con tus propios datos antes de comprometerte con un producto de diarización.
Empieza a usar ElevenAPI para la diarización de hablantes
Si estás listo para crear una función de transcripción compatible con varios hablantes, Scribe v2 de ElevenLabs pone la diarización de hablantes a tu disposición mediante una única API de Voz a Texto. Envía audio a la ruta de API con diarize=true y la respuesta JSON etiqueta cada palabra con un ID de hablante, para hasta 32 hablantes, en más de 90 idiomas y en archivos de hasta 10 horas de duración.
Dos opciones amplían el resultado estándar de la diarización. Para grabaciones de llamadas, detect_speaker_roles=true etiqueta a los hablantes como agente y cliente en lugar de con números anónimos. Si tu espacio de trabajo tiene perfiles de hablante registrados, use_speaker_library=true puede comparar los hablantes detectados con voces registradas, combinando diarización e identificación en una única solicitud.
Un parámetro de umbral de diarización te permite ajustar el equilibrio entre dividir demasiado y fusionar hablantes. Además, cuando los hablantes ya están aislados en canales de audio separados, como en grabaciones de llamadas estéreo, la transcripción multicanal asigna hablantes por canal y omite la diarización por completo.
La guía de inicio rápido de Voz a Texto explica paso a paso la primera integración. Para implementaciones reguladas, la plataforma cumple con SOC 2, ISO 27001, PCI DSS L1 y HIPAA, y ofrece residencia de datos en la UE y modo de retención cero.
¿Quieres incorporar la diarización de hablantes a tus sistemas? Empieza por obtener tu clave de API o consulta la documentación de ElevenLabs para obtener más información.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


