
¿Cómo funciona la transcripción de audio con marcas de tiempo y etiquetado de eventos?
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Un modelo nativo de transcripción a nivel de palabra recibe como entrada una grabación de audio o una transmisión en tiempo real y genera una matriz estructurada de objetos de token etiquetados y con marca de tiempo que representan voz y sonidos no verbales. Cada token pertenece a uno de estos tres tipos: word, spacing o audio_event. Los eventos de audio pueden ser risas, aplausos u otros sonidos de fondo.
En este artículo, veremos cómo funciona la transcripción de audio con marcas de tiempo y por qué es una forma de transcripción más flexible y potente que la transcripción convencional, que depende de la alineación forzada.
Resumen
- La transcripción a nivel de palabra genera directamente matrices estructuradas y con marcas de tiempo de datos de voz y eventos de audio no verbales.
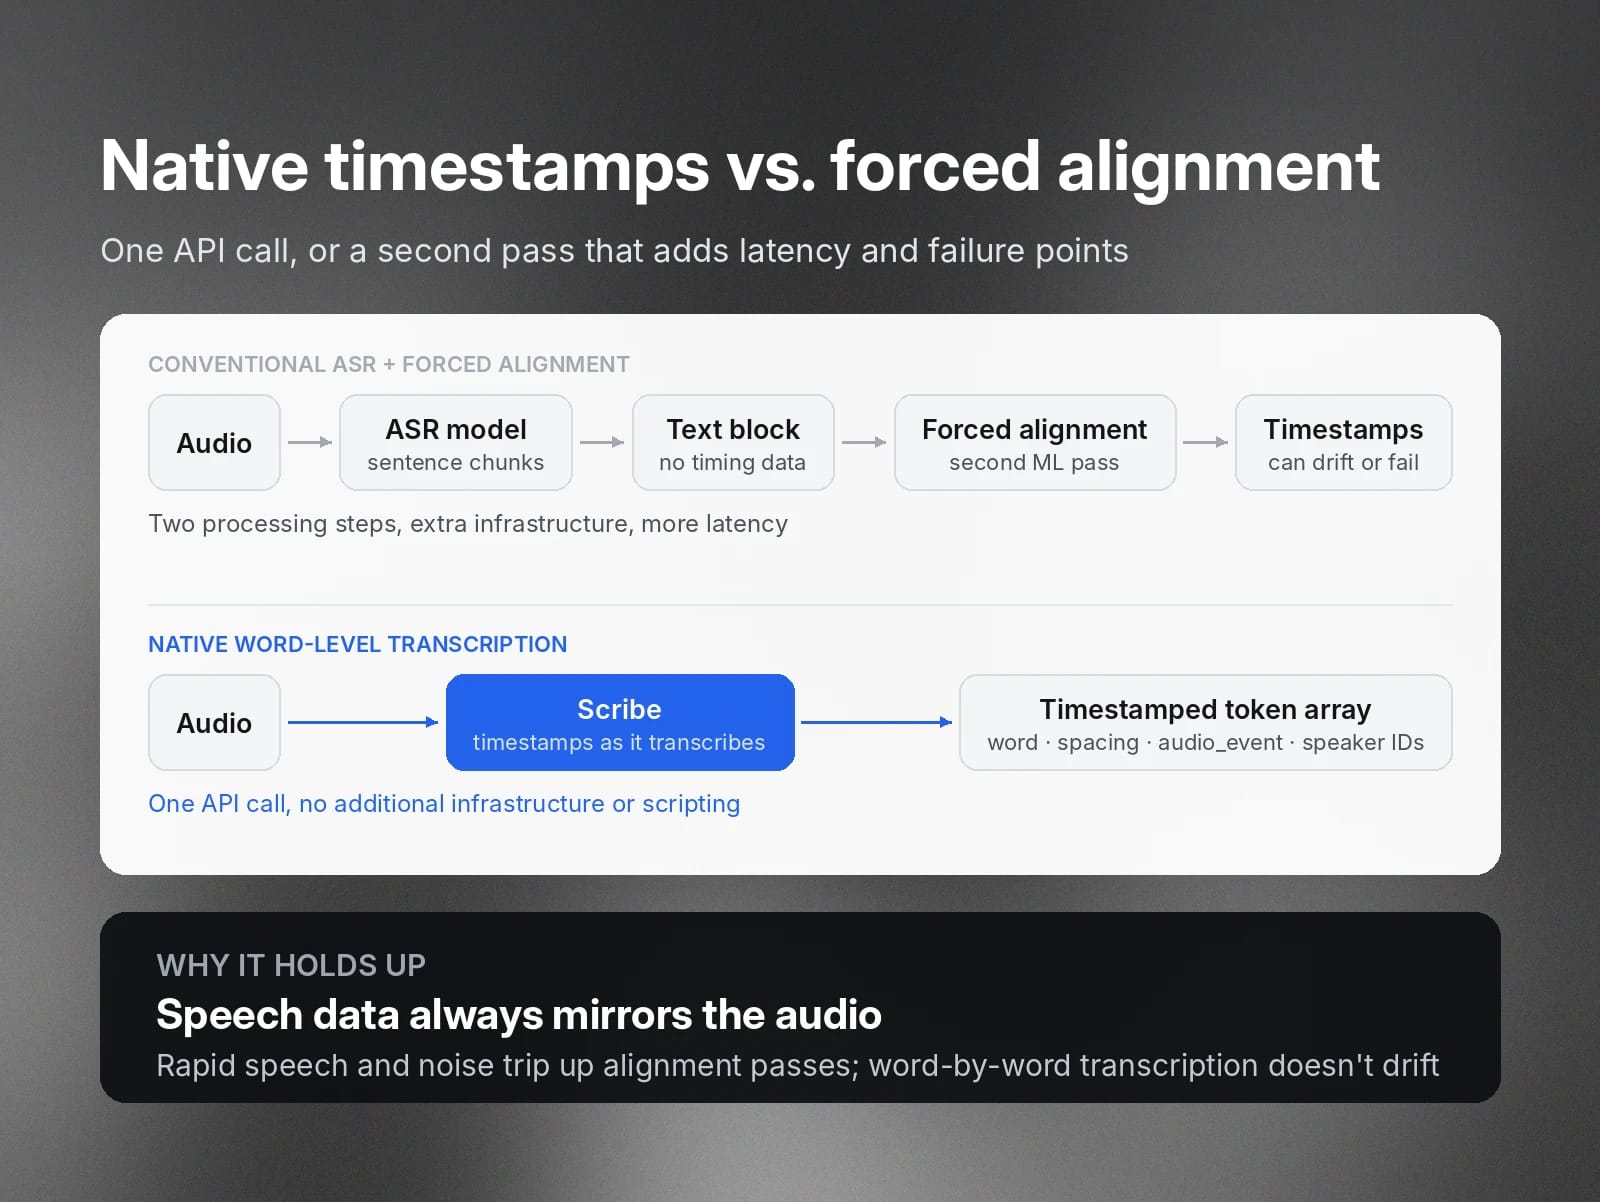
- Esto contrasta con los modelos convencionales de reconocimiento automático de voz, que generan bloques completos de texto. Para añadir marcas de tiempo a ese texto respecto al audio original, debes realizar un segundo proceso de alineación forzada, que tarda más y añade carga computacional.
- Las etiquetas de eventos te ayudan a capturar contenido no verbal, como risas o aplausos. Como estos datos se pueden buscar, puedes usarlos para identificar momentos destacados o virales según las reacciones de la audiencia.
- Puedes enviar los datos estructurados generados a aplicaciones para diversos casos de uso, como subtitulado de gran precisión, archivos de audio con búsqueda y creación automatizada de clips para redes sociales.
- La transcripción a nivel de palabra de Scribe admite hasta 5 canales, cada uno transcrito de forma independiente.
¿Qué es la transcripción de audio con marcas de tiempo y etiquetas de eventos?
La transcripción con marcas de tiempo es una forma de reconocimiento automático de voz (ASR) que registra los puntos exactos de inicio y final de las palabras y otros eventos de audio, como los aplausos, mientras transcribe. Genera datos totalmente estructurados y navegables.
La transcripción ASR convencional analiza el audio en grandes bloques de texto legible. Te proporciona subtítulos y una transcripción para lectores humanos, pero no resulta muy útil como dato.
Si quieres estructurarla con marcas de tiempo, debes procesarla de nuevo mediante un servicio secundario de aprendizaje automático para relacionar el texto con el audio. Con el tiempo podrías generar una salida similar, pero requiere varios pasos de procesamiento en lugar de obtenerse de forma nativa desde la API, por lo que añade latencia y carga computacional adicional.
Añadir navegación al audio
La ventaja principal de la transcripción con marcas de tiempo y etiquetas de eventos es que puede ser leída tanto por personas como por máquinas. Esto tiene importantes aplicaciones empresariales:
- Auditoría de cumplimiento normativo: Puedes buscar palabras clave en una transcripción y obtener marcas de tiempo exactas de cualquier mención de datos sensibles.
- Producción y edición de vídeo: El software de producción de vídeo puede sincronizar los subtítulos al milisegundo con lo que se dice en pantalla. También puede etiquetar adecuadamente las reacciones de la audiencia.
- Archivos con búsqueda: Los equipos de relaciones públicas, ventas y formación, entre otros, pueden transcribir grandes volúmenes de entrevistas a clientes, discursos en ferias comerciales, webinars o reuniones abiertas y convertirlos en archivos masivos donde se puede buscar.
- Analítica de marketing y sentimiento del cliente: El etiquetado de eventos puede identificar reacciones de la audiencia que podrían perderse en una transcripción de texto básica.
¿Qué ventajas ofrecen las marcas de tiempo nativas a nivel de palabra?
Los modelos estándar de Voz a Texto սովորաբար procesan la voz por bloques, normalmente frases o párrafos completos. Si quieres marcas de tiempo palabra por palabra, debes diseñar otra capa de procesamiento para realizar lo que se conoce como alineación forzada en una segunda pasada. Esto añade infraestructura y latencia, además de más posibles puntos de fallo. Por ejemplo, pueden desincronizarse o fallar por completo al intentar procesar habla rápida o voz cubierta por un ruido de fondo intenso.
La transcripción con marcas de tiempo, como la que realiza Scribe, evita este problema al transcribir a un nivel más granular, palabra por palabra. Lo hace en una única llamada a la API. No requiere infraestructura ni scripts adicionales. El modelo calcula las marcas de tiempo mientras transcribe, por lo que los datos de voz siempre reflejan el audio con precisión.
¿Cómo funciona la transcripción con marcas de tiempo y etiquetas de eventos?
Usemos Scribe como ejemplo.
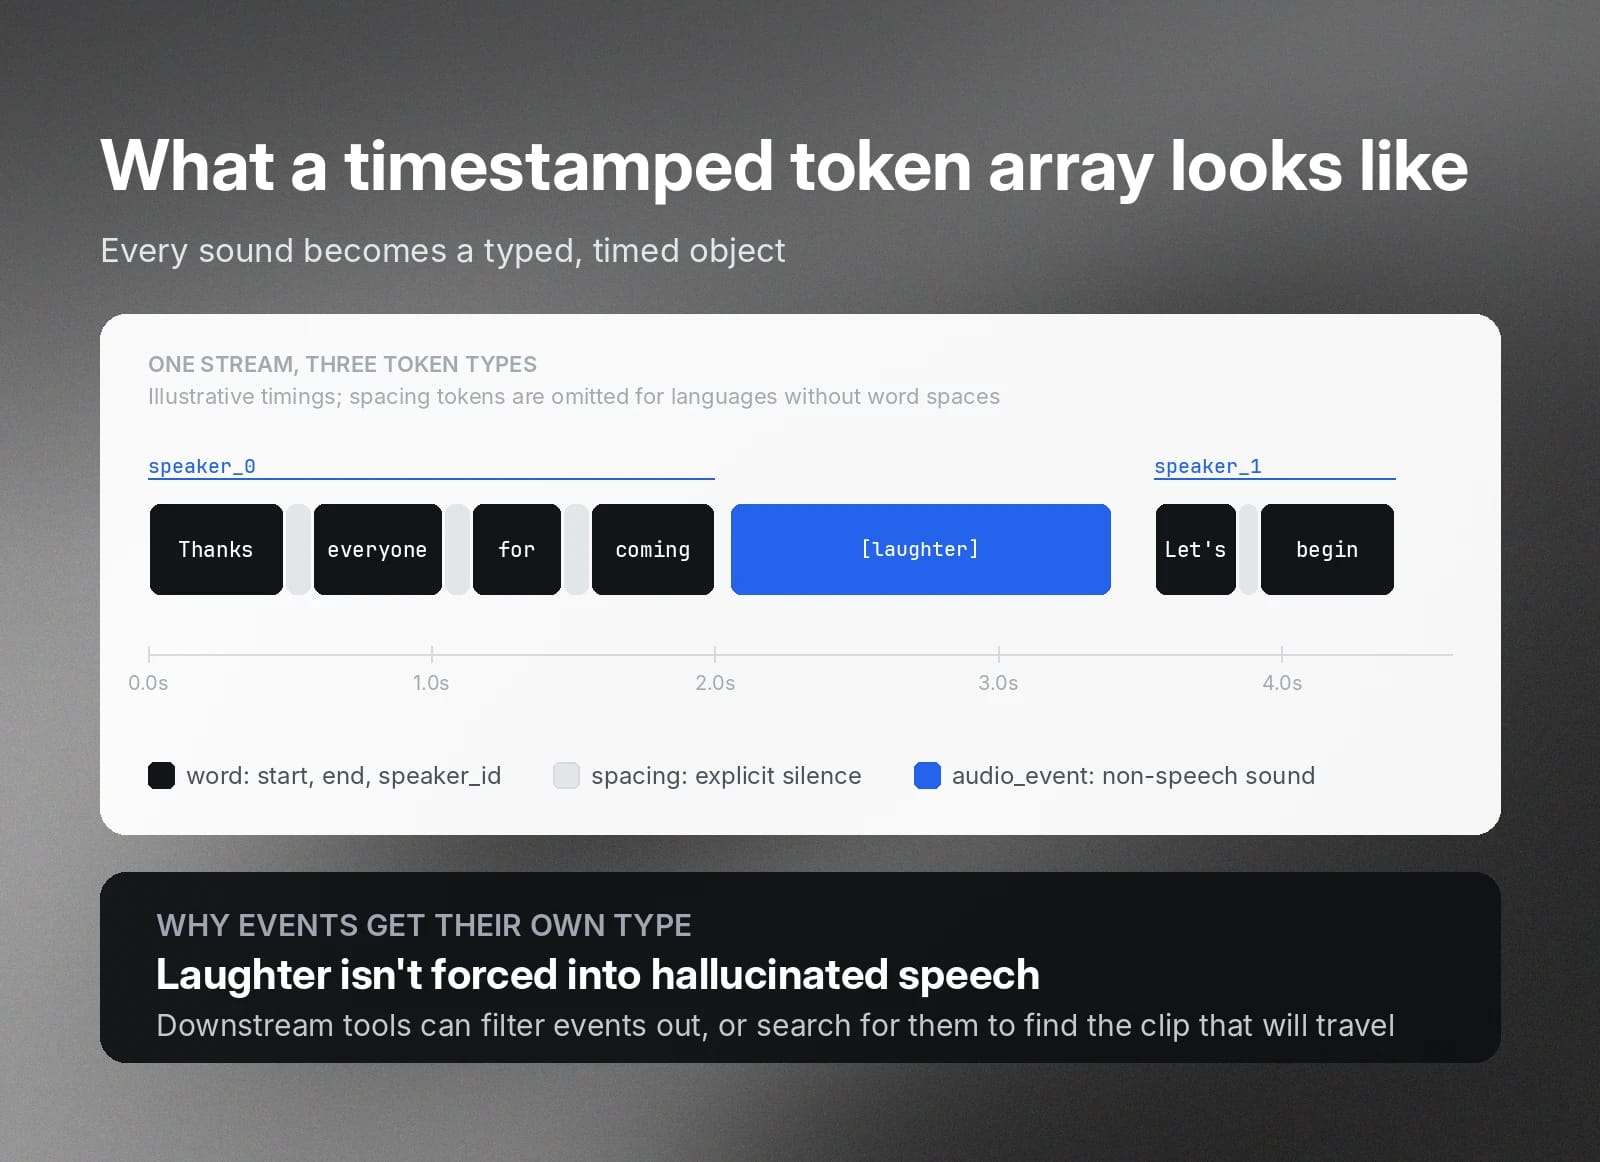
Un modelo nativo de transcripción a nivel de palabra convierte los sonidos de voz de una transmisión de audio en una matriz estructurada de objetos de token. Etiqueta cada token como uno de estos tres tipos: word, spacing o audio_event.
- word: Una palabra individual reconocida, con horas de inicio y final registradas y una etiqueta speaker_id.
- spacing: Silencio o pausas durante el habla etiquetados explícitamente. Resulta útil para que los servicios de subtitulado mantengan el ritmo adecuado. No se utiliza en idiomas detectados que no emplean espacios entre palabras, como japonés, mandarín, tailandés, lao, birmano y cantonés.
- audio_event: Audio no verbal significativo, como risas o aplausos. El modelo sabe estructurarlo como un tipo de evento independiente y no fuerza el audio para convertirlo en voz alucinada.
Parámetros de transmisión en tiempo real
Los modelos de transcripción a nivel de palabra también pueden incluir funciones especiales para admitir transcripción de audio en directo mediante WebSocket. Por ejemplo:
- include_timestamps=true: Este parámetro hace que la conexión incluya marcas de tiempo a nivel de palabra en los mensajes JSON committed_transcript_with_timestamps enviados al final de cada bloque de audio finalizado, para que recibas las marcas de tiempo mientras la transmisión sigue activa. Las etiquetas de eventos de audio solo se incluyen si también está activado tag_audio_events.
- include_language_detection=true: Este parámetro indica a la conexión que etiquete los distintos idiomas hablados detectados junto con la puntuación de confianza del modelo para la detección. Te ayuda a ejecutar subtitulado multilingüe en directo.
¿Cómo etiqueta un modelo de Voz a Texto los eventos no verbales?
Scribe etiquetará los eventos de audio cuando tengas activado el parámetro tag_audio_events. En ese caso, los etiquetará y añadirá marcas de tiempo específicas de inicio y final, igual que hace con las palabras. Puede etiquetar una variedad de reacciones, entre las más comunes las risas y los aplausos, además de otros sonidos ambientales que pueden ser relevantes según el contexto, como pasos o música.
De forma inmediata, esto enriquece las transcripciones y los subtítulos al añadir contexto importante. A un lector le puede resultar más difícil captar el sarcasmo al leer un texto simple y plano. Una etiqueta [laughter] enriquece la transcripción y le aporta más resonancia emocional.
Mejor analítica
El etiquetado de eventos también hace que cualquier análisis posterior sea más limpio, ya que esas herramientas no tienen que analizar un único bloque de texto no estructurado. La transcripción nativa a nivel de palabra separa los eventos de audio como datos estructurados, por lo que tus herramientas pueden filtrarlos cuando corresponda y trabajar únicamente con contenido verbal.
Como los tokens spacing hacen visibles las pausas, puedes analizarlas. Esto puede ser útil para el análisis de sentimiento y casos de uso de control de calidad, por ejemplo para medir cuánto tiempo permaneció en silencio un agente de atención al cliente durante una llamada.
Búsqueda más sencilla por marcas de tiempo
También puedes buscarlos específicamente. Si realizas un análisis de sentimiento de una entrevista de prueba de producto, puedes extraer reacciones emocionales relevantes. O, si gestionas una cuenta en redes sociales, puedes buscar rápidamente risas en un discurso de una hora para encontrar los clips que creas que tienen más posibilidades de viralizarse.
¿Qué aplicaciones prácticas tienen las transcripciones estructuradas con marcas de tiempo?
Obtener datos estructurados de forma nativa en las transcripciones tiene varios casos de uso importantes.
Generación de subtítulos
Puedes exportar transcripciones con marcas de tiempo directamente a formatos de subtitulado de producción, como SRT y VTT, sin procesamiento intermedio. Tu herramienta de edición de vídeo puede utilizar la temporización de las palabras para resaltarlas en los subtítulos a medida que se pronuncian.
El modelo de transcripción puede analizar fácilmente el habla rápida porque la procesa palabra por palabra. Donde un modelo convencional podría tropezar con habla muy rápida o voces superpuestas, un modelo a nivel de palabra como Scribe puede generar una transcripción limpia y estructurada.
Búsqueda de audio y vídeo
La transcripción convencional te permite encontrar palabras clave en el bloque de texto, pero sin alineación forzada no puedes saltar al momento en que se pronunció una frase. Una búsqueda por palabra clave en una transcripción a nivel de palabra está totalmente indexada y te lleva directamente al segundo en que se dijo una frase en el audio. Esto convierte tu archivo de audio en un catálogo de referencia totalmente consultable. Esta capacidad resulta especialmente útil para gestionar grandes bibliotecas multimedia, redes de pódcasts y archivos corporativos.
Auditoría de cumplimiento normativo y riesgos
A menudo querrás grabar audio que contiene información sensible; por ejemplo, grabar llamadas de atención al cliente para control de calidad. Estas son las llamadas con más probabilidades de contener información personal sensible o regulada.
Para cumplir con la normativa y seguir disponiendo de datos de audio para analítica, necesitas una forma de ocultar datos sensibles de las transcripciones en tiempo real. Las marcas de tiempo nativas a nivel de palabra te permiten aprovechar funciones como Detección de entidades de ElevenLabs, que identifica entidades sensibles, como números de tarjeta de crédito o nombres, y devuelve sus desplazamientos y marcas de tiempo para que puedas ocultarlas en tus transcripciones a medida que llegan.
Por ejemplo, puedes detectar y ocultar un número de tarjeta de crédito, el apellido de soltera de la madre, la fecha de nacimiento y el nombre del cliente a medida que se mencionan en una llamada para verificar su identidad.
Creación automatizada de clips para redes sociales
También puedes automatizar mediante programación las búsquedas por palabras clave para encontrar momentos destacados en contenido de larga duración. Por ejemplo, podrías resaltar momentos importantes de un discurso de campaña o un seminario corporativo. Esto te ayuda a convertir contenido reciente en vídeos destacados con edición profesional para YouTube, LinkedIn o TikTok.
Temporización multicanal y multihablante
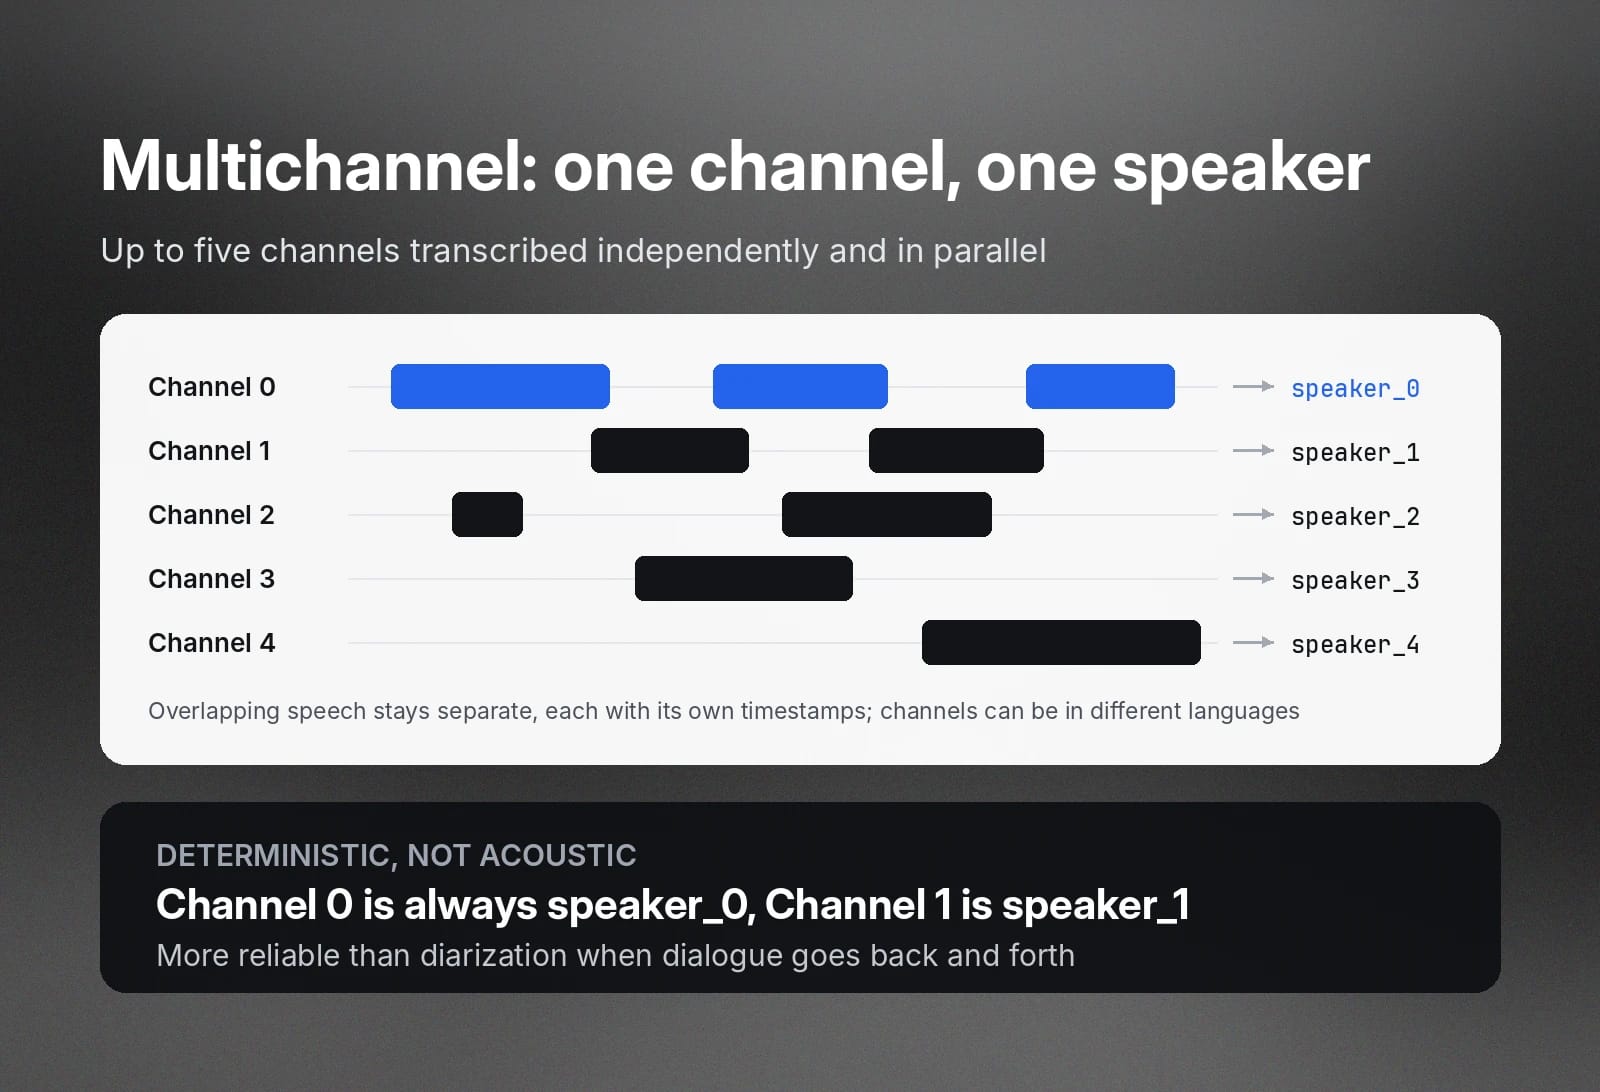
Scribe puede transcribir hasta cinco canales de forma independiente y en paralelo. A cada uno se le asignan un ID de hablante y marcas de tiempo. Esto es más fiable que la diarización de hablantes acústica estándar, que a menudo tiene dificultades con diálogos de ida y vuelta. En grabaciones multicanal, la asignación de hablantes de Scribe es puramente determinista. Esto significa que el canal 0 se asigna a speaker_0, el canal 1 a speaker_1, y así sucesivamente.
Puede reconocer a hablantes que intentan hablar simultáneamente y seguir generando marcas de tiempo independientes para su voz. También pueden hablar en idiomas distintos.
Exporta datos con marcas de tiempo en el formato que necesitas
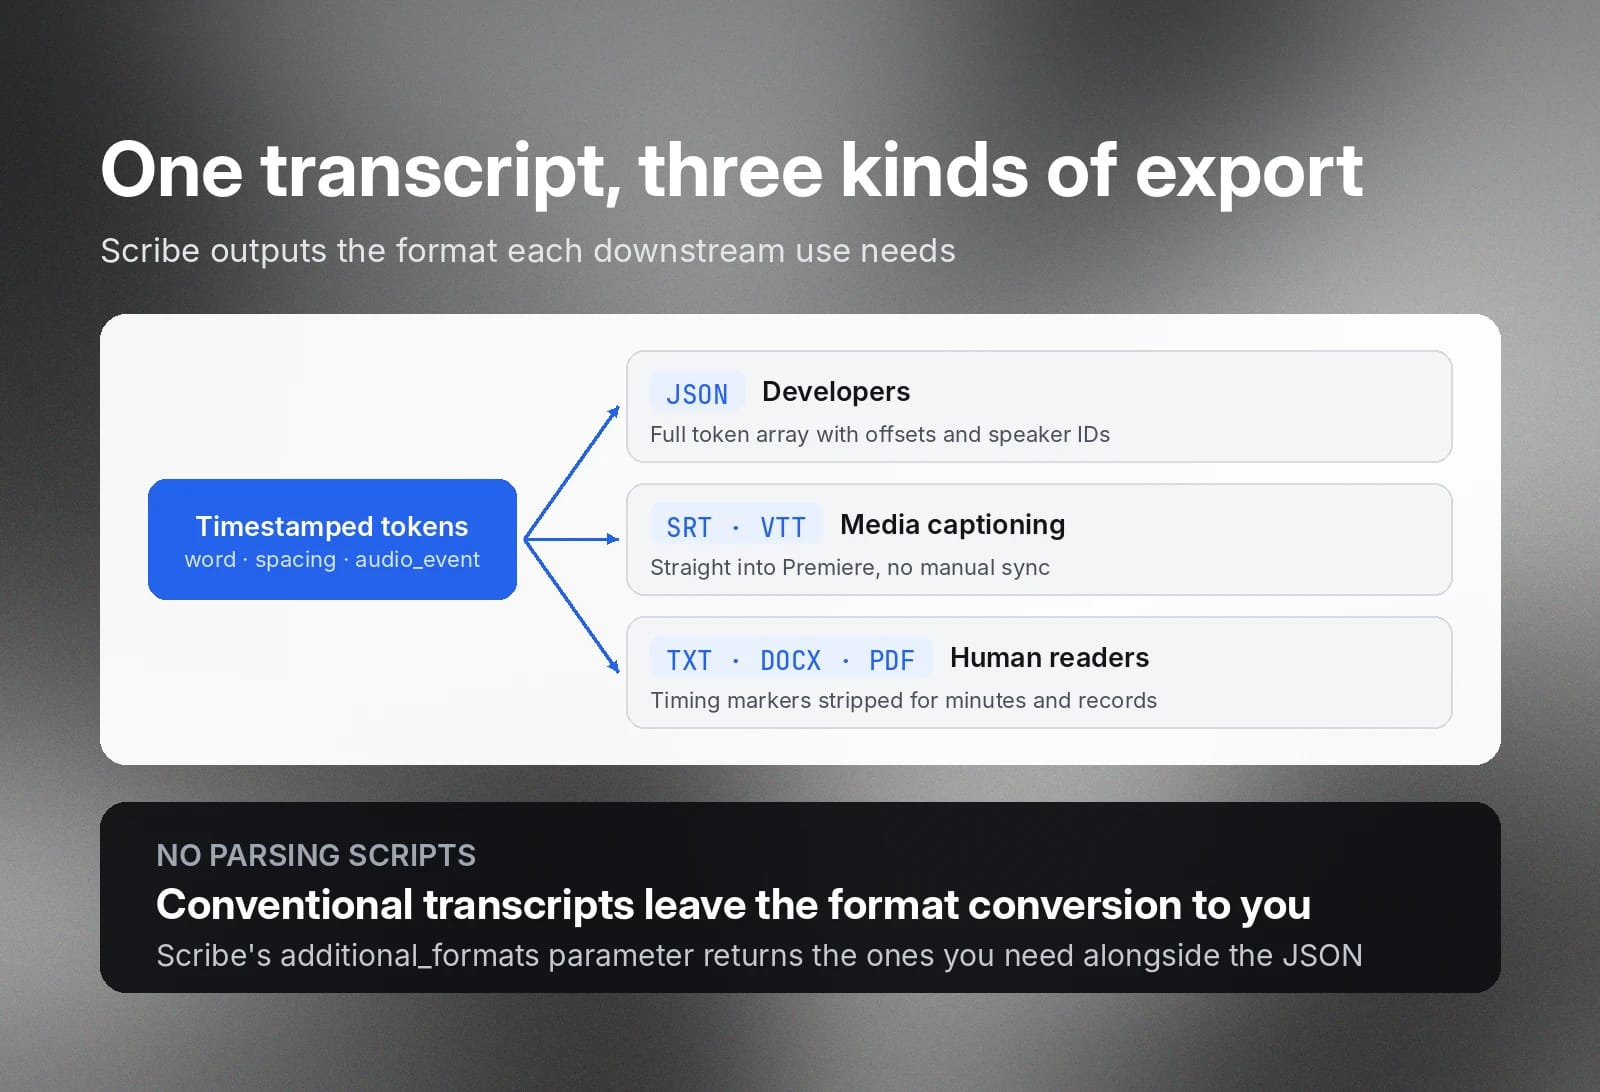
Si quieres distribuir transcripciones convencionales en varios formatos, probablemente tendrás que escribir los scripts de análisis tú mismo. Scribe puede exportar transcripciones en varios formatos según cómo vayas a utilizarlas. Puedes consultar las definiciones completas del esquema en la referencia de la API Create Transcript de ElevenLabs.
Datos estructurados para desarrolladores: JSON
Scribe permite exportar a JSON para desarrolladores que quieran datos en un esquema que puedan enviar a aplicaciones posteriores. Por ejemplo, desarrolladores pueden usar estos datos JSON para crear medios interactivos o una base de datos de búsqueda semántica para tu organización. La matriz completa de tokens word, spacing y audio_event se genera con desplazamientos de inicio y final e ID de hablante.
Subtitulado multimedia: SRT y VTT
Scribe puede generar transcripciones SRT y VTT que puedes incorporar directamente a Adobe Premiere u otras aplicaciones de producción sin sincronización manual.
Legible para personas: TXT, DOCX y PDF
También puede generar transcripciones en formatos fáciles de leer. En estos formatos, Scribe elimina los marcadores de temporización de bajo nivel para que el texto sea más legible y adecuado para documentación legal o de auditoría. Por ejemplo, resulta útil cuando necesitas distribuir eficazmente las actas de una reunión del consejo justo después de una sesión, publicar transcripciones de pódcasts para SEO o archivar documentos legales.
Empieza a usar las transcripciones de ElevenLabs con marcas de tiempo y etiquetas de eventos
La transcripción nativa a nivel de palabra te proporciona los datos estructurados que necesitas para tus workflows de forma rápida y eficiente.
Empieza hoy a transcribir tu audio con Scribe en ElevenAPI o descubre más sobre la transcripción a nivel de palabra.
Preguntas frecuentes sobre marcas de tiempo y transcripción con etiquetas de eventos

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


