Texto a Voz vs Voz a Texto: ¿cuál es la diferencia?
- Publicado
- Última actualización
EscucharEscucha este artículo
Imagina esto: vas de camino al trabajo y tu smartphone te lee los correos sin leer mediante un software de texto a voz (TTS). Y aún mejor: envías tus respuestas sin necesidad de tocar el teléfono ni apartar la vista de la carretera, todo gracias al software de Voz a Texto (STT).
Estas tecnologías no son solo conceptos futuristas y curiosos. Están convirtiéndose rápidamente en parte esencial de nuestra vida diaria, simplificando tareas y mejorando la accesibilidad.
Adentrémonos en el mundo de TTS y STT con IA para descubrir qué son, en qué se diferencian, cómo funcionan, qué buscar en proveedores de TTS y STT, y las distintas formas en que se aplican en todos los sectores.
Diferencias entre TTS y Texto desde Voz
Existen varias diferencias clave entre TTS y la tecnología de texto desde voz. Son las siguientes.
Funcionalidad
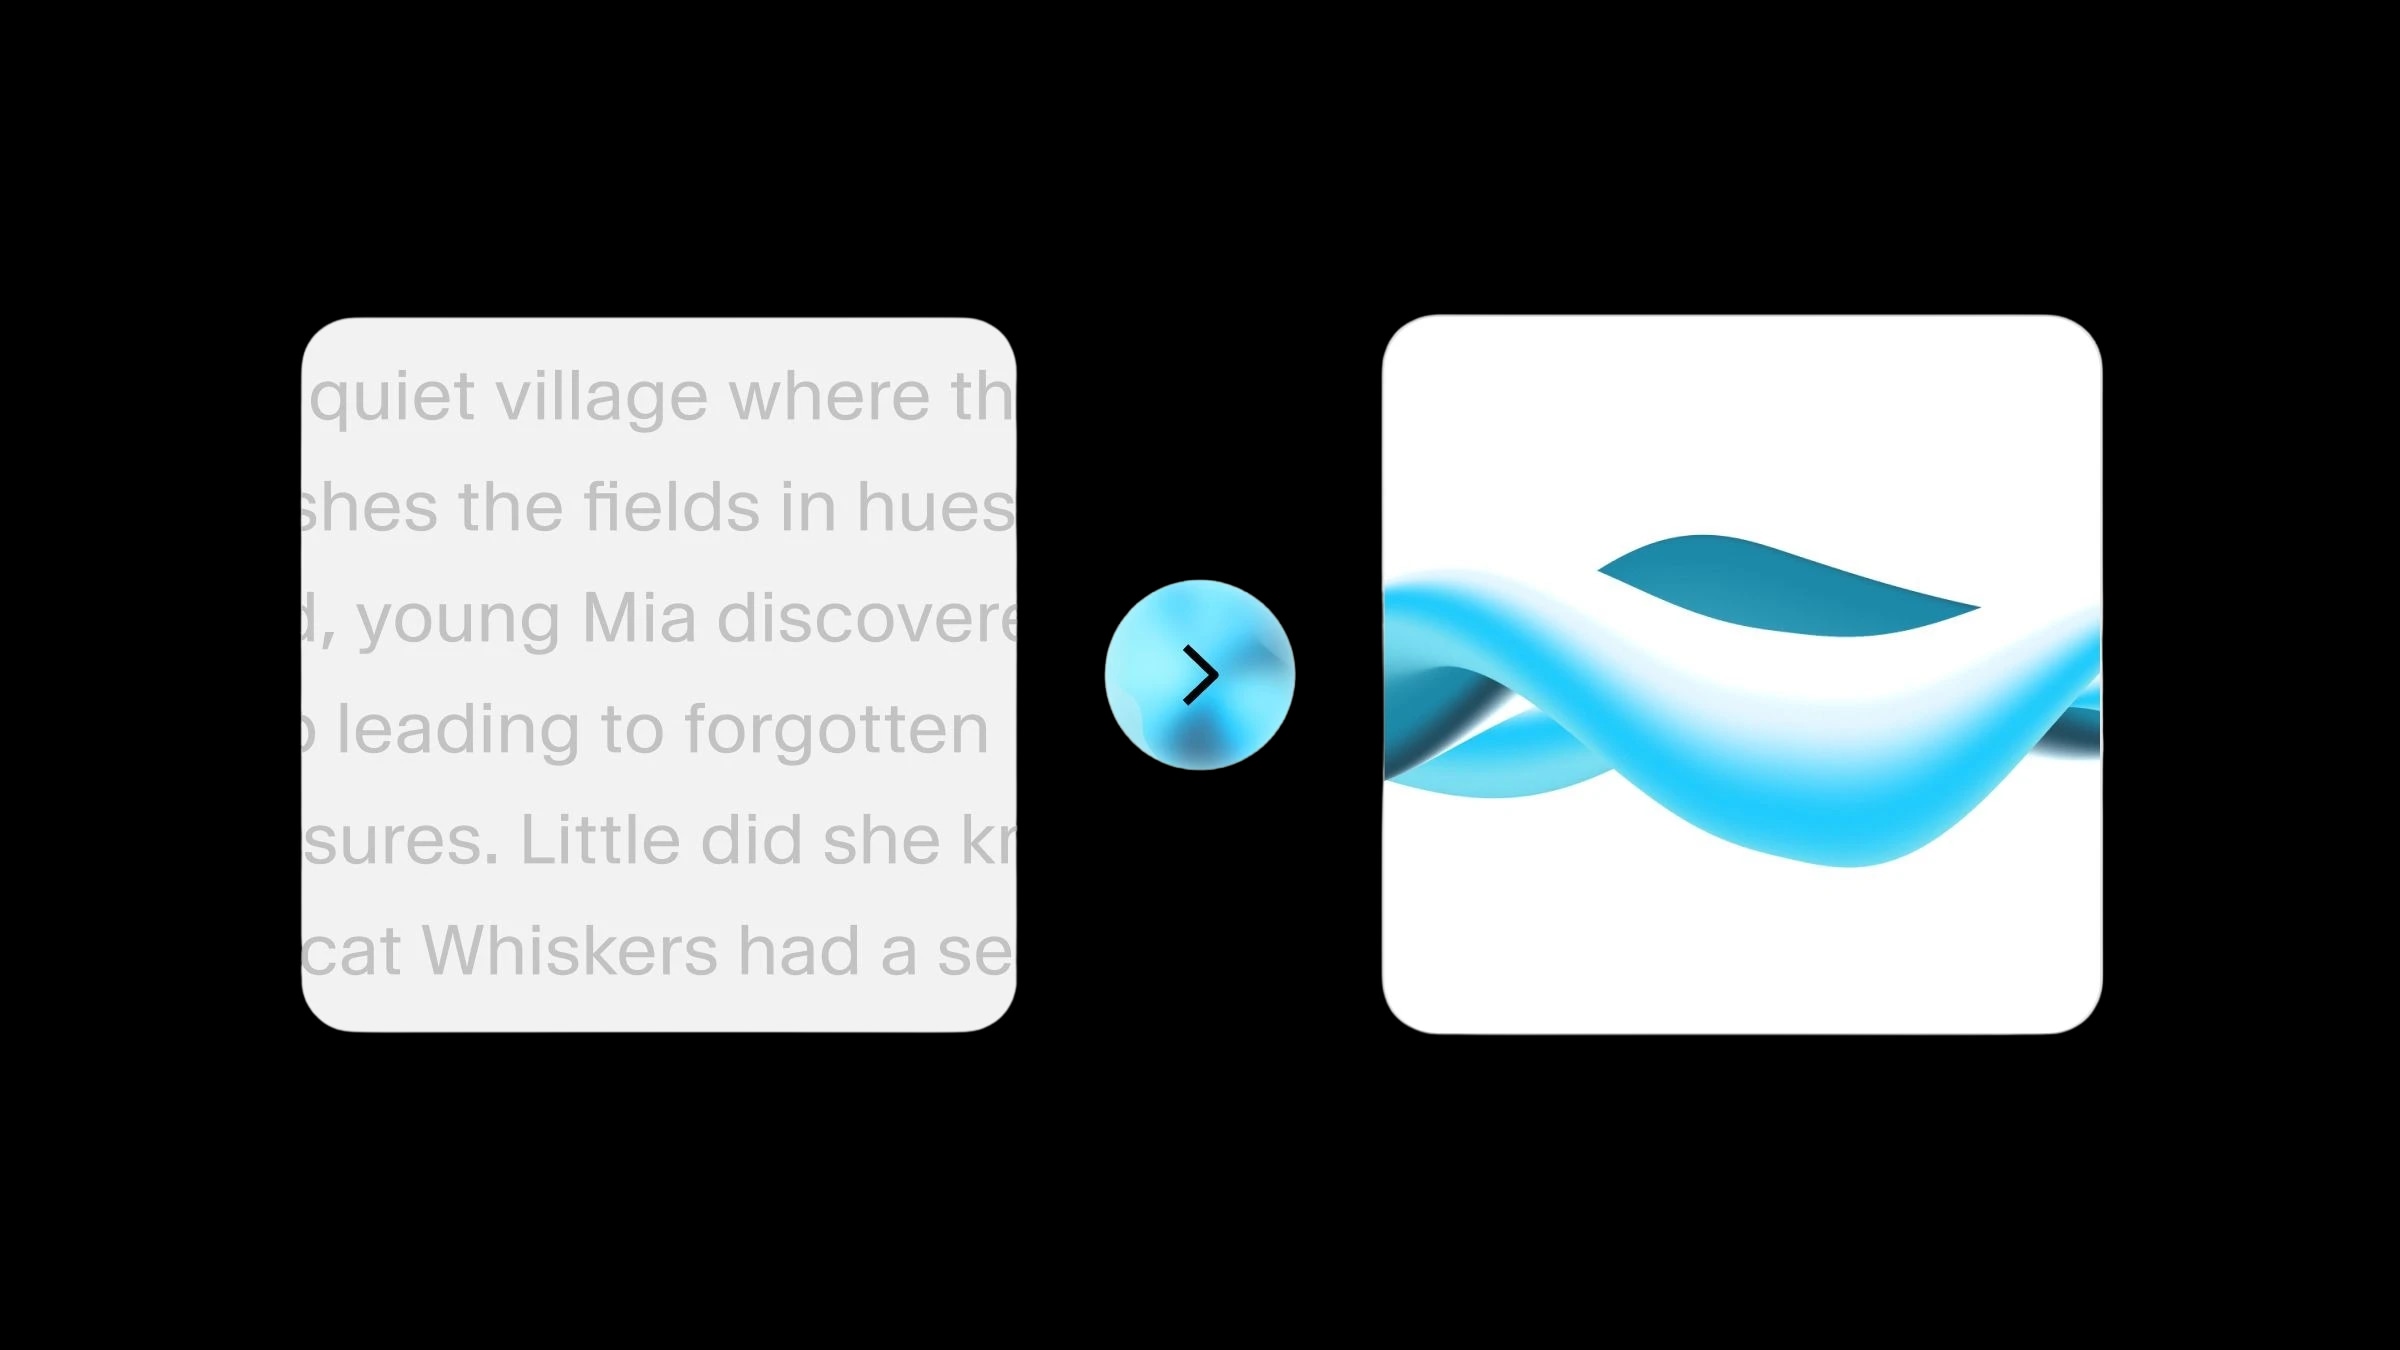
TTS (TTS) convierte texto escrito en palabras habladas, mientras que Voz a Texto (STT) hace lo contrario: transcribe las palabras habladas a texto. TTS se utiliza para hacer audible el contenido escrito y actúa como un asistente de voz para personas con discapacidad visual o dificultades de aprendizaje. Por otro lado, STT captura el lenguaje hablado y lo convierte en una transcripción escrita, útil para dictados y comandos de voz.
Contexto de uso
TTS suele integrarse en lectores electrónicos, sistemas de megafonía y asistentes virtuales para ofrecer una salida de audio. STT se utiliza en servicios de transcripción, aplicaciones controladas por voz y subtitulado en tiempo real para personas con discapacidad auditiva. El contexto de uso de TTS se centra principalmente en la salida de información audible. En cambio, STT se orienta a la entrada, es decir, a capturar y procesar el lenguaje hablado.
Enfoque tecnológico
TTS implica análisis de texto, procesamiento del lenguaje y síntesis de voz. Debe transmitir con precisión los matices del lenguaje hablado, incluida la entonación y el ritmo. STT requiere capacidades avanzadas de reconocimiento de voz para transcribir con precisión distintos acentos, dialectos y patrones de habla, a menudo en tiempo real.
¿Qué es TTS (TTS)?
TTS (TTS) es una tecnología que convierte texto escrito en palabras habladas. En esencia, TTS permite a los ordenadores leer en voz alta y transformar cualquier texto en una voz sintética. Esta tecnología se utiliza ampliamente en aplicaciones que van desde asistentes virtuales hasta herramientas de accesibilidad para personas con dificultades de lectura.
Un ejemplo destacado de tecnología TTS avanzada son las capacidades de TTS de ElevenLabs. El TTS de ElevenLabs destaca por su capacidad de generar voces excepcionalmente naturales y parecidas a las humanas. Lo consigue mediante sofisticados algoritmos de IA que no solo imitan el sonido del habla humana, sino que también entienden y reproducen los matices e inflexiones propios de los patrones naturales del habla.
Este nivel de realismo hace que el TTS de ElevenLabs sea ideal para crear contenido de audio atractivo para distintos medios, mejorar las interfaces de usuario con respuestas de voz y ofrecer una alternativa de lectura accesible para usuarios con discapacidad visual.
¿Qué es Texto desde Voz (Voz a Texto, STT)?
Texto desde Voz, también conocido como Voz a Texto (STT), es el proceso de convertir el lenguaje hablado en texto escrito. Esta tecnología de reconocimiento de voz es fundamental para crear transcripciones de grabaciones de audio, habilitar comandos de voz y facilitar el subtitulado en tiempo real para mejorar la accesibilidad.
ElevenLabs ha logrado avances importantes en tecnología STT. Nuestro modelo Scribe convierte de forma eficiente audio y vídeo en texto en 99 idiomas. Ofrece una interfaz fácil de usar, por lo que es ideal para plasmar por escrito reuniones, conferencias y entrevistas a partir de archivos de audio y vídeo.
¿Cómo funciona TTS?
La tecnología TTS (TTS) transforma texto escrito en voz audible mediante un proceso que implica varios pasos complejos.
Inicialmente, el sistema de TTS analiza el texto y lo segmenta en fonemas, las unidades de sonido más pequeñas de cualquier idioma. Esta segmentación es fundamental para que el sistema pueda pronunciar con precisión distintas palabras.
Tras esta segmentación fonémica, el sistema convierte estos sonidos en voz digital. Aquí, la inteligencia artificial (IA) desempeña un papel crucial. Gracias a algoritmos de IA entrenados con extensos conjuntos de datos de lenguaje hablado, el sistema puede generar voz con tonos y ritmos similares a los humanos. Esta voz generada se alinea después con los fonemas identificados, lo que da como resultado una salida de sonido natural.
Gracias a los avances en IA y aprendizaje automático, las tecnologías modernas de TTS han evolucionado notablemente. Ahora son capaces de comprender matices contextuales, admitir varios idiomas y emular en cierta medida las inflexiones emocionales. Estas mejoras han humanizado considerablemente la voz generada, dando lugar a interacciones más naturales y atractivas con dispositivos digitales.
¿Cuáles son los mejores proveedores de TTS?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
¿Cómo funciona Voz a Texto?
La tecnología Voz a Texto (STT) transforma el lenguaje hablado en texto escrito mediante un proceso complejo de varios pasos.
En primer lugar, captura las palabras habladas, normalmente mediante un micrófono. Esta entrada de audio se convierte después a un formato digital que el sistema puede procesar. El núcleo de STT está en su capacidad de analizar este audio digital. Utiliza algoritmos sofisticados para dividir el habla en segmentos más pequeños y reconocibles.
Estos segmentos son fonemas, las unidades de sonido más pequeñas del habla. El sistema STT compara estos fonemas con un modelo lingüístico predefinido para identificar palabras y frases. Este paso es crucial para comprender distintos acentos, dialectos y variaciones del habla.
A continuación, el sistema aplica técnicas de procesamiento del lenguaje natural (PLN). El PLN ayuda a comprender el contexto y la sintaxis del lenguaje hablado, lo que permite una transcripción más precisa. También permite al sistema manejar estructuras oracionales complejas y jerga específica de cada sector.
Los sistemas STT avanzados emplean algoritmos de aprendizaje automático y aprendizaje profundo, que mejoran con más datos y uso. Estas tecnologías permiten al sistema aprender con el tiempo nuevos patrones de habla, acentos e incluso idiomas, mejorando su precisión y eficiencia.
En resumen, la tecnología STT implica captura de audio, análisis fonémico, modelado lingüístico y PLN, todo ello respaldado por aprendizaje automático para convertir eficazmente la voz en texto.
¿Cuáles son los mejores proveedores de Voz a Texto?
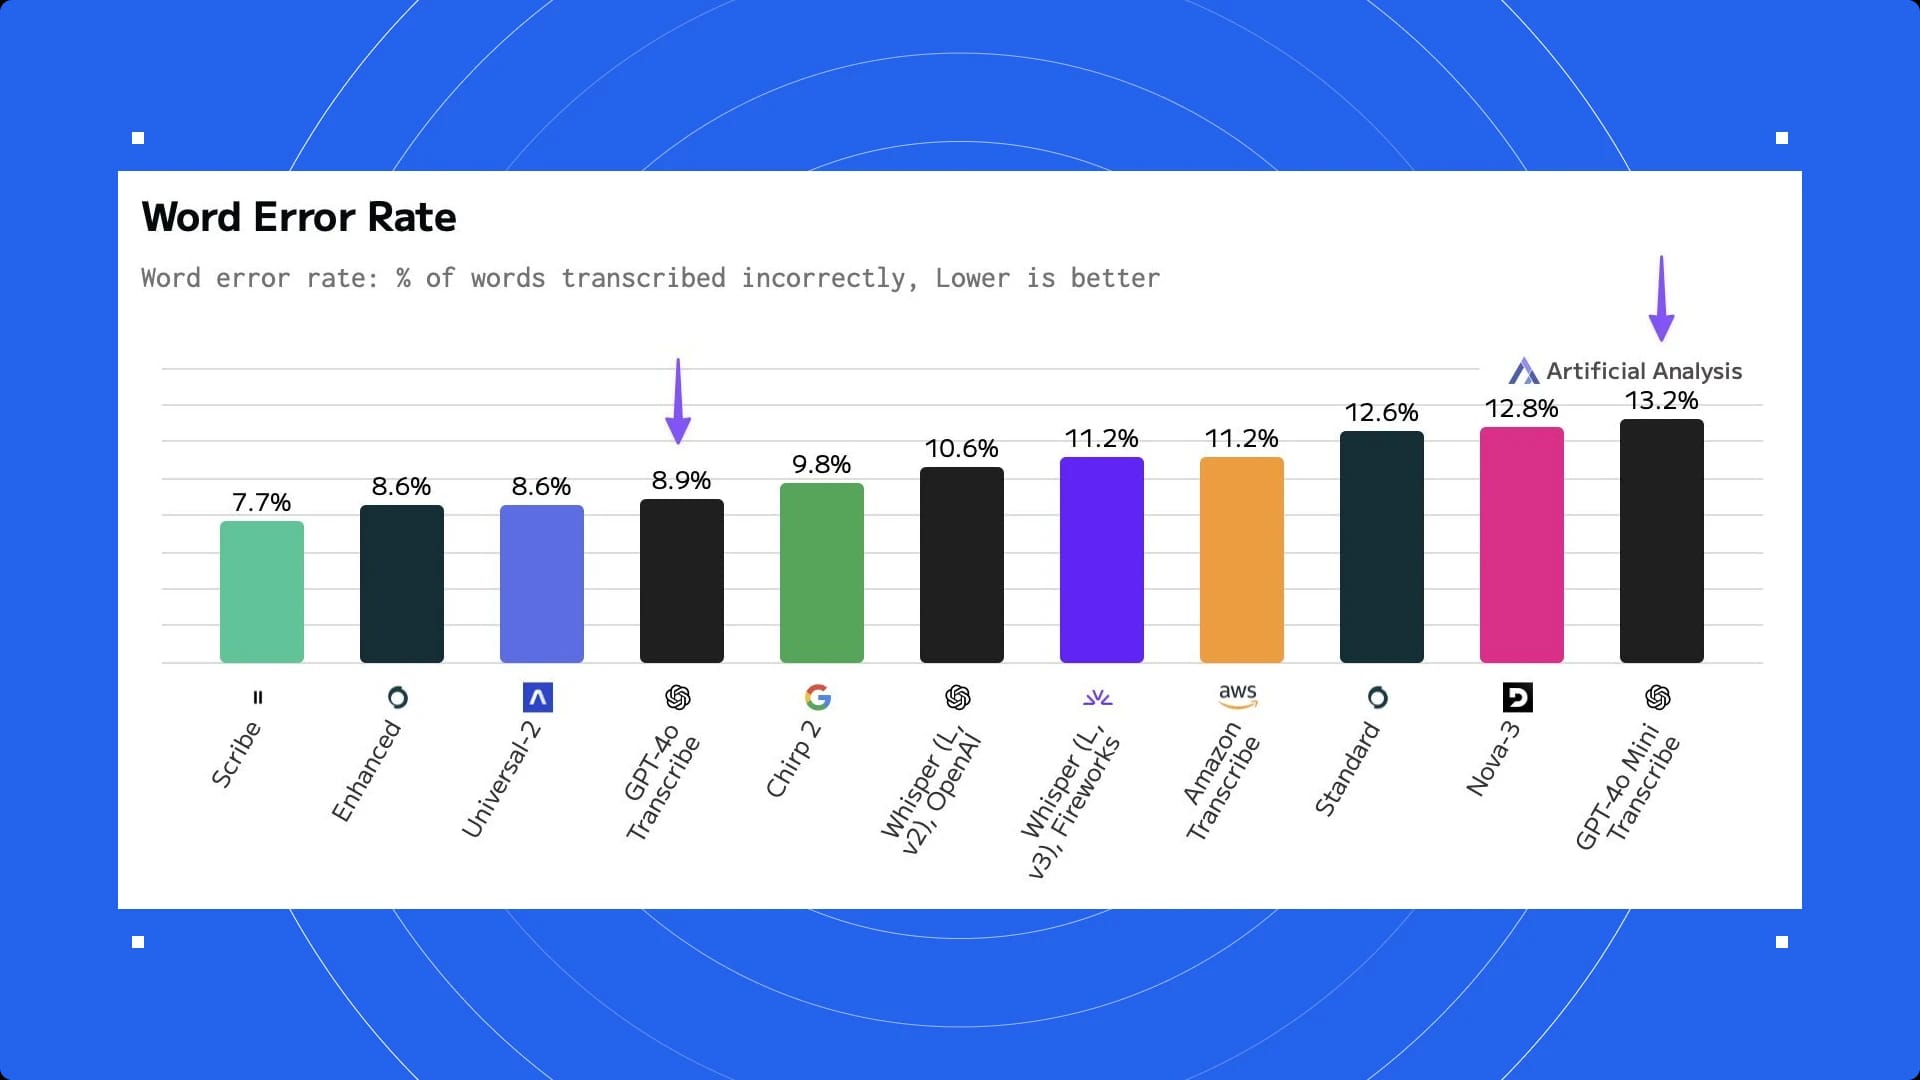
Los mejores proveedores de voz a texto son Scribe de ElevenLabs, seguido de OpenAI y otros proveedores como Google.
TTS y STT: precisión y desafíos
Las tecnologías TTS y Voz a Texto aspiran a una precisión similar a la humana. Su precisión mejora constantemente, pero eso no significa que sea perfecta. Esto es lo que puedes esperar en cuanto a precisión y desafíos de ambas tecnologías.
Precisión y desafíos de TTS (TTS)
La tecnología de TTS de voz IA ha evolucionado significativamente, pero sigue enfrentándose a desafíos. El principal es conseguir voces humanas que suenen naturales. Aunque los sistemas TTS modernos pueden generar audio claro y comprensible, incorporar inflexiones y emociones humanas sigue siendo un obstáculo. Además, TTS tiene dificultades para interpretar el contexto y a veces pronuncia mal las palabras según este. Otro desafío es personalizar las voces para adaptarlas a necesidades diversas, como distintos acentos y patrones de habla, algo esencial para una accesibilidad global.
Precisión y desafíos de Texto desde Voz/Voz a Texto (STT)
La tecnología STT ha avanzado en precisión, especialmente con la llegada del aprendizaje profundo. Sin embargo, encuentra dificultades en entornos ruidosos, donde los sonidos de fondo pueden interferir con el reconocimiento de voz. Capturar y transcribir con precisión diversos acentos y dialectos también plantea un desafío importante. Además, los sistemas STT suelen tener dificultades con los homófonos —palabras que suenan igual pero tienen significados distintos— y para comprender sintaxis complejas o jerga, lo que afecta a su eficacia general en aplicaciones reales.
Aplicaciones en distintos sectores
TTS y Voz a Texto han encontrado casos de uso innovadores en una gran variedad de sectores, transformando nuestra forma de interactuar con la información y mejorando la accesibilidad.
Aplicaciones de TTS en distintos sectores
La tecnología TTS se aplica en diversos sectores. En educación, ayuda a crear materiales de aprendizaje accesibles para estudiantes con dificultades de lectura o discapacidad visual. Por ejemplo, al convertir libros de texto en audiolibros.
En el sector de la automoción, TTS impulsa las respuestas de voz de los sistemas de navegación. El sector de atención al cliente utiliza TTS para las respuestas automatizadas en centros de llamadas, lo que mejora la eficiencia. Además, TTS desempeña un papel importante en el entretenimiento, especialmente en videojuegos y asistentes virtuales, donde ofrece experiencias de usuario interactivas.
Aplicaciones de STT en distintos sectores
La tecnología STT tiene aplicaciones diversas en múltiples sectores. En sanidad, ayuda a transcribir conversaciones entre médicos y pacientes, así como a dictar documentación clínica, mejorando así la eficiencia. En el ámbito jurídico, STT se utiliza para transcribir procedimientos judiciales y documentos legales. La tecnología también desempeña un papel fundamental en los medios, al facilitar el subtitulado en tiempo real de emisiones para personas con discapacidad auditiva. En el mundo corporativo, STT permite transcribir reuniones de forma eficiente, mejorando el registro y la accesibilidad de la información.
Conclusiones
Las tecnologías TTS (TTS) y Voz a Texto (STT), aunque puedan parecer similares, cumplen funciones distintas. TTS transforma texto escrito en palabras habladas y da vida al contenido escrito con voces similares a las humanas. En cambio, STT hace lo contrario: convierte palabras habladas en texto escrito y captura los matices del lenguaje hablado en formato textual.
Ambas tecnologías aprovechan IA avanzada, pero responden a necesidades diferentes: TTS para consumir de forma auditiva material escrito y STT para crear registros escritos de contenido hablado.
¿Listo para empezar? Prueba Eleven v4, nuestro modelo de Texto a Voz más expresivo.
Si quieres probar tecnología TTS de última generación, regístrate en ElevenLabs hoy. No te decepcionará.