Cómo funciona la tecnología de texto a voz: del texto a una voz natural
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
La tecnología de texto a voz (TTS) transforma palabras escritas en audio hablado. Primero, el sistema interpreta qué dice el texto y cómo debe sonar; después, un modelo de IA genera el audio.
Al principio, un motor TTS normaliza el texto de entrada y lo convierte en tokens matemáticos y representaciones vectoriales que un sistema informático puede manipular. Después, el modelo transforma esas construcciones matemáticas en representaciones digitales de sonido y, por último, en audio.
En este artículo, veremos cómo funcionan las distintas herramientas de texto a voz y cómo la última generación de síntesis de voz neuronal con IA generativa ofrece la voz más natural hasta la fecha.
Resumen
- Los sistemas de texto a voz convierten palabras escritas en audio en dos fases. Convierten el texto en tokens, o representaciones matemáticas del lenguaje. Después, transforman los tokens en una representación acústica que se reproduce como sonido.
- Los nuevos motores TTS neuronales utilizan modelos de IA para producir una voz natural. Equipos empresariales los usan para crear contenido, subtitular y potenciar agentes de atención al cliente.
- Los diccionarios de pronunciación y el etiquetado fonético son dos formas de ajustar la salida de TTS para que suene lo más natural posible y garantizar que la jerga técnica y los nombres se pronuncien correctamente.
- Una API de Texto a Voz te permite conectar aplicaciones empresariales con generación de voz de alta calidad.
¿Qué es TTS? Cómo funciona la tecnología de texto a voz
El texto a voz analiza el texto escrito, decide cómo debe sonar cada palabra y utiliza un modelo neuronal y un vocoder para generar el audio hablado.
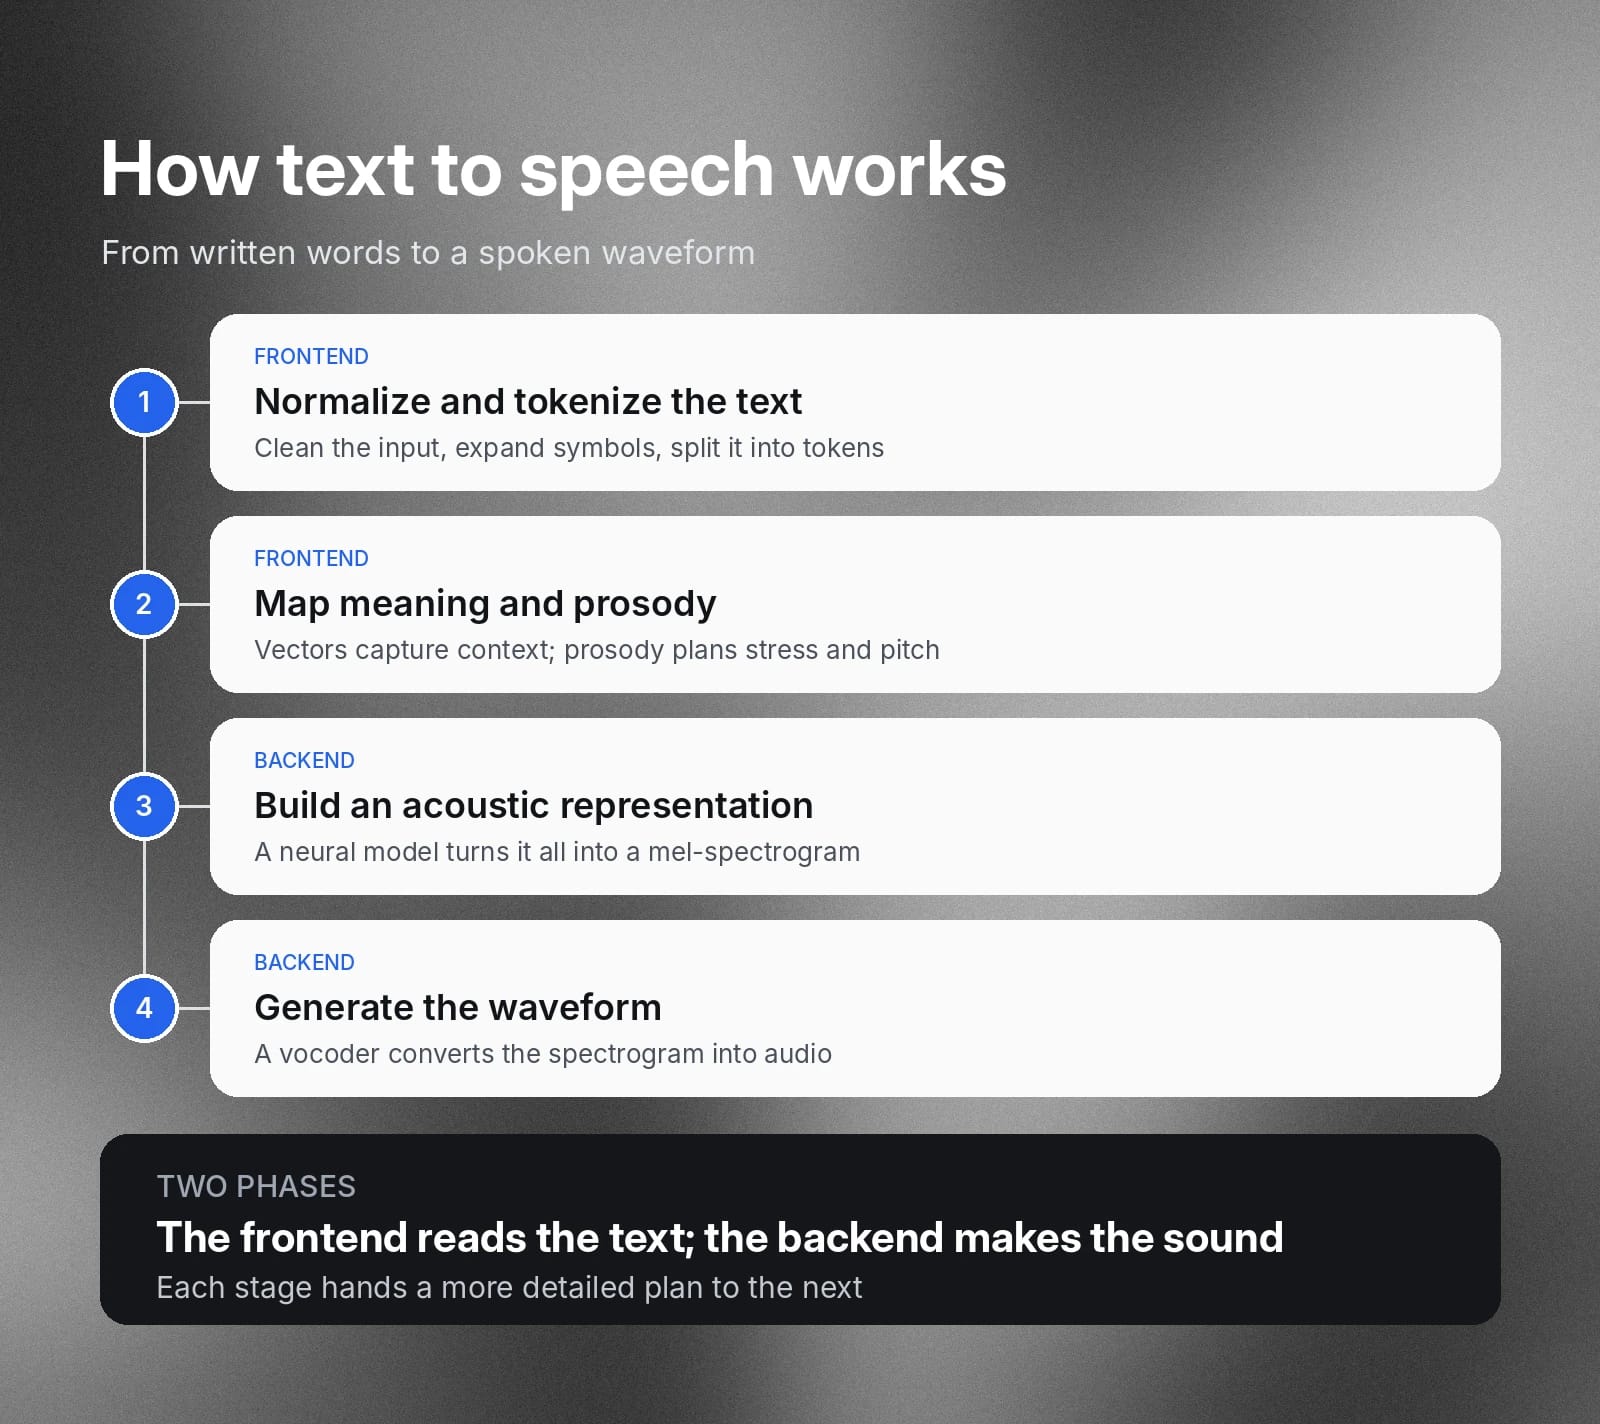
En términos generales, TTS se divide en dos fases:
- Frontend: el sistema convierte el texto en una forma matemática con la que puede trabajar el motor TTS.
- Backend: el sistema toma la salida de la primera fase y la transforma en formas de onda que modelan el habla.
Veamos con más detalle los componentes del funcionamiento de TTS.
Normalización de texto y análisis lingüístico
El primer paso de un proceso TTS es el procesamiento del lenguaje natural (PLN): limpiar, tokenizar y desambiguar el texto de entrada sin procesar. Divide el texto en tokens, unidades individuales del lenguaje escrito que un motor TTS puede manipular. Un token puede ser una palabra completa, una unidad de «subpalabra» o un signo de puntuación.
El texto suele contener símbolos además de palabras completas, como abreviaturas y números. Un motor TTS también debe determinar cómo pronunciar esos elementos. Por ejemplo, el motor TTS lee «$11» y convierte ese texto en los sonidos de «once dólares».
Significado semántico y prosodia
Prosodia es el tono y el ritmo del habla, lo que hace que TTS suene natural. Al procesar el texto, el motor también genera una capa de información prosódica que asigna cambios de énfasis y entonación al texto para que suene más natural.
Un motor TTS también debe adaptar su pronunciación de texto a voz según el contexto. Reunirá esta información en forma de representaciones vectoriales, datos numéricos que reflejan la similitud semántica entre palabras y frases. Piensa en un gráfico X-Y en el que se traza una línea a través de varios puntos, pero representado en muchas más de dos dimensiones.
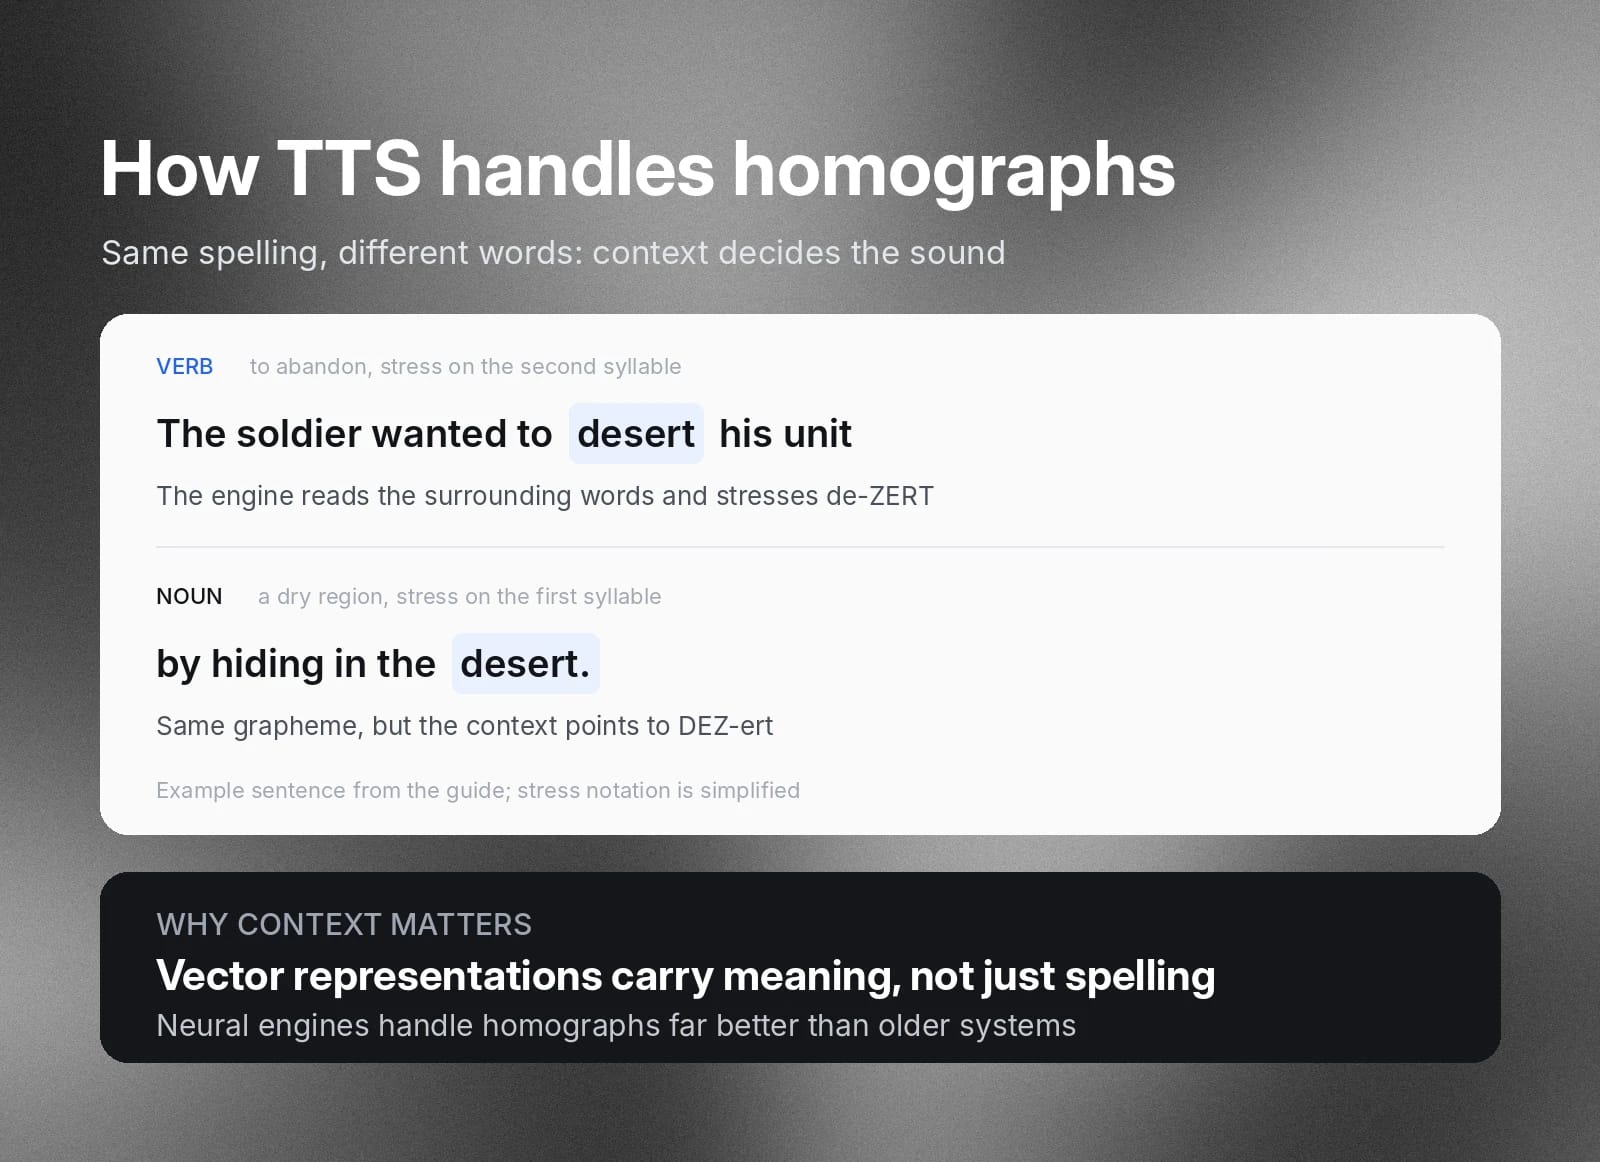
Un ejemplo concreto son los homógrafos. Los homógrafos, es decir, palabras distintas que comparten grafía, a veces deben pronunciarse de forma diferente. El motor TTS debe identificar la entonación y el énfasis que debe usar en cada una al hablar. Por ejemplo, cómo pronunciar el grafema «desert» en la frase «The soldier wanted to desert his unit by hiding in the desert.»
Mira cómo Eleven v4 da vida a este ejemplo.
Modelado acústico y síntesis de formas de onda (voz)
El motor TTS toma la información tokenizada y los vectores contextuales, que ahora son datos numéricos, y los convierte en una representación acústica, como un espectrograma mel. Esto incluye distintas frecuencias, niveles de energía y sonidos que el cerebro interpreta como emoción. En el pasado se han usado muchos sistemas para realizar esta función, pero hoy los modelos neuronales se encuentran entre los más eficaces.
El último paso utiliza un vocoder para convertir estos espectrogramas en audio que las personas reconocen como voz. Este proceso se denomina generación de formas de onda.
TTS en acción: un ejemplo práctico
La forma más sencilla de ver cómo encajan las etapas de TTS es seguir una única frase a través del proceso.
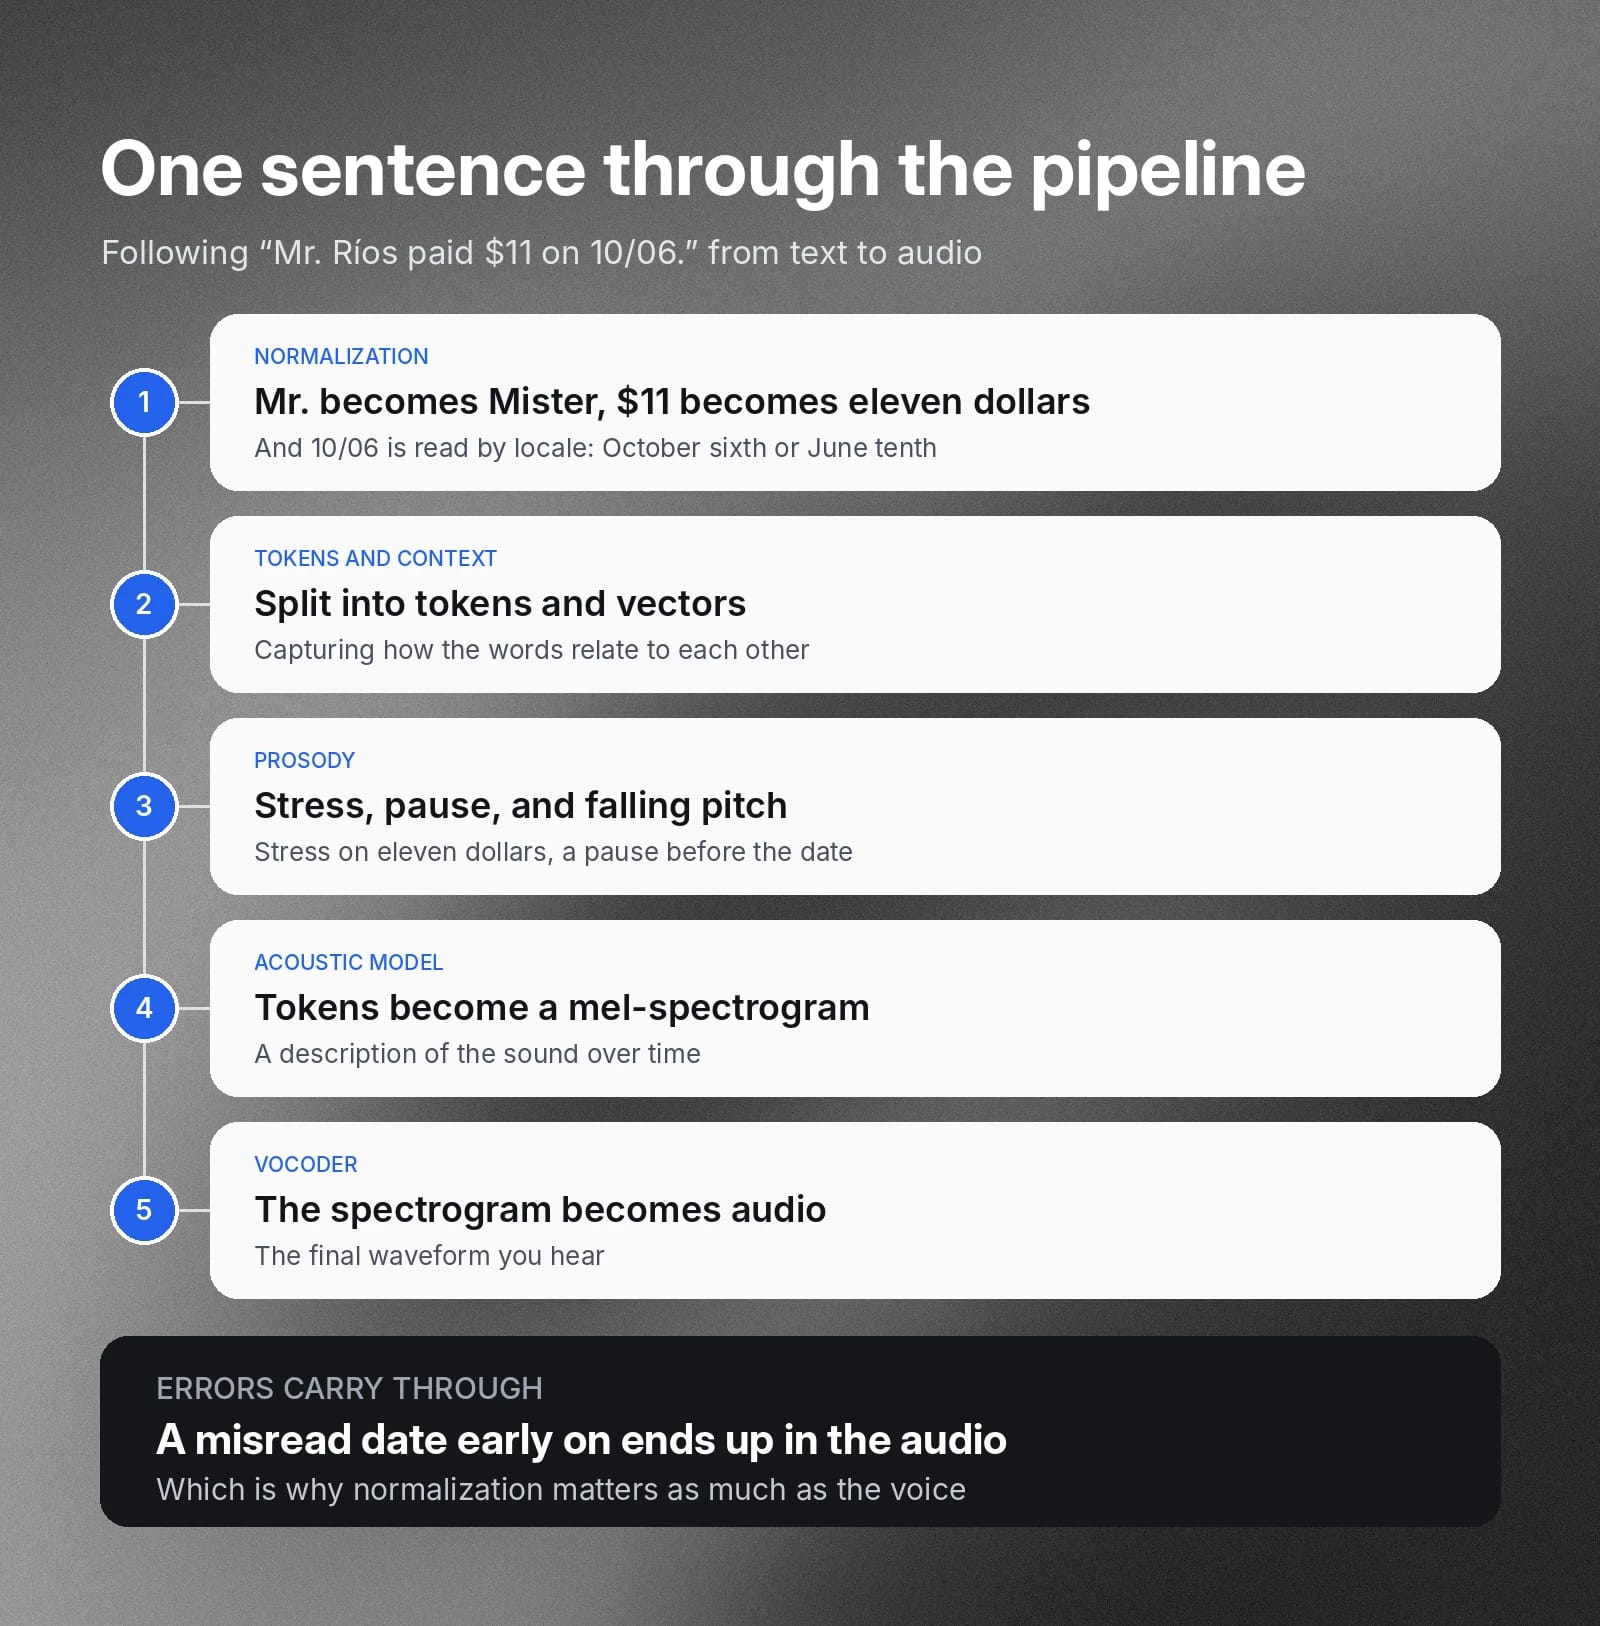
Tomemos el texto «El Sr. Ríos pagó 11 $ el 10/06».
- Normalización: el motor amplía «Sr.» a «señor», lee «11 $» como «once dólares» y decide si «10/06» es «diez de junio» o «seis de octubre», según la configuración regional y el contexto.
- Tokenización y contexto: el texto limpio se divide en tokens y se convierte en vectores que capturan cómo se relacionan las palabras entre sí.
- Prosodia: el motor enfatiza «once dólares», añade una breve pausa antes de la fecha y deja caer el tono al final de la frase.
- Modelo acústico: el modelo neuronal convierte los tokens y el plan prosódico en un espectrograma mel que describe el sonido a lo largo del tiempo.
- Vocoder: el vocoder convierte el espectrograma en la forma de onda de audio final que escuchas.
Cada etapa proporciona un plan más detallado a la siguiente, por lo que los errores al inicio del proceso, como interpretar mal una fecha, se trasladan al audio final.
¿Por qué el texto a voz neuronal suena más humano?
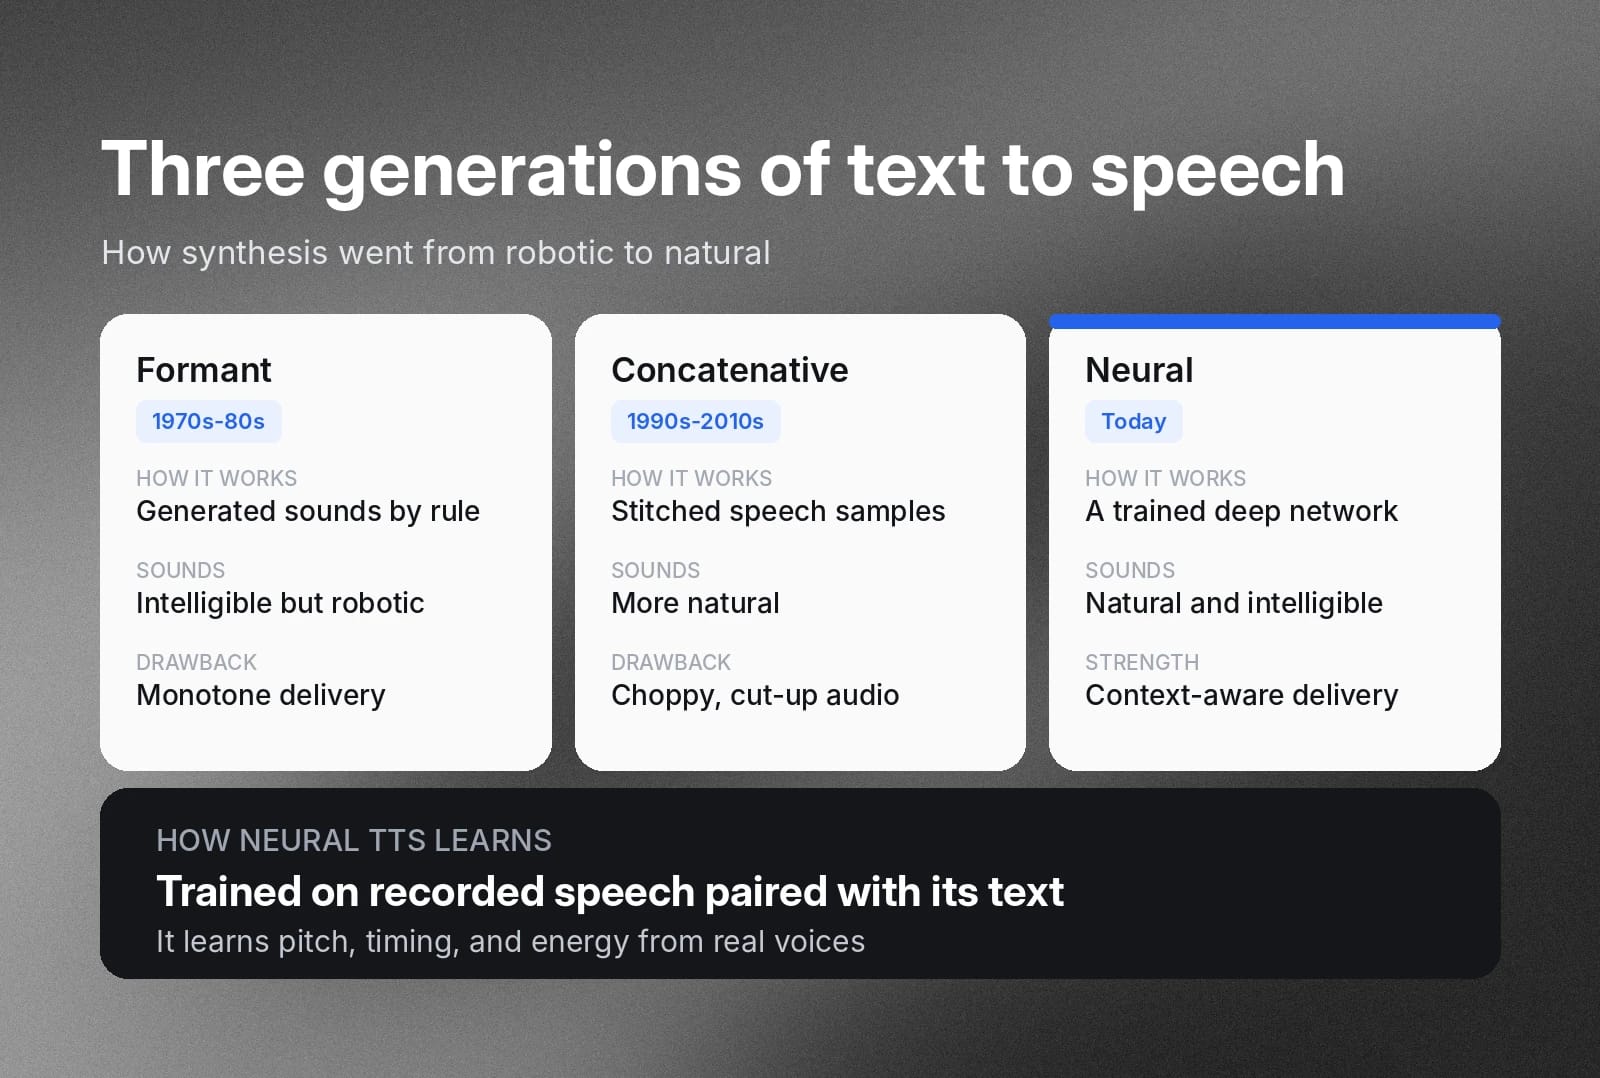
La síntesis de voz neuronal destaca al producir una voz natural e inteligible, las dos cualidades que usan ingenieros para evaluar motores TTS. El TTS neuronal funciona entrenando una red neuronal profunda (DNN) para producir voz a partir de texto. La DNN se entrena con grandes volúmenes de voz grabada junto con el texto correspondiente.
Los motores de síntesis de voz neuronal son solo la última evolución del TTS de nivel empresarial. Antes hubo dos generaciones de tecnología de síntesis comercial.
La síntesis por formantes fue el modo dominante en las décadas de 1970 y 1980. En lugar de tomar muestras de voz humana para producir la salida en tiempo de ejecución, generaba sonidos sintéticos que modelaban el habla. Era inteligible, pero monótona y sonaba robótica.
La síntesis concatenativa dominó desde la década de 1990 hasta la de 2010 y sonaba más natural que los sistemas por formantes anteriores. En lugar de generar tonos basados en reglas matemáticas, unía o concatenaba pequeñas muestras de voz humana. Estos sistemas usaban tablas de consulta lingüísticas para asociar texto normalizado con sonidos y después emitían pequeñas unidades de audio de voz concatenada extraídas de una enorme biblioteca, o «corpus». Aunque suena más natural que la voz de un motor por formantes, la concatenación aún puede hacer que la voz suene entrecortada o fragmentada.
¿Qué diferencia hay entre un generador de voz IA y el texto a voz?
«Generador de voz IA» es un término que suele utilizarse en marketing para describir una amplia gama de tecnologías de voz, incluido el texto a voz. El texto a voz se refiere específicamente a sistemas que reciben texto escrito, modelan su semántica y prosodia, y generan formas de onda de audio.
Los generadores de voz IA forman un ecosistema completo de tecnologías de voz relacionadas, que incluye TTS y otros sistemas generativos para diseño de voz, clonación de voz y transferencia de estilo de voz. Aunque en marketing suele emplearse como sinónimo de texto a voz, generador de voz IA describe mejor la categoría más amplia de herramientas de voz generativa de la que TTS forma parte.
Cómo usar texto a voz para contenido, accesibilidad y atención al cliente
Los modelos de Texto a Voz se han convertido en una parte central de los flujos de trabajo de todo el mundo, tanto en ámbitos personales como comerciales.
Estos son algunos de los principales casos de uso del texto a voz.
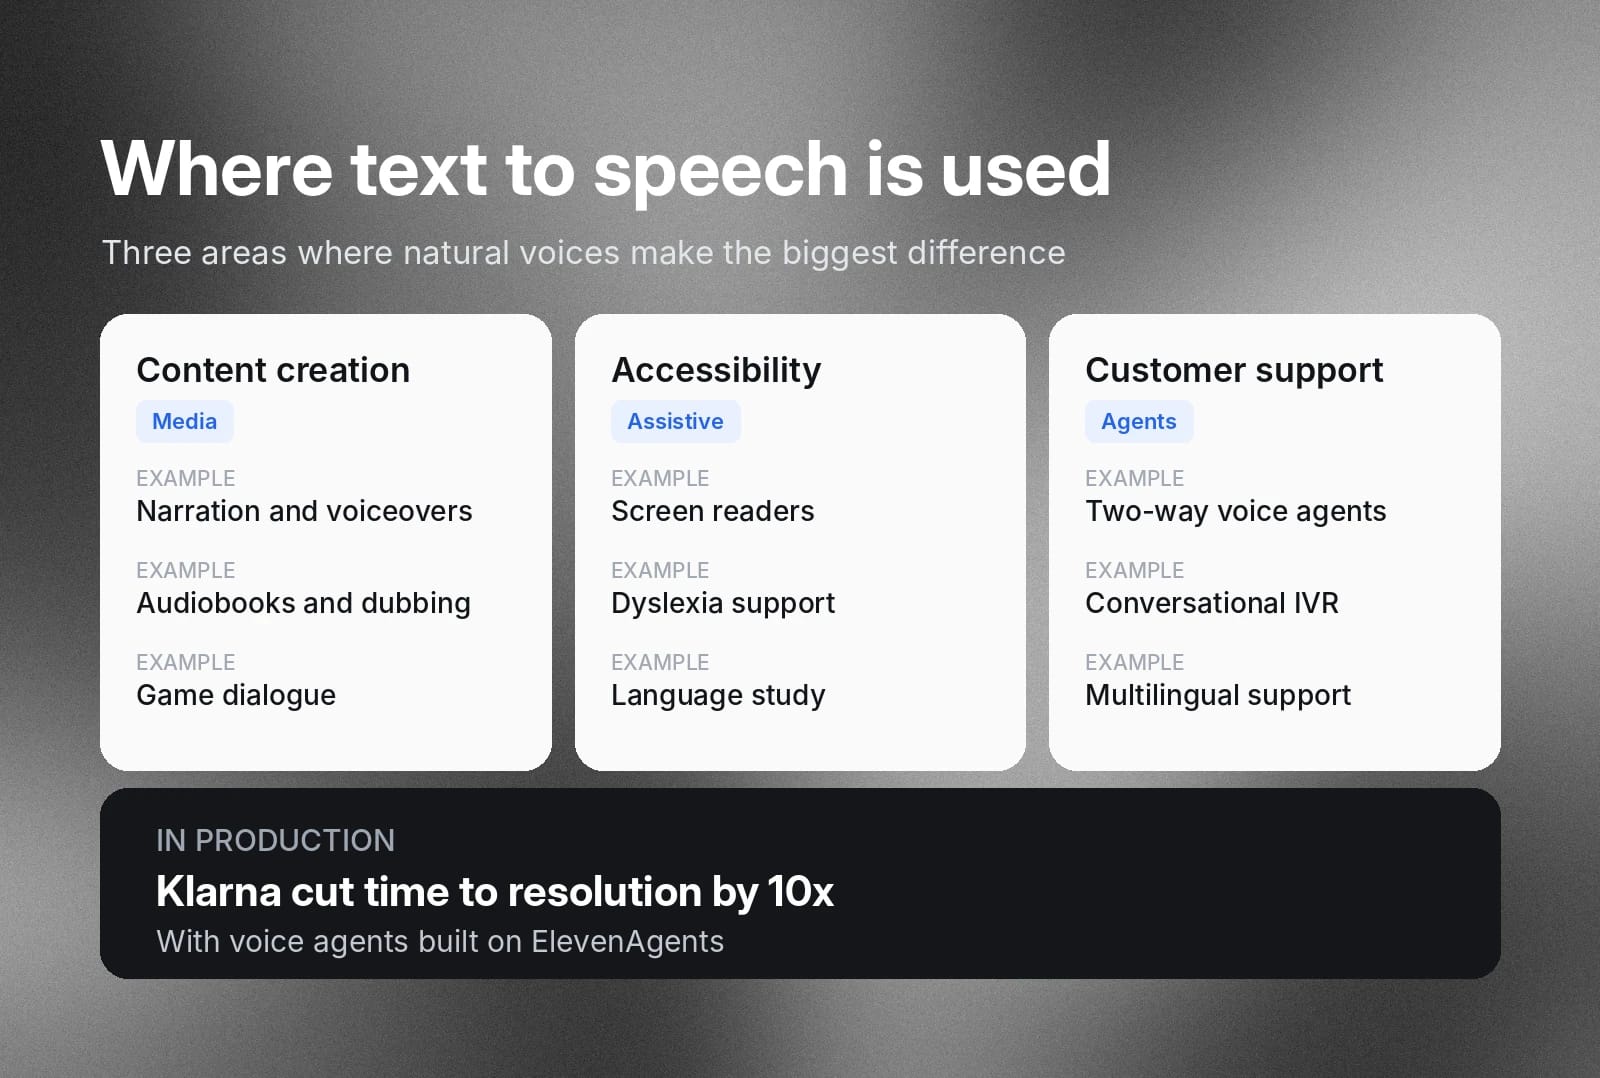
Creación de contenido
Las herramientas de texto a voz pueden ayudar a reducir los costes de producción de medios a gran escala y el tiempo de estudio dedicado a la narración y a retoques de posproducción.
Entre los casos de uso se incluyen:
- Narración
- Locuciones
- Doblaje IA
- Producción de audiolibros
- Diálogos para videojuegos
Por ejemplo, TAP usó TTS de ElevenLabs para ampliar contenido educativo para escuelas de toda la India.
Accesibilidad
El texto a voz es una de las tecnologías de asistencia más utilizadas porque permite acceder al contenido escrito mediante la escucha. Una voz natural mejora la interacción de quien escucha y reduce la fatiga mental al escuchar contenido largo.
Entre los usos habituales de accesibilidad con TTS se incluyen:
- Lectores de pantalla: leen páginas completas en voz alta mediante un lector de pantalla y TTS.
- Apoyo para dislexia y alfabetización: reduce la carga de leer acompañando las sesiones de lectura con una voz TTS.
- Baja visión y ceguera: los lectores de pantalla leen en voz alta los elementos de la interfaz y el contenido de las páginas, para que las personas puedan navegar por software y sitios web sin ver la pantalla.
- Diferencias cognitivas y de atención: escuchar texto puede reducir el esfuerzo de leer documentos largos y facilitar la concentración.
- Aprendizaje y estudio de idiomas: estudiantes escuchan la pronunciación correcta de vocabulario nuevo y pueden oír libros de texto mientras se desplazan o estudian.
Los lectores de pantalla son herramientas de accesibilidad completas que describen todo lo que aparece en una pantalla, incluidos botones y menús. Las herramientas de lectura en voz alta se centran en reproducir el contenido en sí, normalmente con un resaltado que lo acompaña, y se benefician de voces más naturales porque se utilizan durante periodos prolongados.
Atención al cliente
La síntesis de voz neuronal puede ofrecer una experiencia de cliente de alta calidad cuando se combina con un LLM capaz de realizar interacciones autónomas. Plataformas como ElevenAgents combinan la capa de voz con reconocimiento de voz, un LLM y herramientas conectadas que permiten a un agente entender qué necesita quien llama y responder con una voz natural.
Los agentes creados con ElevenAgents funcionan por teléfono, web, WhatsApp, correo electrónico y SMS, para que clientes puedan continuar una conversación entre canales sin tener que repetirse. Entre los casos de uso se incluyen:
- Agentes de voz IA bidireccionales: gestionan conversaciones en directo respondiendo preguntas de una base de conocimiento o dirigiendo a clientes a flujos específicos, como reembolsos o compras.
- Sistemas de respuesta de voz interactiva (IVR): sustituyen los anticuados árboles de menú de «Pulse 3 para ventas» por conversaciones en las que tus clientes pueden hablar con naturalidad.
- Atención multilingüe: atiende a clientes en su propio idioma desde una única configuración de agente.
Klarna, por ejemplo, redujo el tiempo de resolución en 10 veces con ElevenAgents
¿Cómo controlan la pronunciación los motores de texto a voz?
Los motores modernos de síntesis de voz neuronal pueden generar una voz muy natural, pero siempre habrá casos límite en algo tan amplio, profundo y dinámico como el lenguaje humano. Quizá quieras conservar acentos, jerga o pronunciaciones regionales en la voz generada. Puede que produzcas audio para un sector con pronunciaciones específicas de términos técnicos. O quizá simplemente quieras que el nombre de tu marca se pronuncie de una forma muy concreta y coherente.
Diccionarios de pronunciación y sustituciones de fonemas
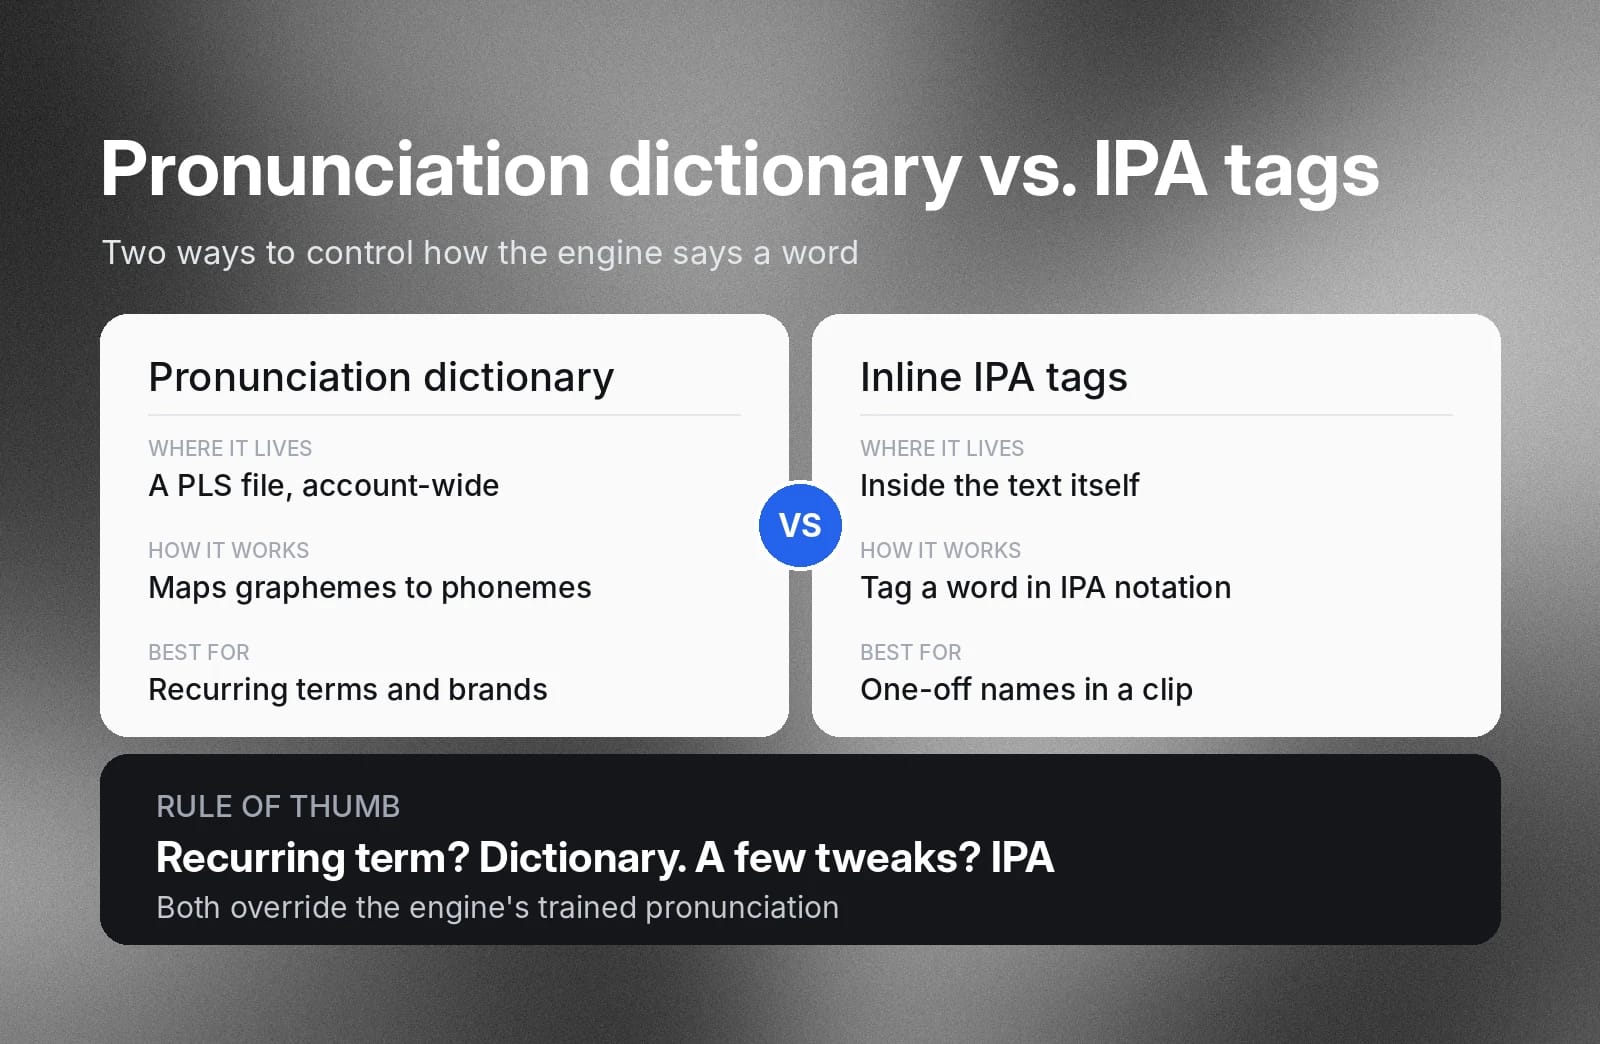
ElevenAPI de ElevenLabs incluye un diccionario de pronunciación que te permite personalizar cómo habla el motor. Creas un diccionario en un archivo de especificación de léxico de pronunciación (PLS) estándar del W3C que asigna grafemas (símbolos en el texto) a fonemas (palabras habladas descompuestas en sonidos). Cuando el motor TTS encuentra uno de los grafemas incluidos, sustituye la pronunciación con la que se entrenó y usa la pronunciación fonética del diccionario.
Puedes aprender a crear un diccionario de pronunciación en ElevenAPI en la documentación de Uso de diccionarios de pronunciación.
AFI nativo y prompting fonético
Algunos modelos TTS también pueden reconocer etiquetas de pronunciación en línea incrustadas directamente en el texto de entrada. Así, en lugar de crear un diccionario para toda la cuenta, si solo quieres ajustar pronunciaciones en uno o dos clips de audio, puedes etiquetar las palabras en el texto mediante notación AFI estándar. Por ejemplo, si grabas un audiolibro y quieres que el nombre de un personaje ficticio se pronuncie de una forma concreta.
Problemas habituales del texto a voz y cómo solucionarlos
Incluso los mejores modelos TTS pueden tener dificultades con los matices del lenguaje humano. Dos de los problemas más habituales son pronunciar mal palabras nuevas y ofrecer una locución monótona. Así puedes solucionarlos.
Pronunciaciones incorrectas de palabras desconocidas, jerga y nombres propios
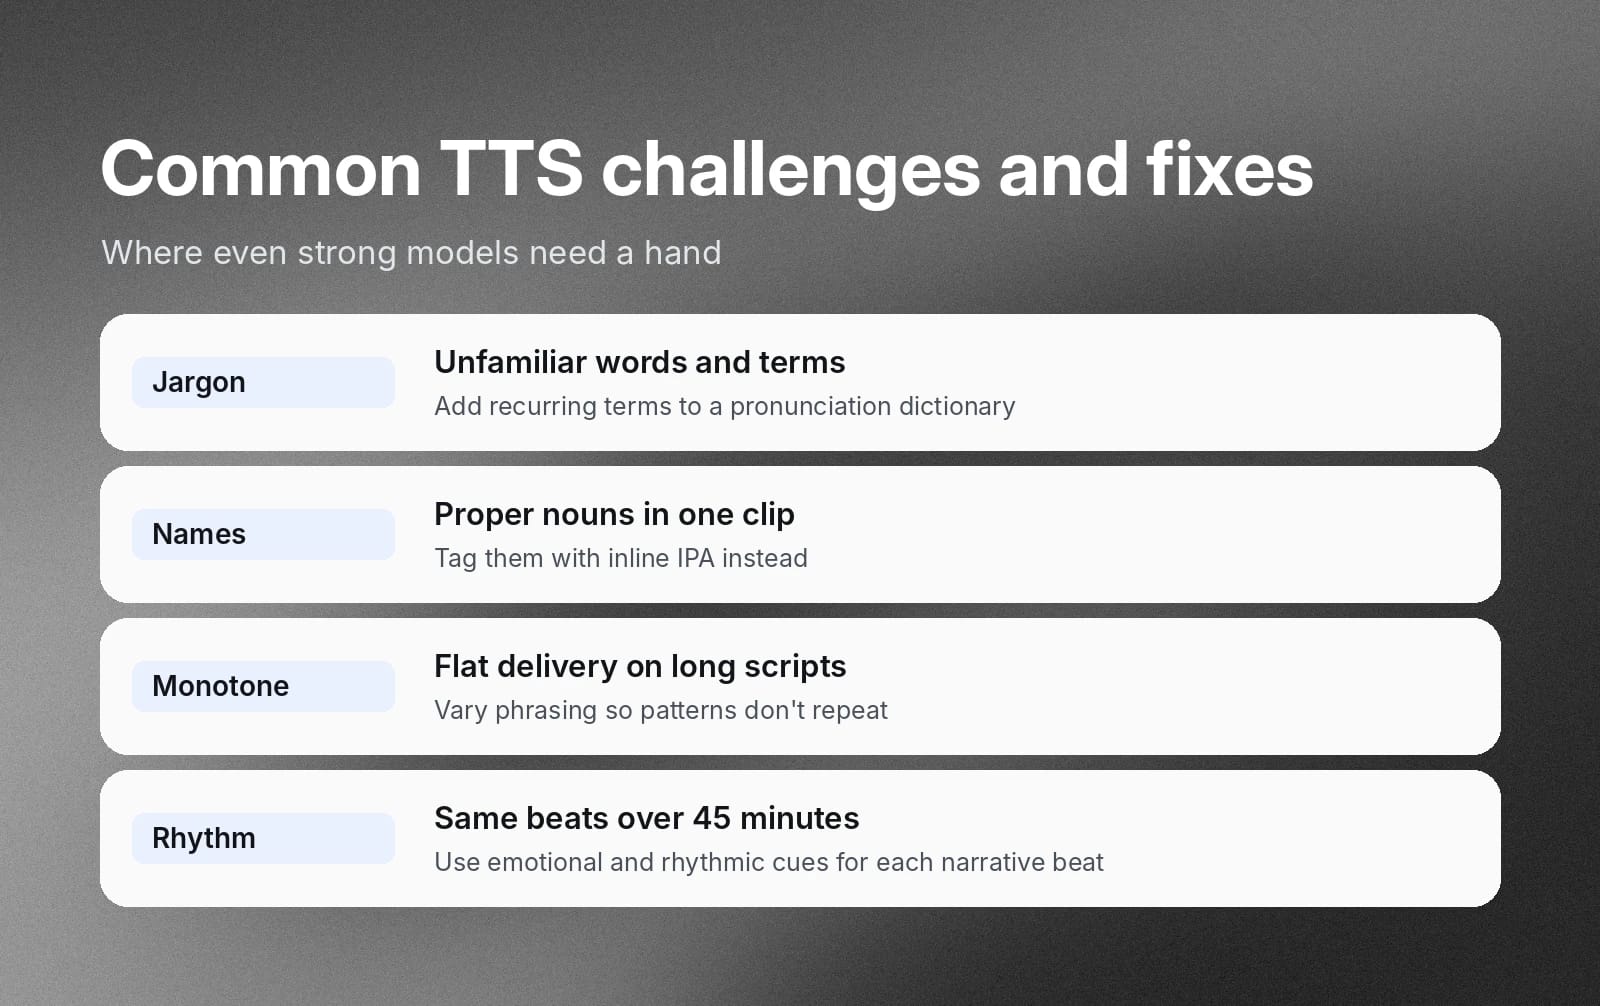
Los motores TTS usan algoritmos para predecir cómo debe pronunciarse el texto normalizado según cómo se asignan los grafemas a los fonemas en sus datos de entrenamiento. Hacen su mejor estimación a partir del texto y el contexto que han procesado. Pero, como vimos en la sección anterior, habrá muchos casos límite en los que querrás que algo se pronuncie de una forma muy específica.
Los diccionarios de pronunciación o las etiquetas AFI específicas son tus mejores herramientas para estos casos límite. Si tienes un término que aparece con frecuencia y quieres que se pronuncie siempre igual, un diccionario es la mejor solución. Si solo quieres hacer ajustes concretos en algunos términos, usa etiquetas fonéticas AFI.
Locución monótona
Estos problemas son más habituales al procesar guiones largos en los que se repiten las mismas palabras o frases. La voz sintetizada de un motor puede sonar muy bien en fragmentos de 10 segundos, pero escuchar la misma pronunciación mecánica y los mismos patrones rítmicos durante una conferencia de 45 minutos cansa rápidamente a quien escucha.
Varía las expresiones de tus guiones y usa con criterio etiquetas fonéticas para cambiar periódicamente las pronunciaciones. Usa indicaciones emocionales y rítmicas para hacer que la salida de voz sea más dinámica, elevando y bajando el tono con los distintos momentos narrativos.
Crea experiencias de voz naturales con una API de Texto a Voz
Las herramientas web ligeras pueden ser estupendas para producir clips de audio pequeños, pero no escalan bien ante necesidades empresariales mayores. Si intentas gestionar miles de interacciones de clientes por minuto o generar contenido de audio largo y de alta calidad, necesitarás herramientas TTS más robustas.
Una API de Texto a Voz como ElevenAPI te permite conectar tu software directamente con modelos de síntesis de voz neuronal. Puedes usar solicitudes REST o WebSockets persistentes para generar audio bajo demanda para agentes u otros fines a gran escala.
Cómo funciona una solicitud a una API de texto a voz
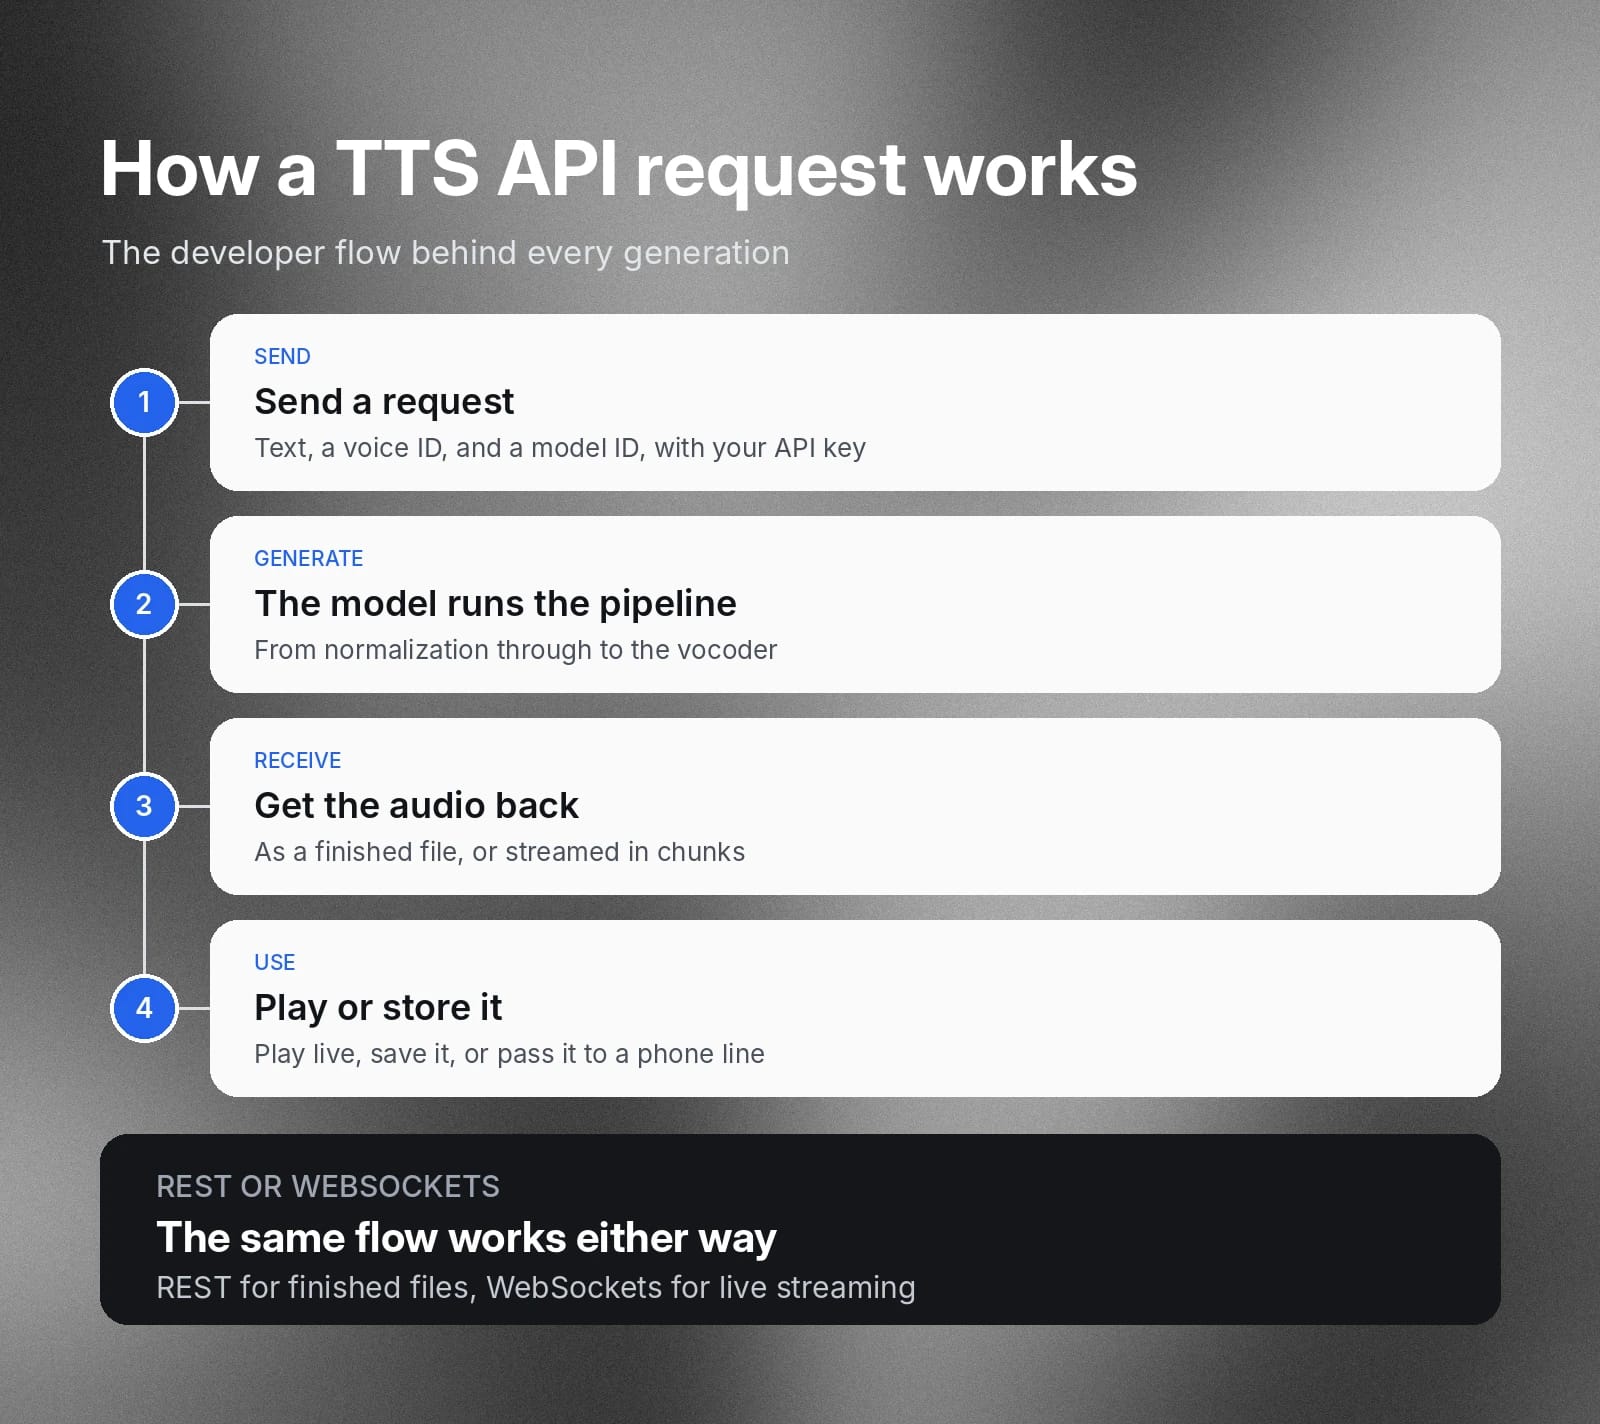
Aunque los modelos son complejos, el flujo para desarrolladores es fácil de entender y poner en marcha.
Con ElevenAPI, puedes integrar Texto a Voz en tus aplicaciones en cuestión de minutos:
- Envía una solicitud: tu aplicación envía el texto, un ID de voz y un ID de modelo a la API con tu clave de API.
- Genera: el modelo ejecuta el proceso descrito anteriormente, desde la normalización hasta el vocoder.
- Recibe el audio: la API devuelve el archivo de audio terminado o lo transmite en fragmentos para que la reproducción pueda comenzar antes de que termine la generación.
- Reproduce o almacena: tu aplicación reproduce el audio en directo, lo guarda o lo envía a otro sistema, como una línea telefónica.
El mismo flujo se aplica tanto si usas REST para archivos terminados como WebSockets para streaming en directo, y los SDK descritos a continuación encapsulan estas llamadas por ti.
Consideraciones de arquitectura para desarrolladores
Según tu caso de uso, quizá tengas que equilibrar ventajas e inconvenientes entre velocidad de procesamiento, fidelidad de audio, latencia y protocolos de red, y capacidades de integración.
Latencia frente a fidelidad
Para que los agentes conversacionales suenen naturales, conviene aspirar a aproximadamente 100 ms hasta el primer audio, lo que implica minimizar la latencia de la red y hacia el motor TTS. Aquí importa la calidad de audio que puede ofrecer la arquitectura de tu agente dentro de esa limitación.
En cambio, la latencia importa menos cuando produces audio largo, como un pódcast o una conferencia. En lugar de minimizar la latencia, querrás maximizar la salida de alta fidelidad.
Protocolos de streaming
Los protocolos que usas para tu conexión a la API también pueden afectar a la latencia y al rendimiento. Los WebSockets permiten un verdadero streaming de audio bidireccional, lo que significa que puedes procesar fragmentos de texto a medida que llegan en vez de esperar a que se procese una entrada completa. La reproducción puede comenzar con los primeros fragmentos mientras el motor TTS sigue procesando los posteriores.
SDK
Las API de Texto a Voz de nivel empresarial, como ElevenAPI, ofrecen completos kits de desarrollo de software (SDK) para Python y TypeScript/JavaScript, además de API REST, para ayudarte a implementar una nueva arquitectura rápidamente. Úsalos para reducir la carga de integración de tu equipo de desarrollo.
Empieza con ElevenAPI para Texto a Voz
La síntesis TTS natural de un modelo de voz líder ofrece la salida de audio de alta calidad que tus agentes y producciones de audio necesitan para mantener la atención de quienes escuchan. Tanto si buscas un agente conversacional de alta calidad que respalde los flujos de trabajo de atención al cliente como si quieres integrar TTS en tu aplicación, ElevenLabs tiene una solución.
Empieza hoy mismo creando tu propio audio de alta fidelidad con ElevenAPI, o descubre más sobre ElevenAgents.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.