Marco de evaluación de agentes de voz: los 6 pilares explicados
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Los agentes de voz deben orquestar una sinfonía de herramientas casi simultáneas. Es un delicado equilibrio entre registrar los comentarios de un cliente con voz a texto (STT) en tiempo real, asimilar el contexto y generar una respuesta con un modelo de lenguaje extenso (LLM), para después generar un archivo de audio con software de texto a voz (TTS).
Con tantas piezas en movimiento, ¿cómo puedes evaluar con precisión el rendimiento de un agente de voz?
En este artículo proponemos un marco de evaluación de agentes de voz con seis pilares que describe exactamente qué medir al evaluar el éxito de un agente. También veremos por qué distintos sectores deben ponderar estos pilares de forma diferente y qué errores habituales debes evitar durante la evaluación.
Resumen
- Los seis pilares principales para evaluar agentes de voz son la calidad de voz TTS, la calidad de conversación, el uso de herramientas y la finalización de tareas, la inteligencia, el cumplimiento normativo y la seguridad, y la fiabilidad.
- Los objetivos de producción más importantes son un MOS de 4,3, un TSR superior al 85 % y un tiempo hasta el primer audio inferior a 500 ms.
- Los distintos sectores ponderarán cada pilar de forma diferente, y algunos despliegues priorizarán uno sobre los demás.
- Entre los errores habituales en las pruebas están evaluar solo audio limpio e ignorar los picos de latencia P99.
- ElevenLabs lidera las métricas que más importan: Scribe v2 logra el WER más bajo del sector, del 2,2 % (Artificial Analysis, junio de 2026); Flash v2.5 y Turbo v2.5 son modelos líderes en velocidad (Artificial Analysis, junio de 2026), y ElevenAgents ofrece una latencia de inferencia del modelo de ~75 ms.
¿Qué es un marco de evaluación de agentes de voz?
Un marco de evaluación de agentes de voz con IA es un sistema estructurado que te permite probar el rendimiento en múltiples dimensiones. Un marco completo incluirá métricas para evaluar desde la fidelidad del audio hasta el flujo de conversación e incluso el cumplimiento normativo.
A diferencia de un chatbot de texto, un agente de voz canaliza cada interacción a través de al menos tres tecnologías combinadas: reconocimiento automático de voz (ASR), que convierte las palabras de un usuario en texto; un LLM que compone una respuesta; y un sistema TTS que transforma esa respuesta de nuevo en audio. Si alguno de estos sistemas falla, toda la experiencia se resiente.
Esta complejidad explica precisamente por qué las empresas deben evaluar los agentes de voz antes de elegir un proveedor y realizar un despliegue. Cualquier latencia adicional o respuesta imprecisa puede tener consecuencias reales, como pérdida de clientes o, en el peor de los casos, multas regulatorias y daños reputacionales.
Un marco para evaluar agentes de voz utiliza benchmarks y datos medibles para determinar si un agente es apto para determinados casos de uso. Desde la perspectiva de negocio, poder evaluar distintos modelos de voz te permite elegir el mejor para tus clientes.
Los seis pilares que debes evaluar en un agente de voz
Aunque crear y desplegar un agente de IA nunca había sido tan sencillo, los procesos activos que ocurren entre bastidores son bastante complejos. Varios componentes actúan al mismo tiempo para escuchar a un usuario, entender lo que quiere, transmitir esa información a un LLM y generar después una respuesta de audio.
Para colaborar con el mejor agente de voz posible, las empresas necesitan un marco riguroso con el que compararlo.
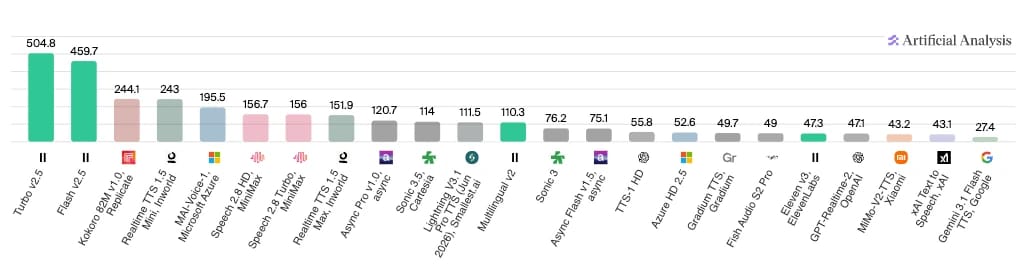
Si te interesa más consultar los resultados de las pruebas, Artificial Analysis ofrece varias comparativas de agentes basadas en distintos componentes. A continuación puedes ver los resultados de su comparación de velocidad entre modelos, donde ElevenLabs Turbo v2.5 y Flash v2.5 lideran con una ventaja considerable en caracteres procesados por segundo.
Para desarrolladores o empresas que quieran realizar sus propios experimentos, estos son los seis pilares de un marco de evaluación de agentes de IA que debes utilizar:
- Calidad de voz TTS: Hasta qué punto el habla sintetizada suena natural, clara y expresiva para usuarios finales. Los mejores modelos del sector, como Eleven v4, ofrecen una entonación emotiva y similar a la humana en más de 70 idiomas.
- Calidad de conversación: ¿Entiende el modelo el habla humana, interpreta su significado y responde con rapidez y en contexto a lo largo de varios turnos?
- Uso de herramientas: El grado en que un agente de IA completa tareas utilizando los recursos disponibles sin necesitar intervención humana.
- Inteligencia: La capacidad de un modelo para razonar, gestionar entradas nuevas y evitar respuestas imprecisas o alucinadas.
- Cumplimiento normativo y seguridad: Junto con todas sus capacidades, agentes de voz con IA deben cumplir todos los requisitos regulatorios y de cumplimiento normativo, incluidas las barreras de seguridad activas.
- Fiabilidad: Componentes como el tiempo de actividad total y un rendimiento uniforme bajo carga permiten determinar si un agente de IA conversacional puede escalar según la demanda.
Aunque cada uno de estos pilares es independiente, se interrelacionan para ofrecer una experiencia final de calidad al usuario. Por ejemplo, si un modelo mejorara su calidad de voz, pero siguiera teniendo una latencia alta, el cliente sufriría esperas incómodas antes de que el modelo emitiera la respuesta.
Veamos cada uno de estos pilares de evaluación de la IA de voz con más detalle.
Calidad de voz TTS
Empezamos por la calidad de voz, ya que probablemente sea lo primero que una persona perciba al interactuar con un agente conversacional de IA. Si suena robótico o extraño, la experiencia subjetiva con el agente será considerablemente peor.
Una de las métricas de evaluación originales, definida por el Sector de Normalización de las Telecomunicaciones de la Unión Internacional de Telecomunicaciones (UIT-T), es el Mean Opinion Score (MOS). El MOS funciona en una escala del 1 al 5, donde 1 es inutilizable y 5 es excelente. Al ser una medición subjetiva, utiliza oyentes humanos y recopila sus comentarios después de una llamada.
Cualquier valor inferior a MOS 3,5 en esta escala resulta poco destacable, especialmente según los estándares actuales, y probablemente afectará a la satisfacción del cliente.
Aunque el MOS es la métrica centrada en las personas, varios requisitos técnicos contribuyen a ese resultado:
- Consistencia del tono y jitter: El tono y el jitter son dos elementos lingüísticos que las personas perciben de forma natural al escuchar. El «tono» se refiere a los cambios de entonación durante el habla, como cuando elevas la voz al hacer una pregunta. El jitter ocurre cuando varía la comprensión del tono por parte de un modelo de voz, lo que le impide mantener una prosodia coherente a lo largo de una frase. La referencia del sector para el jitter es de 30 ms.
- Expresividad emocional: Una voz clara y precisa sigue sonando mal si el tono no encaja con el registro emocional previsto de una frase. Sin señales tonales precisas, los oyentes humanos conectarán menos con los agentes conversacionales de IA y los valorarán peor. ElevenAgents ofrece expresividad casi humana para dotar cada respuesta de una intención emocional clara.
- Ruido de fondo: El ruido de fondo en los agentes de voz tiene dos dimensiones diferenciadas que conviene evaluar. En la salida, se añade sutilmente ruido ambiental a las respuestas para que los agentes suenen más naturales. En la entrada, el filtrado de ruido de fondo en la capa STT es una opción que mejora la precisión. Al evaluar un agente, prueba ambas cosas: comprueba si el ruido ambiente suena natural y evalúa la precisión del STT con y sin el filtro de ruido.
Al calcular el MOS, debes aspirar a 4,3-4,5, lo que demuestra puntuaciones altas en todas estas categorías perceptivas. Para predecir el MOS a escala sin necesitar paneles humanos, puedes utilizar herramientas como UTMOS y NISQA.
Calidad de conversación
La calidad de conversación es un pilar compuesto que se sitúa entre la calidad de voz y la finalización de tareas. Mide la eficacia con la que un agente de voz entiende las necesidades de un usuario, le interrumpe en contexto y mantiene esa información a lo largo de un diálogo de varios turnos hasta completarlo.
La métrica principal aquí es la precisión de clasificación de intenciones, que suele situarse entre el 85 % y el 92 %, mientras que los mejores resultados superan el 96 %. Aunque el 85 % pueda parecer alto, implica que el 15 % de todo el tráfico entrante se categoriza incorrectamente y se dirige a recursos equivocados.
Los elementos técnicos que contribuyen a una alta precisión en la clasificación de intenciones son:
- Gestión de turnos: La gestión de turnos determina hasta qué punto un agente de voz administra el flujo natural de una conversación. Evalúa si sabe cuándo escuchar, responder o esperar más información. También incluye la gestión de interrupciones, cuando un modelo descarta una respuesta en curso y genera otra nueva a partir de la nueva entrada. ElevenLabs utiliza un websocket multicontexto para gestionar estas interrupciones de forma fluida.
- Latencia: Latencia describe el retraso de extremo a extremo entre el momento en que un usuario termina su frase y el inicio de la respuesta de audio del agente. Los agentes de voz listos para producción deben aspirar a un tiempo hasta el primer audio inferior a 500 ms; menos de 300 ms es aún mejor. Los modelos Flash de ElevenLabs ofrecen un tiempo de inferencia líder en el sector de ~75 ms, lo que te sitúa en una buena posición en esta categoría.
- Tasa de fallback: La tasa de fallback mide la frecuencia con la que un agente de IA no entiende a un usuario y pide una aclaración o repetición. Es, en gran medida, una consecuencia indirecta de la precisión del STT: si la capa de reconocimiento de voz escucha mal o representa incorrectamente lo que ha dicho un cliente, el LLM recibe información corrupta. La tasa de fallback se calcula con la fórmula: Tasa de fallback (%) = (Número de fallbacks / Número total de interacciones) * 100.
ElevenLabs Scribe V2 tiene el WER más bajo, del 2,2 %, en la evaluación de modelos de voz a texto de Artificial Analysis
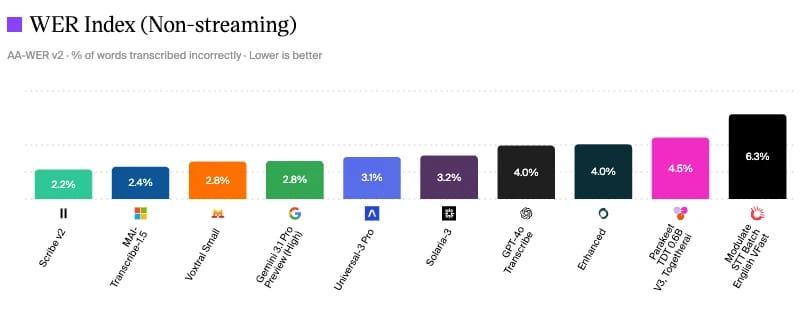
Evaluación de modelos de voz a texto de Artificial Analysis
Una forma de medir la calidad de conversación es consultar los estándares de benchmarking del sector para distintos componentes. Como puedes ver, Scribe v2 de ElevenLabs tiene la tasa de error de palabras más baja, del 2,2 % a junio de 2026, lo que supone menos errores de comprensión, menos fallbacks y una clasificación de intenciones más precisa.
Las empresas pueden comprobar que la calidad conversacional también depende del workflow en el que opere un agente de voz. Por ejemplo, en atención al cliente, otra consideración sería la calidad de transferencia en una escalada o la resolución de preguntas frecuentes.
Uso de herramientas y finalización de tareas
Mientras que la calidad mide cómo se percibió una conversación, la finalización de tareas mide si produjo un resultado satisfactorio. Las empresas deben prestar mucha atención a esta parte del marco de evaluación de agentes de voz, ya que está directamente relacionada con los resultados de negocio.
Una medida del uso de herramientas es la precisión de cumplimentación de campos, que determina hasta qué punto los agentes de IA pueden realizar tareas relativamente rutinarias, como completar un formulario con información del cliente. Una alta precisión demuestra que el agente puede pasar de la conversación a la acción sin perder información por el camino.
La tasa de éxito de tareas (TSR) es una medida porcentual de las tareas de principio a fin que un agente completa correctamente. La finalización depende de la capacidad del agente tanto para entender una solicitud como para utilizar las herramientas conectadas adecuadas (API, bases de datos, generación aumentada por recuperación (RAG) y bases de conocimiento internas) como apoyo.
La fórmula del TSR es:
TSR = (Tareas completadas íntegramente / Total de tareas intentadas) x 100
Los agentes de voz listos para producción deben aspirar a un TSR superior al 85 %, supervisando la precisión y fiabilidad de las llamadas a herramientas. Para evitar una caída de tu TSR, asegúrate de realizar pruebas de regresión ante cualquier modificación del prompt o del modelo conectado. Incluso una pequeña desviación puede tener consecuencias importantes para tu TSR.
Inteligencia
La inteligencia abarca el razonamiento y las capacidades de alto nivel de un agente de voz. Este pilar marca claramente la diferencia entre una IVR guiada por voz (respuesta de voz interactiva) y un agente de voz con IA.
Las dimensiones clave que debes evaluar aquí incluyen:
- Riesgo de alucinación: Las alucinaciones, en las que un agente genera información inexacta o incoherente con los documentos de la empresa, son especialmente perjudiciales en la IA de voz porque pueden transmitirse con seguridad. Estudios recientes sugieren que las alucinaciones frecuentes dañan significativamente la satisfacción de clientes con los agentes de voz.
- Gestión de solicitudes fuera de alcance: Los agentes inteligentes entienden cuándo una pregunta queda fuera de su dominio contextual y pueden responder adecuadamente. En lugar de alucinar una respuesta, la rechazan o redirigen la conversación a un terreno definido por el contexto.
- Retención de contexto: A lo largo de varios turnos, ¿puede un agente seguir las entidades y los compromisos adquiridos anteriormente? Sin esta capacidad, los clientes podrían verse obligados a repetirse o recibir respuestas contradictorias.
- Razonamiento y lógica de varios pasos: ¿Puede el agente gestionar correctamente una lógica condicional o encadenar inferencias a lo largo de varios turnos? Especialmente en casos de uso más técnicos, como servicios financieros, la capacidad de razonar dentro de un contexto predefinido es esencial para el éxito.
Existen varios benchmarks de terceros para estas dimensiones y componentes. Por ejemplo, la evaluación holística de modelos de lenguaje (HELM) de Stanford compara el rendimiento de los LLM en distintas categorías. Para las alucinaciones, TruthfulQA ofrece un análisis sólido de la frecuencia con la que se introducen respuestas falsas.
Una ventaja de ElevenAgents es que, a diferencia de algunas plataformas de voz que te limitan a un único modelo subyacente, puedes sustituir por completo la capa de LLM. En la práctica, esto significa que puedes integrar el modelo que lidere los benchmarks de razonamiento para tu caso de uso específico.
Cumplimiento normativo y seguridad
Las empresas deben implementar barreras de seguridad activas para prevenir resultados perjudiciales o que incumplan las políticas. A diferencia de las instrucciones de prompt a nivel de sistema, que pueden sortearse o anularse, las comprobaciones independientes se ejecutan como una capa separada fuera del propio modelo. Evalúan los resultados antes de que lleguen al usuario y detienen la conversación si se desvía hacia terreno peligroso.
La auditabilidad es un requisito relacionado: los agentes de producción deben conservar registros detallados de decisiones y resultados en un formato que admita una revisión posterior. Sobre todo en sectores muy regulados, demostrar el cumplimiento a posteriori es tan importante como lograrlo desde el principio.
Las regulaciones exactas que debe cumplir tu empresa varían según el sector. Algunos de los marcos más habituales son:
- HIPAA: Para datos sanitarios protegidos en contextos de salud de EE. UU.
- PCI-DSS: Para cualquier agente que gestione datos de tarjetas de pago.
- RGPD: Obligaciones de privacidad de datos para la UE y empresas con clientes en la UE.
Para empresas que evalúan su nivel de cumplimiento normativo, ElevenLabs cuenta con el cumplimiento AICPA SOC Tipo II y RGPD, además de haber obtenido la certificación AIUC-1. La AIUC-1 es un estándar de seguridad diseñado específicamente para agentes de IA.
Fiabilidad
La fiabilidad es el último pilar de nuestro marco de evaluación de agentes de voz y cubre si un agente puede ofrecer resultados de forma consistente en tiempo real.
Al evaluar un agente de voz, busca las siguientes características:
- Tiempo de actividad: Cualquier despliegue de cara al cliente requiere un 99,9 % de tiempo de actividad para evitar interrupciones. Especialmente en casos de uso siempre activos, como la asistencia entrante, un tiempo de actividad fiable es fundamental.
- Degradación controlada: Debido a la complejidad subyacente de los agentes de voz, si un componente empieza a fallar, el agente debe gestionar esa degradación de forma controlada. En la práctica, esto significa derivar a una persona, en lugar de seguir funcionando con mayor carga o devolviendo errores.
- Rendimiento bajo carga:Las pruebas de carga deben intentar simular al menos el doble de tu concurrencia máxima prevista antes de lanzar el servicio. Las pruebas bajo una carga intensa pueden detectar aumentos de latencia o degradaciones del rendimiento que solo aparecen a escala.
Incluso un modelo de alta calidad que cumpla todos los demás requisitos puede resultar inutilizable si no escala con la demanda de tus clientes. ElevenAgents cuenta con la confianza de 1.000.000 de creadores y empresas líderes, lo que demuestra la capacidad de la plataforma para ofrecer despliegues a escala empresarial sin comprometer los benchmarks de rendimiento.
Cómo medir el MOS de agentes de voz (paso a paso)
Si tu empresa quiere medir el MOS manualmente, necesitarás un grupo amplio de oyentes humanos y una selección de clips de audio de conversaciones reales. Es un proceso estructurado que implica recopilar comentarios, calcular promedios e interpretar los datos.
Así puedes medir en la práctica el MOS de agentes de voz:
- Prepara tu conjunto de pruebas: Selecciona una muestra representativa de salidas de audio de tu agente, con al menos 100 clips de distintas conversaciones.
- Realiza la sesión de evaluación: Pide a tus oyentes humanos que valoren cada clip en una escala del 1 al 5 según la calidad de la experiencia de comunicación.
- Agrupa las valoraciones y calcula las puntuaciones: Calcula la media de las valoraciones de cada clip y, después, la media de todos los clips de la muestra para obtener un MOS general. Un MOS de 4,3 o superior indica que tu agente de voz está listo para producción.
Aunque requiere mucho trabajo manual, este proceso te proporcionará un MOS sólido para el agente de voz elegido. Si quieres realizar la prueba a escala, puedes sustituir a los oyentes humanos por herramientas automatizadas como NISQA, que predicen puntuaciones MOS mediante programación. Puedes integrar estos sistemas en tus pipelines activos para supervisar el MOS continuamente a lo largo del tiempo.
Benchmarks de pruebas de IA frente a humanos: FCR, AHT y CSAT
Aunque calcular el MOS repetidamente a lo largo del tiempo permite observar la mejora o regresión del modelo, puedes añadir contexto comparándolo con el rendimiento humano. Ver lo que consiguen realmente las personas en funciones similares mostrará si tu agente de voz se acerca a un nivel ideal.
Estas son algunas métricas que debes considerar en los benchmarks de pruebas de IA frente a humanos.
Los agentes de IA deberían poder igualar el FCR y el CSAT humanos y mejorar significativamente el AHT. Esta mejora se debe a que los agentes de IA suelen gestionar conversaciones más generales que los agentes humanos. Muchas empresas implementan un workflow en el que los agentes de IA son la primera línea de respuesta y solo transfieren las llamadas a agentes humanos si son demasiado complejas para gestionarlas de forma autónoma.
Los datos de 2025 de Poe, un agregador de comparativas de IA, revelan que ElevenLabs mantuvo la mayor capacidad general para atender solicitudes, completando el 74,4 % de todas las solicitudes entrantes. Su éxito se ha traducido en un uso que crece rápidamente, con Eleven v3 y v2.5-Turbo representando más del 60 % de los mensajes enviados a modelos de IA a lo largo del tiempo.
Para mejorar la experiencia, utiliza Eleven v4 como nuestro modelo TTS más emotivo.
Mensajes enviados a modelos de IA a lo largo del tiempo, con ElevenLabs liderando el marco de evaluación de agentes de voz de Poe
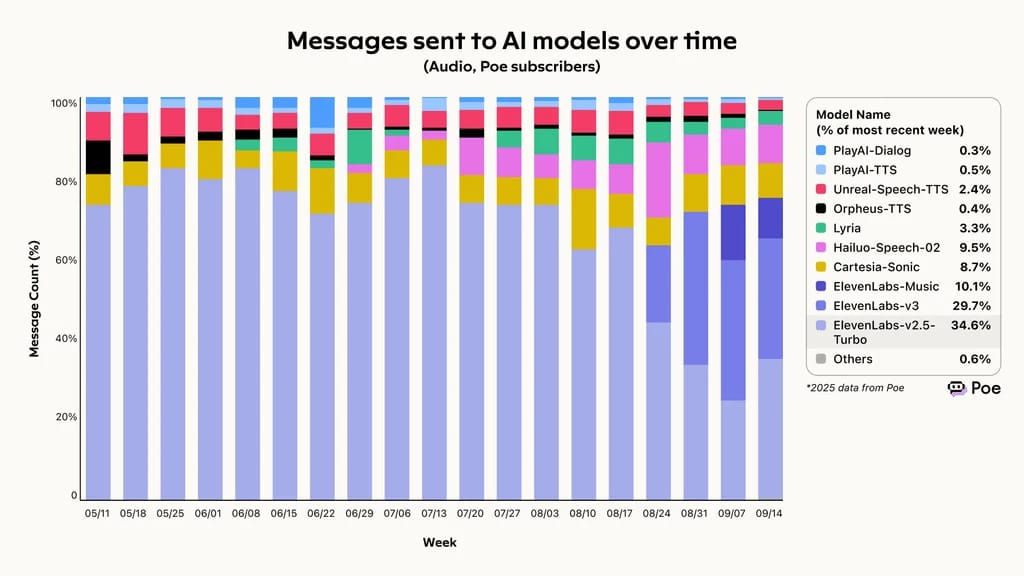
Mensajes enviados a modelos de IA a lo largo del tiempo, según el benchmark de Poe
Errores habituales al probar agentes de voz
Al seguir un marco de evaluación de agentes de voz, resulta tentador probar los escenarios más favorables. La realidad es que la experiencia cotidiana de los clientes que interactúan con tus sistemas de IA de voz no tendrá lugar en condiciones ideales.
Estos son tres errores habituales al probar agentes de voz y cómo corregirlos:
- Probar el camino más fácil: Especialmente al seleccionar clips de audio para el MOS, asegúrate de incluir casos de uso extremos. Los clips con ruido de fondo o habla con acento son muy habituales en la vida real, así que probar solo archivos de audio «limpios» llevará a calibrar mal el MOS.
- Priorizar la contención frente a la resolución: Optimizar tus modelos para mantener a usuarios dentro del sistema de agentes aumenta las tasas de contención sin mejorar los resultados. Si tu FCR es bajo pese a una tasa de contención alta, el agente hace pasar a usuarios por un bucle frustrante. Establece procesos que permitan a usuarios hablar con agentes humanos si lo desean.
- Ignorar los percentiles de latencia: Los SLA suelen definir la latencia según el nivel P95. Aunque esta métrica es importante para ofrecer una experiencia uniforme a la mayoría de tus clientes, no olvides que el 5 % restante también son clientes reales. A escala, el 5 % de un sistema que gestiona 10.000 llamadas diarias sigue siendo 500 personas que experimentan una conversación lenta. Céntrate en P99 como objetivo principal de SLA, no solo en la mediana o P95.
Si tienes esto en cuenta, podrás establecer bases de referencia justas y representativas en lugar de trabajar con promedios idealizados.
Por qué las evaluaciones deben ser específicas para cada caso de uso
Aunque los seis pilares descritos en este marco orientan sobre las áreas que debes explorar, la ponderación de cada pilar dependerá de tu sector. Por ejemplo, una empresa de servicios financieros puede priorizar el cumplimiento normativo y el uso de herramientas, mientras que una marca de consumo consideraría la calidad de voz TTS como su principio rector.
Estos son dos ejemplos de evaluaciones específicas por caso de uso y de cómo pueden modificar el equilibrio entre los pilares.
Atención al cliente
En determinados sectores, como los centros de llamadas, otras métricas de finalización de tareas, como la resolución en la primera llamada (FCR), son una parte importante de la conversación. Poder gestionar correctamente una llamada entrante sin intervención humana reduce significativamente la demanda sobre agentes humanos de atención al cliente. McKinsey estima que los centros de llamadas que utilizan agentes de voz pueden reducir el volumen de interacciones hasta un 50 %.
Aunque no es tan importante como la tasa de éxito de tareas, otra dimensión que debes considerar es la tasa de contención. La tasa de contención es una métrica que analiza la duración total de una llamada. Si tu tasa de contención es muy alta, pero tu FCR es bajo, tus agentes mantienen a las personas en la línea sin proporcionar una solución al cliente. En la práctica, esto puede traducirse en una experiencia frustrante en la que el cliente da vueltas sin avanzar.
Otras métricas que puedes seguir son el AHT, mientras que los agentes de IA buscan resolver rápidamente problemas rutinarios. Por ello, el ámbito de atención al cliente priorizaría la calidad de conversación, especialmente la gestión de turnos y la tasa de fallback, sobre otras áreas.
Salud
Salud es un ámbito muy regulado, con estrictos requisitos de cumplimiento que hacen que el funcionamiento de los agentes de voz sea extremadamente delicado. El cumplimiento normativo es una preocupación central, lo que inclina significativamente la ponderación del pilar de seguridad y de la inteligencia por encima de todo lo demás.
Chatbots sanitarios deben gestionar la programación de citas, las vías de acceso a la telemedicina, el triaje de síntomas y las preguntas sobre seguros. Todo ello requiere un alto grado de inteligencia y uso de herramientas, lo que vuelve a reflejar que las exigencias específicas del sector o función determinan cuál de los pilares es más importante.
Sea cual sea el ámbito en el que trabaje tu empresa, entender los pilares fundamentales de la evaluación de agentes de voz y aplicarlos de forma equilibrada te ayudará a encontrar los mejores agentes para ti.
Crea con ElevenAgents para lograr alto rendimiento y baja latencia
La plataforma que elijas para desarrollar influye directamente en el rendimiento de tus agentes de voz en workflows reales. Especialmente al interactuar con tus clientes, necesitas confiar en que tu agente destacará en todas las categorías.
ElevenAgents está diseñado para despliegues de voz en producción y combina TTS líder del sector mediante Eleven v4, STT en tiempo real a través de Scribe v2 y una capa de orquestación de agentes diseñada para escala empresarial. Todos los componentes están creados para rendir conforme a los benchmarks de este marco, lo que te permite ofrecer experiencias de alta calidad a tus clientes.
Tanto si estás valorando tus opciones como si ya estás listo para empezar a crear, ElevenLabs tiene un camino para ti. Explora la plataforma ElevenAgents para ver cómo se adapta a tu caso de uso o regístrate y empieza a crear hoy mismo.
Preguntas frecuentes sobre la evaluación de agentes de voz

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.