Cómo funciona el motor de orquestación de ElevenAgent
- Publicado
- Última actualización
EscucharEscucha este artículo
ElevenAgents funcionan con un motor de orquestación de baja latencia diseñado específicamente para conversaciones en tiempo real, que añade menos de 100 ms de sobrecarga. Esta arquitectura combina lo mejor de la investigación de ElevenLabs con LLM de vanguardia de proveedores líderes como OpenAI, Google y Anthropic, además de modelos de código abierto seleccionados y alojados por ElevenLabs. Al utilizar varios modelos en distintas fases del proceso de respuesta, el agente garantiza conversaciones muy ágiles y conscientes del contexto. Al aprovechar dinámicamente y de forma conjunta los puntos fuertes de cada modelo, logramos un rendimiento fiable y escalable en una variedad de tareas empresariales y escenarios conversacionales, al tiempo que optimizamos el equilibrio entre inteligencia, velocidad y coste.
En este artículo explicamos cómo estos modelos trabajan juntos para ofrecer las capacidades esenciales que los agentes necesitan para operar en entornos complejos y, más concretamente, qué modelo ve qué tokens y en qué momento. El núcleo de este sistema es la gestión del historial de conversación en los distintos momentos de la interacción. Repasaremos cómo y dónde se comparte el historial de conversación para aclarar su función en la orquestación tanto de agentes independientes como de workflows multiagente.
Agente independiente
Empezamos explorando el agente independiente y sus componentes principales. Es razonable considerar que un agente mínimamente útil cuenta con un prompt de sistema, acceso a varias herramientas y una base de conocimientos. Conviene que clientes opten por agentes independientes en lugar de workflows cuando su caso de uso requiera poca verificación de una secuencia estricta de pasos o cuando sea importante evitar silos de conocimiento entre agentes. Los silos de conocimiento surgen cuando determinadas herramientas, documentos o contexto histórico están accesibles para algunos subagentes, pero no para otros. Son inherentes a los workflows multiagente e introducen una disyuntiva entre flexibilidad y determinismo.
En el caso de los agentes independientes de ElevenLabs, es importante entender cómo:
- Construyen solicitudes de generación eficaces
- Recuperan e incorporan documentos relevantes
- Generan y ejecutan llamadas a herramientas para fundamentar las respuestas del agente
- Generan resultados para evaluación y recopilación de datos
Construcción del contexto de conversación
Una conversación entre un cliente y un agente de ElevenLabs representa una serie de turnos, cada uno compuesto por un intercambio de mensajes entre ambas partes. Esta lista alterna de mensajes del agente y del usuario sirve como punto de partida para construir el contexto de conversación. Durante cada turno, el LLM subyacente recibe solicitudes de generación que contienen una serie de mensajes alternos del agente y el usuario, con un mensaje más que en el turno anterior. Como es natural, esta serie de mensajes lleva delante un único mensaje de sistema que representa el prompt de sistema del agente.
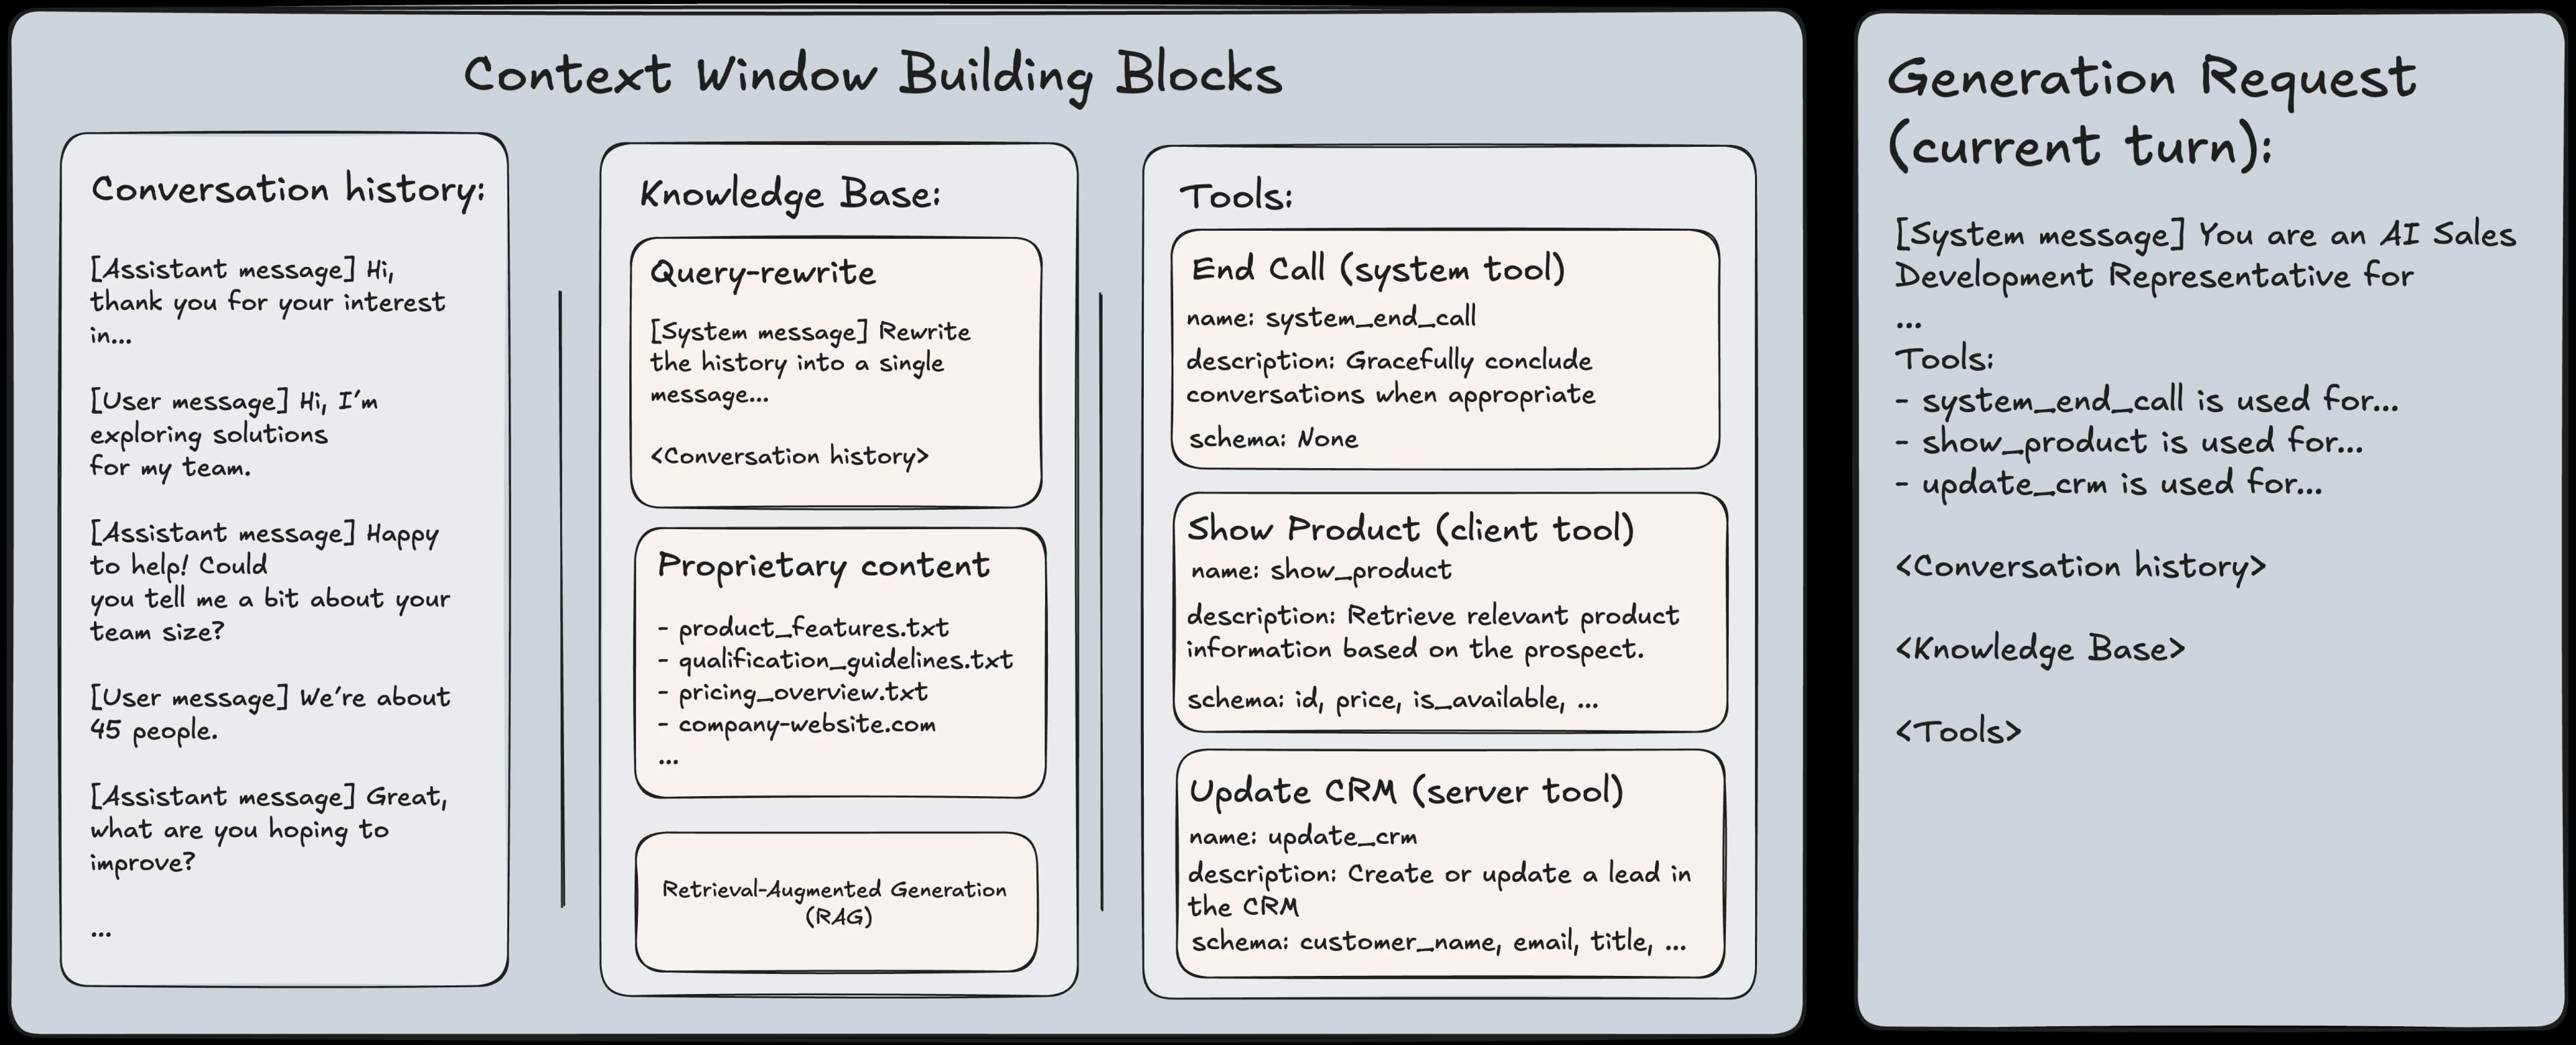
El orquestador de ElevenLabs reduce la latencia percibida del LLM al predecir cuándo ha terminado de hablar un usuario. En algunos casos, esto puede generar varias solicitudes de generación al LLM con el mismo contexto de conversación dentro de un único turno. Aunque la orquestación optimiza la rapidez con la que responden los agentes, la calidad de la respuesta depende igualmente de cómo se accede al conocimiento. A medida que avanzan, clientes suelen empezar a fundamentar las respuestas de sus agentes en una combinación de documentación propia y contenido público. Durante varios años, la generación aumentada por recuperación (RAG) ha sido el enfoque estándar para lograrlo. Bases de conocimientos de ElevenAgents se basan en RAG con una arquitectura multimodelo optimizada que detallamos en una publicación anterior. Esto permite recuperar documentos de forma fiable incluso cuando la última aportación del usuario es una pregunta de seguimiento, una confirmación de una aclaración o no contiene una pregunta explícita.
Sin embargo, la recuperación es solo una de las formas en que los agentes interactúan con sistemas externos.
Realizar acciones y recuperar información con herramientas
Los agentes de ElevenLabs pueden realizar acciones en el mundo real y recuperar información actualizada durante la conversación mediante un sistema flexible de herramientas. Esta capacidad plantea una consideración importante de diseño: cada herramienta activada aumenta el tamaño del prompt serializado, ya que su nombre, descripción y esquema de parámetros se incluyen junto con el prompt de sistema y el historial de conversación. A medida que se añaden más herramientas, también aumenta la carga de razonamiento del modelo para llamar a la secuencia correcta de herramientas. En Agent Builder, la descripción de la herramienta indica qué hace y qué campos devuelve. Esta es la información que el modelo de lenguaje utiliza para entender el contexto de uso. Una vez definida, las condiciones específicas para invocar la herramienta pertenecen al prompt de sistema del agente. Por ejemplo:
- Descripción de la herramienta lookup_order: “Recupera los detalles del pedido de un cliente mediante el ID de pedido. Devuelve el estado del pedido, los artículos comprados, la dirección de envío y el número de seguimiento.”
- Instrucción del prompt de sistema: “Después de verificar la identidad del cliente, llama a la herramienta lookup_order para recuperar los detalles de su pedido.”
Esta separación de responsabilidades permite reutilizar las definiciones de herramientas en distintos agentes, a la vez que permite que el prompt de sistema de cada agente controle el momento exacto en que se invoca una herramienta. Para ayudar a clientes a diseñar estos prompts de sistema de forma eficaz, ofrecemos orientaciones más detalladas en nuestra Guía de prompting. En este marco se pueden definir principalmente varios tipos de herramientas:
- Herramientas webhook que llaman a API externas.
- Herramientas de cliente que envían solicitudes de herramientas como eventos a través del websocket de la conversación.
- Herramientas de sistema para acciones integradas, como transferencias de llamadas.
- Herramientas MCP que se conectan a servidores de Model Context Protocol.
Siempre que un agente decide utilizar una herramienta, extrae los detalles necesarios de la conversación y envía una solicitud para ejecutarla. Cuando la herramienta devuelve un resultado, este se añade a la conversación para que el modelo pueda referirse a él de forma natural en su siguiente respuesta. Si es necesario, la salida de la herramienta también puede actualizar la información almacenada del agente como una variable dinámica. Esta información se guarda en sencillos pares clave-valor, extraídos de la respuesta de la herramienta mediante asignaciones predefinidas. Una vez configuradas, estas variables pueden volver a incorporarse al agente a través de su prompt de sistema, parámetros de herramientas futuros y condiciones del workflow. Este bucle de retroalimentación proporciona a los agentes una forma de memoria de trabajo que evoluciona a medida que interactúan.
Aunque esto describe cómo se integran las herramientas en el razonamiento del agente, también se puede configurar el momento de su ejecución. Las herramientas pueden funcionar en uno de tres modos de ejecución, cada uno adaptado a una necesidad conversacional distinta. En el modo inmediato, la herramienta se ejecuta en cuanto el LLM la solicita. Es el modo predeterminado para consultas rápidas en las que usuarios esperan una respuesta casi instantánea, como comprobar el estado de un pedido. Al combinarse con voz previa a la herramienta, el agente genera primero una breve confirmación como “Déjame comprobarlo” y se la devuelve al usuario mientras la herramienta se ejecuta en paralelo, minimizando los silencios. En el caso de herramientas más lentas, la plataforma amplía automáticamente estos mensajes de espera para ajustarlos al tiempo de espera previsto. Por el contrario, el modo de voz posterior a la herramienta retrasa la ejecución hasta que el agente ha terminado de hablar. Esto es esencial para acciones con consecuencias en el mundo real, como transferir una llamada, finalizar una sesión o enviar un pago. El usuario escucha todo el contexto, por ejemplo, “Voy a transferirte ahora al departamento de facturación”, y tiene la oportunidad de interrumpir antes de que se lleve a cabo la acción. El modo asíncrono ejecuta la herramienta completamente en segundo plano sin pausar la conversación. Este modo es el más adecuado para operaciones de tipo fire-and-forget, como enviar un correo electrónico, activar un workflow externo o registrar datos, en las que el agente no necesita hacer referencia al resultado en su respuesta.
Una vez establecidas la ejecución y la orquestación, el siguiente paso es entender cómo medir el rendimiento.
Medición del rendimiento
Después de completar una llamada con un agente, clientes pueden querer extraer determinados datos de la llamada para analizarlos y almacenarlos posteriormente, o determinar si la llamada ha tenido éxito. Aquí es donde entran en juego la recopilación de datos y los criterios de evaluación. La recopilación de datos permite extraer información estructurada de la transcripción de una llamada para su análisis y agregación posteriores. Clientes suelen exportar estos resultados a su data lakehouse empresarial para crear informes o enriquecer workflows. Por ejemplo, un agente de desarrollo de ventas puede extraer automáticamente los datos de un cliente potencial de una conversación para crear o actualizar un lead en el sistema de gestión de relaciones con clientes (CRM). Por otro lado, los criterios de evaluación determinan si una llamada se considera satisfactoria. Si se cumplen todos los criterios configurados, la llamada se marca como satisfactoria; de lo contrario, se marca como fallida. Esto garantiza que las conversaciones cumplan de forma constante los estándares definidos de calidad e integridad, a la vez que ofrece una respuesta rápida. Cuando finaliza una llamada y se activa el webhook posterior a la llamada, el agente procesa la transcripción final, incluida cualquier ejecución de herramientas y metadatos, mediante un LLM junto con todos los puntos de recopilación de datos y criterios de evaluación configurados. El modelo utiliza este prompt combinado para determinar si se cumple cada criterio de evaluación y extraer los datos especificados para su análisis posterior. Como el LLM interpreta estas configuraciones directamente como parte de su prompt de entrada, es importante darles un formato claro y coherente para que el modelo pueda entenderlas y aplicarlas correctamente. Por ello, recomendamos las siguientes prácticas para redactar descripciones de criterios de evaluación y recopilación de datos.
Criterios de evaluación
- Un objetivo claro por criterio: una frase o viñeta breve es mejor que varios objetivos en un mismo criterio.
- Observable y basado en la transcripción: formula el objetivo de forma que se pueda decidir si ha tenido éxito o ha fallado a partir de la transcripción (qué se ha dicho, qué ha hecho el agente, qué ha pedido el usuario). Evita objetivos que requieran contexto externo del que no dispone el LLM.
- Resultados explícitos de éxito, fallo o desconocido: el LLM ya cuenta con el contexto de que, para marcarlo como satisfactorio, el objetivo debe cumplirse; para marcarlo como fallido, no debe cumplirse; y para marcarlo como desconocido, no debe poder determinarlo a partir de la transcripción. Por tanto, el objetivo debe redactarse de manera que quede bien definido qué significa “cumplido” frente a “no cumplido”; si es ambiguo, el modelo puede tender a clasificaciones desconocidas o incorrectas.
- Sé conciso: a veces se pueden enviar juntos muchos criterios de evaluación. Por tanto, unos criterios de evaluación extensos pueden añadir ruido y provocar alucinaciones.
- El idioma importa: cualquier justificación que proporcione el LLM sobre si se ha cumplido o no un criterio de evaluación se ofrecerá en el mismo idioma que la descripción del criterio, por lo que es importante tenerlo en cuenta.
Recopilación de datos
- Describe exactamente qué extraer: la descripción es la señal principal para el LLM. Indica qué significa el campo, en qué situación debe establecerse y qué hacer cuando no esté claro (por ejemplo, “Deja el valor como null si el cliente nunca indicó una fecha preferida”).
- Haz que coincida con el tipo esperado: el valor proporcionado por el LLM siempre coincidirá con el tipo de datos asignado al punto de recopilación de datos (por ejemplo, booleano, cadena, entero, etc.). Por tanto, la descripción debe ajustarse a ello. Por ejemplo, para un entero podrías usar “Extrae el número de artículos solicitados” y, para un booleano, “Sí/no según si el cliente aceptó la oferta”.
- Usa enums cuando sea posible: para el tipo cadena, si el conjunto de valores es fijo, utiliza un enum en el esquema; limita el modelo y reduce las salidas no válidas.
- Un objetivo de extracción por elemento: no incluyas varios datos no relacionados en la descripción de un mismo elemento; divídelos en elementos separados para que cada llamada tenga un único objetivo de extracción claro.
- Mantén las descripciones breves: las descripciones pueden tener unas pocas frases; no hacen falta párrafos largos. La transcripción ya está en el mensaje del usuario, así que basta con el esquema y una descripción breve.
Actualmente, el LLM utilizado para este paso de evaluación y extracción está fijado en un modelo de baja latencia para garantizar un procesamiento rápido. Esperamos introducir próximamente opciones que ofrezcan mayor flexibilidad a clientes.
A continuación, abordamos casos de uso que requieren orquestación estructurada, determinismo o especialización en varios roles conversacionales, en los que clientes pueden utilizar Workflows.
Workflows
Workflows ofrecen una interfaz visual para diseñar flujos de conversación complejos. En última instancia, generan el objeto lógico que utiliza el orquestador para gestionar varios subagentes, herramientas y transferencias bajo un identificador de agente independiente. Los workflows incorporan otros componentes que se deben tener en cuenta, además de los ya descritos para los agentes independientes, entre ellos cómo:
- Interactúan los prompts de sistema y los objetivos conversacionales de los subagentes.
- Se determina el recorrido por los distintos puntos de transición del grafo.
Objetivos conversacionales especializados
Los workflows reutilizan funcionalidades de los agentes independientes para imponer un comportamiento coherente durante toda la interacción. Esto incluye elementos compartidos, como el prompt de sistema base, las herramientas principales y las bases de conocimientos globales que siempre deben estar disponibles, independientemente de qué parte del workflow esté activa. El prompt de sistema general suele encargarse de definir el contexto conversacional global, el tono esperado, las restricciones de seguridad y las instrucciones específicas de la marca o aplicables a todo el producto.
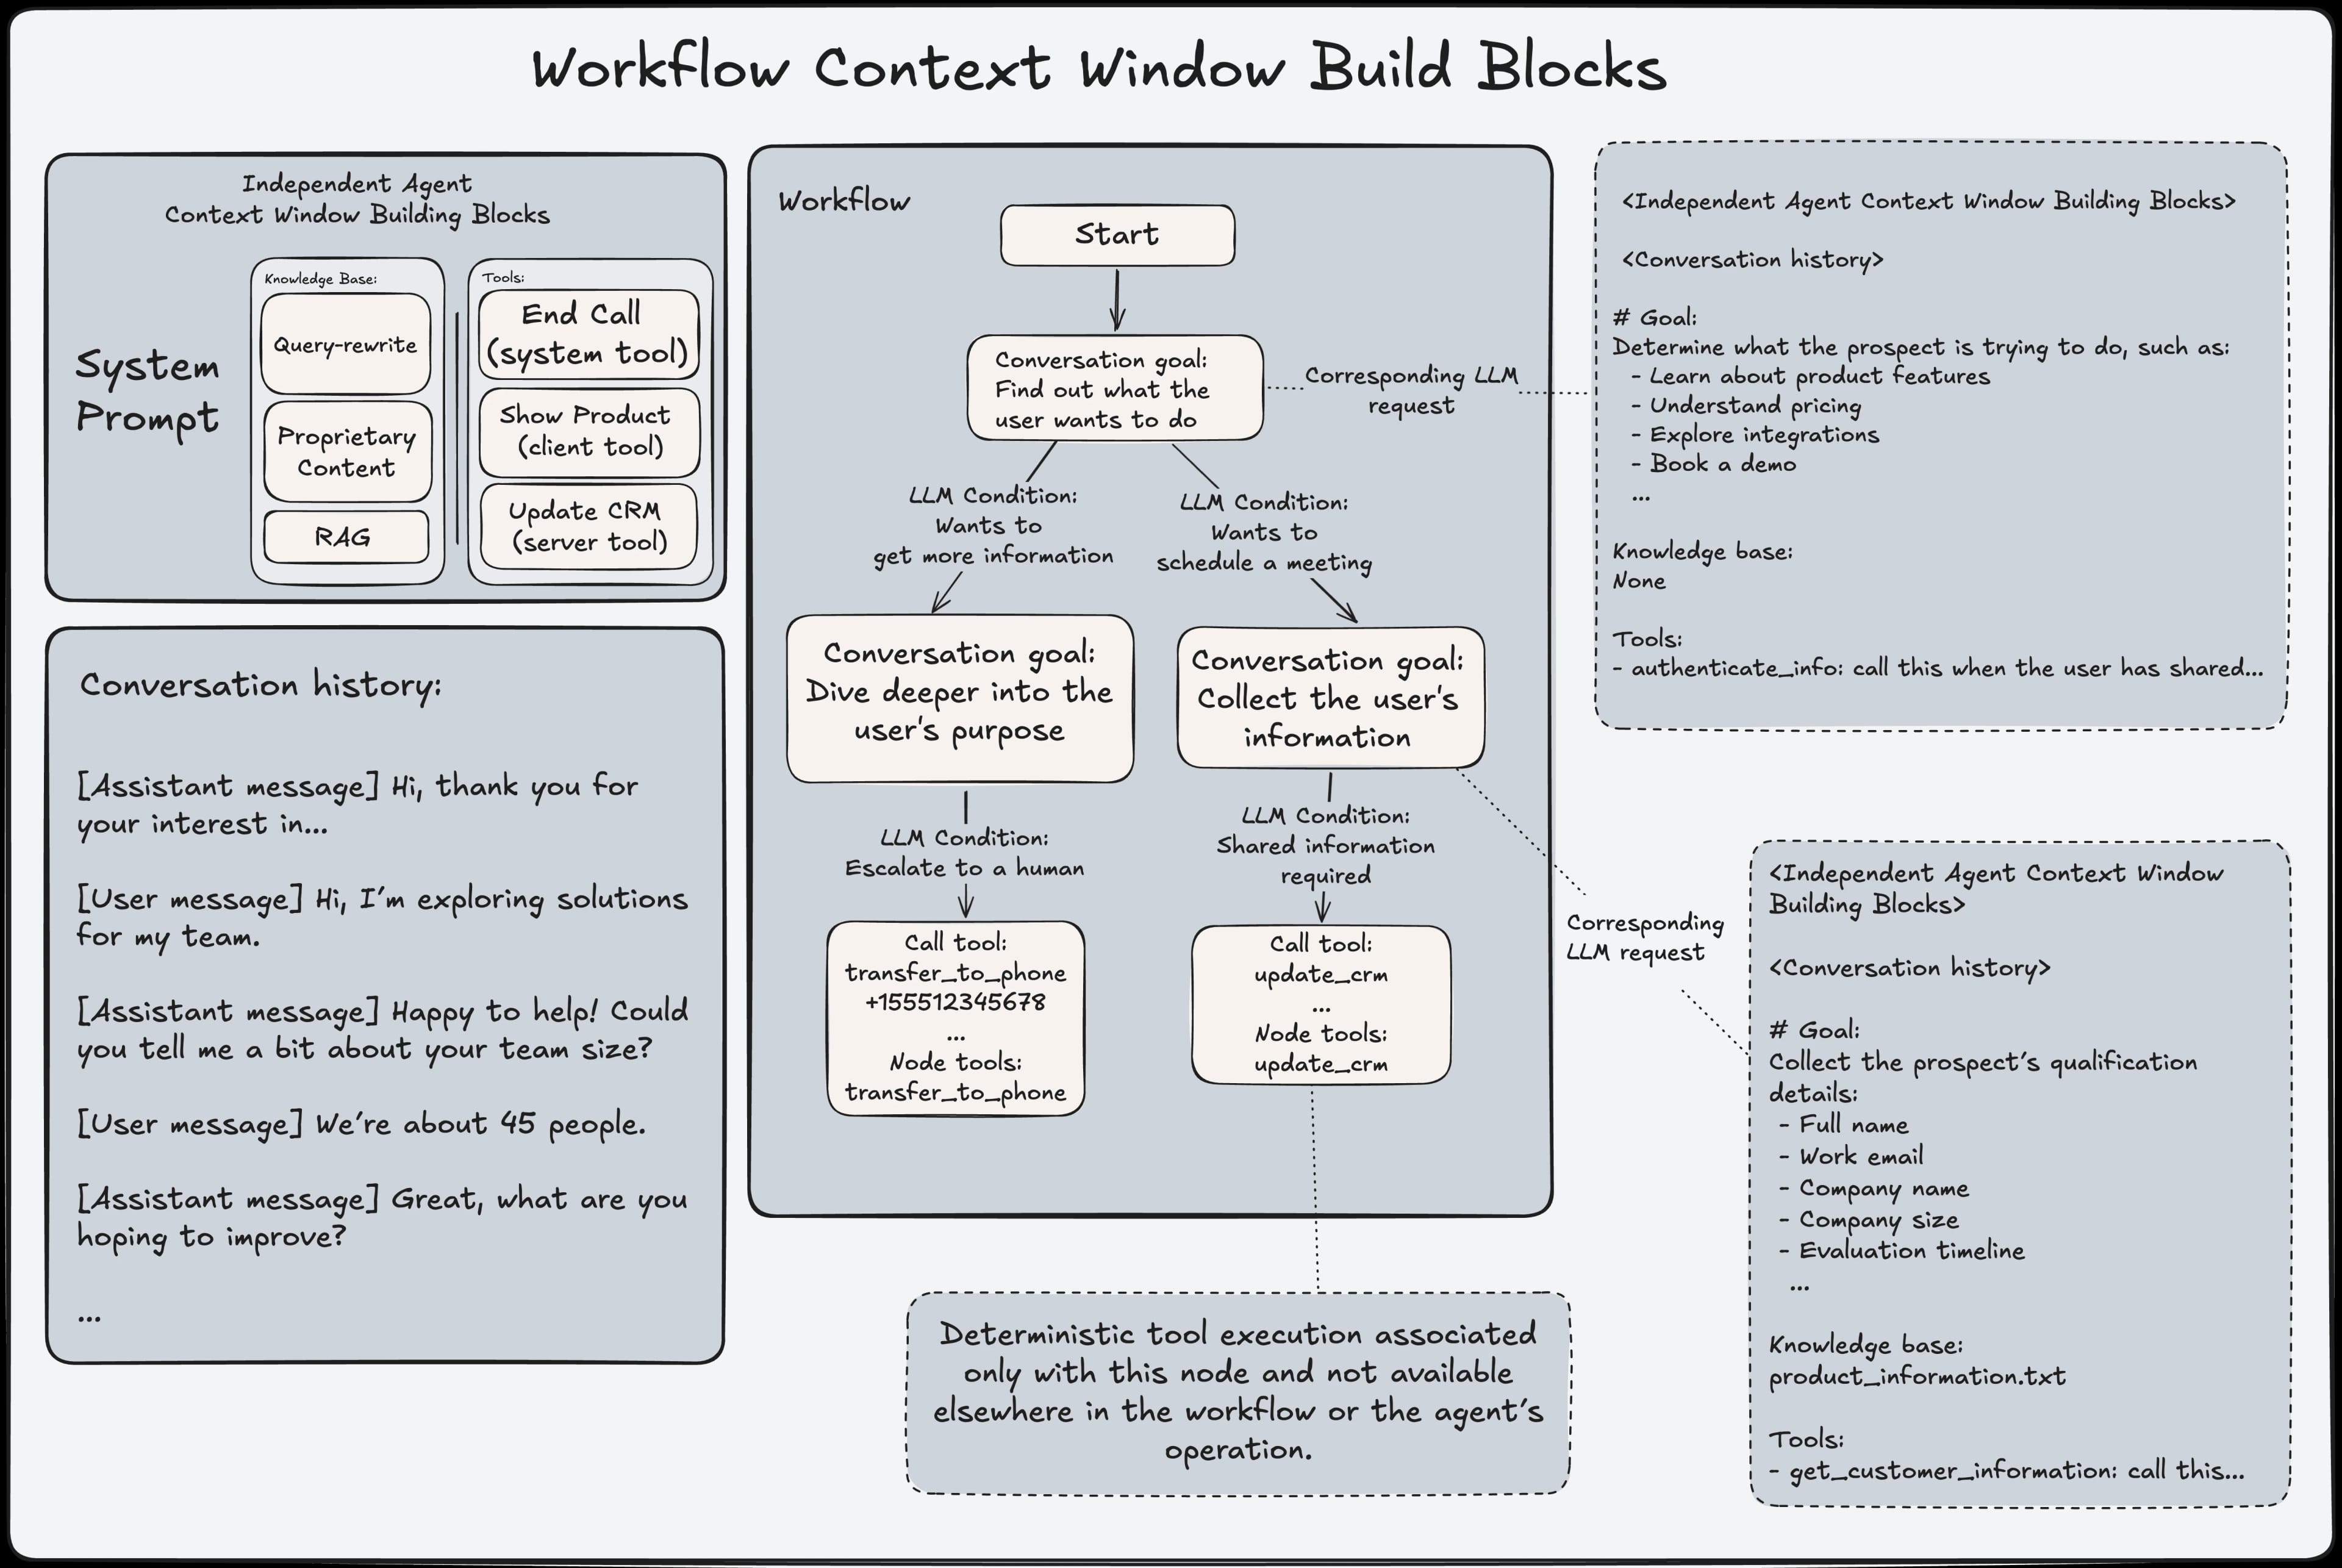
Sobre esta base compartida, los workflows introducen subagentes especializados que operan dentro de un grafo dirigido. A cada subagente se le asigna un objetivo de alcance limitado y amplía la configuración base con instrucciones de prompt, herramientas y fuentes de conocimiento adicionales que solo son relevantes para su función. En lugar de redefinir toda la configuración conversacional, los subagentes añaden su propósito al agente base mediante la composición de prompts y la extensión selectiva del contexto. Aunque el historial de conversación se conserva entre las transiciones de subagentes para mantener la continuidad, cada subagente opera con una visión deliberadamente limitada del sistema. Las bases de conocimientos y las herramientas se exponen de forma selectiva, creando silos claros que evitan filtraciones entre responsabilidades. Para reforzar este aislamiento, el objeto del orquestador se reconstruye en cada transición como si fuera un agente independiente. Esto garantiza que el estado del prompt, la configuración y las capacidades disponibles del subagente activo sigan siendo totalmente deterministas. Este diseño permite que los workflows mantengan la coherencia global al tiempo que admiten especialización local, lo que da lugar a un comportamiento predecible, una clara separación de responsabilidades y un control preciso de cómo se aplican el contexto, el conocimiento y las acciones en cada fase de una interacción.
Uno de los mecanismos clave que hace posible este control es cómo se rigen las transiciones entre subagentes.
Gestión de transiciones de workflows con condiciones de LLM
Los workflows avanzan recorriendo un grafo dirigido de subagentes, en el que las transiciones entre nodos se controlan mediante condiciones explícitas. Estas condiciones determinan cuándo debe pasar el control de un subagente a otro y permiten que los workflows respondan a la entrada del usuario, los resultados de herramientas y las variables dinámicas. Las condiciones del grafo pueden ser deterministas o evaluadas por un LLM. Las condiciones deterministas, como las transiciones incondicionales, las comprobaciones basadas en expresiones de variables dinámicas o las condiciones de resultados de herramientas, ofrecen sólidas garantías sobre el flujo de control y son adecuadas para imponer una progresión estricta en un workflow. Por el contrario, las condiciones basadas en LLM permiten evaluar semánticamente criterios en lenguaje natural, como detectar la intención del usuario o reconocer cuándo se ha proporcionado información específica.
Es importante destacar que las condiciones de LLM se evalúan fuera del prompt de sistema del agente activo y no influyen en su comportamiento de generación. En su lugar, el orquestador las evalúa en paralelo respecto al estado actual de la conversación. Esta separación garantiza que la lógica de transición no contamine el prompt del agente ni afecte a cómo se generan las respuestas, a la vez que permite que los workflows aprovechen el razonamiento de los LLM para recorrer el grafo con flexibilidad. Al combinar condiciones deterministas y evaluadas por LLM, los workflows pueden lograr tanto previsibilidad como adaptabilidad: usan transiciones deterministas cuando la corrección es crítica y transiciones basadas en LLM cuando se requiere interpretación semántica.
Cuando una conversación avanza a una nueva fase, el sistema activa una versión del agente adaptada específicamente a ese paso. Cada fase funciona con sus propias instrucciones específicas y accede únicamente al conocimiento y las herramientas relevantes para su responsabilidad. Por ejemplo, una fase de gestión de reembolsos puede consultar las políticas de reembolso sin heredar contexto no relacionado de la incorporación o la clasificación inicial. El paso de una fase a otra se rige por condiciones de transición explícitas. Estas condiciones determinan cuándo debe cambiar la responsabilidad y permiten que las decisiones de enrutamiento se produzcan de forma natural a medida que avanza la conversación. Para mantener la continuidad, la experiencia del usuario se mantiene fluida entre transiciones, y cada fase hereda el contexto conversacional relevante sin revelar los mecanismos del traspaso. Las medidas de protección también supervisan las transiciones para evitar ciclos de enrutamiento improductivos y garantizar que el workflow se mantenga estable y orientado a objetivos.
Seguridad y protección
Para los casos que requieren mayores controles de seguridad y protección, clientes pueden recurrir a componentes adicionales del orquestador.
Medidas de protección
Los agentes de ElevenLabs implementan medidas de protección mediante un sistema configurable de moderación y alineación que evalúa en tiempo real los mensajes del usuario y del agente. El contenido entrante se clasifica en varias categorías de riesgo, entre ellas contenido sexual, violencia, acoso, odio y autolesión, cada una con umbrales configurables de forma independiente. Cuando se activa una medida de protección, la conversación finaliza de inmediato y se notifica al cliente con un motivo claro del fallo. Esto garantiza que las interacciones inseguras se bloqueen pronto y de forma coherente, sin depender solo de mitigaciones basadas en prompts. Las medidas de protección operan fuera de la lógica de prompts del agente y proporcionan una capa de aplicación fiable que el comportamiento del modelo o la entrada del usuario no pueden eludir. Este enfoque permite que clientes ajusten la sensibilidad de seguridad según su ámbito, a la vez que mantienen una aplicación determinista durante la ejecución.
Gestión de datos conforme a la normativa
A veces, quienes hablan pueden compartir con un agente información sensible sujeta a requisitos estrictos de almacenamiento y procesamiento, por ejemplo, datos médicos que requieren un tratamiento conforme a HIPAA. Para admitir estos casos de uso, ofrecemos el modo de retención cero (ZRM) en el ámbito del agente o del espacio de trabajo. Cuando está activado, todos los datos de las llamadas se procesan únicamente en memoria y nunca se escriben en almacenamiento persistente. Una vez que finalizan la llamada y el procesamiento, ElevenLabs no conserva ninguna información. Como resultado, las transcripciones, grabaciones de audio y resultados de análisis no están disponibles en el panel de control de Agents, y esta política se aplica tanto a los sistemas orientados al cliente como a los registros internos. Aunque los datos no se conservan, se procesan durante la llamada, y los webhooks posteriores a la llamada que se hayan configurado recibirán los resultados, lo que permite que clientes almacenen las transcripciones o los resultados de análisis en sus propios sistemas si lo necesitan.
Cuando ZRM está activo, también nos aseguramos de que los subencargados del tratamiento no conserven datos limitando los LLM disponibles a proveedores con compromisos contractuales que prohíben el entrenamiento con datos de clientes o su conservación; actualmente, esto incluye modelos de Google Gemini y Anthropic Claude. Clientes que quieran utilizar otro LLM con ZRM pueden hacerlo firmando su propio acuerdo con ese proveedor y configurándolo como LLM personalizado mediante claves de API cubiertas por dicho acuerdo. Dado que esto amplía el tratamiento de datos más allá de nuestro límite de confianza estándar, nuestro equipo de Seguridad debe revisar y aprobar manualmente el caso de uso antes de activarlo. Aunque ZRM garantiza que ElevenLabs y sus subencargados del tratamiento no conserven datos de llamadas, clientes siguen siendo responsables de asegurar que las herramientas externas o los webhooks que utilice su agente cumplan los requisitos aplicables de retención y normativa.
De cara al futuro
En esta publicación, hemos analizado cómo los agentes de ElevenLabs gestionan el contexto conversacional, las herramientas, la evaluación y los workflows estructurados para ofrecer experiencias fiables y en tiempo real a escala. A medida que clientes implementan agentes en entornos cada vez más complejos, seguimos ampliando la flexibilidad de nuestro motor de orquestación: desde modelos de evaluación configurables y controles de transición más completos hasta una observabilidad más profunda de la composición de prompts y el uso de tokens en las distintas fases.
Nuestro equipo de ingeniería de implementación colabora estrechamente con clientes para garantizar que estas capacidades evolucionen al mismo ritmo que las implementaciones reales. La próxima generación de Agents ofrecerá aún más transparencia, determinismo y adaptabilidad, sin comprometer el rendimiento de baja latencia que hace posible la conversación en tiempo real.

