
Tutorial de reconocimiento de voz con JavaScript: crea una experiencia de voz
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Incorporar el reconocimiento de voz a sitios web y aplicaciones basadas en navegador es ahora más fácil gracias a las API de Voz a Texto (STT) nativas del navegador, como Web Speech API. Desarrolladores pueden transmitir fácilmente la entrada del micrófono, analizar datos de audio y procesar transcripciones mediante llamadas a la API, sin crear un servidor local de reconocimiento automático de voz.
Web Speech API es una API habitual de reconocimiento de voz para implementar comandos de voz en JavaScript. Expone métodos, argumentos y propiedades que permiten ejecutar transcripciones en tiempo real en un navegador web. Sin embargo, desarrolladores pueden encontrar limitada Web Speech API para clientes web complejos.
Esta guía explica cómo configurar una aplicación web sencilla de reconocimiento de voz con JavaScript usando Web Speech API, sus limitaciones y alternativas para crear clientes de transcripción en tiempo real más robustos.
Resumen
- Web Speech API es una API de Voz a Texto nativa del navegador que envía el audio del micrófono a un servicio backend en la nube para procesarlo.
- Desarrolladores usan la clase de API SpeechRecognition para crear aplicaciones de comandos de voz en JavaScript.
- Al crear una aplicación de reconocimiento de voz, ten en cuenta la privacidad de usuarios e indica que la grabación de audio está en curso.
- Web Speech API tiene varias limitaciones, entre ellas la falta de consistencia en las transcripciones, la dependencia del navegador y la ausencia de comprensión de intenciones.
- ElevenLabs ofrece API de Voz a Texto de alta precisión y preparadas para producción que admiten streaming tanto del cliente como del servidor.
Cómo funciona Web Speech API
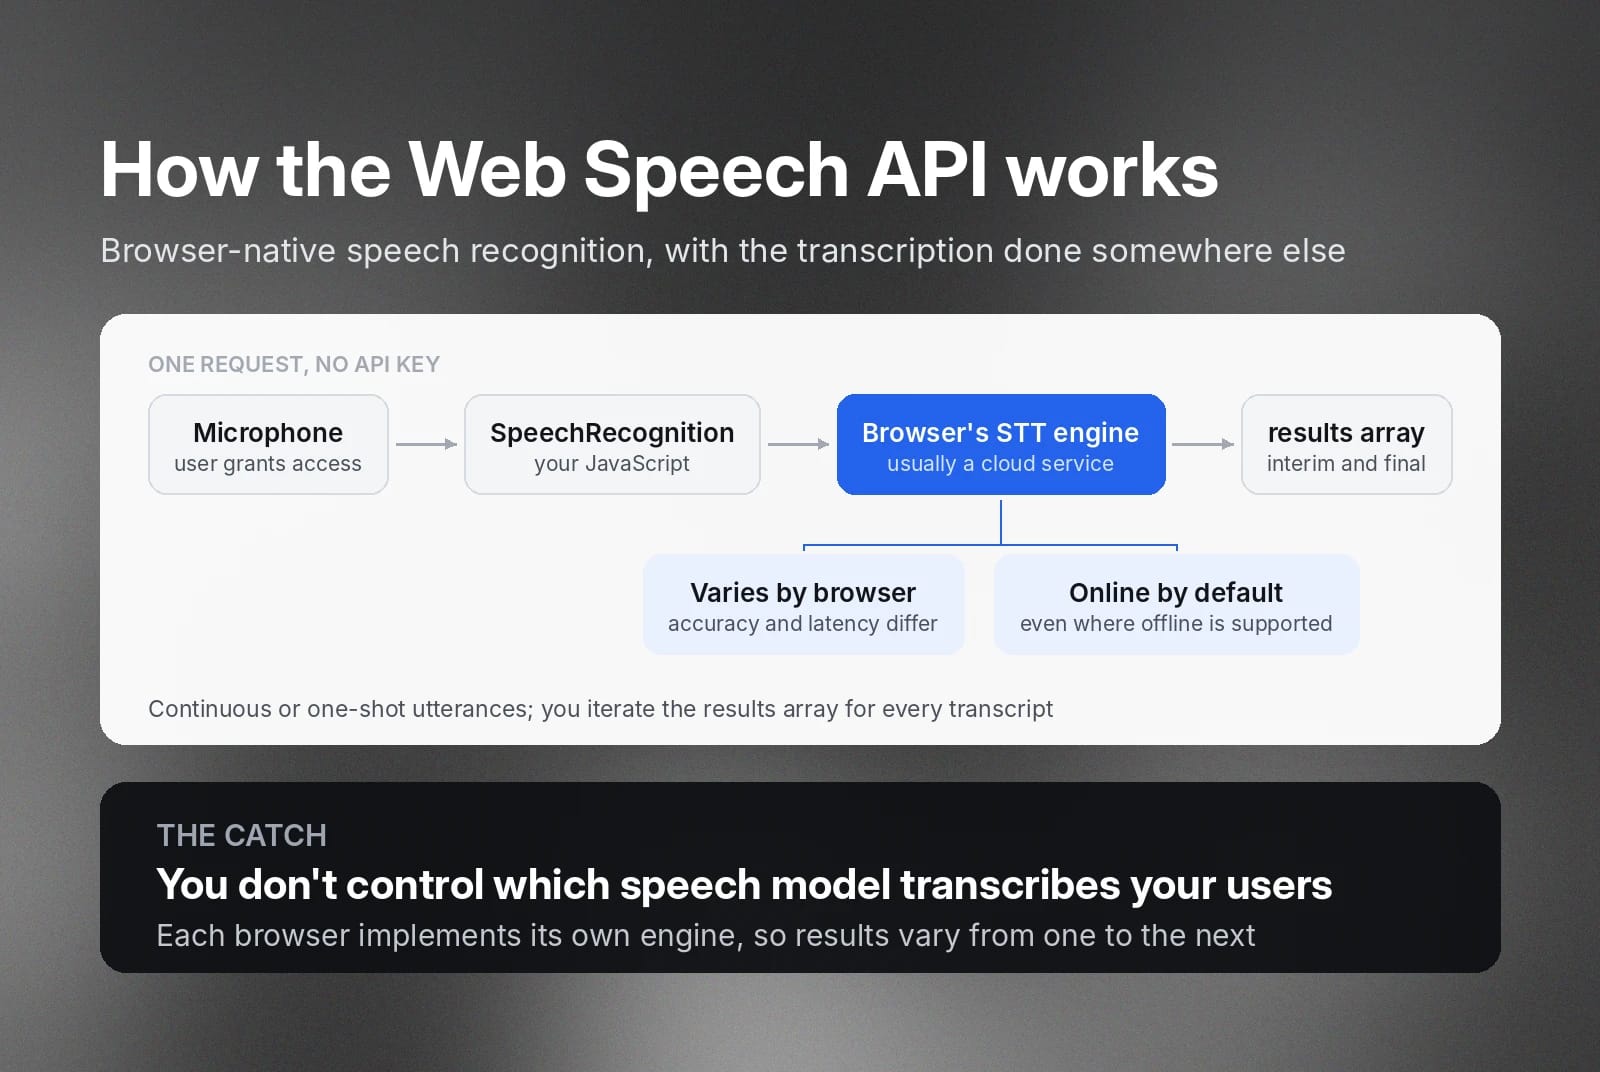
Web Speech API proporciona a desarrolladores web reconocimiento de voz nativo del navegador sin necesidad de un servidor local. Básicamente, Web Speech API envía un flujo de audio desde tu navegador web a un servicio backend en la nube para procesarlo, analizarlo y convertirlo en transcripciones. Como depende del motor backend del navegador para realizar la transcripción, los resultados pueden variar de un navegador a otro.
Por lo general, Web Speech API requiere una conexión activa a internet para transcribir flujos de audio, especialmente si desarrollas para Chrome y Safari. Sin embargo, algunos navegadores ya admiten la transcripción sin conexión. Para la transcripción sin conexión, el navegador actúa como motor de Voz a Texto, identifica fonemas y los convierte en texto coherente.
Independientemente del navegador que uses, los fundamentos de la API son los mismos.
- No necesitas una clave de API para realizar una solicitud a la API.
- Web Speech API admite enunciados continuos o de una sola vez.
- Devuelve transcripciones provisionales y finales.
Sin embargo, como cada navegador puede implementar el motor STT de forma distinta, la precisión y la latencia pueden variar.
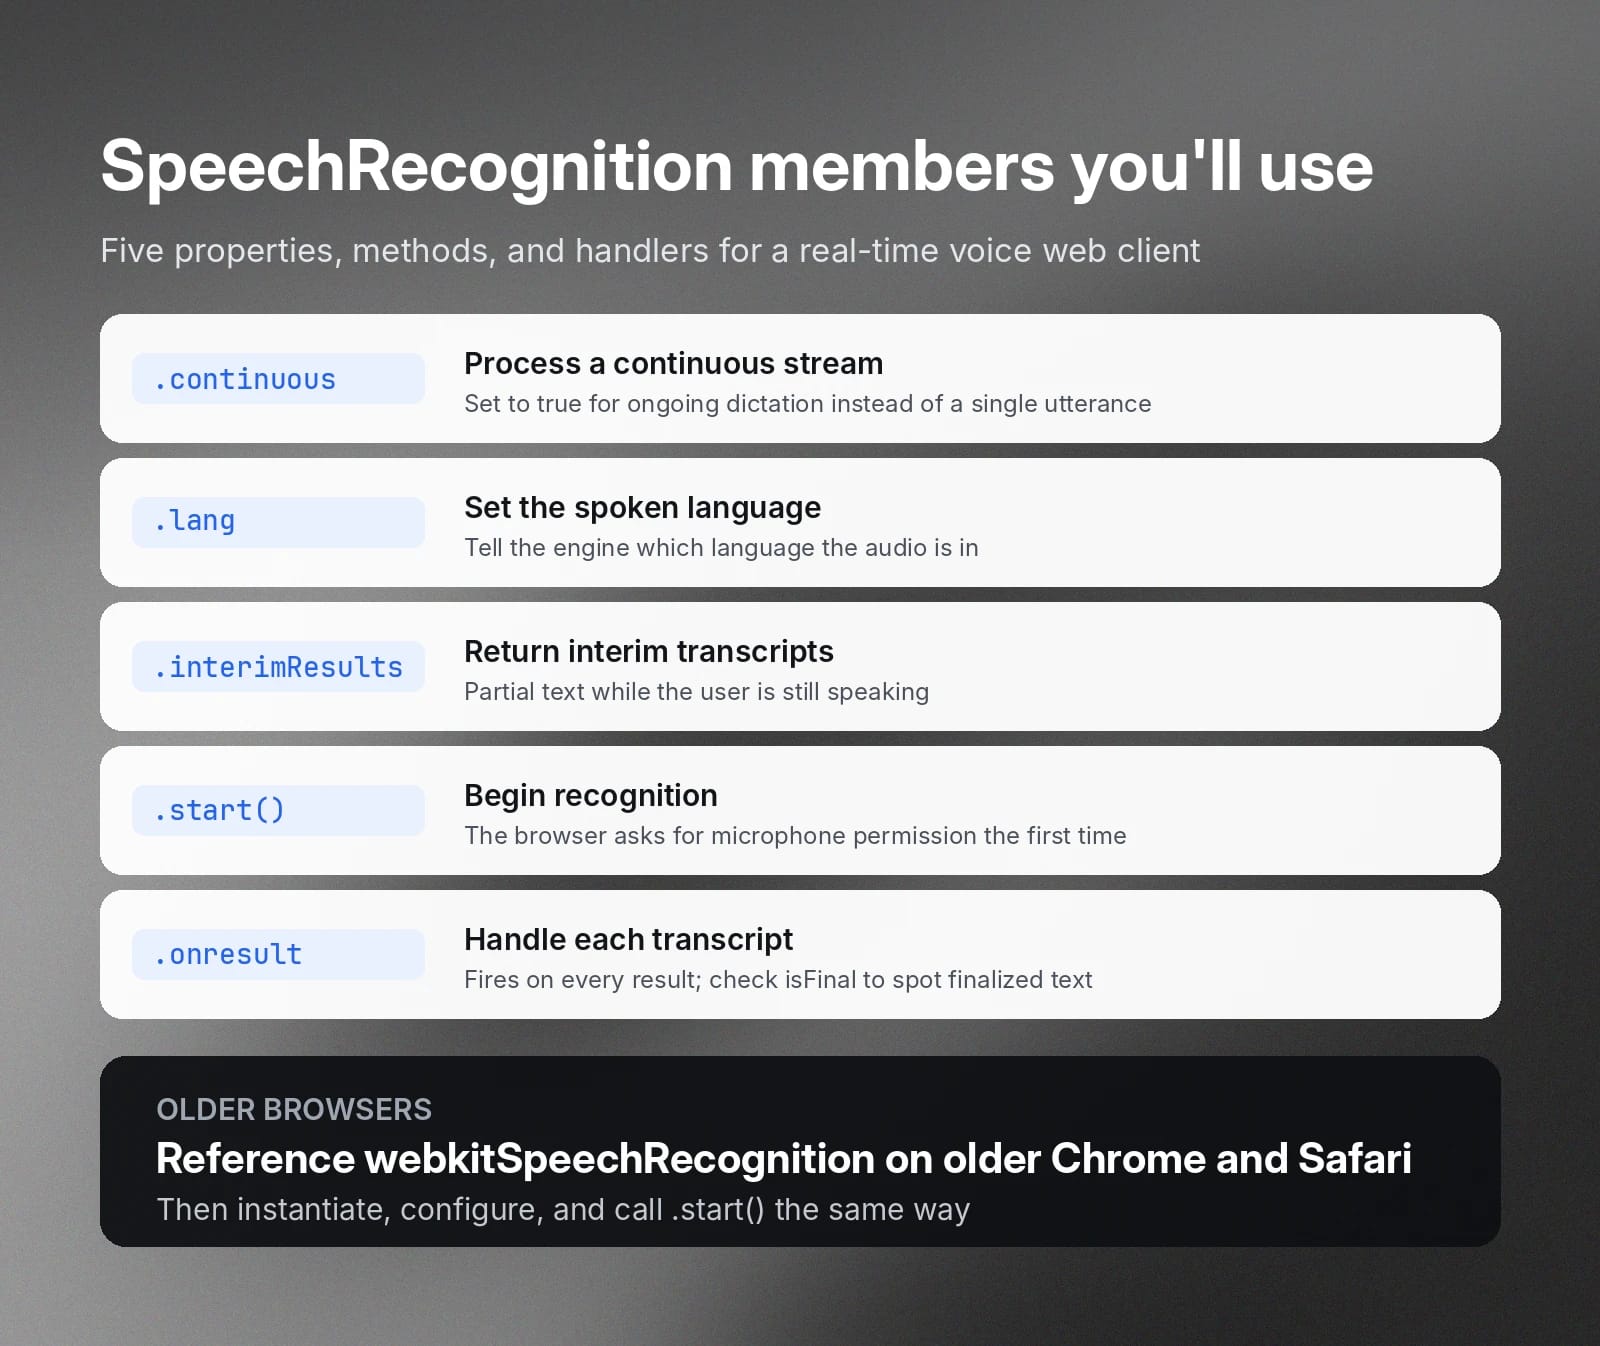
Para usar Web Speech API, inicializa la interfaz SpeechRecognition en tu código JavaScript. Después, accedes a métodos, atributos y controladores de eventos mientras programas. Estos son algunos que usarás para crear un cliente web de búsqueda por voz.
- SpeechRecognition.continuous: Permite que el motor de voz procese un flujo continuo cuando se establece en true.
- SpeechRecognition.lang: Establece el idioma del audio.
- SpeechRecognition.interimResults: Indica al motor que devuelva transcripciones provisionales.
- SpeechRecognition.start(): Inicia el proceso de reconocimiento de voz.
- SpeechRecognition.onresult: Acepta un controlador de eventos, que la API activa cuando termina de transcribir.
Web Speech API devuelve la transcripción en un array de cadenas. Cuando el motor STT devuelve una transcripción, ya sea provisional o final, puedes encontrarla en el array results. Puede devolver una o varias cadenas. Por tanto, debes iterar por las cadenas de resultados para recuperar todo el texto transcrito.
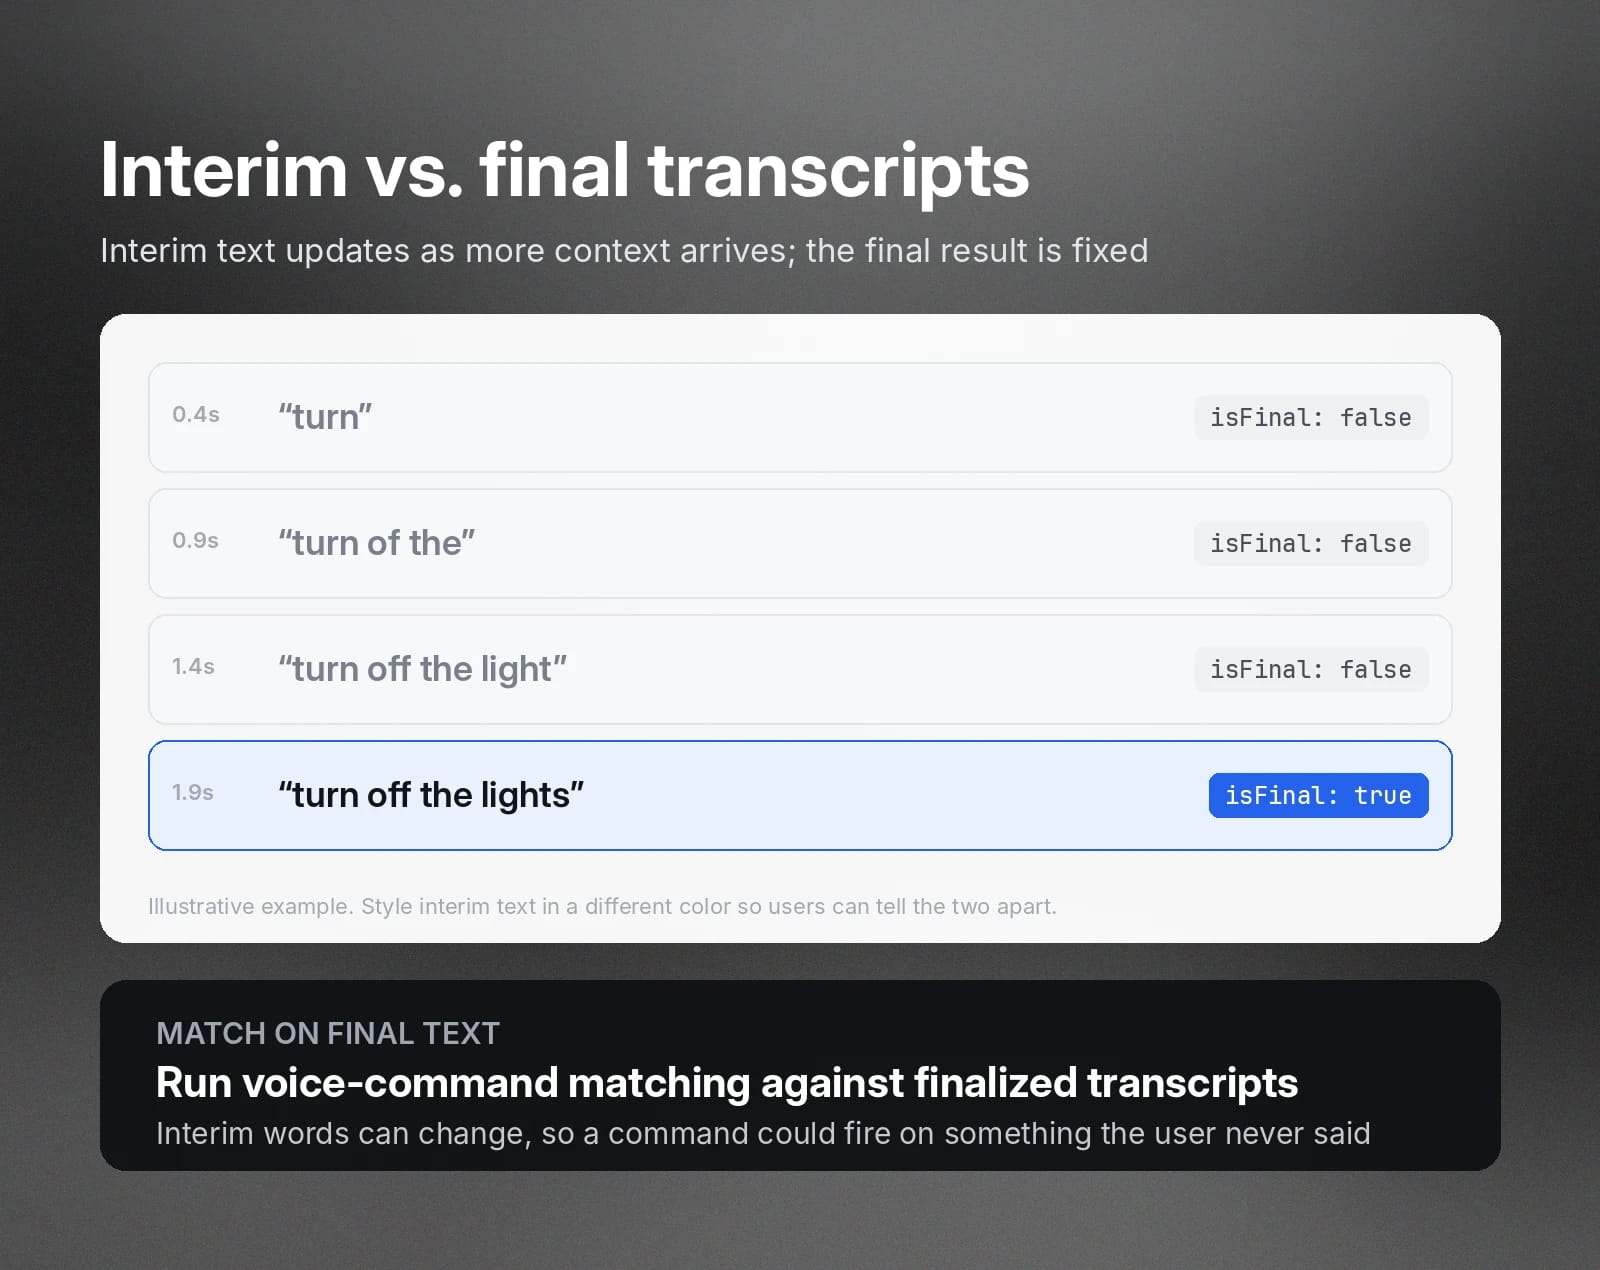
Nota: Si has activado la transcripción provisional, comprueba la propiedad isFinal para determinar si el texto es una transcripción finalizada.
Crea un ejemplo de reconocimiento de voz con JavaScript
Este ejemplo usa la interfaz SpeechRecognition de JavaScript para crear una aplicación web de transcripción en tiempo real. La captura de pantalla de abajo muestra la página terminada.
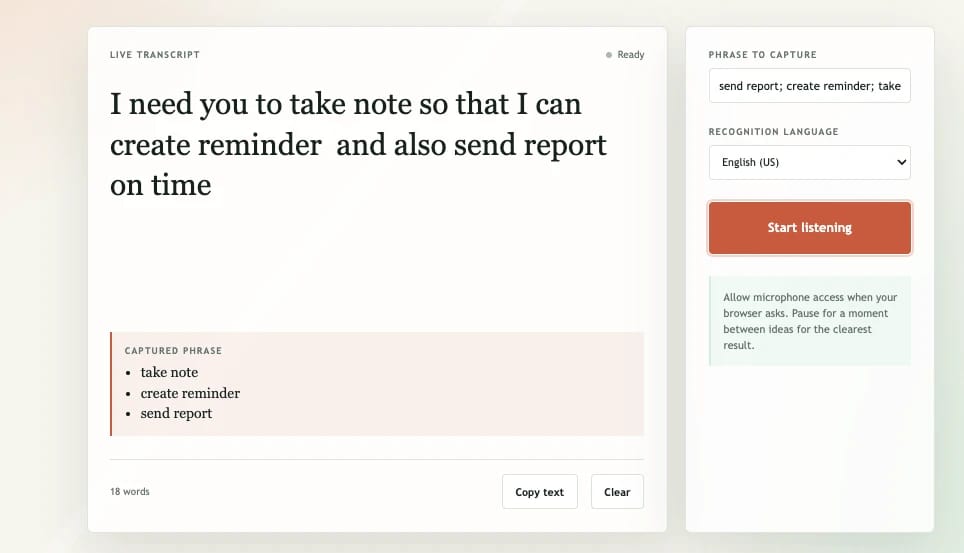
En la página de ejemplo, un botón Iniciar escucha comienza la grabación. A medida que el usuario habla, el navegador envía el audio al motor STT, espera la transcripción y muestra tanto el texto provisional como el final.
El ejemplo también incluye una función de comandos de voz que captura términos concretos introducidos por el usuario. Compara la transcripción con una lista de frases predeterminada en tu propio código, lo cual es distinto del prompting de términos clave en una API de Voz a Texto.
Los fragmentos siguientes muestran las partes clave de este ejemplo.
Configura la API SpeechRecognition y solicita acceso al micrófono
Para usarla en tu código, primero debes crear una instancia de la clase SpeechRecognition. Si usas una versión antigua de Chrome o Safari, debes hacer referencia a webkitSpeechRecognition.
Después, crea una instancia de SpeechRecognition y configura el modo de streaming, la compatibilidad con transcripción provisional y el idioma hablado.
Después, puedes iniciar la transcripción invocando el método .start().
Al iniciar el proceso de reconocimiento de voz por primera vez, el navegador pedirá permiso al usuario. El usuario debe hacer clic en Permitir para iniciar la transcripción. De lo contrario, la API devolverá un valor "not-allowed” en el controlador SpeechRecognitionErrorEvent .
Muestra transcripciones en directo y resultados finales
En este ejemplo, mostramos la transcripción mientras el usuario habla al micrófono. Para ello, añadimos una función al evento onresult.
Las transcripciones provisionales no están finalizadas. Por tanto, el texto mostrado puede no coincidir exactamente con las palabras que has dicho. A medida que el motor STT recibe más contexto de las palabras siguientes, corregirá la transcripción y la devolverá en la cadena.
También puedes aplicar un color diferente al texto provisional para distinguirlo de la transcripción final. Este CSS lo hace:
Añade comandos de voz en JavaScript
Añade un cuadro de texto donde usuarios introduzcan las frases que quieren detectar, separadas por puntos y coma. Como alternativa, puedes guardar las frases en un archivo JSON y cargarlas en tu código.
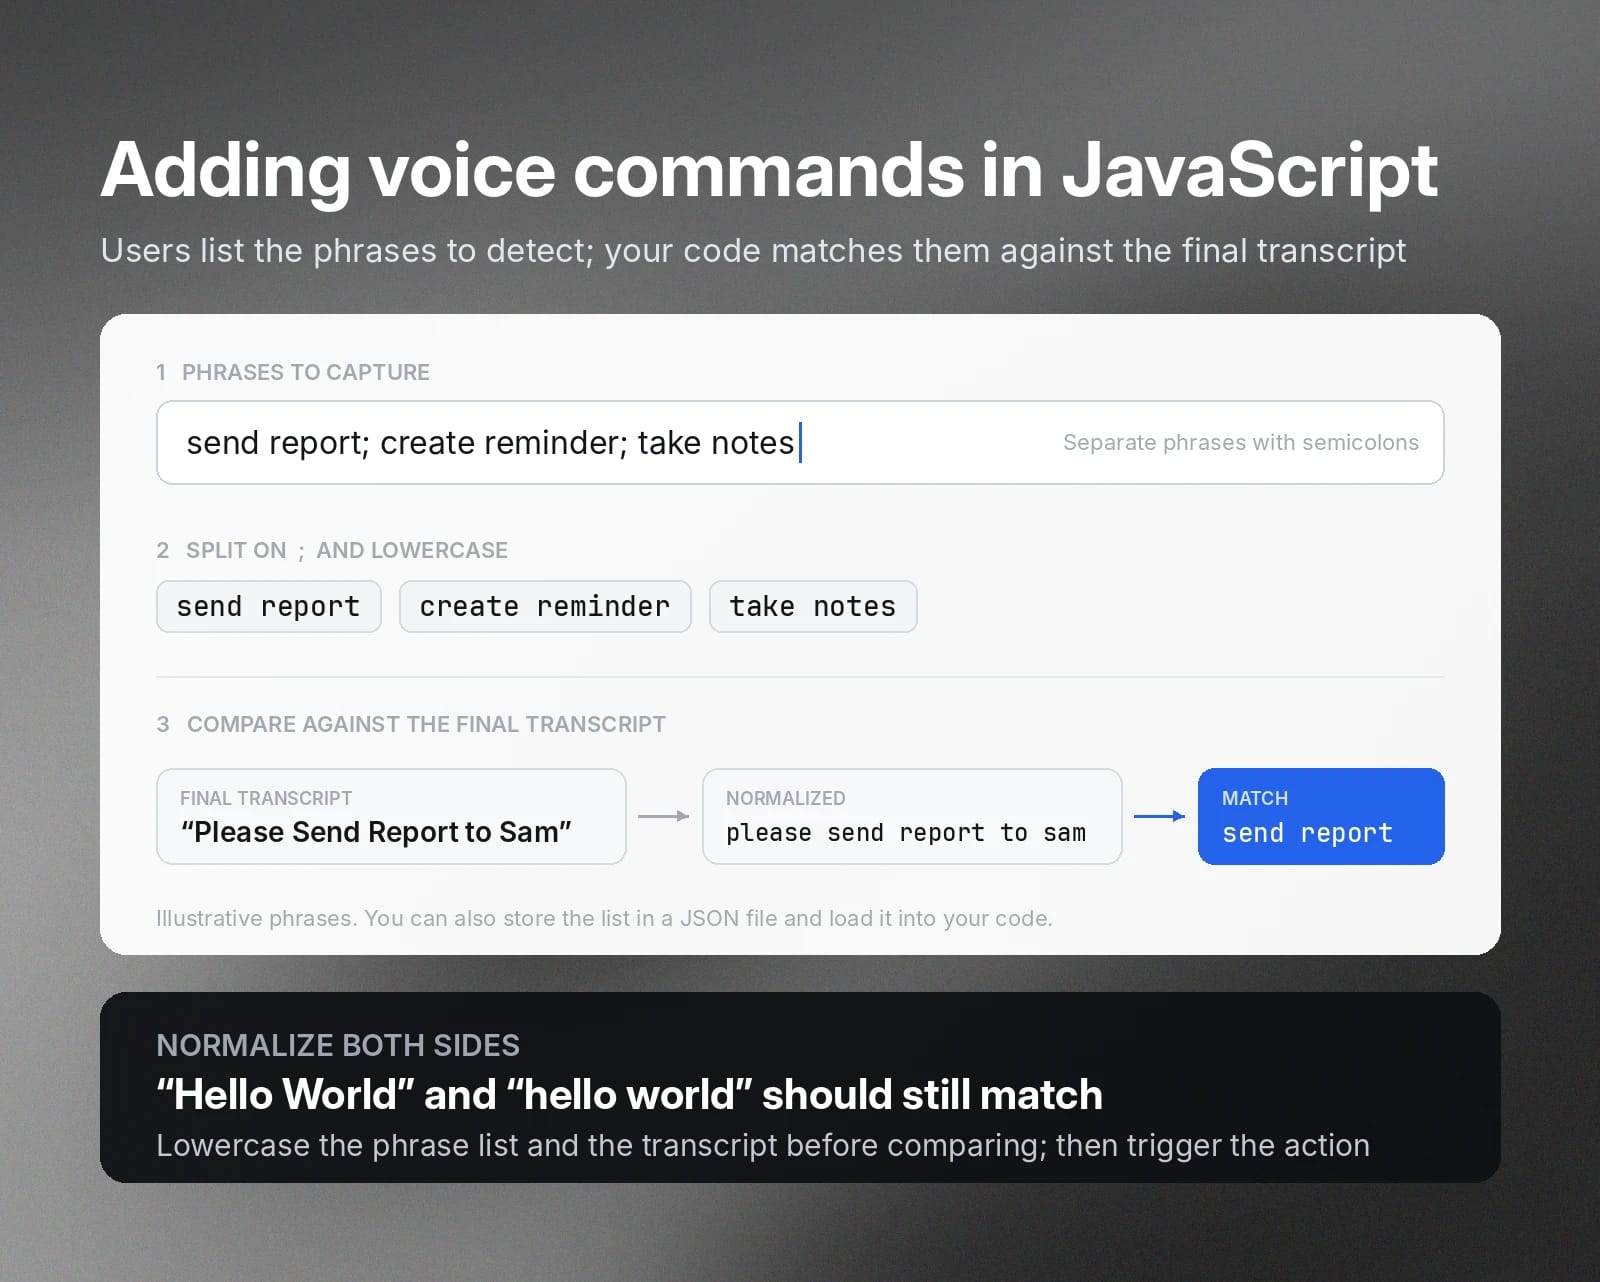
Después, crea una función que compara la transcripción final con la lista de frases. Al comparar texto, normaliza ambas listas convirtiéndolas a minúsculas. Esto se debe a que usuarios pueden escribir palabras con mayúscula inicial, lo que puede causar una falta de coincidencia aunque sea la misma palabra. Por ejemplo, «Hola Mundo» y «hola mundo» deberían coincidir, aunque una tenga mayúsculas.
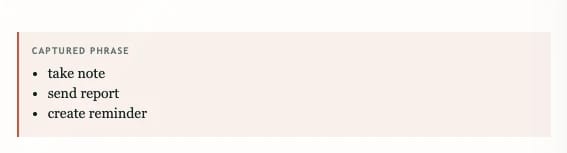
Cada vez que el código recibe una transcripción, recorre la lista de frases. Si hay una coincidencia, activas una acción, como iniciar una aplicación o, en este caso, mostrar la frase coincidente en un panel independiente.
Gestiona la compatibilidad del navegador, los permisos y los errores de reconocimiento
Web Speech API hace más accesible ejecutar el reconocimiento de Voz a Texto en JavaScript, pero no siempre funciona sin problemas. Usuarios pueden usar un navegador con compatibilidad backend limitada o inexistente para la API SpeechRecognition. En algunos casos, los problemas de red harán que falle la transcripción.
Por tanto, tu código debe gestionar estas situaciones y avisar a usuarios en consecuencia.
Por ejemplo, puedes indicar a usuarios que usen Chrome o Edge, donde se ha demostrado que funciona la API SpeechRecognition.
Por otro lado, para gestionar errores, asocias una función de gestión de errores al controlador de eventos onerror y procesas el código de error correspondiente.
Por ejemplo:
Código de error | Acción |
not-allowed | Muestra un texto que indique al usuario que compruebe la configuración del navegador. |
no-speech | Indica al usuario que hable más cerca del micrófono |
network | Pide al usuario que compruebe su conexión a internet |
aborted | Informa al usuario de que se ha detenido el proceso de reconocimiento de voz. |
Haz que el reconocimiento de voz con JavaScript sea accesible y respete la privacidad
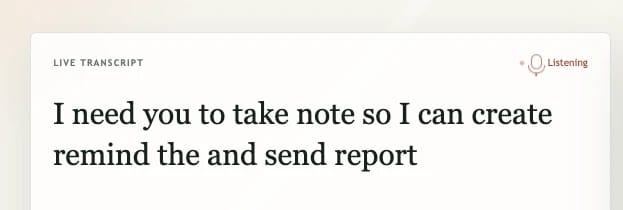
Al integrar Web Speech API, ten en cuenta la privacidad. Muestra siempre un indicador visual o verbal antes de que el cliente web empiece a grabar. Por ejemplo, muestra un icono de escucha como señal visual mientras el código de reconocimiento de voz de JavaScript envía activamente la señal del micrófono al motor de Voz a Texto.
Otro aspecto al que desarrolladores deben prestar atención es la privacidad de los datos. Cuando transcribes con la API SpeechRecognition, la API realiza la transcripción en línea de forma predeterminada. Aunque el navegador admita Voz a Texto sin conexión, la API intentará primero realizar la transcripción en línea.
Estas especificaciones técnicas son esenciales al crear servicios de transcripción en los que la residencia de los datos, la gobernanza y el cumplimiento normativo están estrictamente regulados.
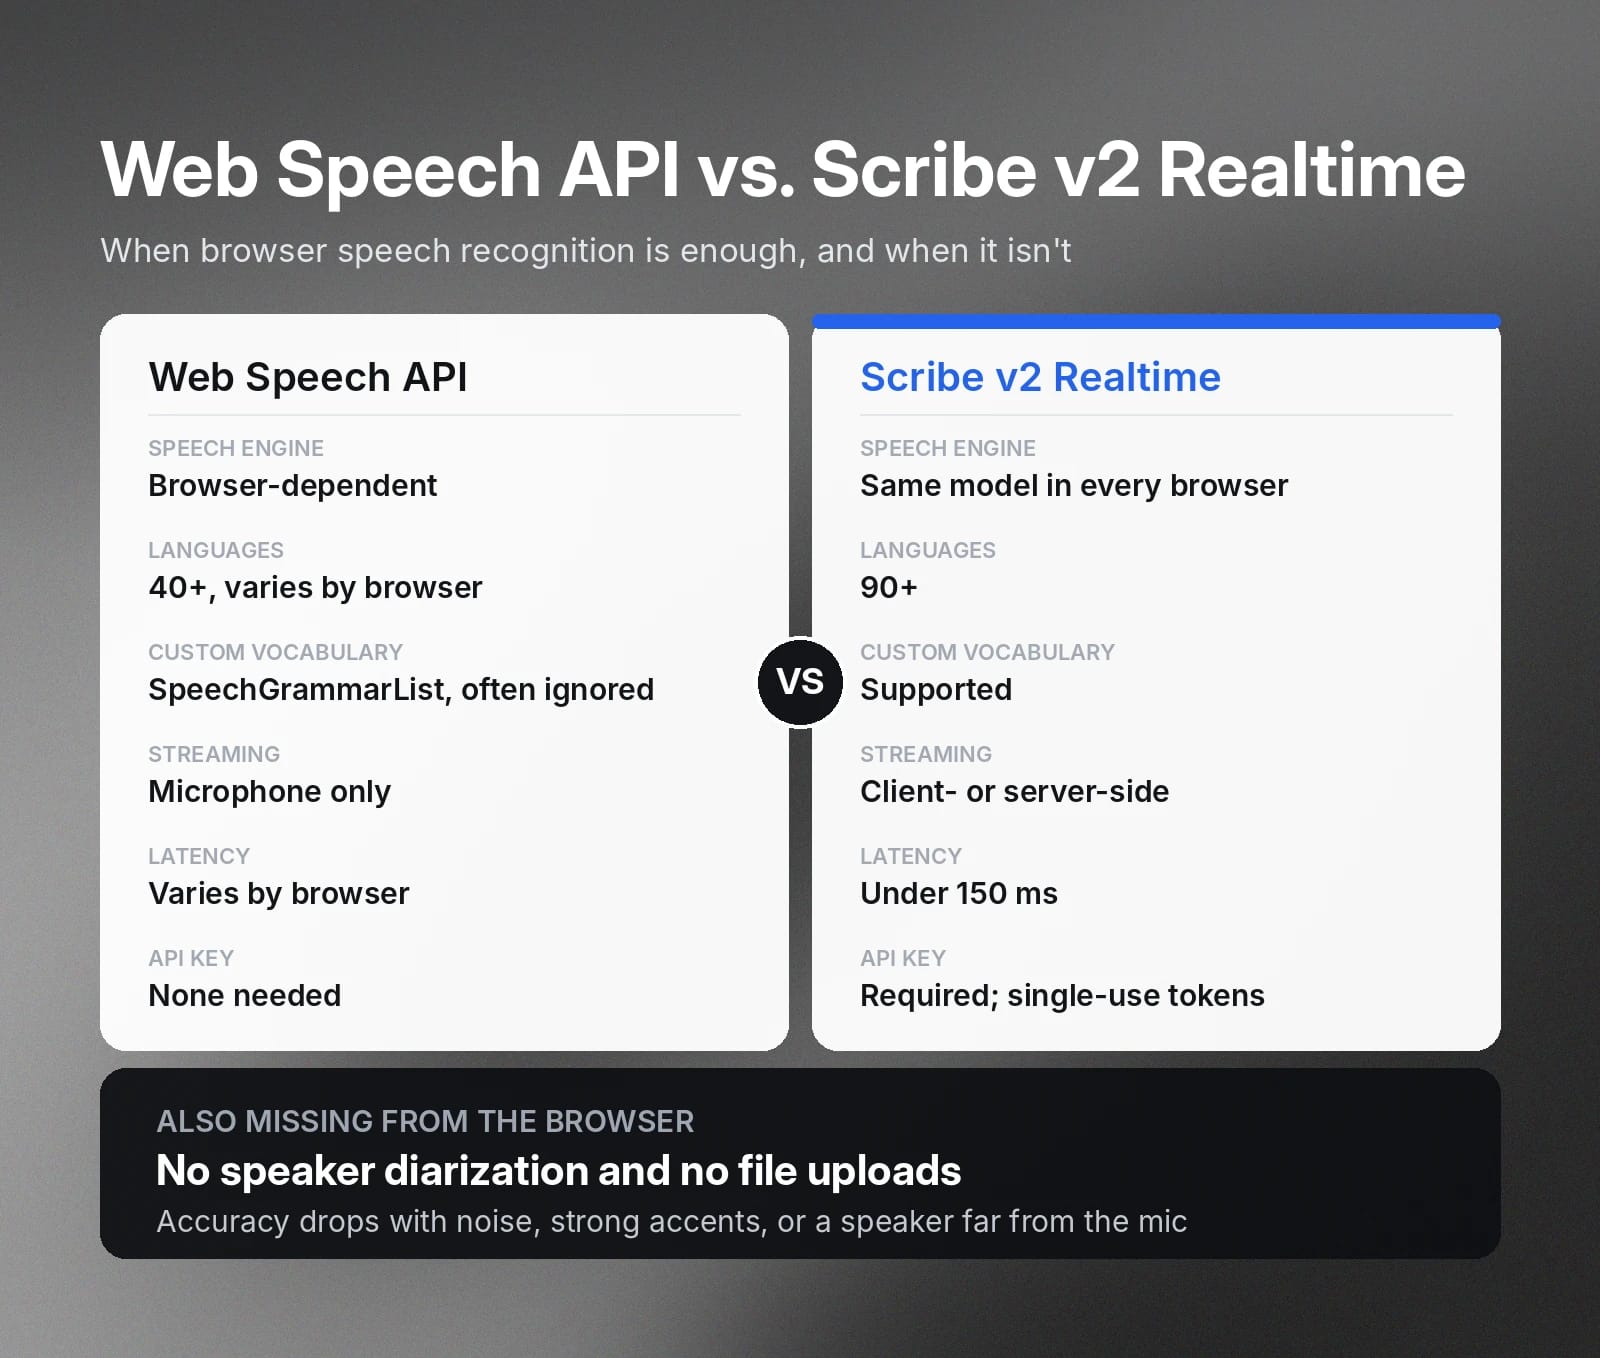
Identifica cuándo el reconocimiento de voz del navegador no es suficiente para producción
Hemos mostrado los pasos para crear reconocimiento automático de voz para aplicaciones de voz basadas en navegador con Web Speech API. La API hace accesibles las funciones de Voz a Texto a desarrolladores de JavaScript. Sin embargo, varias limitaciones restringen los casos de uso, especialmente en productos web comerciales.
- Dependencia del navegador: La transcripción depende en gran medida del navegador del usuario. Desarrolladores no tienen control sobre los modelos de voz específicos que utilizan, lo que provoca un rendimiento de transcripción inconsistente.
- Compatibilidad lingüística limitada: La API admite más de 40 idiomas, pero el número exacto puede variar entre navegadores.
- Diarización de hablantes: No puedes detectar quién está hablando ni reflejar a cada hablante en la transcripción.
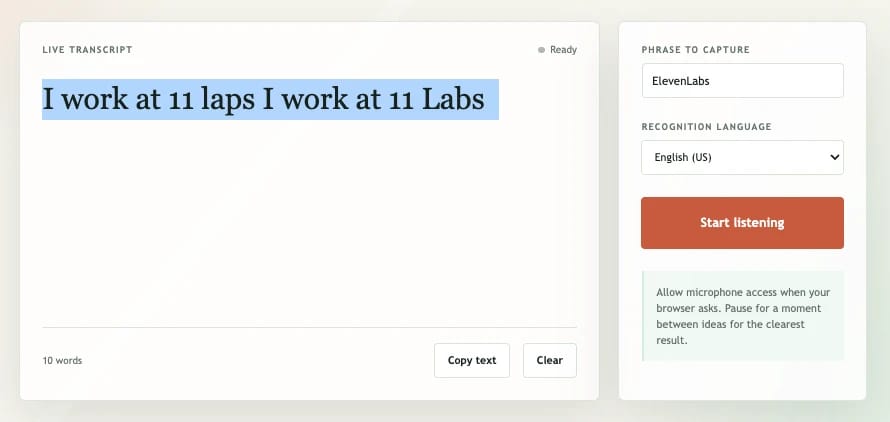
- Vocabularios personalizados: La API SpeechRecognition no ofrece una compatibilidad fiable con vocabularios personalizados. Por ejemplo, no puede transcribir con precisión «ElevenLabs». (La API oficial SpeechRecognition proporciona una interfaz de vocabulario personalizado mediante SpeechGrammarList, pero los navegadores modernos suelen ignorarla.)
- Precisión: La precisión de la transcripción disminuirá cuando el hablante se encuentre en un entorno ruidoso, tenga un acento marcado o esté lejos del micrófono.
- Streaming desde el servidor: Solo puedes transmitir desde el micrófono, ya que Web Speech API no admite streaming desde el servidor ni cargas manuales de archivos de audio.
Si estas limitaciones te impiden comercializar tu producto de reconocimiento de voz, recomendamos usar ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime es un modelo de reconocimiento de voz que ofrece transcripción en tiempo real de alta precisión con una latencia inferior a 150 ms. Admite más de 90 idiomas, consistencia independiente del navegador y vocabularios personalizados. Con ElevenLabs Scribe v2 Realtime, puedes ejecutar streaming desde el cliente o desde el servidor según la arquitectura de tu aplicación web.
Tutorial de reconocimiento de voz con JavaScript y ElevenLabs Scribe v2 Realtime
Crear un comando de voz en JavaScript con ElevenLabs sigue un enfoque similar. Sin embargo, tendrás que crear una clave de API de ElevenLabs para autorizar las solicitudes a la API. A continuación encontrarás pasos rápidos para crear un cliente web que transmita desde un micrófono.
- Instala el SDK de ElevenLabs
- Crea un token de un solo uso para pasar la clave de API sin exponerla
- Configura y conéctate al modelo Scribe v2 Realtime con los parámetros deseados
- Crea controladores de eventos para procesar transcripciones y gestionar excepciones
Para obtener una guía completa sobre Scribe v2 Realtime, consulta nuestra documentación oficial.
Empieza a usar ElevenAPI para Voz a Texto en producción
ElevenAPI ofrece modelos de Voz a Texto preparados para producción para el desarrollo de clientes web y servidores. Además del reconocimiento de voz en tiempo real, desarrolladores usan los modelos de Voz a Texto de ElevenAPI para habilitar la transcripción por lotes con diarización de hablantes, marcas de tiempo por palabra y procesamiento asíncrono.
En lugar de consultar continuamente el motor de Voz a Texto, puedes crear un webhook en el panel de ElevenLabs y proporcionar una URL de callback donde la API entregue la transcripción completada.
Tanto si quieres crear un cliente web como una aplicación de servidor con reconocimiento automático de voz, ElevenAPI ofrece modelos de audio que puedes integrar fácilmente en tu código.
Obtén tu clave de API de ElevenLabs y explora la documentación de la API para empezar a crear.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


