
¿Qué es un LLM? Guía práctica sobre los modelos de lenguaje
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
Un modelo de lenguaje de gran tamaño (LLM) es un sistema de inteligencia artificial entrenado con un conjunto de datos enorme para analizar, predecir y generar lenguaje natural. Entre los LLM más conocidos están los modelos GPT de OpenAI, Claude de Anthropic y Gemini de Google, que suelen utilizarse para tareas como escribir, editar y programar.
Al principio, los conjuntos de datos de los LLM incluían principalmente texto de fuentes como libros, blogs e incluso foros online. Los LLM modernos utilizan ahora datos multimodales para ampliar los casos de uso, por ejemplo, para impulsar agentes de voz conversacionales o crear música.
Antes de implementar esta tecnología, las organizaciones suelen necesitar respuestas a preguntas como: ¿qué es un LLM?, ¿cómo funciona un LLM? y ¿qué arquitecturas debería usar el equipo? Esta guía responde a estas preguntas y muestra aplicaciones reales de la tecnología y sus beneficios tangibles.
Resumen
- Un modelo de lenguaje de gran tamaño (LLM) es un modelo de inteligencia artificial entrenado con enormes conjuntos de datos de texto y datos multimodales para analizar, predecir y generar resultados.
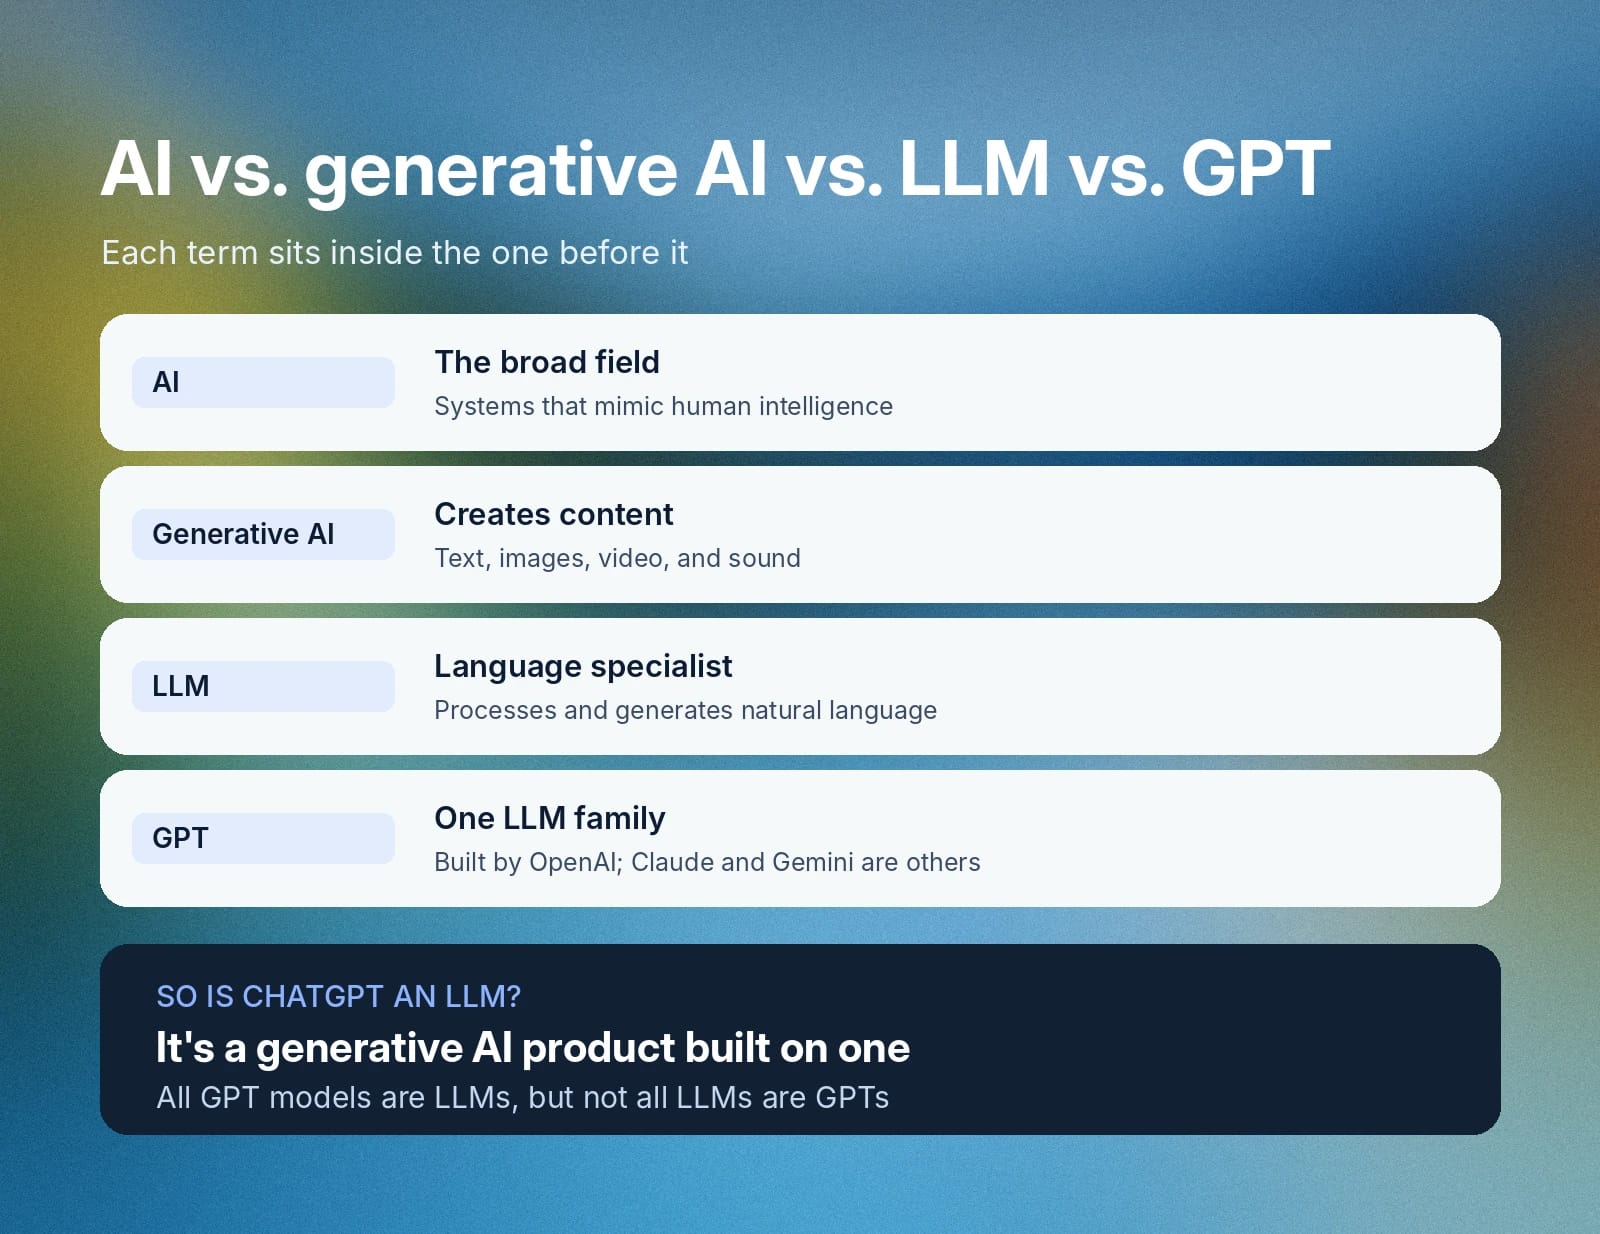
- La principal diferencia entre los GPT y los LLM es que GPT (transformador generativo preentrenado) es una familia específica de LLM creada por OpenAI, mientras que LLM es el término general para modelos como Claude y Gemini.
- La IA generativa es la categoría amplia de modelos que crean una gran variedad de contenido a partir de datos de entrenamiento, mientras que los LLM son un subconjunto especializado de la IA generativa centrado en el procesamiento del lenguaje natural.
- Los LLM utilizan redes neuronales transformadoras para dividir el texto en unidades más pequeñas llamadas tokens y, después, predecir el siguiente token basándose en la información contextual del prompt y el historial de chat existente.
- Entre los ejemplos prácticos de modelos de lenguaje de gran tamaño están los chatbots de atención al cliente, las herramientas de escritura automatizada, los generadores de código y las capas de procesamiento del lenguaje natural para aplicaciones de voz.
¿Qué es un LLM? Definición de modelo de lenguaje de gran tamaño
Un modelo de lenguaje de gran tamaño es un programa de IA basado en redes neuronales de aprendizaje profundo para analizar, predecir y generar lenguaje natural. Desarrolladores entrenaron estos modelos con conjuntos de datos que contienen miles de millones de obras procedentes de libros, artículos académicos, sitios web y blogs. El término «gran tamaño» se refiere tanto al enorme volumen de datos utilizado para entrenar estos modelos como a los miles de millones de parámetros internos que rigen su comportamiento.
Los modelos de lenguaje de gran tamaño suponen un cambio importante respecto al funcionamiento del software anterior; el software tradicional dependía de comandos de sintaxis explícitos, pero los LLM no. En lugar de procesar cada palabra de forma aislada, los LLM utilizan relaciones contextuales para reconocer patrones lingüísticos complejos y reglas gramaticales. Interpretan el lenguaje humano no estructurado y siguen respondiendo a prompts abiertos de usuarios, adaptándose a los cambios de contexto durante la conversación.
Estos avances en el procesamiento del lenguaje natural permiten que ElevenAgents comprenda intenciones complejas de clientes y ejecute workflows automatizados.
¿Cómo funcionan los modelos de lenguaje de gran tamaño?
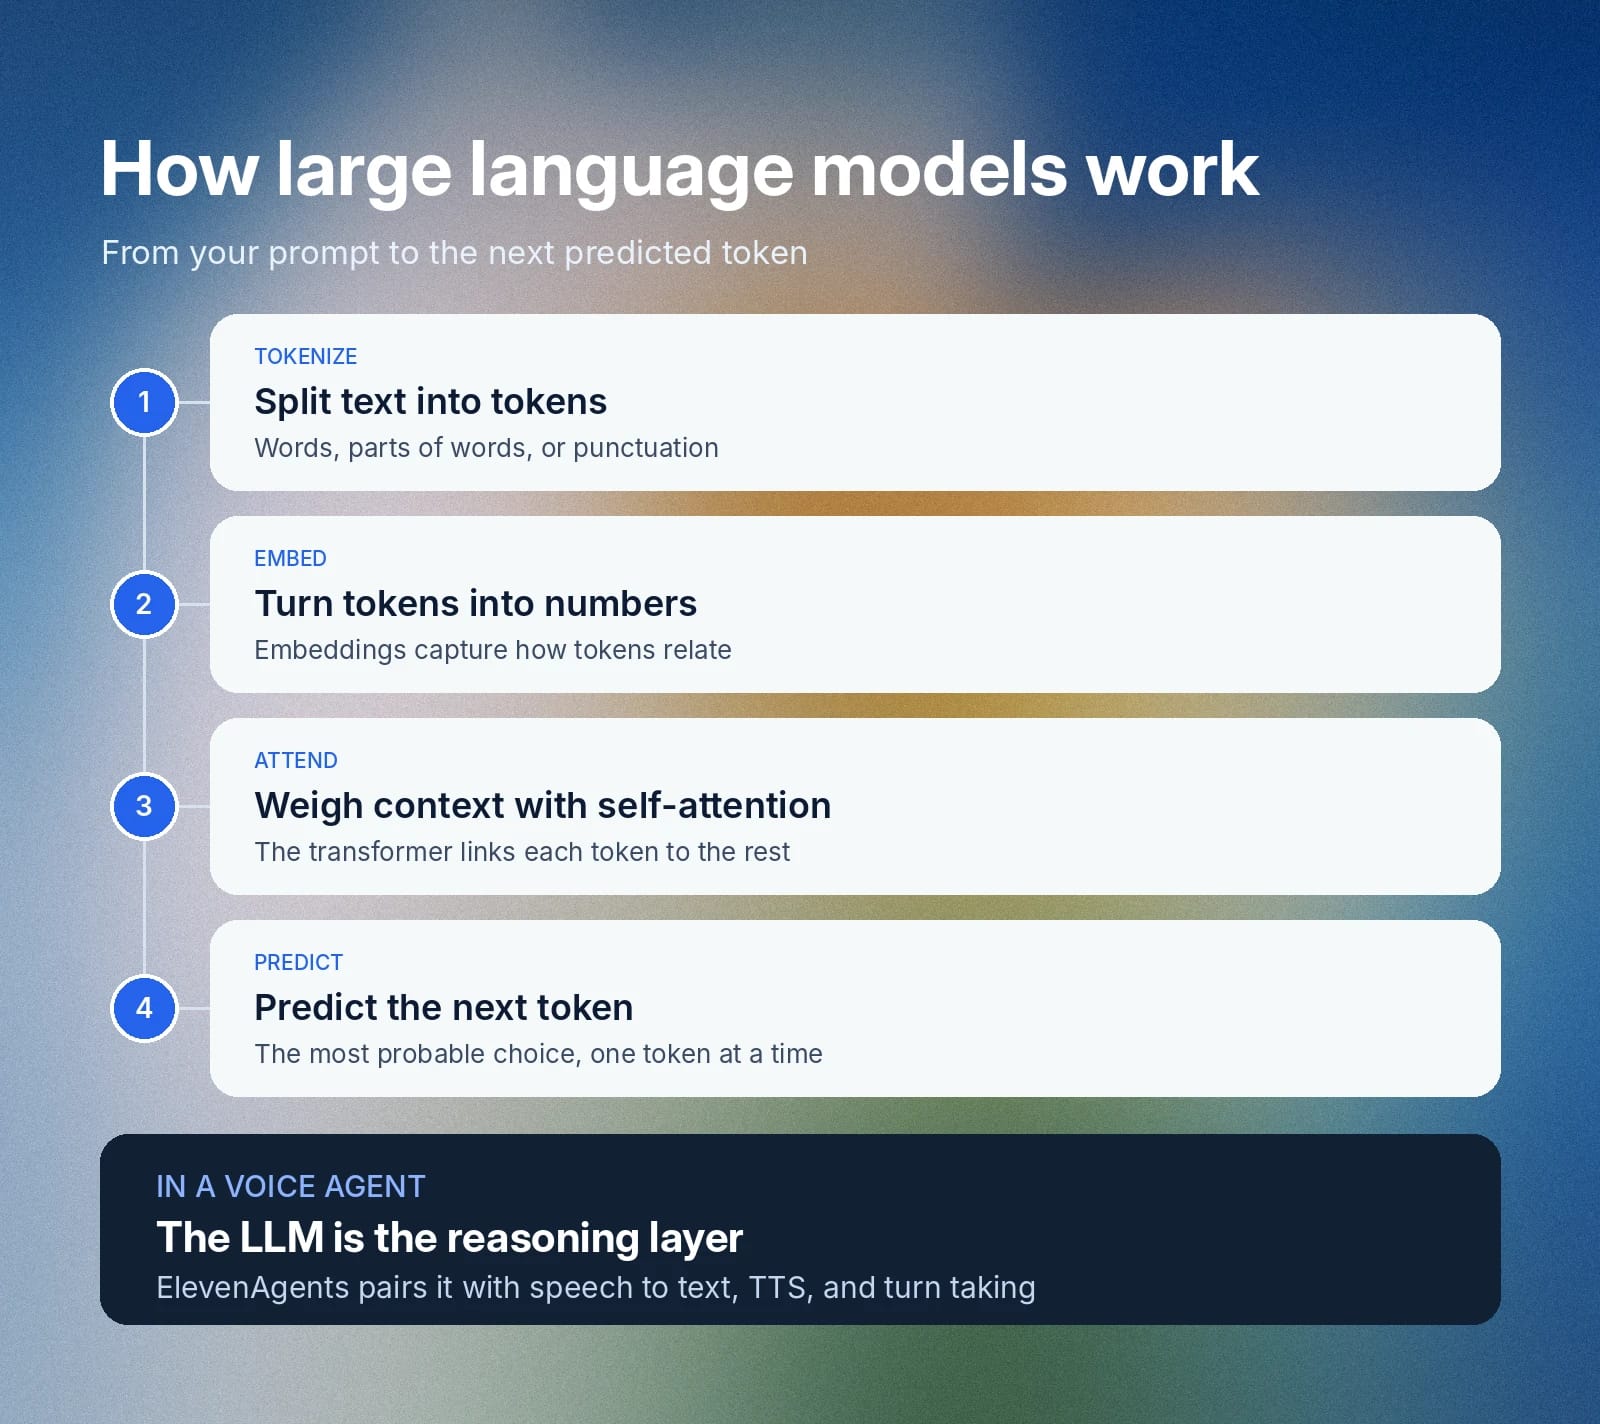
Los modelos de lenguaje de gran tamaño procesan texto mediante redes neuronales artificiales para analizar entradas en lenguaje natural y generar contenido relevante. El proceso comienza con la tokenización, en la que el modelo divide el texto de entrada en unidades más pequeñas llamadas tokens. Después, el modelo traduce estos tokens a representaciones numéricas, llamadas embeddings, para evaluar relaciones matemáticas o estadísticas entre ellos.
La mayoría de los sistemas LLM modernos se basan en la arquitectura de redes neuronales transformadoras. Los transformadores utilizan mecanismos de autoatención, que evalúan las relaciones contextuales entre tokens. El modelo predice el token estadísticamente más probable para completar una secuencia mediante patrones aprendidos que calculan distribuciones de probabilidad.
La autoatención permite que los modelos de procesamiento del lenguaje natural mantengan el contexto a largo plazo y se adapten a cambios en mitad de una conversación. Las integraciones de plataforma con ElevenAgents aprovechan estas capacidades para ofrecer respuestas relevantes y de baja latencia que imitan la conversación humana natural.
¿Qué es la temperatura en un LLM?
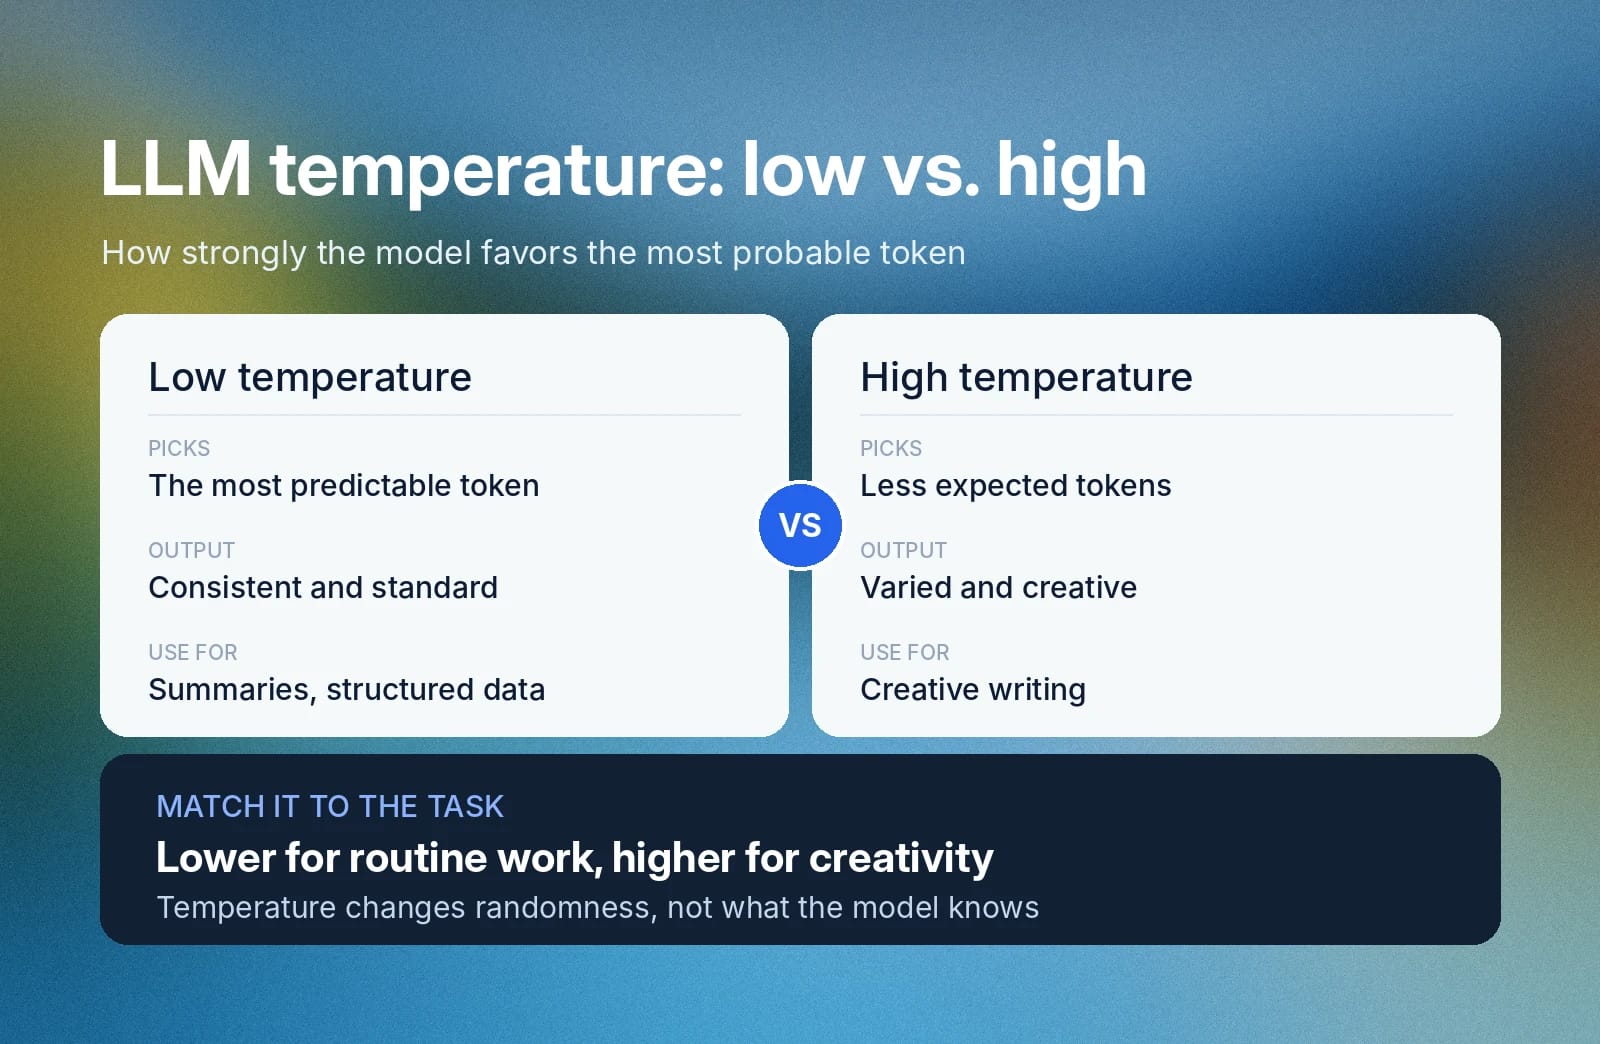
La temperatura de un LLM es una configuración variable que desarrolladores pueden ajustar para determinar hasta qué punto serán aleatorias las respuestas de un LLM. Los LLM generan el siguiente token de una cadena de palabras seleccionando la opción más frecuente. Sin embargo, para cada elección que realiza el LLM, puede haber otras alternativas con una ponderación similar.
Al ajustar la temperatura de un LLM, cambias hasta qué punto favorece la opción más probable. Una temperatura baja produciría una respuesta estándar y consistente, ya que tendería a elegir siempre el siguiente token más predecible de una cadena. Por otro lado, una temperatura alta se desviaría de la elección esperada con más frecuencia y produciría respuestas más creativas y variadas.
Debes adaptar el valor de temperatura de tu LLM a la tarea que quieres realizar. Todo lo que necesite un elemento de creatividad debería usar temperaturas más altas, mientras que las tareas rutinarias o los resultados estructurados, como los resúmenes de datos, deberían usar temperaturas más bajas.
¿Cómo se entrenan y ajustan los LLM?
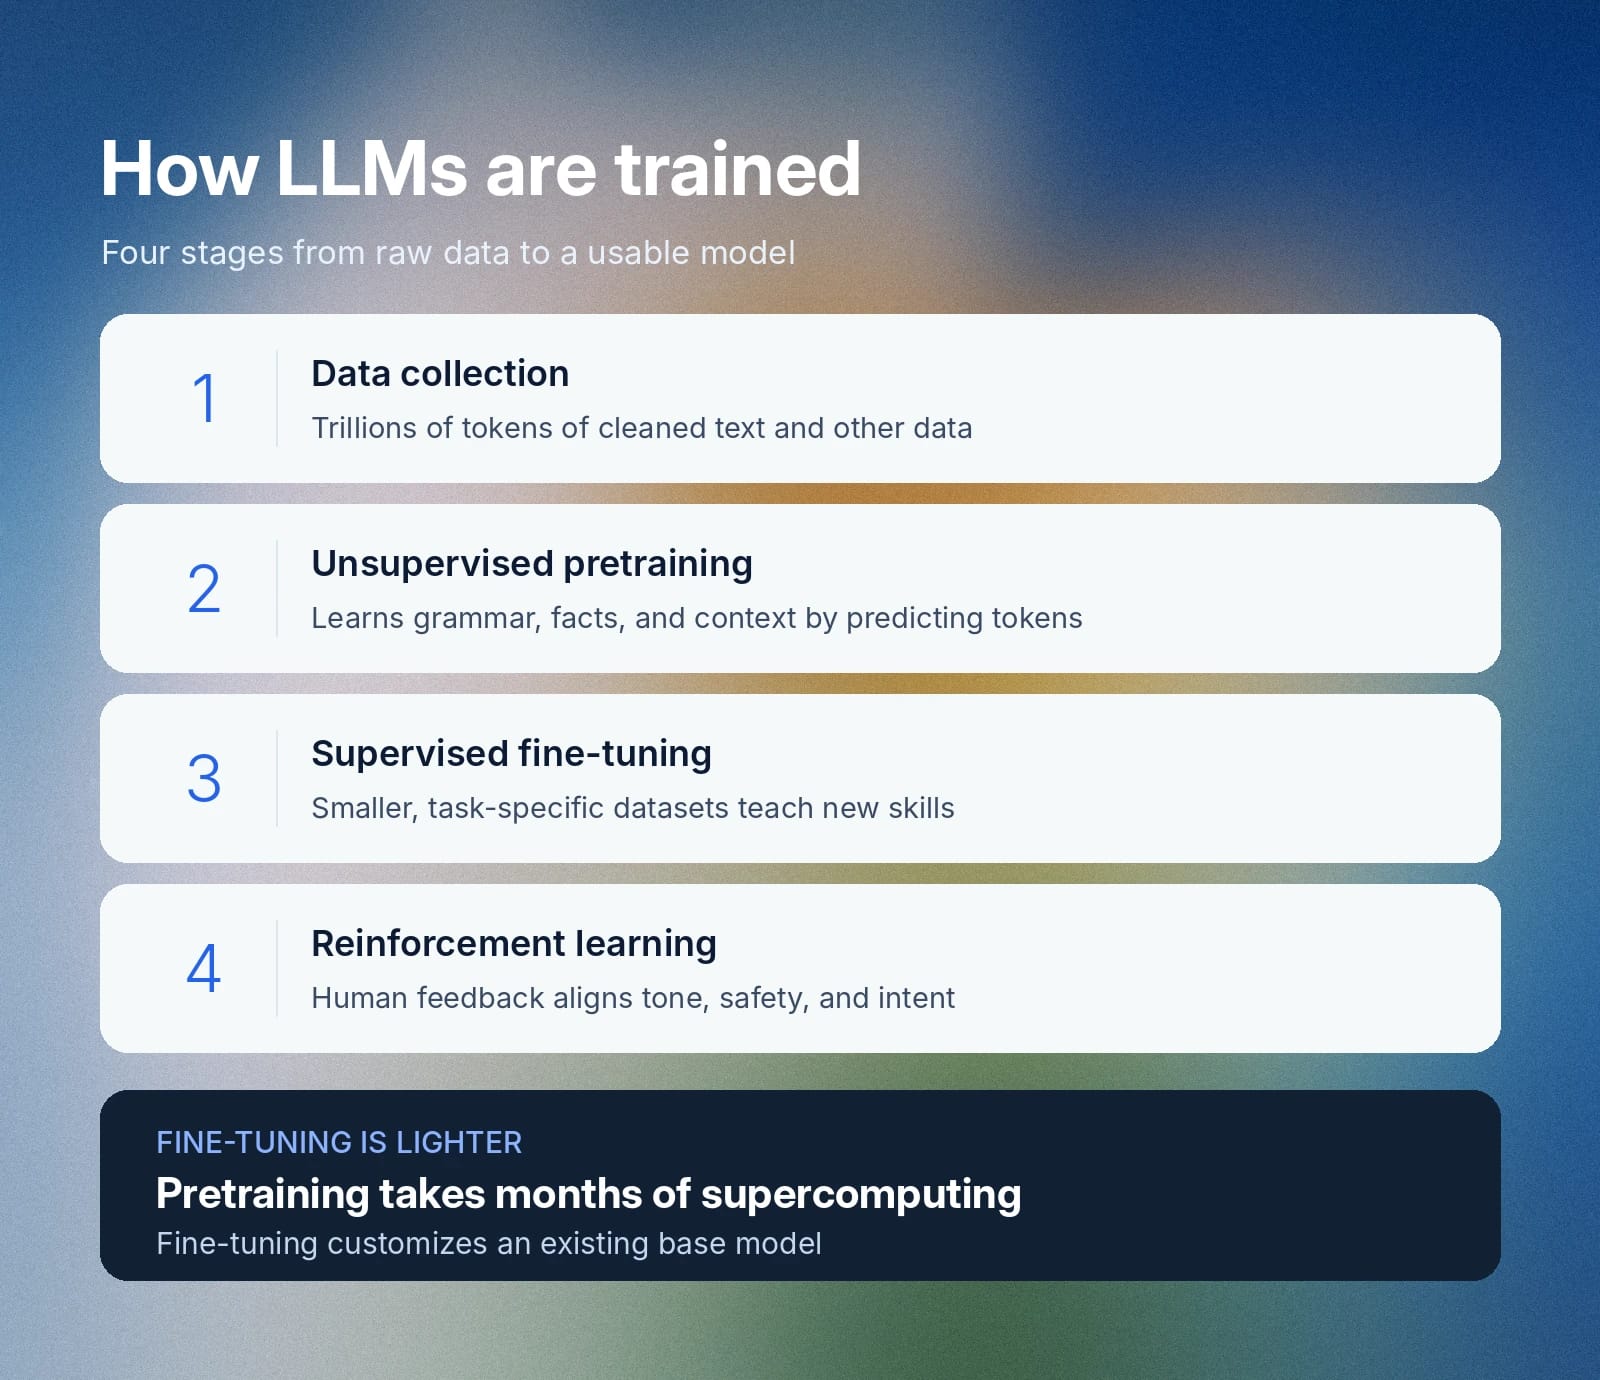
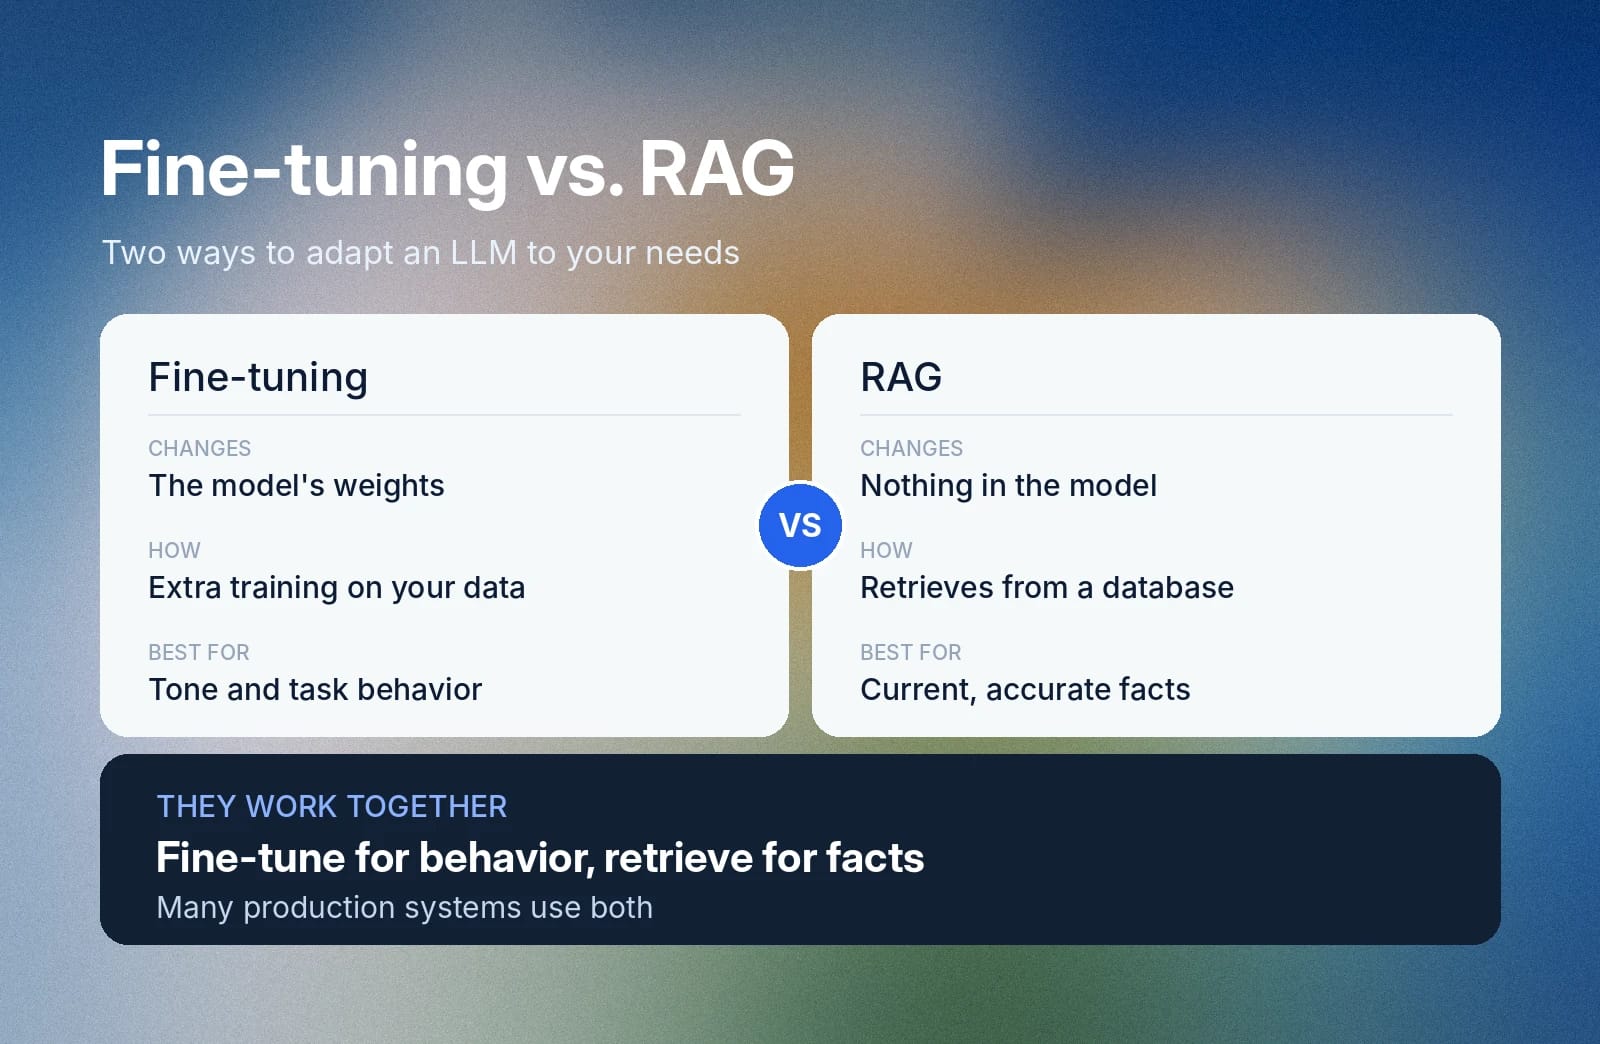
El entrenamiento de LLM requiere un proceso de varias etapas para transformar texto sin procesar y datos multimodales en sistemas de lenguaje funcionales. Las empresas necesitan capacidad avanzada de supercomputación funcionando durante varios meses, mientras que el fine-tuning es un proceso más ligero que personaliza el modelo base existente.
Las empresas de IA de frontera suelen tratar su proceso exacto de entrenamiento como información propietaria y la mayoría no revela el código fuente ni los pesos. Sin embargo, el entrenamiento suele seguir este proceso:
- Recopilación y preprocesamiento de datos: Desarrolladores crean conjuntos de datos a partir de varias fuentes, con corpus de preentrenamiento que incluyen billones de tokens extraídos de terabytes de texto depurado. La extracción o recopilación de texto de fuentes de internet es una de las principales formas en que las empresas crean estos conjuntos de datos.
- Preentrenamiento no supervisado: El modelo de lenguaje de gran tamaño lee billones de tokens para aprender reglas gramaticales, relaciones factuales y contexto lingüístico. Básicamente, se preentrena mediante modelado de lenguaje autorregresivo impulsado por mecanismos de autoatención que calculan el siguiente token estadísticamente probable de una secuencia.
- Fine-tuning supervisado: Ingenieros utilizan conjuntos de datos más pequeños y específicos para cada tarea con el fin de ajustar el modelo preentrenado. Este paso enseña al modelo competencias específicas, desde responder preguntas generales hasta generar logotipos o realizar investigación de laboratorio.
- Aprendizaje por refuerzo y alineación: Desarrolladores perfeccionan el comportamiento del modelo mediante comentarios de revisores humanos y modelos de recompensa. Esta etapa alinea las respuestas del modelo con las directrices de seguridad, los requisitos de tono y la intención humana.
Tipos de arquitecturas LLM: codificadores, decodificadores y modelos híbridos
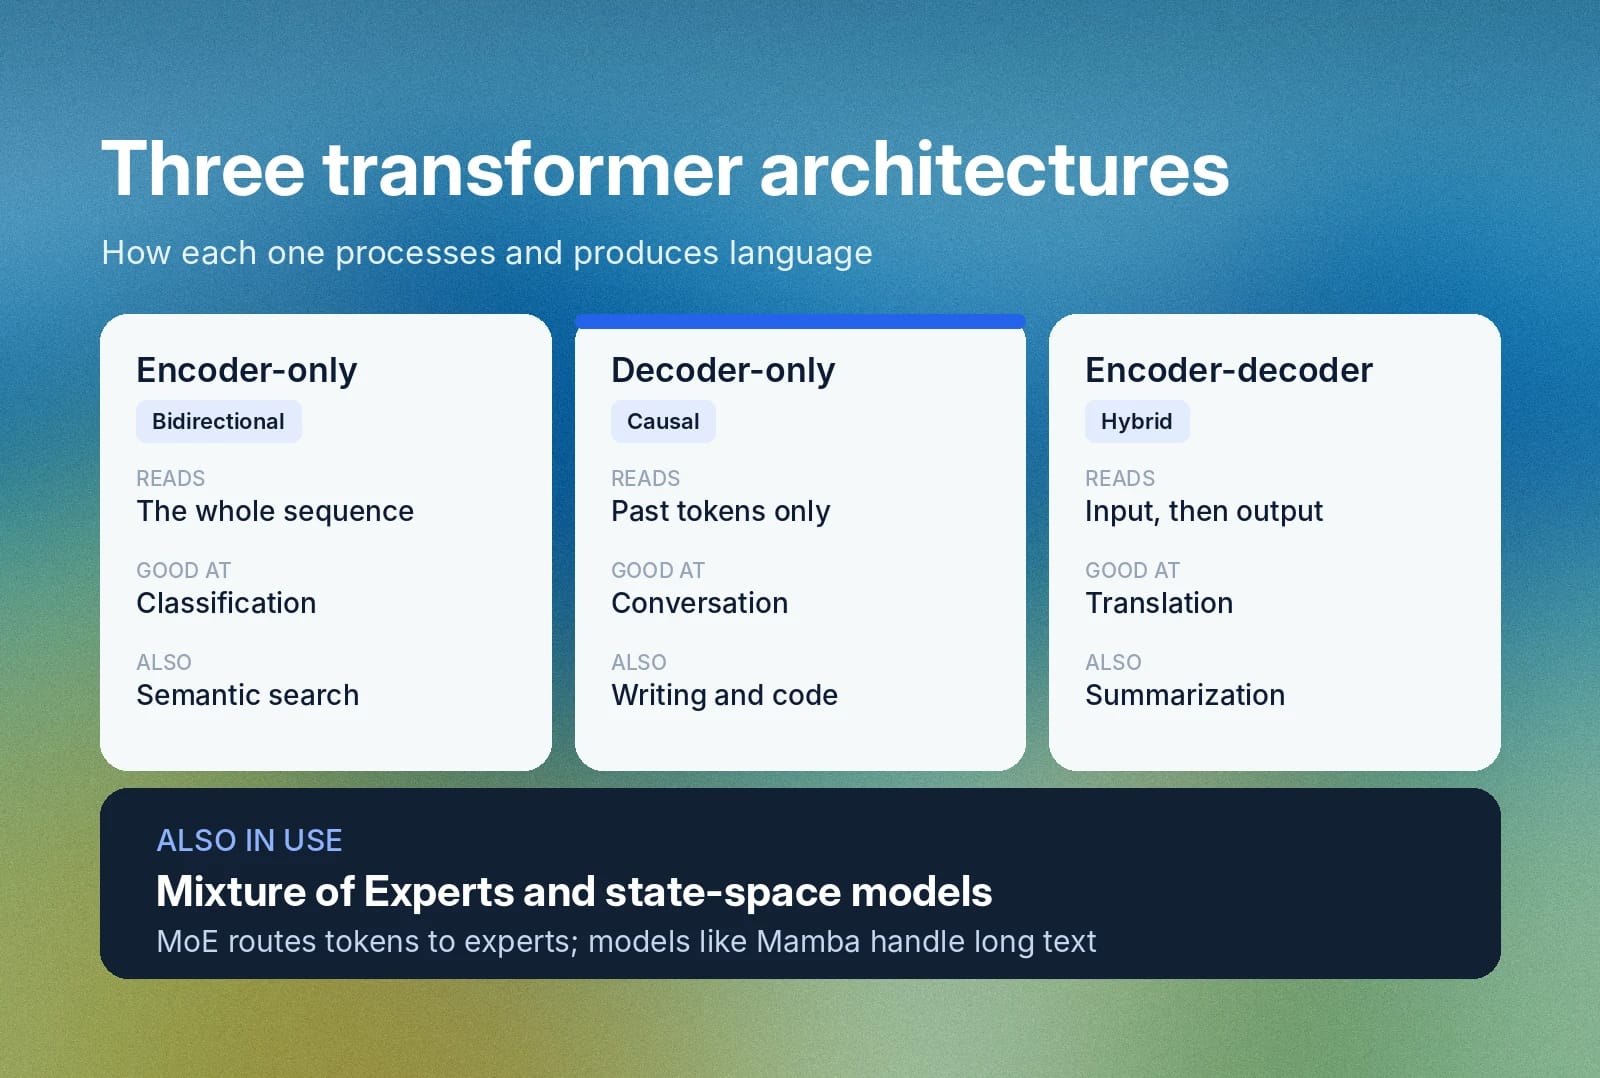
Las arquitecturas transformadoras organizan las capas de redes neuronales de distintas formas para procesar entradas y generar contenido. Los transformadores clásicos se dividen en tres categorías principales: modelos solo codificador, solo decodificador y codificador-decodificador, o híbridos. Sin embargo, los sistemas modernos también incorporan arquitecturas eficientes para escalar el rendimiento.
Modelos solo codificador
Las arquitecturas solo codificador procesan secuencias completas a la vez mediante autoatención bidireccional. Esto permite a la máquina ponderar la relación de cada token con otros tokens anteriores y posteriores. En la práctica, optimiza los modelos para tareas como:
- Clasificación de texto
- Análisis de sentimiento
- Recuperación de información
- Búsqueda semántica
Estas tareas también aparecen en los workflows de voz. El modelo de Scribe Voz a Texto de ElevenLabs transcribe voz en más de 90 idiomas y su función de detección de entidades identifica información confidencial y lenguaje ofensivo en las transcripciones.
Modelos solo decodificador
Las arquitecturas solo decodificador utilizan atención causal para procesar tokens y predecir cada palabra a partir de tokens anteriores. Estos modelos generan conversaciones fluidas y son la arquitectura principal de los chatbots conversacionales modernos, los asistentes de escritura abierta y las herramientas de generación de código.
En ElevenAgents, el LLM que eliges, que normalmente es un modelo solo decodificador, genera las respuestas del agente, mientras que un modelo propietario de toma de turnos gestiona los tiempos de la conversación.
Modelos codificador-decodificador (híbridos)
Los modelos codificador-decodificador utilizan un codificador para procesar la entrada y un decodificador para generar la salida. Este enfoque de estructura dual hace que los modelos híbridos sean más adecuados para tareas que requieren preservar estrictamente el contexto, como resumir documentos, traducir idiomas y reformatear datos.
La traducción es una tarea clásica de codificador-decodificador, y Doblaje IA de ElevenLabs es compatible con más de 90 idiomas.
Mezcla de expertos (MoE) y modelos de espacio de estados
En lugar de activar todos los parámetros de la red neuronal para cada palabra, la mezcla de expertos (MoE) dirige tokens individuales a equipos más pequeños de subredes «expertas» especializadas. Esto ofrece una profundidad de razonamiento comparable a la de modelos masivos, pero con mayor velocidad y menores costes de computación. Por su parte, los modelos de espacio de estados, como Mamba, procesan textos extremadamente largos de forma eficiente.
ElevenAgents incluye LLM de código abierto que ElevenLabs aloja en nuestra propia infraestructura.
Ejemplos de modelos de lenguaje de gran tamaño y aplicaciones cotidianas
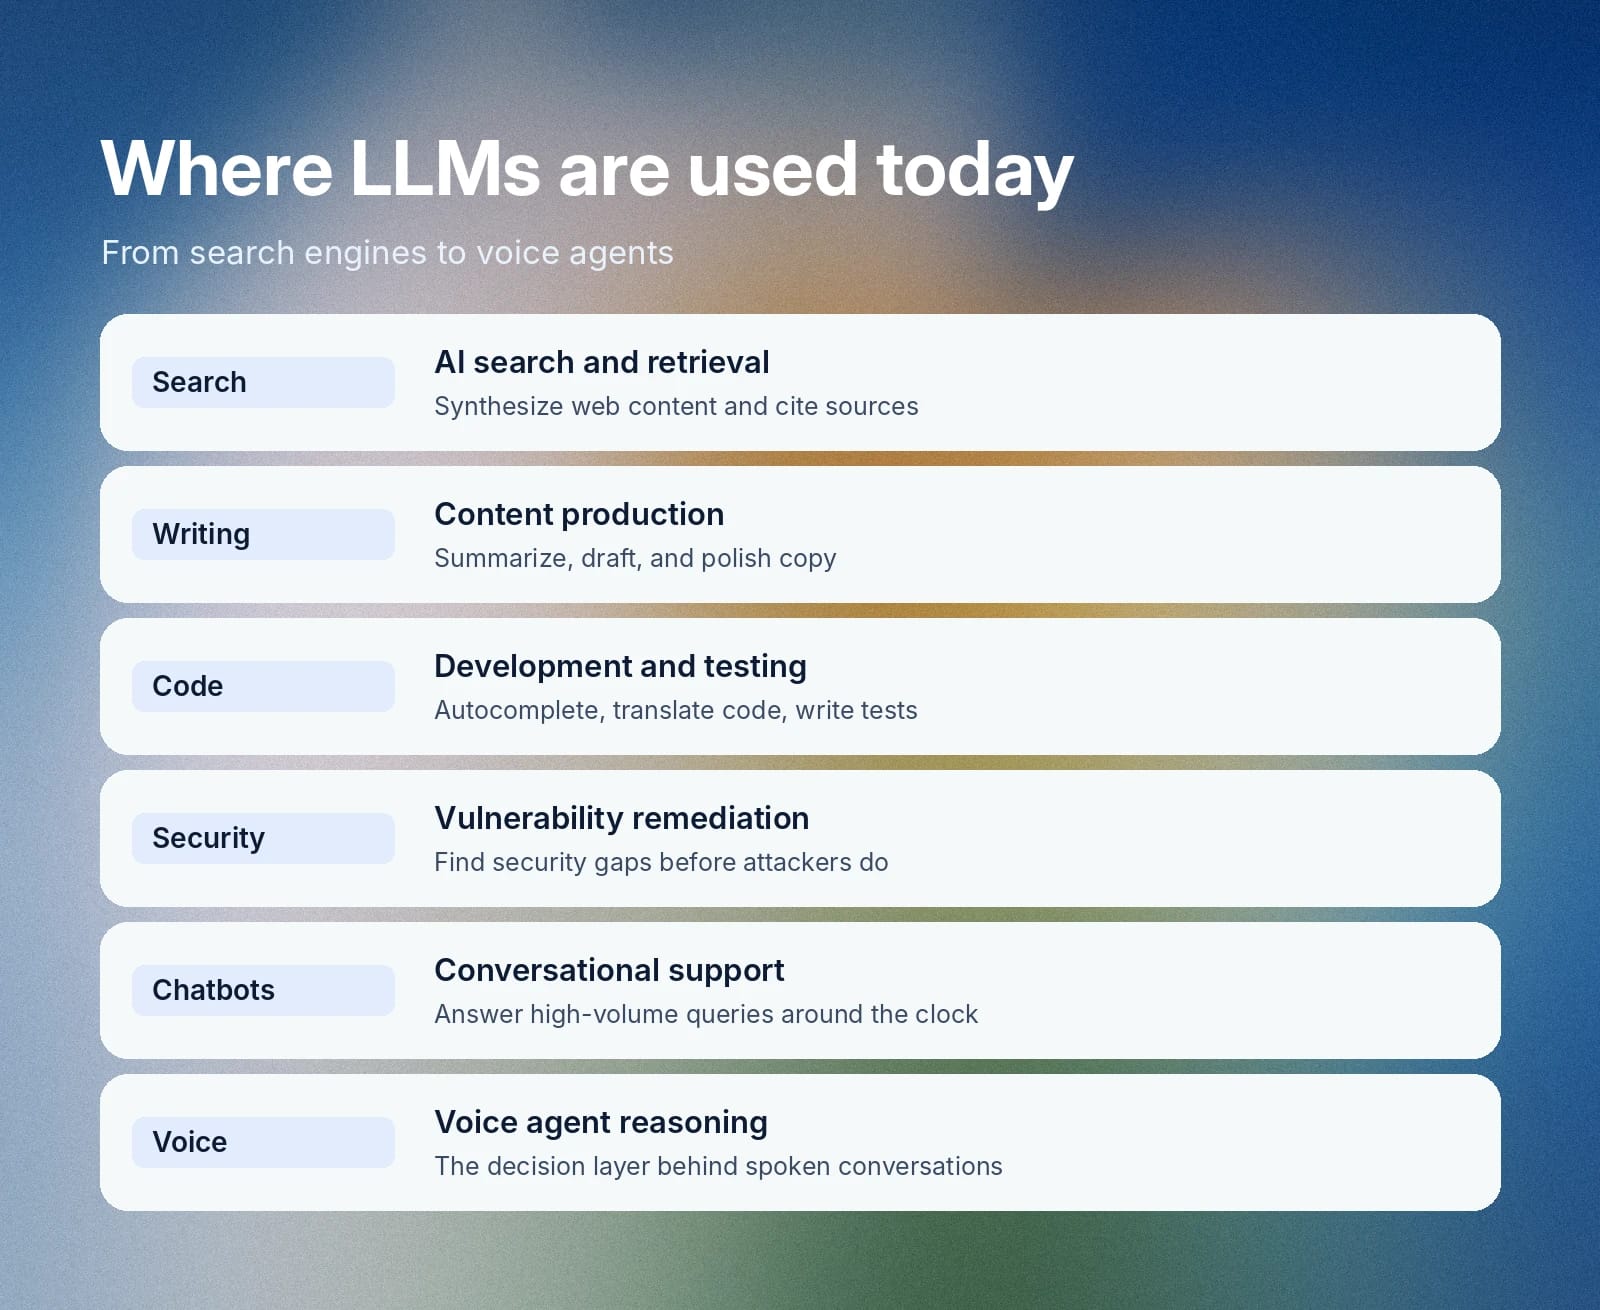
Las organizaciones han encontrado una amplia variedad de casos de uso para los modelos de lenguaje de gran tamaño. Estos casos de uso muestran cómo la IA ha pasado de ser investigación experimental a una función estándar en la web, las aplicaciones de software y los dispositivos cotidianos. Aunque especialistas en IA siguen estudiando y optimizando la arquitectura subyacente, los ejemplos de LLM en el mundo real muestran cómo los equipos los han implementado hasta ahora:
- Búsqueda con IA y recuperación de información: Los motores de búsqueda conversacionales como Bing, Resúmenes de IA de Google y Perplexity utilizan LLM para analizar contenido web en tiempo real. Los modelos sintetizan información, citan fuentes directamente y permiten a usuarios hacer preguntas de seguimiento.
- Redacción, edición y producción de contenido: Los LLM y otras herramientas impulsadas por IA facilitan la redacción y edición de materiales para uso interno y externo. Por ejemplo, NotebookLM resume informes extensos, Jasper AI redacta anuncios y Grammarly mejora los textos.
- Generación de código, desarrollo y pruebas: La IA impulsa herramientas de programación como GitHub Copilot para autocompletar funciones y traducir código de un lenguaje de programación a otro. Los equipos también pueden usarla para generar conjuntos de pruebas automatizadas e identificar y corregir errores fácilmente antes del despliegue.
- Ciberseguridad y corrección de vulnerabilidades: Las empresas de IA de frontera han lanzado modelos especializados para detectar brechas de seguridad, lo que ayuda a las organizaciones a aplicar correcciones antes de que atacantes puedan encontrarlas y aprovecharlas.
- Chatbots y asistentes conversacionales: Las organizaciones implementan interfaces conversacionales para ofrecer atención al cliente 24/7. Integrar plataformas como ElevenAgents permite a las empresas automatizar consultas de gran volumen mediante soluciones conversacionales en lugar de depender de las preguntas frecuentes.
- Motor de razonamiento para agentes de voz: Los LLM también actúan como capa central de razonamiento para sistemas de voz IA. ElevenAgents combina el LLM que elijas con Voz a Texto, Texto a Voz de baja latencia y un modelo propietario de toma de turnos para mantener conversaciones naturales en tiempo real.
¿Cuáles son las limitaciones de los modelos de lenguaje de gran tamaño?
Como base de la mayoría de los productos de IA con los que interactúan consumidores, los LLM son un potente componente arquitectónico que ayuda en numerosos workflows y casos de uso. Pero si quieres crear con LLM o entrenar tu propio modelo, debes conocer sus principales limitaciones:
- Alucinaciones: No hay garantía de que lo que genera un LLM sea preciso. Una respuesta puede contener fácilmente información inventada o simplemente incorrecta.
- Conocimiento estático: Sin RAG, un LLM se limita al conocimiento preestablecido que obtuvo durante el proceso de entrenamiento.
- Sesgos: Si tus datos de entrenamiento contienen sesgos, tu modelo los reflejará. Es especialmente importante tenerlo en cuenta si utilizas un LLM para clasificar datos o tomar decisiones sobre información, ya que ciertos sesgos implícitos en tus datos podrían acabar influyendo negativamente en los resultados sin que lo sepas.
- Ventana de contexto limitada: Los LLM suelen funcionar solo con una cantidad fija de texto, lo que significa que las conversaciones más largas pueden empezar a perder detalles y ser menos eficaces con el tiempo.
- Coste y latencia: Cuanto mayor es el LLM, más capacidad de computación se necesita para ejecutarlo. Si eliges modelos más potentes, probablemente pagarás más por ese servicio mejorado.
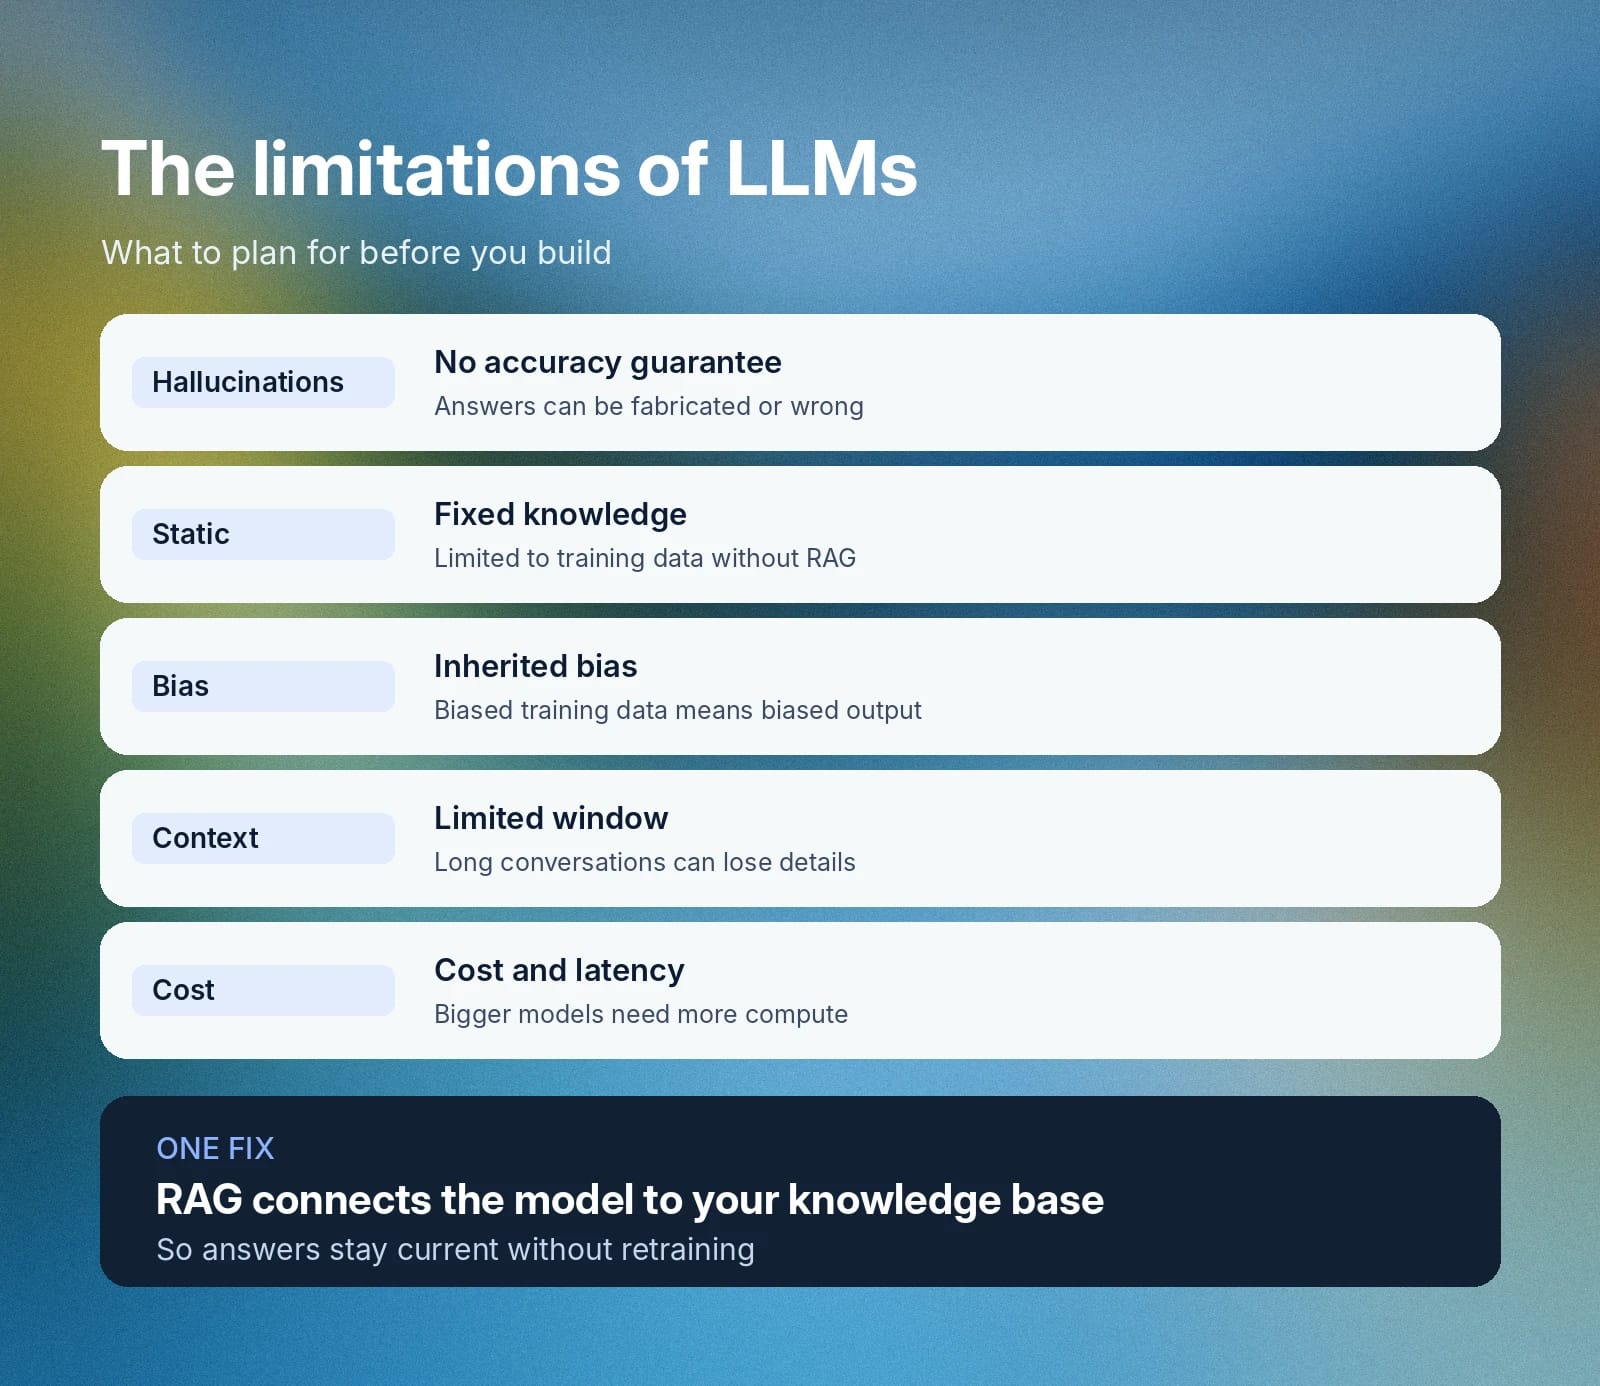
Hay varias estrategias que puedes considerar o implementaciones que puedes realizar para reducir el impacto de estas limitaciones. Por ejemplo, habilitar RAG en un LLM y conectarle una base de conocimiento en constante expansión resolvería el problema del conocimiento estático.
Crea experiencias LLM con voz con ElevenAgents
Elegir un modelo de lenguaje de gran tamaño para tu caso de uso es una decisión crítica que quizá debas ajustar a medida que cambian las necesidades de tu empresa e incluso los requisitos normativos. Evitar la dependencia de un proveedor mantiene la agilidad y flexibilidad de tu empresa al crear soluciones de IA de voz conversacional.
ElevenAgents te permite elegir entre LLM compatibles de proveedores como OpenAI, Anthropic y Google, o conectar tu propio modelo personalizado mediante una ruta de API compatible con OpenAI. Así podrás elegir fácilmente el equilibrio óptimo entre velocidad, capacidad de razonamiento y coste para tus necesidades específicas.
Explora ElevenAgents para descubrir cómo los LLM alojados simplifican los workflows de voz o contacta con ventas para empezar a crear hoy tus agentes de voz de baja latencia.
Preguntas frecuentes sobre los LLM

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


