
¿Qué es RAG? Cómo funciona la generación aumentada por recuperación
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Los modelos de IA generan respuestas basándose en lo que aprendieron durante el entrenamiento, lo que significa que no conocen automáticamente las políticas, los productos ni otra información de una empresa creada después de ese entrenamiento. RAG (generación aumentada por recuperación) resuelve esto recuperando información externa relevante y proporcionándosela al modelo antes de que responda.
RAG basa las respuestas que ofrece una IA en los documentos reales de una empresa. Un agente de atención al cliente que utiliza RAG puede consultar la política de devoluciones o las especificaciones del producto vigentes antes de responder, lo que reduce el riesgo de alucinaciones.
Esta guía explica qué significa RAG en IA, cómo funcionan conjuntamente la recuperación y la generación, y en qué se diferencia RAG de un LLM por sí solo. También veremos las limitaciones de RAG, dónde funciona bien en aplicaciones de IA generativa y cómo RAG facilita la recuperación de conocimiento en agentes de IA.
Resumen
- RAG combina un sistema de recuperación con un modelo generativo para que el modelo pueda utilizar información más allá de sus datos de entrenamiento.
- El conocimiento que recupera RAG se encuentra fuera del modelo, por lo que puede actualizarse sin volver a entrenar nada.
- ElevenAgents utiliza RAG automáticamente cuando una base de conocimiento es demasiado grande para caber directamente en el contexto del modelo, de modo que las respuestas siguen siendo rápidas sin sacrificar la precisión en bases de conocimiento grandes y complejas.
¿Qué es RAG en IA?
RAG es una arquitectura de sistema construida alrededor de un LLM para proporcionarle información externa, como directrices de marca, manuales de producto, artículos de una base de conocimiento o bases de datos internas. Esto permite que la IA trabaje con información específica de la empresa, de modo que sus respuestas pueden reflejar políticas actuales, conocimiento privado y detalles de la empresa para los que el modelo nunca fue entrenado.
Además, un LLM solo puede considerar una cantidad limitada de información a la vez, conocida como su ventana de contexto. Una base de conocimiento organizacional grande puede superar rápidamente ese límite, por lo que RAG mantiene la información fuera del LLM y recupera solo los fragmentos necesarios para la pregunta actual.
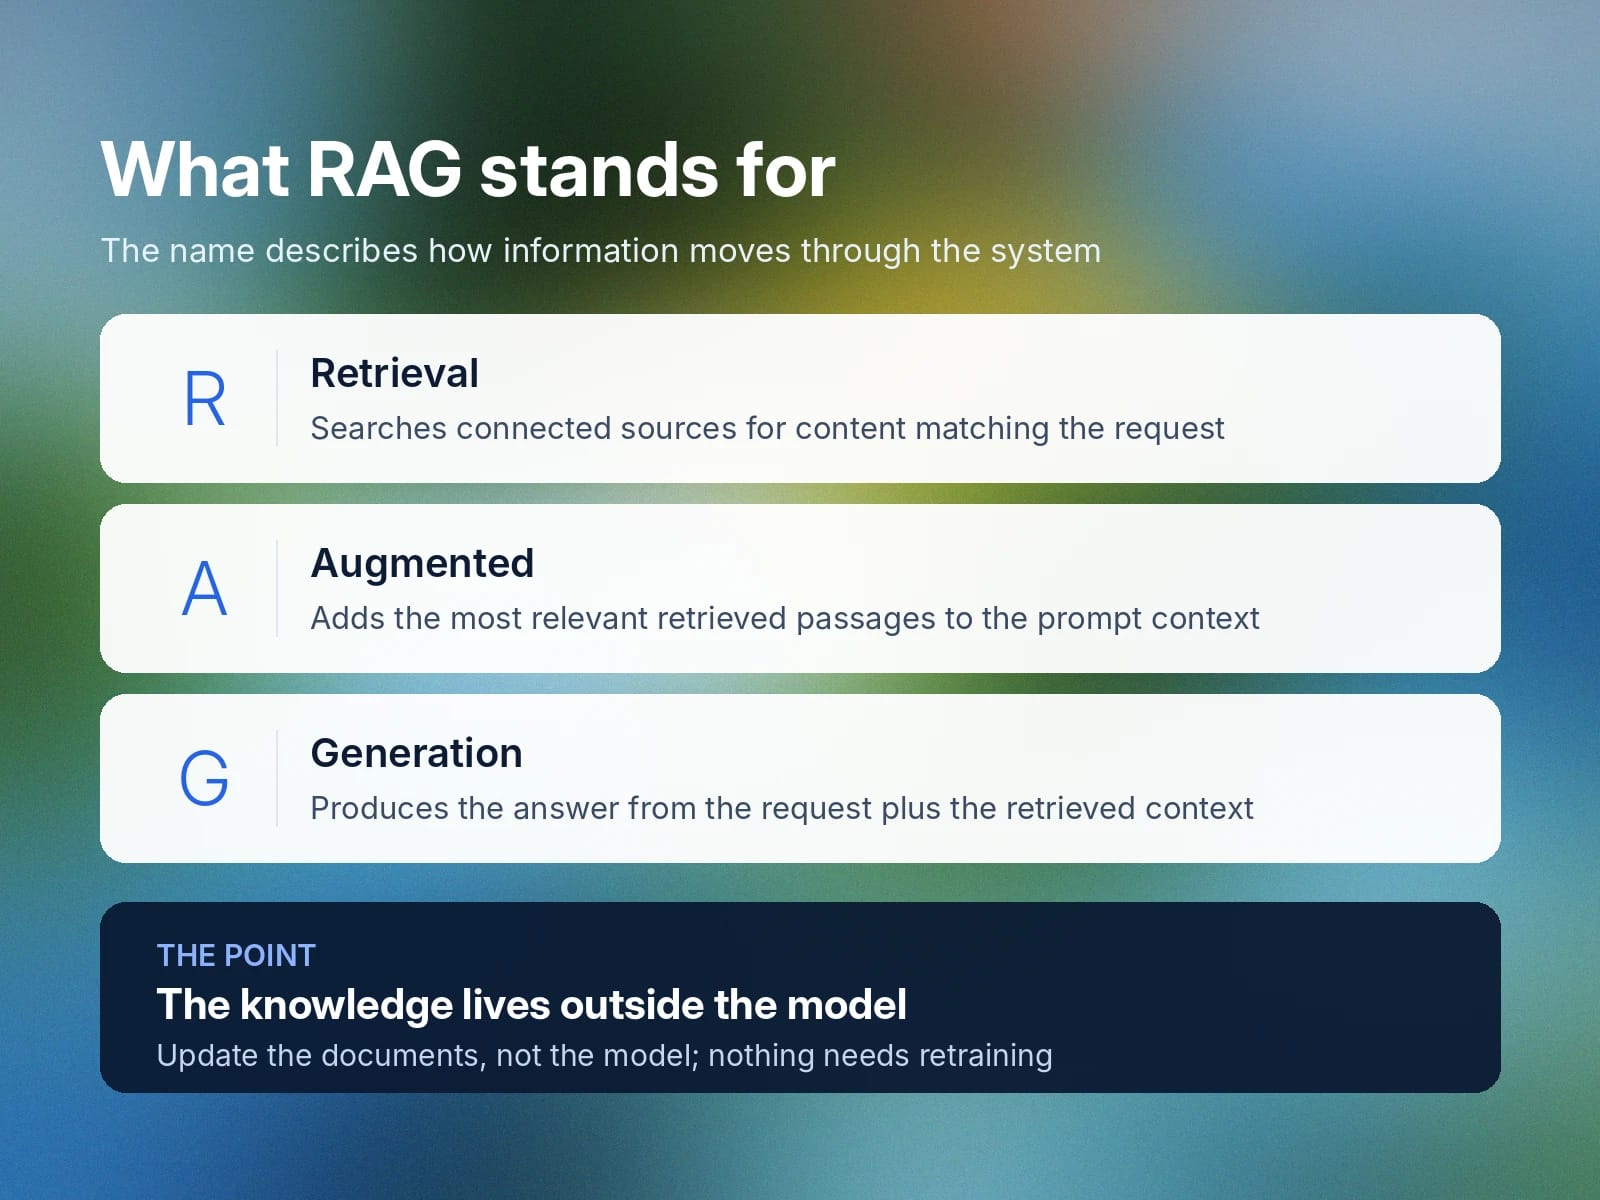
El nombre describe cómo fluye la información por el sistema:
- Recuperación: Busca en fuentes conectadas, como documentos de políticas, registros del servicio de asistencia o archivos de inventario, contenido que coincida con la solicitud del usuario.
- Aumento: Añade los fragmentos recuperados más relevantes al contexto del prompt.
- Generación: Utiliza la solicitud del usuario y el contexto recuperado para elaborar la respuesta.
RAG también facilita el grounding, la práctica de vincular una respuesta de IA a información específica de las fuentes, al proporcionar al LLM material relevante que puede usar para generar una respuesta. Por ejemplo, si un cliente pregunta por una política de garantía, el sistema RAG recupera las condiciones pertinentes de la documentación de la empresa y se las proporciona al LLM para que responda basándose en ellas.
¿Cómo funciona la generación aumentada por recuperación?
Un sistema RAG prepara conocimiento externo para su búsqueda, recupera la información más relevante para la pregunta de un usuario y se la proporciona al LLM como contexto antes de generar una respuesta.
Las implementaciones de RAG varían en complejidad. RAG básico utiliza un proceso directo de recuperar y generar, mientras que los enfoques más avanzados pueden añadir reescritura de consultas, filtrado, reclasificación u otras técnicas de recuperación.
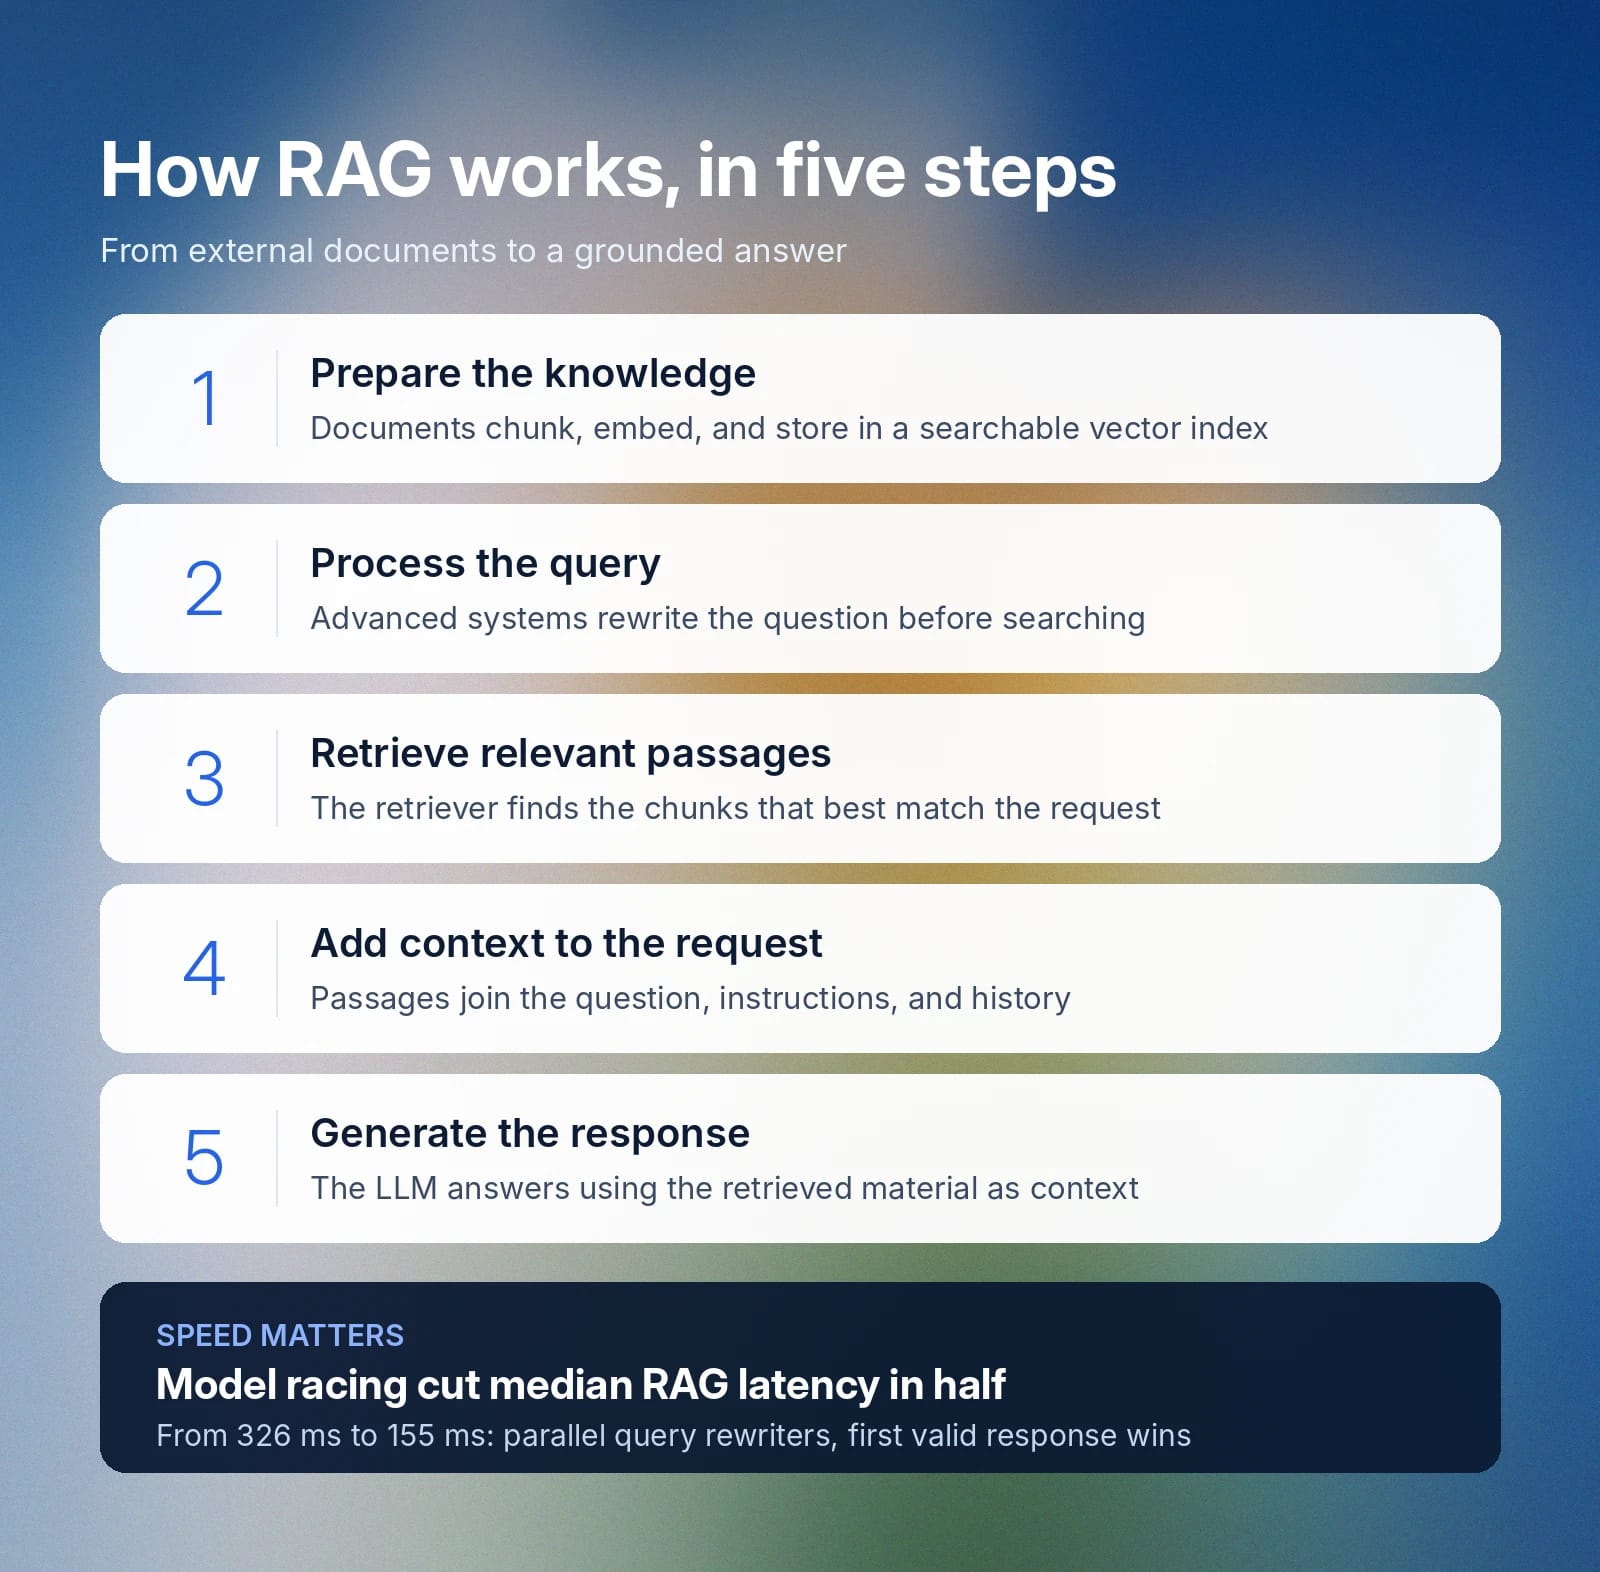
El proceso RAG suele seguir cinco pasos:
- Preparar el conocimiento: Los documentos se dividen en fragmentos más pequeños (un proceso denominado «chunking»), se convierten en representaciones matemáticas llamadas embeddings y se almacenan en un índice consultable o una base de datos vectorial.
- Procesar la consulta: El sistema interpreta la pregunta del usuario y, en sistemas RAG más avanzados, la reescribe o perfecciona antes de buscar.
- Recuperar los fragmentos relevantes: El recuperador busca en la base de conocimiento indexada los fragmentos de texto que mejor coinciden con la solicitud.
- Añadir contexto a la solicitud del modelo: Los fragmentos seleccionados se envían al LLM junto con la pregunta del usuario, las instrucciones relevantes y el historial de la conversación.
- Generar la respuesta: El LLM genera una respuesta utilizando el material recuperado como parte de su contexto.
Muchos sistemas RAG activan la recuperación de forma selectiva como una herramienta externa. ElevenAgents permite a los equipos activar RAG para una base de conocimiento directamente en los ajustes del agente, y el sistema utiliza la reescritura de consultas para transformar diálogos previos y referencias imprecisas en una consulta de búsqueda precisa y autosuficiente durante los seguimientos conversacionales.
Para garantizar respuestas rápidas, ElevenLabs también desarrolló una arquitectura de competición de modelos que envía cada consulta a varios modelos de reescritura en paralelo y utiliza la primera respuesta válida. Este enfoque redujo a la mitad la latencia media de RAG, de 326 ms a 155 ms, manteniendo la recuperación lo suficientemente rápida como para preservar un flujo conversacional natural incluso cuando la activa una base de conocimiento grande.
¿Cuál es la diferencia entre los LLM y los modelos RAG?
Un LLM es un modelo que comprende y genera lenguaje. RAG es una arquitectura alrededor del LLM que recupera información externa cuando la aplicación la necesita.
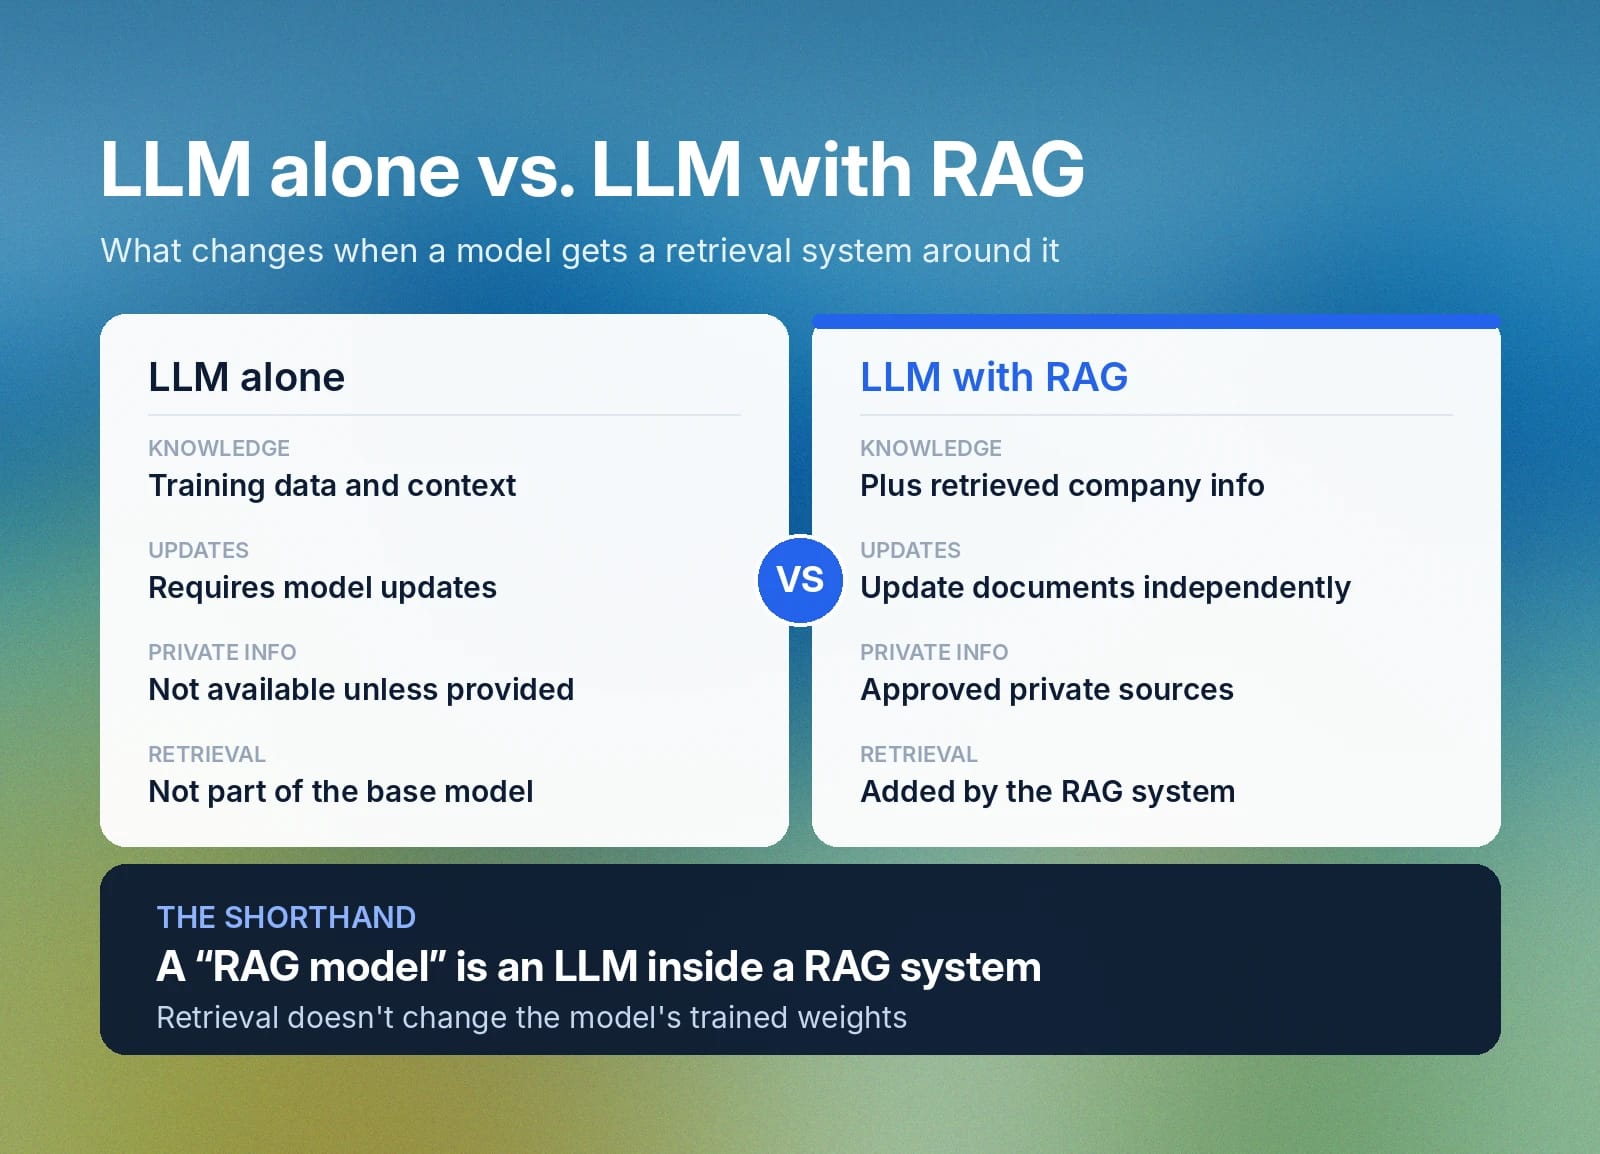
Esto es lo que cambia cuando se combina un LLM con RAG:
Característica | LLM por sí solo | LLM utilizado con RAG |
Conocimiento | Datos de entrenamiento y contexto actual | Datos de entrenamiento, contexto actual e información recuperada de la empresa, como políticas, documentación de producto o contenido de la base de conocimiento |
Actualizaciones | La información nueva debe proporcionarse en el contexto o mediante actualizaciones del modelo | El conocimiento externo puede actualizarse por separado del modelo |
Información privada | No está disponible salvo que se proporcione | Puede recuperar información de fuentes privadas aprobadas |
Recuperación | No forma parte del modelo base | La añade el sistema RAG que lo rodea |
«Modelo RAG» se utiliza a veces como abreviatura para referirse a un LLM usado dentro de un sistema RAG. Por ejemplo, una empresa podría decir que utiliza un «modelo RAG» para atención al cliente cuando la configuración real es un LLM que recupera contenido relevante del centro de ayuda o de políticas antes de generar una respuesta.
Limitaciones de los modelos RAG en aplicaciones reales
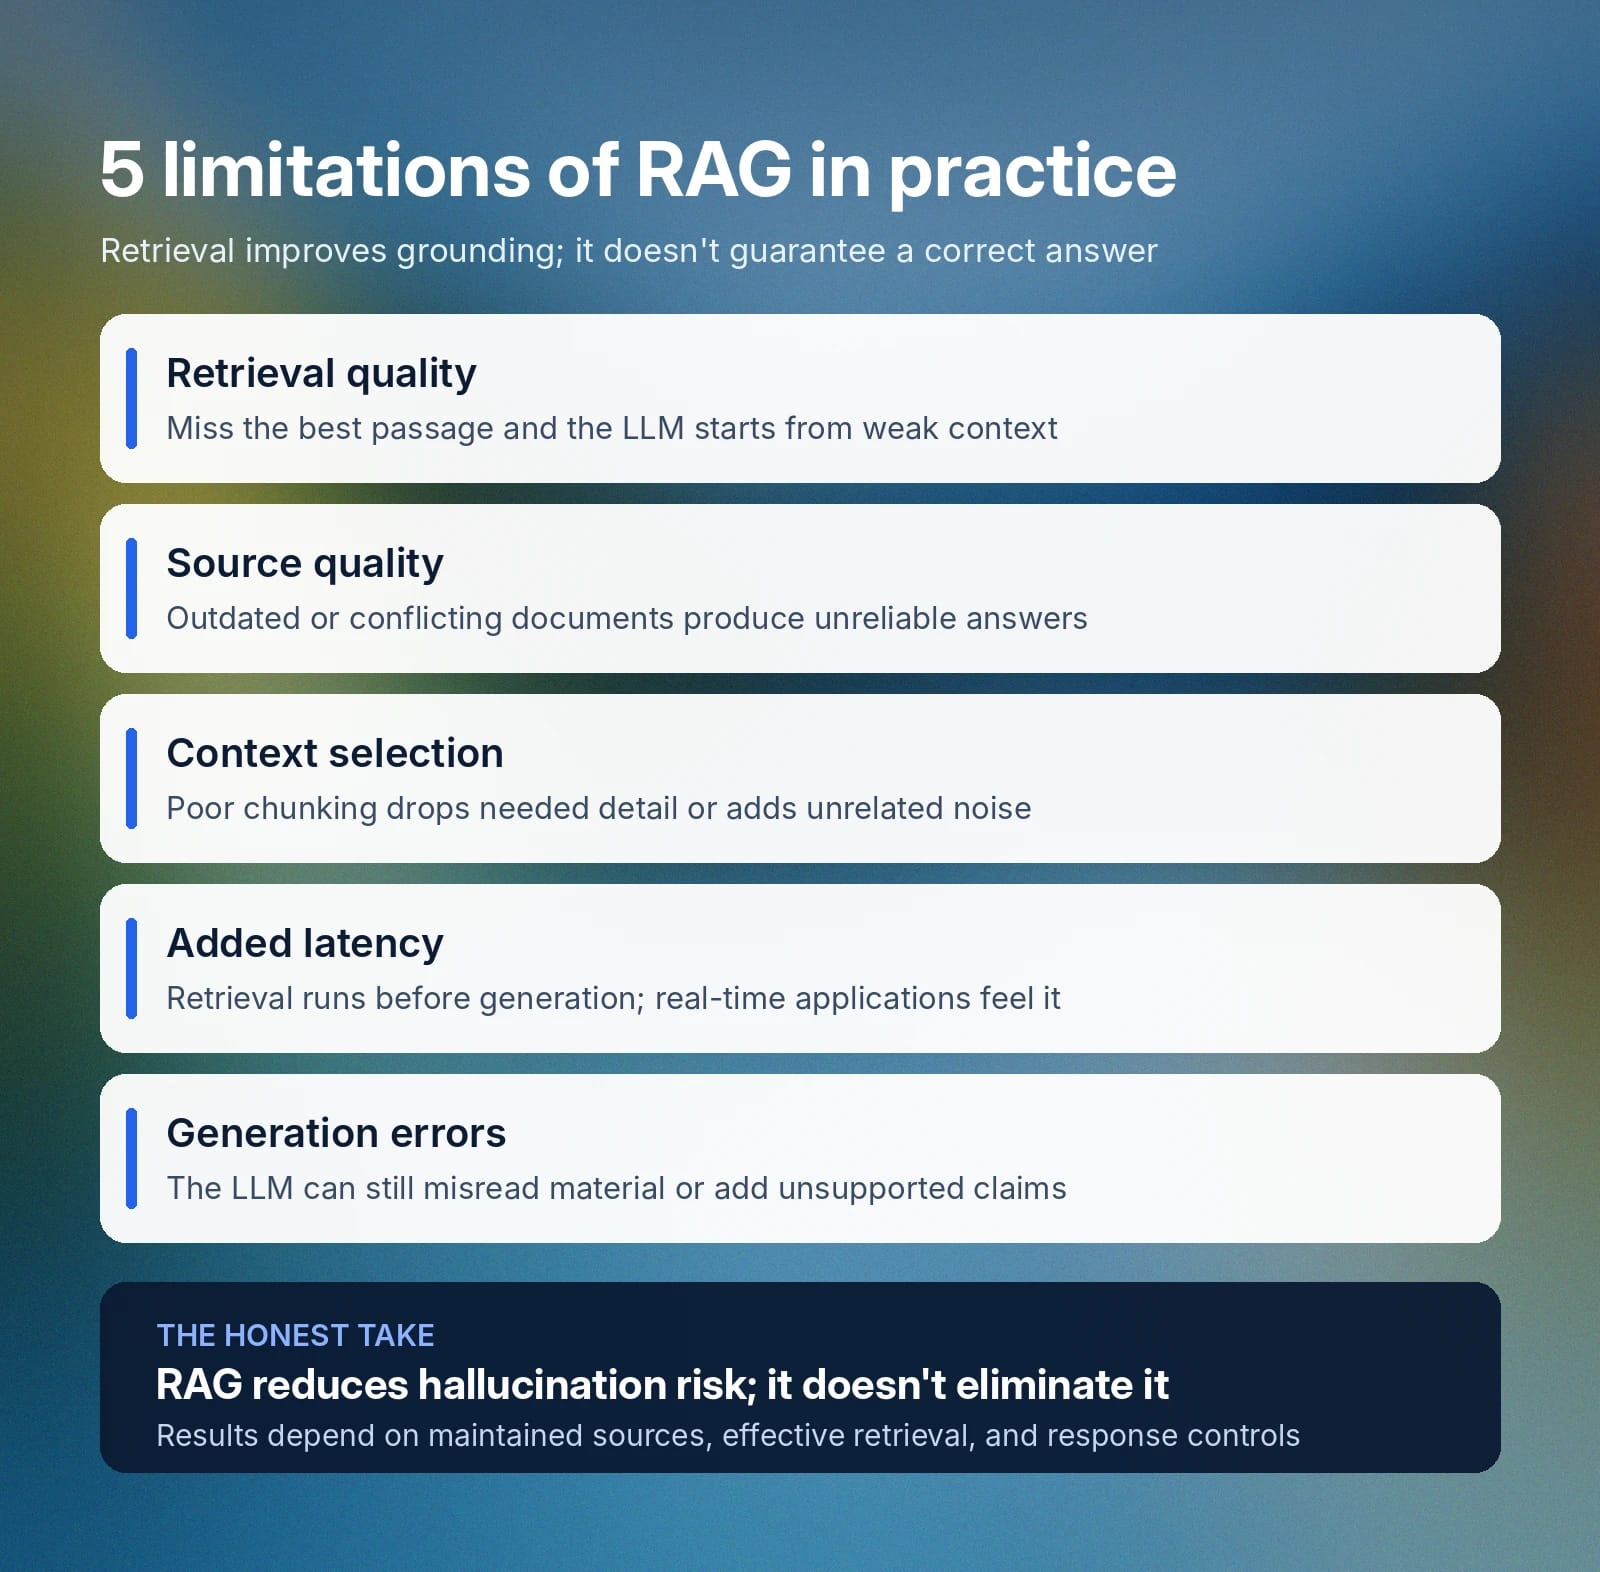
RAG mejora el acceso a conocimiento empresarial relevante almacenado fuera del LLM, pero la recuperación introduce sus propias limitaciones y no garantiza una respuesta correcta. Las principales limitaciones aparecen en lo que el sistema recupera, lo que envía al modelo y cómo responde el modelo:
- Calidad de la recuperación: Si el sistema no encuentra el fragmento más relevante, el LLM parte de un contexto incompleto o poco sólido. Consultas mal formuladas, coincidencias semánticas débiles o redacción ambigua pueden desviar la recuperación.
- Calidad de las fuentes: Los documentos desactualizados, contradictorios o incompletos pueden dar lugar a respuestas poco fiables.
- Selección del contexto: Un chunking deficiente o malas decisiones de recuperación pueden eliminar detalles necesarios o introducir información no relacionada.
- Latencia añadida: La recuperación y el procesamiento de consultas se producen antes de la generación, lo que puede ralentizar las respuestas en aplicaciones en tiempo real.
- Errores de generación: El LLM aún puede interpretar mal la información recuperada o introducir afirmaciones sin respaldo.
Aunque RAG puede reducir el riesgo de alucinaciones, no lo elimina por completo. Los resultados precisos siguen dependiendo de fuentes bien mantenidas, una recuperación eficaz y controles sobre la respuesta final.
RAG en IA generativa: casos de uso prácticos y ventajas
RAG resulta especialmente útil cuando una aplicación de IA necesita información que cambia con frecuencia, pertenece a la organización o es demasiado extensa para incluirla en cada solicitud al modelo.
Estos son los ámbitos en los que RAG marca más la diferencia:
Mantenerse al día con información que se actualiza con frecuencia
RAG ayuda a los equipos a mantener las respuestas de IA alineadas con los detalles actuales de los productos, los precios, las políticas y el inventario. Los equipos pueden actualizar la información de origen de forma independiente, y RAG recupera la versión relevante cuando se hace una pregunta. Por ejemplo, un agente de cualificación de leads puede consultar los últimos precios o detalles de los planes al cualificar una llamada entrante.
Utilizar conocimiento privado o especializado
Algunos conocimientos son privados o especializados en lugar de públicos, como las políticas internas, la documentación técnica o el contenido de soporte destinado a un equipo específico. RAG permite a un agente recuperar información directamente de estas fuentes, en lugar de depender solo de lo que está disponible públicamente o integrado en el modelo.
Por ejemplo, un agente interno de soporte de TI o RR. HH. puede recuperar información de una base de conocimiento específica de RR. HH. para responder a preguntas sobre prestaciones de empleados, en lugar de buscar en documentación pública que no tendría esa información.
Buscar en bases de conocimiento grandes
RAG ayuda cuando una empresa tiene mucha más documentación de la que un LLM puede considerar en una sola solicitud. Recupera solo los fragmentos relevantes para la pregunta actual en lugar de enviar toda la colección al modelo. En un contexto de ventas, un asistente técnico puede buscar en manuales de producto para encontrar requisitos relevantes durante una llamada.
Empieza con ElevenAgents para acceder a soluciones RAG avanzadas
ElevenAgents permite a los equipos crear agentes de voz IA y chat que utilizan RAG con fuentes de conocimiento conectadas, ya sea mediante la plataforma web sin código o la API para equipos que quieran integrar agentes directamente en sus propios productos.
Para los agentes con RAG activado, los equipos pueden añadir documentos, URL o texto a una base de conocimiento y recuperar solo la información relevante para cada consulta.
ElevenLabs también ha optimizado la recuperación para conversaciones en tiempo real, reduciendo la latencia media de RAG de 326 ms a 155 ms en su arquitectura de ElevenAgents. Los equipos que crean con ElevenAgents obtienen estas capacidades de recuperación listas para usar, tanto si configuran un agente desde el panel como si desarrollan sobre él mediante la API.
Empieza a crear con ElevenAgents o contacta con nuestro equipo para hablar sobre la configuración adecuada para tu aplicación.


