
¿Qué es una ventana de contexto? Lo que todo usuario de un LLM debería saber
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Una ventana de contexto es la cantidad de información que un modelo de lenguaje de gran tamaño (LLM) puede procesar en una sola solicitud. Se mide en tokens y puede incluir tu prompt, el historial de la conversación, instrucciones del sistema, documentos recuperados, resultados de herramientas y la respuesta generada por el modelo.
Una ventana de contexto más amplia permite que un modelo trabaje con más información en una sola solicitud. Por ejemplo, un agente de programación que investiga un error podría trabajar a la vez con los archivos de código fuente pertinentes, la documentación, los resultados de pruebas y los cambios recientes en el código, en lugar de analizar cada elemento por separado y perder contexto útil entre solicitudes.
Sin embargo, una ventana de contexto más amplia no equivale a una memoria perfecta. Los prompts más largos requieren más capacidad de cálculo, consumen más tokens y pueden dificultar que un modelo identifique qué detalles importan realmente. Las investigaciones sobre modelos de contexto largo, incluido el estudio Lost in the Middle y el benchmark RULER de NVIDIA, han constatado repetidamente que los modelos aprovechan menos la información disponible a medida que crece el contexto, especialmente cuando la información relevante queda oculta entre material menos útil.
En este artículo explicamos cómo funcionan las ventanas de contexto, cómo se miden, qué ocurre cuando se llenan y cómo desarrolladores pueden gestionarlas eficazmente.
Resumen
- Una ventana de contexto es el presupuesto total de tokens que un LLM utiliza para una sola solicitud. Abarca el prompt del usuario, el historial de la conversación, el contenido recuperado y la respuesta generada.
- Las ventanas de contexto más amplias permiten manejar documentos, bases de código y conversaciones más largos, pero no garantizan que el modelo aproveche bien todas sus partes.
- Los modelos recuperan información con menor fiabilidad de la parte central de los prompts largos, un patrón documentado en el estudio Lost in the Middle y el benchmark RULER.
- Una gestión eficaz del contexto (recuperación, resumen y caché) suele ser mejor que limitarse a maximizar la cantidad de tokens enviados.
- La mejor estrategia de contexto es la que se adapta a tu carga de trabajo real, no la que utiliza la ventana de contexto anunciada más grande.
¿Qué es una ventana de contexto en un modelo de IA?
Una ventana de contexto es el espacio de trabajo activo de un modelo, donde se reúne todo lo relevante para la solicitud actual antes de que el modelo genere una respuesta.
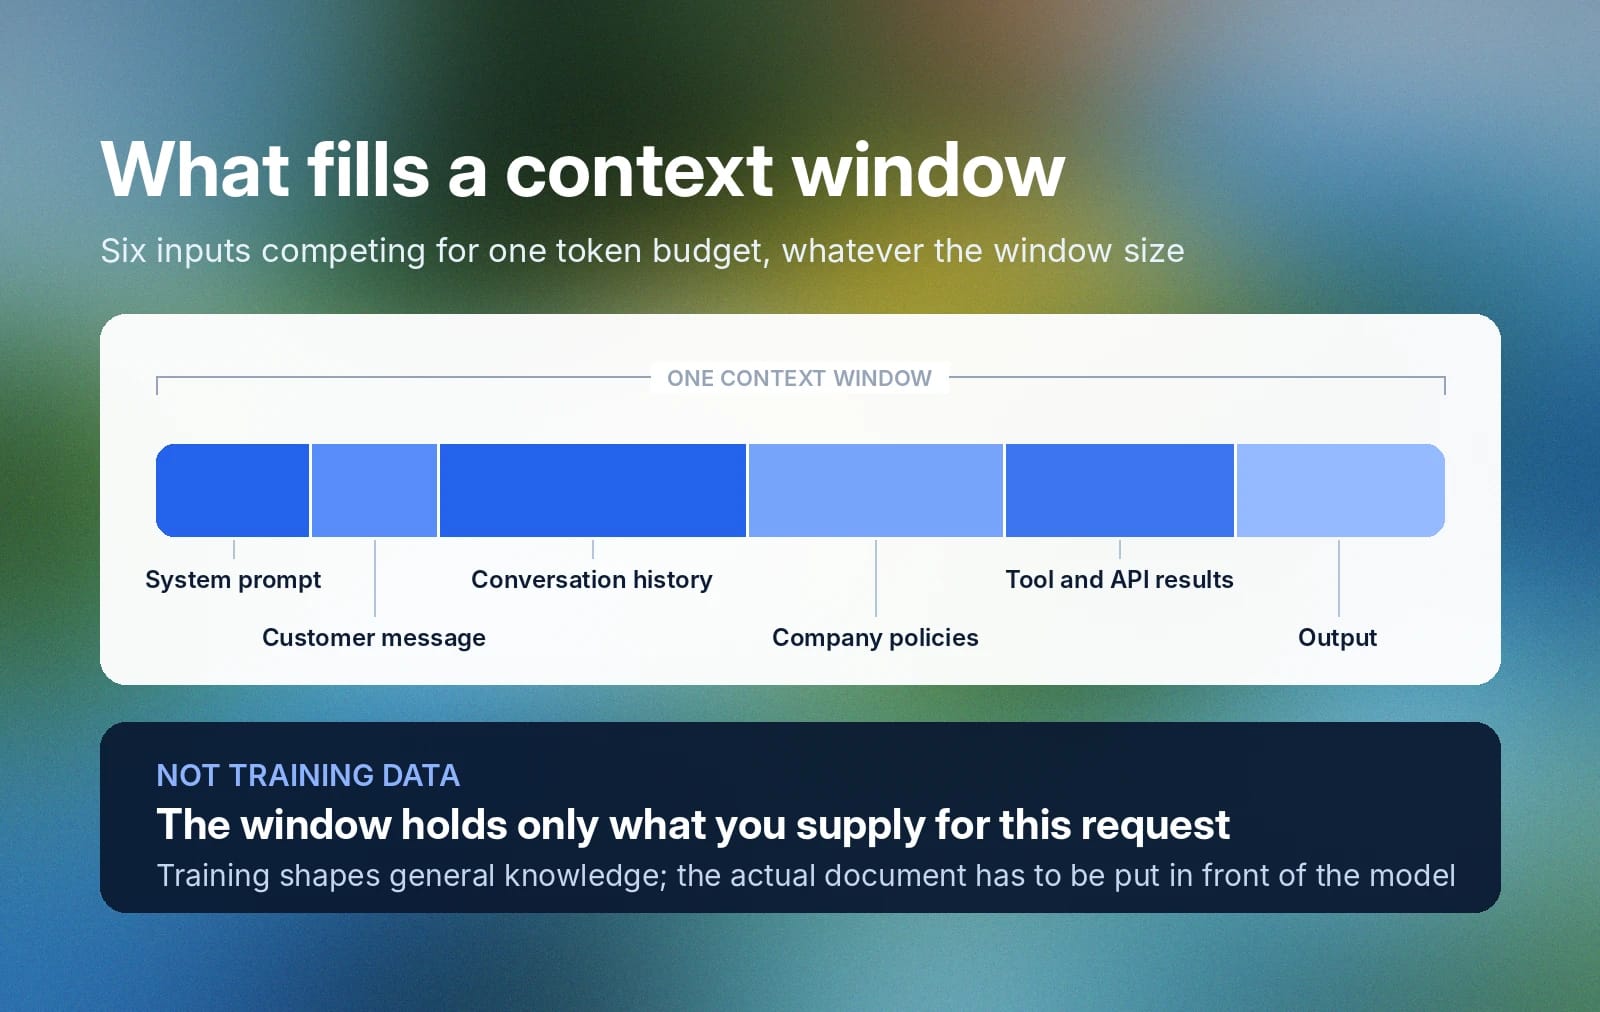
Imagina un agente de IA que resume una conversación de atención al cliente y recomienda una solución. Para hacerlo bien, el modelo debe procesar:
- El prompt del sistema
- El mensaje del cliente
- El historial de la conversación
- Las políticas de la empresa
- Los resultados de herramientas y API
- La respuesta generada
Todo ello compite por espacio dentro de la misma ventana de contexto, independientemente de lo grande que sea.
Las ventanas de contexto no incluyen datos de entrenamiento. El entrenamiento incorpora información de forma permanente a los parámetros de un modelo, lo que determina lo que «sabe» en términos generales. En cambio, una ventana de contexto solo contiene la información proporcionada para la tarea actual.
Esta distinción importa en la práctica: si una aplicación necesita que un modelo razone sobre una política concreta, el registro de un cliente o un documento técnico, esa información no está disponible solo porque el modelo se haya entrenado con material similar. Por lo general, debe entrar directamente en el contexto de trabajo del modelo a través del prompt o de un sistema de recuperación o herramientas; de lo contrario, el modelo razonará a partir de conocimiento general en vez de basarse en el documento real que tiene delante.
Tokenización y ventanas de contexto: cómo se procesan los datos
Antes de que un LLM procese texto, un tokenizador lo divide en unidades más pequeñas llamadas tokens. Un token puede representar una palabra completa, parte de una palabra, un signo de puntuación u otro fragmento breve de texto.
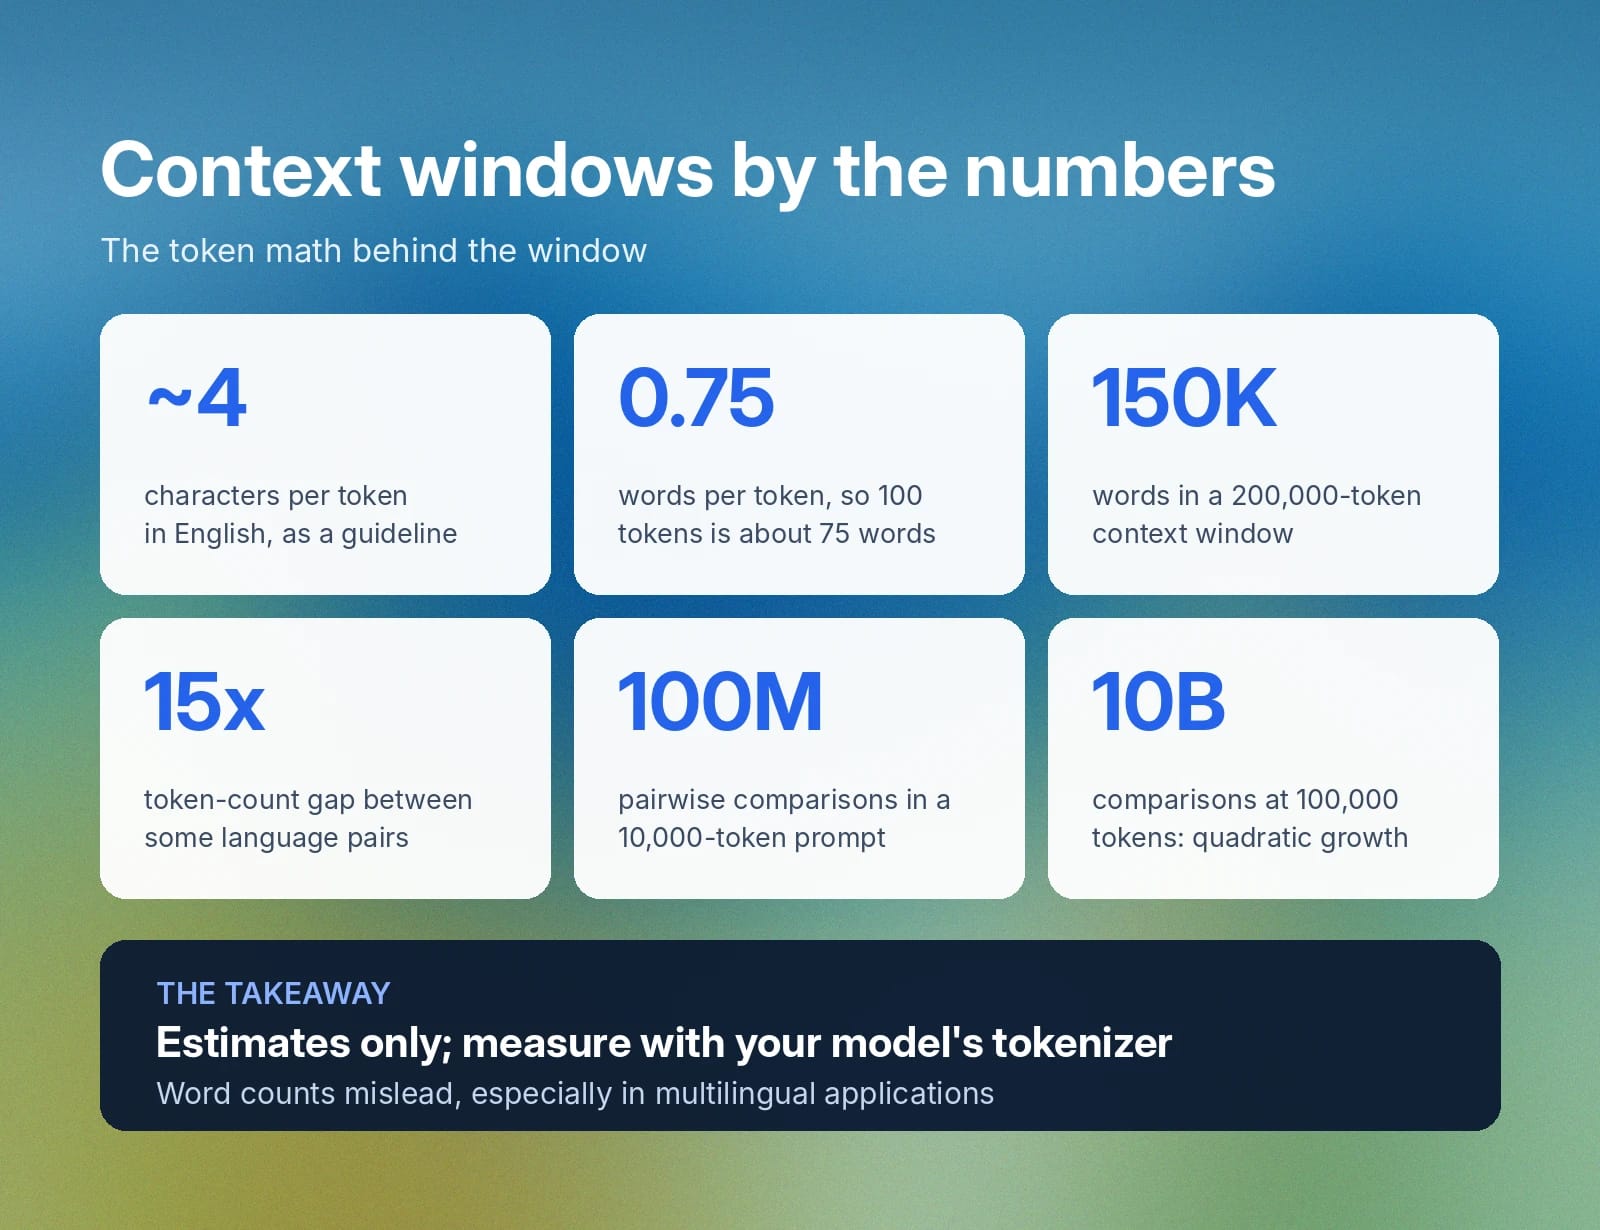
En inglés, una pauta útil es que un token representa aproximadamente cuatro caracteres o unas tres cuartas partes de una palabra. Según esta estimación, 100 tokens corresponden a unas 75 palabras. Sin embargo, esto es solo una aproximación. Piensa en la frase «Las ventanas de contexto afectan al rendimiento de las aplicaciones». Un tokenizador no necesariamente la representa como cinco palabras completas; según el tokenizador, una o más palabras pueden dividirse en varios subtokens.
La tokenización también varía considerablemente entre idiomas. Dos frases con significados y longitudes visibles similares pueden consumir cantidades muy distintas de tokens según el idioma y el tokenizador. La investigación sobre la equidad de los tokenizadores ha revelado que algunos pares de idiomas difieren hasta 15 veces en longitud tokenizada para textos equivalentes, incluso con tokenizadores diseñados para compatibilidad multilingüe. Desarrolladores que crean aplicaciones multilingües deberían medir el uso de tokens con el tokenizador real de su modelo, en lugar de calcularlo a partir del número de palabras.
Una ventana de contexto de 200.000 tokens puede parecer enorme, pero una aplicación que añade continuamente el historial de conversaciones, documentación recuperada, respuestas de herramientas e instrucciones del sistema puede acercarse a ese límite antes de lo esperado. Por eso, las aplicaciones en producción suelen supervisar el uso de tokens y utilizar técnicas como el resumen, la poda del historial, el filtrado de recuperación y la compresión de prompts para mantener la información más relevante dentro del contexto activo.
¿Cómo funciona una ventana de contexto en los modelos de lenguaje?
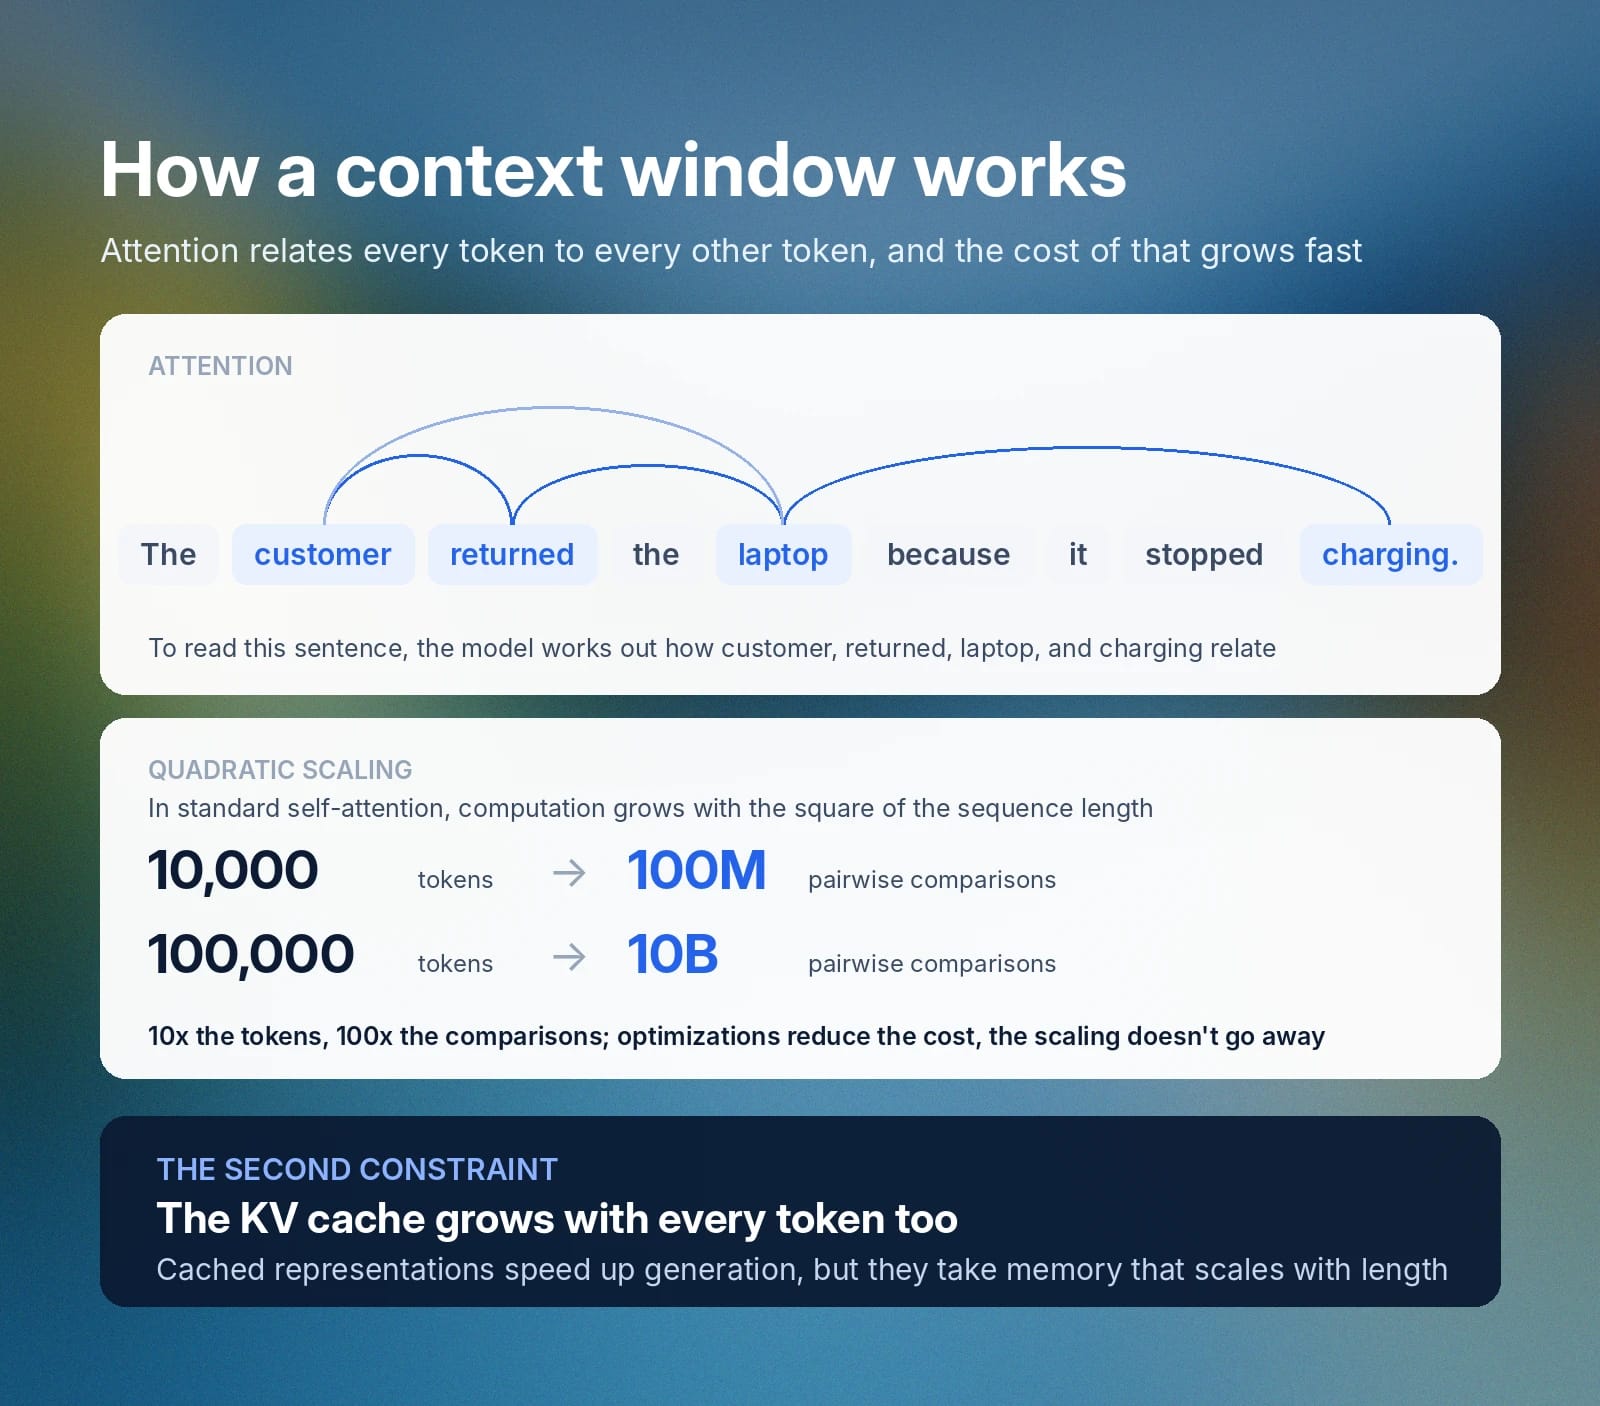
Una ventana de contexto funciona mediante el mecanismo de atención de la arquitectura transformer, que calcula cómo se relaciona cada token de una entrada con todos los demás antes de que el modelo genere una respuesta.
Piensa en la frase «El cliente devolvió el portátil porque dejó de cargar». Para interpretarla correctamente, el modelo debe determinar cómo se relacionan cliente, portátil, devolvió y cargar entre sí. A medida que una secuencia se alarga, el número de estas relaciones crece rápidamente.
En la autoatención estándar, el cálculo necesario crece aproximadamente con el cuadrado de la longitud de la secuencia. Por ejemplo, un prompt de 10.000 tokens requiere alrededor de 100 millones de comparaciones por pares, mientras que uno de 100.000 tokens requiere unos 10.000 millones. Los modelos modernos utilizan diversas optimizaciones de arquitectura e infraestructura para reducir ese coste en la práctica, pero el problema de escalabilidad subyacente no desaparece.
Las conversaciones largas añaden una segunda limitación: la caché clave-valor, o KV. Durante la generación, los modelos conservan representaciones intermedias de tokens anteriores en lugar de recalcularlas para cada token nuevo, lo que acelera considerablemente la inferencia. Sin embargo, la propia caché ocupa memoria y crece a medida que la secuencia se alarga.
Longitud máxima de contexto en modelos de IA y por qué importa
La longitud máxima de contexto de un modelo define cuánta información puede aceptar y procesar en una sola solicitud. Sin embargo, que el modelo utilice eficazmente una ventana de contexto amplia es una cuestión distinta.
Las ventanas de contexto más largas permiten casos de uso que eran difíciles o poco prácticos con LLM anteriores. Desarrolladores pueden proporcionar a un modelo un repositorio de código completo, un documento jurídico extenso, un artículo de investigación, la transcripción de una reunión o un historial de conversación considerable, sin tener que reducir primero el material a unos miles de tokens.
Esto importa porque conservar una mayor parte del contexto original puede mejorar la capacidad del modelo para responder preguntas con precisión, identificar relaciones entre fragmentos de información distantes y realizar tareas que dependen del documento en su conjunto. Por ejemplo, un asistente de programación puede necesitar examinar varios archivos para entender cómo se llama a una función, mientras que un asistente de documentos jurídicos puede necesitar comparar definiciones de una sección con obligaciones descritas mucho más adelante en el documento.
Sin embargo, una ventana de contexto más amplia no produce automáticamente mejores resultados. Las entradas muy largas pueden aumentar el coste y la latencia, y los modelos pueden prestar menos atención a la información oculta en la parte central de un contexto extenso. Por tanto, desarrolladores deberían incluir información relevante de forma selectiva, organizar claramente las entradas largas y utilizar técnicas como la recuperación, el resumen y la poda de contexto cuando resulte adecuado.
Comparación de tamaños de ventana de contexto por modelo
Las ventanas de contexto varían mucho entre las principales familias de modelos actuales, desde unos cientos de miles de tokens hasta 10 millones. Así se comparan los modelos insignia actuales:
Modelo | Ventana de contexto | Notas |
10 millones de tokens | Modelo de pesos abiertos de Meta; la mayor ventana disponible públicamente en el momento de escribir este artículo | |
1,05 millones de tokens | El modelo insignia actual de OpenAI para programación y razonamiento agéntico | |
1 millón de tokens | El modelo actual de nivel Pro de Google para análisis de documentos largos y múltiples archivos | |
1 millón de tokens | El modelo actual de nivel Sonnet de Anthropic; la ventana se aplica por defecto en toda la API de Claude |
Los límites anunciados cambian rápidamente a medida que los proveedores lanzan nuevos modelos y elevan sus topes, así que considera cualquier tabla como esta una referencia puntual, no una clasificación permanente. El tamaño del contexto es solo uno de los factores para elegir un modelo. Por sí solo no dice nada sobre la calidad del razonamiento, los límites de salida, la latencia o el coste.
Implicaciones de una ventana de contexto pequeña frente a una grande
Una ventana de contexto pequeña obliga a desarrolladores a ser selectivos. Los documentos largos se dividen en fragmentos, el historial de conversaciones más antiguo se resume y el conocimiento externo solo se recupera cuando realmente se necesita.
Una ventana de contexto grande elimina algunas de estas limitaciones. Puedes proporcionar más ejemplos, conservar más historial de conversaciones o analizar un conjunto mayor de documentos sin tener que dividirlo todo antes.
Sin embargo, una ventana más amplia introduce un problema distinto: la dilución de la atención. Cuando un prompt contiene una gran cantidad de información, el modelo puede tener dificultades para identificar qué detalles son más relevantes para la solicitud actual. Las instrucciones o pruebas importantes pueden quedar ocultas entre contenido menos relevante, lo que aumenta el riesgo de respuestas incompletas, incoherentes o menos precisas.
Por qué los modelos se pierden en el medio
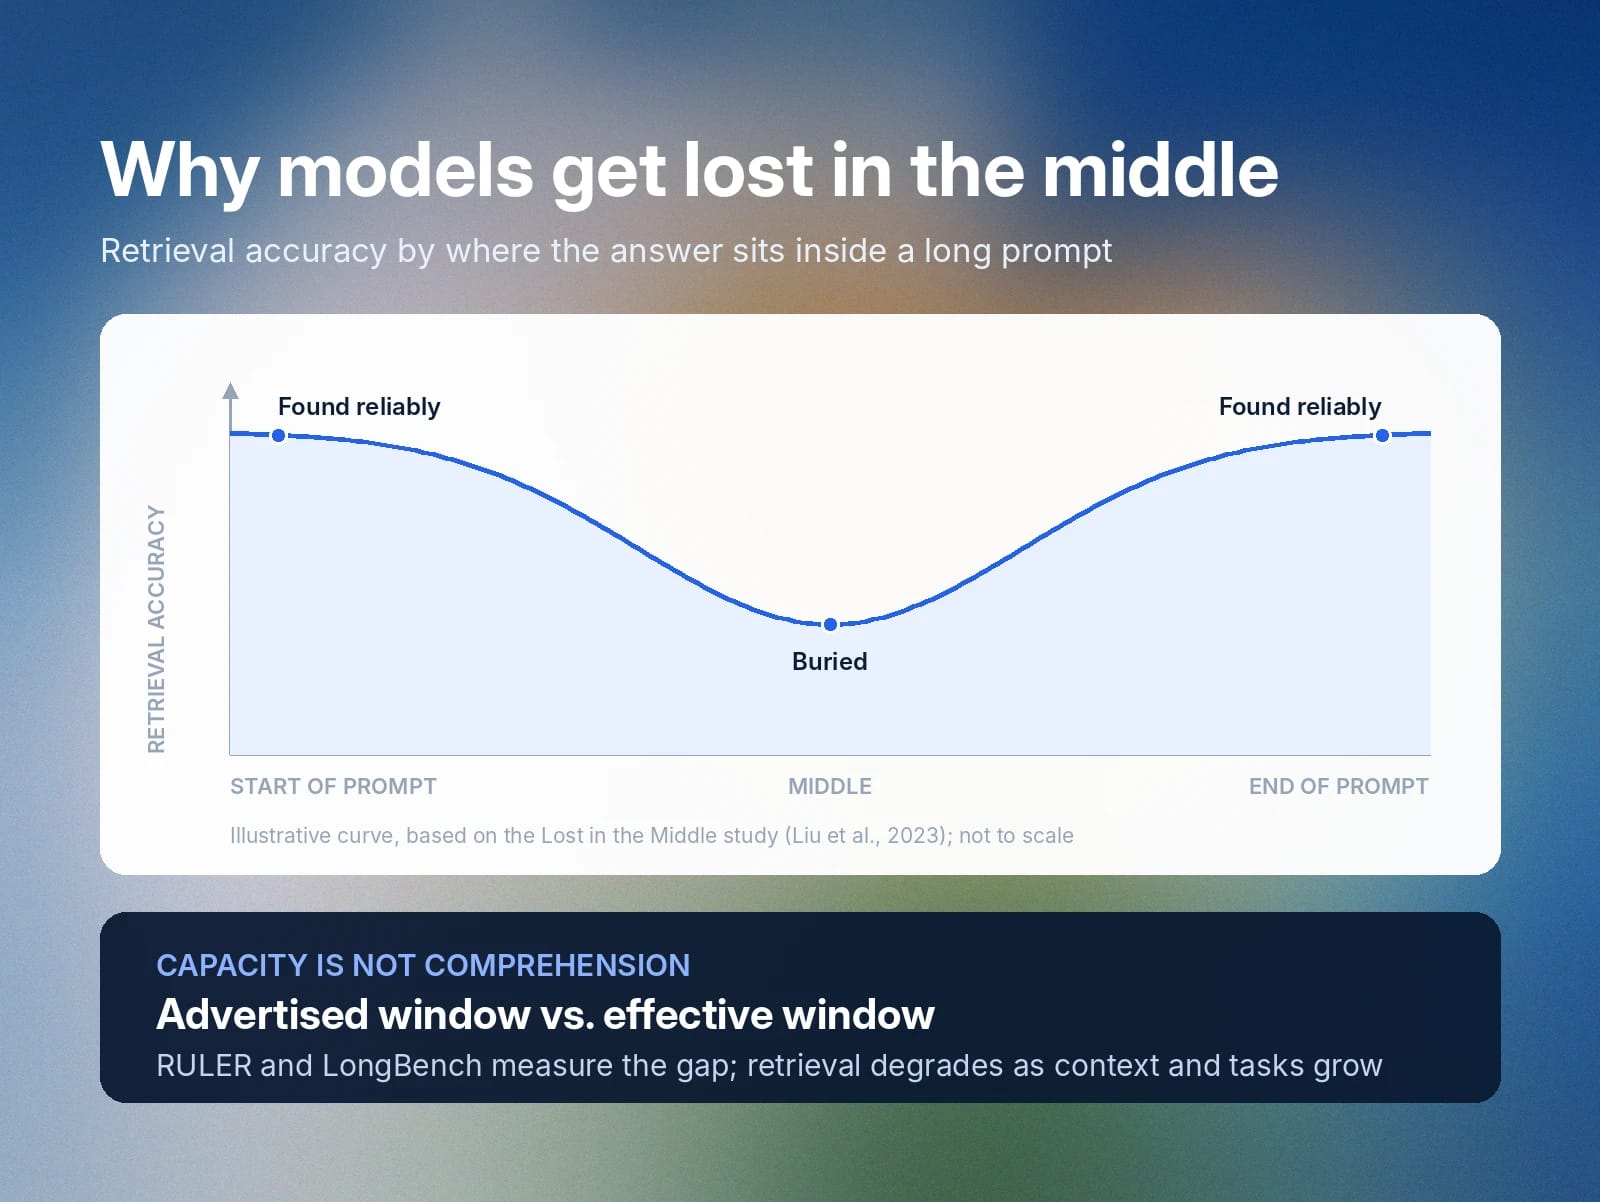
Los modelos suelen recuperar mejor la información cuando está cerca del principio o el final de un prompt largo, y peor cuando queda oculta en el medio. El influyente estudio Lost in the Middle probó esto directamente colocando la respuesta a una pregunta en distintas posiciones dentro de un prompt largo y midiendo con qué frecuencia la encontraban los modelos. La precisión fue sistemáticamente mayor al principio y al final del contexto, y menor en el medio.
Esto significa que un modelo puede aceptar técnicamente un documento sin utilizar de forma fiable todas sus partes. Envía a un LLM 100 documentos de soporte porque uno de ellos contiene la respuesta a la pregunta de un cliente, y una ventana de contexto mayor puede permitir que quepan los 100. Pero el modelo todavía tiene que encontrar un pasaje relevante entre otros 99 irrelevantes, y una ventana más larga no garantiza que lo haga.
Por eso conviene distinguir entre la ventana de contexto anunciada de un modelo y su ventana de contexto efectiva para una carga de trabajo determinada. Benchmarks como RULER y LongBench intentan medir esa diferencia. RULER descubrió que los modelos que obtenían puntuaciones casi perfectas en pruebas de recuperación sencillas seguían empeorando a medida que aumentaban la longitud del contexto y la complejidad de la tarea. LongBench evalúa tareas más amplias, como preguntas y respuestas sobre documentos, razonamiento con varios documentos, resumen, aprendizaje few-shot y completado de código.
El contexto largo sigue aportando valor real. La capacidad y la comprensión son propiedades diferentes, y ambas importan al elegir un modelo para una tarea concreta.
Gestión de los límites de contexto: buenas prácticas para desarrolladores
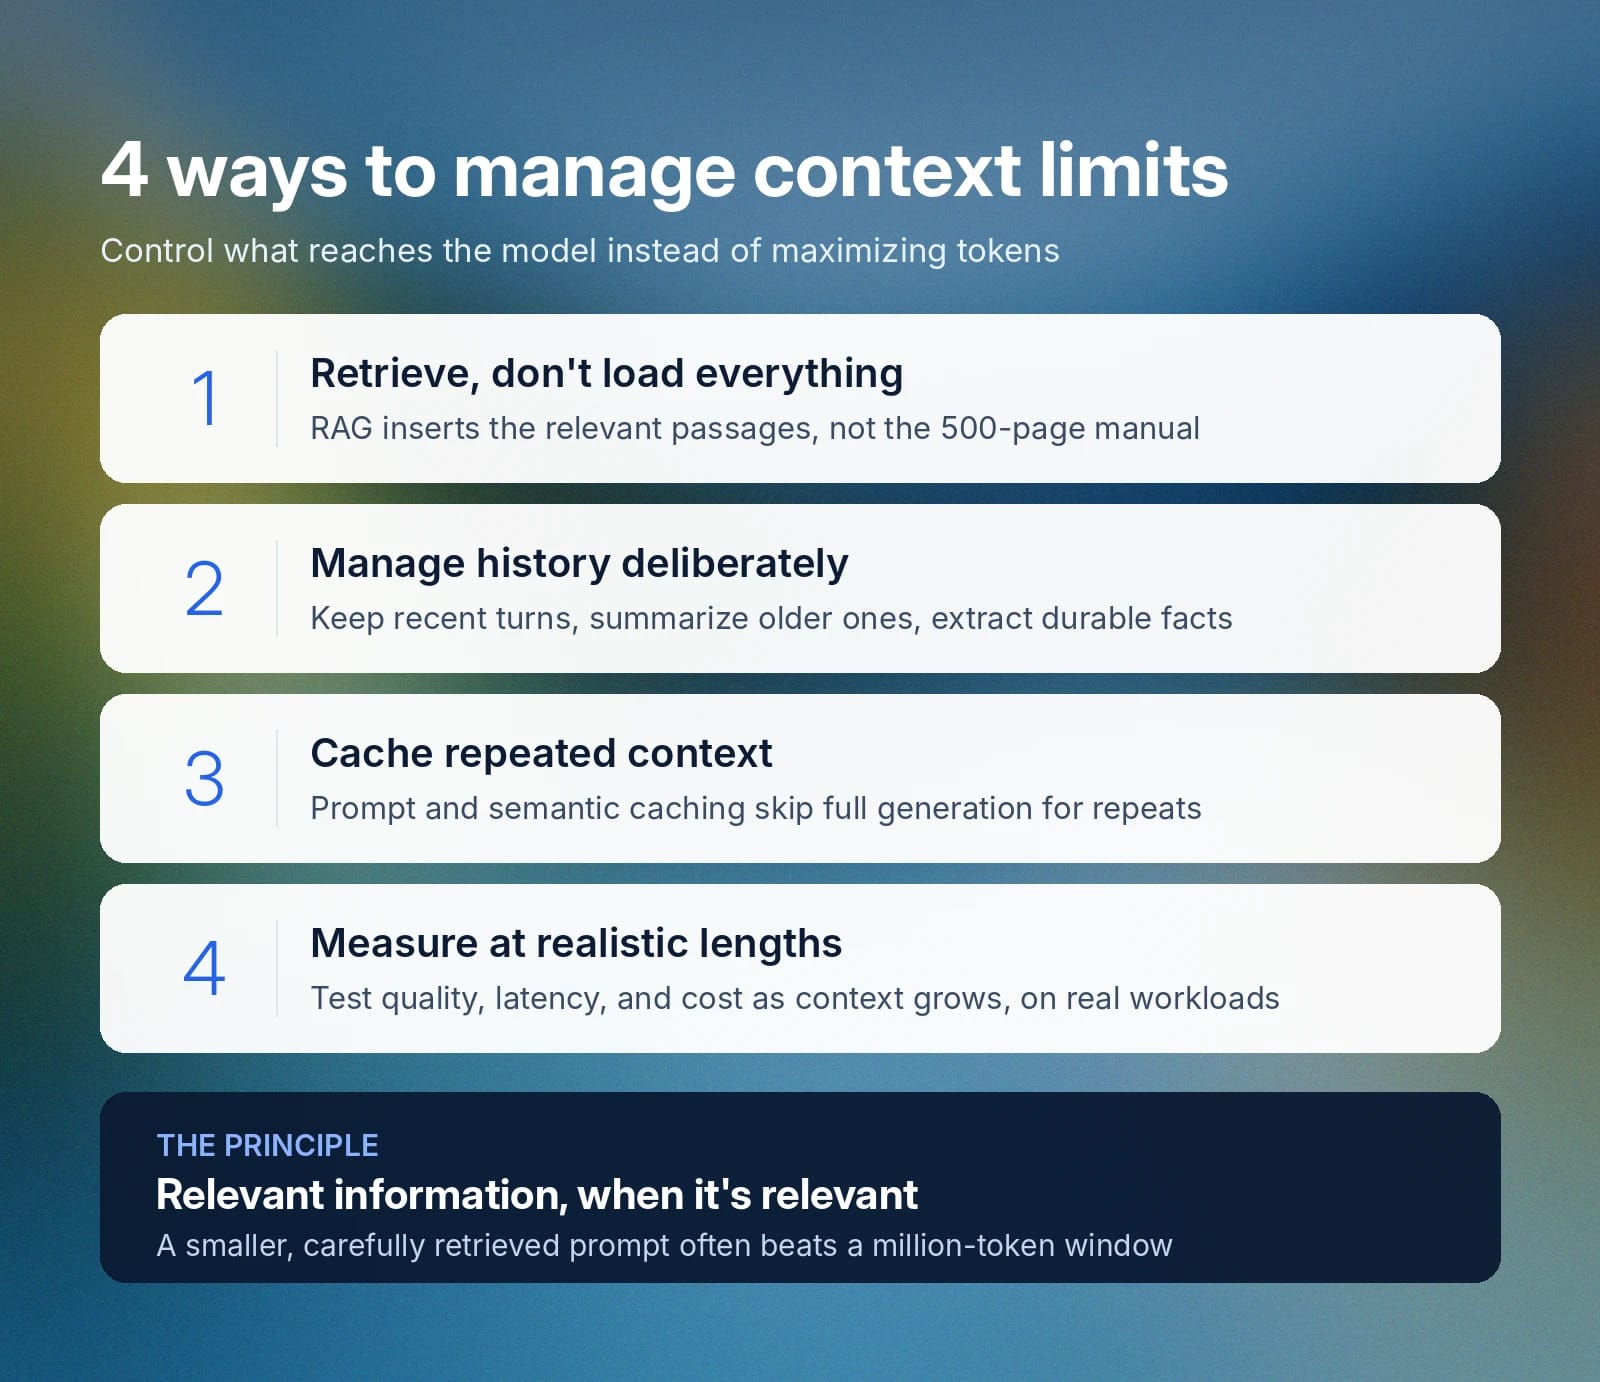
Una buena gestión del contexto consiste en controlar qué llega al modelo: proporcionar la información relevante para la tarea cuando sea relevante, en lugar de intentar maximizar el número de tokens en cada solicitud. Las siguientes prácticas pueden ayudar a desarrolladores a reducir el contexto innecesario, mejorar la calidad de las respuestas y controlar el coste y la latencia.
1. Recupera información relevante en lugar de cargarlo todo
La generación aumentada por recuperación, o RAG, permite que una aplicación busque en una base de conocimiento externa e inserte solo los pasajes relevantes en el contexto del modelo. En lugar de incluir un manual completo de 500 páginas en cada solicitud de soporte, la aplicación recupera los pocos pasajes más cercanos a la pregunta real del cliente.
Esto reduce el uso de tokens y ofrece al modelo una señal mucho más clara sobre lo que importa. La calidad de la recuperación sigue siendo importante: los sistemas RAG en producción suelen mejorar los resultados fragmentando los documentos cuidadosamente, recuperando varios pasajes candidatos, reordenándolos por relevancia y filtrando todo lo irrelevante antes de construir el prompt final. ElevenLabs, por ejemplo, rediseñó su canalización de RAG para añadir reescritura de consultas y llamadas paralelas a modelos, reduciendo a la mitad la latencia mediana de recuperación.
2. Gestiona el historial de conversaciones de forma deliberada
Las aplicaciones conversacionales acumulan contexto rápidamente. Añadir indefinidamente cada mensaje anterior desperdicia tokens y puede incorporar detalles irrelevantes en turnos posteriores.
Las aplicaciones resuelven esto conservando los turnos más recientes, resumiendo intercambios anteriores, extrayendo hechos duraderos a una memoria estructurada y recuperando detalles antiguos solo cuando vuelven a ser relevantes. Esto crea una división útil entre el contexto conversacional a corto plazo, que el modelo necesita de inmediato, y la memoria de la aplicación a más largo plazo, que puede recuperarse más adelante.
3. Usa caché cuando el contexto se repite
Muchas aplicaciones envían repetidamente las mismas instrucciones extensas o responden a preguntas semánticamente similares a otras que ya han gestionado. La caché reduce esa sobrecarga.
La caché de prompts o de contexto permite reutilizar entradas repetidas de forma más eficiente, y la caché semántica va un paso más allá al reconocer cuándo una pregunta nueva significa aproximadamente lo mismo que otra que el sistema ya ha respondido. «¿Cuál es vuestra política de devoluciones?» y «¿Cuánto tiempo tengo para devolver un artículo?» son cadenas distintas que una caché semántica puede tratar como la misma pregunta, evitando una llamada completa de generación y reduciendo tanto la latencia como el coste de tokens.
4. Mide el rendimiento con longitudes de contexto realistas
No elijas una estrategia de contexto basándote únicamente en el límite de tokens anunciado por un proveedor de modelos. Prueba cargas de trabajo representativas de producción y mide la calidad de las respuestas, la precisión de recuperación, la latencia, el uso de tokens, el coste y las tasas de error a medida que aumenta la longitud del contexto.
Compara estrategias como proporcionar más contexto, recuperar menos pasajes, resumir el historial de conversaciones o combinar recuperación y resumen. Un modelo con una ventana de contexto de un millón de tokens puede ser compatible técnicamente con tu aplicación, mientras que un prompt más pequeño y cuidadosamente recuperado puede producir resultados más rápidos y precisos a un coste menor.
Empieza con ElevenAgents para crear soluciones lingüísticas escalables
La gestión del contexto es especialmente importante en los agentes conversacionales, que deben combinar la expresión actual con turnos anteriores, instrucciones de negocio, información de clientes, contenido de bases de conocimiento y resultados de herramientas, todo ello respondiendo con la rapidez suficiente para que la conversación parezca natural.
ElevenAgents reúne estos elementos en una sola plataforma para crear e implementar agentes de voz con IA. Su motor de orquestación coordina el reconocimiento de voz, un LLM y Texto a Voz, mientras desarrolladores configuran prompts, bases de conocimiento, herramientas, workflows y el modelo de lenguaje subyacente. La entonación expresiva, incluida la forma en que un agente transmite contexto emocional en la voz, depende del mismo contexto que determina en primer lugar lo que dice el agente.
En cuanto a la gestión del conocimiento, ElevenAgents admite tanto documentos de contexto completo como RAG, configurable directamente en la plataforma. Los documentos pequeños se incluyen directamente en el prompt de un agente, de modo que su contenido permanece disponible durante toda la conversación. En cambio, las bases de conocimiento más grandes se indexan, y RAG recupera los pasajes relevantes para cada consulta en lugar de cargarlo todo en la ventana de contexto de una vez.
Empieza registrándote en ElevenAgents hoy o habla con nuestro equipo para conocer tus opciones de implementación.
Preguntas frecuentes sobre las ventanas de contexto

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.

