Presentamos Scribe v2
- Publicado
EscucharEscucha este artículo
Scribe v2 está diseñado para la transcripción por lotes, la creación de subtítulos y el subtitulado a gran escala. Mejora la estabilidad y la precisión de Scribe v1, y gestiona mejor el audio de larga duración, las pausas, los cambios de tono y los silencios prolongados.

Mientras que Scribe v2 Realtime está optimizado para una latencia ultrabaja y casos de uso de agentes, Scribe v2 está optimizado para grabaciones largas y complejas, y mantiene la precisión con distintos hablantes, acentos y estilos de entonación. El resultado son transcripciones fiables de forma constante en una amplia variedad de condiciones de audio reales.
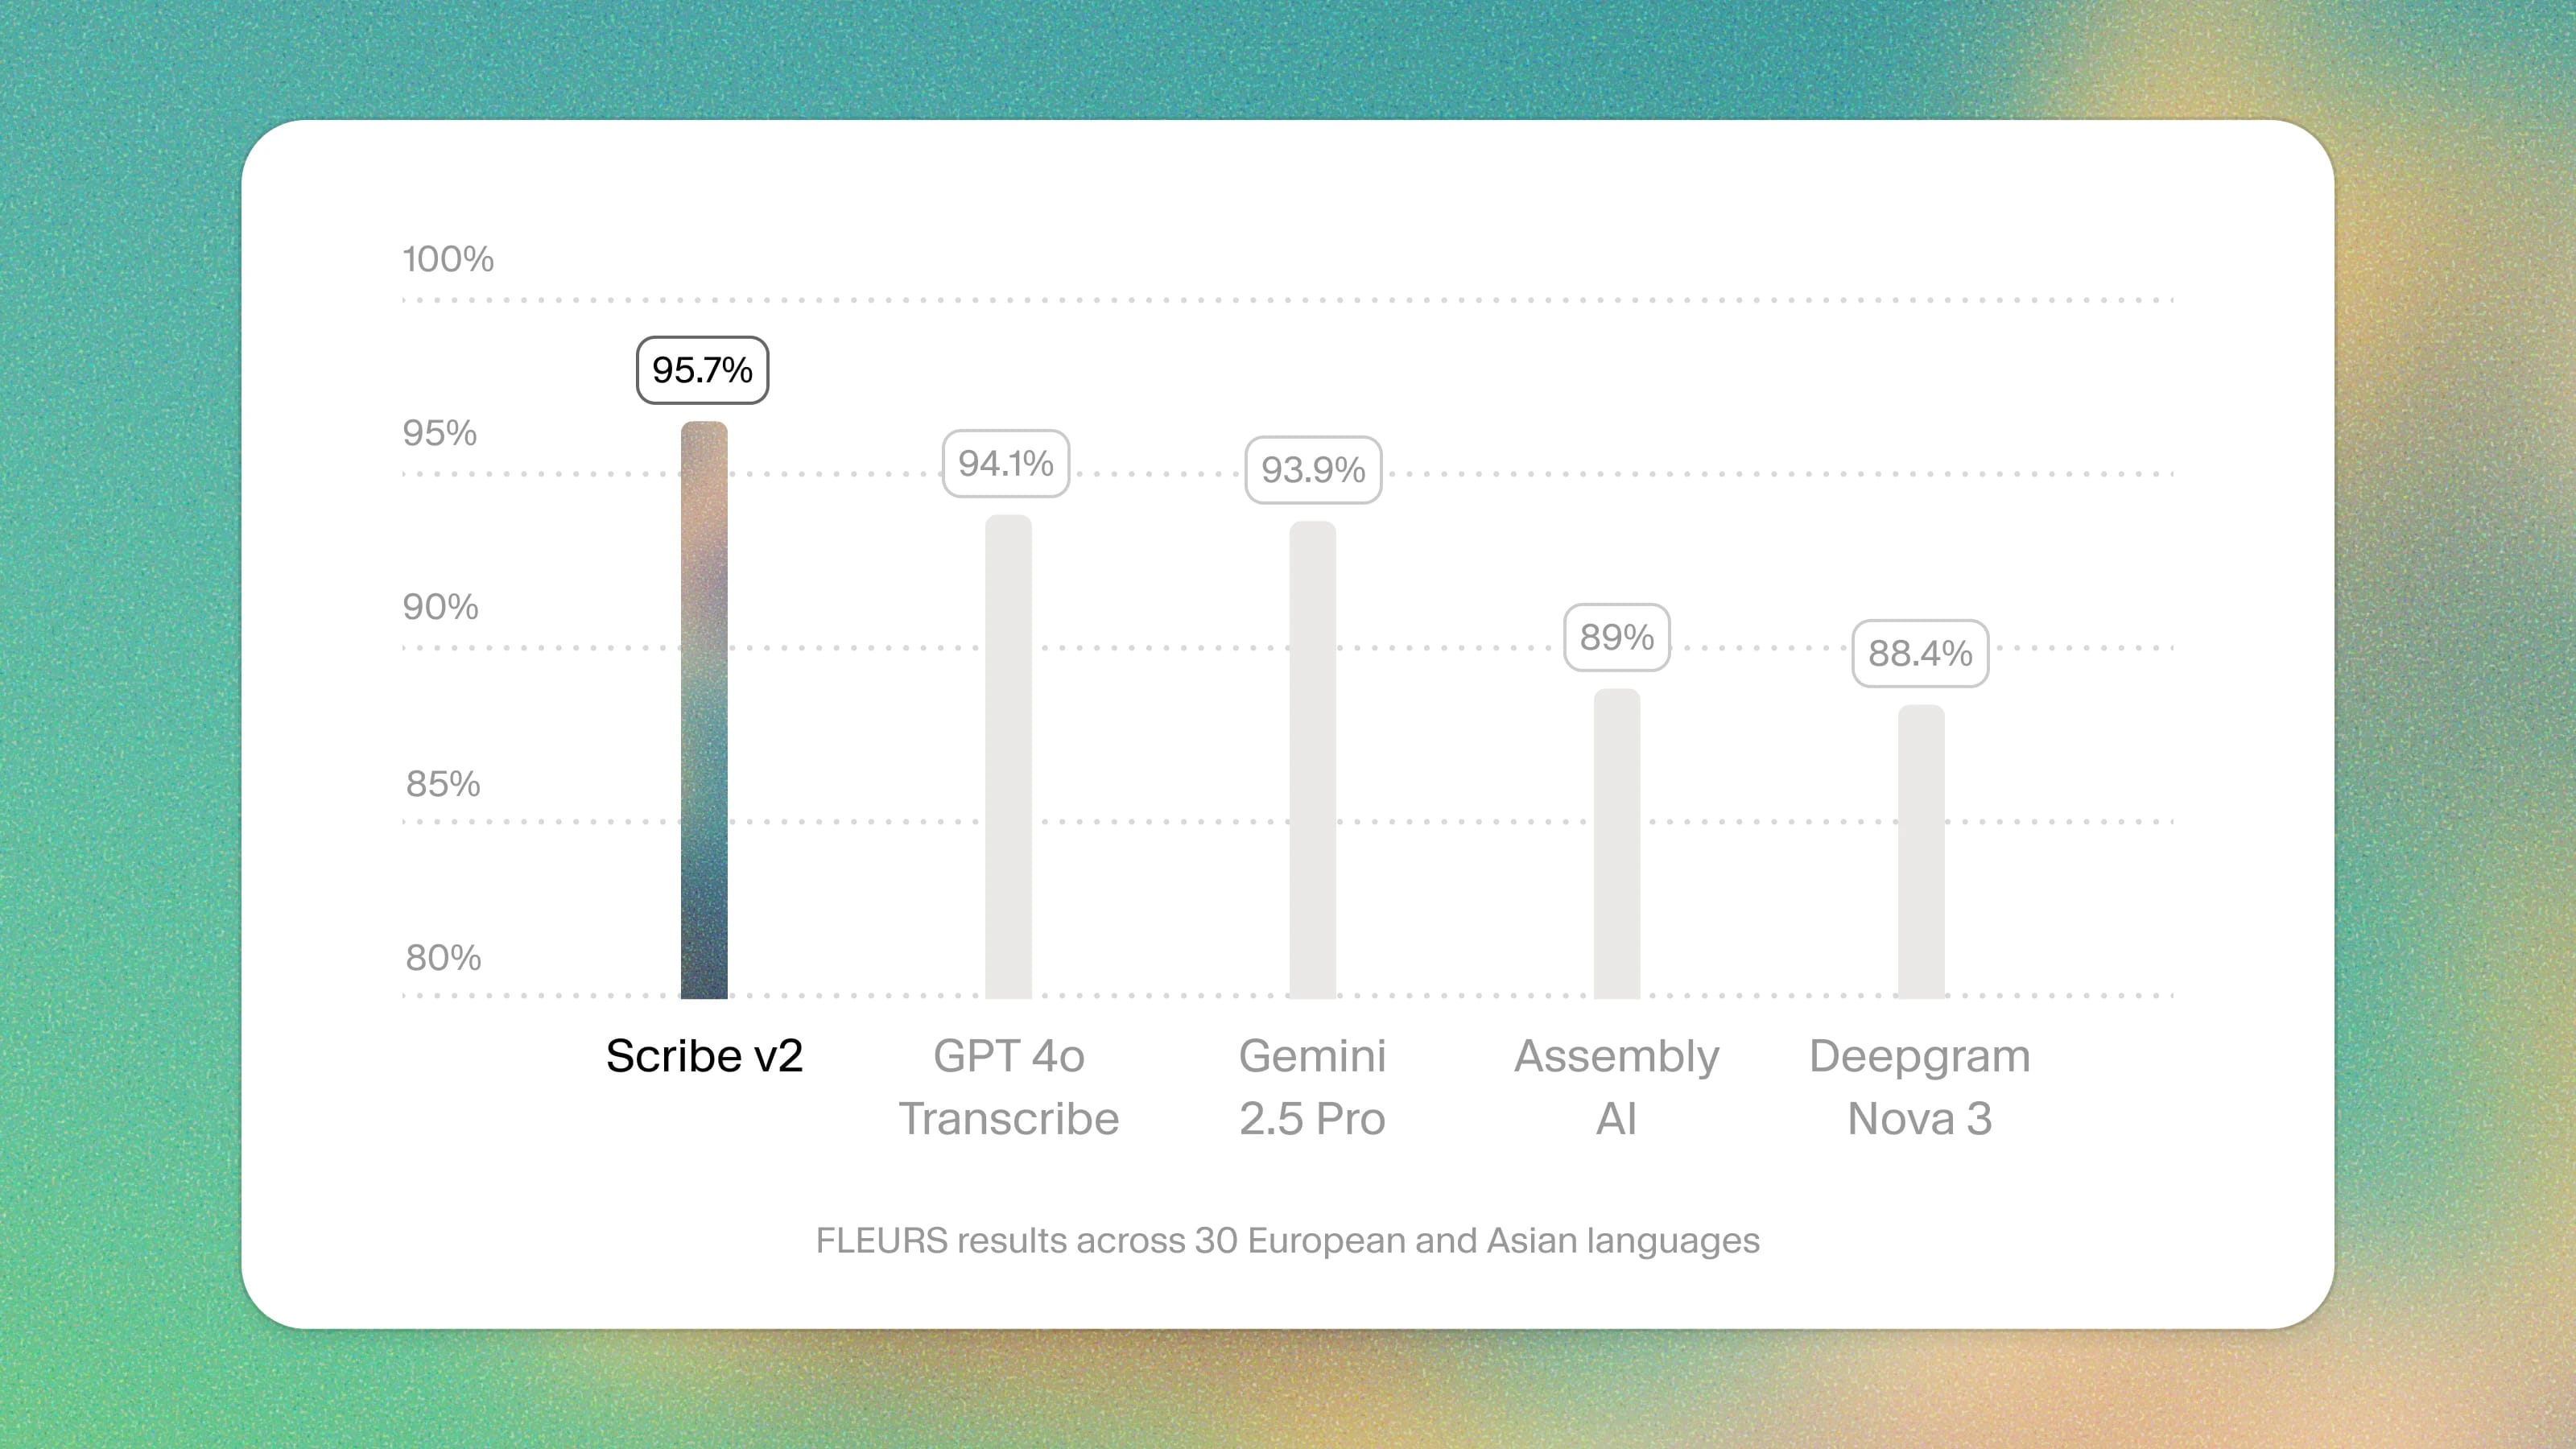
Scribe v2 logra la tasa de error de palabras más baja registrada en pruebas de referencia estándar del sector.
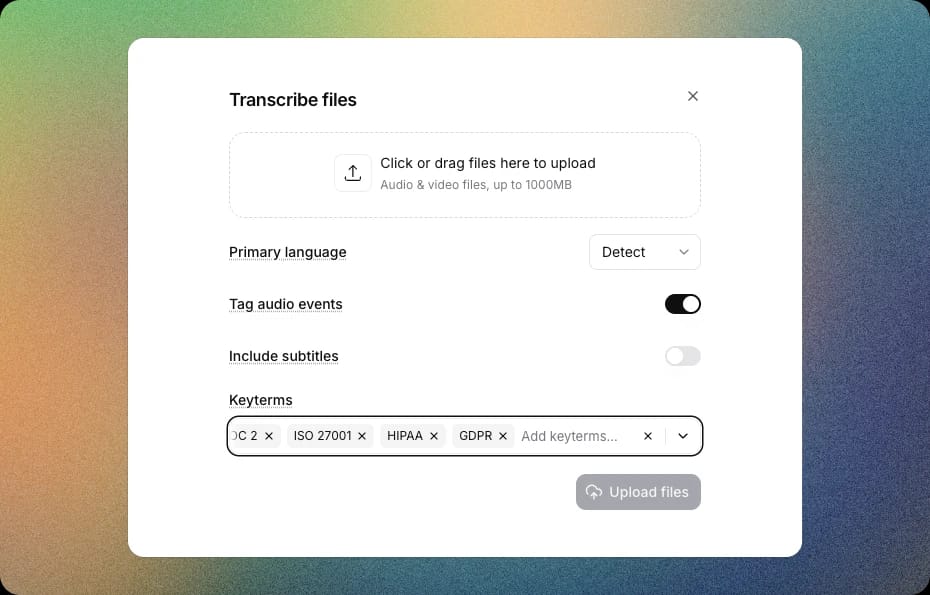
Keyterm Prompting para una transcripción basada en el contexto
Keyterm Prompting va más allá del Vocabulario personalizado estándar al usar el contexto de la transcripción. Selecciona hasta 100 palabras o frases, y Scribe v2 decidirá con precisión cuándo transcribir esos términos. Esto lo hace especialmente adecuado para ámbitos técnicos, nombres de marca y lenguaje específico de cada sector.
Detección de entidades integrada con marcas de tiempo precisas
Scribe v2 incluye detección de entidades nativa para el análisis estructurado de audio.
Puedes seleccionar hasta 56 categorías de información de identificación personal, datos de salud o detalles de pago. Scribe v2 detectará automáticamente estas instancias y sus marcas de tiempo exactas en la transcripción, lo que facilita revisar, ocultar o procesar información sensible a gran escala.
Consulta más información en la documentación de la API: https://elevenlabs.io/docs/developers/guides/cookbooks/speech-to-text/batch/entity-detection
Transcripción automática en varios idiomas
Scribe v2 admite flujos de trabajo inteligentes en varios idiomas desde el primer momento.
Puedes enviar audio que contenga varios idiomas en un único archivo. El modelo detecta automáticamente cada idioma y lo transcribe correctamente sin necesidad de segmentación ni configuración manual.
Funciones adicionales para flujos de trabajo de producción
Scribe v2 incluye un conjunto de funciones diseñadas para casos de uso empresariales y de desarrollador:
- Diarización inteligente de hablantes para etiquetar a cada hablante de forma clara e intuitiva
- Marcas de tiempo precisas a nivel de palabra para alinear subtítulos con exactitud y crear experiencias interactivas
- Etiquetado dinámico de audio que detecta eventos no verbales como risas o pasos
- Preparado para empresas, con cumplimiento de SOC 2, ISO 27001, PCI DSS L1, HIPAA y RGPD, residencia de datos en la UE y la India, y compatibilidad con el modo de retención cero
Scribe v2, ahora en ElevenLabs Studio
Scribe v2 ya se utiliza en ElevenLabs Studio para crear subtítulos, textos de apoyo y transcripciones más precisos, ayudando a equipos que gestionan grandes bibliotecas de audio y vídeo para marketing, medios, investigación, formación y cumplimiento normativo.
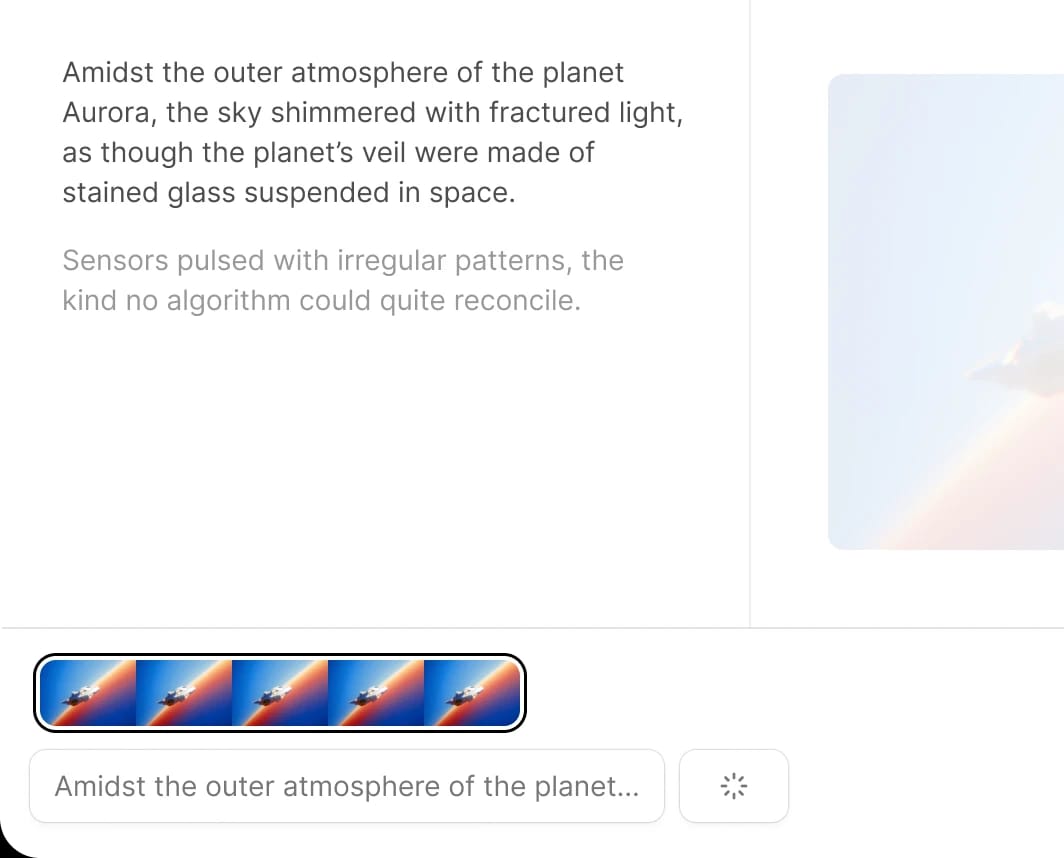
Pruébalo ahora: https://elevenlabs.io/app/studio
Crea con la API
Con Scribe v2, desarrolladores y empresas pueden automatizar flujos de procesamiento de audio complejos, mejorar la precisión en flujos de trabajo de contenido globales y escalar de forma segura con controles completos de cumplimiento normativo y residencia de datos.
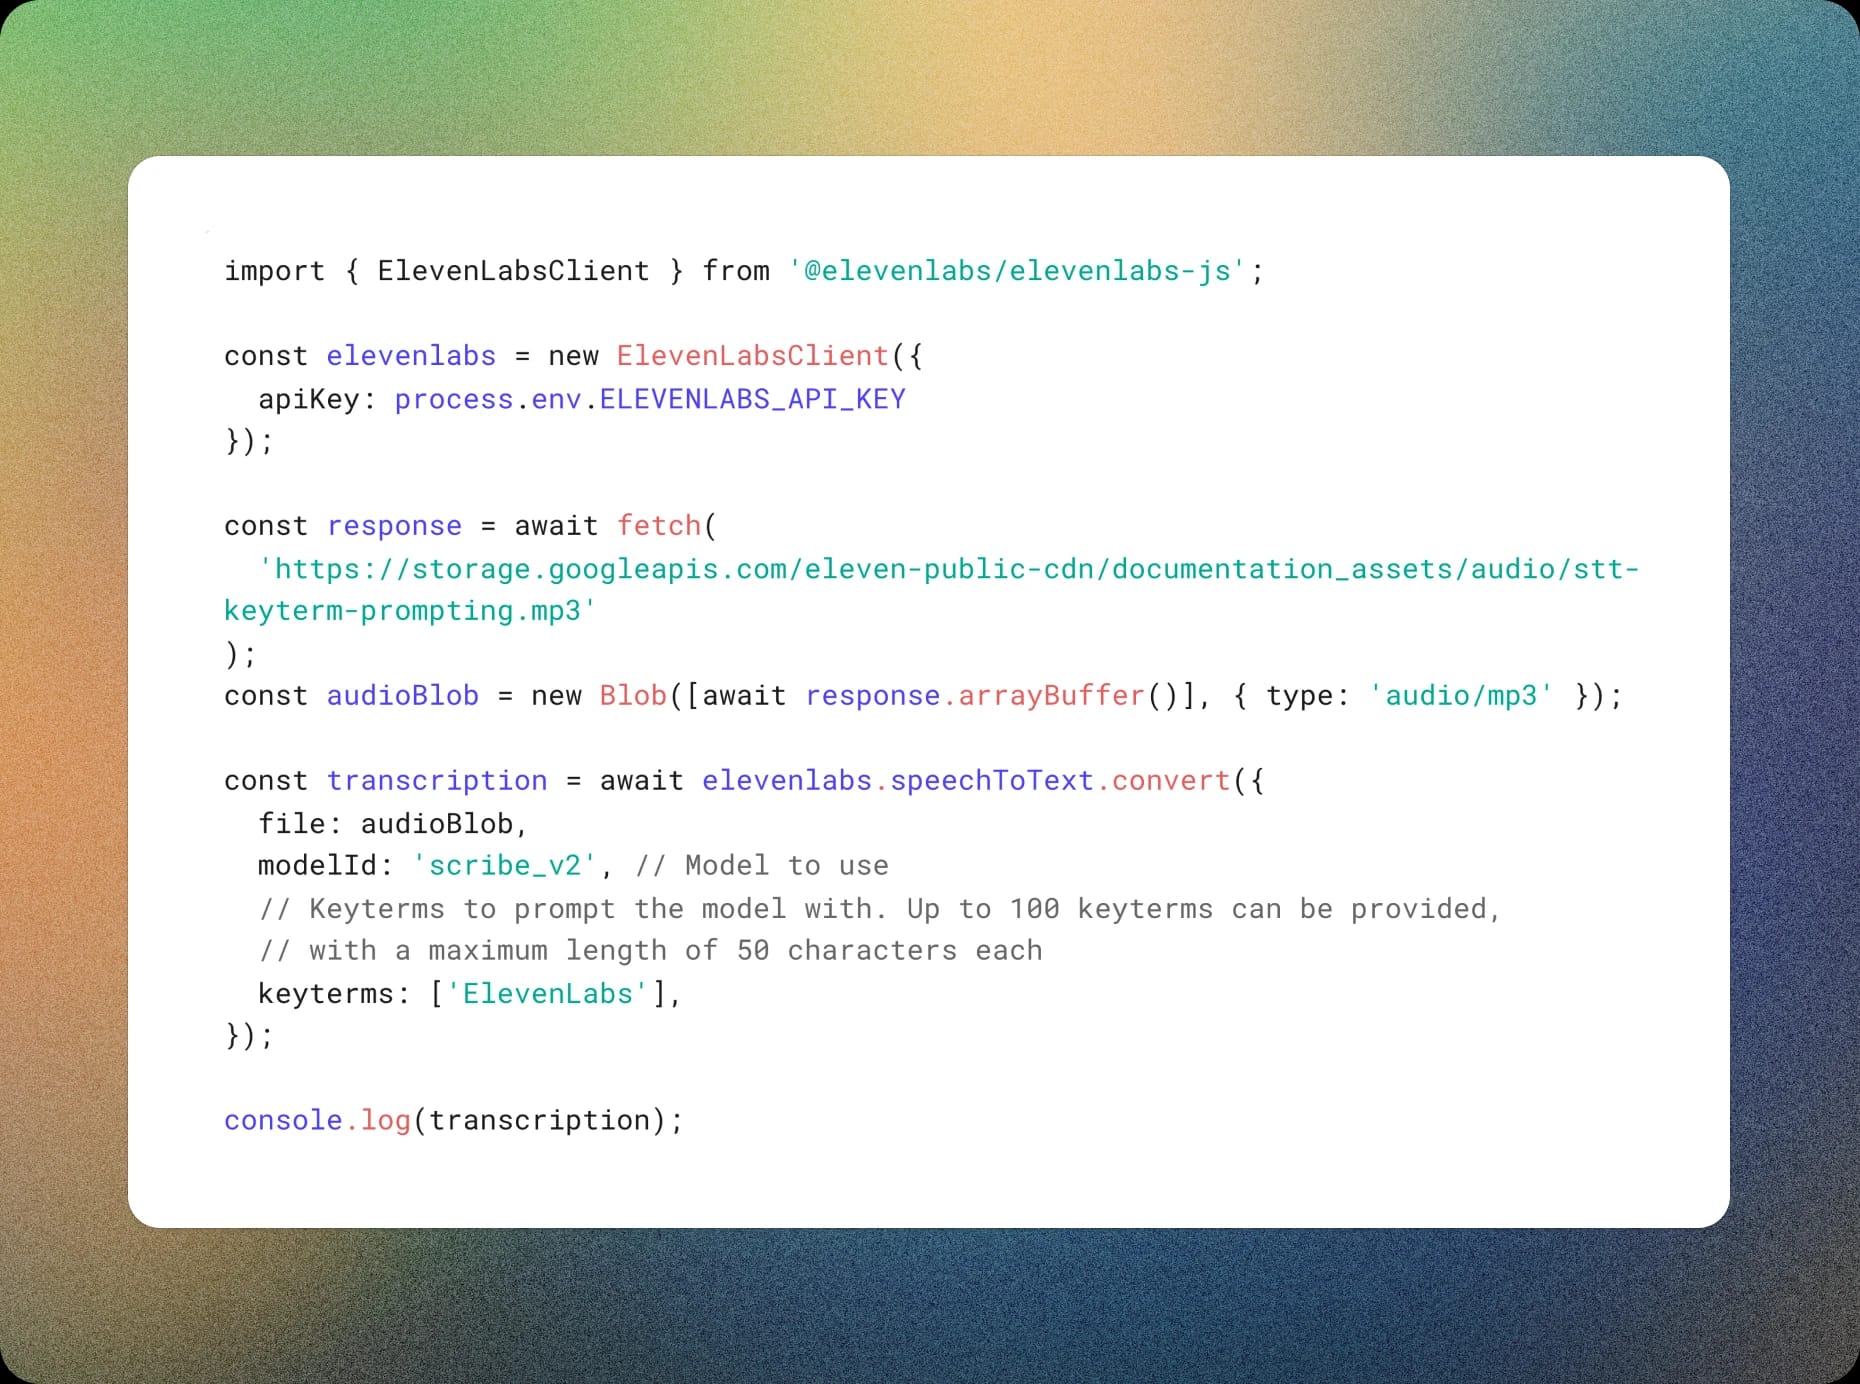
Scribe v2 ya está disponible a través de nuestra API y la plataforma Creative.
Pruébalo ahora: https://elevenlabs.io/app/speech-to-text
Lee la documentación: https://elevenlabs.io/docs/capabilities/speech-to-text
Regístrate aquí: https://elevenlabs.io/speech-to-text