Cómo sabe tu transcripción dónde se pronuncia cada palabra
- Escrito por
- Mike Murphy
- Publicado
- Última actualización
EscucharEscucha este artículo
Si alguna vez has visto una película en televisión con problemas de emisión y los diálogos de actores están completamente desincronizados de los subtítulos, sabrás lo distraído que puede resultar y cómo puede sacarte de la historia. Los vídeos y el software que usan modelos de voz tienen el mismo problema: un subtítulo que aparece un segundo tarde o una transcripción que resalta la palabra equivocada pueden parecer igual de defectuosos.
«Los humanos somos bastante buenos sincronizando contenido multimedia, al menos a nivel de palabra», afirma Danila Kozlov, investigador de ElevenLabs especializado en alineación. «A menudo intuimos cuándo empieza una palabra, pero a nivel de carácter y con precisión submilisegundo, es mucho más difícil».
Hoy, en ElevenLabs compartimos más información sobre Cue, un modelo de alineación forzada que sitúa cada carácter de un archivo de audio en una línea de tiempo precisa. Cue impulsa la familia de modelos Scribe de ElevenLabs y, en grabaciones reales, es más preciso que todos los alineadores que hemos probado en los 29 idiomas del benchmark. También procesa grabaciones de cualquier duración en una sola pasada y alinea una hora de audio en menos de un segundo.
¿Qué es la alineación forzada?
Imagina que alguien te da un vídeo y una transcripción y te pide que relaciones cada palabra con el momento en que se pronuncia. Eso es la alineación forzada. Cuando haces clic en una palabra de una transcripción de ElevenLabs y el reproductor salta a ese punto exacto, un alineador está haciendo el trabajo.
Sin embargo, la alineación forzada es diferente del concepto más difuso de alineación de IA. Este consiste en diseñar sistemas de IA para que su comportamiento se ajuste a los valores de las personas y a las preferencias empresariales. Con la alineación forzada, solo hablamos de sincronizar texto y sonido.
Cue es el último paso del proceso de Voz a Texto. Scribe, el modelo de Voz a Texto de ElevenLabs, transcribe el audio y el alineador establece los tiempos. Todas las solicitudes de Scribe pasan por él. El mismo modelo también impulsa los subtítulos, el doblaje y la sincronización de letras de música, y está disponible por separado mediante la API de alineación forzada.
Como tantos productos dependen de él, un alineador debe ser preciso en todos los idiomas compatibles, extremadamente rápido y capaz de gestionar muchas solicitudes a la vez.
Las limitaciones de los alineadores tradicionales
Antes del nuevo modelo, el equipo creó el modelo de alineación que se había usado hasta entonces en todos los productos de ElevenLabs. Aunque era potente, sabían que podían hacer una nueva versión aún mejor. Cuando Kozlov se incorporó, él y el equipo empezaron entrevistando a clientes y usuarios internos de ElevenLabs sobre qué les frustraba al trabajar con el alineador anterior. Sus quejas coincidían con las limitaciones de las herramientas de código abierto que el equipo probó.
La duración es el primer gran problema. Muchos alineadores actuales funcionan bien con clips de unos 30 segundos, pero los archivos más largos deben dividirse en fragmentos. Cada fragmento nuevo puede añadir un pequeño error de sincronización, y unirlos puede añadir más. En grabaciones completas, el error medio de sincronización de Cue es de solo 179 milisegundos, mientras que las herramientas de código abierto oscilaban entre 283 ms y más de 6000 ms.
El audio grabado en situaciones reales es aún más difícil. El ruido de fondo, las voces superpuestas y la música ambiental hacen que muchas herramientas pierdan el punto al relacionar texto y audio. Pero estos son precisamente los tipos de archivos que muchas personas quieren transcribir, ya que todos solemos vivir en lugares que no son perfectamente silenciosos. En grabaciones en inglés con problemas de fondo, el error medio de Cue es de 57 ms, frente a entre 65 ms y 920 ms de las demás.
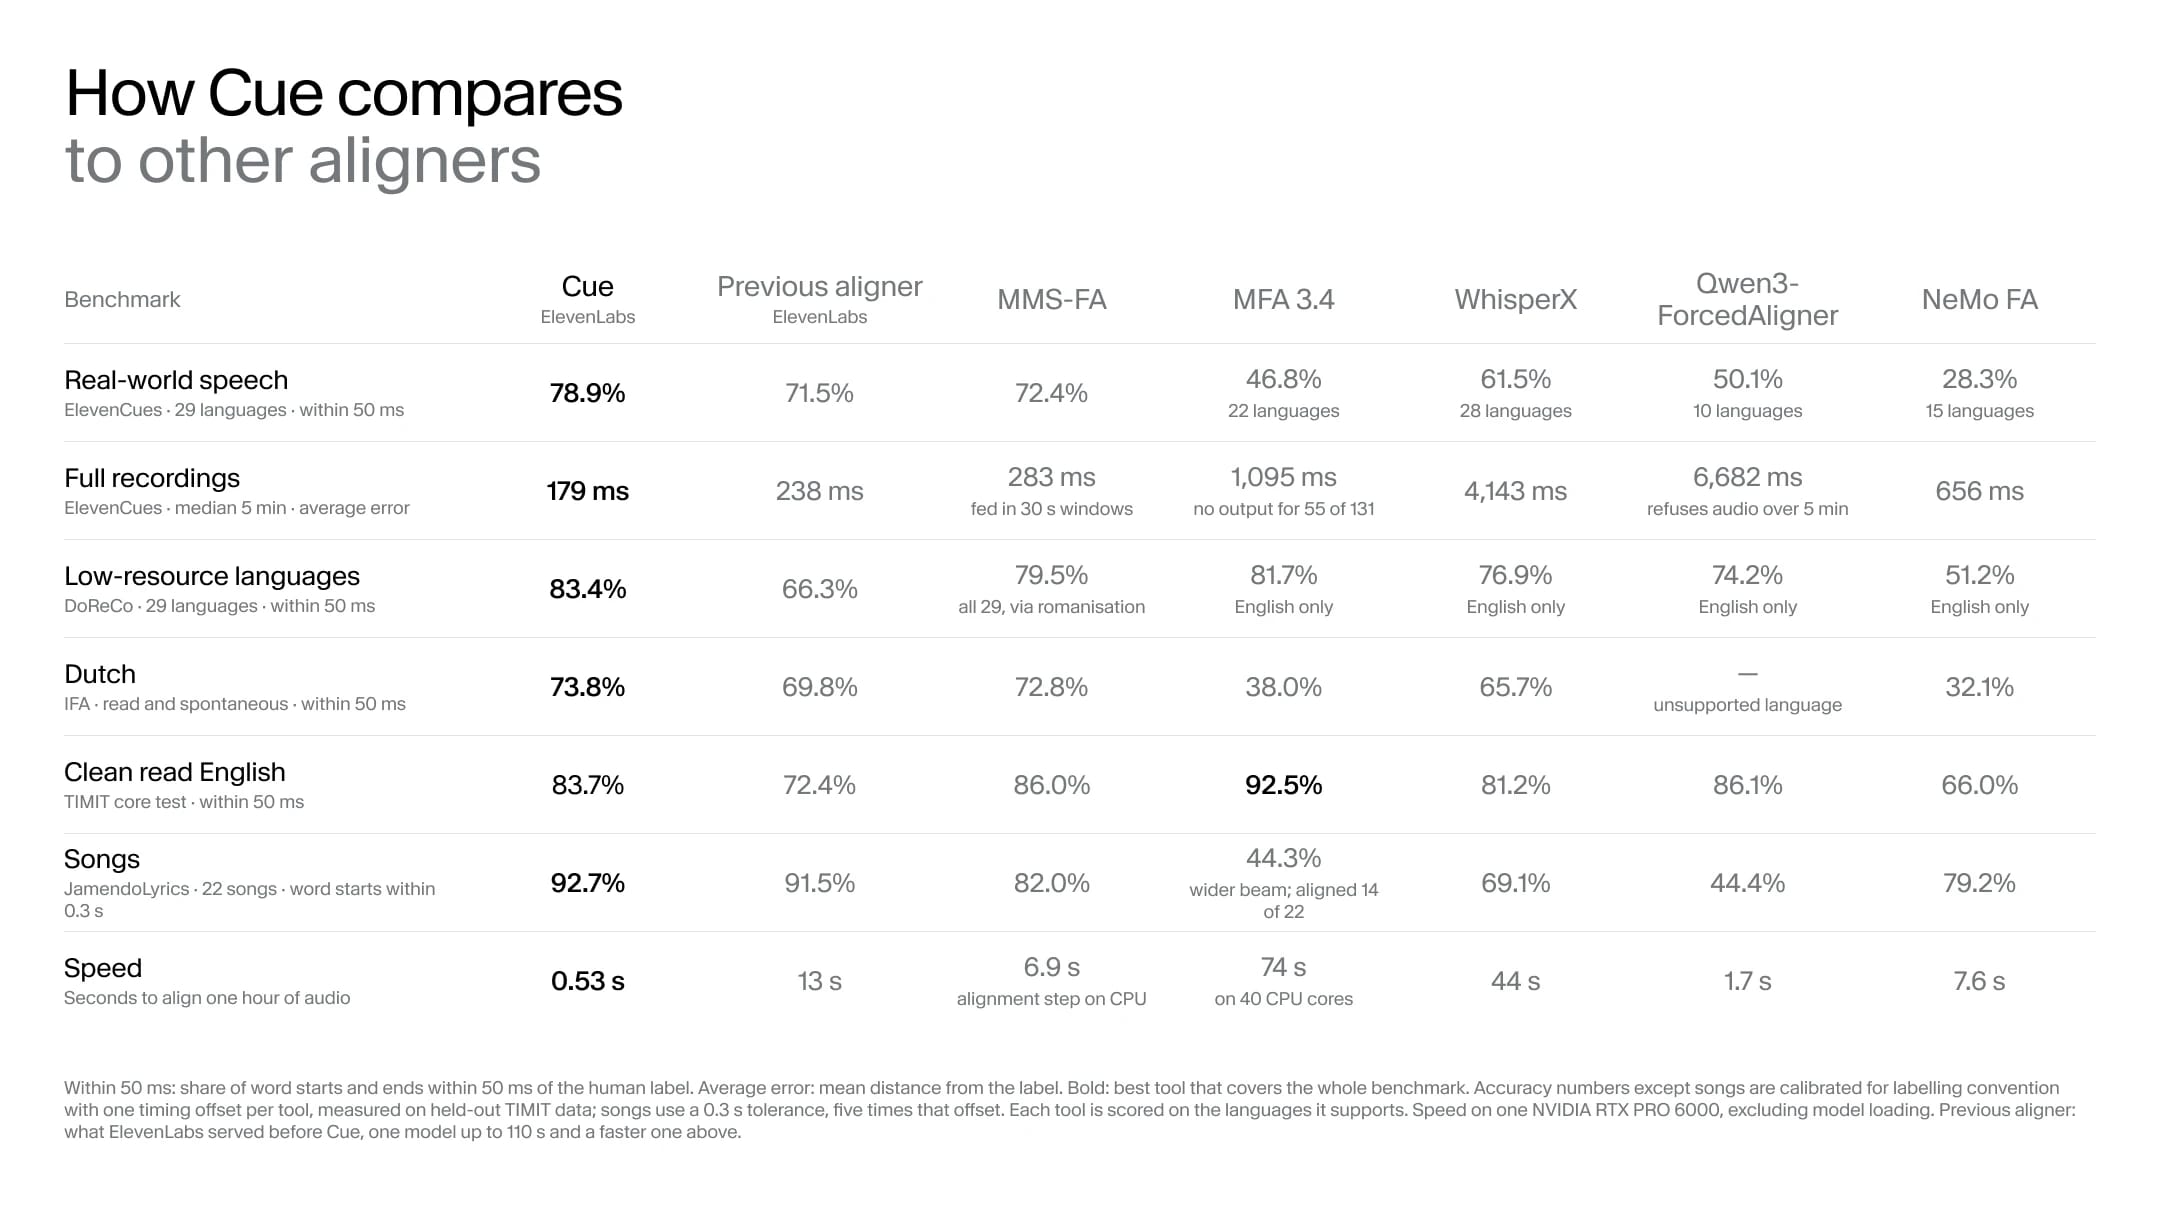
La compatibilidad con idiomas es otra limitación. La mayoría de los alineadores de código abierto necesitan un modelo independiente para cada idioma que admiten, por lo que los idiomas con menos datos de entrenamiento suelen ofrecer peores resultados o simplemente no son compatibles. MMS-FA es la única otra herramienta que gestiona los 29 idiomas del benchmark y, en comparación, Cue solía ser más rápida al determinar los límites entre palabras.
La velocidad también es un problema para estos modelos, ya que alinear grandes volúmenes de audio puede resultar caro rápidamente. Cue puede alinear una hora de audio en alrededor de medio segundo con nuestra GPU de producción. La siguiente herramienta más rápida, Qwen3-ForcedAligner, tarda casi 2 segundos, y la más lenta de las probadas tarda bastante más de un minuto.
Qué diferencia a Cue
Cue es un único modelo que cubre más de 90 idiomas del benchmark, a diferencia de la mayoría de sus competidores. También puede procesar grabaciones de cualquier duración en una sola pasada, lo que evita la división en fragmentos que hace que los errores de sincronización se acumulen en archivos largos.
Pellizca o usa Control y la rueda del ratón para ampliar o reducir. Desliza horizontalmente o usa Mayús y la rueda del ratón para desplazarte. Con una palabra seleccionada, usa más y menos para ampliar o reducir, o Mayús y las flechas izquierda o derecha para desplazarte.
Selecciona una palabra para ver sus caracteres
Aunque la mayoría de los modelos se han hecho más grandes a medida que mejoraba su rendimiento, Cue es más pequeño que el alineador anterior de ElevenLabs, según Kozlov. Sigue funcionando con una GPU, pero alinea una hora de audio en aproximadamente medio segundo.
El equipo creó Cue pensando en los tipos de audio que la gente realmente sube. Tomando el alineador anterior como referencia, crearon un benchmark a partir de solicitudes reales y evaluaron todas las herramientas de la misma forma, considerando un error cada palabra que una herramienta no lograba ubicar. Cue trabaja a nivel de carácter, que es más detallado que las etiquetas a nivel de palabra que usan la mayoría de los benchmarks, por lo que esas puntuaciones probablemente subestiman su precisión.
«En algún momento se alcanza el nivel de las capacidades humanas», dice Kozlov sobre los modelos de alineación. «Nuestro alineador actual va más allá de ese nivel y, por tanto, resulta mucho más difícil comprobar si es totalmente correcto o simplemente hasta qué punto es preciso, porque no existe un benchmark de referencia. Tuvimos que usar benchmarks a nivel de palabra para evaluar un sistema a nivel de carácter, lo que no muestra necesariamente todo el potencial de Cue».
La calidad de Cue también refleja la rapidez con la que ElevenLabs puede actuar a partir de los comentarios de usuarios. Poco después de lanzar Cue, un cliente avisó al equipo de que el georgiano y algunos otros idiomas con menos recursos rendían peor de lo esperado. En ElevenLabs mantenemos la investigación cerca de los equipos y clientes que utilizan nuestros productos, lo que permitió detectar el problema rápidamente, investigar posibles mejoras del modelo, entrenar una nueva versión y lanzarla, todo ello en menos de 24 horas desde que el cliente comunicó el problema.
Alinear canciones
La música es difícil porque al cantar se alargan y difuminan las palabras, y pocos modelos pueden hacerlo bien. El equipo no esperaba que Cue lo gestionara tan bien como lo hace. Cue pudo alinear un subconjunto de canciones del conjunto de datos con licencia Creative Commons JamendoLyrics MultiLang. Pudo hacerlo en inglés, francés, español y alemán —en una sola pasada— con una precisión sorprendente. Situó el 92,7 % de las palabras a menos de 0,3 segundos de la etiqueta, frente al 82,0 % de la siguiente mejor herramienta.
El error medio de inicio de Cue fue de 0,82 segundos, aproximadamente la mitad que el de su competidor más cercano. Fue más preciso que cualquier otra herramienta en al menos 19 de las 22 canciones. El potencial de poder cantar en un karaoke tus nuevas canciones favoritas el mismo día de su lanzamiento es enorme.
Prueba Cue hoy
Cue ya está detrás de todas las transcripciones de Voz a Texto de ElevenLabs. Para usarlo directamente, prueba la API de alineación forzada.
Agradecimientos
El trabajo en los modelos de alineación de ElevenLabs no habría sido posible sin muchas personas de toda la empresa. El equipo quiere dar las gracias a todas las personas que trabajaron en la versión anterior del modelo y en la nueva, entre ellas el cofundador y CTO Piotr Dąbkowski; investigadores como Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel y Angelos Perivolaropoulos; así como Ani Janelidze, de Operaciones de Datos; nuestros equipos de ingeniería de implementación y soporte; y Lorenzo Dossi por su trabajo en la visualización de este blog.
Mike Murphy es el editor y redactor jefe del blog de ElevenLabs, donde transforma investigaciones y tecnologías complejas en historias claras y atractivas. Antes de unirse a ElevenLabs, trabajó durante años como periodista especializado en tecnología, incluido en Quartz, y dirigió los contenidos de IBM Research. Tiene un máster en Periodismo por Northwestern.