Presentamos Eleven v4, nuestro modelo más expresivo
- Publicado
- Última actualización
EscucharEscucha este artículo
Una misma frase puede cambiar mucho según cómo se diga. «Necesito que mantengas la calma» debería sonar distinto según quién la pronuncie: un médico que se lo dice con suavidad a un paciente asustado o un personaje de un videojuego que se lo grita a su escuadrón antes de entrar en combate.
Hoy lanzamos Eleven v4, nuestro modelo de Texto a Voz más expresivo hasta la fecha, junto con su variante de baja latencia, Eleven v4 Turbo.
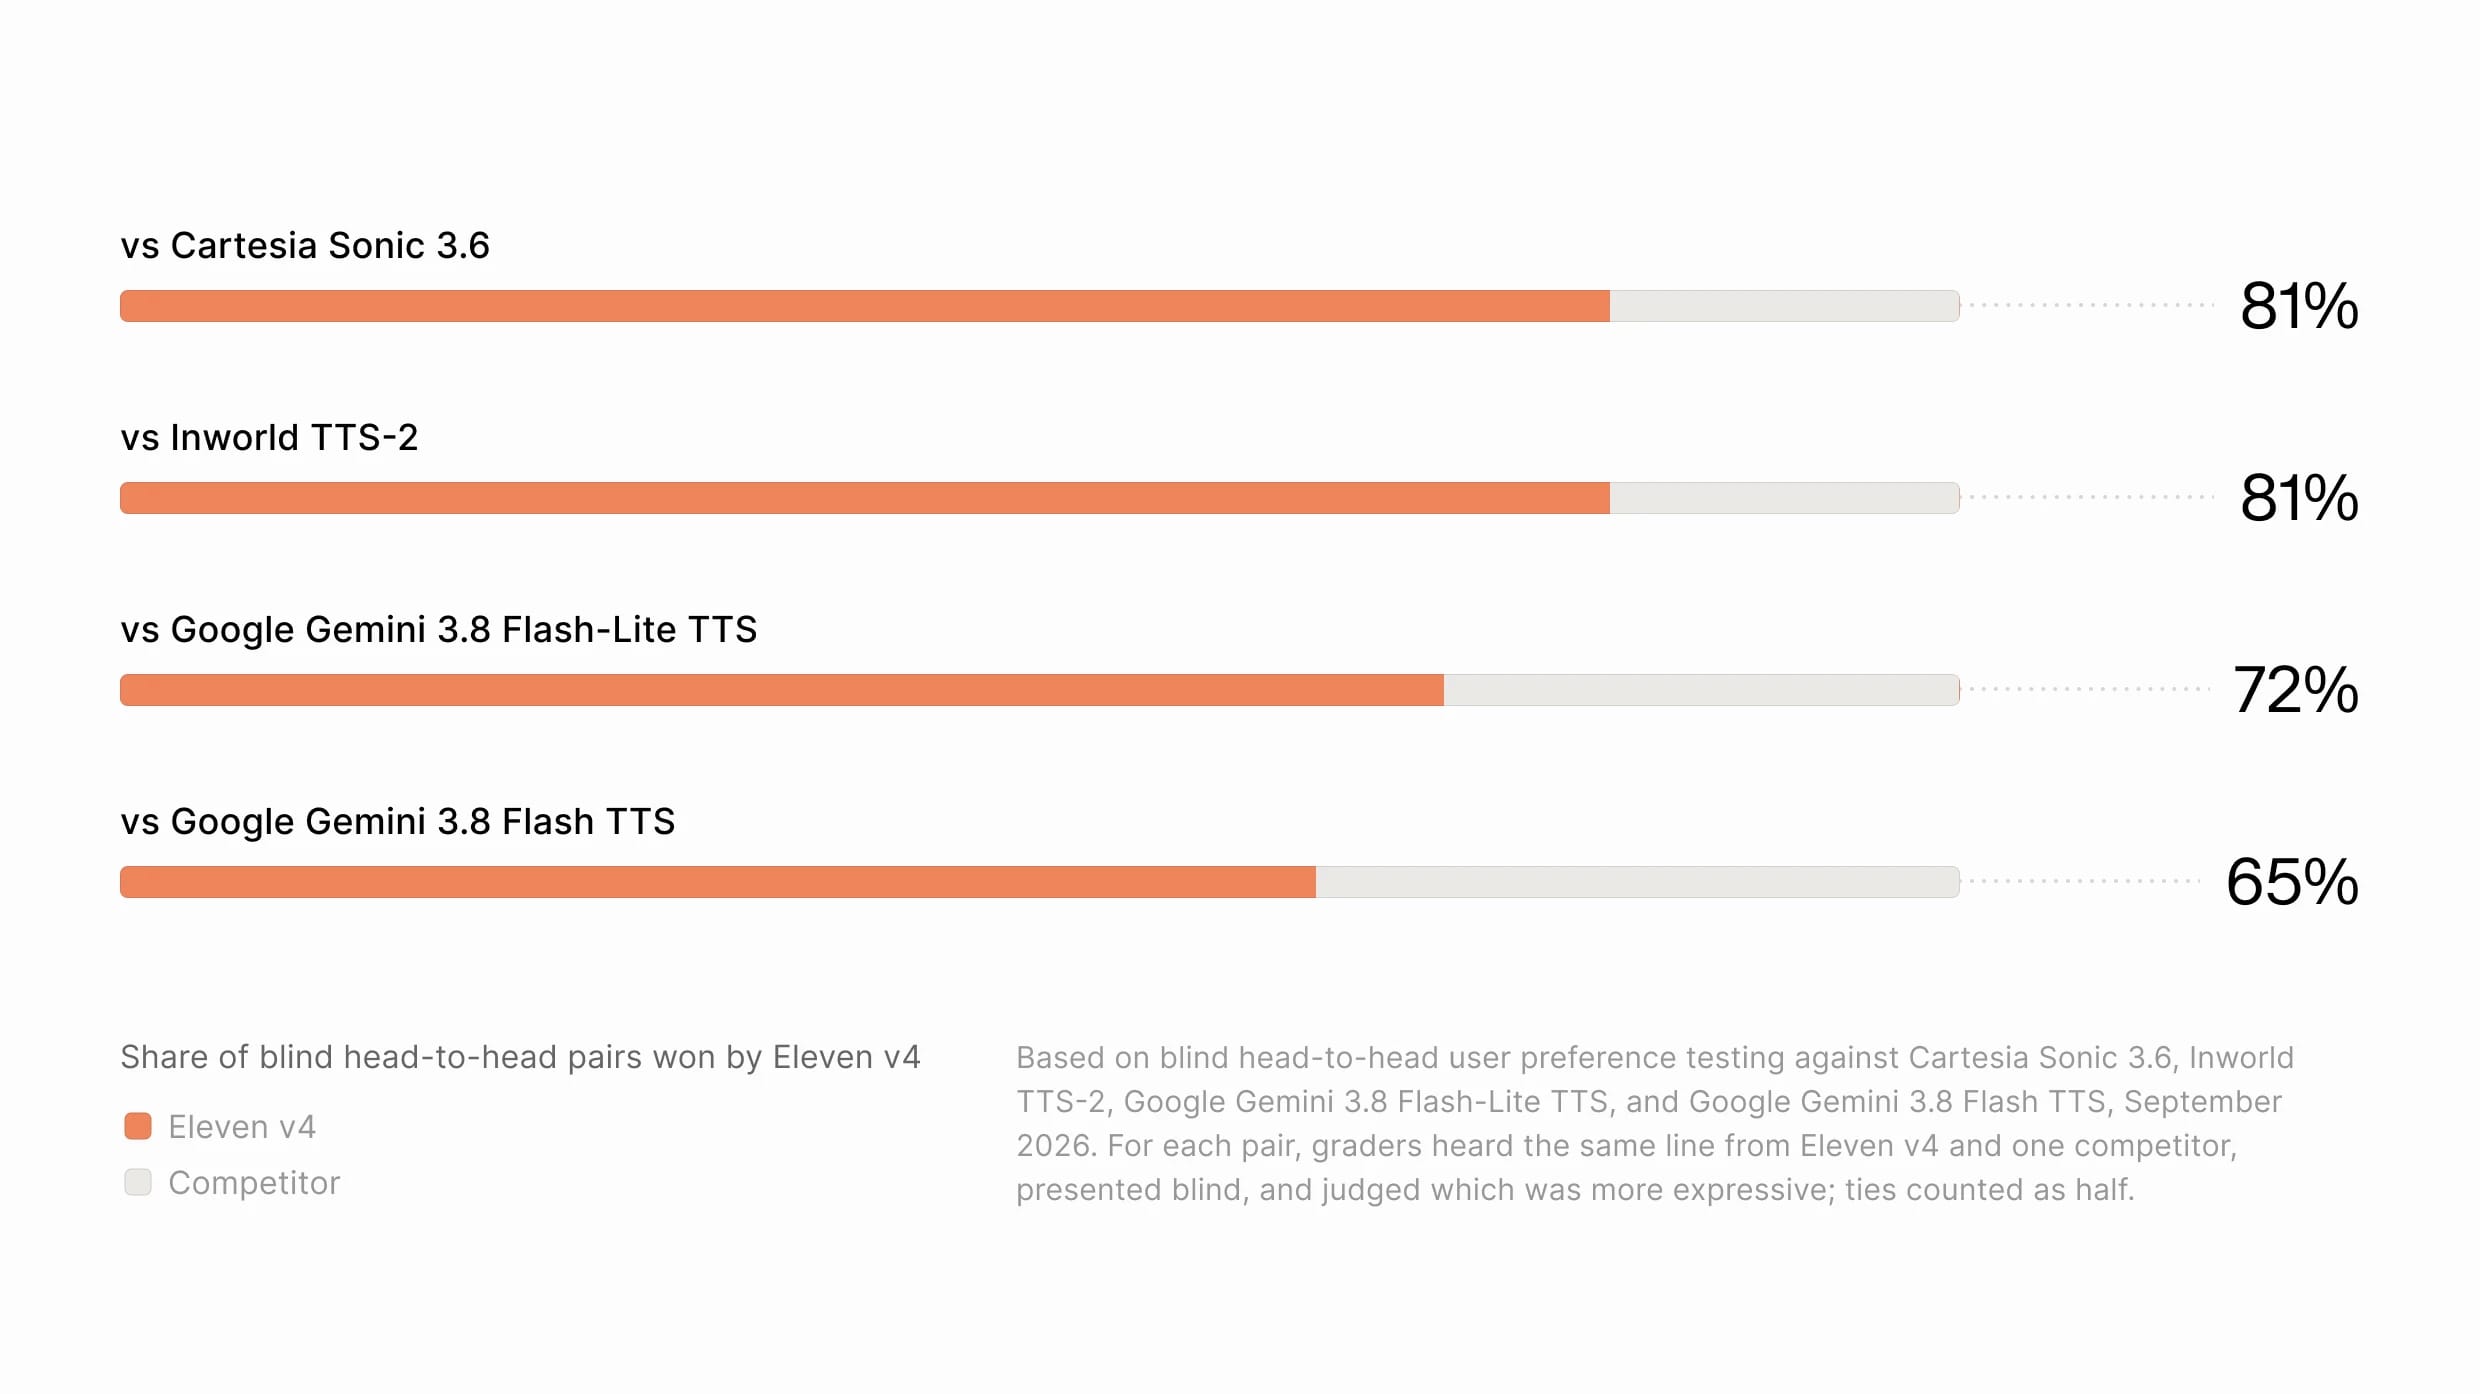
Clasificado en el n.º 1 por Artificial Analysis1, y preferido por aproximadamente el 75 % de oyentes en pruebas comparativas a ciegas frente a modelos de la competencia2, Eleven v4 se ha diseñado para interpretar el tono, el ritmo, la emoción, el personaje y el contexto. Genera voz que puede sonar dramática, tierna, urgente, cómica o conversacional, sin perder la identidad del hablante. Unas dinámicas más naturales entre varios hablantes hacen que las conversaciones se sientan fluidas, en lugar de parecer líneas independientes unidas entre sí. Los hablantes responden al contexto de la conversación, generando diálogos e interacciones entre personajes más naturales.
Una nueva arquitectura diseñada para rendir
Basado en una arquitectura completamente nueva, Eleven v4 es nuestro modelo de Texto a Voz más expresivo, clasificado en el n.º 1 por Artificial Analysis1. Eleven v4 Turbo lleva esta misma tecnología a casos de uso de baja latencia, como los agentes. Con una latencia de inferencia mediana de aproximadamente 100 ms, puede responder más rápido que la pausa media entre dos personas al hablar.
Ambos modelos pueden generar voz expresiva, en lugar de mecánica. La fidelidad de audio subyacente también es mayor en todos los aspectos, con resultados más limpios y naturales.
Las generaciones anteriores de modelos de texto a voz pueden leer texto en voz alta, pero Eleven v4 aporta a la voz una profundidad emocional mucho más natural. El modelo puede interpretar el tono deseado, el ritmo que debe tener la voz, el carácter del texto y su contexto para ofrecer una voz con resonancia emocional.
Usuarios también tienen un control preciso sobre los resultados y pueden describir en lenguaje natural cómo debe pronunciarse una frase. También pueden añadir instrucciones específicas sobre cómo decir determinadas expresiones, qué emoción deben transmitir e incluso efectos de sonido, mediante etiquetas integradas como [laughs], [said angrily in French accent], [light rain] o [phone buzzing]. Eleven v4 sigue estas etiquetas de audio e indicaciones de dirección con más precisión que los modelos anteriores, para que obtengas la entonación que describes. Así es más fácil dirigir narraciones, desarrollar personajes o sus diálogos y trabajar en otros casos donde la entonación importa.
La documentación para desarrolladores de ElevenLabs incluye la sintaxis completa de las etiquetas y cómo aplicarlas mediante la API. También hemos mejorado significativamente la compatibilidad con los fonemas del Alfabeto Fonético Internacional (AFI), por lo que las pronunciaciones personalizadas funcionan de forma más fiable.
Eleven v4 también mejora la consistencia y las conversaciones dinámicas entre varios hablantes. Gracias a un nuevo método para capturar la identidad de los hablantes, Eleven v4 conserva las cualidades únicas de cada voz. Puede mantener una voz consistente en conversaciones de agentes, audiolibros o anuncios. Como el modelo comprende el contexto de toda una escena, genera diálogos naturales en los que los hablantes responden a lo que se acaba de decir, en lugar de unir líneas aisladas.
Un modelo Turbo para casos de uso de baja latencia
Los modelos de voz de alta calidad suelen tardar más en generar voz, por lo que usuarios han tenido que elegir entre agentes de voz rápidos o expresivos agentes de voz. Muchos han optado por agentes eficaces, pero monótonos, que pueden parecer robóticos a un cliente alterado que solo busca resolver su problema.
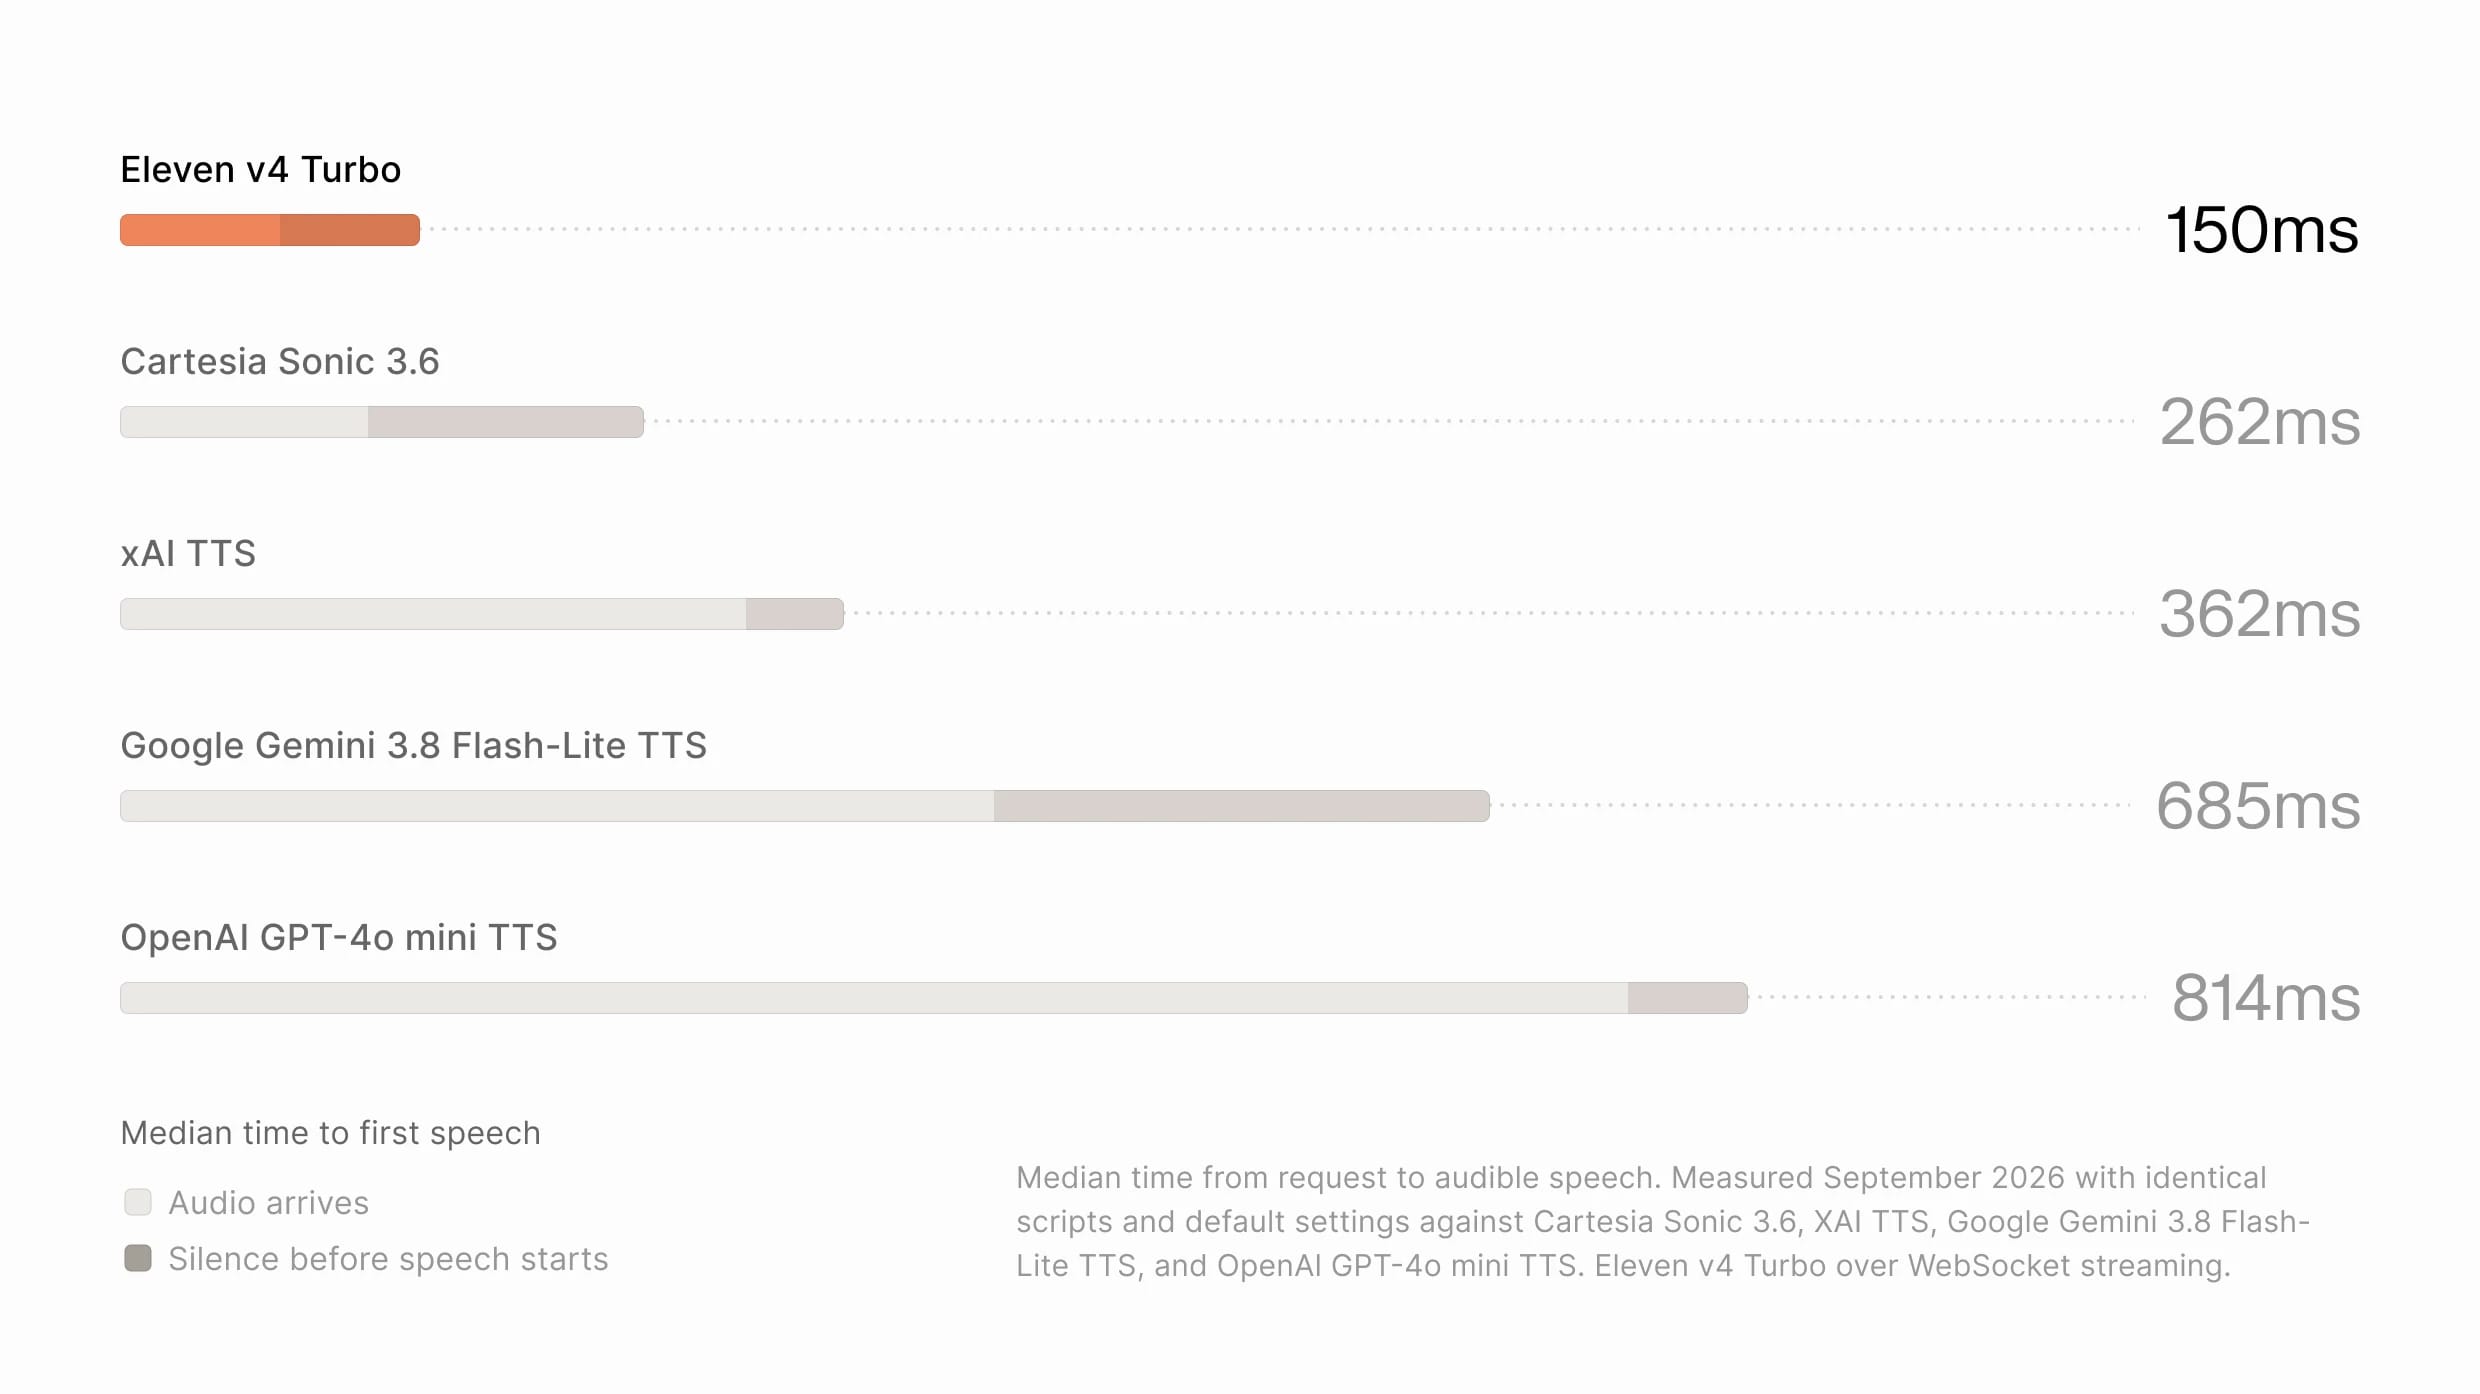
Eleven v4 Turbo combina velocidad y emoción con un tiempo mediano hasta la primera voz de aproximadamente 150 ms3, lo que permite implementar agentes potentes en innumerables sectores: desde agentes cercanos y tranquilizadores que pronuncian correctamente términos médicos en el ámbito sanitario hasta agentes que hablan rápido y usan jerga para entretener a jugadores de videojuegos.
El modelo Eleven v4 Turbo está diseñado para funcionar con la plataforma de agentes conversacionales de ElevenLabs, ElevenAgents. Otros creadores de agentes combinan modelos y software de distintos proveedores, por lo que usuarios no tienen forma de perfeccionar o mejorar los resultados de los modelos para sus casos de uso concretos. Los equipos de investigación e ingeniería de ElevenLabs han optimizado Eleven v4 Turbo y ElevenAgents conjuntamente como un único sistema para ofrecer agentes más expresivos, fiables y de baja latencia.
Una voz, multitud de idiomas
La forma en que nos comunicamos varía según el contexto, el lugar e incluso la hora del día. Crear voz expresiva que refleje todo eso en distintos idiomas sigue siendo uno de los mayores retos del audio creado con IA.
Eleven v4 mejora en todas estas áreas, y sus avances van más allá de cómo el modelo pronuncia las frases. Eleven v4 capta mejor el ritmo, la emoción y la entonación en distintos idiomas, ayudando a creadores a producir voz que resulta natural para cada idioma y contexto. Por ejemplo, la forma en que hablarías con una persona mayor desconocida en Japón es bastante distinta de cómo lo harías en Italia.
Tanto Eleven v4 como Eleven v4 Turbo admiten más de 90 idiomas. Ahora, una voz grabada en un idioma también habla cualquier otro con fluidez, adoptando el acento de un hablante nativo y conservando la identidad de la voz original. La fidelidad al acento es notablemente mayor que antes, por lo que la voz ya no vuelve gradualmente a su acento de origen a lo largo de una generación.
Catalán
Español
Para el doblaje y la localización, esto significa que la voz de marca que hayas elegido —ya sea la de un actor famoso con quien trabajas o un tono que encaje mejor con el estilo de tu empresa— sonará muy bien en cualquier idioma compatible con Eleven v4.
Clonación de voz más auténtica y consistente
La clonación de voz es más auténtica, potente y consistente en Eleven v4 y Eleven v4 Turbo, con una similitud con la voz original significativamente mayor. Ahora, Instant Voice Clones puede capturar voces con gran fidelidad usando solo 10 segundos de audio.
Voz real
Eleven v4
Eleven v4 también conserva la identidad del hablante de forma más fiable entre generaciones, diálogos, narraciones y líneas regeneradas. Esto significa que, en proyectos de larga duración, los personajes, narradores y voces clonadas se mantienen consistentes durante toda la producción. Eleven v4 también incorpora compatibilidad con Professional Voice Clones (PVC) para los casos de uso de clonación que requieren la máxima fidelidad.
El encadenamiento de solicitudes —unir generaciones para crear contenido más extenso— también es mucho más fiable en Eleven v4, lo que mejora la experiencia de trabajar en ElevenLabs Studio y en la app ElevenLabs Reader.
Escucha la diferencia
Eleven v4 y Eleven v4 Turbo son el resultado de nuestras últimas investigaciones en generación de voz expresiva. Están diseñados para contenido en el que la entonación importa tanto como las propias palabras, ya sean audiolibros, interpretaciones de personajes, locuciones, doblaje o la localización de agentes conversacionales.
Ambos modelos ya están disponibles en ElevenAgents, ElevenCreative y a través de ElevenAPI. Crea una cuenta gratuita para empezar a generar con Eleven v4 o Eleven v4 Turbo hoy mismo.
- Artificial Analysis, clasificación Provider Voice Arena, septiembre de 2026
- Basado en pruebas a ciegas de preferencia de usuarios frente a Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS y Google Gemini 3.8 Flash TTS, en septiembre de 2026. En cada pareja, evaluadores escucharon la misma frase de Eleven v4 y de un competidor, presentada a ciegas, y determinaron cuál era más expresiva y cuál sonaba más natural; los empates contaron como medio punto.
- Tiempo mediano desde la solicitud hasta la voz audible. Medido en septiembre de 2026 con guiones idénticos y configuraciones predeterminadas frente a Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS y OpenAI GPT-4o mini TTS; la latencia de red se midió y eliminó en todos los sistemas. Eleven v4 Turbo mediante streaming por WebSocket.