¿Cómo se crean voces sintéticas para que suenen naturales?
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Los sofisticados modelos de IA actuales crean voces sintéticas que suenan como el habla natural. Entrenados con enormes conjuntos de datos de voces humanas reales, estos modelos utilizan redes neuronales avanzadas para identificar y replicar patrones de habla auténticos. Crear una voz sintética también se denomina síntesis de habla o síntesis de voz, mientras que el audio que produce se llama habla sintética.
Para crear una nueva voz sintética, un usuario se graba hablando. Mientras tanto, el modelo de IA analiza sus patrones fonéticos y su entonación únicos, y utiliza estos datos para replicar su voz. Después, el usuario puede ajustar características vocales como el acento, el tono y el ritmo para crear el resultado final. Algunas voces sintéticas son un clon directo del habla de una persona, mientras que otras son una combinación de varias voces. También se pueden diseñar voces a partir de una descripción de texto, sin necesidad de grabación alguna.
Las voces sintéticas abren un amplio abanico de posibilidades creativas para podcasts, audiolibros, videojuegos y publicidad. En este artículo veremos cómo se crean las voces sintéticas, qué hace que suenen naturales y cómo crear tu propia voz sintética con ElevenLabs.
Resumen
- Las voces sintéticas se crean con modelos neuronales de IA que analizan y replican patrones del habla humana.
- Las voces sintéticas sirven para narrar audiolibros, generar diálogos para videojuegos, crear podcasts y locuciones a gran escala, crear agentes de IA para atención al cliente o incluso preservar voces en riesgo de perderse.
- La clonación de voz funciona analizando grabaciones de la voz de una persona concreta y replicando su acento y sus patrones de habla únicos.
- Las voces IA modernas suenan naturales porque replican la prosodia humana y tienen en cuenta el contexto, en lugar de limitarse a reproducir palabras o sílabas individuales.
Cómo se crean las voces sintéticas paso a paso
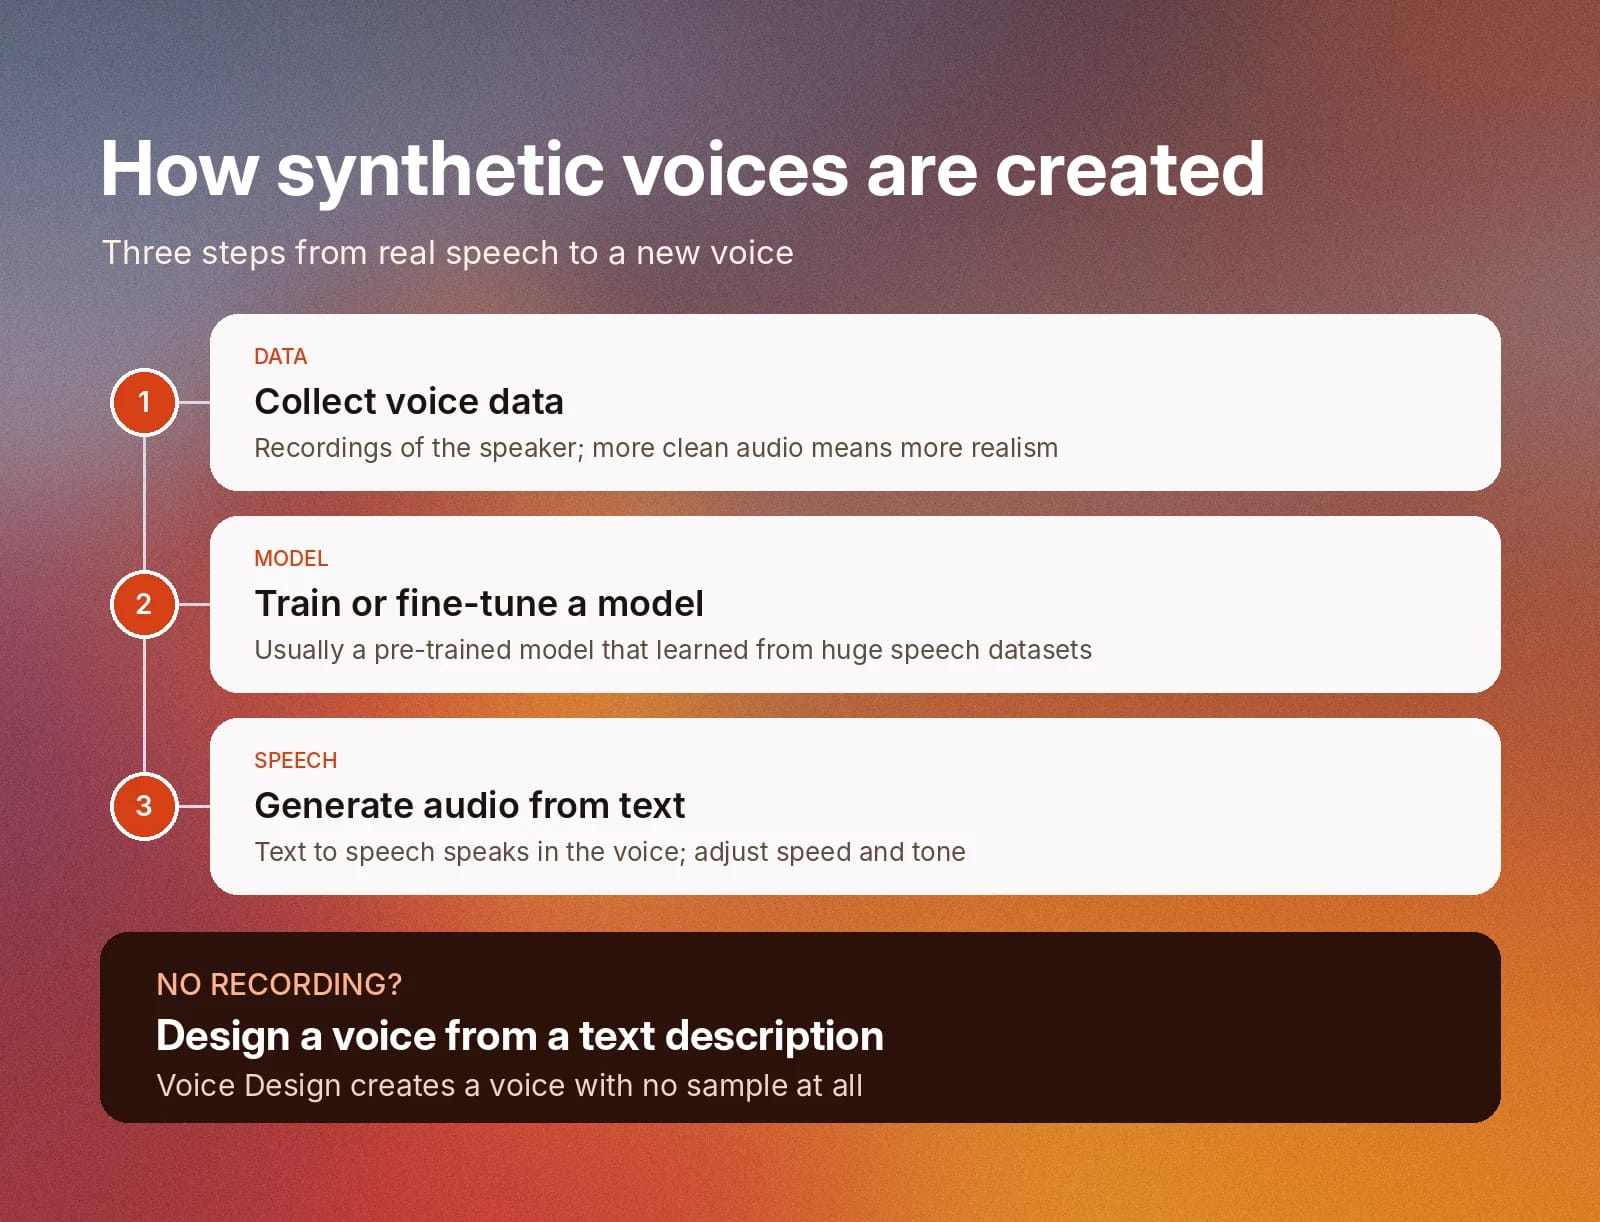
La creación de una voz sintética es un proceso de tres pasos.
Así es como funciona en la práctica:
- Paso 1: Recopila datos de voz: Las voces sintéticas parten del habla humana real. Para crear una nueva voz, necesitarás grabaciones de audio de las personas cuya voz quieras replicar. Cuantos más datos proporciones, más precisa y realista será la voz final. Estas son algunas buenas prácticas para la clonación de voz.
- Paso 2: Entrena o ajusta un modelo de IA: Para crear voces sintéticas, los modelos de IA primero analizan extensos conjuntos de datos con una amplia variedad de grabaciones de habla. Los modelos utilizan estos datos para comprender los patrones del habla humana. Una vez entrenado un modelo de IA, puede clonar voces reales a partir de una sola grabación de voz. En la mayoría de los casos, utilizarás un modelo preentrenado en lugar de crear el tuyo desde cero.
- Paso 3: Genera audio a partir de texto: Las voces sintéticas utilizan Texto a Voz para generar audio. Puedes ajustar factores como la velocidad y el tono para adaptarlos a tus preferencias. Para profundizar, lee nuestra guía sobre cómo funciona la tecnología de texto a voz.
De los datos de voz al Texto a Voz neuronal
Los modelos neuronales de texto a voz se entrenan con numerosos conjuntos de datos de grabaciones de habla real. Estos conjuntos incluyen grabaciones en distintos idiomas, con diferentes acentos, emociones y tonos. El texto a voz neuronal es una forma de síntesis de habla muy utilizada hoy en día.
Los modelos tradicionales unían grabaciones existentes de palabras, sílabas y fonemas. Los resultados eran muy robóticos, ya que no podían replicar las variaciones de tono, ritmo y expresión que hacen que el habla suene humana.
En lugar de limitarse a aprender cómo suenan las letras y las sílabas, los modelos modernos de texto a voz neuronal aprenden patrones naturales de pronunciación humana y ritmos del habla. Al convertir texto en voz, estos modelos analizan el texto, lo transforman en características acústicas y luego utilizan esas características para generar formas de onda.
Como las características acústicas, como el tono, el ritmo y el timbre, están integradas en los modelos neuronales de IA, el habla resultante suena mucho más natural y auténtica que la de los modelos del pasado.
Los resultados también son personalizables: puedes cambiar factores como la velocidad, la emoción e incluso el acento para obtener exactamente la voz que buscas. Por ejemplo, tu marca podría usar la misma voz sintética en toda su web, pero transmitir entusiasmo y urgencia en contenido de marketing y serenidad en las interacciones de atención al cliente.
Texto a voz estándar, neuronal y generativo
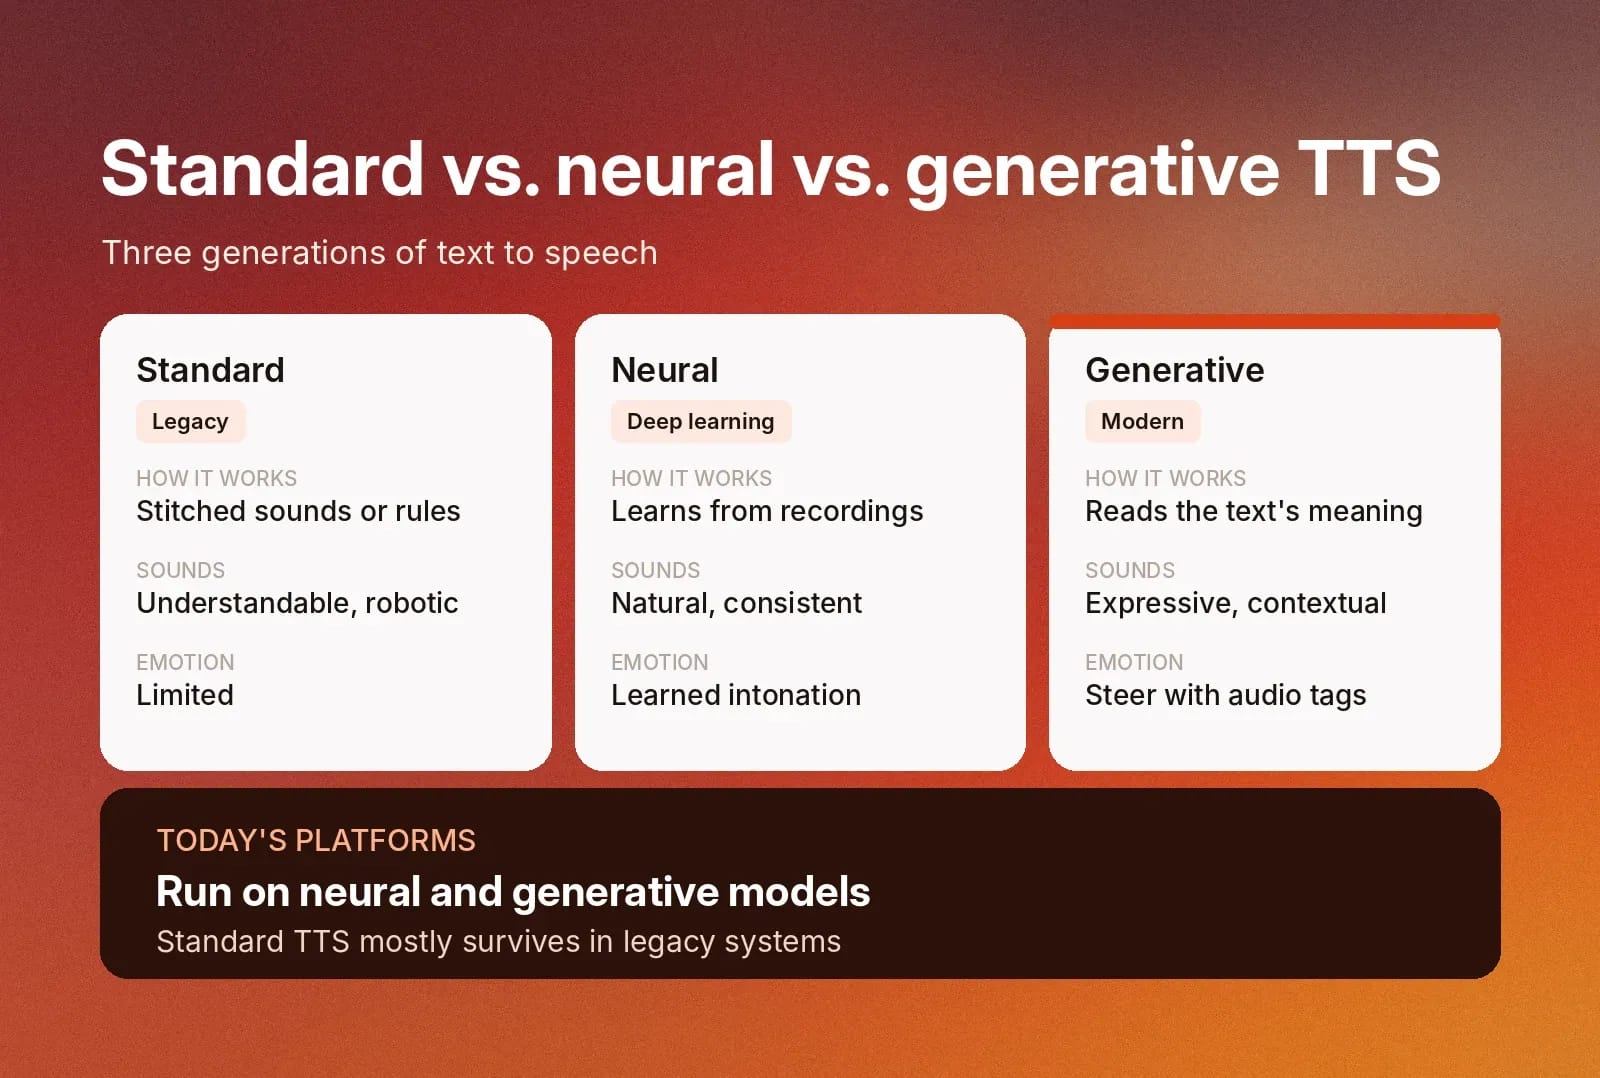
Los modelos de texto a voz se dividen en tres grandes generaciones.
Comprender sus diferencias ayuda a entender por qué los modelos modernos, como Texto a Voz de ElevenLabs, pueden sonar tan naturales.
- Texto a voz estándar: Estos sistemas unen sonidos pregrabados o siguen reglas y modelos estadísticos para pronunciar texto. El resultado es comprensible, pero robótico y con una emoción limitada.
- Texto a voz neuronal: Los modelos de aprendizaje profundo aprenden pronunciación, ritmo y entonación a partir de grandes conjuntos de grabaciones y generan un habla mucho más natural y coherente.
- Texto a voz generativo: Los modelos generativos se entrenan con datos de habla aún más amplios y variados, y utilizan el significado del texto para decidir la emoción, el ritmo y el énfasis. Puedes guiar su entonación con instrucciones, como etiquetas de audio.
Las plataformas de voz modernas utilizan modelos neuronales y generativos, mientras que el texto a voz estándar sobrevive principalmente en sistemas heredados.
¿Qué hace que la generación de voz con IA suene natural?
Las voces sintéticas generadas por IA suenan muy parecidas a las voces humanas. De hecho, puede resultar difícil distinguirlas si no escuchas con atención.
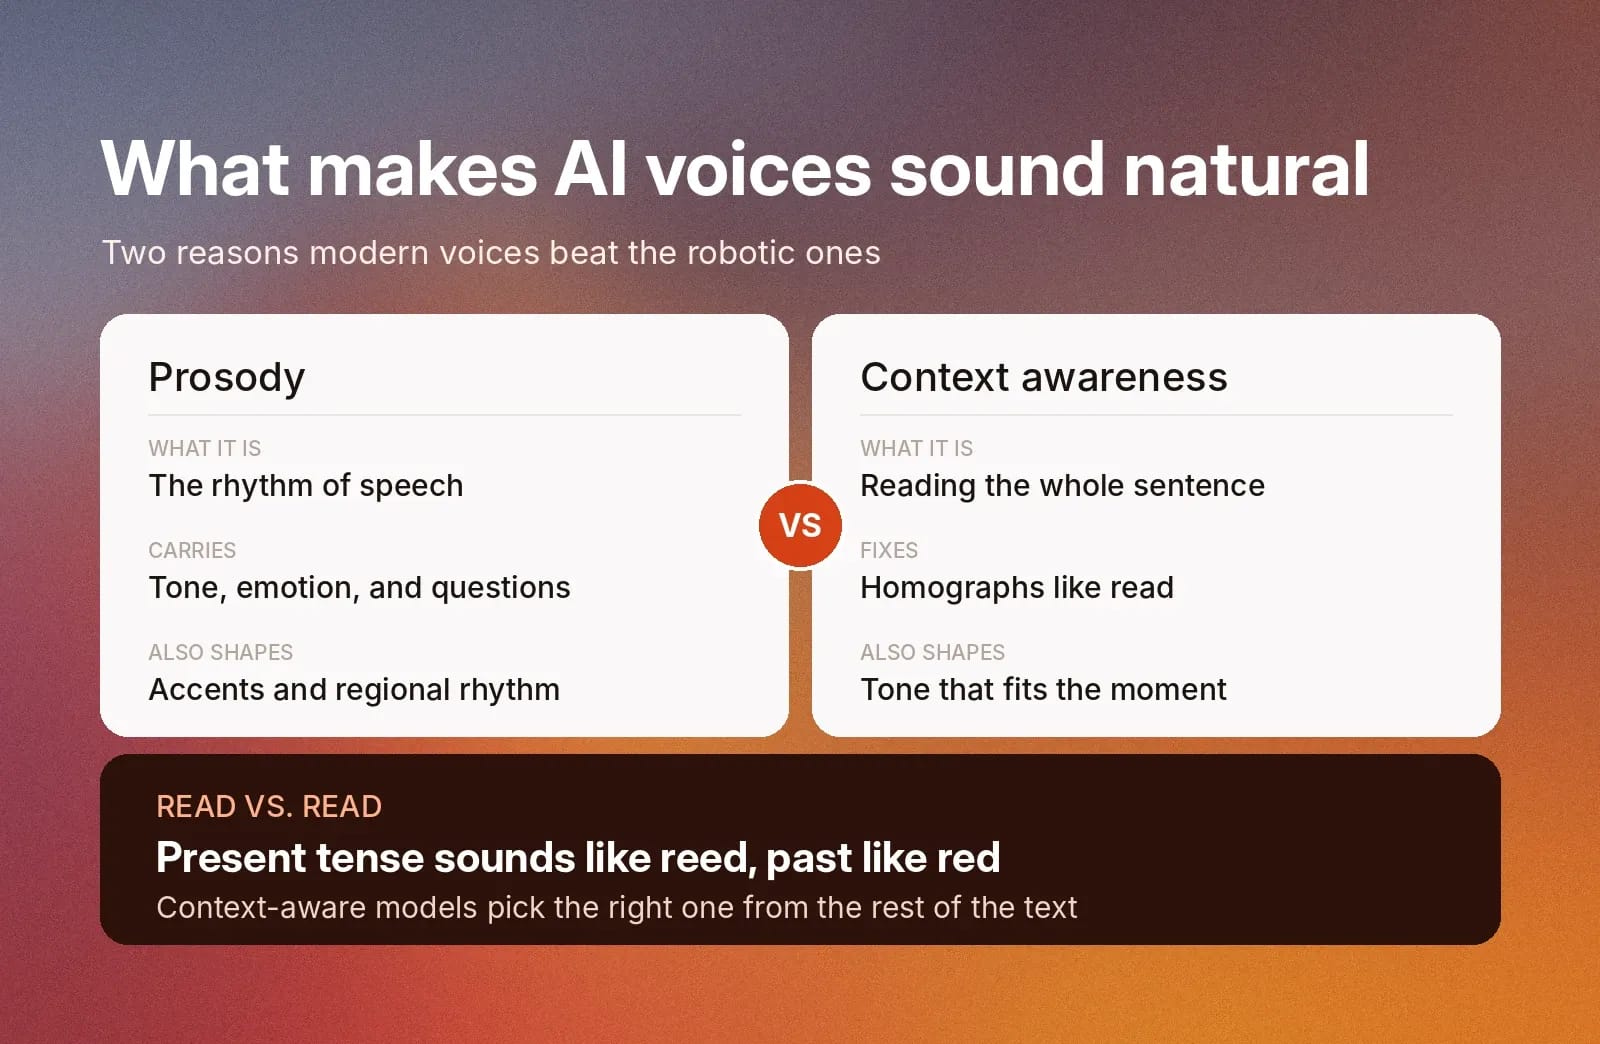
Hay dos motivos por los que las voces generadas por IA suenan más naturales que las voces robóticas del pasado: la prosodia y la comprensión del contexto.
Prosodia
La prosodia es el ritmo del habla humana natural. Los pequeños cambios en la entonación y la velocidad transmiten tono y emoción cuando hablamos. Por ejemplo, hablar rápido puede transmitir estrés o entusiasmo, mientras que elevar el tono al final de una frase convierte una afirmación en una pregunta.
Los modelos de voz IA actuales están entrenados para comprender y replicar la prosodia. Esto significa que el resultado refleja el flujo de una conversación humana natural, en lugar de sonar rígido o plano.
Si utilizas una voz sintética para narrar un audiolibro o crear diálogos para videojuegos, empleará la prosodia para reflejar las emociones del personaje. Si creas una locución para contenido educativo o un agente de IA de atención al cliente, el modelo de IA ajustará la prosodia para ofrecer una entonación tranquila y empática.
Al comprender la prosodia, los modelos de IA también pueden replicar acentos únicos. Por ejemplo, el ritmo de un acento inglés norteamericano suena muy distinto al de un acento inglés británico, escocés o irlandés, aunque hablen el mismo idioma.
Comprensión del contexto
En lugar de procesar cada palabra individualmente, los modelos TTS basados en IA analizan la frase, la oración o la conversación completa y ajustan la entonación según el contexto.
Por ejemplo, hay muchas palabras que se escriben igual, pero se pronuncian de forma distinta según el tiempo verbal y el contexto. Por ejemplo, la palabra inglesa «read» se pronuncia como «reed» en presente, pero como «red» en pasado.
Como las voces IA tienen en cuenta el contexto, identifican la pronunciación adecuada basándose en el resto del texto. También ajustan su entonación para que el tono y la emoción sean apropiados para la situación.
¿Cómo funciona la clonación de voz?
La clonación de voz utiliza IA para analizar la voz de una persona real y aplicar después sus características vocales al habla sintética.
Primero, la persona que clona su voz debe proporcionar una muestra de audio corta. El modelo de IA utiliza la muestra para identificar el acento, el tono, el timbre y la cadencia de la persona. El modelo emplea estas características para crear una réplica digital de su voz. Los usuarios pueden generar nuevo habla con esa voz mediante tecnología de texto a voz.
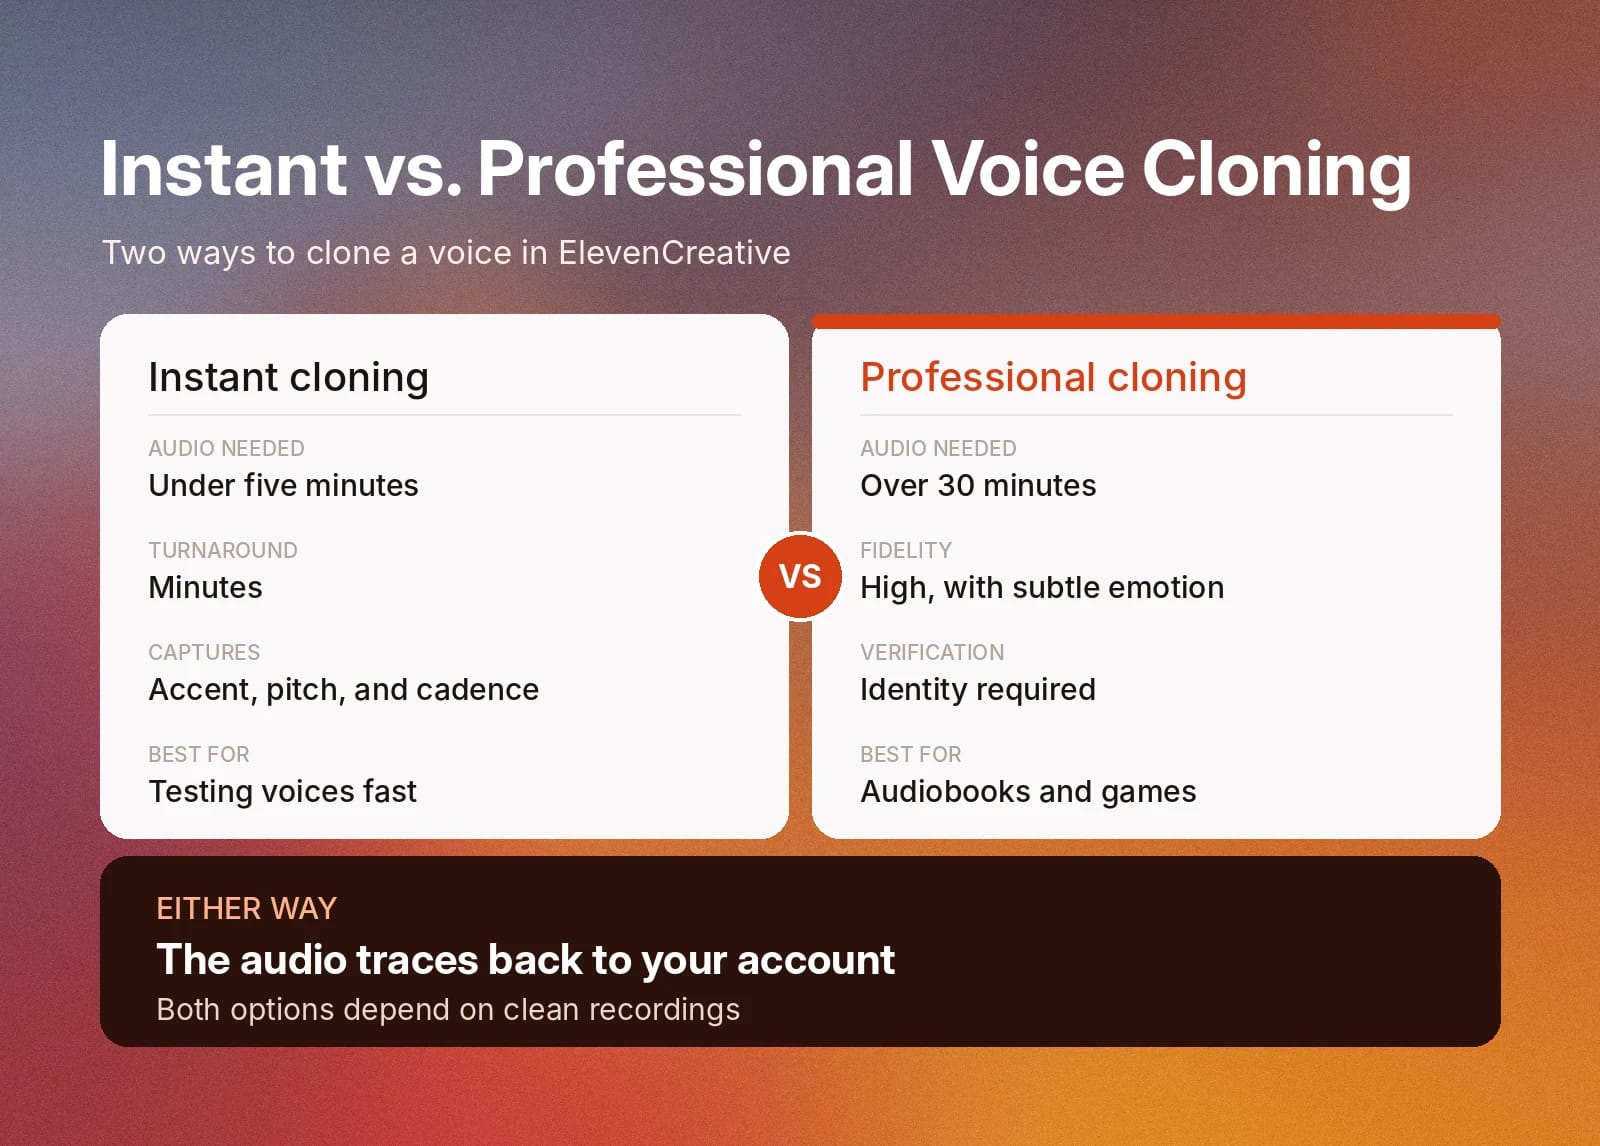
Hay dos tipos de clonación de voz: instantánea y profesional. La clonación instantánea crea una réplica de voz con menos de dos minutos de audio de muestra. Esto facilita probar opciones de voz antes de comprometerte con un proyecto mayor.
La clonación profesional utiliza entre 30 minutos y tres horas de muestras de audio para crear un clon de voz de alta fidelidad. Los clones de voz profesionales conservan detalles sutiles, como la emoción y la entonación, que no están presentes en los clones instantáneos. También requieren verificación de identidad.
La clonación de voz tiene diversos usos, desde generar locuciones rápidamente hasta preservar voces que, de otro modo, podrían perderse.
Cómo grabar buenas muestras de voz para la síntesis de habla
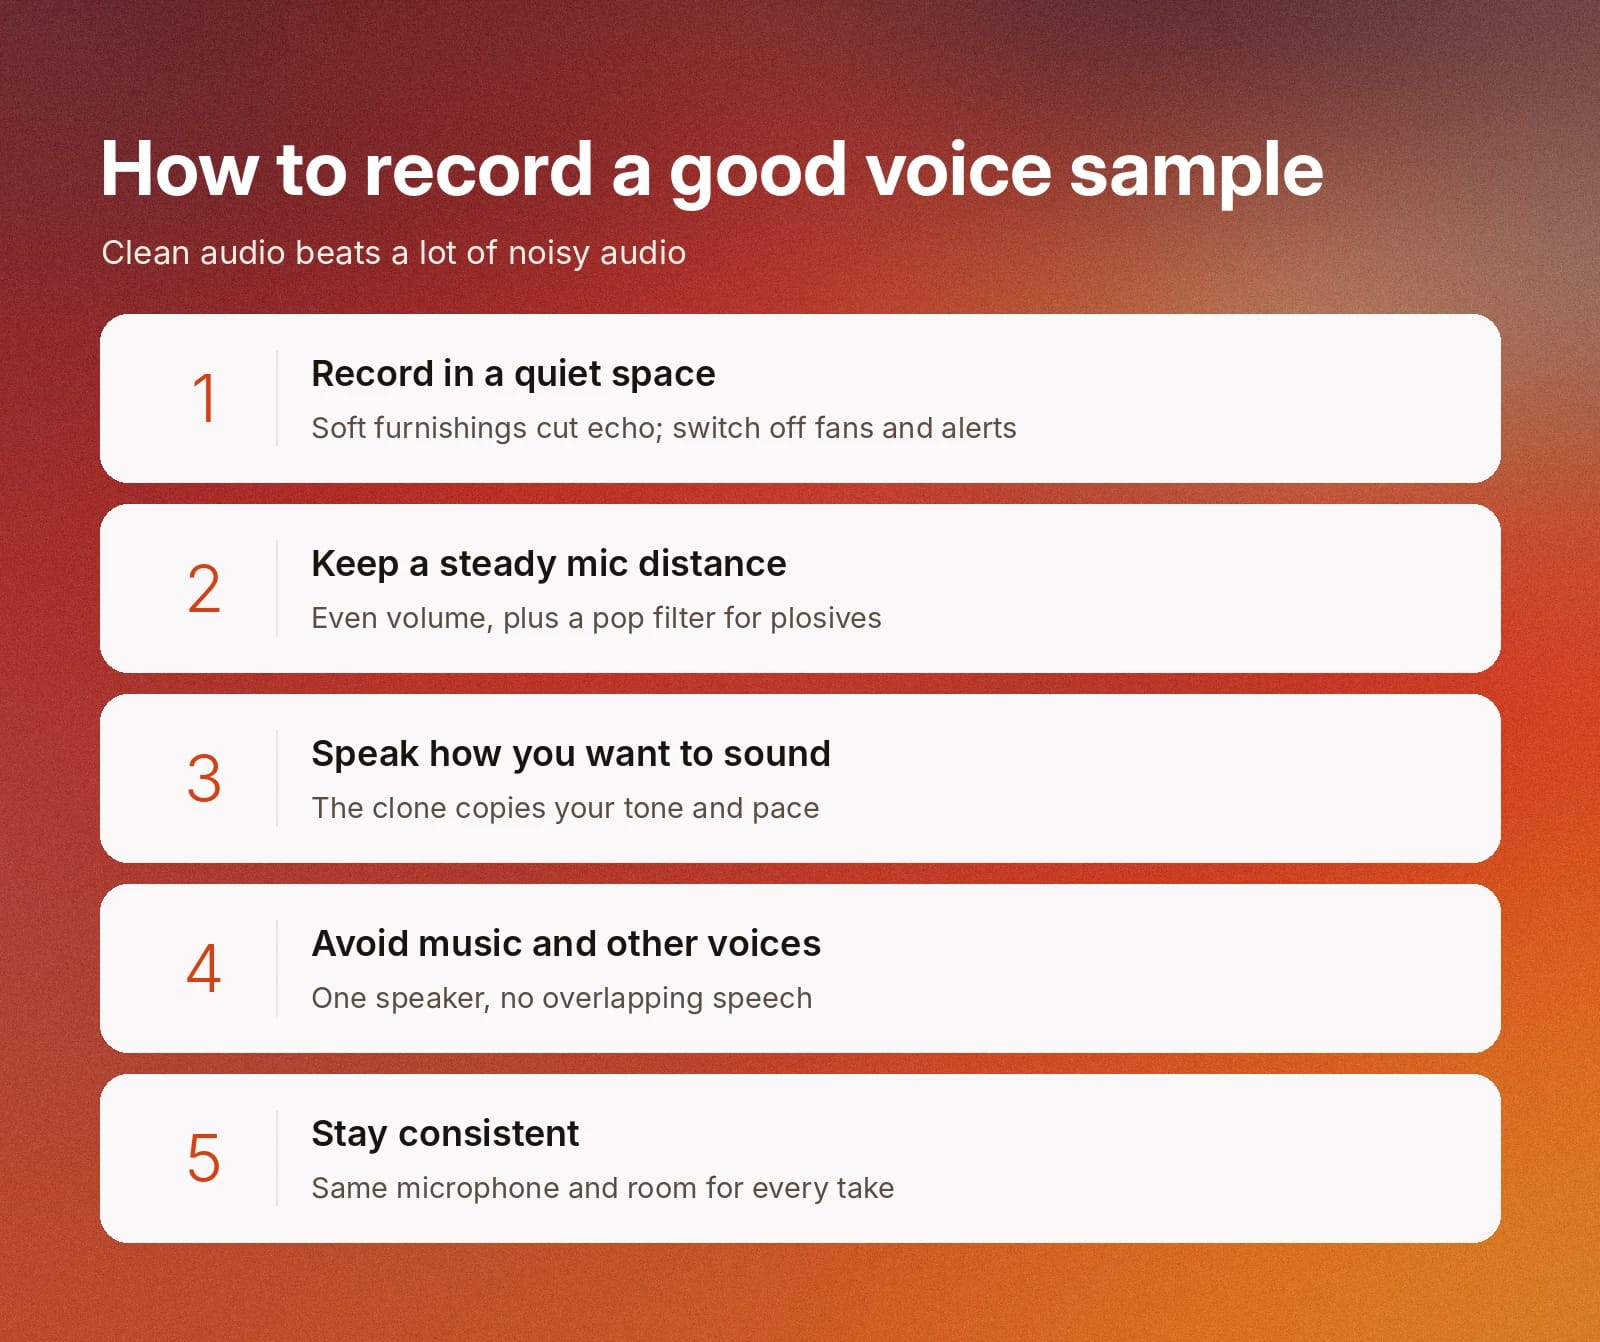
La calidad de un clon de voz depende de la calidad de la grabación. Incluso sin equipos de grabación caros, puedes hacer muchas pequeñas cosas para mejorar cómo suena tu clon de voz.
Estos hábitos te ayudan a obtener muestras limpias:
- Graba en un espacio silencioso: Los muebles blandos, como las cortinas y las alfombras, reducen el eco, y apagar ventiladores y notificaciones elimina el ruido de fondo.
- Mantén el micrófono a una distancia constante: Una distancia uniforme mantiene el volumen estable y un filtro antipop reduce los sonidos oclusivos fuertes.
- Habla como quieres que suene el clon: El clon copia tu entonación. Graba con el tono y el ritmo que tengas pensado usar.
- Evita la música y otras voces: Utiliza un único hablante, sin música de fondo ni voces superpuestas.
- Mantén la coherencia: Utiliza el mismo micrófono y la misma sala en todas tus grabaciones.
Aunque la clonación instantánea necesita menos audio y la profesional necesita más, ambas dependen de grabaciones limpias. Un audio limpio con la duración adecuada ofrece mejores resultados que una gran cantidad de audio con ruido.
Cómo crear una voz sin grabar: Diseño de voz
No todas las voces sintéticas empiezan con una grabación. Con Diseño de voz, describes por texto la voz que quieres, incluidos detalles como la edad, el género, el acento, el tono y el ritmo, y el modelo de IA genera opciones de voz que se ajustan a tu descripción. Puedes escuchar las opciones, elegir la que prefieras y guardarla en tu biblioteca de voces.
Diseño de voz resulta útil cuando necesitas una voz para un personaje, una marca o un producto y no hay una persona real que clonar. Lee la documentación de Diseño de voz para aprender a escribir descripciones de voz eficaces.
Cómo saber si una voz se ha generado con IA
No hay una única señal que demuestre que una voz se ha generado con IA. Combinar una escucha atenta, herramientas de detección y una comprobación del origen del audio funciona mejor que depender de cualquiera de estos elementos por separado.
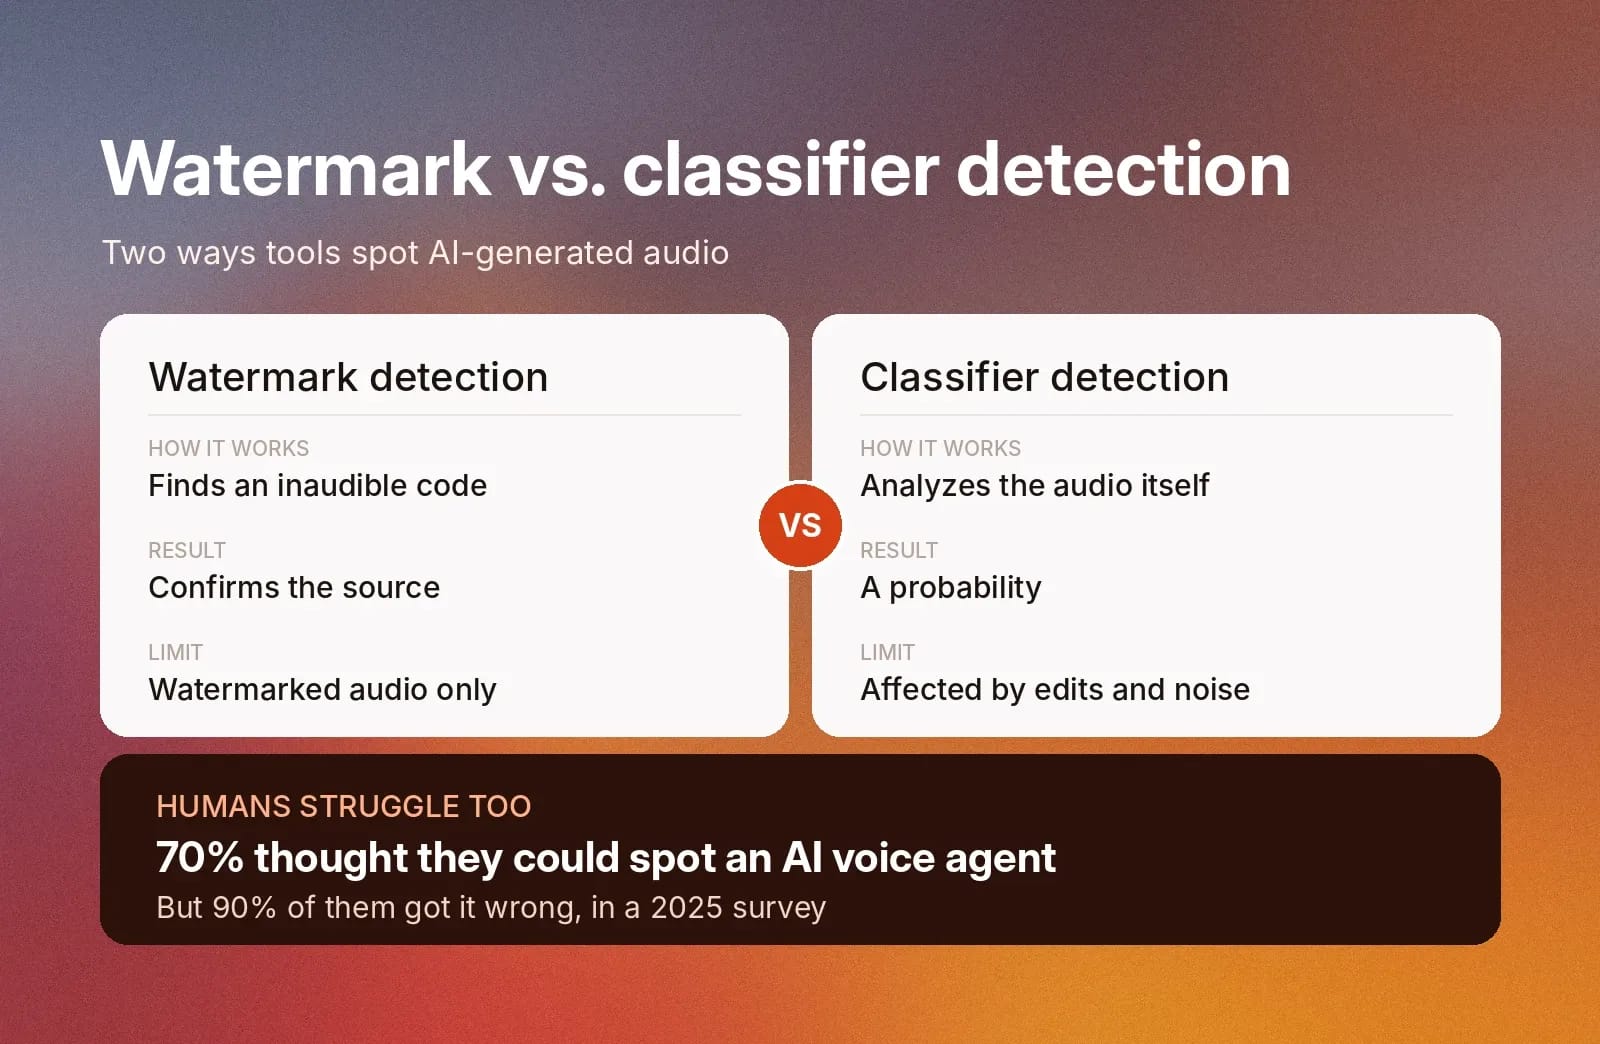
Muchas personas creen que pueden distinguir entre una voz real y otra generada por IA, pero no siempre aciertan. Una encuesta de 2025 reveló que el 70 % de consumidores creía poder identificar correctamente a un agente de voz IA, pero el 90 % no lo consiguió.
En lugar de depender del oído humano, puedes utilizar una herramienta de detección. Estas herramientas funcionan principalmente de dos formas:
- Detección de marcas de agua: Algunos proveedores de IA insertan una marca de agua, un código que los humanos no pueden oír, en el audio que generan. Un detector puede encontrar la marca de agua y confirmar de dónde procede el audio. Esto solo funciona con audio que incluye una marca de agua.
- Detección basada en clasificadores: Un clasificador analiza el audio y estima la probabilidad de que se haya generado con IA. Puede señalar audio que no tenga marca de agua, pero el resultado es una probabilidad y puede verse afectado por la compresión, el ruido de fondo o la edición.
Ninguno de los métodos es perfecto. Considera el resultado de detección como una prueba más y compáralo con lo que sabes sobre la fuente. Hemos escrito una guía sobre la detección de deepfakes de audio, que profundiza más en este tema.
ElevenLabs Speech Classifier es una herramienta que identifica la probabilidad de que una muestra de audio se haya generado con modelos de voz IA de ElevenLabs. ElevenLabs también se ha asociado con Reality Defender en iniciativas de detección de deepfakes para identificar y prevenir el fraude de voz.
En qué fijarte al escuchar
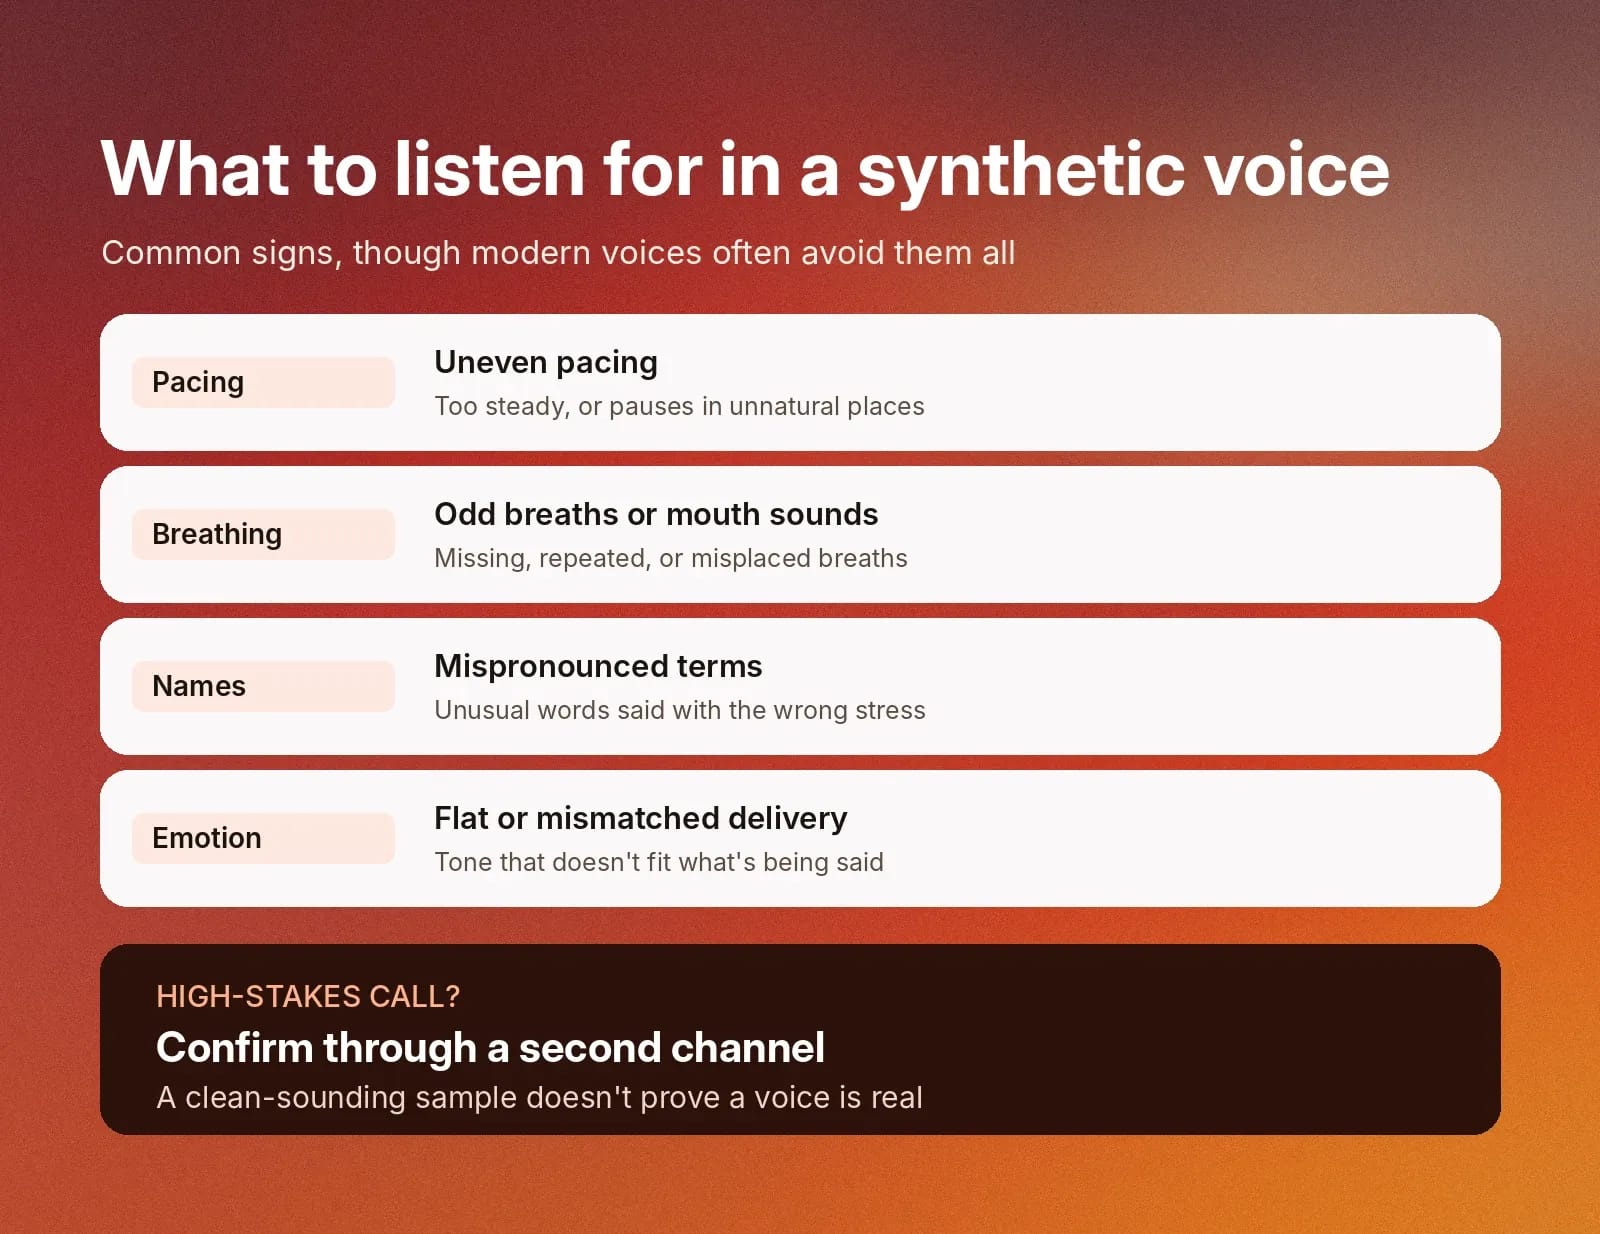
Las herramientas de detección no siempre están a mano, por lo que conviene conocer las señales habituales de una voz sintética.
Presta atención a:
- Ritmo irregular: Un habla demasiado constante o con pausas en lugares poco naturales.
- Sonidos extraños de respiración o boca: Respiraciones que faltan, se repiten o aparecen en lugares inadecuados. Podrían indicar artefactos de audio generados involuntariamente por un modelo.
- Nombres o términos mal pronunciados: Palabras poco habituales dichas con el acento equivocado. Esto es aún más común en idiomas que usan tildes para enfatizar determinadas sílabas de las palabras, como el español.
- Emoción plana o que no encaja: Una entonación que no se ajusta al significado de las palabras. Esto demuestra falta de comprensión del propio texto, un problema habitual en los modelos TTS heredados.
Las voces sintéticas modernas suelen evitar todos estos problemas. Una muestra que suena limpia no demuestra que una voz sea real. Para cualquier situación de alto riesgo, como una llamada en la que te piden dinero, confirma la información a través de un segundo canal.
Crea experiencias de voz personalizadas con ElevenCreative
ElevenCreative te ayuda a crear experiencias de voz personalizadas para tus proyectos creativos. Elige entre una amplia biblioteca de más de 20 000 voces prediseñadas o crea la tuya con una clonación de voz precisa y segura.
Utiliza ElevenCreative para replicar tu voz con Clonación de voz instantánea o Clonación de voz profesional. La Clonación de voz instantánea funciona en minutos para ayudarte a probar opciones de voz o poner en marcha proyectos personales rápidamente. La Clonación de voz profesional utiliza muestras de audio más largas para crear voces de alta calidad, ideales para proyectos extensos como audiolibros, videojuegos o podcasts. Elijas la opción que elijas, el audio queda vinculado a tu cuenta por motivos de seguridad.
La Biblioteca de voces personalizable de ElevenCreative y sus herramientas de clonación de voz te ayudan a dar vida a tus proyectos creativos. Regístrate en ElevenCreative para explorar voces icónicas o crear la tuya.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.