Detección de deepfakes de audio: cómo funciona y cómo verificar audio de ElevenLabs
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
La detección de deepfakes de audio es el proceso de analizar audio de voz para determinar si el habla es auténtica. Los sintetizadores de voz IA que generan deepfakes son cada vez más accesibles. Tanto en la vida pública como en las empresas, es importante identificar rápidamente si lo que oyes es real o ha sido manipulado por un actor malicioso.
En este artículo, exploraremos cómo funciona la detección de deepfakes de audio, los distintos tipos de detección, sus puntos fuertes y débiles, y cómo integrar la detección de deepfakes en sistemas de detección de fraude a gran escala.
Resumen
- Cada vez es más difícil detectar por oído el habla sintetizada mediante deepfakes. Supone un riesgo importante tanto para la vida pública como para las empresas.
- Existen varios tipos de software de detección de deepfakes. Las herramientas convencionales usan análisis estadísticos para evaluar la probabilidad de que una muestra de audio haya sido generada por IA.
- La nueva tecnología de marcado de agua permite obtener una respuesta definitiva de sí o no sobre si una muestra de voz fue sintetizada.
- El marcado de agua es muy preciso, pero los detectores solo funcionan con el audio propio de cada proveedor. Por ejemplo, Audio Detector de ElevenLabs puede identificar con gran precisión las marcas de agua generadas por sus propios productos, pero no las de otras empresas.
- El marcado de agua es un recurso importante para organizaciones que necesitan detectar deepfakes a gran escala, pero debe ser solo una de las muchas herramientas de su sistema de detección de deepfakes.
¿Qué es la detección de deepfakes de audio?
La detección de deepfakes de audio es el proceso de determinar si un audio de voz ha sido generado o manipulado por inteligencia artificial.
Un deepfake es cualquier tipo de contenido multimedia —normalmente imagen, vídeo o audio— creado por una aplicación de IA generativa con el fin de tergiversar lo que alguien dice o hace. Los deepfakes de audio tienen muchos usos maliciosos. Pueden utilizarse para cometer fraude, intentar acceder a cuentas personales, hacer propaganda política o suplantar en secreto a una pareja o familiar en disputas domésticas.
Según las tendencias actuales, las víctimas de las estafas con deepfakes de audio tienen más probabilidades de ser:
- Políticos y otras figuras públicas: Personas con numerosas muestras de voz disponibles en internet para entrenamiento podrían ver su voz falsificada mediante deepfake por adversarios o terceros para engañar a la opinión pública.
- Familiares: Un actor malicioso puede intentar usar grabaciones de voz encontradas para estafar a familiares mayores mediante solicitudes de dinero falsas creadas con deepfakes.
- Directivos de empresas: Entrevistas, presentaciones y llamadas de resultados falsificadas podrían utilizarse para dañar la reputación de una empresa.
- Equipos de atención al cliente: Los estafadores podrían usar muestras de voz recopiladas para engañar a equipos de atención al cliente y conseguir acceso a cuentas privadas.
Por desgracia, las personas no detectamos los deepfakes de forma fiable. En entornos de investigación controlados, la capacidad de las personas para identificarlos no es mejor que el azar, y esa investigación es de 2024. Desde entonces, los medios generativos se han vuelto mucho más sofisticados.
La educación y la legislación contribuirán mucho a proteger a la sociedad de la influencia de los deepfakes, pero siguen siendo necesarios métodos de detección fiables.
¿Cómo funciona la detección de deepfakes de audio?
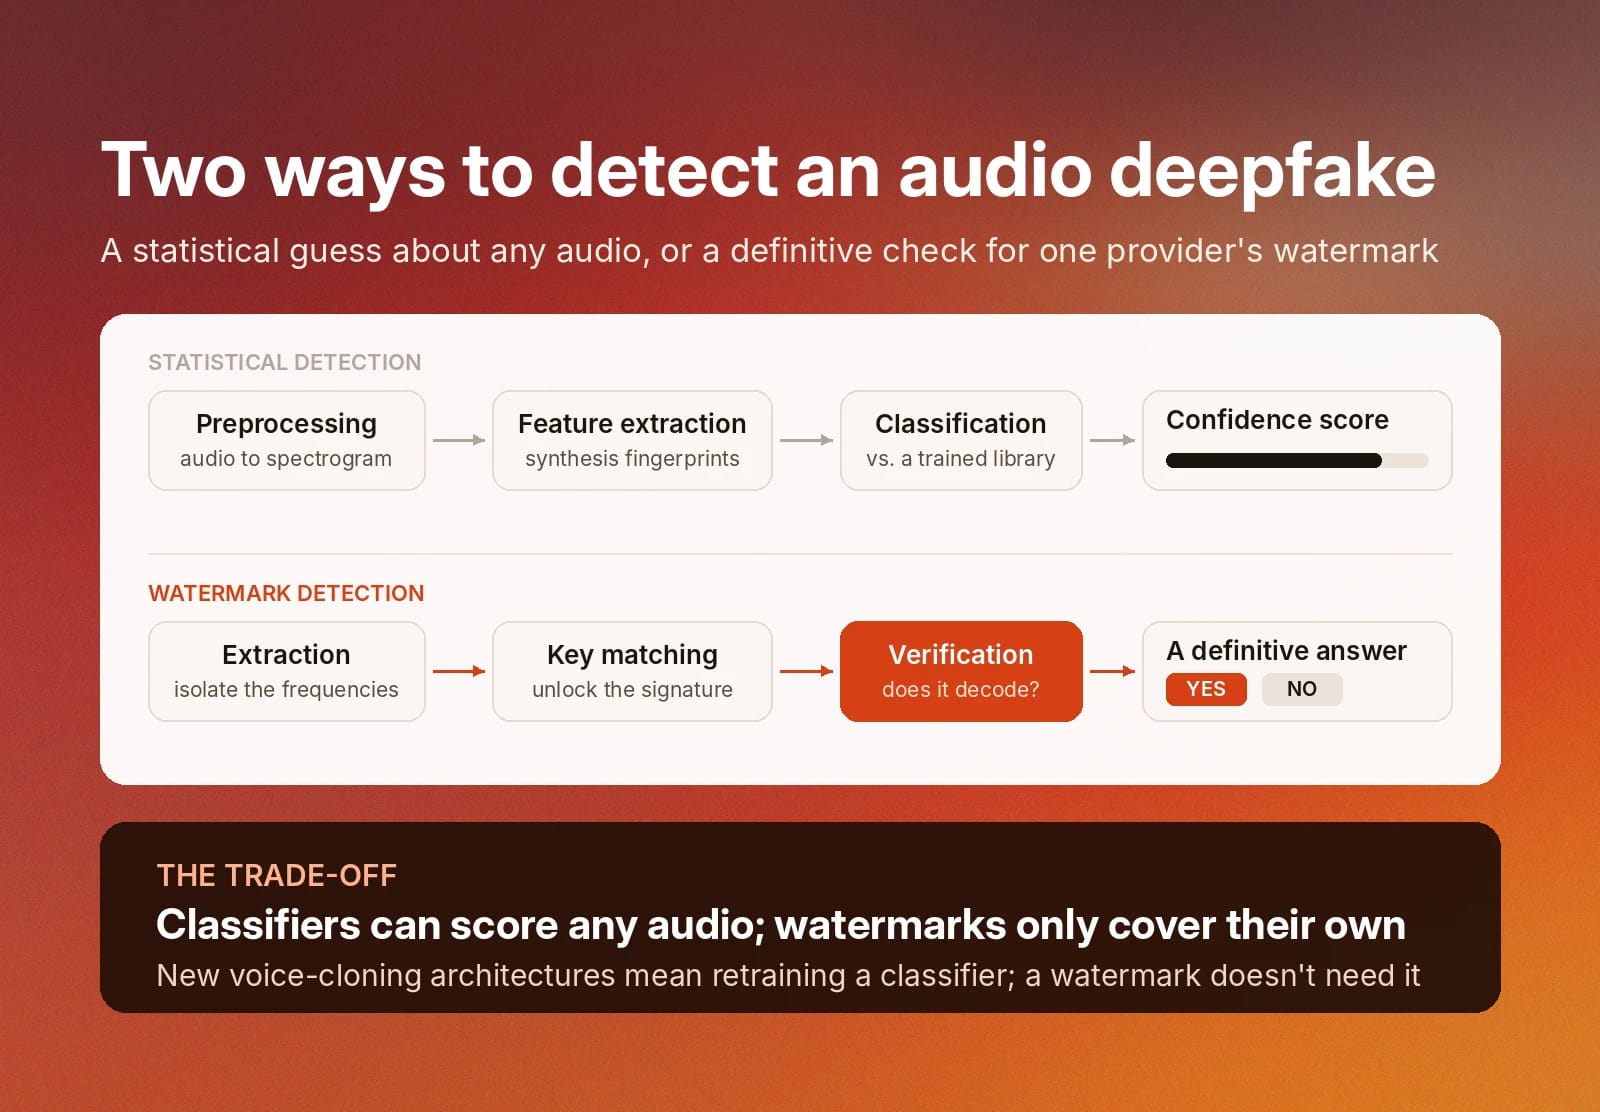
La detección convencional de deepfakes utiliza análisis estadísticos para medir la probabilidad de que un contenido haya sido generado por una IA. Una herramienta de detección emplea técnicas de aprendizaje automático para reconocer los patrones subyacentes de distintos tipos de habla sintetizada.
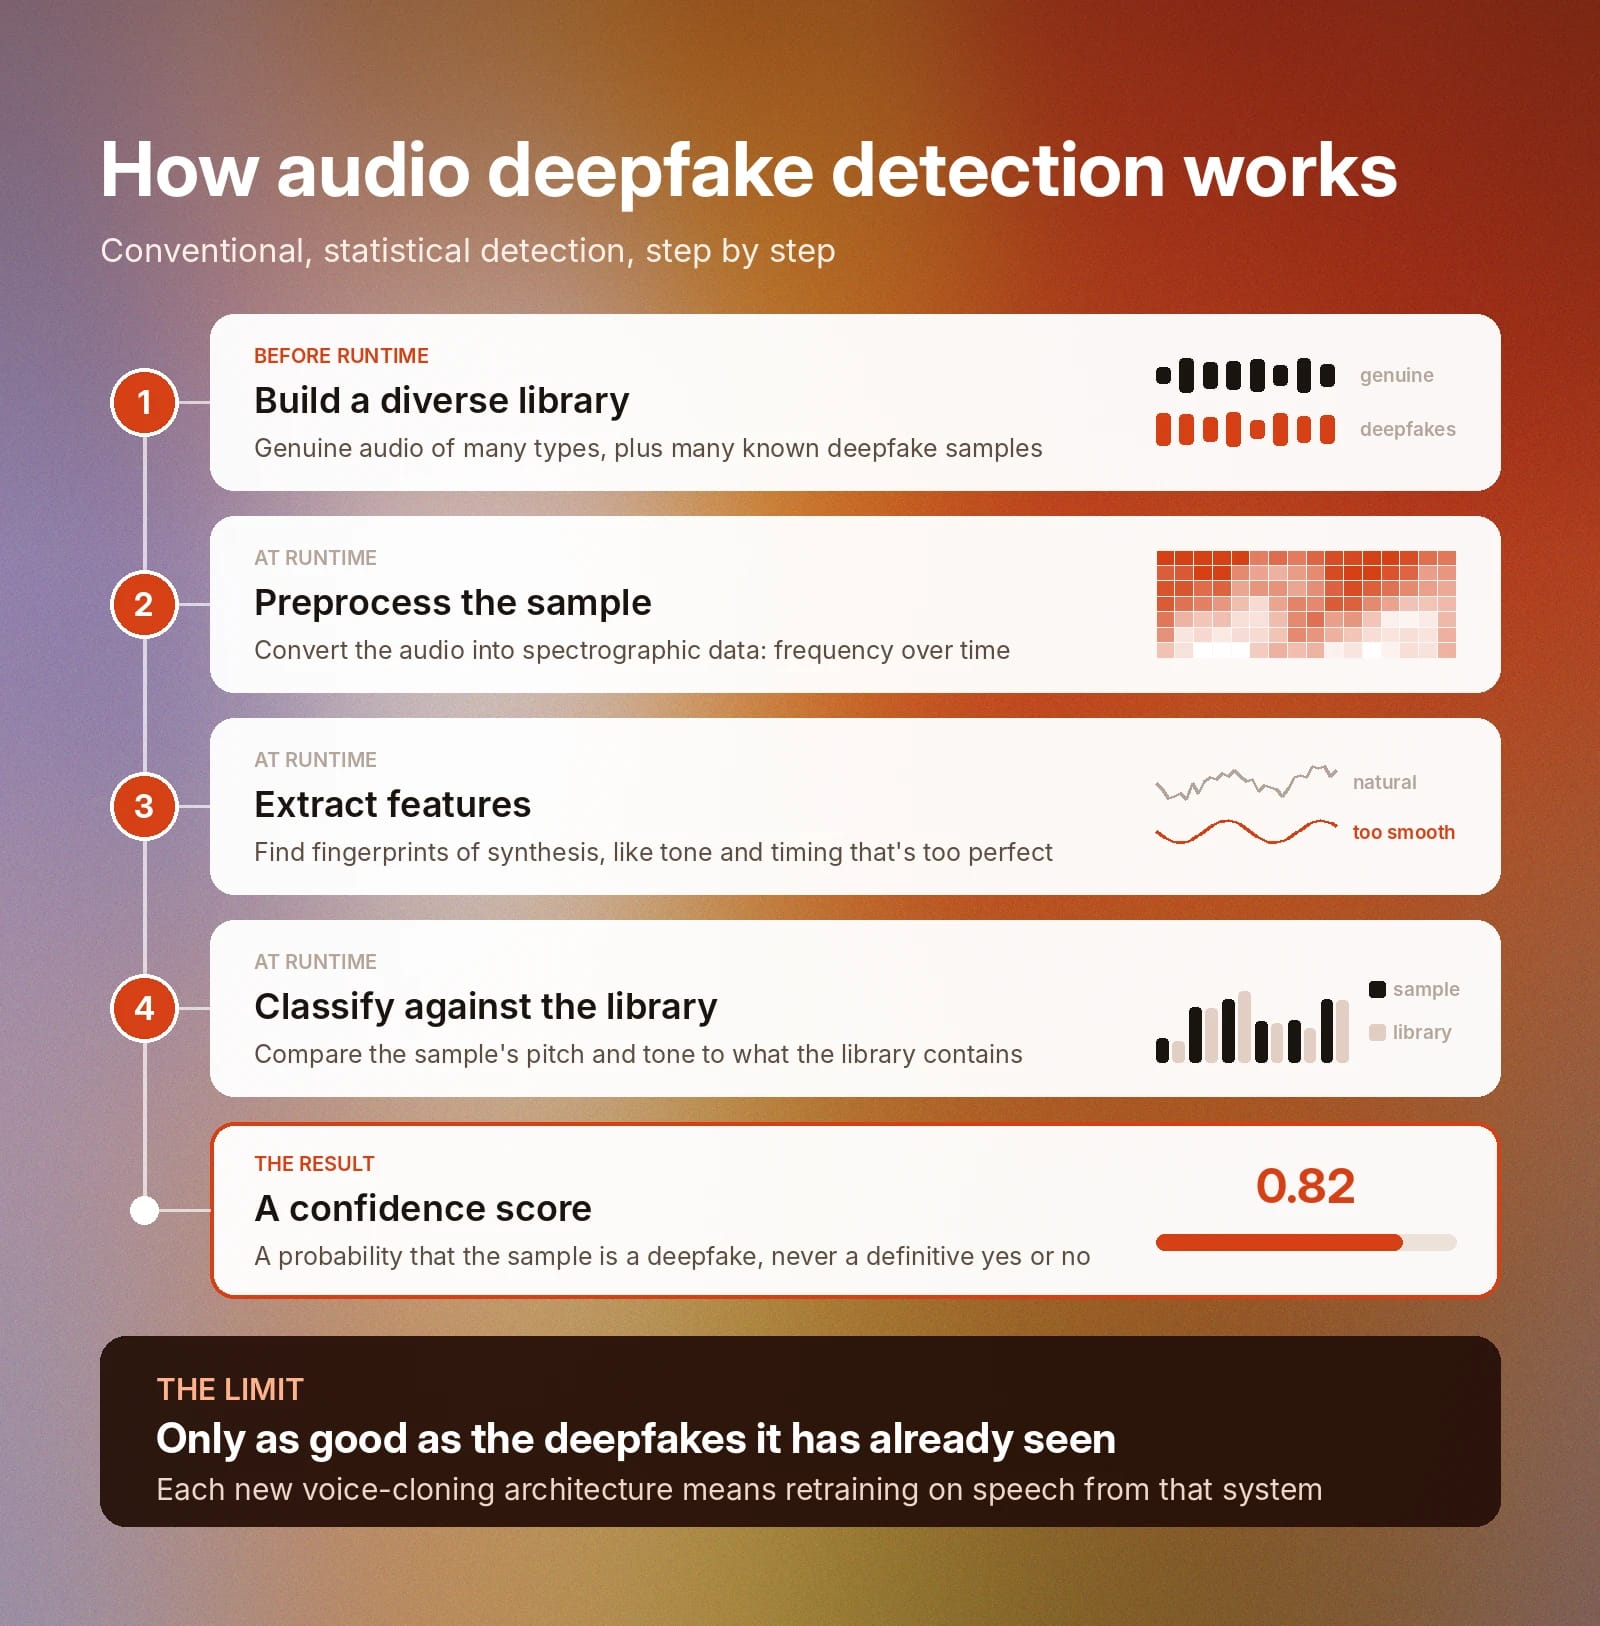
El primer paso es crear una biblioteca de contenido de audio con la que comparar los presuntos deepfakes. Debe ser un conjunto de datos diverso, que incluya muestras de audio auténticas de distintos tipos y numerosas muestras conocidas de deepfakes para facilitar detecciones positivas.
Durante su ejecución, sigue un proceso de tres fases: preprocesamiento, extracción de características y clasificación.
Preprocesamiento de audio
Cuando proporcionas una muestra de audio a una herramienta de detección entrenada, la convierte en datos espectrográficos, es decir, una representación matemática de los cambios de frecuencia a lo largo del tiempo.
Extracción de características
A continuación, la herramienta de detección extrae de los datos de la muestra características que actúan como huellas dactilares del habla sintetizada. Por ejemplo, el habla generada por IA a veces es demasiado perfecta y carece de las irregularidades tonales y temporales presentes en el habla natural. Comparar el tono y la entonación del hablante con su biblioteca también ayudará a la herramienta a identificar otras señales de alerta.
Clasificación
Como la detección convencional de deepfakes se basa en análisis estadísticos, no puede darte una respuesta definitiva de «sí» o «no» a la pregunta de si una muestra es un deepfake. En su lugar, genera una puntuación de confianza, o probabilidad, de que la muestra sea un deepfake.
Como miden las similitudes entre una muestra y una biblioteca de audio existente, las herramientas convencionales están limitadas por las muestras de deepfakes conocidas que tienen disponibles. Cada vez que alguien lanza una nueva arquitectura para clonar voces, debes volver a entrenar tu herramienta de detección con habla sintetizada en ese nuevo sistema para detectarla con precisión.
¿Cuál es la diferencia entre el marcado de agua y la detección estadística?
El marcado de agua es un enfoque completamente distinto para clasificar el habla. Un clasificador de aprendizaje automático calcula probabilísticamente si una muestra es auténtica a partir de lo que conoce, gracias a sus datos de entrenamiento, sobre el habla natural: cómo se reflejan el peso emocional y el énfasis reales en los datos espectrográficos, y qué tipos de cambios tonales y temporales son naturales.
El marcado de agua es determinista. Una marca de agua es una firma matemática incorporada en los datos de audio por el sintetizador a niveles que el oído humano no puede percibir. Un detector de marcas de agua verifica, con un sí o un no, si encuentra esa firma oculta.
Un detector funciona en tres fases sencillas:
- Extracción: La herramienta extrae datos espectrográficos y aísla las frecuencias en las que espera encontrar una marca de agua.
- Coincidencia de claves: Intenta descifrar la firma con una clave.
- Verificación: Si la señal se descodifica correctamente, la herramienta confirma que el generador de voz IA en cuestión generó el audio.
Proceso de detección de marcas de agua de ElevenLabs
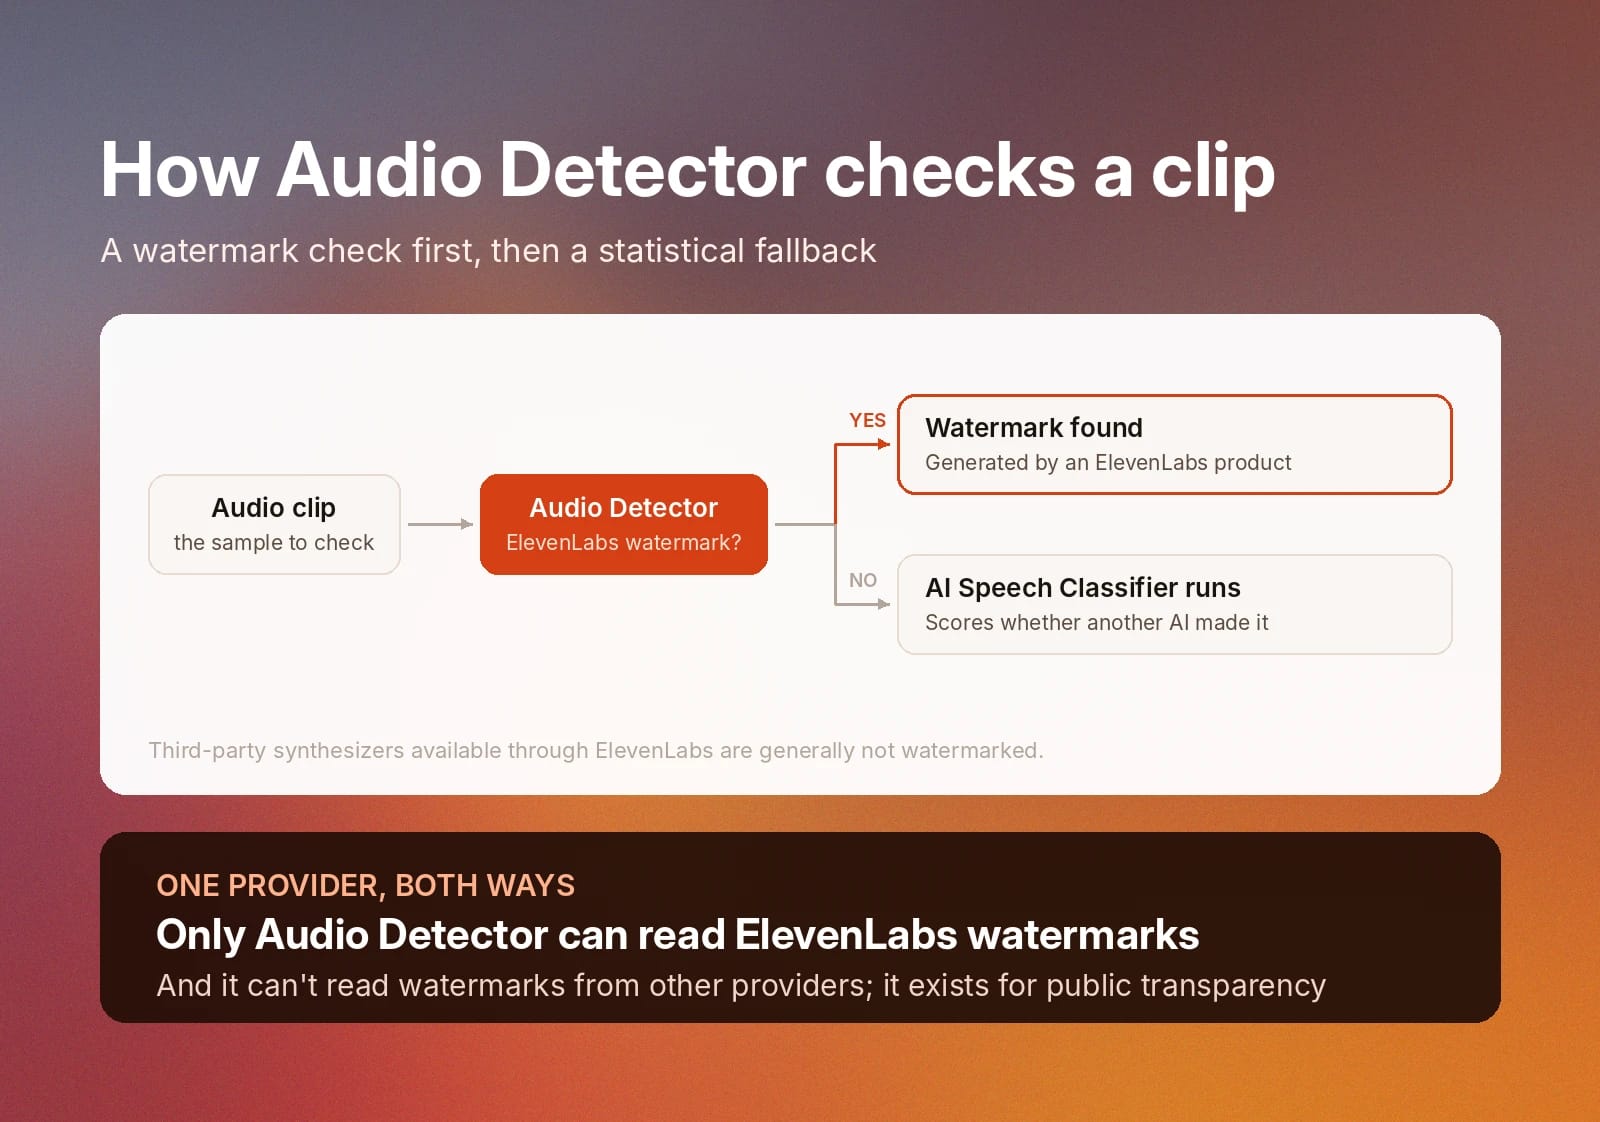
La herramienta de marcado de agua de ElevenLabs es Audio Detector. Analiza muestras de audio y verifica si el contenido fue generado por un producto de ElevenLabs. Si no encuentra una marca de agua, ejecuta el análisis estadístico de AI Speech Classifier para evaluar si el audio fue generado por IA de otra fuente.
Por cómo funciona el marcado de agua, Audio Detector de ElevenLabs solo detecta audio generado por ElevenLabs. Actualmente no puede identificar marcas de agua de otros proveedores de voz IA.
Y, a la inversa, solo Audio Detector de ElevenLabs puede detectar las marcas de agua de ElevenLabs.
Ten en cuenta también que el contenido generado por sintetizadores de terceros disponibles a través de ElevenLabs no suele incluir marcas de agua.
Otras opciones para detectar audio generado por ElevenLabs
El ElevenCreative AI Speech Classifier está disponible gratis y sin iniciar sesión. Analizará el primer minuto de una muestra de audio y proporcionará una puntuación de confianza sobre la probabilidad de que el audio haya sido generado por un modelo de ElevenLabs.
Ten en cuenta que no puede clasificar de forma fiable el audio de Eleven v3. Es más eficaz al clasificar audio generado por modelos antiguos de ElevenLabs de Texto a Voz. Su precisión también disminuirá al analizar contenido de voz muy comprimido o editado.
¿Cómo detectar voces sintéticas a gran escala?
Algunos equipos empresariales necesitan detectar deepfakes a gran escala casi en tiempo real. Pensemos en el equipo de atención al cliente de un banco nacional. Sus representantes interactuarán con miles de clientes al día. Los miembros del equipo deben compartir y actualizar periódicamente datos privados de las cuentas.
La dirección de ese equipo se preocupa mucho por la rapidez con la que pueden identificar a un interlocutor fraudulento y responder a clientes legítimos. Necesitan un sistema de detección de voz capaz de identificar en directo, durante las llamadas de clientes, audio de los principales motores de generación de voz.
Crear un sistema completo de detección de voz
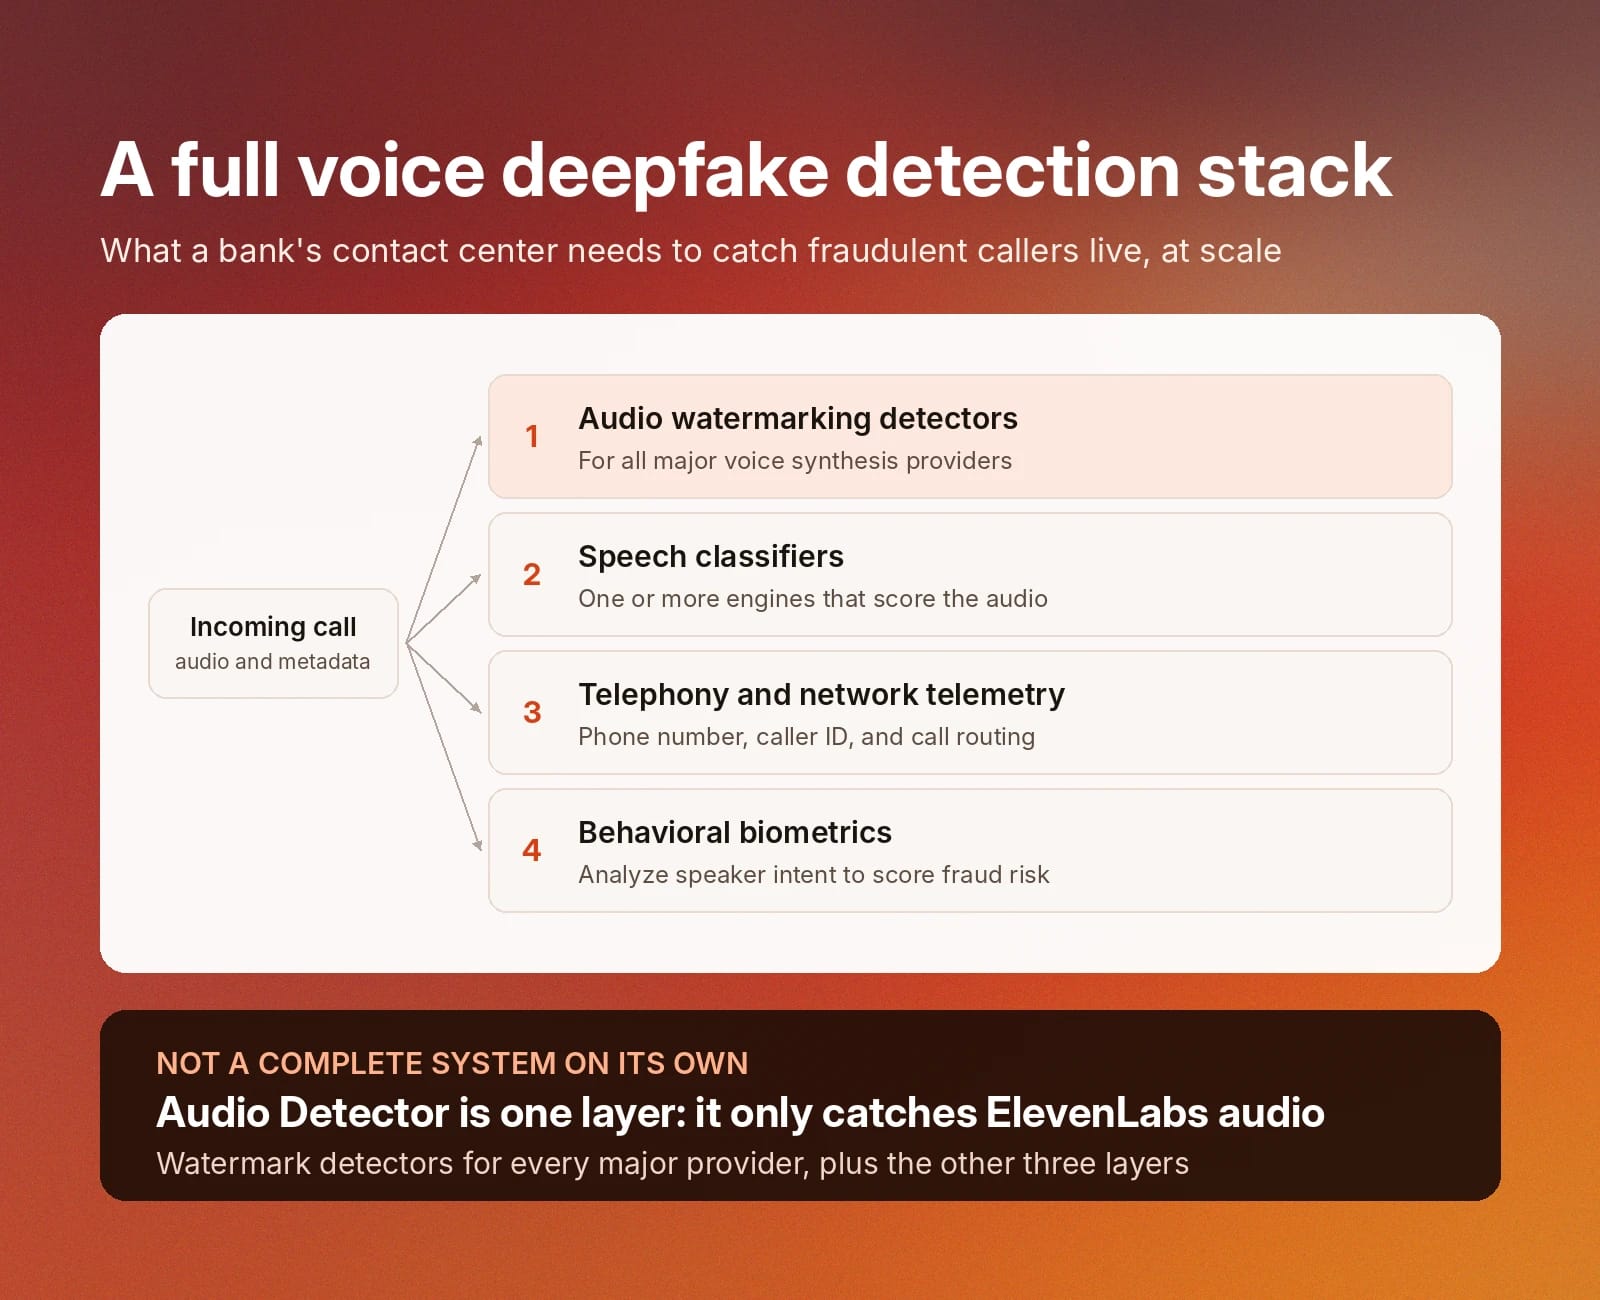
Audio Detector de ElevenLabs desempeña un papel importante aquí, pero es importante recordar que solo detecta audio con marcas de agua de ElevenLabs. Por sí solo no es un sistema completo de detección de voz. Las organizaciones que quieren capacidades completas de detección de voz deben reunir varios tipos de herramientas:
- Detectores de marcas de agua de audio: Para todos los principales proveedores de síntesis de voz.
- Clasificadores de voz: Uno o varios motores de clasificación que puedan puntuar datos de audio.
- Telemetría de telefonía y red: Análisis de metadatos de llamadas, como el número de teléfono, el identificador de llamada y el enrutamiento de llamadas.
- Biometría conductual: Software para analizar la intención del hablante y evaluar el riesgo de fraude.
Empieza con la detección de deepfakes de ElevenLabs
ElevenLabs se compromete a contribuir positivamente a la vida pública, tanto mediante servicios relevantes de generación de voz como proporcionando al público las herramientas que necesita para identificar deepfakes y otros usos maliciosos de audio generado por IA.
¿Tienes un clip de audio que quieres analizar para detectar deepfakes? Regístrate para probar Audio Detector de ElevenLabs o empieza con AI Speech Classifier hoy mismo.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.