¿Qué son las Audio Tags? La guía completa del TTS emocional
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
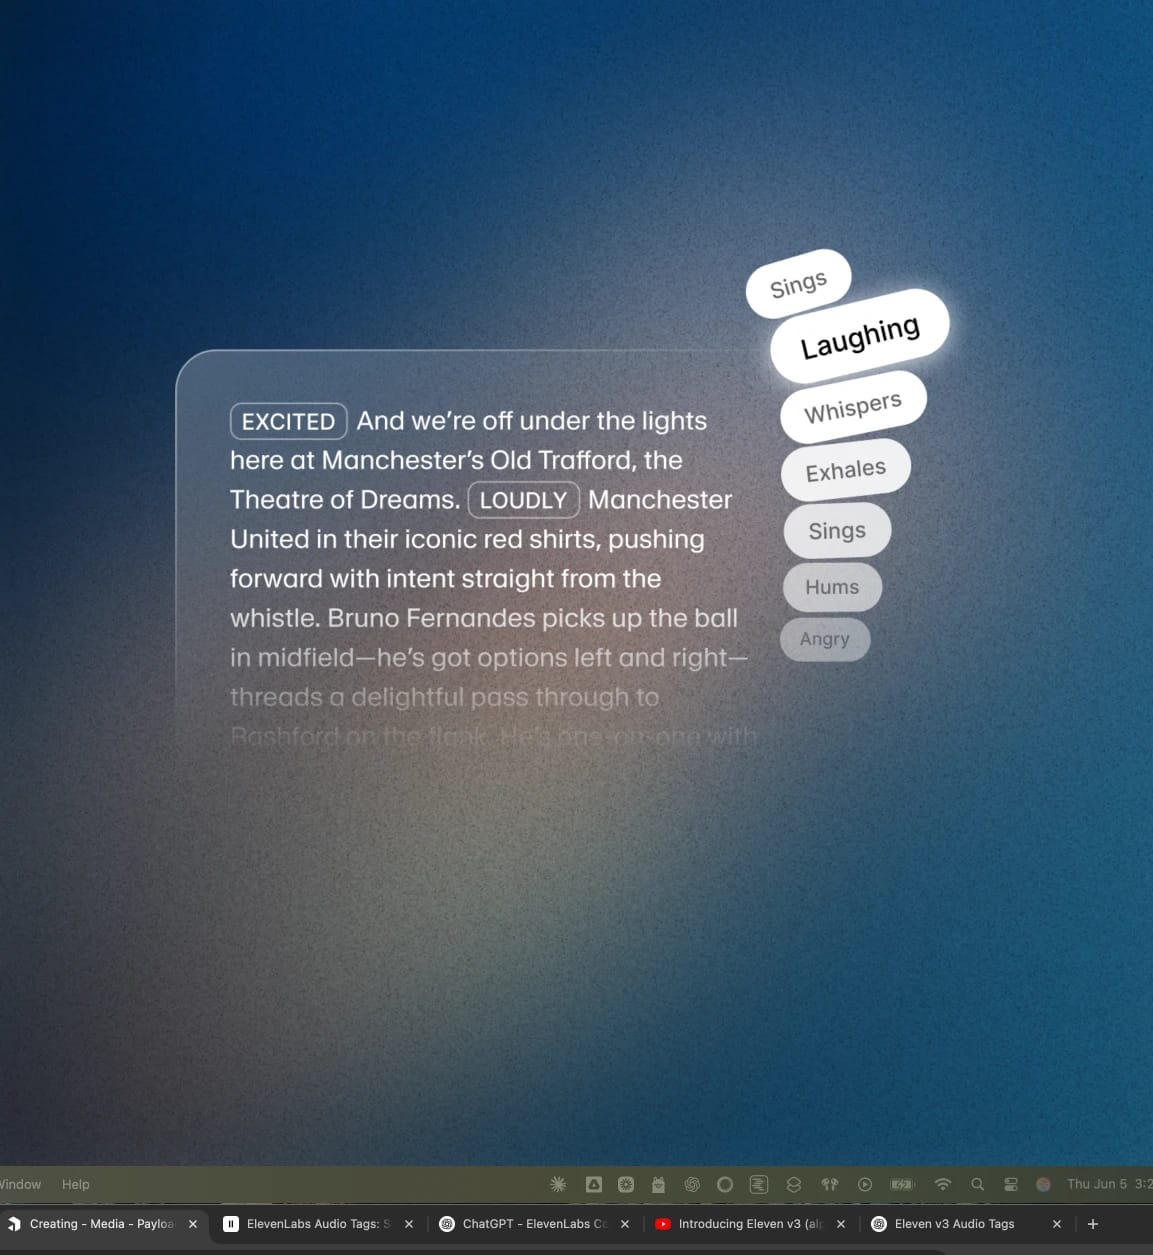
Audio Tags son indicaciones entre corchetes, en lenguaje natural, como [laughs], [gasps], [excited] y [worried], que Eleven v3 y Eleven v4 interpretan como instrucciones de interpretación, en lugar de palabras que deben pronunciarse. Al escribir un guion para un modelo de Texto a Voz, insertar estos Audio Tags te da un control preciso sobre la entonación emocional de tu texto.
Eleven v3 pasó a estar disponible públicamente en marzo de 2026. Antes de v3, conseguir una interpretación emocional concreta de un modelo de Texto a Voz implicaba regenerar contenido y esperar lo mejor. Audio Tags eliminan esa incertidumbre y te dan control total sobre una interpretación emocional de texto a voz. Eleven v4 lleva esto aún más lejos y te ofrece un control emocional preciso.
Esta guía explica qué son los Audio Tags, cómo funcionan, todas las categorías de tags disponibles y cómo se comparan con SSML (Speech Synthesis Markup Language). También veremos casos de uso habituales, cada uno con un enlace a su guía específica.
Resumen
- Audio Tags son indicaciones entre corchetes como [shouts] o [excited] que dirigen la emoción, el ritmo, la entonación y el tono en el TTS de Eleven v3 y Eleven v4.
- Eleven v3 y Eleven v4 no admiten SSML, pero lo sustituyen por Audio Tags para ofrecer una experiencia de escritura más natural.
- Los tags abarcan varias categorías, como emociones, entonación y ritmo, reacciones humanas, acentos y efectos de sonido.
- La puntuación y las mayúsculas de tu texto te permiten moldear el ritmo de una interpretación con voz IA.
- Puedes acceder a Audio Tags en ElevenLabs desde la interfaz o mediante la API.
¿Cómo funcionan los Audio Tags?
Audio Tags se insertan directamente en la transcripción y van entre corchetes. Cuando quieras cambiar la entonación, por ejemplo, de normal a [worried], solo tienes que añadir un audio tag.
También puedes usar más de un tag en una misma frase y combinarlos para lograr una interpretación con más matices, por ejemplo: [tired] Ha sido un día largo… [upset] ¿Cuántos días más podré aguantar?
La arquitectura de Eleven v4 permite que el modelo lea el contexto con mayor profundidad que los modelos anteriores, por lo que puede seguir indicaciones emocionales, cambios de tono, transiciones entre hablantes y pistas contextuales sin necesitar un parámetro o ajuste independiente. Solo dile al modelo lo que requiere el momento y reproducirá la frase exactamente como la habías planeado.
Eleven v4 también gestiona diálogos con varios hablantes que resultan espontáneos, incluidas interrupciones, cambios de ánimo y el intercambio natural de una conversación real, todo ello solo a partir de los tags y la estructura del guion.
Audio Tags frente a SSML
Si has trabajado con otros sistemas de TTS, seguramente conozcas Speech Synthesis Markup Language. Plataformas como Amazon Polly y Microsoft Azure Speech usan tags SSML como <break> o <emphasis> para aportar cierto contexto adicional a un guion de TTS.
Eleven v4 no admite tags de pausa de SSML ni el resto del conjunto de tags de SSML. En su lugar, Audio Tags, la puntuación y la propia estructura del texto asumen esa función, al tiempo que ofrecen un control preciso de la entonación.
Puedes usar la siguiente tabla para relacionar tags SSML habituales con su equivalente en Eleven v4.
Desde la perspectiva de quien escribe, añadir [whispers] a una frase requiere mucho menos esfuerzo que configurar una velocidad de prosodia.
Las categorías de Audio Tags en v3: dirige la interpretación con Audio Tags
Puedes colocar Audio Tags en cualquier parte del guion para moldear la entonación en tiempo real. También puedes combinar tags dentro de un guion o incluso en una misma frase.
Los tags se agrupan en las siguientes categorías principales.
Emociones
Estos tags pueden ayudarte a definir el tono emocional de la voz, ya sea sombrío, intenso o alegre. Por ejemplo, puedes usar uno o combinar [sad], [angry], [happily] y [sorrowful].
Entonación y ritmo
Estos se centran más en el tono y la interpretación. Puedes usar estos tags para ajustar el volumen y la energía en escenas que necesitan contención o fuerza. Algunos ejemplos son [whispers], [shouts] y [softly].
Reacciones humanas
El habla verdaderamente natural incluye reacciones. Por ejemplo, puedes añadir realismo incorporando momentos naturales y no guionizados al habla. Tags como [laughs], [clears throat] y [sighs] ayudan a crear un modelo de TTS capaz de transmitir emoción humana.
Otros ejemplos de categorías de audio tags son:
- Acentos y voces de personajes: Los tags de acento cambian la voz a una región o personalidad concretas sin cambiar de modelo, como [French accent], [British accent] o [pirate voice]. Úsalos para convertir una sola voz en un reparto flexible, en lugar de una única interpretación fija.
- Efectos de sonido: Los tags de efectos de sonido añaden audio no verbal directamente a la generación, como [gunshot], [explosion] y [clapping]. Funcionan muy bien para audio inmersivo, juegos y narración dramatizada, cuando la escena necesita más que una voz. Como alternativa, usa el generador de efectos de sonido con IA ElevenCreative.
Aunque los tags te ofrecen un alto nivel de control, también puedes usar la puntuación para dar forma al ritmo y al énfasis. Por ejemplo, añade puntos suspensivos para una pausa natural o usa comas para crear patrones de respiración naturales. Prueba a escribir una palabra en mayúsculas para darle énfasis: «Lo quiero AHORA MISMO».
¿Qué puedes hacer con Audio Tags?
Audio Tags desbloquean la complejidad emocional de los guiones de forma intuitiva. Escribe de manera natural y añade tags sobre la marcha.
Aquí tienes una breve muestra de algunos casos de uso de TTS emocional con Audio Tags.
Conciencia situacional en audio creado con IA
Tags como [whisper] o [shouting] permiten a Eleven v4 reaccionar al momento. Desde suavizar una advertencia hasta mantener una pausa prolongada para crear suspense, puedes integrar una conciencia situacional dinámica en tu guion.
Para conocer todos los detalles, consulta nuestra guía sobre conciencia situacional en audio creado con IA.
Dirigir la interpretación de personajes en el habla
Al crear un guion con varios personajes, quieres mostrar claramente en qué se diferencia cada voz. Desde ajustar su personalidad con [sarcastically] hasta definir cómo habla con [British accent], puedes captar toda una gama de emociones con nuestro motor de TTS.
Descubre más detalles sobre cómo dirigir la interpretación de personajes en el habla con IA.
Expresar contexto emocional en el habla
Audio Tags te permiten moldear la entonación emocional de una frase a medida que avanza. Puedes desarrollar emociones a lo largo de un discurso hasta alcanzar un clímax en el momento en que imaginas a tu personaje desplegando todo su potencial. Tags como [awe], [booming] y [big laugh] ayudan a incorporar toda una gama emocional a la interpretación de tu voz IA.
Más información sobre cómo usar el contexto emocional en el habla con IA.
Dar vida a diálogos con varios personajes
Al crear interpretaciones de diálogo con varios personajes, puedes comenzar cada frase con un audio tag para desarrollar conversaciones ricas entre personajes.
Toma como ejemplo lo siguiente: Tom: [coughing] [beginning to speak] perdón, hoy estoy un poco enfermo— Emma: [interrupting] —¿Enfermo? ¡Sabes cuánto odio que tosas, Tom! Tom: [surprised] Es solo una pequeña tos, no es nada grave. ¿Cómo te sentirías si…? Emma: [overlapping] [annoyed] —Creo que tienes que irte a casa.
Descubre qué más puedes hacer con diálogos con varios personajes en Eleven v3.
Control preciso de la entonación para el habla con IA
Puedes controlar el ritmo del habla con Eleven v3 y Eleven v4 mediante Audio Tags o la puntuación. Tags como [pause], [rushed] o [drawn out] te permiten moldear activamente la frase con precisión. Como alternativa, añade puntos suspensivos, puntos y signos de exclamación para incorporar emoción de forma natural a tu interpretación de TTS.
Hemos escrito una guía detallada sobre el control preciso de la entonación en Eleven v3.
El TTS emocional está disponible en la API
Audio Tags funcionan igual a través de la API de Texto a Voz que en la interfaz de ElevenLabs. Escribe el tag directamente en el texto del guion y la API devolverá la interpretación indicada en el audio generado, desde flujos de producción de audiolibros hasta locuciones publicitarias.
Más información sobre Eleven v4 o contacta con ventas para empezar hoy mismo.
Preguntas frecuentes sobre Audio Tags y TTS emocional

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.