Tasa de error de palabras (WER): conceptos clave, fórmula y usos
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
En teoría, la tasa de error de palabras (WER) es una métrica para determinar la precisión de una herramienta de Reconocimiento Automático del Habla (ASR). Una WER baja significa que la transcripción final es más precisa, mientras que una tasa de error alta indica información mal transcrita.
En la práctica, la WER podría marcar la diferencia entre un software de transcripción médica que indica que un paciente necesita «quince miligramos» o «cincuenta miligramos» de un medicamento. Es la diferencia entre una herramienta de soporte que transcribe con precisión las necesidades de un cliente y otra que deja a tu usuario frustrado.
En este artículo explicaremos qué es la WER, cómo calcularla y cómo usarla para comparar tu propio proveedor de ASR.
Resumen
- La tasa de error de palabras contabiliza tres tipos de errores: sustituciones, eliminaciones e inserciones, y los divide entre el número de palabras de la transcripción de referencia.
- La fórmula de la WER es WER = (S + D + I) / N.
- Cuanto menor sea la puntuación WER, más preciso será el resultado final.
- Una WER inferior al 5 % es una buena referencia, aunque las transcripciones legales o médicas pueden requerir una tasa de error de palabras aún menor.
- La WER trata todos los errores por igual, por lo que no es una métrica perfecta para evaluar el contexto. Métricas emergentes, como la tasa de error semántico de palabras (SWER), intentan resolverlo midiendo si se ha conservado el significado de una expresión.
¿Qué es la tasa de error de palabras?
La tasa de error de palabras (WER) es la métrica estándar para medir la precisión del reconocimiento de voz en modelos de voz a texto. Representa, en una escala de 0 a 1 (0,8 representaría una tasa de error del 80 %), los errores que comete un sistema STT al transcribir, teniendo en cuenta sus sustituciones, eliminaciones e inserciones.
Una sustitución ocurre cuando una palabra se reemplaza por otra incorrecta. Una eliminación ocurre cuando se omite una palabra por completo. Por último, una inserción ocurre cuando se añade a la transcripción una palabra que nunca se pronunció. La WER utiliza estos tres componentes y los divide entre el número de palabras de la transcripción correcta, lo que da como resultado una cifra que puedes comparar con la de otros proveedores.
Esta es la fórmula de la WER:
WER = (S + D + I) / N
Donde:
- S: Sustituciones (la palabra es incorrecta)
- D: Eliminaciones (falta una palabra)
- I: Inserciones (hay una palabra adicional)
- N: Total de palabras de la transcripción de referencia
Puedes expresar la WER como un decimal o un porcentaje. Cuanto menor sea la WER, mejor será tu puntuación, ya que el modelo habrá cometido menos errores al transcribir.
En la práctica, una WER del 10 % significa que aproximadamente 1 de cada 10 palabras de la transcripción de tu reunión necesita una segunda revisión.
¿Por qué es importante la tasa de error de palabras en los sistemas de reconocimiento de voz?
La tasa de error de palabras proporciona una métrica objetiva que los equipos pueden utilizar para comparar distintos proveedores. Va más allá de las afirmaciones de marketing y muestra claramente la precisión de un modelo de reconocimiento de voz. Al basarse en datos, cualquier empresa que evalúe sus opciones puede ver con claridad qué modelos lideran actualmente este campo.
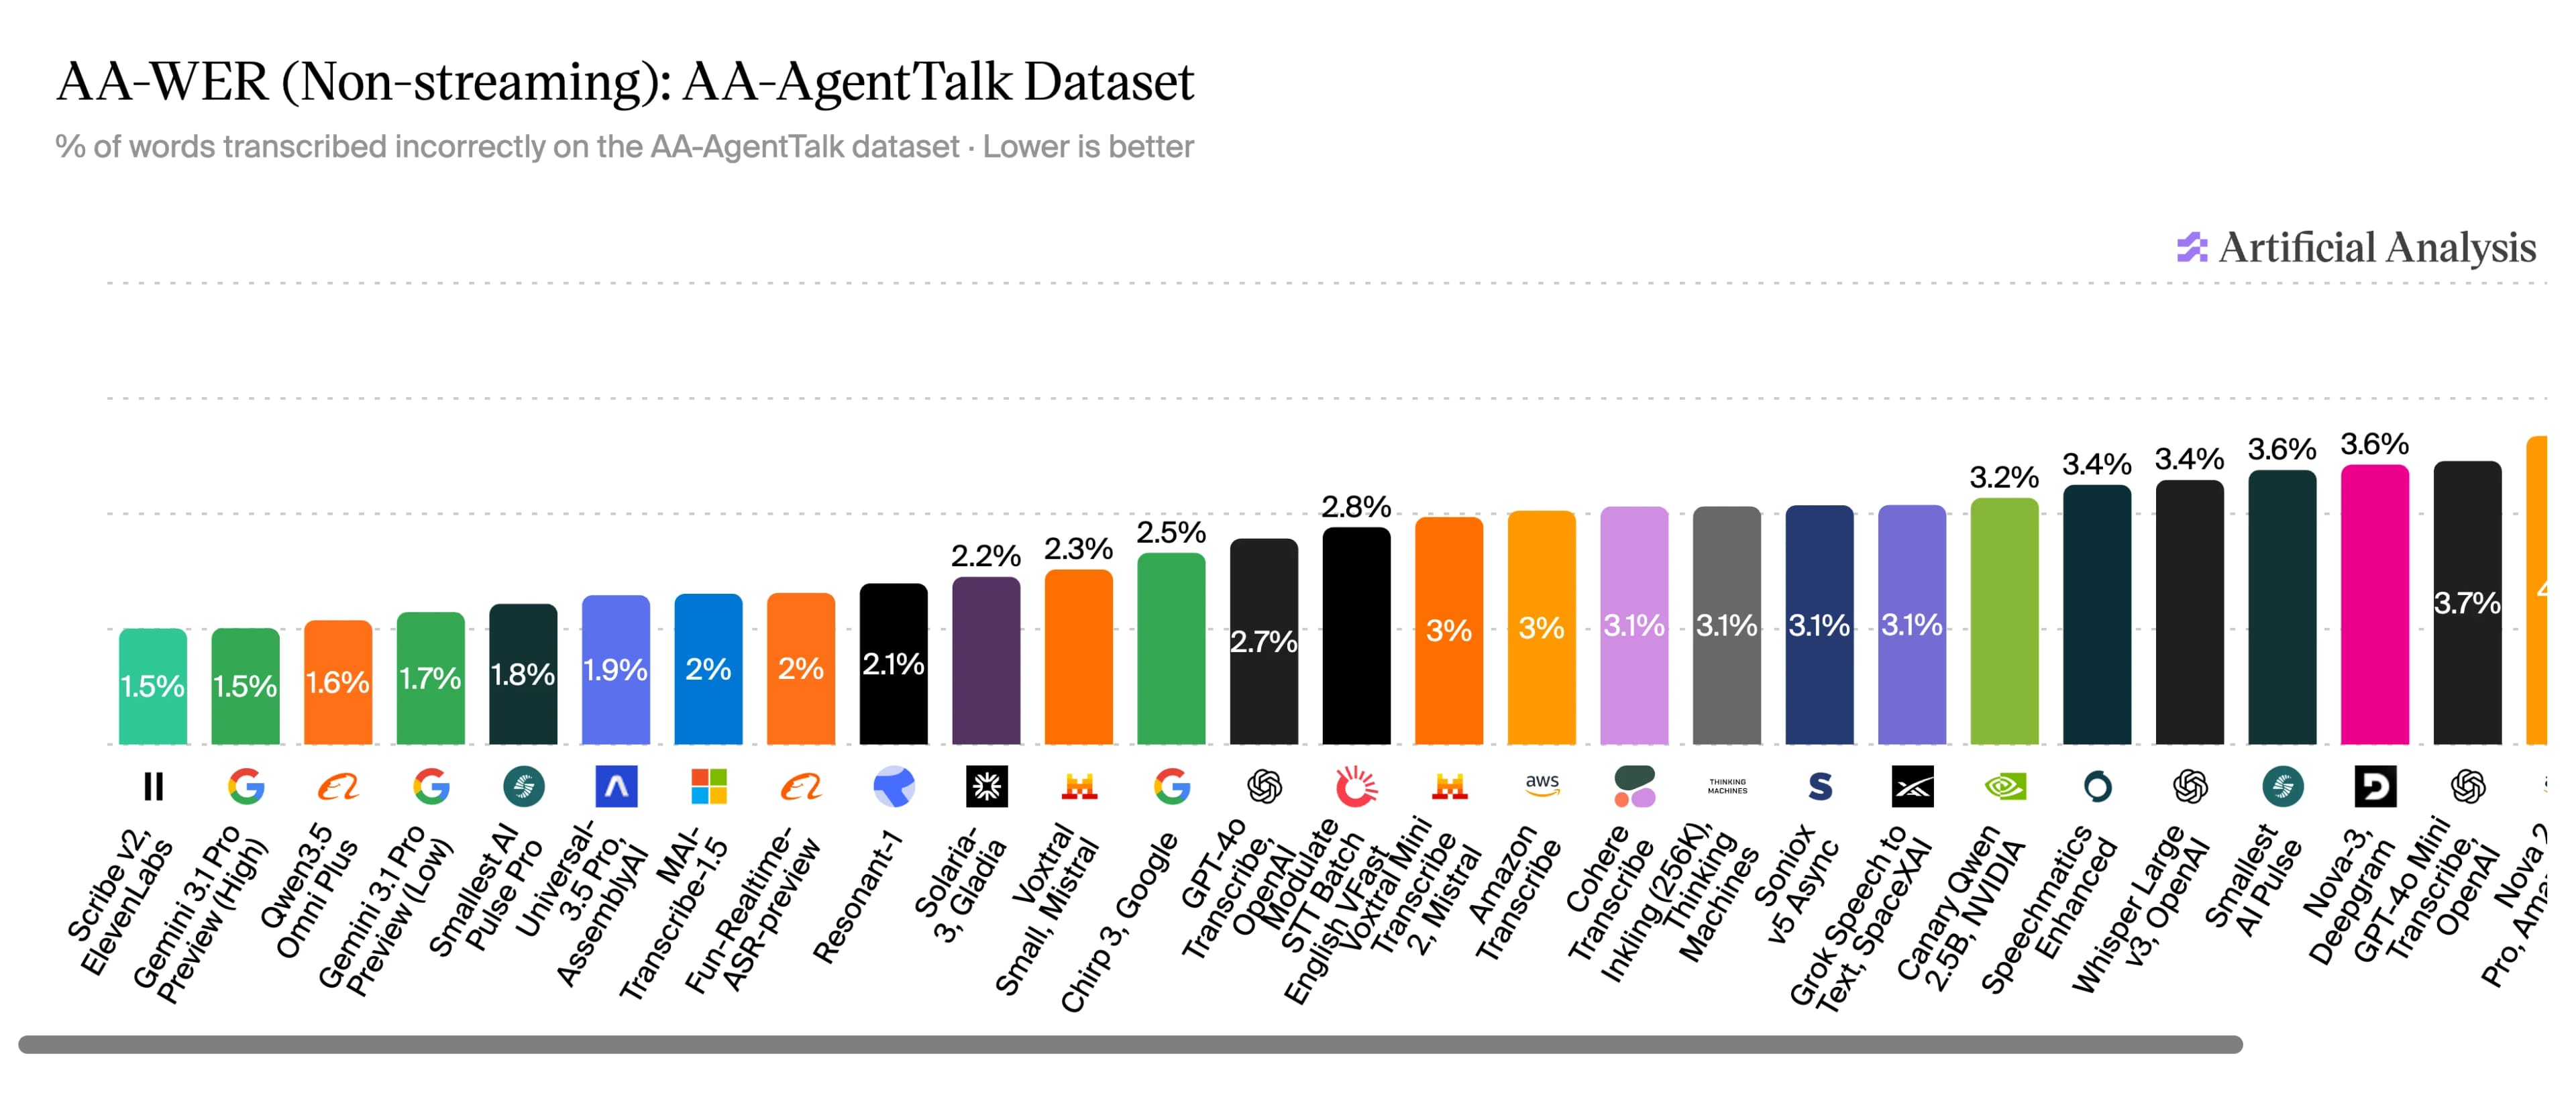
Fuente: Artificial Analysis consultado el 10 de julio de 2026.
En julio de 2026, una investigación independiente de Artificial Analysis sitúa a Scribe v2 de ElevenLabs como el modelo con la WER más baja del sector en el conjunto de datos AA-AgentTalk para modelos de transcripción no en streaming, con una WER del 1,5 %.
Más allá de la evaluación de proveedores, la WER tiene un impacto real en el producto. Un software de transcripción médica con una WER del 12 % podría introducir errores críticos en los historiales de pacientes. Las transcripciones incorrectas en una llamada de atención al cliente podrían provocar fallos posteriores, como un análisis de sentimiento impreciso o una categorización deficiente.
Más allá de estos problemas específicos de cada caso de uso, cuando los sistemas ASR fallan, quienes suelen verse más afectados son las personas para las que la transcripción es la única forma de acceder al contenido hablado. El World Wide Web Consortium ofrece amplia documentación sobre los estándares mínimos que exigen las iniciativas de accesibilidad.
Cómo calcular la tasa de error de palabras: fórmula y ejemplo
Calcular la tasa de error de palabras es sencillo una vez conoces los pasos. Como hemos visto antes, la fórmula que usarás es WER = (S + D + I) / N. Todos los términos se describen arriba, pero, como referencia rápida, son sustituciones, eliminaciones, inserciones y N, el total de palabras de la transcripción.
Así se calcula la WER:
- Crea una transcripción de referencia: utiliza transcripción y verificación humanas para producir una transcripción precisa de un clip de audio.
- Usa tu herramienta STT: utiliza una plataforma ASR para transcribir el clip de audio y generar una transcripción con IA que usarás como prueba.
- Alinea las dos versiones: utiliza programación dinámica —concretamente, el algoritmo de Levenshtein— para encontrar el número mínimo de ediciones. Profundizaremos en ese algoritmo en una sección posterior.
- Aplica la fórmula: cuenta el número total de errores de la versión generada por IA frente a la copia verificada por humanos y, a continuación, usa WER = (S + D + I) / N para calcular la WER exacta.
Esto puede parecer bastante técnico sobre el papel, pero en la práctica es mucho más sencillo. Aquí tienes un ejemplo para mostrarte a qué nos referimos.
Transcripción de referencia: La señora Dalloway dijo que compraría las flores ella misma.
Resultado de ASR: La señorita Dalloway dijo que compraría flores ella misma.
Si calculamos el total de errores, tenemos 1 S y 1 D de un total de 9 palabras.
Con la fórmula, obtenemos: WER = 2 / 9 = 0,222 = 22,2 %.
Cálculo de la tasa de error de palabras con Python
Aunque el método manual funciona muy bien, puedes ahorrar tiempo calculando la WER con Python. La biblioteca jiwer se encarga de todo ello automáticamente.
Con la documentación de jiwer, puedes instalar el paquete, creado específicamente para evaluar un sistema ASR y generar métricas clave como la WER. Una vez descargado, puedes usar el siguiente código para calcular rápidamente la WER con Python:
Observa que, en este ejemplo, el resultado de ASR difiere de la referencia original en dos puntos. La palabra «jumps» se transcribió incorrectamente como «leaps» (una sustitución) y se insertó «last» antes de «lazy» (una inserción). Con dos errores entre las nueve palabras de la transcripción de referencia, el resultado es una tasa de error de palabras (WER) de 0,222 o 22,2 %.
Comparación de la tasa de error de palabras y otras métricas de reconocimiento
Aunque la WER es la métrica estándar para calcular la precisión de un ASR, hay otras herramientas que puedes utilizar. Por ejemplo:
- Tasa de error de caracteres (CER): al igual que la WER, mide la precisión de la transcripción a nivel de carácter, en lugar de a nivel de palabra. Es idónea para idiomas sin límites claros entre palabras (scriptio continua) o tareas sensibles a la ortografía.
- Tasa de error de coincidencia (MER): mide la proporción de errores de transcripción, tratando las sustituciones, inserciones y eliminaciones de forma ligeramente distinta a la WER. Se centra en la proporción de errores de una frase.
- Información de palabras perdida (WIL): una estimación de cuánta información original se perdió durante la transcripción; proporciona una medida de inteligibilidad en vez del recuento directo de errores de la WER.
- Tasa de error de embeddings (EmbER): ofrece un análisis semántico entre las transcripciones. Va más allá de la WER y permite conocer la distancia semántica entre la palabra correcta y la transcripción incorrecta.
Cada una de estas métricas es más adecuada para un escenario diferente. Aquí tienes una tabla de referencia:
Ejemplos de distancia de Levenshtein: las matemáticas detrás de la WER
La tasa de error de palabras mide realmente la distancia entre el original y el resultado de la hipótesis. Para entender esta diferencia matemáticamente, utilizamos la distancia de Levenshtein.
La distancia de Levenshtein cuenta el número mínimo de ediciones de una sola unidad necesarias para transformar una secuencia en otra. En el caso de la WER, se refiere específicamente a las sustituciones, inserciones y eliminaciones. Por ejemplo, si quisiéramos transformar «Cat» en «Mat», tendríamos que cambiar la letra «C» por «M», lo que da una distancia de Levenshtein de 1.
Aunque este cálculo aparece mucho más en la CER, la WER toma la distancia de Levenshtein y la aplica a nivel de palabra. Cada unidad es una palabra completa en vez de un carácter; la distancia real mide cuántas ediciones de palabras harían falta para transformar nuestro resultado de ASR en el original correcto.
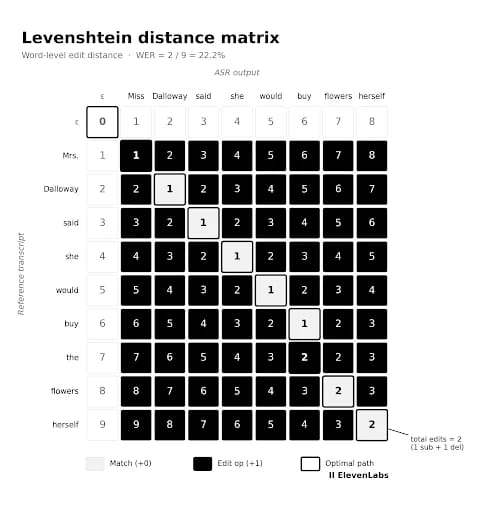
Construimos una matriz en la que cada celda representa la distancia total entre la transcripción original y la transcripción de ASR. La distancia de Levenshtein rellena entonces la matriz de arriba a la izquierda a abajo a la derecha, y la última celda indica el número total de ediciones a nivel de palabra. Al dividir ese número entre N, obtenemos la WER.
Aunque esta matriz suele calcularse con caracteres individuales, aquí tienes una versión ampliada de nuestro ejemplo anterior para simplificar.
Errores y conceptos equivocados habituales sobre la tasa de error de palabras
Sobre todo a medida que las API de STT se vuelven más accesibles y el software ASR pasa a ser una parte habitual de ecosistemas de agentes más amplios, veremos muchas comparaciones entre distintas herramientas.
Antes de calcular tus propias tasas de error de palabras, hay algunos problemas y conceptos equivocados habituales que debes comprender.
- Todos los errores son iguales: la WER trata cada error como igualmente significativo. Aunque esto puede estar bien en muchos contextos, en algunos casos de uso resulta inaceptable. Por ejemplo, en un hospital, un error del 5 %, que se consideraría una buena WER, puede seguir siendo inaceptable, ya que incluso uno o dos errores podrían poner en riesgo a un paciente. Esta limitación ha llevado al desarrollo de métricas más recientes, como la tasa de error semántico de palabras (SWER), que intenta medir si se ha conservado el significado de una frase en lugar de comprobar si cada palabra coincide exactamente.
- La WER puede superar el 100 %: aunque antes hemos dicho que la WER está entre 0 y 1, puedes encontrar una WER superior al 100 %. Esto ocurre porque los errores de inserción pueden generar más palabras que el total de la transcripción original. Un ejemplo habitual es transcribir «I'm» como «I am», donde una palabra se convierte en dos.
- Técnicamente, una WER más baja no siempre es mejor: una WER del 5 % es, sobre el papel, mejor que una WER del 10 %. Pero si los errores que contribuyeron a ese 5 % cambiaron significativamente el contexto de una frase y los del 10 % no, la cifra no refleja toda la realidad. El contexto sigue siendo muy importante, y métricas como la SWER se desarrollan específicamente para captar este impacto semántico.
En 2024, Apple publicó un interesante estudio que exploraba el último punto anterior. Cuando personas evaluaron un cálculo de WER del 9,4 % considerando si el ASR era legible o no, asignaron al mismo pasaje una WER de solo el 2,2 %. En el ejemplo analizado, las personas consideraron los «errores» insignificantes en muchos casos, lo que dio como resultado una WER humana más de 4 veces más permisiva que la de las máquinas.
Referencias de WER por sector
La WER ideal depende en gran medida del sector o caso de uso en el que emplees tecnología ASR. Aunque menos del 5 % es una referencia del sector para la WER, ámbitos específicos como la transcripción médica o jurídica necesitan una tasa mucho menor.
En el estudio de Artificial Analysis de julio de 2026, Scribe v2 de ElevenLabs obtuvo una WER del 1,5 %. Sin embargo, es importante recordar que estas estadísticas suelen realizarse principalmente en inglés. Es posible que la tecnología STT no sea tan eficaz en otros idiomas.
La documentación de ElevenLabs detalla los rangos generales de WER para todos los idiomas compatibles con Scribe v1 y Scribe v2.
Empieza con ElevenAPI para mejorar la precisión del reconocimiento
Cuando desarrollas una aplicación o producto en el que la calidad de la transcripción importa, la diferencia entre una API de ASR bien elegida y otra mediocre se refleja primero en tu WER y después en la experiencia de tus usuarios.
ElevenLabs Scribe es la capa de Voz a Texto accesible a través de ElevenAPI. Además de más de 90 idiomas y una WER líder en el sector, ofrece funciones como diarización de hablantes, marcas de tiempo por palabra, prompting de términos clave y detección de entidades.
Consulta la documentación de ElevenLabs para saber más sobre ElevenAPI o empieza registrándote hoy.
Preguntas frecuentes sobre la tasa de error de palabras

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.