Modelos de interacción: Cómo lograr un diálogo natural entre humanos e IA
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Cualquiera que haya intentado interrumpir a un agente de voz de IA a mitad de frase sabe lo que se siente cuando un sistema no está diseñado para la conversación humana. El ritmo no es el adecuado, la voz está desconectada del contenido e, incluso cuando la información es correcta, la interacción resulta extraña: no es como hablar con alguien que sabe del tema, sino como manejar un software que casualmente usa palabras.
La causa de esta sensación poco natural es estructural: muchos sistemas de voz IA se diseñaron para gestionar turnos, no conversaciones. Escuchan, procesan y responden a un intercambio cada vez. Eso funciona en demostraciones sencillas, pero falla cuando la conversación se vuelve emocional e impredecible.
Los modelos de interacción son sistemas de IA diseñados para comunicarse mediante audio y texto en tiempo real, y perciben no solo qué se dice, sino cuándo se dice y qué tipo de respuesta emocional requiere el momento. Este artículo explica qué diferencia a un modelo de interacción, por qué importa a las empresas que implementan voz IA y cómo ElevenLabs está avanzando hacia este objetivo.
Resumen
- La mayoría de sistemas de voz IA fallan en una conversación real porque no pueden gestionar interrupciones, silencios ni el contexto que se mantiene entre turnos.
- La plataforma de interacción de ElevenLabs está diseñada para gestionar interrupciones, pausas y solapamientos de voz sin perder el contexto ni romper el flujo de la conversación.
- ElevenLabs está avanzando hacia auténticos modelos de interacción con una arquitectura en cascada avanzada, Voz a Texto (STT) y Texto a Voz (TTS) propios, y una plataforma optimizada para baja latencia y conversaciones naturales de ida y vuelta.
Por qué la mayoría de comunicaciones de voz entre humanos e IA no resultan naturales
La mayoría de sistemas de voz IA tratan una conversación como una serie de entradas y salidas independientes: el sistema espera un bloque de voz, lo convierte en texto, procesa ese texto y responde. Esto funciona para interacciones de órdenes y respuestas, pero una conversación real no es una secuencia limpia de intercambios de texto. Es un diálogo continuo lleno de pausas e interjecciones.
Eliminar el flujo entre turnos y el contexto que se conserva entre ellos provoca tres fallos concretos:
- Te interrumpe o te hace esperar: El sistema no distingue una pausa para pensar de un turno terminado, así que interviene mientras aún hablas o se queda en silencio después de que hayas terminado. Si organizas tus ideas a mitad de frase, te corta; si acabas de exponer tu punto, tienes que esperar un instante de silencio incómodo.
- No puede reaccionar cuando empieza a hablar: En cuanto el sistema empieza a responder, deja de escuchar. Si lo interrumpes para redirigir la conversación, sigue dando la respuesta a una pregunta que ya has dejado atrás, porque no detecta que algo ha cambiado.
- Olvida cosas durante la conversación: Cada turno se procesa de forma aislada, por lo que el contexto de cinco intercambios anteriores no se conserva. Acabas repitiéndote o el sistema responde como si la conversación acabara de empezar.
El resultado es una conversación que puede ser funcionalmente correcta y aun así resultar extraña.
Lo que los modelos de interacción hacen y la voz IA tradicional no puede
Mientras la voz IA tradicional gestiona un turno cada vez, un modelo de interacción gestiona toda la conversación y atiende a lo que se está diciendo y a lo que debe suceder después, todo a la vez. La diferencia funcional es que un modelo de interacción responde al estado real del intercambio, no solo a la entrada más reciente.
Los modelos de interacción ofrecen:
- Respuesta en tiempo real: El sistema está diseñado para responder a velocidad de conversación, con un ciclo de extremo a extremo que puede durar menos de un segundo, según la configuración.
- Gestión natural de interrupciones, silencios y solapamientos: Distingue una pausa para pensar de un turno terminado, así que no interrumpe a las personas ni deja silencios incómodos. Y cuando un cliente habla encima para redirigir la conversación, gestiona el solapamiento sin perder el contexto ni desestabilizar la conversación.
- Continuidad durante todo el intercambio: En lugar de reiniciar el contexto en cada turno, el sistema conserva el historial de la conversación, de modo que lo que dice en el turno 10 refleja todo lo ocurrido desde el primer turno.
- Entonación adaptativa: La voz puede programarse para cambiar (más tranquila, más directa o más tranquilizadora) según el tipo de tarea que esté realizando.
- Ejecución de tareas en paralelo: El sistema recupera información, realiza llamadas a herramientas y sigue hablando al mismo tiempo, en lugar de quedarse en silencio mientras busca algo.
La prueba de un modelo de interacción es una llamada que va mal. En la grabación de abajo, un cliente llama por la cancelación de un vuelo. Está tenso y necesita una solución rápida a su problema.
El agente reconoce de inmediato la urgencia y frustración del cliente por las palabras que utiliza. Ajusta su tono, gestiona la interrupción sin perder el hilo y usa las herramientas conectadas para ofrecer soluciones reales al vuelo cancelado. Al final, el cliente obtiene una solución sin necesidad de un agente humano.
Compáralo con los agentes habituales basados en turnos que se usan hoy. Estos sistemas esperarían cada pausa, responderían desde una postura neutral y no captarían en absoluto la frustración del cliente. Tras varios intercambios que no abordan lo que realmente siente quien llama, probablemente habría que derivar la llamada a una persona, dejando al cliente más frustrado que al principio.
Cómo ElevenLabs está avanzando hacia los modelos de interacción
Nuestro pipeline de conversación utiliza una arquitectura en cascada avanzada en lugar de una arquitectura fusionada, así que, en vez de que un único modelo gestione todo, cada etapa cuenta con su propio componente especializado.
La ventaja de este enfoque es que podemos optimizar cada etapa del pipeline de forma independiente e incorporar un modelo mejor para cualquier componente sin tener que reconstruir todo el sistema. Además, como desarrollamos esos componentes internamente, están cooptimizados para transmitirse contexto enriquecido entre sí, no solo datos. Esto significa que el pipeline sigue comportándose como una conversación coherente, en lugar de como una cadena de herramientas independientes.
Estructura del modelo en cascada
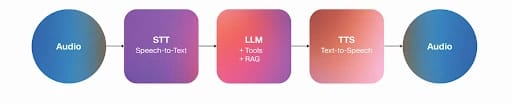
Estructura del modelo fusionado
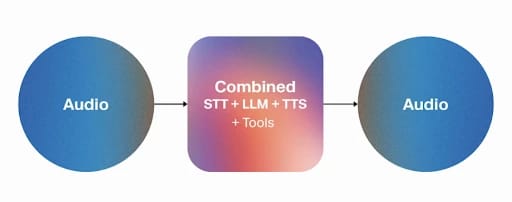
Imágenes: modelos en cascada frente a fusionados
Esta es la tecnología que compone actualmente el pipeline:
- Scribe v2 Realtime: Nuestro modelo de STT propio transcribe voz en unos 150 ms en más de 90 idiomas, incluso con ruido de fondo, acentos, interrupciones y eventos no verbales como risas y pausas. También está diseñado para manejar vocabulario específico de cada sector, desde términos médicos hasta jerga financiera.
- Gestión predictiva de turnos: Este sistema decide cuándo hablar, hacer una pausa o esperar, interpretando el flujo de la conversación en lugar de depender de un umbral de silencio fijo. Las mejoras de nuestro modelo de detección de actividad de voz le ayudan a filtrar mejor la voz de fondo y las respuestas cortas, para que el intercambio de turnos resulte más natural.
- Eleven v3 Conversational: Uno de nuestros modelos TTS más expresivos, diseñado para diálogos en directo de ida y vuelta. Mantiene la temperatura emocional de la conversación entre turnos, de modo que la entonación del agente en el turno 10 refleja todo lo anterior, no solo la respuesta más reciente.
- Modo Expresivo: Basado en Eleven v3 Conversational y en el sistema de gestión de turnos, Modo Expresivo controla cómo suena el agente en cada momento. Reduce la tensión cuando clientes están frustrados, tranquiliza cuando están confundidos y es directo cuando hace falta claridad. También interpreta etiquetas expresivas, de modo que el modelo puede actuar según indicaciones como [laughs], [whispers] o [sighs] para dar forma a momentos concretos de la entonación.
- Flash v2.5: Nuestro modelo TTS de baja latencia admite 32 idiomas y genera voz en menos de 75 ms. Cuando la latencia es prioritaria, mantiene el tiempo de respuesta dentro del ritmo humano natural.
- Speech Engine: La capa de conexión que une toda la plataforma y conecta tu servidor con nuestra ElevenAPI mediante WebSocket, con una conexión por conversación. Nosotros gestionamos STT y TTS mientras tu servidor ejecuta el LLM, para que los equipos técnicos puedan aportar su propio modelo y mantener la lógica de conversación en su propia infraestructura.
Estos modelos mejoran constantemente y se publican nuevas versiones con regularidad. Cada lanzamiento reduce la distancia entre hablar con un software y hablar con una persona, con respuestas más rápidas, una detección emocional más precisa, más idiomas y una entonación más fluida.
Hablar mientras piensa
No todas las partes de un modelo de interacción tienen que ejecutarse en una secuencia estricta. ElevenAgents puede seguir trabajando en segundo plano mientras continúa la conversación, en lugar de recurrir al silencio entre una pregunta y una respuesta.
Varios sistemas básicos trabajan juntos para permitir hablar y pensar simultáneamente:
- Llamadas a herramientas en paralelo: El agente puede consultar una base de datos, ejecutar una herramienta o comprobar el estado de un pedido mientras sigue hablando, para que la recuperación de información nunca parezca una pausa incómoda en la conversación.
- Tiempo de espera flexible: Si un LLM tarda más de lo esperado en generar una respuesta, el agente dice una breve frase de relleno como «Déjame pensar» o «hmmm», en lugar de dejar un silencio incómodo. Tiempo de espera flexible ayuda a mantener un flujo conversacional natural y reduce la probabilidad de interrupciones.
- Términos que ignoran interrupciones: En lugar de usar un umbral de silencio fijo, el sistema intenta interpretar el significado de lo que se dice para intuir cuándo ha terminado realmente un turno. Del mismo modo, confirmaciones breves como «vale» o «ajá» pueden configurarse para pasar sin activar una interrupción completa, lo que significa que el agente no pierde el hilo cada vez que quien llama interviene.
En conjunto, estos sistemas evitan que el agente parezca estar almacenando en búfer o cargando una respuesta. Forman un motor conversacional optimizado que llena las pausas de manera natural, como lo haría una persona, mientras procesa información y organiza sus ideas en segundo plano.
Cómo funciona realmente una conversación con ElevenLabs
Los componentes anteriores no se ejecutan uno tras otro en una línea ordenada. Se solapan. Así gestionaría un agente de ElevenLabs a una persona que pregunta: «¿Mi pedido ya se ha enviado o sigue procesándose?», durante una llamada de soporte.
- La persona que llama habla: El audio se transmite a ElevenLabs mediante la conexión WebSocket y Scribe empieza a transcribir en tiempo real, con unos 150 ms de retraso respecto a la voz.
- El sistema interpreta el flujo: Mientras Scribe sigue transcribiendo, la gestión predictiva de turnos ya está evaluando si la persona ha terminado o sigue formulando la idea. El final «¿o sigue procesándose?» se interpreta como una cesión de turno y no como una pausa, por lo que activa el siguiente paso en lugar de esperar en silencio.
- El LLM reúne el contexto y responde: La pregunta transcrita se envía al LLM junto con el historial de la conversación, el registro del pedido recuperado de los sistemas propios de la empresa mediante RAG, los resultados de herramientas usadas antes en la llamada y el prompt del sistema. Razona sobre todo ello y genera una respuesta basada en el pedido real de quien llama, no un mensaje de estado genérico.
- El modelo TTS sintetiza la respuesta: El texto se convierte en audio de sonido natural. Si el Modo Expresivo está activo, la respuesta incluye indicaciones de entonación acordes al momento, de modo que una actualización rutinaria suena sencilla y sin prisa en lugar de plana. Cuando la latencia es prioritaria, Flash realiza la síntesis en menos de 75 ms.
- La respuesta se transmite de vuelta: El audio empieza a reproducirse antes de que termine la síntesis, por lo que quien llama oye el inicio de la respuesta mientras el resto aún se está generando.
- El ciclo se repite: Cada nuevo turno conserva el tono, el contexto y el historial de la conversación.
A lo largo de este proceso rápido, la conversación resulta natural. Quien llama deja de adaptarse a la máquina: no habla más despacio, no vocaliza en exceso ni espera un pitido. Simplemente habla, como lo haría con una persona.
Implementa agentes de voz naturales en toda tu empresa
Todo lo descrito aquí ya está en producción, no en una hoja de ruta. Desde la arquitectura en cascada hasta el pipeline de menos de un segundo, empresas de todo el mundo ya utilizan ElevenAgents para gestionar conversaciones reales con clientes a escala.
Esto incluye entornos regulados y de alto riesgo, porque nuestra arquitectura de agentes admite salvaguardas, registros de auditoría y controles de cumplimiento normativo. ElevenLabs cuenta con certificaciones SOC 2 Type II, ISO 27001, HIPAA y PCI DSS Level 1, además de Zero Retention Mode y residencia regional de datos para equipos que necesitan mantener los datos dentro de un límite específico.
¿Listo para poner un agente a trabajar? Puedes crear un agente y empezar a desarrollarlo en la consola, o hablar con nuestro equipo comercial sobre una implementación adaptada a tu entorno.
Preguntas frecuentes sobre los modelos de interacción

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.