Conoce Flash
- Publicado
EscucharEscucha este artículo
Conoce Flash. Nuestro modelo más reciente, que genera voz en 75 ms + la latencia de la aplicación y la red.
Flash es nuestro modelo recomendado para agentes de voz conversacionales de baja latencia. Puedes usar Flash hoy mismo en nuestra plataforma de IA conversacional.
También puedes desarrollar directamente con la API usando los ID de modelo «eleven_flash_v2» y «eleven_flash_v2_5»: https://elevenlabs.io/docs/api-reference/text-to-speech/convert
Flash v2 está disponible solo en inglés y Flash v2.5 admite 32 idiomas. Ambos cuestan 1 crédito por cada 2 caracteres
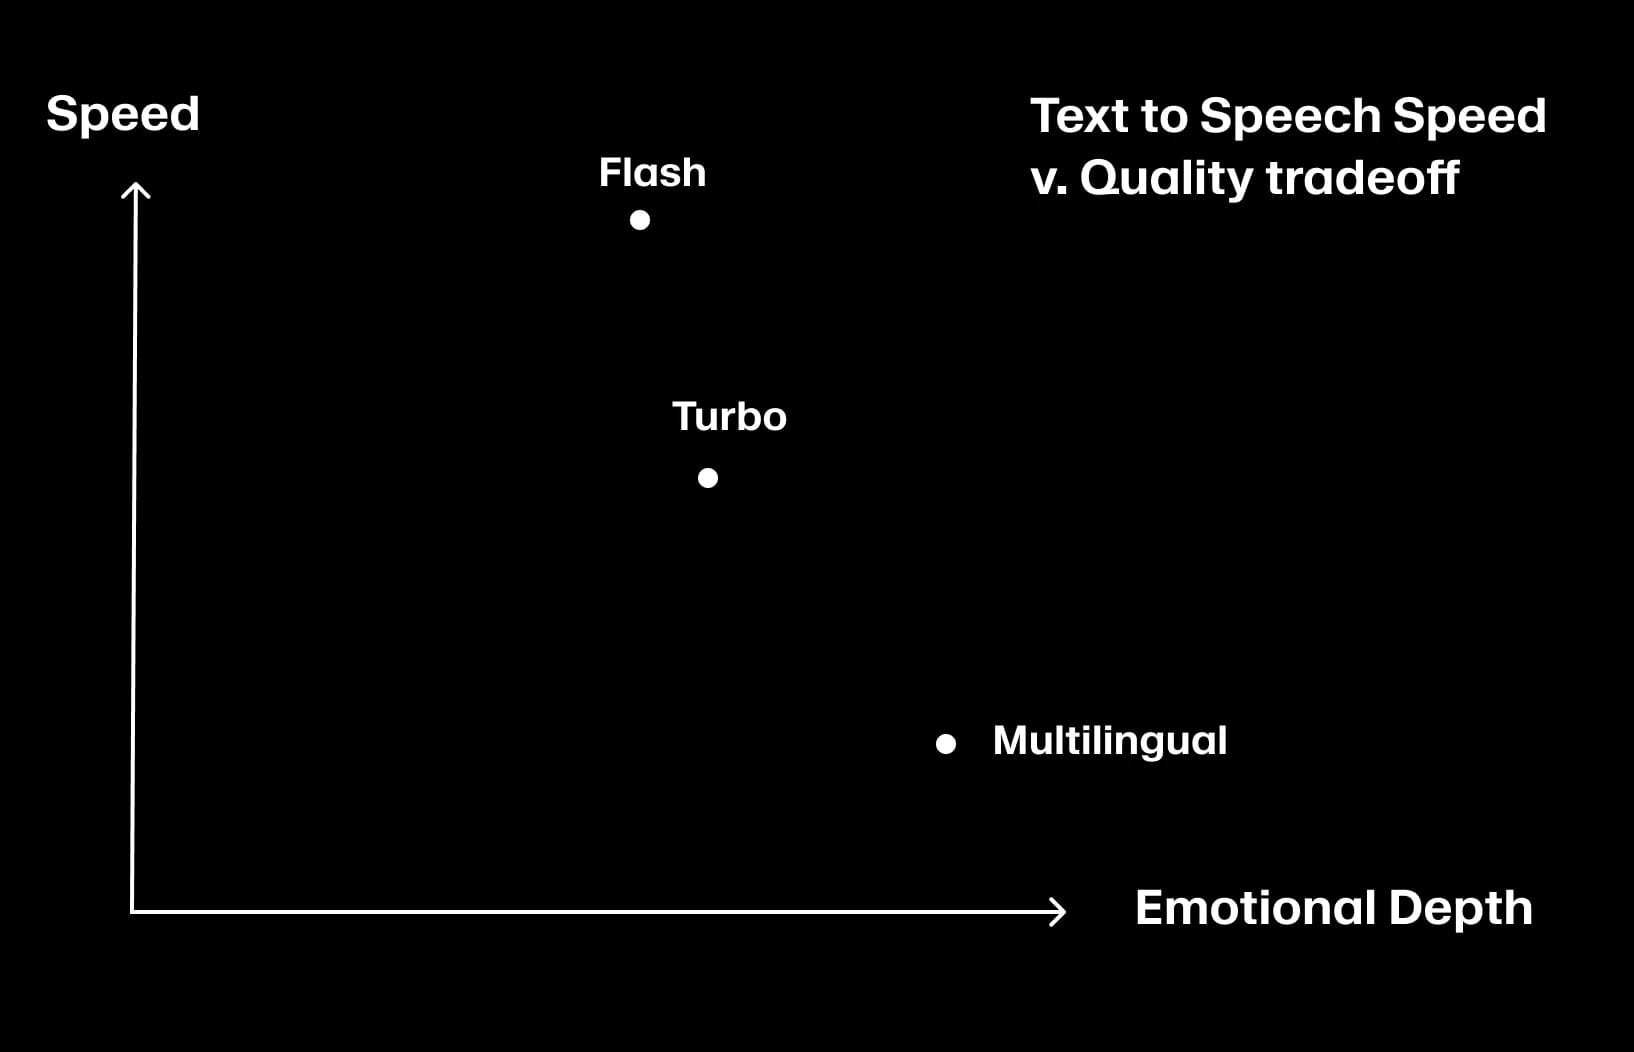
Ofrece una calidad y una profundidad emocional ligeramente inferiores a las de los modelos Turbo, pero una latencia considerablemente menor. En pruebas a ciegas realizadas por nuestros evaluadores humanos, Eleven Flash superó sistemáticamente a modelos comparables de latencia ultrabaja, lo que lo convierte en el modelo más rápido con una calidad de este nivel.
Consulta nuestra guía de modelos para encontrar el que mejor se adapte a tu caso de uso: https://elevenlabs.io/docs/developer-guides/models
Tenemos muchas ganas de ver todas las interacciones conversacionales naturales y de baja latencia que Flash hará posibles.