Modelos en Cascada vs Fusionados: Cómo la arquitectura determina si tu agente de voz está listo para empresas
- Publicado
- Última actualización
EscucharEscucha este artículo
La mayoría de la gente cree que los agentes de voz se crean con una arquitectura en cascada o fusionada. En la práctica, los agentes se diseñan a lo largo de un espectro entre ambas, y suelen utilizarse cinco arquitecturas según la aplicación.
La arquitectura del agente determina su capacidad para comportarse de forma fiable en producción, adaptarse a requisitos empresariales específicos y sonar natural en una conversación. Una arquitectura basada en fusión, como el modelo Realtime de OpenAI, puede sonar sorprendentemente realista en intercambios breves. Pero cuando los equipos necesitan aplicar medidas de cumplimiento normativo, depurar una respuesta fallida o incorporar un LLM más potente cuando se lance el mes que viene, una única red fusionada ofrece pocas alternativas.
En ElevenLabs utilizamos una arquitectura avanzada basada en cascada. Aprovechamos componentes especializados para el reconocimiento de voz, el razonamiento y la generación de voz, logrando altos niveles de inteligencia y fiabilidad. Añadimos prosodia contextual, optimización de baja latencia y una gestión inteligente de turnos para que las conversaciones fluyan de forma natural. La hemos creado así porque las empresas y administraciones públicas con las que trabajamos necesitan agentes que suenen realistas y en los que se pueda confiar en producción para tareas complejas.
Este artículo recorre las cinco arquitecturas principales, para qué sirven, dónde fallan y cómo entendemos la base de los agentes desplegados en flujos de trabajo críticos.
Qué evalúan los equipos al elegir una arquitectura
Las preguntas que se hacen los equipos suelen agruparse en tres categorías.
¿Puede gestionar tareas complejas?
- Razonamiento y flexibilidad del modelo: ¿Puedes elegir los mejores modelos para tu caso de uso, incluidos los LLM más potentes disponibles, y actualizarlos cuando haya mejores opciones?
- Lógica del agente: ¿Puedes definir y controlar los flujos de conversación, las reglas de decisión y las vías de escalado que sigue tu agente?
- Uso de herramientas: ¿Puede la arquitectura admitir llamadas a herramientas de varios pasos e integraciones con sistemas externos?
¿Sonará y se sentirá humano?
- Prosodia: ¿El agente ofrece ritmo, entonación y tono emocional naturales?
- Latencia: ¿Las respuestas son lo bastante rápidas como para que la conversación resulte natural?
- Gestión de turnos: ¿El agente sabe cuándo hablar, hacer una pausa o ceder el turno?
¿Puedo confiar en él en producción?
- Fiabilidad: ¿El agente se comporta de forma predecible y coherente, o se desvía con el tiempo?
- Medidas de protección: ¿Puede la arquitectura aplicar protecciones frente a respuestas no deseadas o usuarios maliciosos?
- Transparencia: ¿La arquitectura genera resultados intermedios o es una caja negra?
Las diferencias entre las arquitecturas en cascada y fusionadas
Las arquitecturas basadas en cascada se construyen encadenando componentes especializados: Voz a Texto (STT), un modelo de lenguaje de gran tamaño y Texto a Voz (TTS). Cada etapa puede optimizarse, probarse y actualizarse de forma independiente.
Arquitectura en cascada
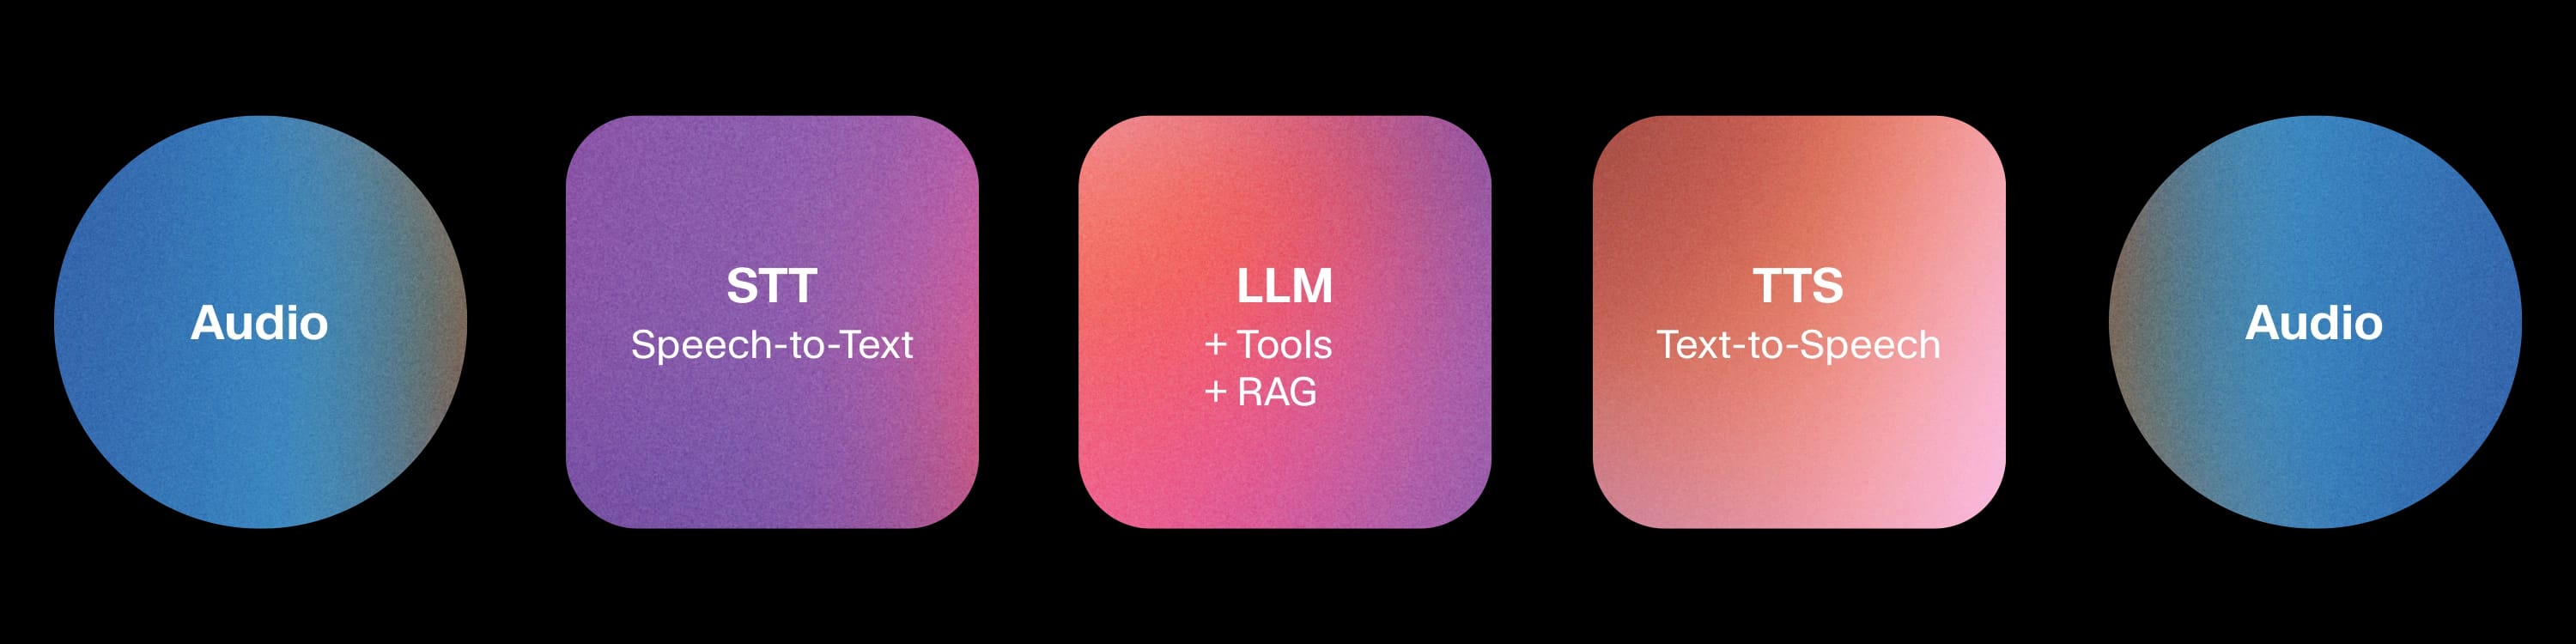
Esa modularidad es lo que convierte a las arquitecturas en cascada en la base de la mayoría de agentes de nivel empresarial. Cada etapa genera resultados que se pueden inspeccionar: texto legible entre el STT y el LLM, y entre el LLM y el TTS. Las medidas de protección se pueden aplicar en la capa de texto, el LLM de frontera más reciente se puede integrar sin modificar los modelos de voz y, cuando algo falla, normalmente se puede identificar el origen del fallo.
La crítica habitual a las arquitecturas en cascada es que pierden señales prosódicas. La voz se reduce a texto, y la entonación, el ritmo y la emoción deben reconstruirse en la salida. Estas señales pueden recuperarse parcialmente mediante modelado explícito, pero no se capturan de forma tan natural como en los enfoques fusionados. Otras dimensiones, como la latencia y la gestión de turnos, normalmente pueden optimizarse hasta alcanzar niveles de rendimiento comparables en ambos enfoques.
Modelo fusionado
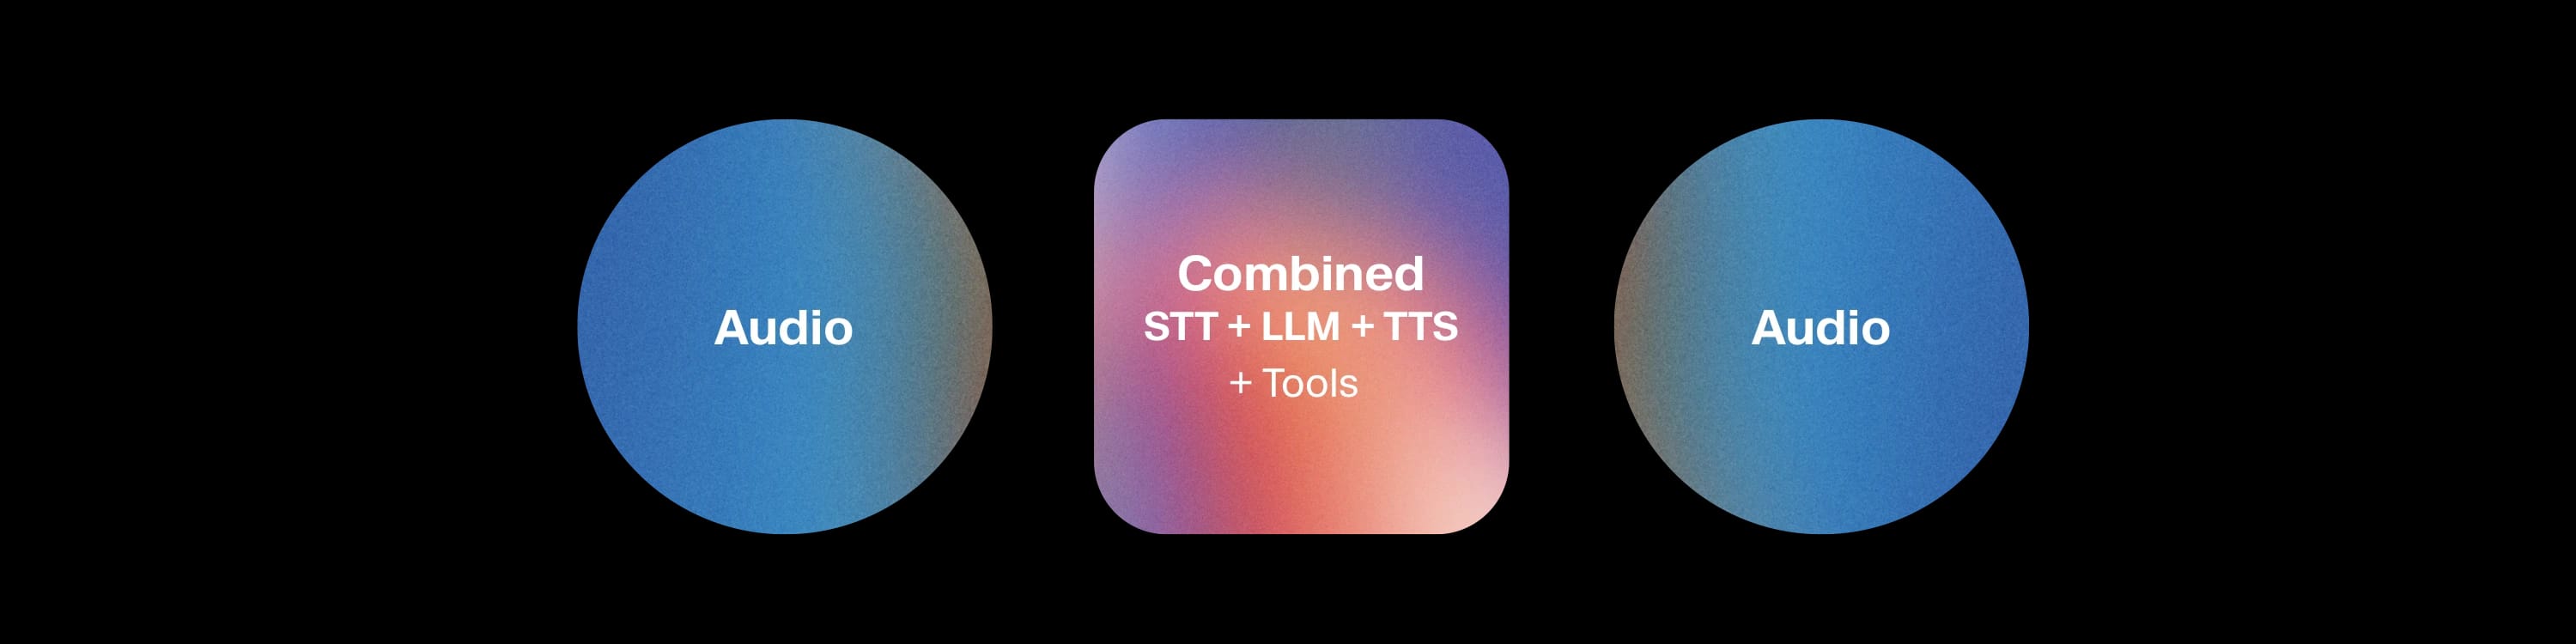
Las arquitecturas fusionadas adoptan un enfoque fundamentalmente distinto. El reconocimiento, el razonamiento y la generación tienen lugar dentro de una única red multimodal. Entra audio y sale audio, sin ninguna capa intermedia que se pueda inspeccionar.
Esta ausencia de etapas intermedias es tanto su atractivo como su limitación. La arquitectura fusionada puede conservar las señales prosódicas de forma natural, porque la voz nunca se descompone en texto. Sin embargo, hay poca capacidad para aplicar medidas de protección, sustituir componentes individuales o inspeccionar resultados intermedios para depurar. También existen limitaciones a la hora de ajustar el STT para terminología específica de un sector o de integrar un LLM diferente para mejorar el razonamiento y las llamadas a herramientas. El sistema es una sola red y los equipos están limitados a las capacidades de razonamiento con las que se distribuye, que hoy implican núcleos más ligeros que no pueden igualar a los LLM de frontera en tareas complejas.
Las cinco arquitecturas
1. En cascada básica
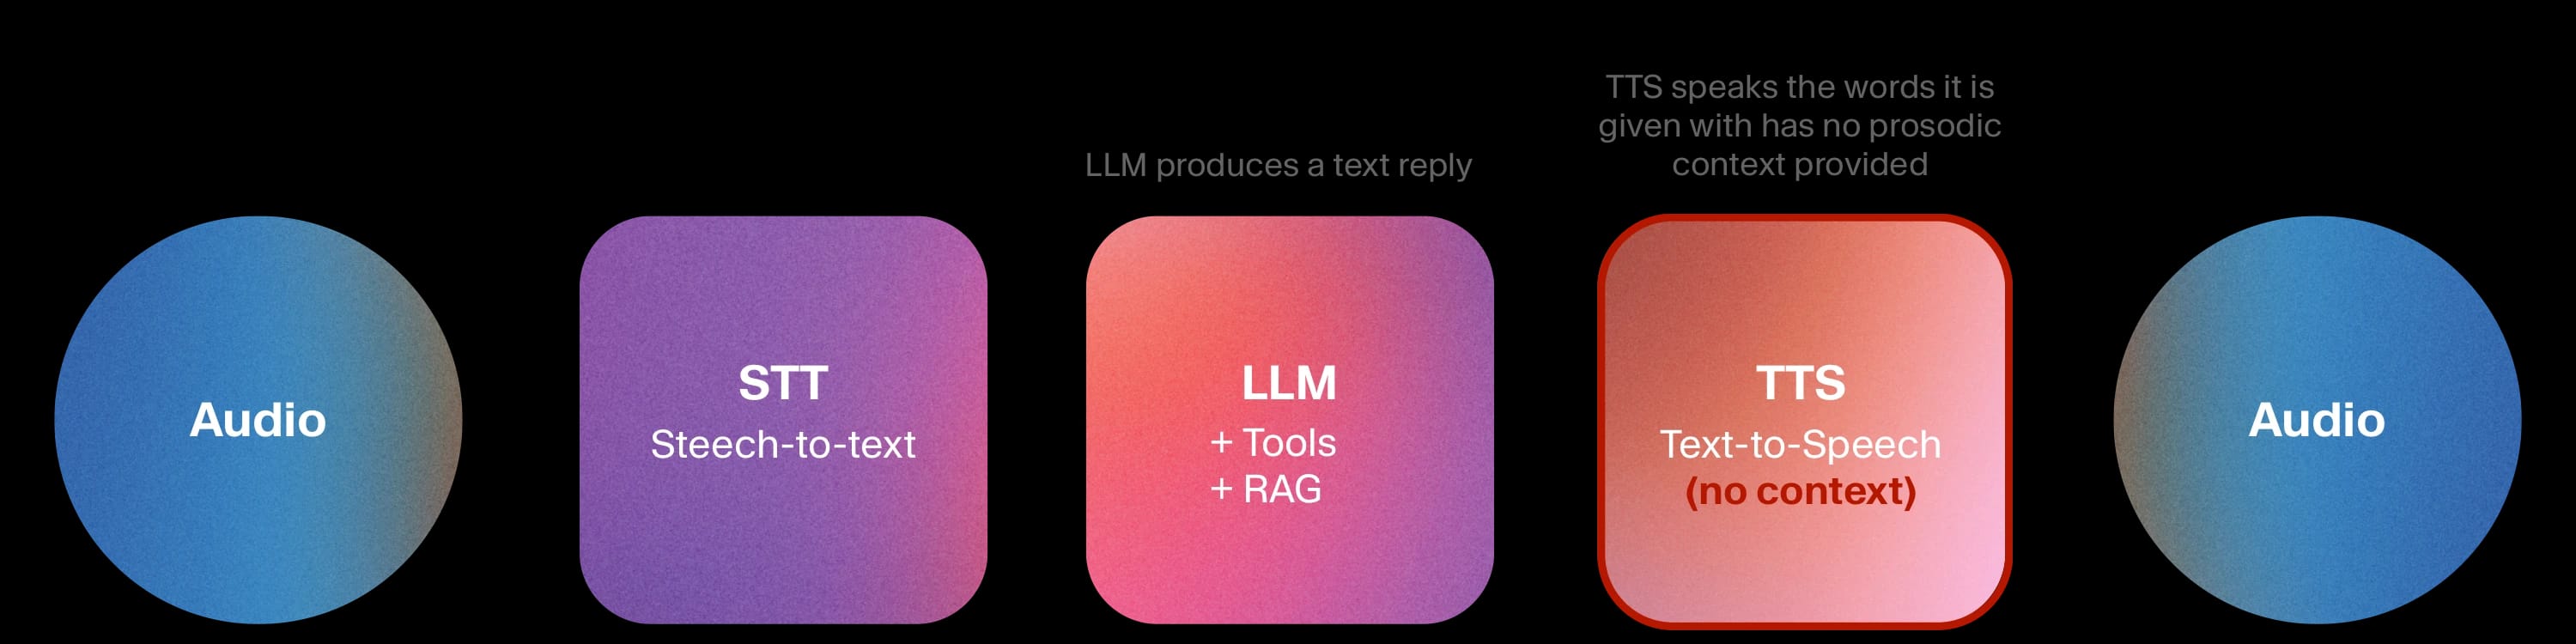
El audio se transcribe, el LLM genera una respuesta de texto y el TTS la pronuncia. Todas las etapas funcionan con texto sin formato, así que puedes verlo, probarlo y controlarlo todo.
Las ventajas en términos de confianza son claras: medidas de protección en la capa de texto, flujos de conversación deterministas y registros de auditoría completos. Como el LLM es un componente independiente, puedes combinar el agente con el modelo de frontera que ofrezca las mejores capacidades de razonamiento o llamadas a herramientas, y actualizarlo en cuanto aparezca uno mejor. La debilidad está en la calidad de la conversación: sin un TTS contextual, el agente suena funcional pero plano. No hay adaptación emocional ni variación prosódica, algo aceptable para comunicar saldos de cuenta, pero insuficiente para atender a un cliente frustrado.
Ejemplos de casos de uso:
- Sustitución de IVR en telecomunicaciones y servicios públicos
- Gestión de preguntas frecuentes en la incorporación de usuarios de SaaS
- Notificaciones salientes, como confirmaciones de citas, recordatorios de recetas y avisos de entrega, donde la coherencia importa más que la calidez
2. En cascada avanzada
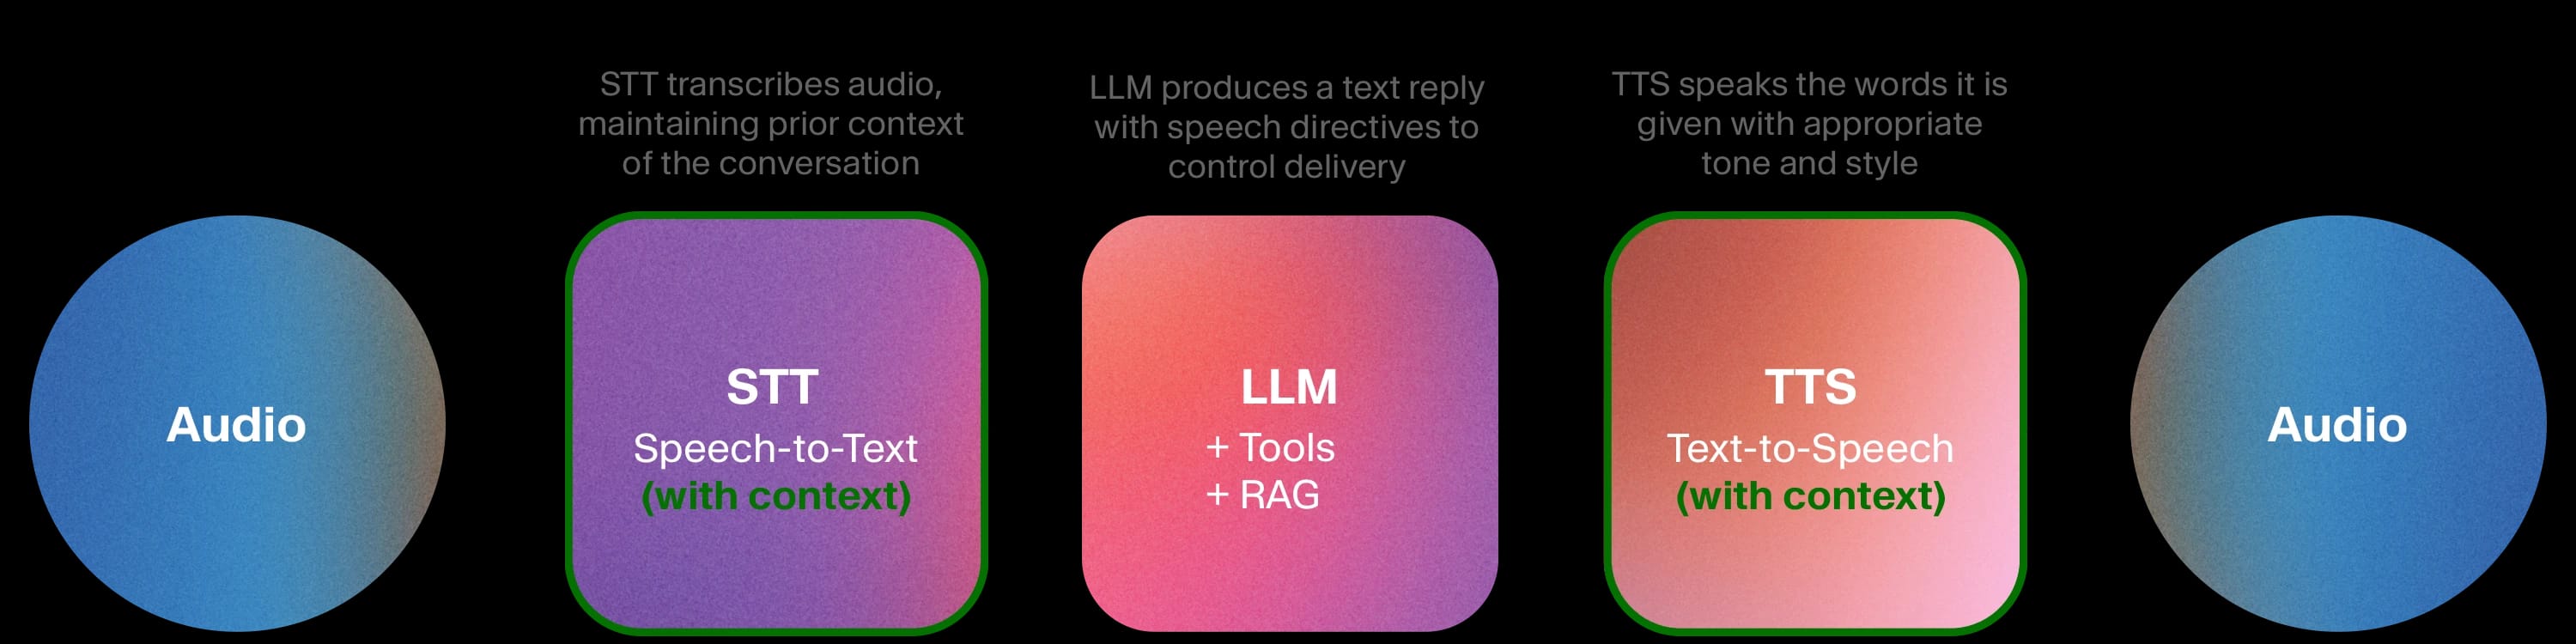
La misma arquitectura modular, pero ahora varios componentes operan con un contexto más rico. Esto es lo que hemos creado con Modo Expresivo en ElevenAgents.
El modelo STT Scribe v2 Realtime genera transcripciones rápidas y precisas a partir del contexto previo de la conversación. A partir del texto, el LLM indica al TTS cómo debe expresar la voz, no solo qué debe decir, con instrucciones como «de forma tranquilizadora», «con énfasis» o «con urgencia», adaptando dinámicamente su tono durante toda la conversación. El sistema de gestión de turnos se basa en las mismas señales, lo que permite al agente determinar cuándo responder y cuándo ceder el turno. Los modelos de voz están ubicados conjuntamente en una única pila, sin saltos de red entre componentes, por lo que la latencia se mantiene baja.
La arquitectura conserva todo lo de la cascada básica: transparencia total, medidas de protección en la capa de texto, componentes intercambiables, ajuste por dominio y acceso a los modelos de llamadas a herramientas y razonamiento más potentes disponibles. Añade una mejora significativa en prosodia, latencia y gestión de turnos. Los equipos pueden integrar un nuevo LLM de frontera la semana de su lanzamiento o ajustar el STT para el sector sanitario sin reconstruir ningún otro componente.
Ejemplos de casos de uso:
- Atención al cliente para servicios financieros, donde una comunicación empática en una llamada por un cargo impugnado se combina con estrictas medidas de cumplimiento normativo y un registro completo de la interacción
- Recepcionistas sanitarios que realizan el triaje de llamadas de pacientes con la urgencia adecuada, flujos conformes con HIPAA y reconocimiento de voz ajustado al dominio para terminología médica
- Asistentes de ventas que mantienen un tono cálido y persuasivo mientras siguen una guía estructurada y actualizan el CRM
3. En cascada híbrida y fusionada
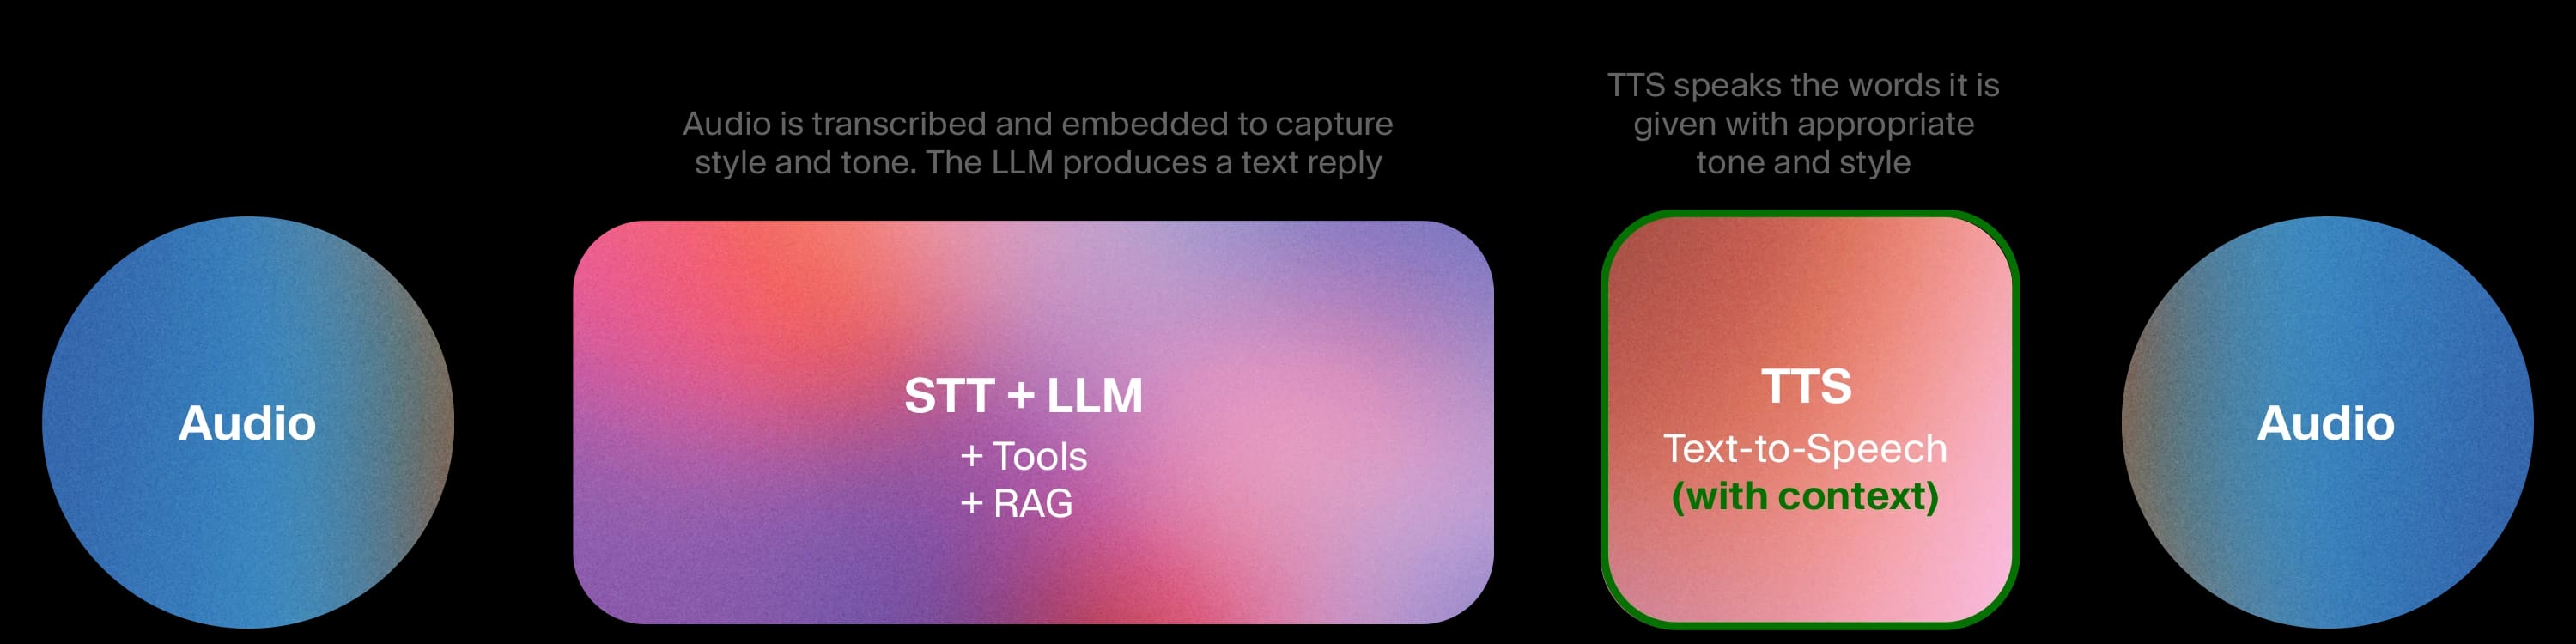
Algunas arquitecturas introducen características acústicas de la voz de entrada —pronunciación, emoción y tono— directamente en el LLM como embeddings, en lugar de convertirlas primero en texto. El TTS sigue siendo modular.
Esto proporciona al LLM información más rica sobre cómo se ha dicho algo, no solo qué se ha dicho, lo que resulta valioso para aplicaciones específicas. El bloque fusionado ASR+LLM es más difícil de auditar que una transferencia de texto limpia porque la representación intermedia es un embedding, no algo que una persona pueda leer. Además, el LLM ya no se puede sustituir fácilmente, lo que limita tus capacidades de razonamiento y llamadas a herramientas al modelo en torno al que se creó el bloque fusionado.
Ejemplos de casos de uso:
- Aprendizaje de idiomas y entrenamiento de pronunciación, donde oír cómo habla un estudiante importa tanto como lo que dice
- Atención sensible al tono y de baja complejidad, donde detectar la frustración importa, pero la tarea en sí es sencilla.
4. Fusionada secuencial
Un único modelo multimodal gestiona el reconocimiento, el razonamiento y la generación en una sola pasada, un turno cada vez.
La prosodia puede ser muy buena. Como la voz nunca se descompone en texto, el modelo conserva de forma natural el ritmo, la entonación y las señales emocionales. Las conversaciones breves pueden sonar extraordinariamente fluidas.
Pero sin una capa de texto hay poca capacidad para aplicar medidas de protección, pocos resultados intermedios para depurar y poca flexibilidad para incorporar un LLM mejor o ajustar el STT a tu dominio. Los núcleos de razonamiento suelen ser más ligeros que los LLM de frontera, por lo que las llamadas a herramientas complejas y las tareas de varios pasos se resienten. Cuando una tarea exige resolver un problema complejo, la prosodia por sí sola no basta.
Ejemplos de casos de uso:
- Acompañantes personales, chatbots de entretenimiento y aplicaciones donde la expresividad impulsa la interacción y los requisitos de cumplimiento normativo son mínimos.
5. Fusionada dúplex
La entrada y la salida se procesan simultáneamente, y el modelo escucha y habla al mismo tiempo. Esto puede hacer que los intercambios breves resulten sorprendentemente naturales, con habla realmente solapada y transiciones de turno fluidas.
También es la arquitectura más difícil de controlar, las medidas de protección son muy difíciles de aplicar y la diafonía introduce errores impredecibles. Inspeccionar, registrar o depurar resulta extremadamente difícil, y el sistema es en gran medida cerrado, con opciones mínimas para sustituir componentes, ajustar el dominio o personalizarlo. El razonamiento y el uso de herramientas están aún más limitados que en los modelos fusionados secuenciales porque el procesamiento simultáneo deja menos capacidad para lógica compleja. Y el mismo procesamiento simultáneo que hace naturales los intercambios cortos vuelve inestables las conversaciones largas.
Ejemplos de casos de uso:
- Apps experimentales de acompañamiento, plataformas sociales de voz y demostraciones de investigación donde se acepta un comportamiento impredecible.
Elegir la arquitectura adecuada para tu caso de uso
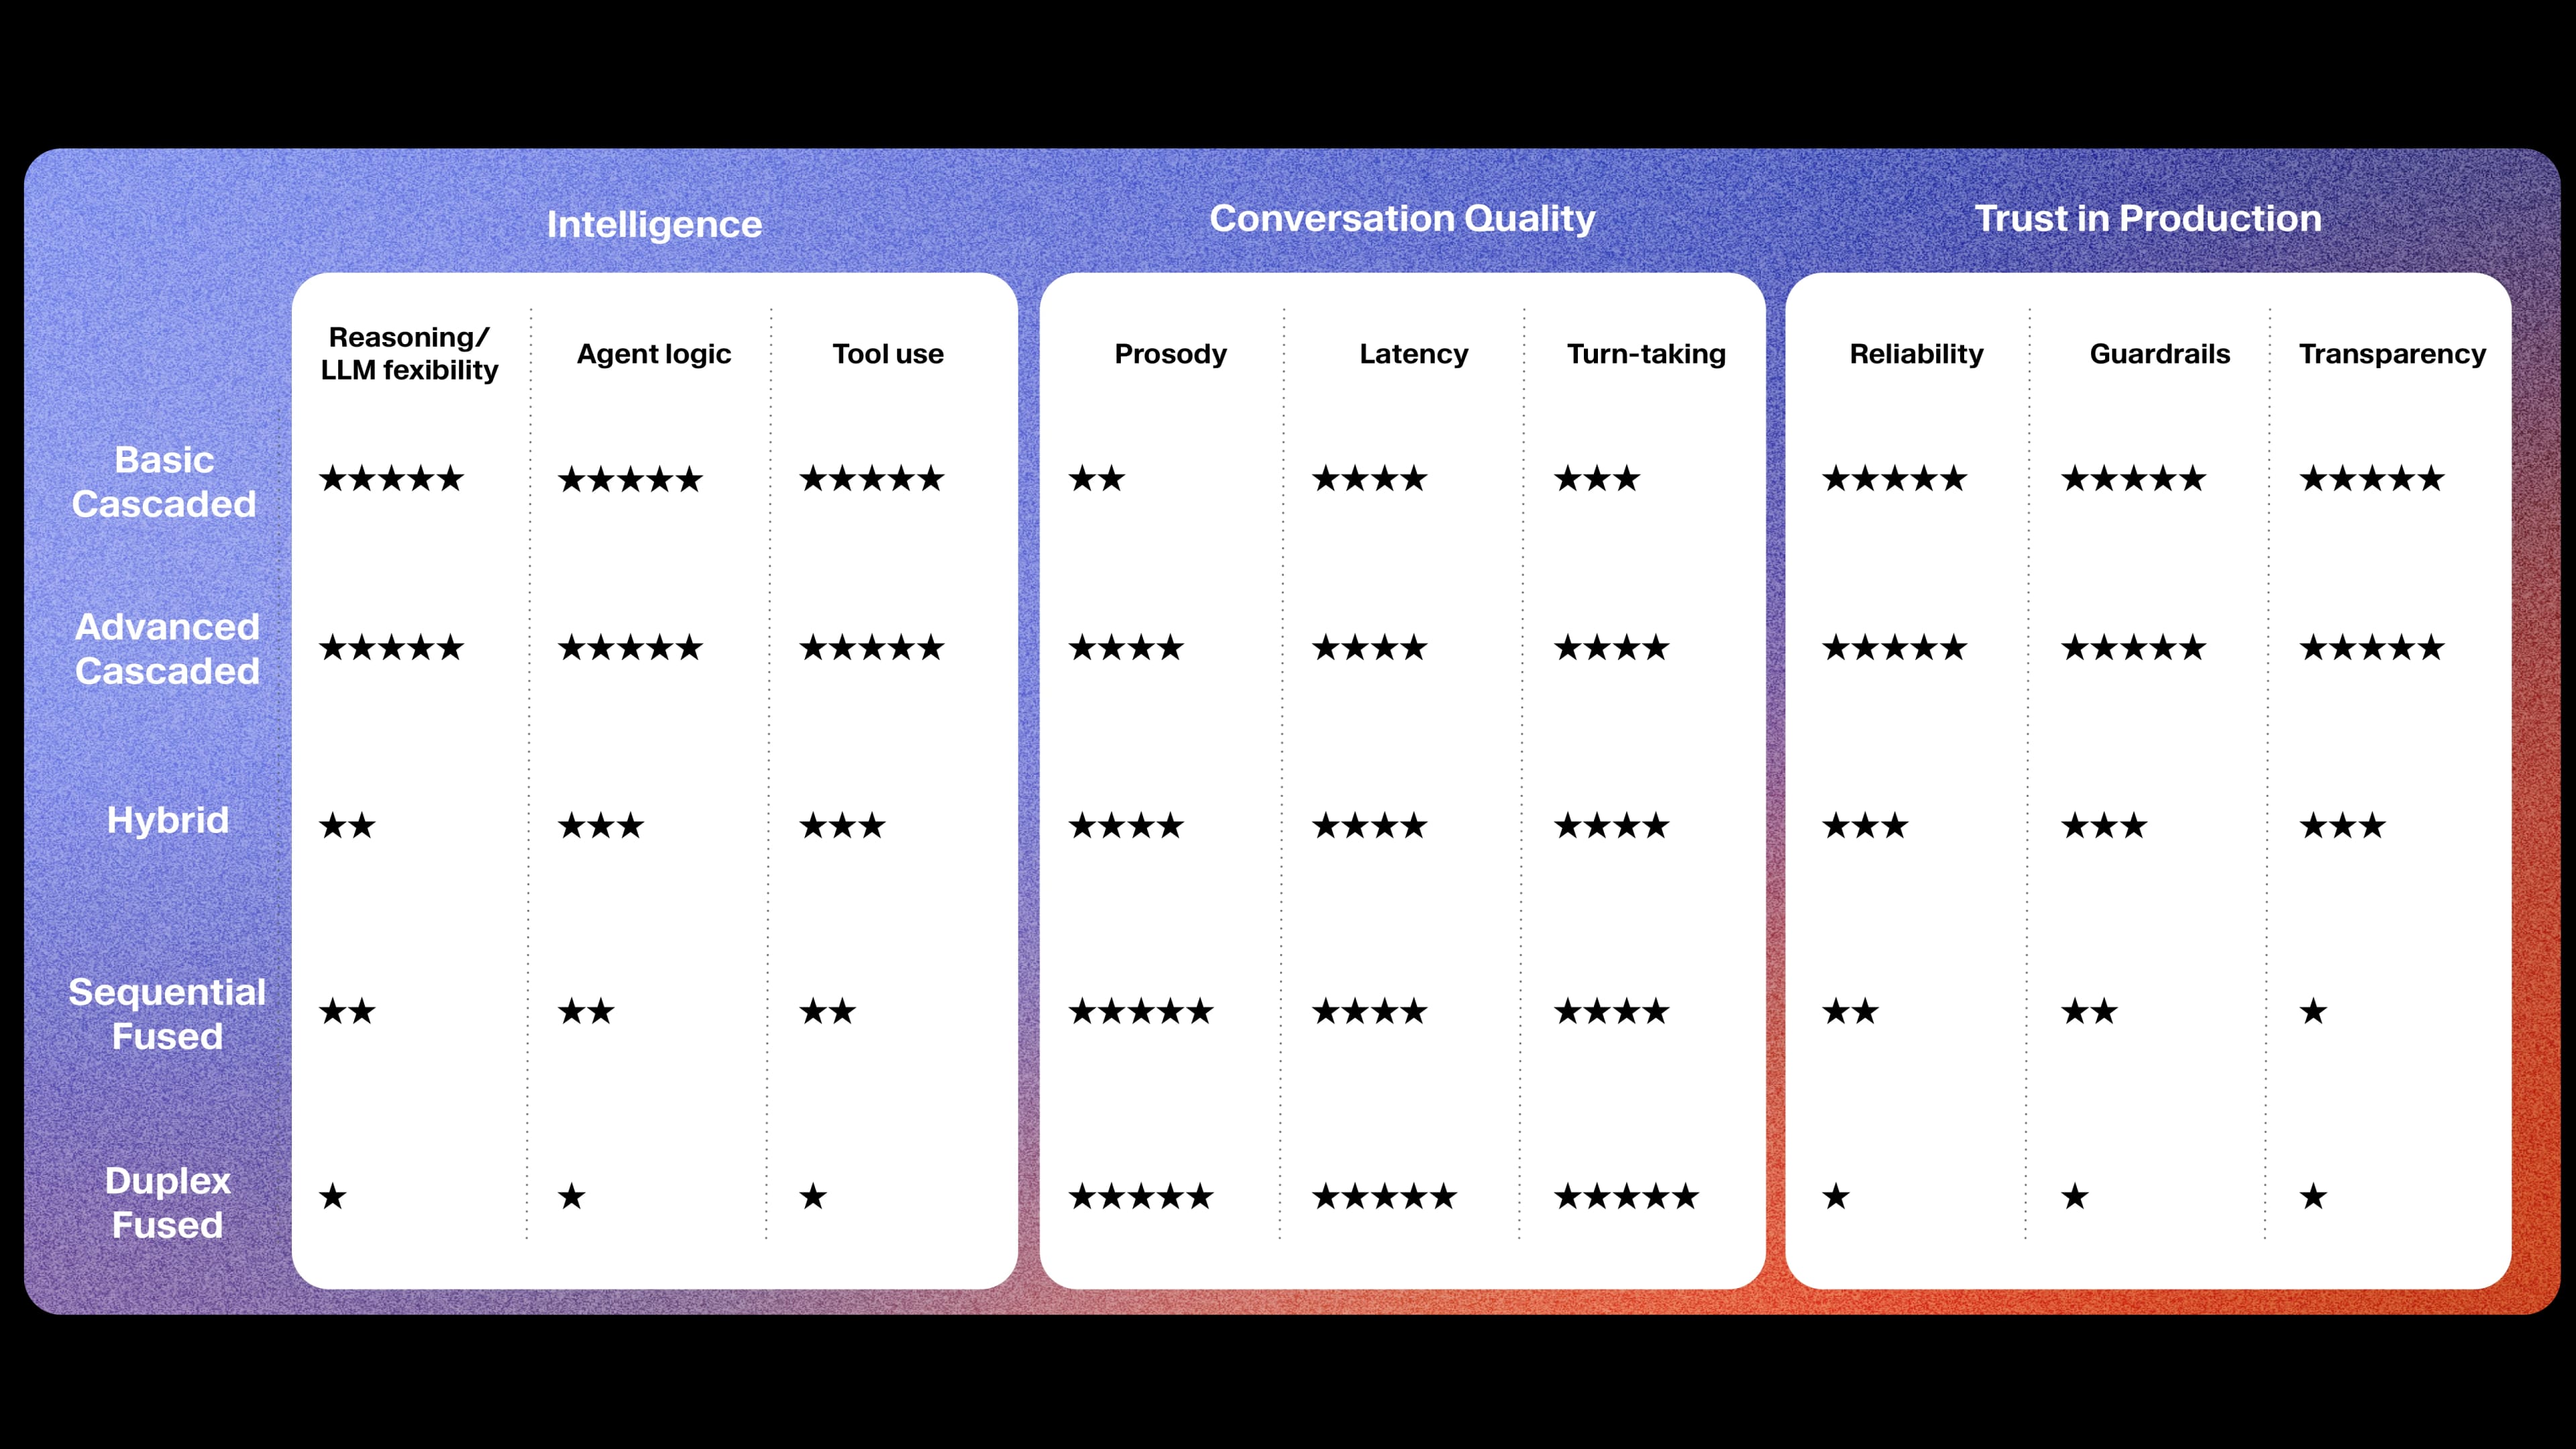
La arquitectura adecuada depende de lo que requiera cada aplicación. Si estás creando una experiencia en la que una voz natural es la característica principal, las arquitecturas fusionadas ofrecen ventajas reales si estás dispuesto a renunciar a razonamiento de frontera, medidas de protección y transparencia. Aunque los modelos fusionados lideran en prosodia, los sistemas avanzados en cascada se acercan cada trimestre, mientras que los modelos fusionados no han logrado avances significativos en razonamiento complejo ni confianza debido a limitaciones de su arquitectura.
Para la mayoría de empresas y administraciones públicas, la mejor arquitectura es aquella que no solo suena bien, sino que también es capaz, personalizable, fiable y está lista para desplegarse a escala. Por eso decidimos crear ElevenAgents con una arquitectura avanzada en cascada e inversiones en Modo Expresivo y modelos de Voz a Texto y Texto a Voz de primer nivel, optimizados conjuntamente. Esto permite a los equipos Voz a Texto y Texto a Voz. Esto permite a los equipos crear agentes con altos niveles de inteligencia, fiabilidad y control, junto con una voz natural y humana.
A medida que los agentes de IA se expanden por la atención al cliente, la educación, los asistentes personales y otros ámbitos, los que tengan éxito se basarán en arquitecturas adaptadas a sus aplicaciones específicas.