¿Qué es la latencia de la IA conversacional y qué factores influyen en ella?
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Para la IA conversacional, la latencia es lo que diferencia las buenas aplicaciones de las excelentes.
La IA conversacional es, por naturaleza, aspiracional. Busca reproducir la misma sensación que conversar con una persona, reflejando el mismo rango emocional, tono y cadencia. Si además tienes en cuenta lo «natural» que resulta el intervalo entre que dejas de hablar y que un agente de IA empieza a responder, obtienes un objetivo de latencia basado en cómo se comunican realmente las personas.
Las empresas que quieran implementar agentes de IA conversacional a escala deben reducir esa latencia al máximo si quieren lograr esa ilusión de naturalidad. Este artículo explica qué es la latencia de la IA conversacional, qué provoca retrasos en todo el flujo y cómo reducirlos a grandes rasgos.
Resumen
- La latencia de la IA conversacional es el retraso total de extremo a extremo desde que un usuario deja de hablar hasta que escucha la primera palabra del agente.
- Los agentes con más de 700 ms pueden resultar poco naturales, y los que superan los 1200 ms tienen tasas de abandono elevadas.
- La latencia se acumula en cada etapa del flujo de IA conversacional.
- ElevenAgents gestiona todo el flujo en una arquitectura única y unificada, haciendo que la IA conversacional de baja latencia sea accesible para tu empresa.
¿Qué es la latencia de la IA conversacional?
La latencia de la IA conversacional se refiere al tiempo total que tarda un sistema en responder después de que hayas hablado. En los modelos de IA modernos, la latencia se mide en ms. Entre bastidores, la cifra de latencia total se compone de varios procesos independientes, cada uno de los cuales aporta una parte del flujo de extremo a extremo.
Un flujo típico de IA conversacional es el siguiente:
- Un usuario habla
- Un modelo de voz a texto transcribe el audio
- La transcripción se envía a un modelo de LLM, que genera una respuesta
- El texto del LLM se sintetiza después en audio con un modelo de texto a voz
- El audio se reproduce para el usuario
Cada una de estas etapas añade latencia a un sistema de IA conversacional. Por eso, al hablar de latencia, conviene aclarar varios acrónimos.
Latencia de inferencia del modelo
La latencia de inferencia del modelo es el tiempo que un modelo dedica a generar una salida, medido internamente y sin tener en cuenta factores externos. Es una medida específica del modelo que indica la rapidez con la que funciona tu motor con entradas habituales. Por ejemplo, Flash v2.5 tiene una latencia de inferencia de alrededor de 75 ms. Con este dato, puedes comparar la rapidez de los modelos de distintos competidores.
Dicho esto, recuerda que no es la cifra de latencia que experimenta realmente un usuario. Se refiere específicamente al tiempo total que un modelo dedica a generar una salida.
Tiempo hasta el primer token del LLM
El tiempo hasta el primer token (TTFT) de un modelo de lenguaje grande (LLM) es el tiempo total que tarda un modelo de lenguaje grande en procesar un prompt y generar su primer token de salida utilizable.
La generación de TTS comienza cuando llega el primer token de tu LLM, por lo que mide cuánto tarda el LLM en empezar a activar tu modelo de TTS. En la mayoría de sistemas de IA conversacional de extremo a extremo, el TTFT del LLM constituye una parte importante de la latencia total.
Tiempo hasta el primer audio de TTS (TTFA)
El tiempo hasta el primer audio de TTS (TTFA) mide el tiempo desde la primera solicitud de TTS hasta que el primer fragmento de audio sale realmente del modelo. Es una forma de describir la latencia de inferencia del modelo, pero específicamente para motores de TTS.
Tiempo de extremo a extremo hasta el primer audio (TTFA)
El TTFA de extremo a extremo es la latencia total de la IA conversacional. Es la suma de todas las partes del flujo, desde el reconocimiento de voz, el TTFT del LLM, el TTS y el TTFA, hasta todas las transmisiones de red entre pasos. Al hablar de la latencia de la IA conversacional en conjunto, esta es la métrica que percibe el usuario.
Cuando hablen, esperarán al TTFA de extremo a extremo antes de escuchar una respuesta de tu agente. Es una medida integral, lo que significa que mejorar cualquier parte del flujo la mejorará.
Por qué importa la latencia de la IA conversacional
Cuando un usuario habla con tu agente de IA, la latencia se convierte en un factor clave de su percepción de la experiencia. Una latencia baja reduce el tiempo que debe esperar para recibir una respuesta, haciendo que la conversación resulte natural y que tu agente parezca competente.
Los agentes con una latencia alta parecen artificiales y menos competentes, aunque la calidad de sus respuestas sea la misma. Para las empresas, incluso una diferencia de unos pocos cientos de ms puede parecer una eternidad y hacer que tu agente de atención al cliente resulte lento e ineficaz.
Estos son algunos escenarios que muestran por qué importa en la práctica la latencia de la IA conversacional:
- Menos de 500 ms: Un agente conversacional resulta ágil y responde con rapidez. Puede que los usuarios no perciban el retraso entre que dejan de hablar y reciben una primera respuesta, lo que permite que la conversación fluya sin problemas.
- De 500 ms a 1000 ms: El retraso entre que un usuario deja de hablar y recibe una respuesta puede empezar a notarse. Es solo un poco demasiado largo, por lo que los usuarios podrían intentar anticiparse repitiéndose o haciendo una pausa para comprobar si el agente les ha entendido de verdad.
- Más de 1000 ms: Los retrasos empiezan a parecer lentos, con pausas que hacen que algunos usuarios sientan que el agente de IA no sigue del todo el ritmo de la conversación. Las transcripciones pueden mostrar interrupciones ocasionales o solicitudes para hablar con un agente humano. En algunos casos, los usuarios pueden abandonar la llamada.
Cada uno de estos umbrales se traduce en resultados empresariales reales.
En el extremo bajo del espectro de latencia, tendrás un agente de atención al cliente capaz de gestionar de forma natural las preguntas entrantes y ayudar a los usuarios a resolver sus consultas sin ayuda adicional. Esto reduce la carga de tus agentes humanos y mantiene alta la satisfacción de los clientes. En el extremo alto del espectro, frustrarás a tus clientes con un agente que parece dudar durante demasiado tiempo.
Hemos definido los benchmarks de presupuesto de latencia para agentes de voz en otro artículo para mostrar cómo es una buena latencia tanto en valores P50 como P95.
¿Qué causa la latencia de la IA conversacional?
La latencia de la IA conversacional es un término que resume varios procesos distintos, donde cada segmento contribuye al conjunto. Teniendo esto en cuenta, el cuello de botella para lograr una baja latencia es más un problema de sistema que algo que se resuelva simplemente eligiendo un modelo mejor. Al fin y al cabo, varios modelos interactúan dentro del flujo.
Para desarrolladores, hemos elaborado una guía técnica detallada sobre la optimización de la latencia de los agentes de voz que puedes utilizar para mejorar cada etapa del tiempo de extremo a extremo hasta el primer audio (TTFA).
Más allá del flujo principal, otros factores como la telefonía y las llamadas a funciones también añaden latencia, aunque no formen parte de la infraestructura interna del modelo.
Aquí tienes una visión general de todos los factores que contribuyen a la latencia de la IA conversacional.
Reconocimiento automático de voz
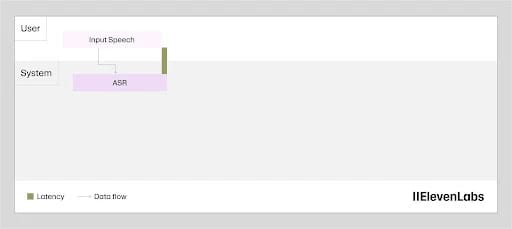
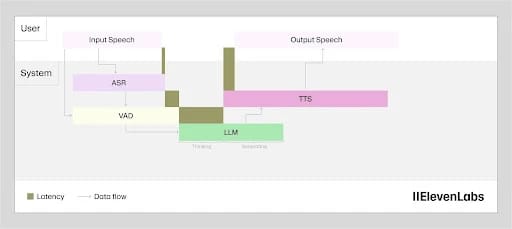
La latencia del reconocimiento de voz no es el tiempo que se tarda en generar una transcripción. El proceso de transcripción se ejecuta en segundo plano mientras el usuario habla, por lo que, cuando termina de hablar, el texto ya está en gran parte listo.
En este caso, la latencia es el intervalo entre el final del habla y el momento en que se finaliza la transcripción y se envía a la siguiente etapa. Scribe v2 Realtime reduce este intervalo a aproximadamente 150 ms mediante streaming continuo, para que la salida esté lista en cuanto termina el turno.
Gestión de turnos y detección del final de intervención
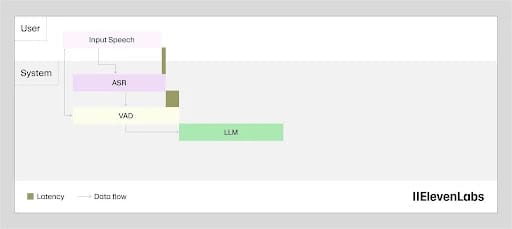
Un detector de actividad de voz (VAD) se sitúa entre el reconocimiento de voz y el modelo de lenguaje. Su función es decidir cuándo el usuario ha terminado realmente de hablar.
Para evitar errores, el VAD espera a que se alcance un umbral de silencio sostenido antes de declarar que el turno ha terminado, y esa espera añade latencia antes de que el modelo de lenguaje procese una palabra. Esa pequeña latencia adicional suma tiempo, pero también evita que el sistema empiece a responder mientras el usuario sigue hablando.
Técnicamente, si todos los demás componentes de la IA conversacional tuvieran latencia cero, la latencia atribuida a la gestión de turnos sería algo positivo. Las personas hacen una breve pausa antes de responder. Que una máquina haga una pausa similar aporta realismo a la interacción. Sin embargo, como los demás componentes de la IA conversacional ya introducen latencia, lo ideal es que sea mínima.
Procesamiento del modelo de lenguaje
Una vez que la transcripción está lista desde el motor de voz a texto (STT), el modelo de lenguaje genera una respuesta. La latencia aquí es el tiempo que tarda en empezar a generar tokens, no en generar la respuesta completa. Esos tokens se transmiten directamente a la etapa de TTS a medida que llegan, así que lo más importante es el TTFT.
Además de la elección del modelo, tanto la longitud del prompt como el tamaño de la base de conocimiento afectan a esta etapa. Cuanto más contexto tenga que considerar el LLM, más tardará. Al diseñar estos sistemas a escala, tendrás que encontrar el equilibrio adecuado entre una base de conocimiento útil y un prompt conciso para mantener la rapidez.
Síntesis de voz
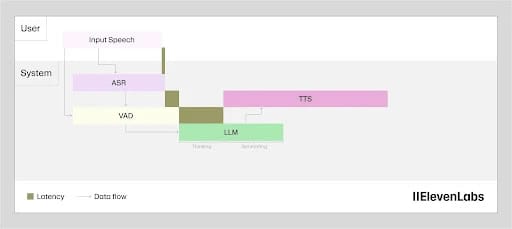
La latencia de TTS es el tiempo entre recibir los primeros tokens del modelo de lenguaje y el inicio del audio. Como los tokens llegan más rápido de lo que se reproduce el habla humana, el modelo de síntesis nunca espera a tener la respuesta completa. La latencia de TTS es estrictamente el tiempo hasta el primer fragmento de audio.
Esta etapa solía ser la que más contribuía individualmente a la latencia de la IA conversacional, ya que los modelos más antiguos tardaban entre 2 y 3 segundos en empezar a generar voz. Flash v2.5 de ElevenLabs aborda este problema directamente, ofreciendo síntesis de voz con una latencia de ~75 ms y reduciendo ese cuello de botella de segundos a una fracción de segundo.
Latencia de red
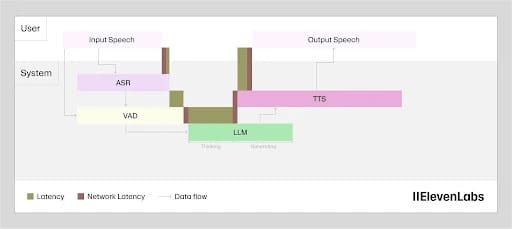
Enviar datos de un lugar a otro siempre añade latencia, y la distancia geográfica no hace más que agravar la latencia de red de ida y vuelta.
Como varios componentes trabajan juntos para generar una respuesta de extremo a extremo, puede acumularse una latencia considerable a través de varios saltos de red.
Llamadas a funciones
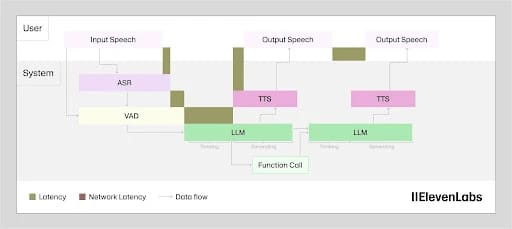
Las llamadas a funciones añaden comunicaciones de ida y vuelta de la API en la etapa del LLM. Una consulta interna rápida añade decenas de milisegundos, mientras que un procesador de pagos o un sistema de inventario puede añadir segundos. La cantidad de latencia depende por completo del servicio al que se llama, lo que convierte esta etapa en la más difícil de optimizar directamente.
El patrón más eficaz es indicar al LLM que responda antes de que se complete la llamada a la herramienta. Una frase como «Déjame comprobarlo» mantiene al usuario involucrado mientras se resuelve la llamada externa, en lugar de dejar silencio. La respuesta de voz comienza mientras la herramienta se ejecuta en paralelo.
Cómo reducir la latencia de la IA conversacional
Reducir la latencia de la IA conversacional requiere abordar cada etapa del flujo según su impacto. Aunque cada mejora individual que realices afecta a la latencia, tendrás que trabajar en todo el flujo de forma integral para lograr el mayor cambio.
Estos son algunos principios que pueden orientarte para reducir la latencia de la IA conversacional a alto nivel:
- Elección del modelo de TTS: Los modelos de TTS optimizados para la velocidad, como Flash v2.5, utilizan arquitecturas distintas de los modelos optimizados para la calidad, como Eleven v3 y Eleven v4. Para agentes de voz en tiempo real, la elección adecuada es el modelo de mayor calidad que cumpla tu objetivo de latencia, que casi siempre será uno optimizado para la velocidad.
- Elección del modelo de LLM: Los LLM más pequeños y rápidos suelen producir un tiempo hasta el primer token menor que los más grandes. Elegir el LLM más rápido que siga cumpliendo tu estándar de calidad para la tarea importa tanto como elegir el modelo de TTS.
- Streaming: El TTS en streaming devuelve audio en fragmentos a medida que avanza la síntesis, de modo que el usuario oye la primera palabra mientras el modelo sigue generando el resto. Este concepto también se aplica a la salida del LLM: iniciar la síntesis de TTS con la primera frase mientras el modelo de lenguaje genera las siguientes puede recuperar latencia del flujo.
- Prompt de sistema: Los usuarios pueden simplificar los prompts de sistema trasladando las instrucciones a procedimientos o workflows, en lugar de mantenerlas como parte de cada paso de decisión. Esto reduce la cantidad de contexto sobre el que el modelo debe razonar en cada turno.
- Guardrails: Ejecutar los guardrails en el modelo de streaming permite que la salida empiece a reproducirse antes de que termine la comprobación, en lugar de bloquear la reproducción hasta que finalice.
- Ubicación conjunta de modelos: Usar modelos ubicados conjuntamente cuando sea posible, como en la pila de ElevenLabs Agents, mantiene los componentes cerca unos de otros para que la latencia no aumente por los saltos entre modelos alojados por separado.
- Geografía: La proximidad entre tus servidores y tus usuarios puede reducir significativamente la latencia, ya que recorta directamente la contribución de la red al TTFA de extremo a extremo.
Además de estos factores, puedes consultar esta guía técnica para optimizar la latencia para obtener más información.
Empieza con IA conversacional de baja latencia en ElevenAgents
La latencia de la IA conversacional es un aspecto fundamental al crear e implementar agentes. Con ElevenAgents, la optimización de la latencia está integrada en el proceso. Desde técnicas de solapamiento para recuperar tiempo hasta una baja latencia de inferencia en cada componente, ElevenAgents crea pilas de IA conversacional de baja latencia para tu empresa.
Al final, el objetivo es crear realismo. Un usuario debe sentir la facilidad de hablar con una persona mientras obtiene las ventajas de un programa informático. Al optimizar los subprocesos, esto ya es posible.
Descubre más información sobre ElevenAgents o contacta con ventas para empezar hoy mismo.
Preguntas frecuentes sobre la latencia de la IA conversacional

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.