
¿Qué es la detección de actividad de voz y cómo funciona?
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
La detección de actividad de voz clasifica si breves fotogramas de audio de milisegundos contienen habla humana. Se utiliza en muchas aplicaciones de procesamiento de audio digital, como la transcripción, la telefonía y los agentes de voz.
En este artículo, veremos qué hace la detección de actividad de voz, qué no hace y cómo encaja en aplicaciones empresariales clave.
Resumen
- La detección de actividad de voz (VAD) es un componente fundamental de los flujos de trabajo de audio modernos. Analiza continuamente un flujo de audio y determina con un sí o un no si hay habla humana en cada fotograma de audio de milisegundos.
- VAD indica a las herramientas de audio posteriores cuándo deben funcionar y cuándo deben esperar. Lo usan los LLM, los servicios de transcripción y otros flujos de audio empresariales.
- Los algoritmos de detección de actividad de voz se ejecutan en un ciclo continuo de cinco etapas: capturar el audio, dividirlo en fotogramas, extraer características vocales, calcular la probabilidad de que contenga voz y transmitir una decisión a los servicios posteriores.
- En un principio, VAD se basaba exclusivamente en el procesamiento matemático de señales para determinar con un sí o un no la presencia de voz. Los sistemas modernos basados en IA usan redes neuronales para realizar la misma función, pero comprenden mejor el contexto del ruido de fondo y las señales semánticas.
- Los sistemas VAD solo clasifican si un fotograma de audio contiene voz. No indican cuándo una persona ha terminado de hablar. Los sistemas de endpointing usan VAD y otras herramientas de análisis heurístico para decidir si un hablante ha terminado su intervención.
- En entornos empresariales, VAD ayuda a los agentes de voz a conversar de forma natural con clientes sin interrumpirlos, optimiza el uso del ancho de banda de VoIP, reduce los costes de transcripción con IA de voz a texto (STT) y tiene otros usos.
- Prueba los sistemas VAD en condiciones reales. Las grabaciones impecables de estudio no son un medio eficaz para determinar sus capacidades.
¿Qué es la detección de actividad de voz (VAD)?
La detección de actividad de voz (VAD) es un proceso de software que clasifica si pequeños fragmentos de audio, llamados fotogramas, contienen voz. Los algoritmos VAD se ejecutan de decenas a cientos de veces por segundo en un flujo de audio y devuelven una respuesta binaria de «sí» o «no» sobre si detectan voz.
Se utiliza en flujos de audio digital más amplios, como las telecomunicaciones o la transcripción de voz. Indica a otros sistemas posteriores, como ASR/STT, LLM y planificadores de turnos, si deben escuchar activamente el flujo de audio o esperar.
VAD no es lo mismo que el reconocimiento automático de voz (ASR). Lo único que hace un sistema VAD es dar una respuesta probabilística de sí o no sobre si detecta voz. No genera palabras reales. Su función principal es indicar a los sistemas posteriores si deben procesar un determinado fotograma de audio.
¿Cómo funcionan los algoritmos de detección de actividad de voz?
Un algoritmo VAD se ejecuta sobre un flujo de audio y decide con un sí o un no si un fotograma de audio determinado, normalmente de 10 a 30 milisegundos, contiene voz.
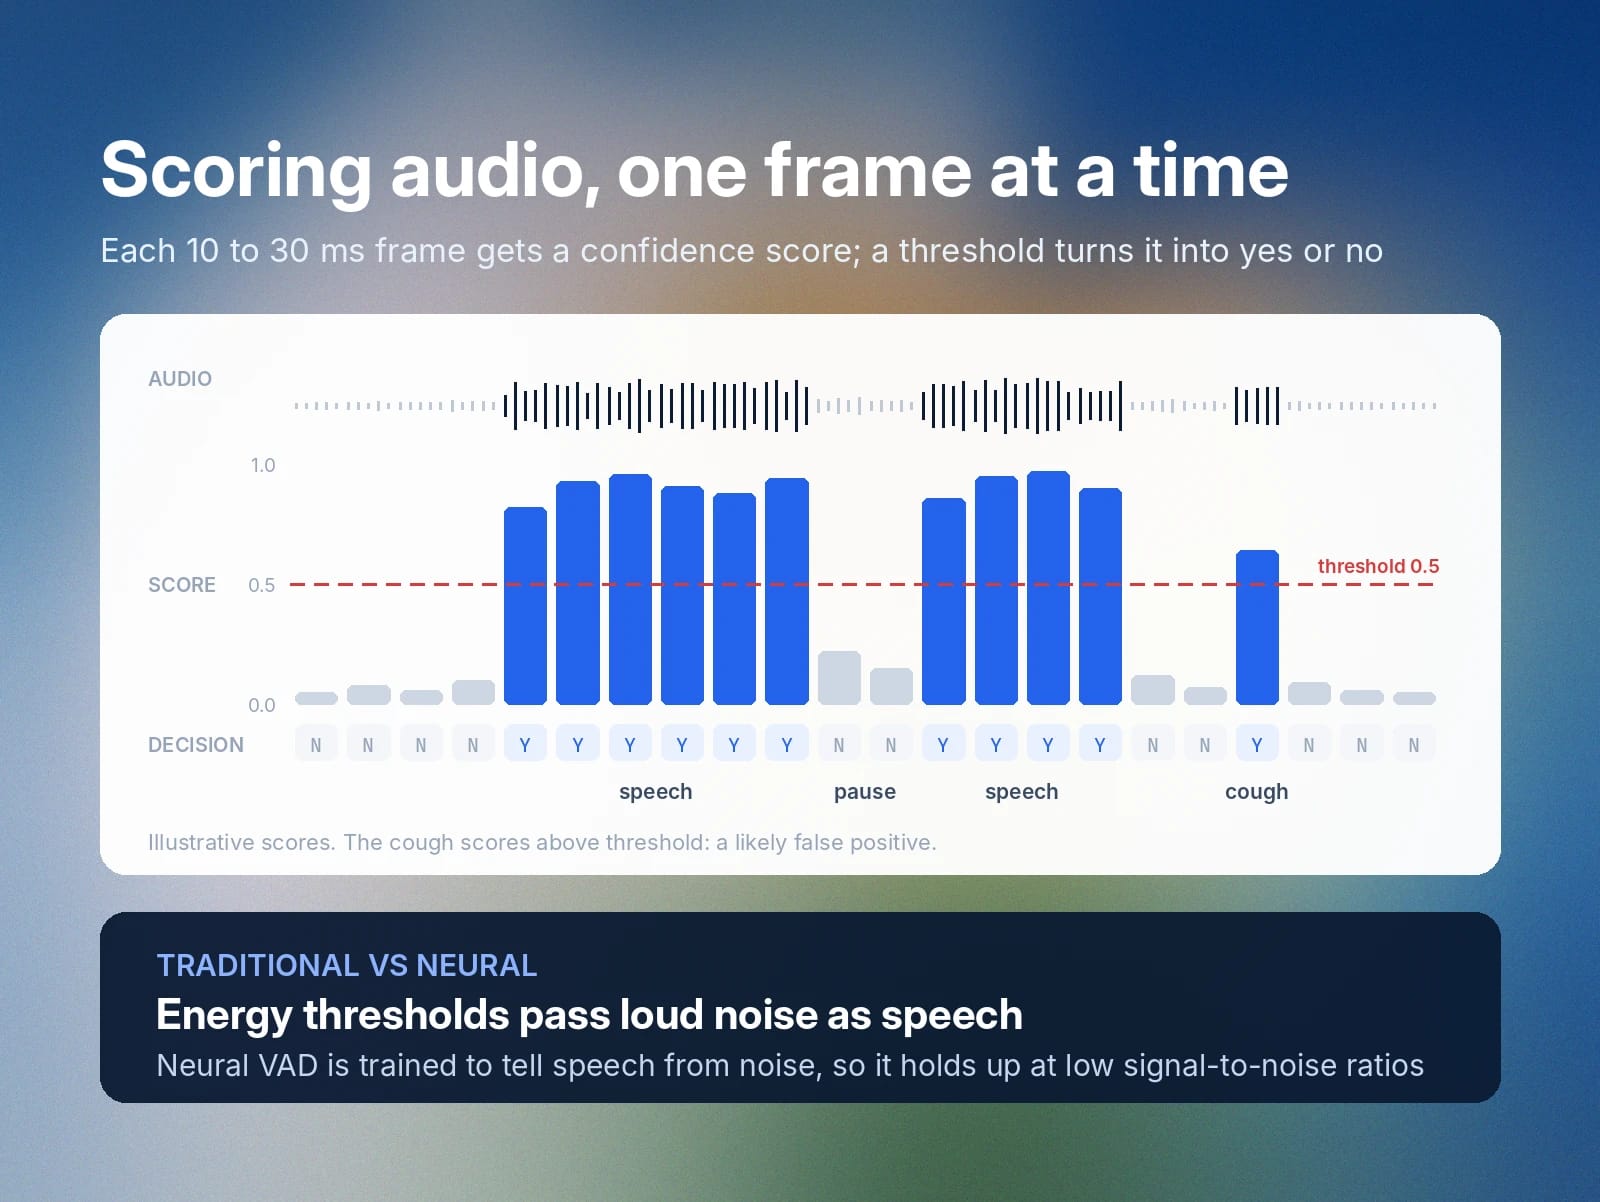
Funcionan de forma continua en un ciclo de cinco etapas:
- Captura de voz: El sistema que ejecuta VAD recibe un flujo de audio mediante WebRTC o telefonía y aplica un filtrado de ruido básico a los datos.
- Segmentación en fotogramas: El algoritmo divide el flujo de audio sin procesar en fotogramas uniformes.
- Extracción de características: El algoritmo extrae del flujo características acústicas que puede representar matemáticamente como datos digitales.
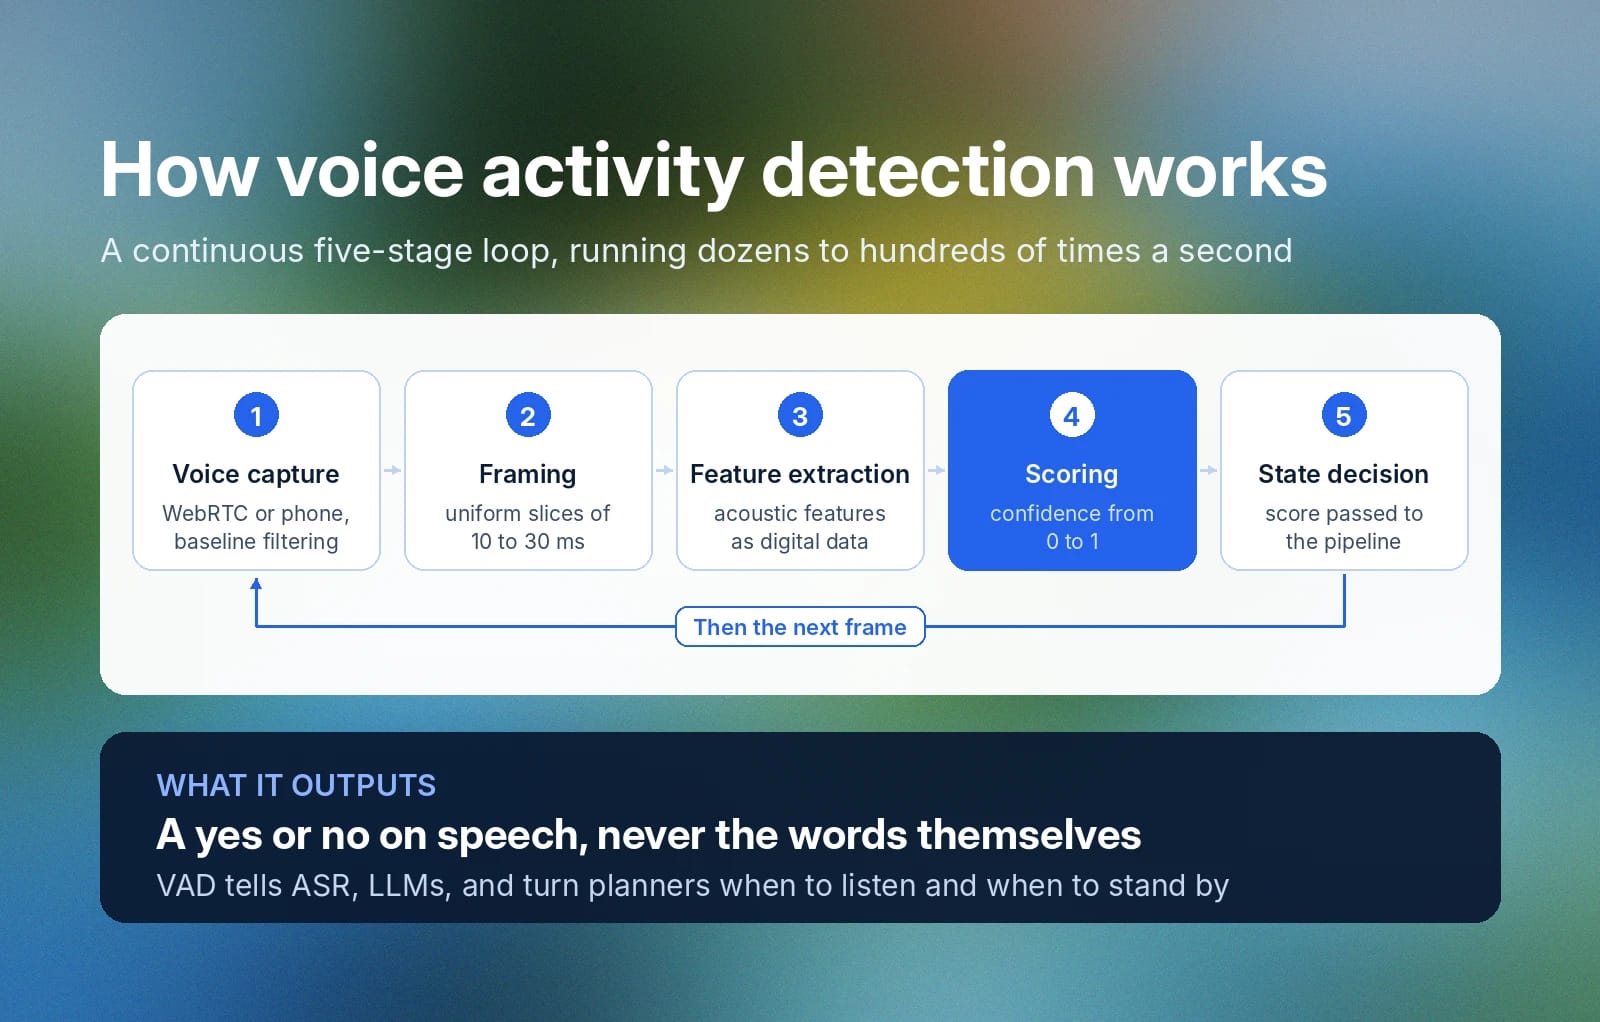
- Puntuación: El sistema procesa las características extraídas de un fotograma con el algoritmo VAD para generar una puntuación de confianza entre 0 y 1 (0 = «sin voz» y 1 = «voz») sobre si contiene voz.
- Decisión de estado: El sistema VAD transmite la puntuación de confianza al flujo de audio en el que se ejecuta para que este pueda decidir cómo gestionarla.
Detección de actividad de voz tradicional frente a la basada en IA
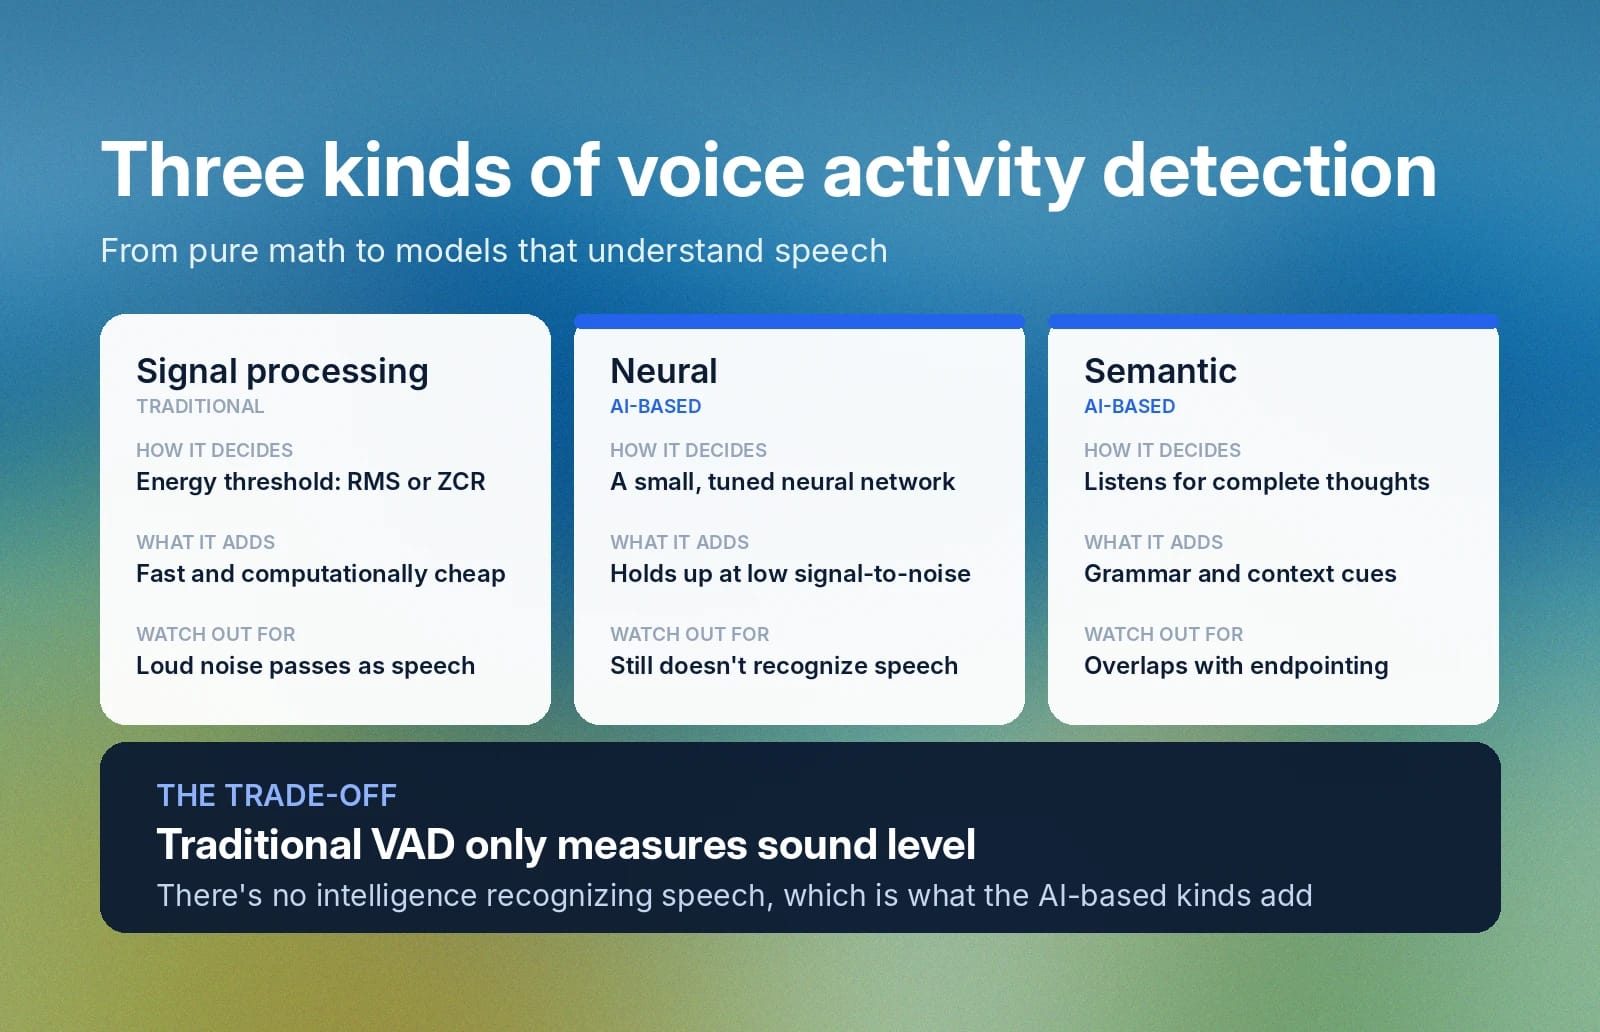
VAD se divide en dos grandes categorías: procesamiento de señales e IA.
Dentro de VAD basado en IA, hay dos enfoques distintos, lo que suma tres tipos de detección de actividad de voz.
Veámoslos con más detalle.
VAD tradicional (procesamiento de señales)
La tecnología VAD tradicional mide el nivel de energía de un flujo de audio y confirma la presencia de voz si supera un determinado umbral. Es puramente matemática y suele consistir en un cálculo de raíz cuadrática media (RMS) o de tasa de cruces por cero (ZCR). Si un fotograma mide por encima del umbral, se considera voz. Si está por debajo, no.
El VAD tradicional es rápido y requiere poco procesamiento, pero solo mide el nivel de sonido del audio. Un ruido de fondo intenso puede causar falsos positivos. No hay ninguna inteligencia que reconozca realmente la voz.
VAD basado en IA
Hay dos tipos de VAD más recientes basados en IA: neuronal y semántico. En lugar de usar un umbral puramente matemático, el VAD neuronal emplea una red neuronal pequeña y muy ajustada para determinar si un fotograma de audio contiene voz o silencio. Su entrenamiento les permite entender la diferencia entre voz y ruido, por lo que rinden mejor que el VAD tradicional cuando un flujo de audio tiene una relación señal-ruido (SNR) baja, es decir, cuando hay mucho ruido de fondo.
La desventaja del VAD neuronal es que sigue sin reconocer el habla en sí. El VAD semántico basado en IA es una variante diferente que sí lo hace. Se solapa con el endpointing porque escucha un flujo de audio para determinar si las ideas expresadas están completas. Puede entender gramatical y contextualmente si es probable que haya más habla a continuación.
VAD frente a endpointing
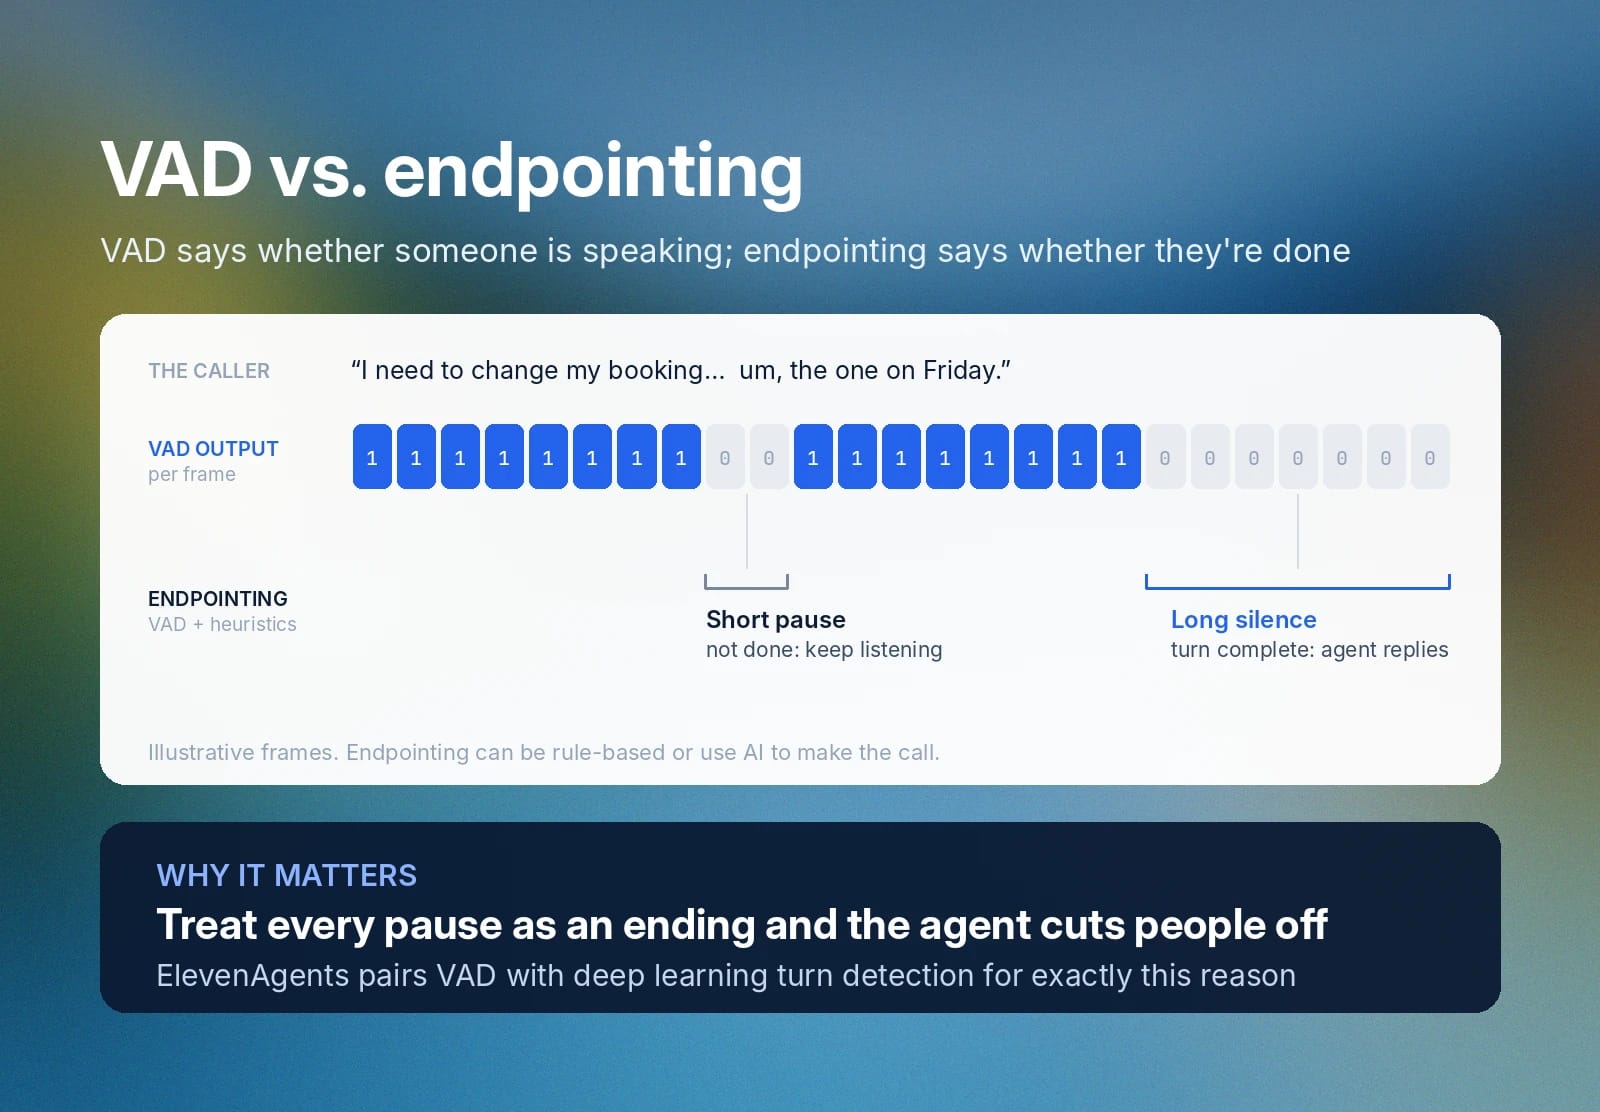
VAD y el endpointing son tecnologías complementarias. Un sistema de detección de actividad de voz simplemente decide si alguien está hablando en cada fotograma de audio que procesa. Toma una decisión binaria de sí o no y la transmite al resto del flujo de procesamiento de audio.
Un sistema de endpointing utiliza la salida de VAD, combinada con análisis heurístico, para determinar si un hablante ha terminado su intervención. Puede utilizar procesamiento de señales basado en reglas o IA para tomar esta decisión.
Aplicaciones de la detección de actividad de voz en IA en tiempo real
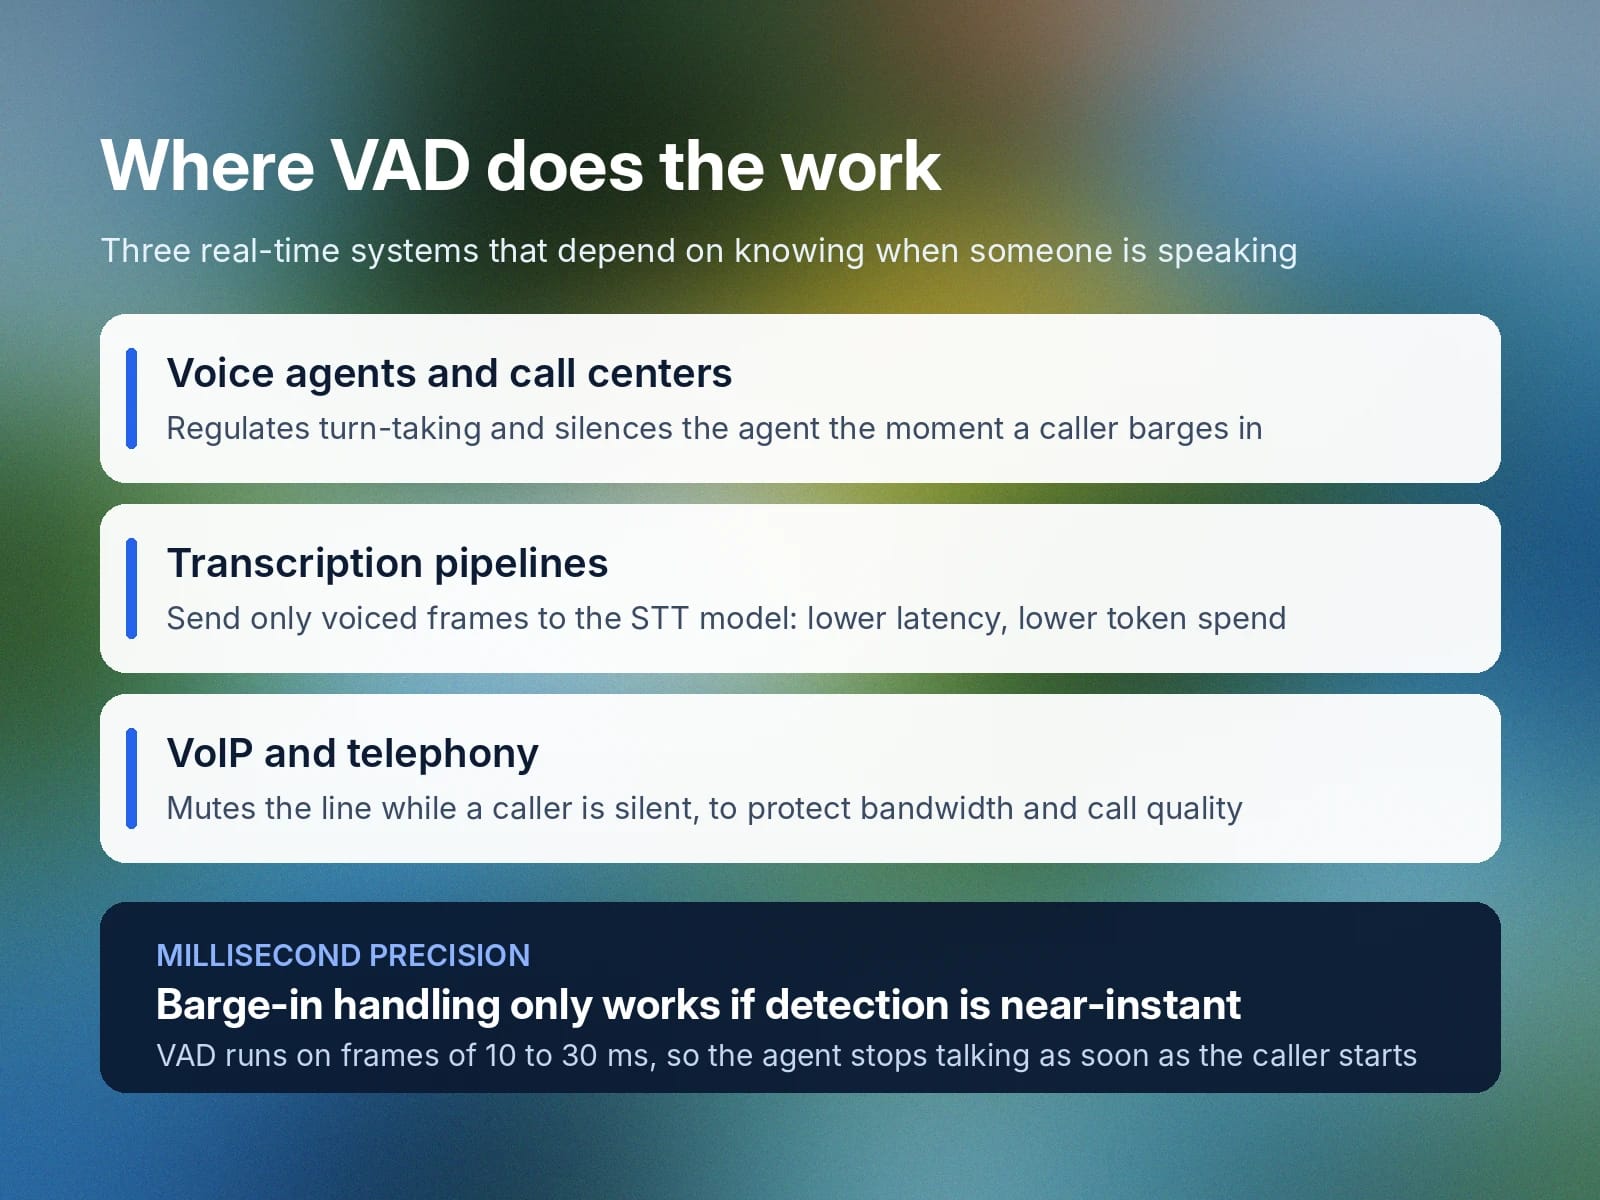
La detección de actividad de voz es importante en varios casos de uso.
Agentes de voz autónomos y centros de llamadas
Un agente autónomo que atiende llamadas de clientes necesita saber cuándo es adecuado responder. No quieres que el agente interrumpa a un cliente a mitad de frase ni que siga hablando por encima del cliente cuando este responde antes de tiempo. VAD ayuda a regular los turnos de conversación y a mantener un flujo natural en la interacción. Como funciona con precisión de milisegundos, también es muy eficaz para gestionar las «interrupciones» de clientes y silencia al agente cuando el cliente lo corta.
Flujos de transcripción
Si utilizas un servicio de API de Voz a Texto para transcripción, como ElevenAPI, puedes filtrar el audio que le envías mediante detección de actividad de voz para que el modelo procese solo los fotogramas con voz. Esto reduce la latencia de red y, lo que es más importante, el uso de tokens en el modelo de transcripción. No gastarás recursos de IA en ruido de fondo.
Optimización de VoIP y telefonía
La latencia también puede afectar a la calidad de las llamadas en redes VoIP empresariales. Para optimizar el rendimiento, estos sistemas de audio digital silencian temporalmente una línea mediante VAD cuando la persona que llama no está hablando.
¿Qué dificulta la detección de actividad de voz?
La detección de actividad de voz tradicional se basa en algoritmos matemáticos para decidir si hay voz. Sin embargo, los patrones del habla humana son desordenados. Las conversaciones suelen ser irregulares, con pausas y reinicios, y tienen lugar en entornos reales con ruido de fondo e incluso conversaciones paralelas. El principal reto de VAD es identificar silencios significativos dentro de audio ruidoso.
Esto se traduce en algunos retos concretos.
Pausas a mitad de frase
Las personas no hablan a un ritmo constante durante toda una conversación. Hacen pausas, ordenan sus ideas, se replantean lo que dicen mientras hablan y pierden el hilo. Ninguna de estas pausas significa que hayan terminado de hablar. Para las personas que escuchan suele ser fácil de entender, pero puede resultar difícil para el software, incluso para los modelos de IA más recientes.
Si los sistemas VAD confunden estas pausas con el final de una intervención, pueden cortar una frase a mitad de una transacción o hacer que un agente de voz interrumpa a una persona.
Ruido vocal
El habla baja, las consonantes finales descendentes (habituales al final de una frase) y cualidades como la voz crepitante pueden hacer que los sistemas VAD no detecten voz legítima.
Acústica impredecible
El ruido blanco de fondo continuo, como el de un ventilador o el agua corriendo, resulta relativamente fácil de filtrar para los sistemas VAD. El ruido esporádico, como el ladrido de un perro, podría marcarse erróneamente como voz fantasma.
Una compresión de audio intensa elimina el rango dinámico y puede dificultar que VAD diferencie los fotogramas de silencio de los de voz.
Cómo evaluar el rendimiento de VAD
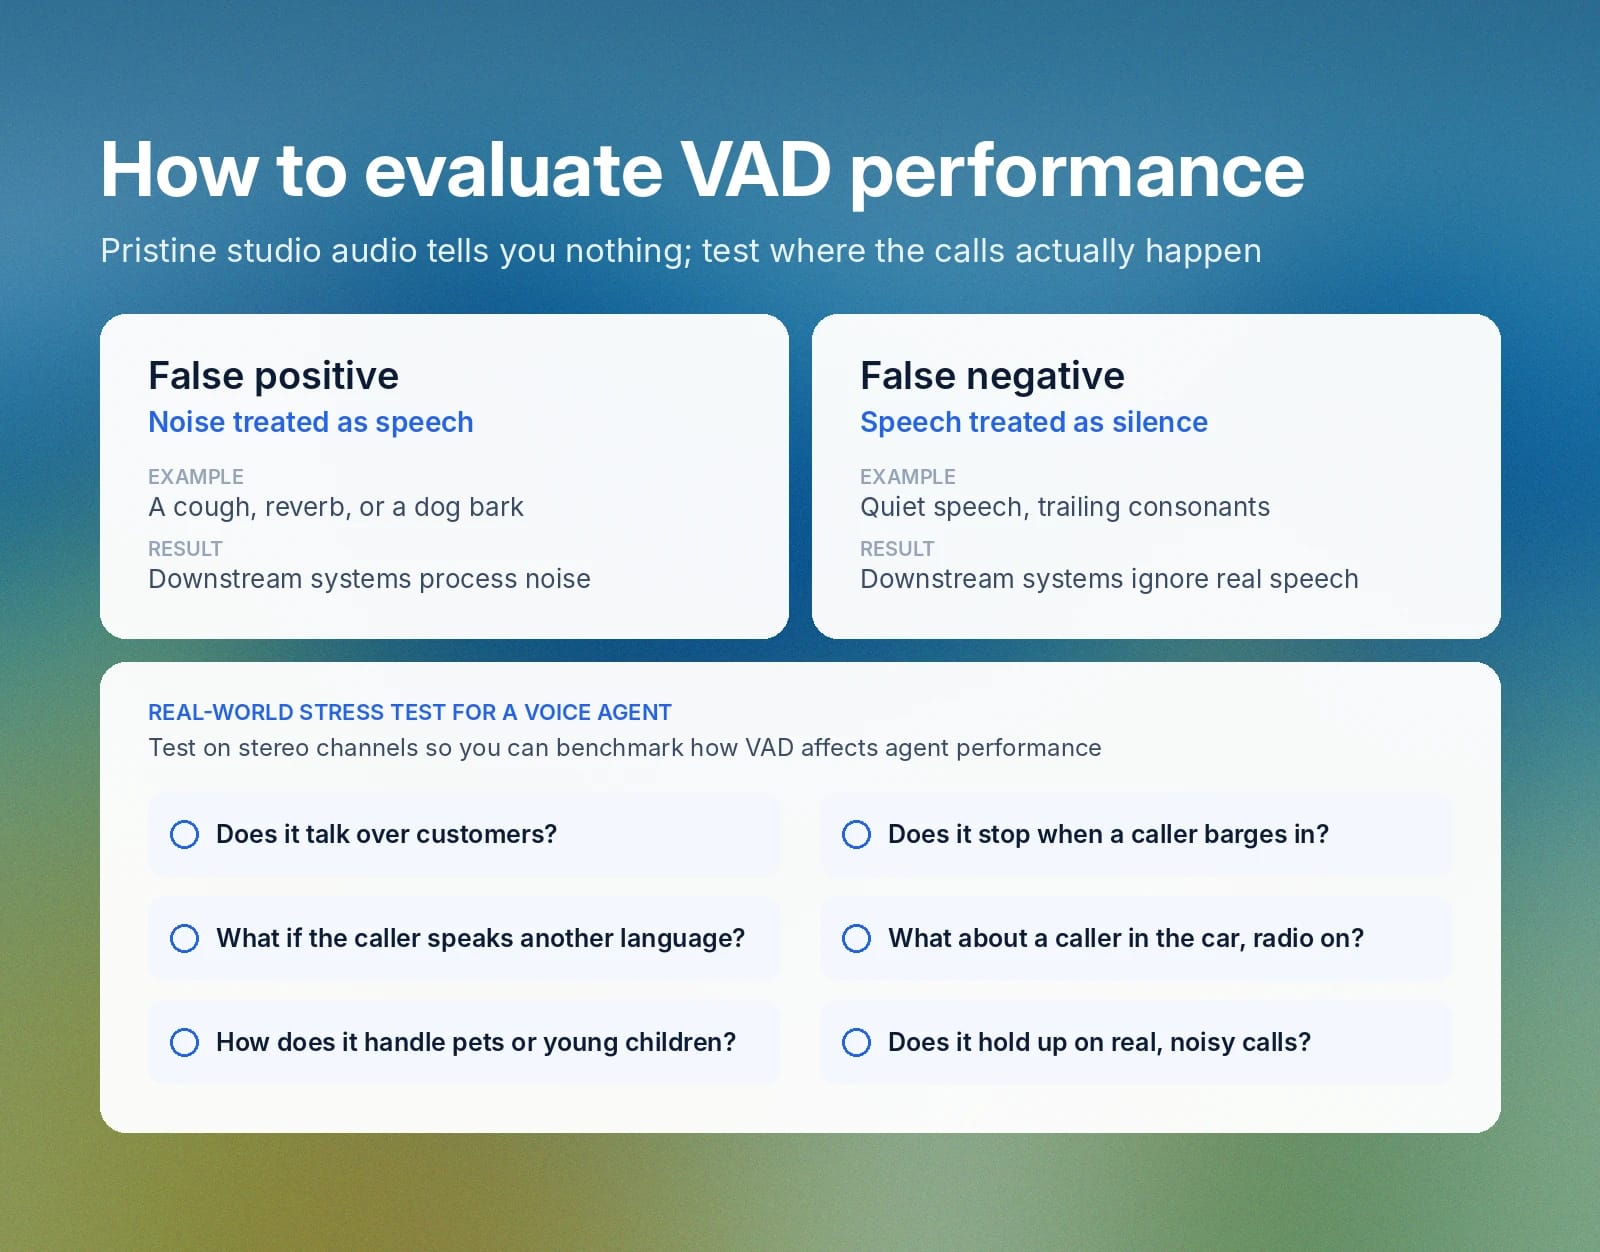
El habla humana es desordenada, especialmente cuando se graba en entornos reales y dinámicos. Las grabaciones de audio impecables no son un buen mecanismo para probar el rendimiento de VAD. La precisión pura de voz a texto tampoco mide directamente la eficacia de un sistema VAD, ya que ocurre después de lo que detecta VAD.
Falsos positivos frente a falsos negativos
Los falsos positivos de VAD son ruidos tratados como voz. Una tos, reverberación, el ladrido de un perro o cualquier otro ruido de fondo repentino pueden activarlos y hacer que se transmitan por error como fotogramas de voz.
Los falsos negativos son voz tratada como silencio. VAD indica por error a los servicios posteriores que ignoren los fotogramas de audio.
Pruebas de estrés en condiciones reales
Para evaluar un servicio VAD, debes comprobar cómo funciona en los entornos donde se grabará el audio y en condiciones reales.
Por ejemplo, si vas a usar VAD para un agente de voz, prueba con canales estéreo para comparar cómo afecta al rendimiento del agente. Pueden surgir preguntas como estas:
- ¿Hay falsos negativos que hacen que hable por encima de clientes?
- ¿Impide que el agente hable cuando un usuario lo interrumpe?
- ¿Qué ocurre si la persona que llama habla un idioma extranjero?
- ¿Cómo funciona al escuchar a personas que llaman desde entornos reales?
- ¿Qué ocurre cuando un cliente llama desde el coche pero no baja el volumen de la radio?
- ¿Cómo responde ante el ruido de fondo de mascotas o niños pequeños?
Es probable que todas estas situaciones ocurran al atender llamadas de clientes. VAD debe detectarlas y rendir bien bajo presión.
Empieza a usar ElevenAgents para atención al cliente
ElevenAgents utiliza un sistema híbrido de VAD y detección de turnos mediante aprendizaje profundo para que las conversaciones con agentes fluyan de forma natural.
Empieza hoy a crear un nuevo agente de atención al cliente con ElevenAgents. Regístrate para empezar.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.



