
Soluciona problemas de precisión de Voz a Texto con un workflow más inteligente
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
La precisión de Voz a Texto (STT) depende de tres factores: la calidad del audio, cómo habla la gente y las palabras que utiliza. El ruido y la compresión intensa eliminan detalles de una grabación, e incluso los modelos más potentes tienen dificultades con voces superpuestas o jerga desconocida. Esta guía explica el origen de cada problema de STT y cómo solucionarlo.
Los errores de transcripción rara vez se quedan en la transcripción. Un nombre de medicamento mal entendido en una nota clínica o un número de cuenta incorrecto en el registro de una llamada se propaga a todos los sistemas que usan ese texto, desde la búsqueda y la analítica hasta los agentes de IA que actúan según lo dicho. Una precisión baja también alarga el tiempo de revisión, porque alguien tiene que localizar y corregir los errores a mano.
La buena noticia es que la mayoría de los problemas de precisión de STT se pueden solucionar. Muchas de estas soluciones solo requieren pequeños cambios en tus configuraciones o ajustes de grabación actuales, por lo que puedes resolver el problema sin tener que cambiar la configuración del modelo.
También puedes encontrar este tema bajo los nombres de precisión del reconocimiento de voz, precisión de ASR o precisión de la transcripción. Voz a Texto, reconocimiento de voz y reconocimiento automático de voz (ASR) describen el mismo proceso de convertir audio hablado en texto escrito. Las soluciones de esta guía son aplicables independientemente del término que uses.
Resumen
- La precisión de Voz a Texto depende de la calidad de la entrada de audio, la dinámica de los hablantes y cuestiones léxicas y contextuales.
- Para solucionar un problema de precisión, identifica en qué punto del pipeline (entrada, procesamiento o salida) puedes hacer un cambio.
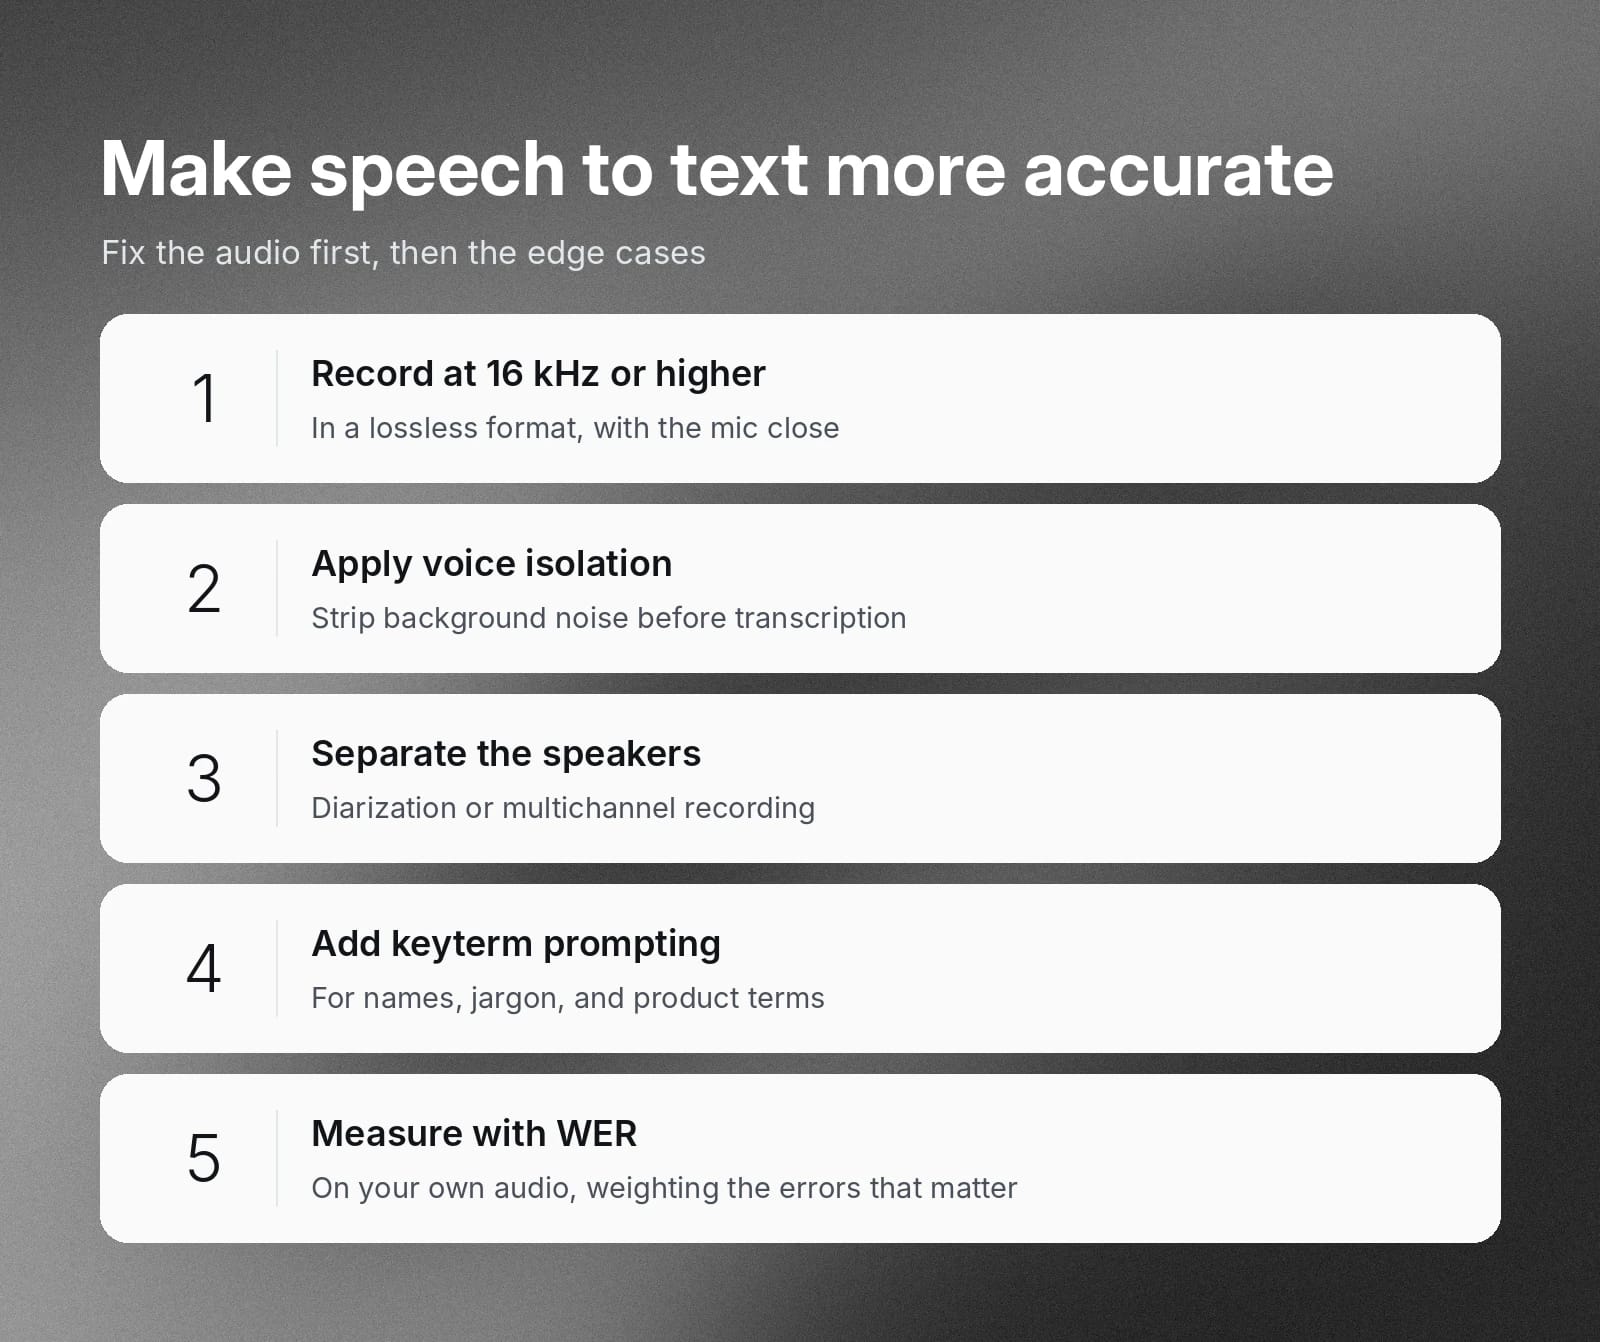
- Graba a 16 kHz o más, utiliza formatos sin pérdida y coloca los micrófonos a entre 10 y 15 cm del hablante.
- Utiliza limpieza de audio, diarización o grabación multicanal y prompting de términos clave para gestionar el ruido, los hablantes superpuestos y el vocabulario especializado.
- Mide la precisión con la tasa de error de palabras (WER) y comprueba qué errores son más importantes para tu caso de uso.
¿Qué causa los problemas de precisión de Voz a Texto?
Imagina que alguien te pide transcribir una grabación de audio de un profesor con un acento muy marcado que describe física teórica compleja, grabada en un restaurante lleno con música de fondo y conversaciones ambientales. Los sistemas informáticos digitales no están adaptados de forma natural a la variabilidad acústica. Hace falta mucho entrenamiento y ajuste fino para que STT funcione de forma eficaz y, aunque las herramientas modernas de IA son muy eficaces, muchos problemas pueden seguir afectando al resultado. Sin embargo, si entiendes cuáles son, puedes abordarlos en tus workflows de transcripción.
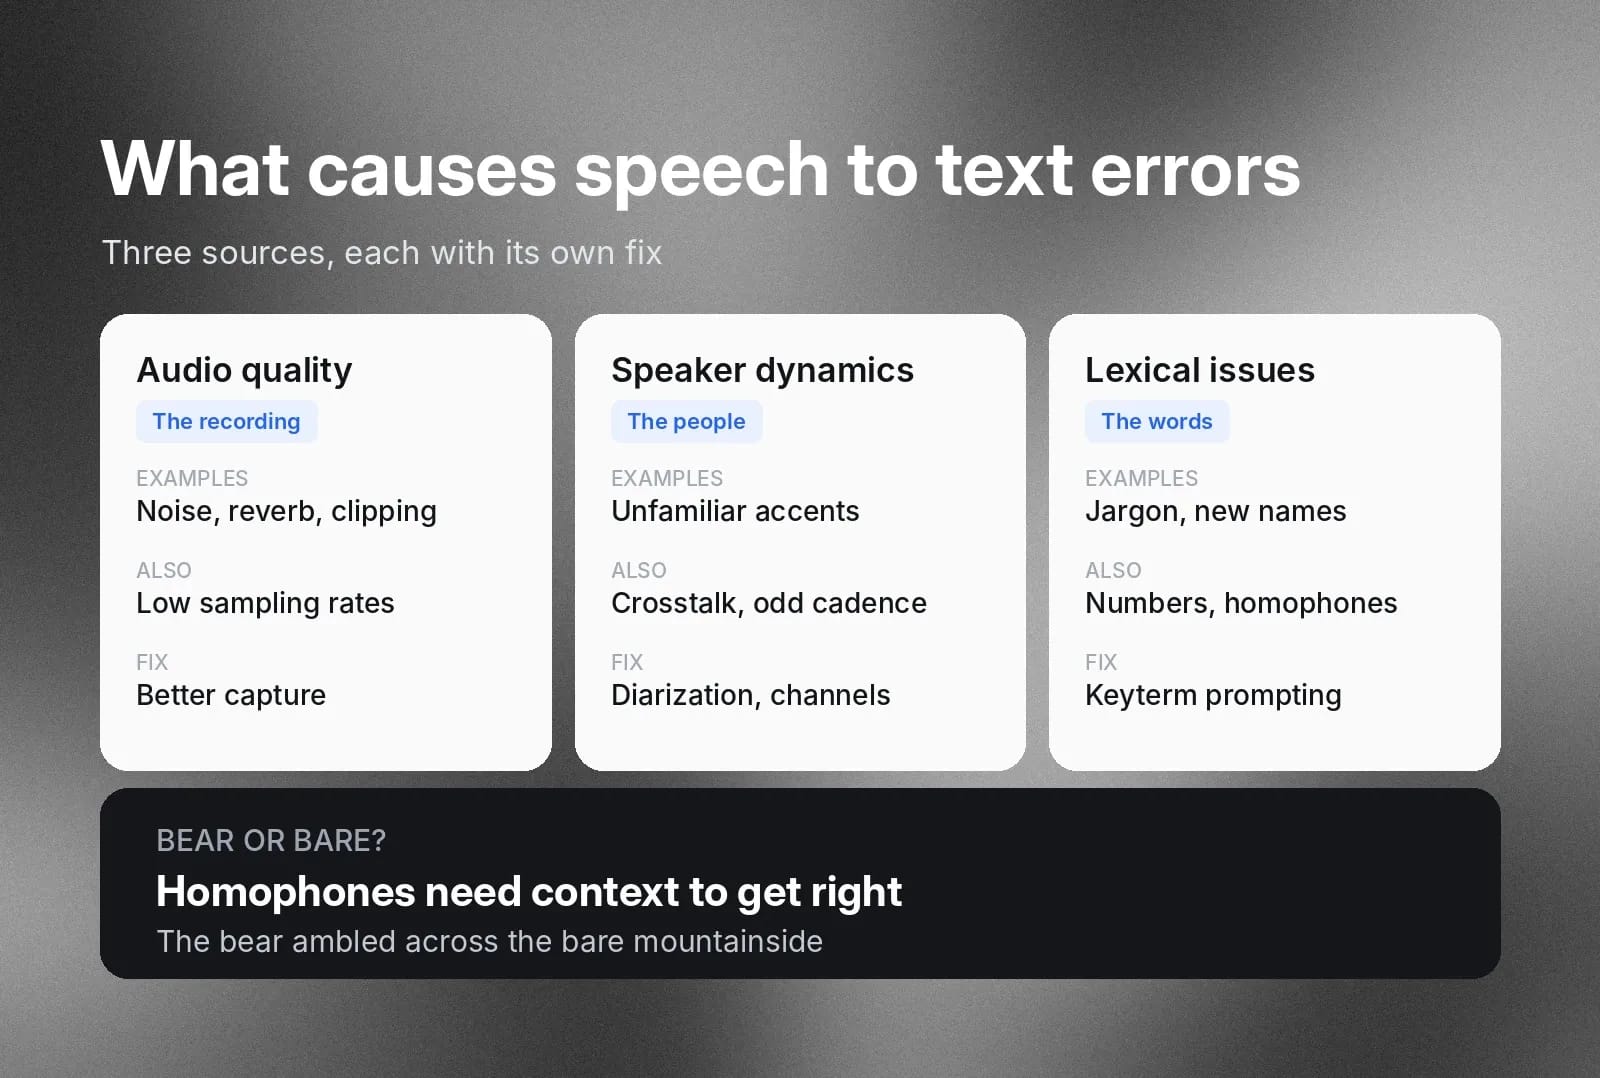
Hay tres causas principales de una conversión inexacta de Voz a Texto:
- Problemas con la calidad de la entrada de audio
- Dinámica de los hablantes
- Cuestiones léxicas y contextuales
Cada causa necesita una solución distinta, que las secciones siguientes explican por orden.
Problemas de calidad de audio
En primer lugar, la propia grabación de audio puede tener problemas. Los problemas con el micrófono pueden hacer que la voz se distorsione o se recorte. La reverberación por la acústica del recinto, una mala relación señal-ruido (SNR) en la grabación o una frecuencia de muestreo baja pueden eliminar información fonética importante de las grabaciones.
Dinámica de los hablantes
Un único hablante con un acento neutro, hablando en un lugar silencioso, será relativamente fácil de transcribir. Pero ese rara vez es el tipo de grabación que queremos transcribir. Los acentos desconocidos y un ritmo de habla entrecortado o simplemente poco convencional pueden confundir a un modelo de STT entrenado con habla estandarizada. La conversación cruzada o los hablantes superpuestos también pueden dificultar que un modelo interprete con precisión lo que se dice.
Cuestiones léxicas y contextuales
Por último, el contenido del habla también puede suponer un reto para algunos modelos de STT. La jerga del sector y los nombres de productos nuevos pueden no formar parte del lenguaje que un modelo de STT ha encontrado durante su entrenamiento. Como selecciona el resultado estadísticamente más probable, el habla desconocida podría no estar entre sus predicciones principales. Las expresiones numéricas o matemáticas, o el habla que normalmente se escribiría con cifras, tampoco se transcriben siempre con claridad.
Los homófonos son palabras que suenan igual pero se escriben de forma distinta. Un modelo de STT necesita suficiente comprensión contextual para distinguirlos. Por ejemplo, «vaca» y «baca». El modelo necesitaría saber si se refiere al animal, «vaca», o al soporte para transportar carga sobre un vehículo, «baca».
Cómo solucionar problemas de precisión de Voz a Texto, desde el audio hasta el resultado
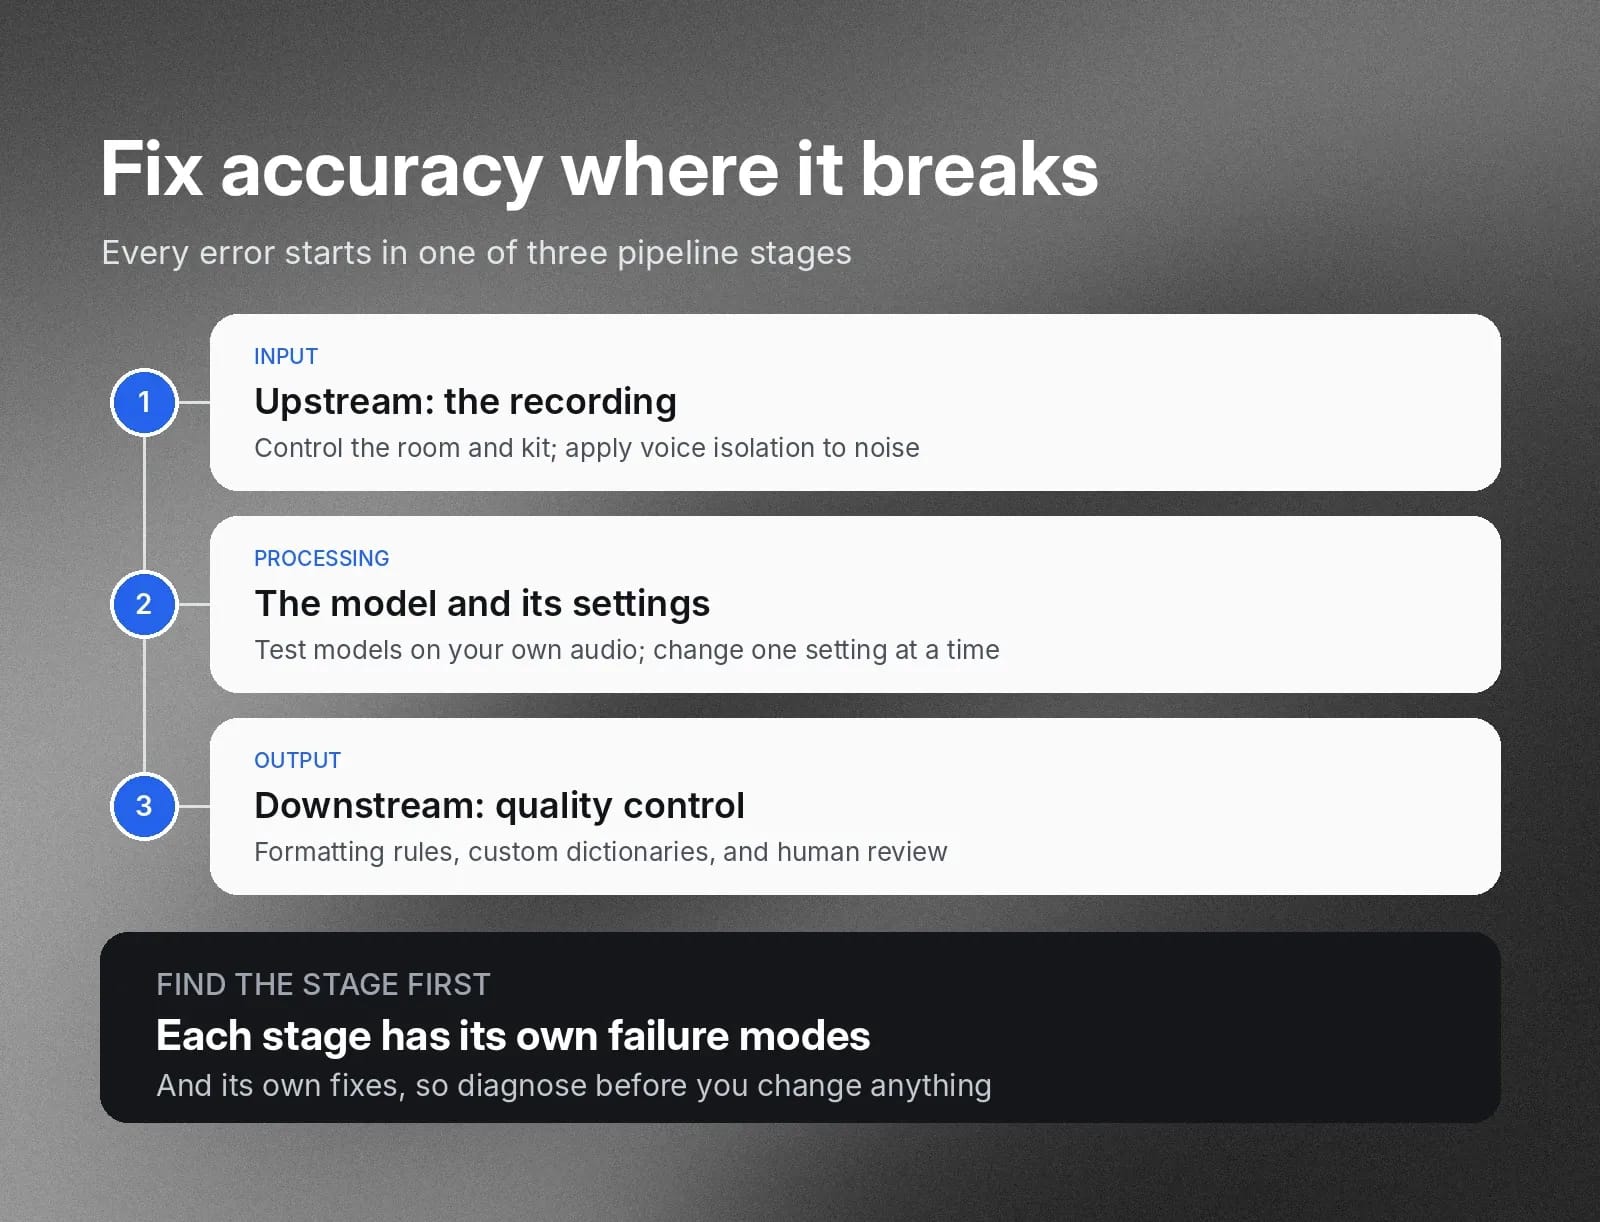
El procesamiento de Voz a Texto se realiza en una serie de pasos bien definidos. Para solucionar un problema de precisión, debes identificar en qué punto de ese pipeline puedes hacer un cambio. En términos generales, el proceso de STT se divide en:
- Entrada
- Procesamiento
- Salida
Cada etapa tiene sus propios modos de fallo y sus propias soluciones.
Problemas de precisión en la entrada
Puede haber problemas con el entorno en el que estás grabando. Entre los más habituales se encuentran el ruido de fondo o los ecos. El equipo de grabación también podría ser el origen del problema si presenta algún fallo.
Solucionar los problemas en esta etapa suele implicar aislar la causa y resolverla. Por ejemplo, si sabes que la herramienta de STT tiene dificultades con fondos ruidosos, es buena idea mantener las conversaciones en un entorno sobre el que tengas más control.
Para cualquier ruido que no puedas evitar, aplica limpieza de audio antes de que el audio llegue al modelo.
Problemas de precisión en el procesamiento
La configuración de tu API para un motor de STT puede afectar al procesamiento. La estructura del prompt y el modelo que elijas también pueden influir en la calidad y el número de imprecisiones.
Solucionar los problemas en esta etapa significa probar tu configuración con tu propio audio. Ejecuta las mismas grabaciones de muestra en cada modelo candidato, compara sus tasas de error de palabras y después modifica un ajuste cada vez para afinar el resultado.
Si un modelo sigue sin reconocer un tipo de habla, como una llamada con ruido o un acento regional concreto, prueba distintos modelos para evaluar su precisión en el entorno exacto que vas a utilizar.
Problemas de precisión en la salida
Esta es tu capa de control de calidad, donde procesos especializados corrigen los errores y las ambigüedades de transcripción que el motor principal podría haber pasado por alto. Los pipelines de STT usan habitualmente la coincidencia de patrones basada en reglas para estandarizar el formato —por ejemplo, cambiar «diez euros» por «10,00 €»—, un proceso denominado normalización inversa de texto (ITN); pero si un hablante usa uno de esos términos de forma no estándar o lo pronuncia mal, una herramienta rígida de buscar y reemplazar no lo detectará.
También está la cuestión de si una persona en el circuito (HITL) comprueba la calidad del resultado. Si no es así, las imprecisiones pueden llegar al resultado de producción. Como en cualquier actividad realizada por una persona, existe la posibilidad de error humano.
En esta etapa, solucionar los problemas significa detectar los errores que dejan los motores principales. Puedes comparar las transcripciones con una muestra de referencia para descubrir qué errores se repiten y, después, añadir reglas específicas o un diccionario personalizado para esos términos. Especialmente en transcripciones de alto riesgo, añade siempre una fase de revisión humana.
Cómo mejorar la precisión del reconocimiento de voz con mejor audio
Mejorar la calidad del audio durante la grabación puede reducir muchos problemas de precisión posteriores. Utiliza una frecuencia de muestreo más alta, aplica una compresión mínima o ninguna y mantén un entorno de grabación lo más despejado posible.
Calidad de muestreo
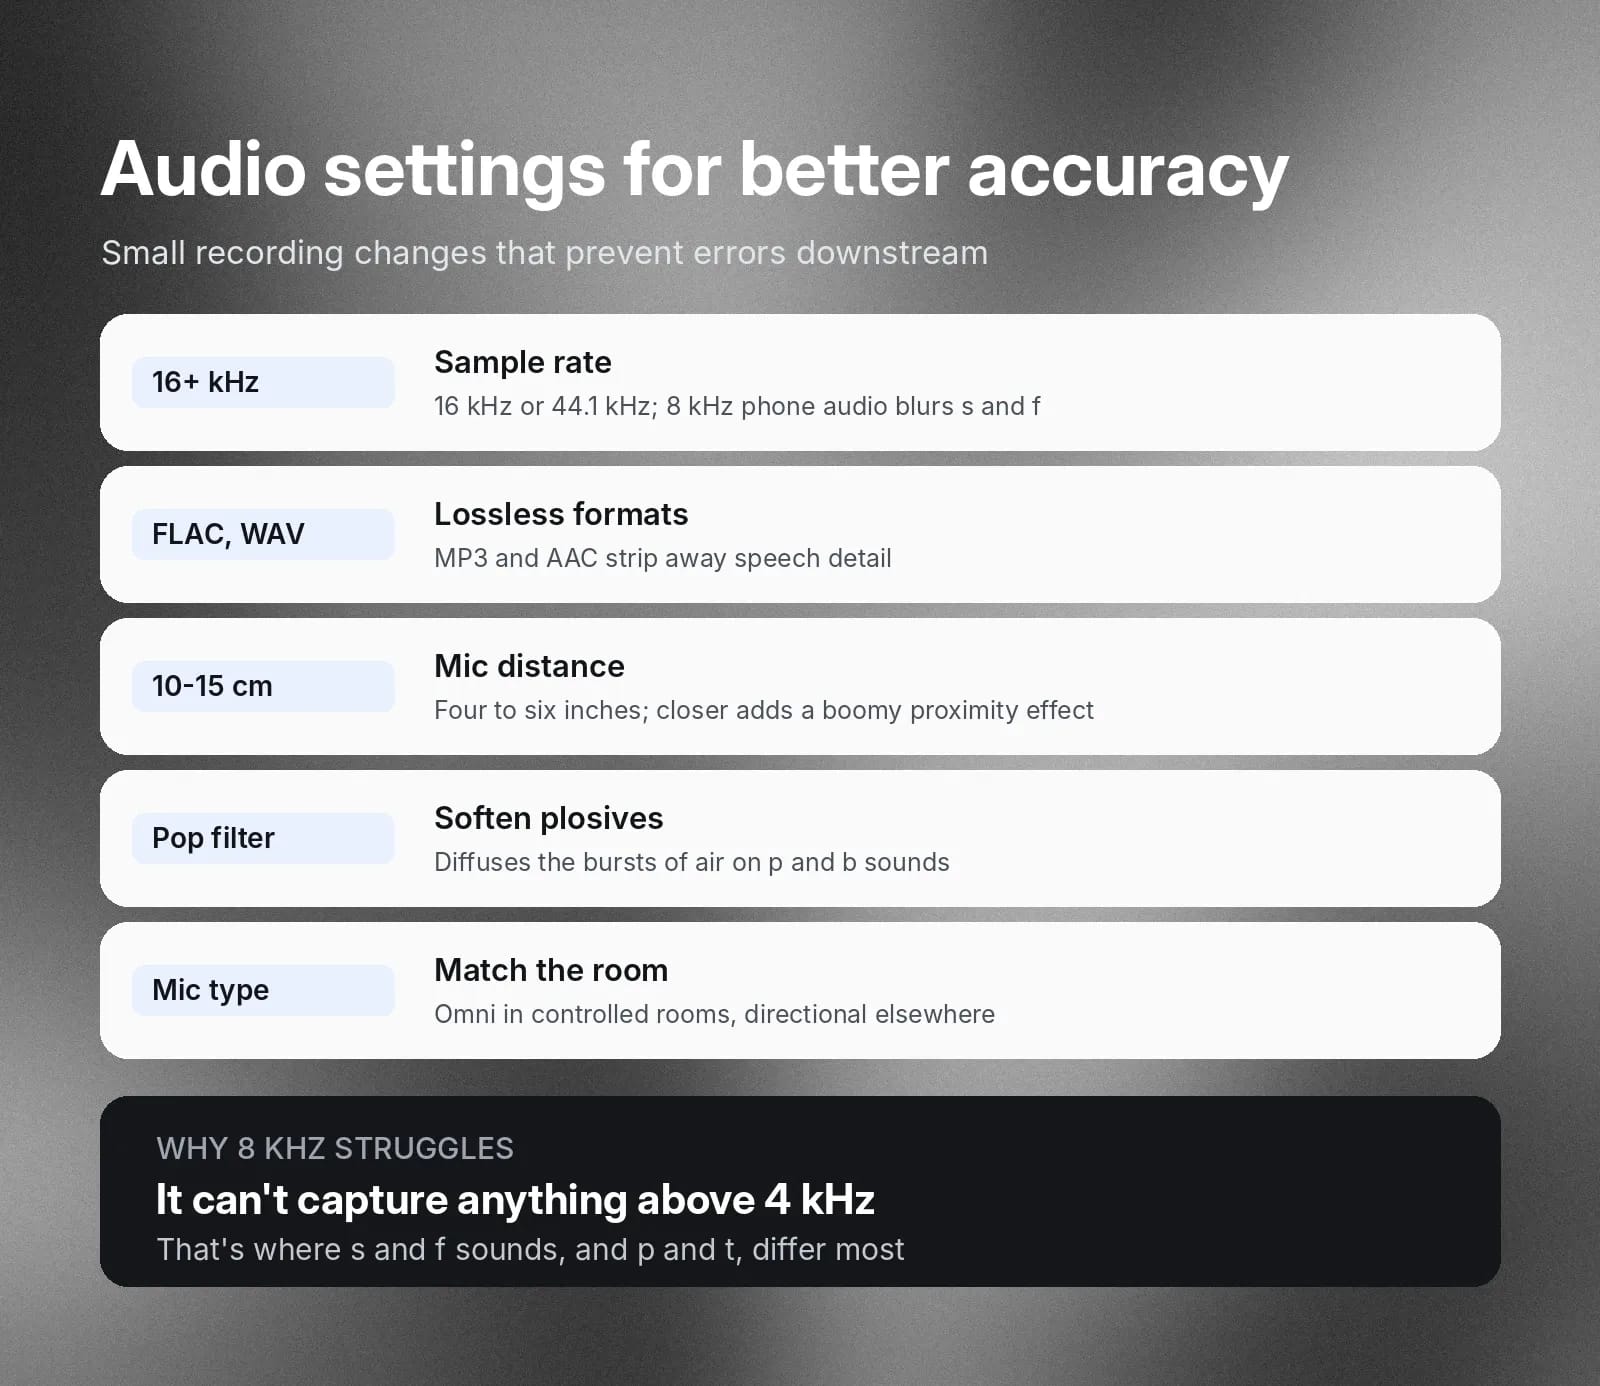
Utiliza audio de 16 kHz o 44,1 kHz para grabar. El muestreo de audio telefónico tradicional de 8 kHz o menos puede resultar difícil de interpretar para los modelos de STT. Para los modelos, suena apagado y confuso, y no pueden pedir a los hablantes que repitan lo que han dicho como lo haría una persona en una llamada.
Una frecuencia de muestreo solo puede reproducir frecuencias de hasta la mitad de su valor. Esto se denomina frecuencia de Nyquist del sistema. Con solo 8 kHz, se eliminaría todo lo que estuviera por encima de 4 kHz, lo que dificultaría específicamente que un modelo de STT distinga entre fricativas —sonidos como «s» y «f»— y oclusivas —como «p» y «t».
Compresión
Grabar en formatos con pérdida, como MP3 y AAC, también puede eliminar matices del habla. El modelo tiene menos señal con la que trabajar. Utiliza formatos sin pérdida o sin comprimir, como FLAC o PCM WAV.
Entorno de grabación
Sigue las prácticas recomendadas de ingeniería de audio para el uso de micrófonos. Los micrófonos omnidireccionales funcionan mejor en entornos controlados. En otros casos, los micrófonos direccionales aíslan mejor la voz. Coloca los micrófonos a entre 10 y 15 cm de la boca del hablante e intenta evitar que se acerque más, ya que creará un efecto de proximidad y enturbiará la grabación al potenciar las frecuencias bajas.
Utiliza también un filtro antipop en el micrófono siempre que sea posible. Los filtros antipop dispersan las ráfagas de aire que se producen al pronunciar consonantes oclusivas, como los sonidos «p» y «b».
Reduce el ruido de fondo para mejorar el reconocimiento de voz
Como se ha indicado en la sección anterior, usa la grabación con el micrófono cerca siempre que sea posible, idealmente a entre 10 y 15 cm de la boca del hablante. Evita el ruido blanco y el ruido de fondo que enturbien las grabaciones. Algunas fuentes habituales que podrías no advertir sin experiencia en grabaciones de campo incluyen el zumbido de los sistemas de climatización, el tecleo y el ruido general de la calle. Todo ello puede dificultar que un modelo de STT interprete el habla.
Sin embargo, a menudo no es posible evitar el ruido de fondo; en ese caso, aplica limpieza de audio como paso de preprocesamiento antes de enviar el audio a un modelo de STT. La limpieza de audio utiliza algoritmos de software o un modelo neuronal especializado y ligero para filtrar el audio de fondo de las grabaciones de voz.
Gestiona acentos, hablantes superpuestos y vocabulario especializado
Los modelos multilingües modernos se entrenan con conjuntos de habla diversos, pero sus niveles de precisión siguen variando al trabajar con audio del mundo real. Realiza tus propias pruebas comparativas con distintos modelos usando audios de muestra de los grupos demográficos relevantes. Si tienes llamadas de atención al cliente históricas que puedas usar, pásalas por transcripción, especialmente las que incluyan los acentos, ritmos y patrones de habla que quieres transcribir en situaciones reales.
Revisa los resultados en busca de errores e identifica patrones relevantes. ¿El modelo tiene dificultades con la jerga de los grupos de menor edad? ¿Tropieza con un acento regional concreto que encuentras con frecuencia?
Gestiona los hablantes superpuestos
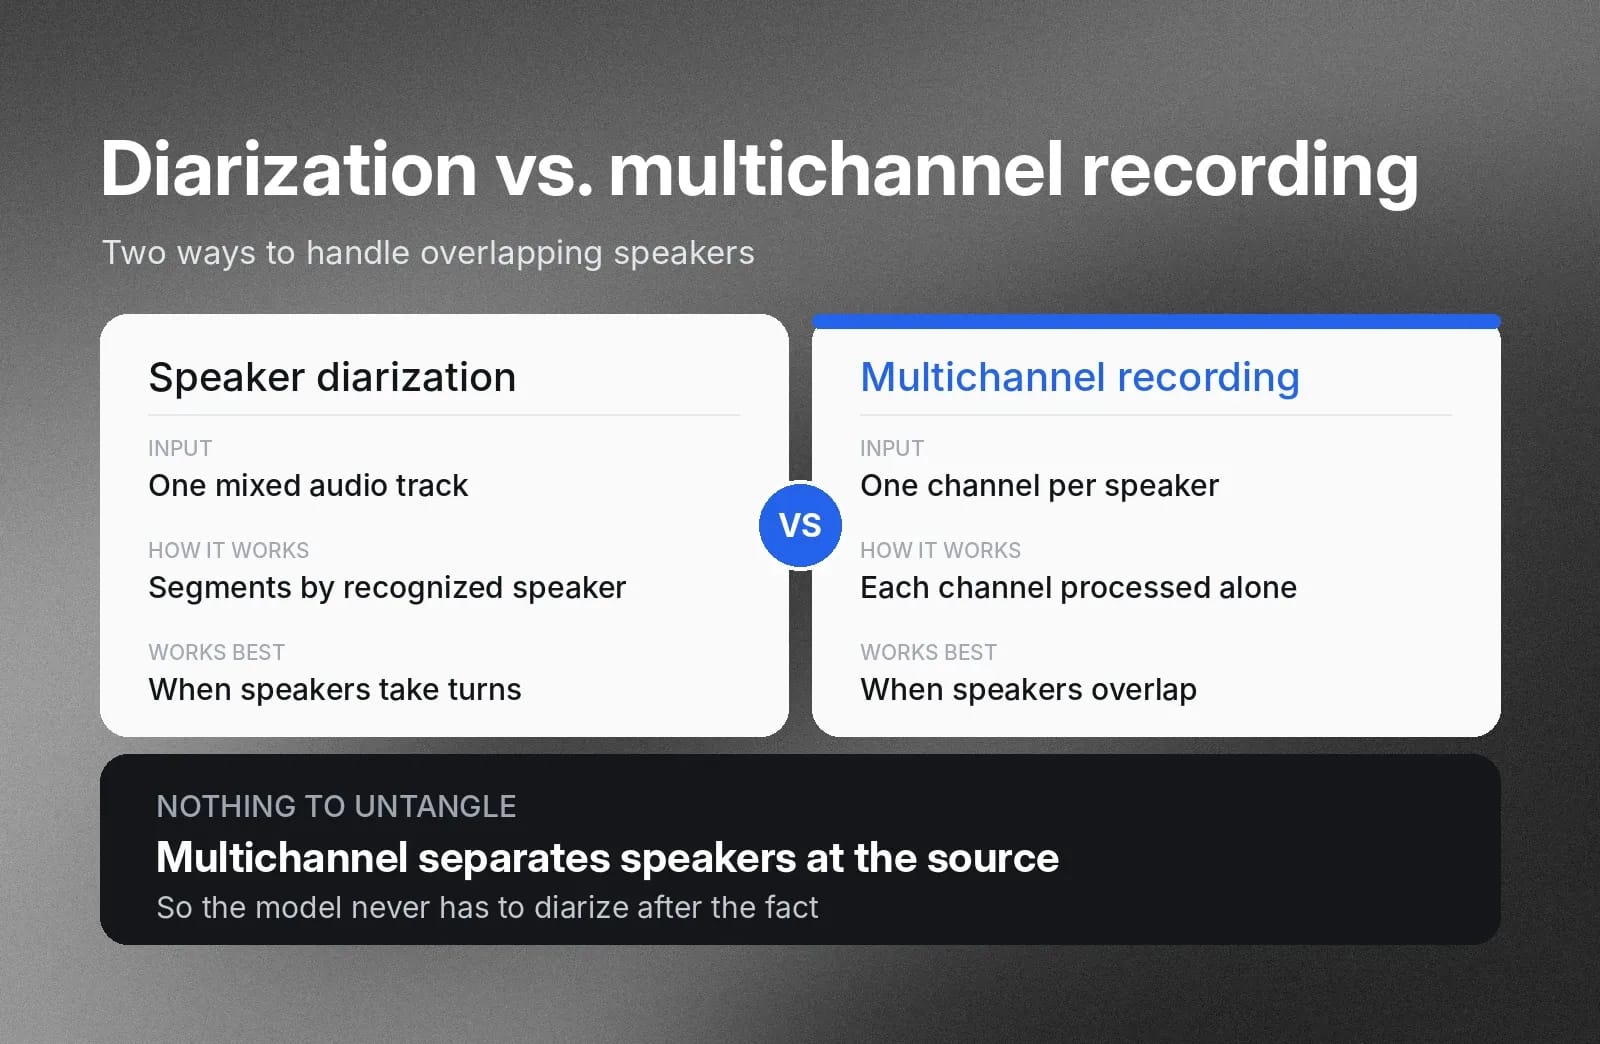
Tus dos herramientas principales para transcribir con precisión el habla superpuesta son la diarización y la grabación multicanal. Un proceso de diarización toma una entrada de audio sin procesar y la segmenta según los hablantes identificados individualmente. Funciona bien cuando los hablantes se turnan con claridad.
En lugar de mezclar todos los flujos de voz en una sola pista de audio, la grabación multicanal nativa permite mantener a cada hablante en un canal independiente, que el modelo de STT puede identificar y procesar de forma autónoma. Cada hablante queda separado de forma nativa en la grabación, por lo que el modelo de voz no tiene que realizar diarización a posteriori.
El prompting de términos clave aporta sesgo positivo
Los nombres de marcas, los nombres de productos nuevos, la jerga del sector y otros términos únicos a menudo no se transcriben con precisión si no estaban en los datos de entrenamiento de un modelo de STT. El prompting de términos clave consiste en proporcionar a un modelo de STT grafías específicas que quieres que priorice. Normalmente no son prompts de sustitución directa: simplemente orientan al modelo para que seleccione, según el contexto, la grafía personalizada que quieres.
Transcribe con precisión números, identificadores y nombres de medicamentos
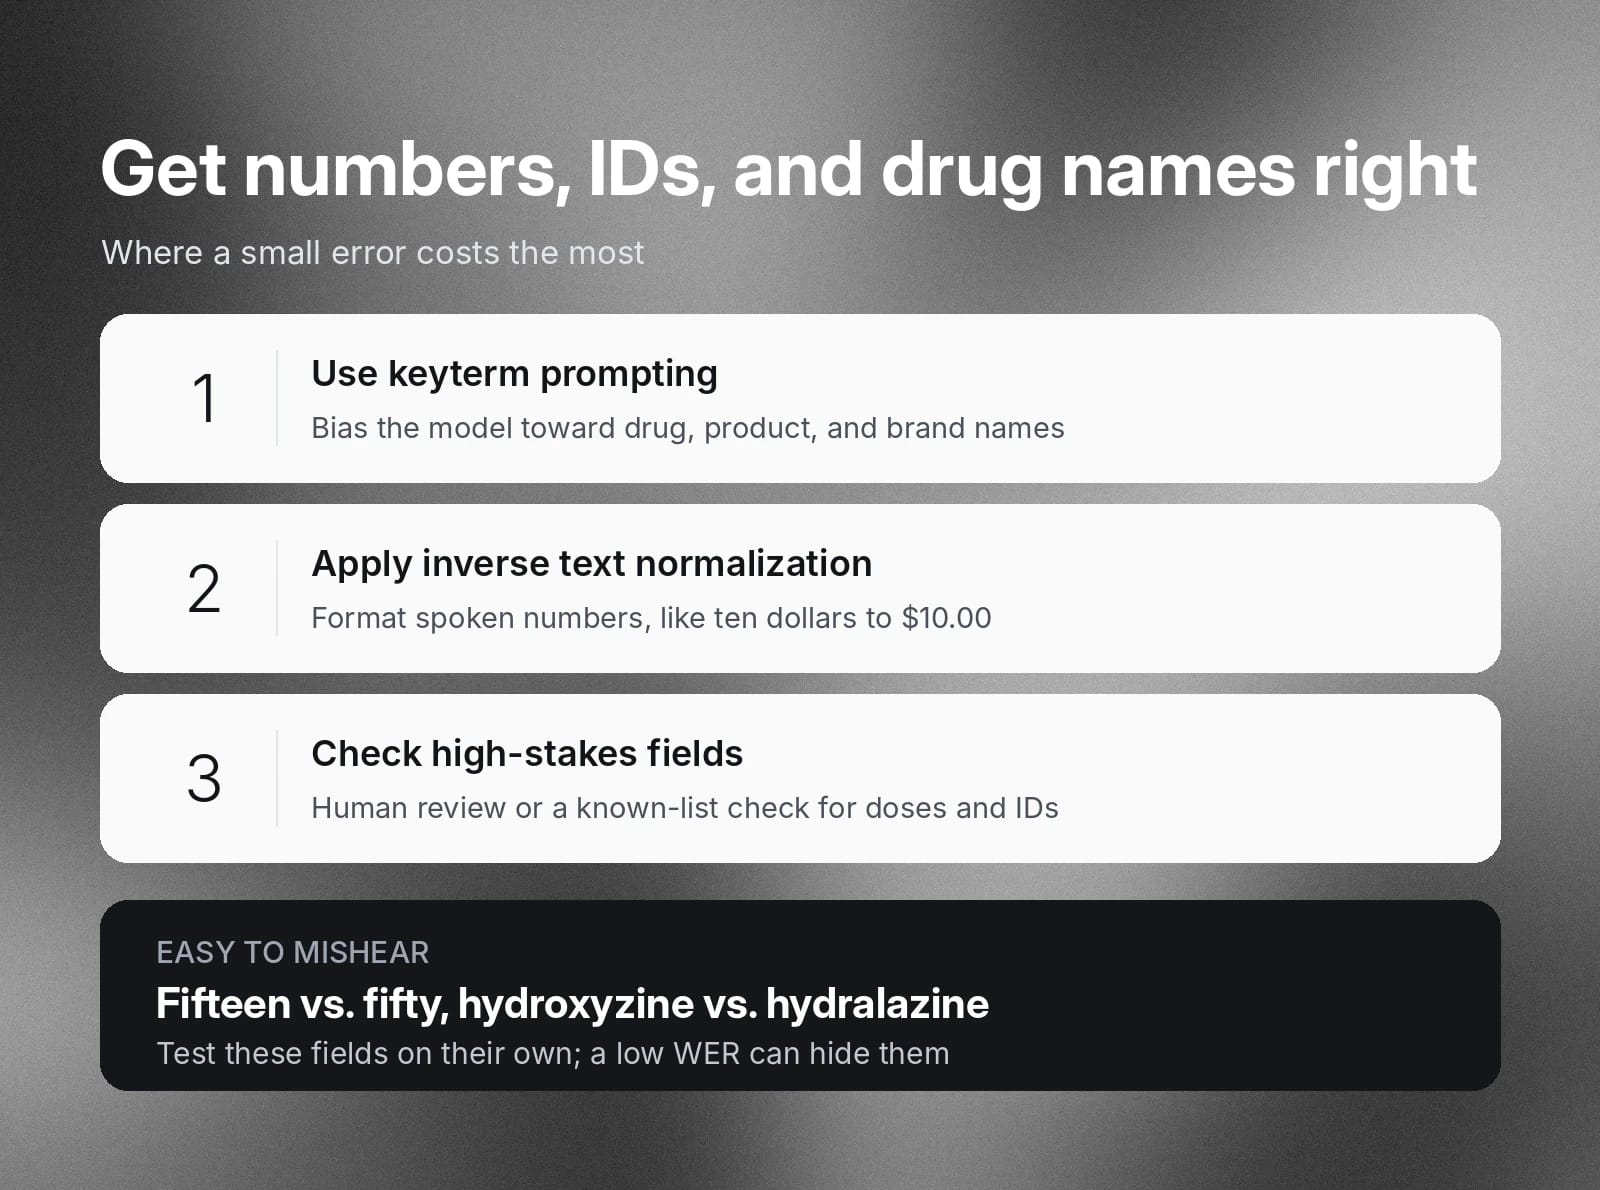
Los números, identificadores de cuentas, códigos postales y nombres de medicamentos son los ámbitos donde un pequeño error tiene mayor coste. Un modelo puede confundir «quince» con «cincuenta» o dos nombres de medicamentos que solo se diferencian en una sílaba, como hidroxizina e hidralazina.
Estos tres pasos ayudan:
- Usa prompting de términos clave: orienta el modelo hacia las grafías de los nombres de medicamentos, productos y otros términos que esperas encontrar.
- Aplica la normalización inversa de texto (ITN): da un formato coherente a los números hablados; por ejemplo, cambia «diez euros» por «10,00 €».
- Añade una comprobación para campos de alto riesgo: utiliza una revisión humana o una comprobación automática con una lista conocida para campos como las dosis de medicamentos y los números de cuenta.
Prueba estos campos por separado, porque una WER general baja puede ocultar errores precisamente en las palabras que más importan.
Mide la calidad con la tasa de error de palabras en el reconocimiento de voz
La tasa de error de palabras (WER) es una métrica útil para evaluar la precisión de un motor de STT. Puedes comparar la WER entre las distintas pruebas de modelos que realices para hacerte una idea de su precisión relativa.
Así se calcula la WER:
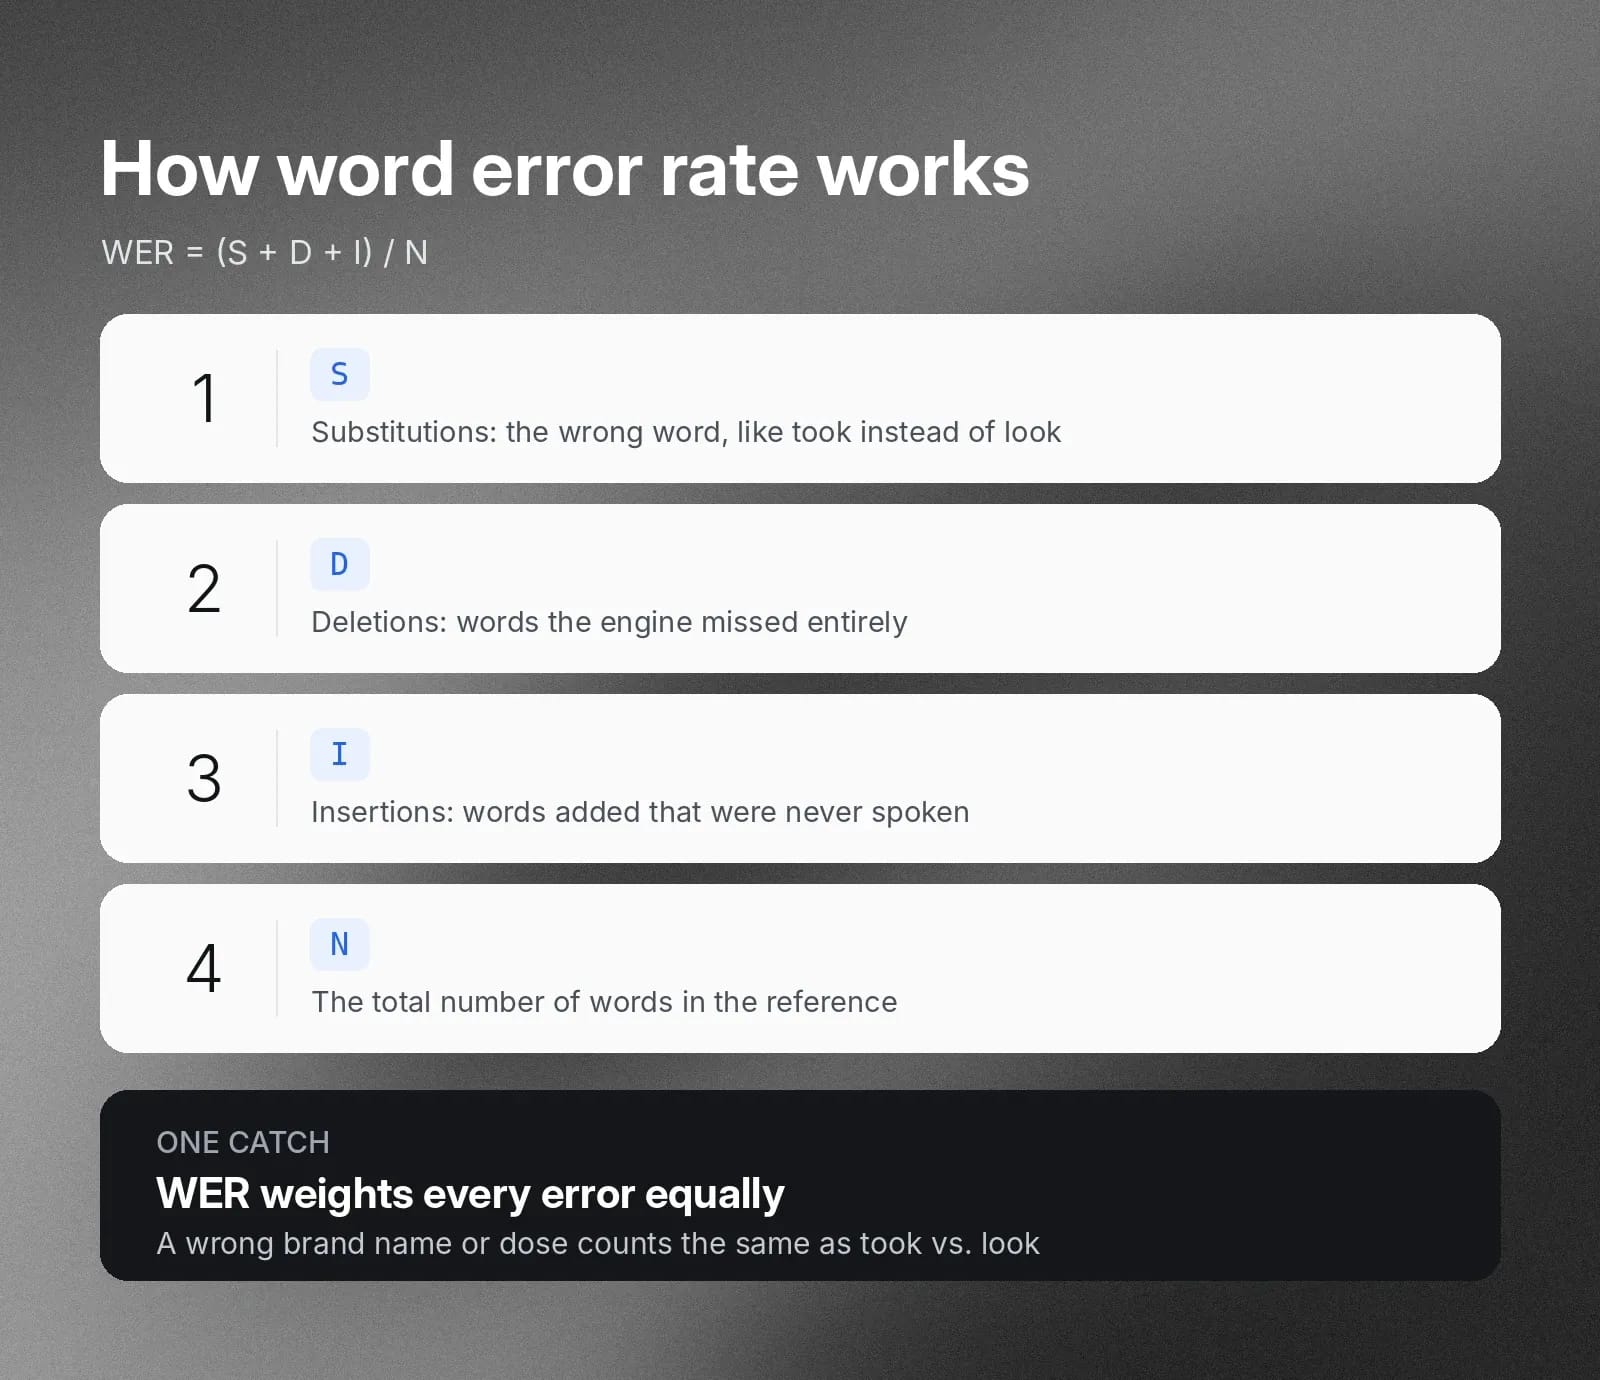
WER = (S + D + I) / N
- Sustituciones (S): dentro de una transcripción, el número de veces que el motor de STT genera una palabra incorrecta, por ejemplo, «casa» en lugar de «caza».
- Eliminaciones (D): el número de palabras que omitió por completo.
- Inserciones (I): el número de palabras que añadió y que nunca se dijeron.
- Total de palabras de referencia (N): el número total de palabras de la muestra de entrada de voz.
Es importante tener en cuenta que la WER pondera todos los errores por igual. Por ejemplo, sustituir «casa» por «caza» cuenta lo mismo que reconocer mal el nombre de tu marca o una cifra importante, como el tamaño de una dosis de medicamento. Consulta las WER de distintos modelos.
¿Qué se considera una buena tasa de error de palabras?
No existe una única WER buena, porque el objetivo adecuado depende de tu audio y de tu caso de uso. El audio limpio de un solo hablante produce tasas de error mucho más bajas que las llamadas ruidosas con hablantes superpuestos. Compara modelos con tus propias grabaciones en lugar de basarte en una cifra destacada.
Como referencia para audio especializado, Scribe v2 Medical se encuentra entre los modelos con mejor rendimiento en pruebas comparativas públicas de ASR médico. Consulta los resultados actuales de las pruebas para conocer las cifras más recientes.
Los resultados de las pruebas comparativas cambian a medida que se lanzan nuevos modelos. Consulta los resultados actuales antes de comparar.
Exactitud frente a precisión: qué deben medir los equipos de transcripción
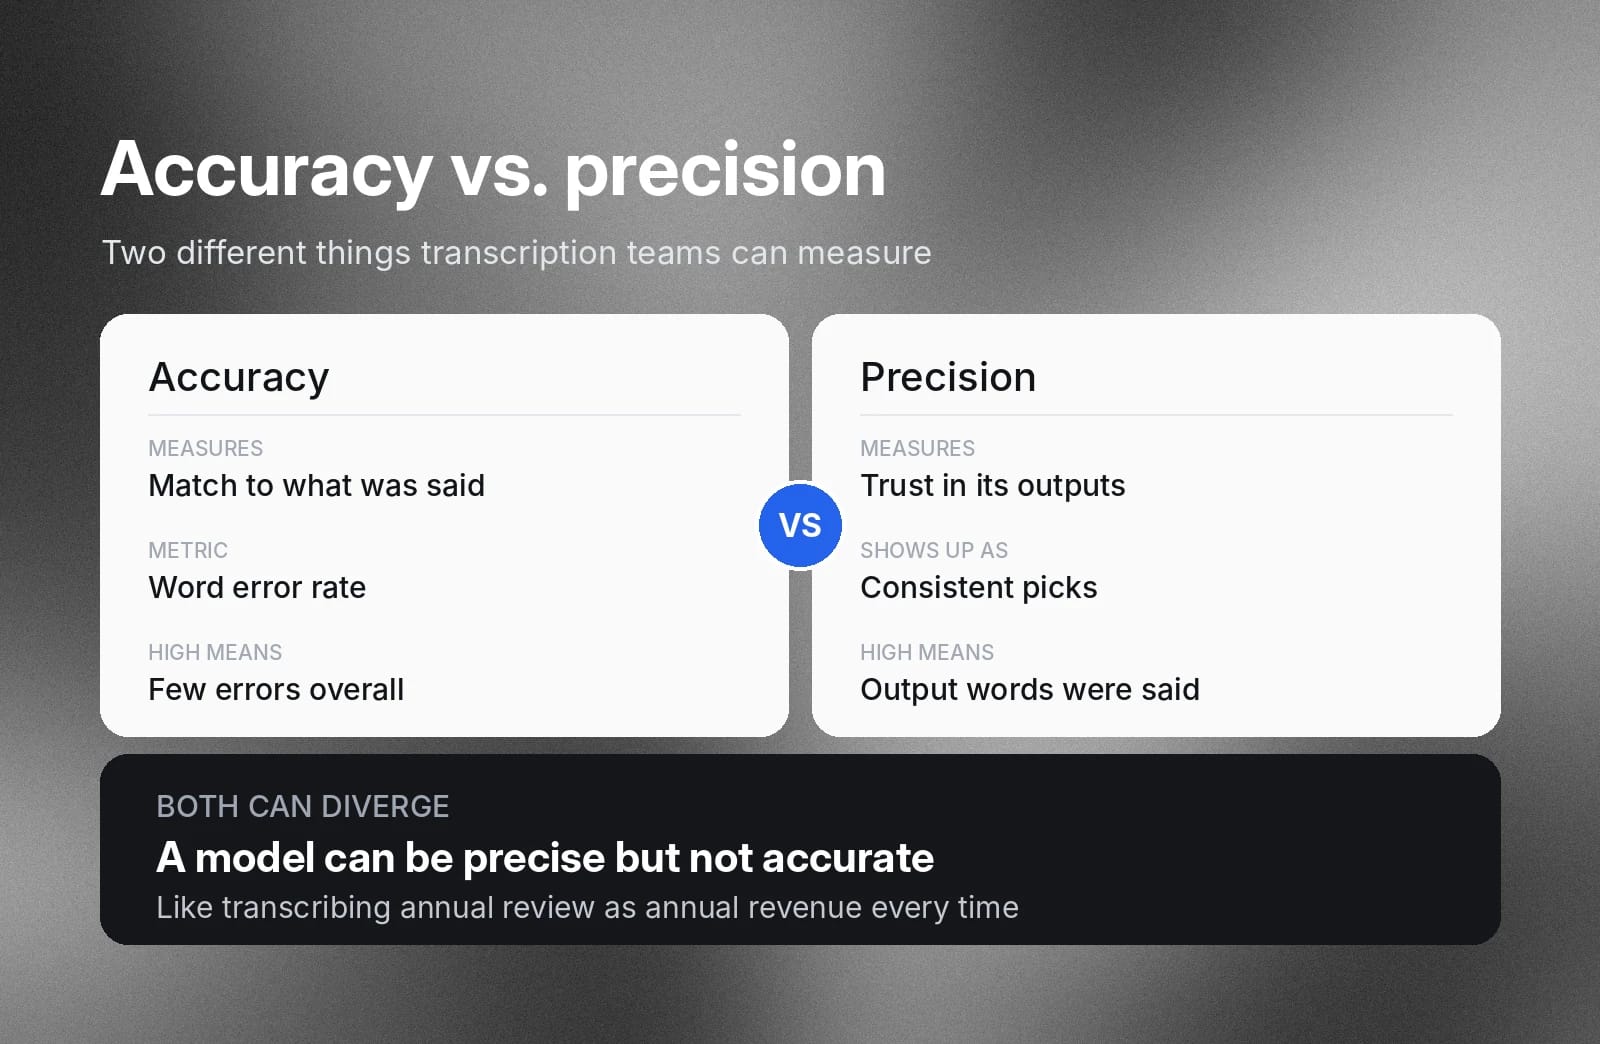
La exactitud indica hasta qué punto el resultado de la transcripción coincide con la entrada hablada de «referencia». La tasa de error de palabras mide la exactitud.
La precisión indica la fiabilidad de las predicciones positivas del modelo de STT. Un modelo muy preciso seleccionará la misma palabra para un habla compleja en varias ejecuciones. Si el modelo genera una palabra, puedes confiar en que esa palabra estaba presente en el habla. Pero un modelo muy preciso puede seguir teniendo una exactitud baja, lo que significa que elimina muchas palabras.
Empieza con ElevenAPI para lograr transcripciones más exactas
ElevenAPI te da acceso a Scribe v2, el modelo de Voz a Texto de ElevenLabs, junto con funciones que abordan los problemas de precisión de esta guía: prompting de términos clave para nombres y jerga, transcripción multicanal para hablantes superpuestos y diarización de hablantes.
Si quieres transcribir sin usar la API, también puedes acceder a ElevenCreateive STT.
Empieza hoy a generar Voz a Texto de alta calidad con ElevenAPI o descubre más sobre las capacidades de Voz a Texto de ElevenAPI.
Preguntas frecuentes sobre la precisión de Voz a Texto

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.


