Scribe v2 Medical ya está disponible para todo el mundo
- Escrito por
- Min Kim
- Publicado
- Última actualización
EscucharEscucha este artículo
El audio clínico es una de las pruebas más exigentes para el reconocimiento preciso de voz. Los nombres de medicamentos son largos, poco frecuentes y fáciles de confundir (hydroxyzine y hydralazine se diferencian por una sílaba que puede oírse mal). El vocabulario es denso, con dosis, unidades y términos de anatomía y patología que pueden sucederse rápidamente. Además, hay mucho en juego porque un error de transcripción podría acabar en el historial de un paciente.
Por eso ElevenLabs lanza hoy Scribe v2 Medical, nuestro modelo de Voz a Texto ajustado para audio clínico, que ya está disponible de forma general en ElevenAPI. En las evaluaciones que presentamos a continuación, obtiene sistemáticamente una de las tasas de error por palabra (WER) más bajas entre los modelos comparados y reduce el WER en audio clínico aproximadamente un 35 % frente a nuestro modelo base Scribe v2.
Los modelos de uso general gestionan muy bien el habla cotidiana, pero pueden perder rendimiento justo donde los flujos de trabajo clínicos más lo necesitan. Entrenamos un ajuste médico de Scribe v2 centrado tanto en nombres de medicamentos como en dictado clínico, utilizando benchmarks públicos que cualquiera puede reproducir.
Scribe v2 Medical está optimizado para casos de uso clínicos
Dictado clínico (MedDictate)
MedDictate de Corti evalúa la transcripción de notas clínicas dictadas, que incluyen nombres de medicamentos, dosis y unidades consecutivamente en inglés, francés y alemán. En nuestra evaluación, Scribe v2 Medical registra el WER global más bajo entre los modelos que probamos y un WER aproximadamente un 35 % menor que el de Scribe v2 base.
Modelo
EN
FR
DE
WER global
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (base)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Solo inglés (24 clips): Deepgram Nova-3 Medical no es compatible con francés ni alemán.
Terminología médica (MedTerm)
MedTerm también es un conjunto de datos publicado por Corti e incluye un benchmark de terminología clínica de 600 muestras en los mismos tres idiomas, con los términos médicos de cada muestra anotados. Esta anotación permite evaluar los modelos en dos dimensiones más allá del WER de la transcripción completa. La recuperación de términos es el porcentaje de términos médicos anotados que aparecen correctamente en la transcripción (cuanto más alto, mejor). El WER de términos es la tasa de error solo en esos términos, sin tener en cuenta el habla cotidiana que los rodea (cuanto más bajo, mejor).
Scribe v2 Medical lidera todos los modelos evaluados en ambas dimensiones y a todos los demás proveedores en los tres idiomas:
Modelo
Recuperación de términos ↑
WER de términos ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (base)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Benchmark de ASR médico de Eka
El benchmark de ASR médico de Eka contiene 3619 muestras de audio clínico en inglés —con nombres aislados de medicamentos y afecciones, frases clínicas y conversaciones entre profesionales sanitarios y pacientes—, con anotaciones por término y una clasificación publicada en la ficha del conjunto de datos.
Dado que el conjunto de datos publicado incluye modelos más antiguos como Gemini 2.5 Flash y GPT-4o, realizamos la evaluación con modelos más recientes. SemWER (WER semántico) evalúa si el modelo ha oído el contenido correcto, independientemente del formato («mg» y «miligramos» cuentan como la misma respuesta), y kwWER (WER de palabras clave) aplica la misma puntuación únicamente a las palabras clave médicas anotadas.
Modelo
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (base)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka anota los términos médicos de cada muestra, lo que permite evaluar con más detalle las mejoras de Scribe v2 Medical respecto al modelo base únicamente en los términos médicos. Scribe v2 Medical comete un 15 % menos de errores que el modelo base (9.5 % frente a 11.1 %), y las mejoras son mayores cuando los términos aparecen en frases clínicas completas (7.5 % frente a 9.9 %).
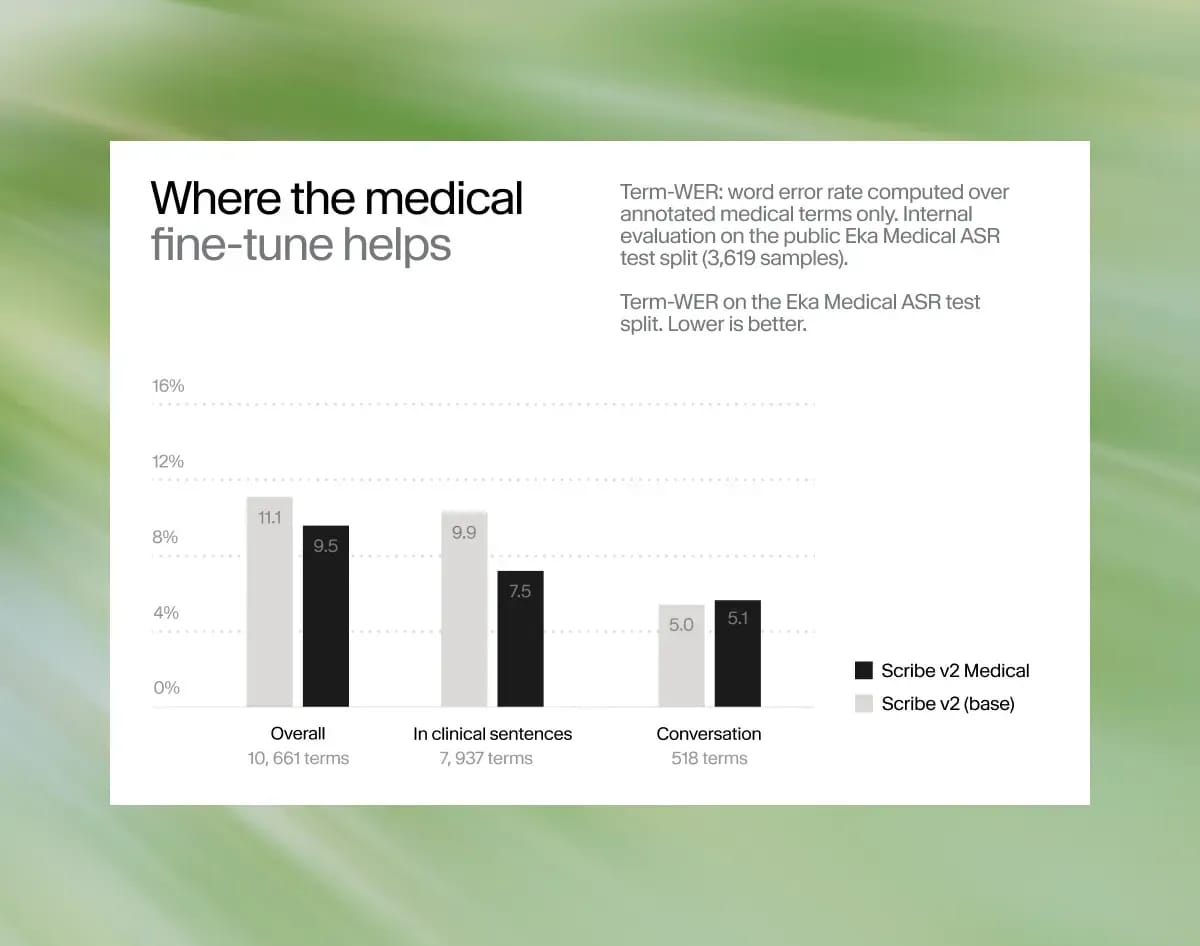
Una salvedad de los mismos datos es que los clips aislados de una sola palabra —un único nombre de medicamento pronunciado sin contexto— siguen siendo el caso más difícil para todos los modelos de la clasificación, incluido Scribe v2 Medical. Obtuvo un WER del 14.3 % en términos aislados, frente al 7.5 % cuando esos términos aparecen en frases. Sin contexto, una sílaba mal oída puede dar lugar a errores llamativos:
- etodolac (un AINE) → «It'll do the luck»
- levomilnacipran (un antidepresivo) → «Leave me alone now, Sephora.»
- methdilazine (un antihistamínico) → «Let's play our scene.»
Una forma de reducir estos errores es mediante prompting de términos clave, que te permite destacar nombres de medicamentos o expresiones médicas para orientar al modelo a transcribirlos correctamente.
Clientes en producción
Clientes ya están utilizando Scribe v2 Medical en producción y observan mejoras en el audio clínico.
«Desde que cambiamos de Deepgram a ElevenLabs Scribe v2 Medical, estamos viendo una precisión mucho mayor en la terminología clínica, y eso ha cambiado la forma de trabajar del equipo», afirma Mendel Erlenwein, CEO y fundador de CareCo. «Cuando nuestros coordinadores confían en las transcripciones, pueden dedicar menos tiempo a corregir notas y más a hablar por teléfono con pacientes. Nuestros pacientes siguen tratamientos complejos, y la nota que lee el equipo asistencial tiene que ser correcta.»
Alto rendimiento con habla general
El equipo también verificó que el ajuste médico no reduce el rendimiento en otras áreas. En 6000 muestras de habla cotidiana no médica procedentes de Common Voice, Scribe v2 Medical obtiene el mismo resultado que Scribe v2 base al redondear: un WER del 5.3 % en ambos casos. Así, con v2 Medical obtienes las ventajas de un modelo médico especializado sin renunciar a precisión en este benchmark.
Diseñado para información sanitaria protegida
Scribe v2 Medical cumple los requisitos para HIPAA para clientes empresariales que tengan acuerdos de asociado comercial vigentes y Modo de retención cero (ZRM) activado.
Con ZRM activado para las solicitudes de la API de Voz a Texto, la entrada de audio y la salida de texto se eliminan inmediatamente después de completar cada solicitud. ElevenLabs no conserva ninguna de las dos, y tu aplicación recibe la respuesta completa de la API y controla cómo se conservan las transcripciones.
Primeros pasos
Scribe v2 Medical está disponible en la API de Voz a Texto. Solo tienes que indicar el nuevo ID de modelo: scribe_v2_medical
El modelo funciona en la ruta por lotes de Voz a Texto .