¿Qué es la toma de turnos en la IA conversacional? Guía para lograr un flujo natural
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
Un buen servicio de atención al cliente requiere habilidades conversacionales excepcionales. Una de las más importantes es aprender a escuchar y saber cuándo hablar. De lo contrario, los agentes de atención al cliente corren el riesgo de interrumpir a clientes ya frustrados que quizá hayan llamado varias veces para explicar su problema.
El mismo estándar se aplica a la toma de turnos en la IA conversacional. Los agentes deben lograr un delicado equilibrio: guardar silencio el tiempo suficiente para dejar hablar a la persona, pero no tanto como para que la latencia y los silencios incómodos reduzcan la calidad de la conversación.
Por eso, la toma de turnos conversacional moderna requiere que los modelos evalúen rápidamente la intención del habla en lugar de usar temporizadores de silencio rígidos. Nuestra arquitectura unificada en ElevenLabs lo consigue analizando continuamente el tono, el ritmo y el contexto de las palabras para mantener las conversaciones bien encaminadas y conservar un flujo natural.
Resumen
- Los equipos de atención al cliente implementan agentes de voz entrenados en toma de turnos para resolver incidencias rápidamente y con menos fricción.
- La toma de turnos es importante para que los modelos determinen cuándo responder o intervenir, mantener el turno y escuchar o guardar silencio.
- Agentes de IA se basan en una sincronización adaptativa, detección de actividad de voz y análisis semántico para mantener un flujo de conversación natural.
- Los equipos de ingeniería hacen seguimiento de la latencia de respuesta y las tasas de interrupción para medir el flujo conversacional y optimizar workflows.
¿Qué es la toma de turnos en la IA conversacional?
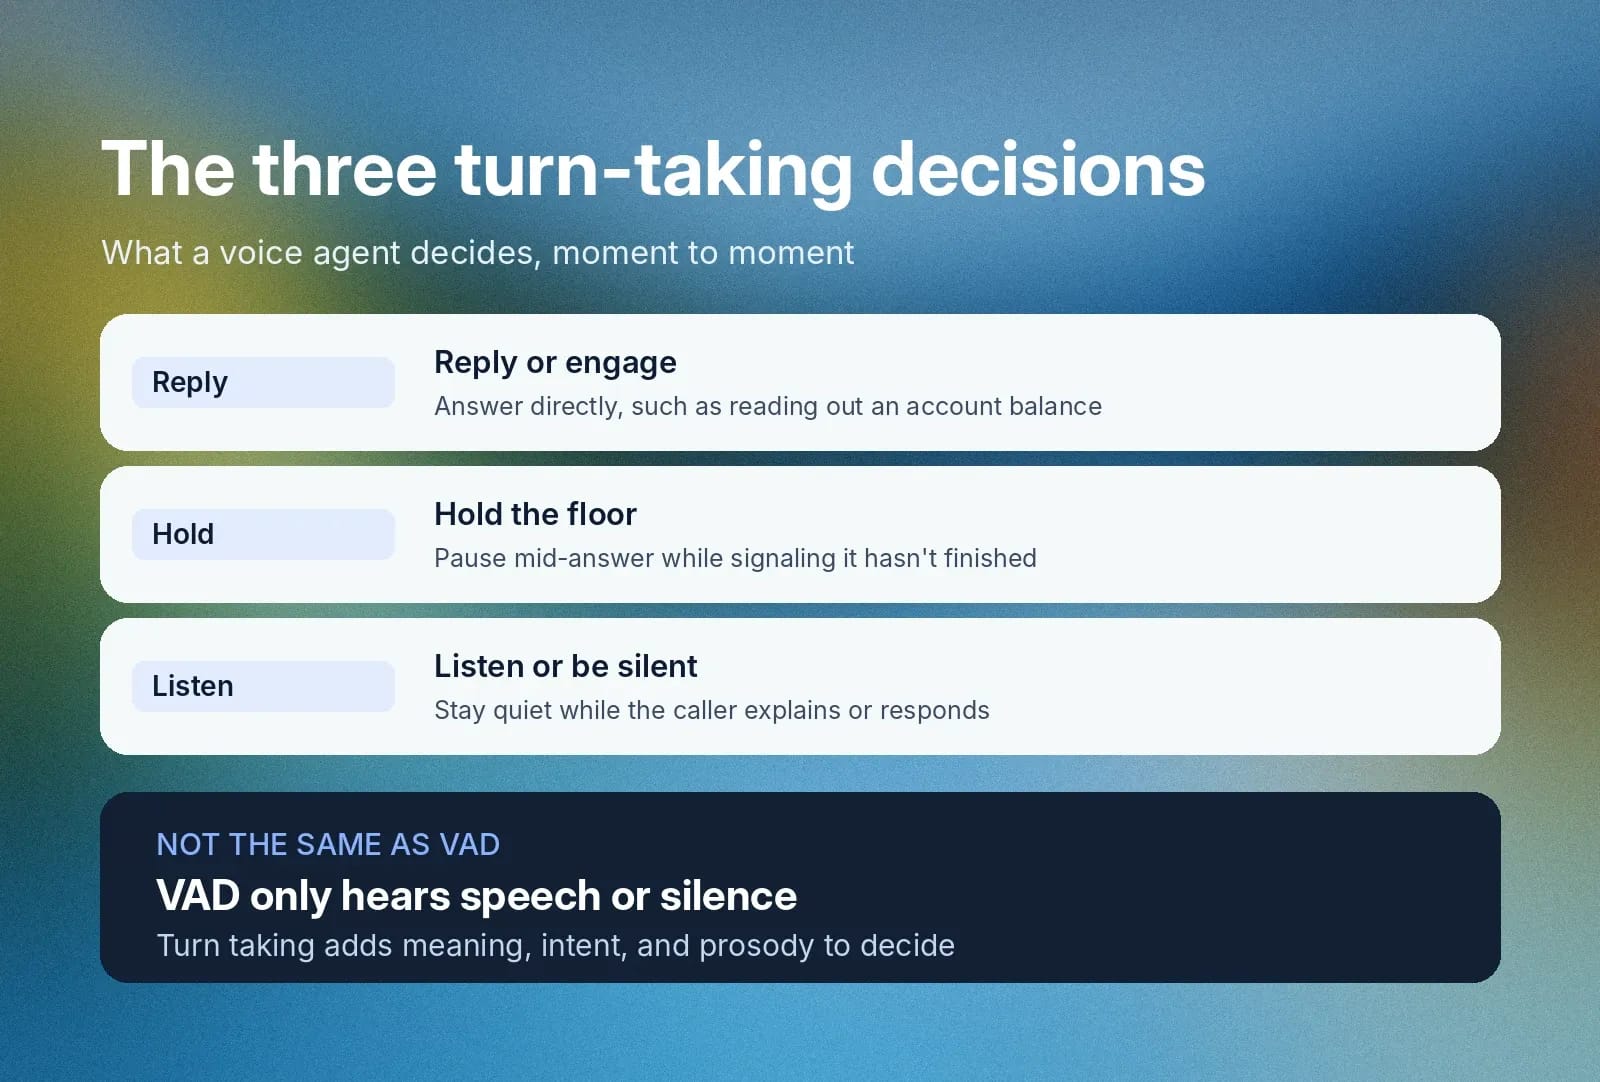
Cuando los modelos de IA conversacional participan en la toma de turnos, siguen un sistema de reglas que determina el momento óptimo para:
- Responder o intervenir: aquí, el agente de IA responde directamente a la pregunta. Por ejemplo, un cliente pregunta por el saldo de su cuenta y el sistema responde: «El saldo de su cuenta es de 57,34 $.»
- Mantener el turno: en este caso, el modelo sigue hablando e indica que no ha terminado incluso mientras hace una pausa. Por ejemplo, un cliente pregunta por el saldo de su cuenta y recibe esta respuesta: «Primero, déjame usar la información que enviaste para consultar tu cuenta… [pause]. El saldo de tu cuenta es de 57,34 $, pero… [pause] también veo un pago pendiente por ese importe. ¿Llamas para saber cuándo se procesará ese pago sin que se te cobre una comisión por demora?»
- Escuchar o guardar silencio: en este punto, el agente permanece en silencio mientras espera a que el cliente explique su situación o responda. Por ejemplo, el cliente confirma que quería saber si el pago se ha procesado porque han pasado varios días desde que lo envió. El modelo de IA responde: «Sí, veo que han pasado dos días desde que enviaste el pago. Normalmente tarda tres días en procesarse, así que debería completarse mañana por la mañana. No se te cobrará ninguna comisión por demora. ¿Necesitas ayuda con algo más?»
La documentación para desarrolladores suele denominarlo detección de turno o detección de final de turno. Los sistemas que combinan la detección de actividad de voz con la comprensión del lenguaje para determinar si un hablante ha terminado suelen describirse como VAD semántica.
Esta forma fluida de mantener el diálogo con un cliente elimina los mensajes rígidos al estilo walkie-talkie y permite que los agentes de voz mantengan conversaciones naturales.
También conviene señalar que esta capa de decisión de tres puntos de la IA conversacional difiere de la detección de actividad de voz (VAD) sin procesar. Mientras que la VAD clasifica el audio como habla o silencio, la toma de turnos conversacional considera el contexto semántico, la intención y la prosodia, además de la señal en bruto. Consulta nuestra guía sobre VAD para conocer en detalle cómo funcionan los algoritmos de detección de habla y por qué los necesitas.
Por qué la toma de turnos natural es esencial para los agentes de voz
Una mala toma de turnos es la forma más rápida de irritar a un cliente, especialmente a quienes ya sienten rechazo al hablar con bots menos avanzados. Los agentes de IA conversacional obsoletos hablan por encima de quienes llaman, hacen pausas largas e incómodas o no siguen el ritmo de la conversación.
ElevenAgents utiliza una sincronización adaptativa para que tus agentes automatizados mantengan un ritmo natural de ida y vuelta. Esta precisión en los tiempos genera confianza en clientes respecto a la capacidad del modelo. Por extensión, también genera confianza en la tecnología que has implementado y en el compromiso de tu marca con la satisfacción del cliente.
Al utilizar Eleven v4 Turbo con ElevenAgents, los agentes tienen una mediana de 142 ms desde la solicitud hasta el habla audible.
Además, una toma de turnos conversacional bien sincronizada mantiene a clientes implicados el tiempo suficiente para resolver el problema al primer intento, sin escalarlo a un agente humano.
Cómo funciona la toma de turnos conversacional en tiempo real
La toma de turnos conversacional en tiempo real utiliza un pipeline multicapa que analiza continuamente el audio en directo. Los modelos también se basan en una combinación de reglas para determinar las mejores acciones con las que mantener conversaciones fluidas. ElevenAgents gestiona estos procesos en tres etapas diferenciadas para que cada intercambio sea ágil y natural.
Detección de habla, silencio e intención
La detección de actividad de voz interpreta y clasifica los flujos de audio entrantes como habla o silencio decenas de veces por segundo. Una vez que la VAD entrega la señal en bruto, la detección de intención determina si la persona realmente ha dejado de hablar o simplemente ha hecho una pausa para pensar. Entre los factores que puede considerar para confirmar que un turno ha terminado están una entonación descendente o una frase sintácticamente completa. En cambio, puede detectar una pausa temporal por un tono sostenido o por el uso de muletillas como «eh…» o «en plan…»
Decidir cuándo responder
Como los retrasos en la respuesta pueden hacer que quienes llaman abandonen la conversación, la decisión del modelo sobre cuándo responder es uno de los factores más críticos para el éxito. Las arquitecturas de voz tradicionales suelen depender de temporizadores restrictivos para determinar cuándo una persona ha dejado realmente de hablar, pero esto puede hacer que interrumpan a quienes llaman cuando intentan hablar de nuevo o simplemente crear silencios incómodos. La toma de turnos moderna en la IA conversacional usa aprendizaje profundo para comprender por completo señales como la prosodia, el ritmo al hablar y las muletillas.
Gestionar la latencia de respuesta desde la escucha hasta la salida de voz
Según una investigación lingüística publicada en Journal of Cognition, los intervalos entre turnos de hablantes humanos son de media de unos 200 ms entre culturas. Por eso, los modelos que tardan mucho más en responder generan pausas incómodas. Esto provoca impaciencia y aumenta las tasas de abandono de llamadas.
Gestión de interrupciones, señales de escucha y habla solapada
Los proveedores y la forma en que programan sus modelos de IA conversacional determinan lo bien que los agentes gestionan las interrupciones, las señales de escucha y el habla solapada.
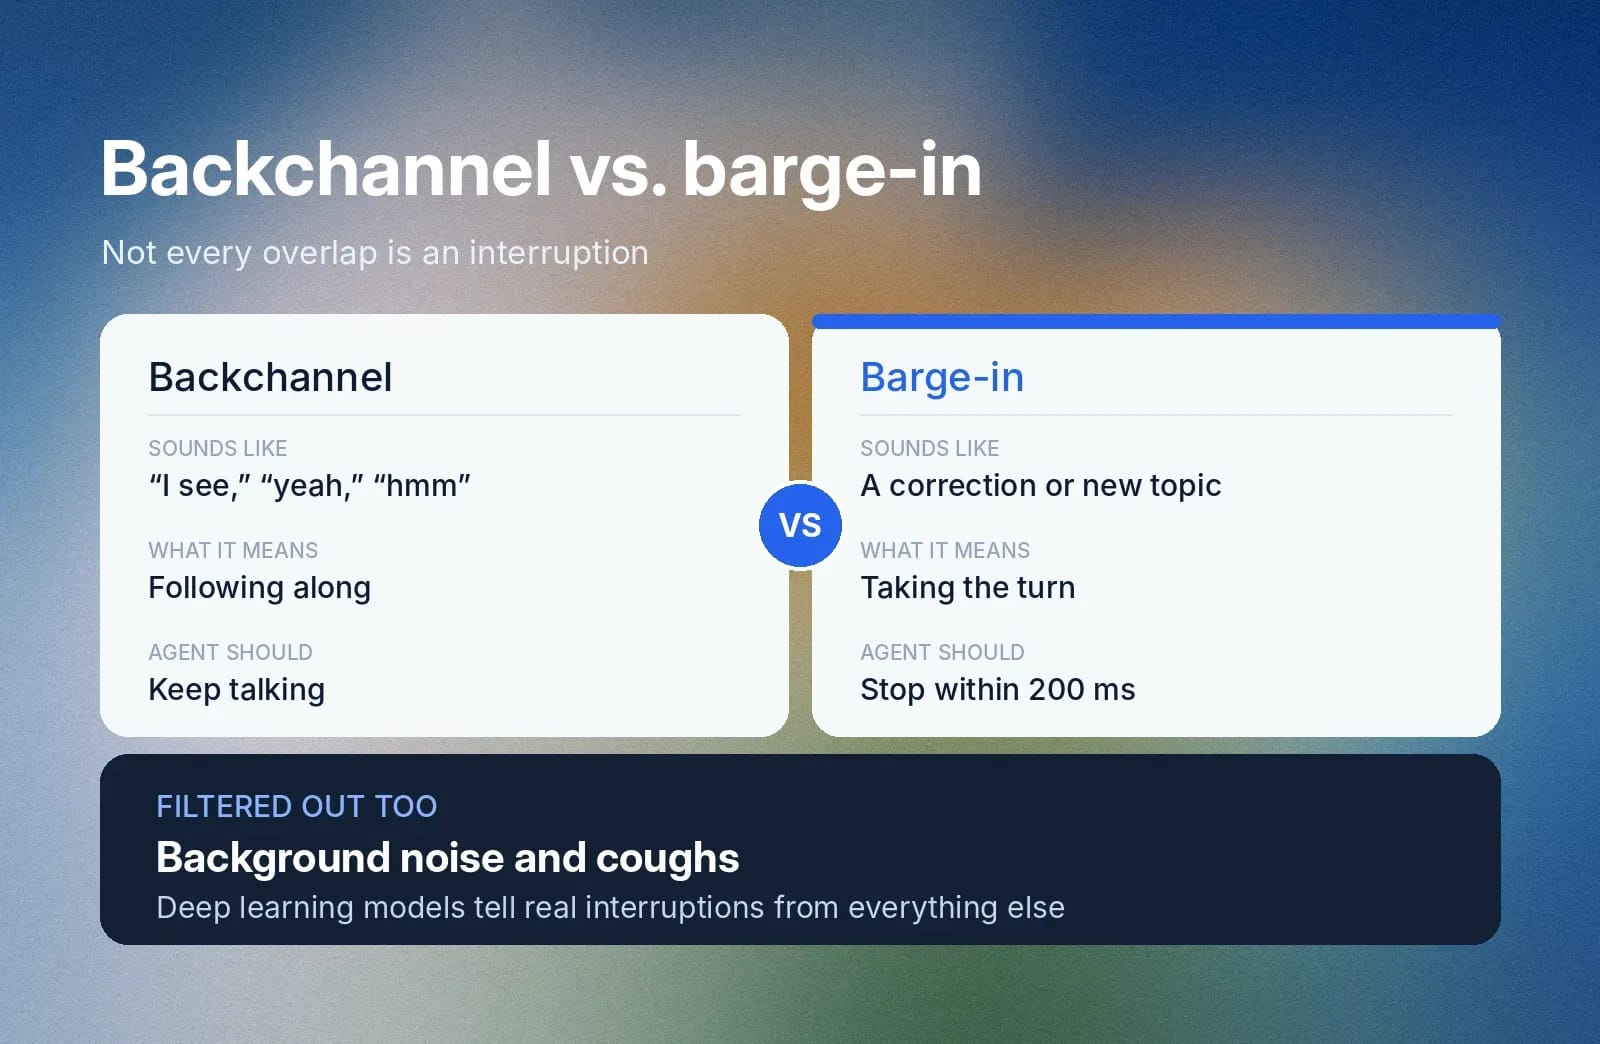
Las señales de escucha son sonidos o palabras breves de reconocimiento que usa quien escucha, como «entiendo» o «sí», para mostrar que sigue la conversación sin tomar el turno. Un agente de voz debe entender estas señales para seguir hablando en vez de considerarlas indicaciones de una interrupción.
ElevenAgents gestiona los solapamientos en directo cediendo inmediatamente el turno cuando quien llama interrumpe de verdad. Cuando una persona irrumpe, por ejemplo, para corregir un dato de su cuenta o cambiar el tema de conversación, ElevenAgents envía una señal de detención en menos de 200 ms. Esto hace que el agente deje de hablar a mitad de frase en lugar de permitirle completar la oración que tenía prevista.
Nuestros modelos de aprendizaje profundo también filtran continuamente el ruido de fondo y distinguen las interrupciones reales de las muletillas de reconocimiento o reflexión. Por ejemplo, un usuario que dice «entiendo…» o «mmm…» mientras habla un agente ha creado habla solapada, pero no está tratando de intervenir.
Funciones como estas ayudan a nuestros agentes de voz a mantener tiempos de respuesta precisos y un flujo natural incluso en momentos de interrupción con una intención clara.
Fallos habituales en la toma de turnos y cómo prevenirlos
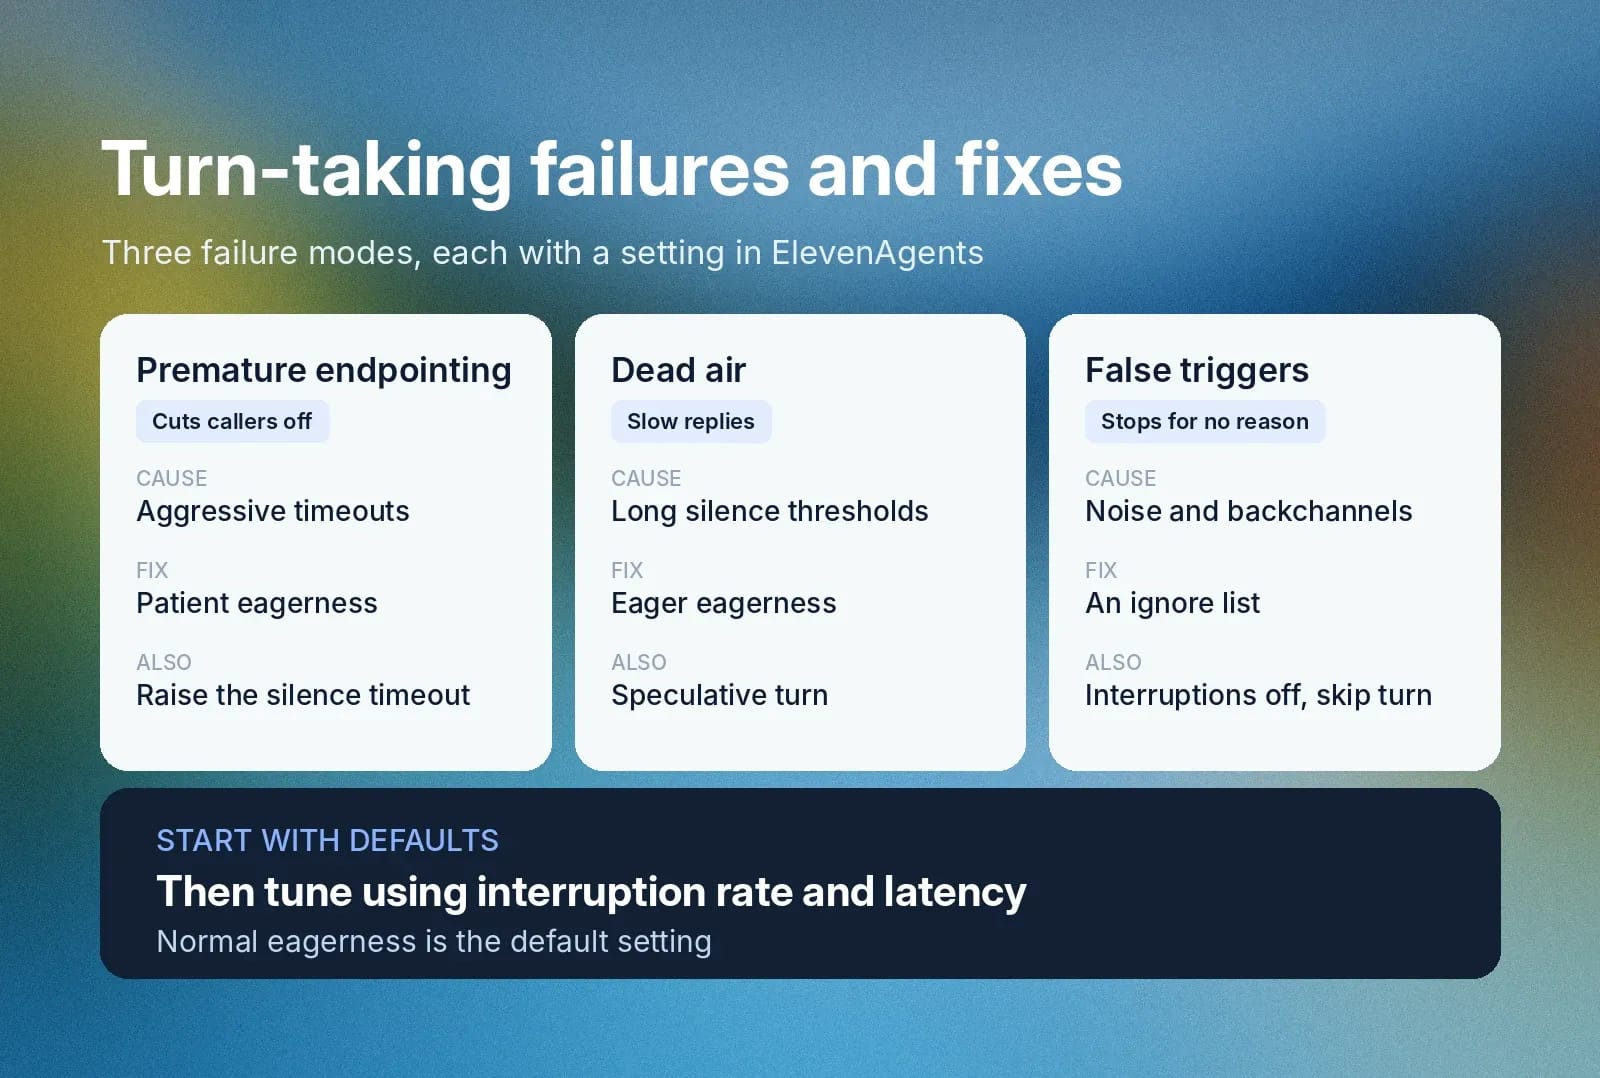
Los modelos de IA conversacional se enfrentan a tres modos de fallo principales que los equipos de ingeniería deben tener en cuenta al configurar agentes de voz:
- Detección prematura de final de turno: unos tiempos de espera demasiado agresivos pueden hacer que los modelos confundan con turnos terminados las pausas a mitad de frase, cuando quien llama solo quería pensar o buscar información. Esto hace que el agente de voz interrumpa con frecuencia y frustre a clientes.
- Silencios incómodos y respuestas tardías: unos umbrales de silencio excesivos provocan pausas largas e incómodas que pueden aumentar las tasas de abandono. Estos retrasos hacen que los agentes de voz parezcan lentos y poco receptivos, lo que afecta negativamente a la experiencia del cliente y a la imagen de tu marca.
- Activaciones falsas por muletillas y ruido: los modelos mal ajustados también pueden interpretar el ruido ambiental, la tos y las señales de escucha como interrupciones reales. Esto hace que el modelo haga pausas o se detenga innecesariamente cuando el cliente realmente está escuchando y no trata de interrumpir.
Los ingenieros pueden prevenir estos problemas implementando ElevenAgents con modelos de lenguaje contextuales. Este enfoque adaptativo, combinado con VAD, elimina los cortes falsos, las respuestas demasiado lentas y la sensibilidad excesiva al ruido de fondo.
Cómo configurar la toma de turnos en ElevenAgents
La configuración adecuada para la toma de turnos depende del caso de uso y de las llamadas habituales que reciba tu agente. ElevenAgents permite a los equipos ajustar con precisión cada uno de los modos de fallo anteriores en la configuración del agente.
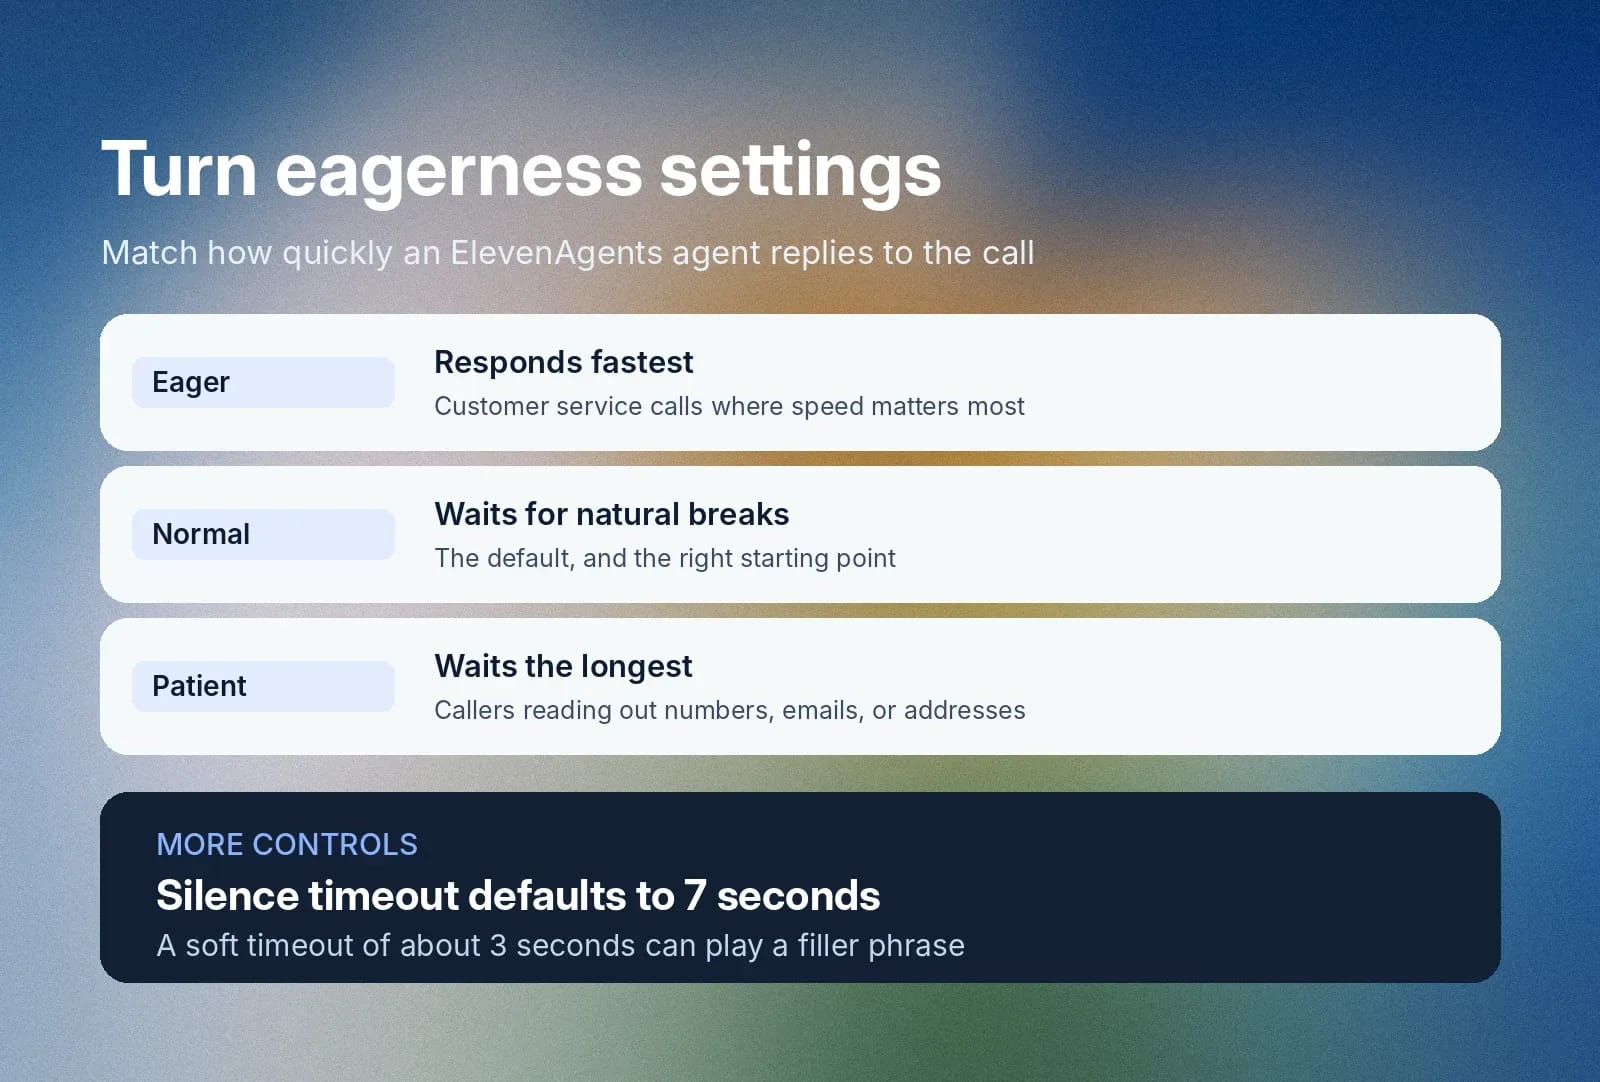
- Detección prematura de final de turno: configura la predisposición a tomar el turno como Paciente cuando quienes llaman dicten números de teléfono, correos electrónicos, direcciones u otros datos sensibles. La predisposición tiene tres niveles distintos. Ávido responde más rápido, Normal (predeterminado) espera pausas naturales y Paciente espera más tiempo. También puedes ajustar el tiempo de espera por silencio según el caso de uso: por ejemplo, 5–10 segundos para una atención al cliente ágil o 15–30 segundos para avisos legales. Los intervalos predeterminados y recomendados varían según el canal y el escenario.
- Silencios incómodos y respuestas tardías: usa la predisposición Ávido en llamadas de atención al cliente donde la rapidez es importante. El turno especulativo inicia la respuesta del modelo de lenguaje antes de que el agente esté seguro de que quien llama ha terminado, lo que reduce la latencia, aunque también puede aumentar los costes de LLM. Un tiempo de espera flexible también puede reproducir una breve frase de relleno cuando el modelo es lento; se recomiendan 3 segundos.
- Activaciones falsas e interrupciones no deseadas: añade palabras de reconocimiento, como «vale», a una lista de ignorados para que no interrumpan al agente. Desactiva las interrupciones cuando sea necesario escuchar cada palabra, por ejemplo, al leer un aviso legal. El agente aún puede transcribir lo que dice quien llama y procesarlo en el siguiente turno. Para frases como «dame un minuto», la herramienta para omitir turno mantiene al agente en silencio y puede volver a contactar tras un tiempo establecido.
La forma más potente de usar esta configuración es combinarla con Workflows, que permite al agente cambiar dinámicamente su predisposición a tomar el turno; por ejemplo, de Normal durante una conversación informal a Paciente cuando llega a un paso que recoge un número de teléfono. Empieza con la configuración predeterminada y ajusta la predisposición y los tiempos de espera según las métricas de tasa de interrupción y latencia de respuesta indicadas a continuación.
Cómo medir la calidad de la toma de turnos en la IA conversacional
Los equipos de garantía de calidad necesitan métricas operativas concretas para evaluar la toma de turnos en la IA conversacional. Es necesario pasar de medir la tecnología y las configuraciones a medir el impacto real. En pocas palabras, deben medir más que aquello que «parece natural» y lo que no.
La tasa de interrupción y la latencia de respuesta son las dos métricas principales que se deben considerar. La tasa de interrupción mide con qué frecuencia el modelo corta incorrectamente a quien llama, mientras que la latencia de respuesta registra cuánto tarda el modelo en responder cuando una persona deja de hablar y espera una respuesta. ElevenAgents registra ambas métricas en cada llamada para que los equipos puedan usar los datos para optimizar los umbrales de detección de actividad de voz sin depender de revisiones manuales de transcripciones. Consulta nuestra guía sobre cómo medir la IA conversacional para ver un desglose completo de los marcos de evaluación.
Los equipos de garantía de calidad mantienen altas tasas de precisión al crear una cadencia estructurada para evaluar el modelo. Este es un ejemplo de calendario que utiliza un equipo habitual.
Actividad de evaluación
Frecuencia
Objetivo de calidad
Supervisión operativa
Semanal
Realiza un seguimiento del rendimiento en tiempo real y detecta problemas de sincronización en agentes de voz activos
Revisiones de satisfacción de usuarios
Mensual
Analiza el sentimiento de quienes llaman para ajustar con precisión la configuración de toma de turnos
Benchmarks completos del sistema
Trimestral
Evalúa la precisión integral, la toma de turnos conversacional y los umbrales de latencia de respuesta
Por último, aunque haya métricas automatizadas disponibles, los equipos de garantía de calidad deberían seguir extrayendo algunos datos para revisiones manuales. Pueden obtener datos más precisos si inspeccionan archivos de audio sin procesar en lugar de limitarse a las transcripciones de texto. Esto se debe a que las transcripciones de texto añaden otra capa de automatización y podrían pasar por alto errores de la herramienta de transcripción, especialmente cuando el habla se solapa.

Empieza a usar ElevenAgents para conversaciones de voz naturales
Los agentes de voz con una interacción humana que resuelven incidencias rápidamente reducen costes y mejoran la eficiencia operativa. Sin embargo, para obtener estos beneficios necesitas modelos de IA avanzados que puedas ajustar con precisión para gestionar correctamente la toma de turnos. Los equipos de ingeniería lo consiguen implementando ElevenAgents. Nuestra arquitectura unificada combina la detección de actividad de voz con la comprensión semántica para mantener un flujo de conversación natural y reducir la latencia.
Consulta nuestra documentación sobre detección de turnos de ElevenAgents para configurar una toma de turnos conversacional natural en tu equipo de atención al cliente o regístrate para empezar.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.