
Medir la IA conversacional: métricas esenciales para el éxito
- Escrito por
- Jack Limebear
- Publicado
- Última actualización
EscucharEscucha este artículo
Las herramientas de IA conversacional reducen drásticamente el coste de ofrecer atención al cliente las 24 horas. Lo hacen sin necesidad de cubrir turnos de noche ni asumir los riesgos para la privacidad de los datos que implica externalizar puestos en el extranjero.
Pero el ahorro de costes solo importa si un agente de IA es capaz de resolver los problemas de clientes. Medir la IA conversacional con los indicadores clave de rendimiento adecuados te indica si funciona, especialmente en empresas que gestionan un gran volumen de consultas de clientes.
Este artículo explica cómo evaluar el flujo conversacional y la precisión de las respuestas protege tanto la experiencia del cliente como tu marca. Explicamos cómo los equipos de experiencia del cliente realizan experimentos eficaces de pruebas A/B con los saludos a quienes llaman. También aprenderás a mantener una plataforma de IA conversacional fiable y multilingüe.
Resumen
- Medir sistemáticamente la IA conversacional en métricas de calidad, experiencia y operaciones proporciona los datos necesarios para proteger la experiencia del cliente.
- Las herramientas de evaluación automatizada realizan un seguimiento y mejoran continuamente las métricas de IA conversacional a gran escala, mientras que personal humano lleva a cabo comprobaciones puntuales periódicas.
- Aislar una variable concreta cada vez en las pruebas A/B permite identificar con precisión qué ha fallado para aplicar correcciones que aborden directamente los problemas detectados.
- La mejora continua es necesaria porque las empresas de IA actualizan con frecuencia los modelos subyacentes, lo que a menudo hace que chatbots que antes eran fiables se comporten de forma distinta en producción.
Qué significa medir la IA conversacional y por qué importa
Medir la IA conversacional implica evaluar sistemáticamente hasta qué punto tus agentes de IA probados o desplegados atienden las solicitudes de clientes y resuelven problemas. El objetivo es determinar con qué eficacia tus sistemas automatizados gestionan conversaciones de varios turnos en el mundo real según los estándares de rendimiento que hayas establecido. Estos estándares suelen reflejar hasta qué punto los modelos comprenden la intención del usuario, respetan la voz de marca, ofrecen respuestas precisas y resuelven el problema correctamente.
Las evaluaciones de modelos pueden parecer mucho trabajo adicional para un sistema pensado para reducir las tareas que realiza tu equipo. Pero sin una evaluación constante, sería difícil saber cómo rinde el modelo en casos de uso reales. En otras palabras, sabes que tu sistema de IA reduce los costes operativos de atención al cliente, pero ¿puedes confirmar que satisface a clientes en lugar de llevarlos a buscar otras soluciones?
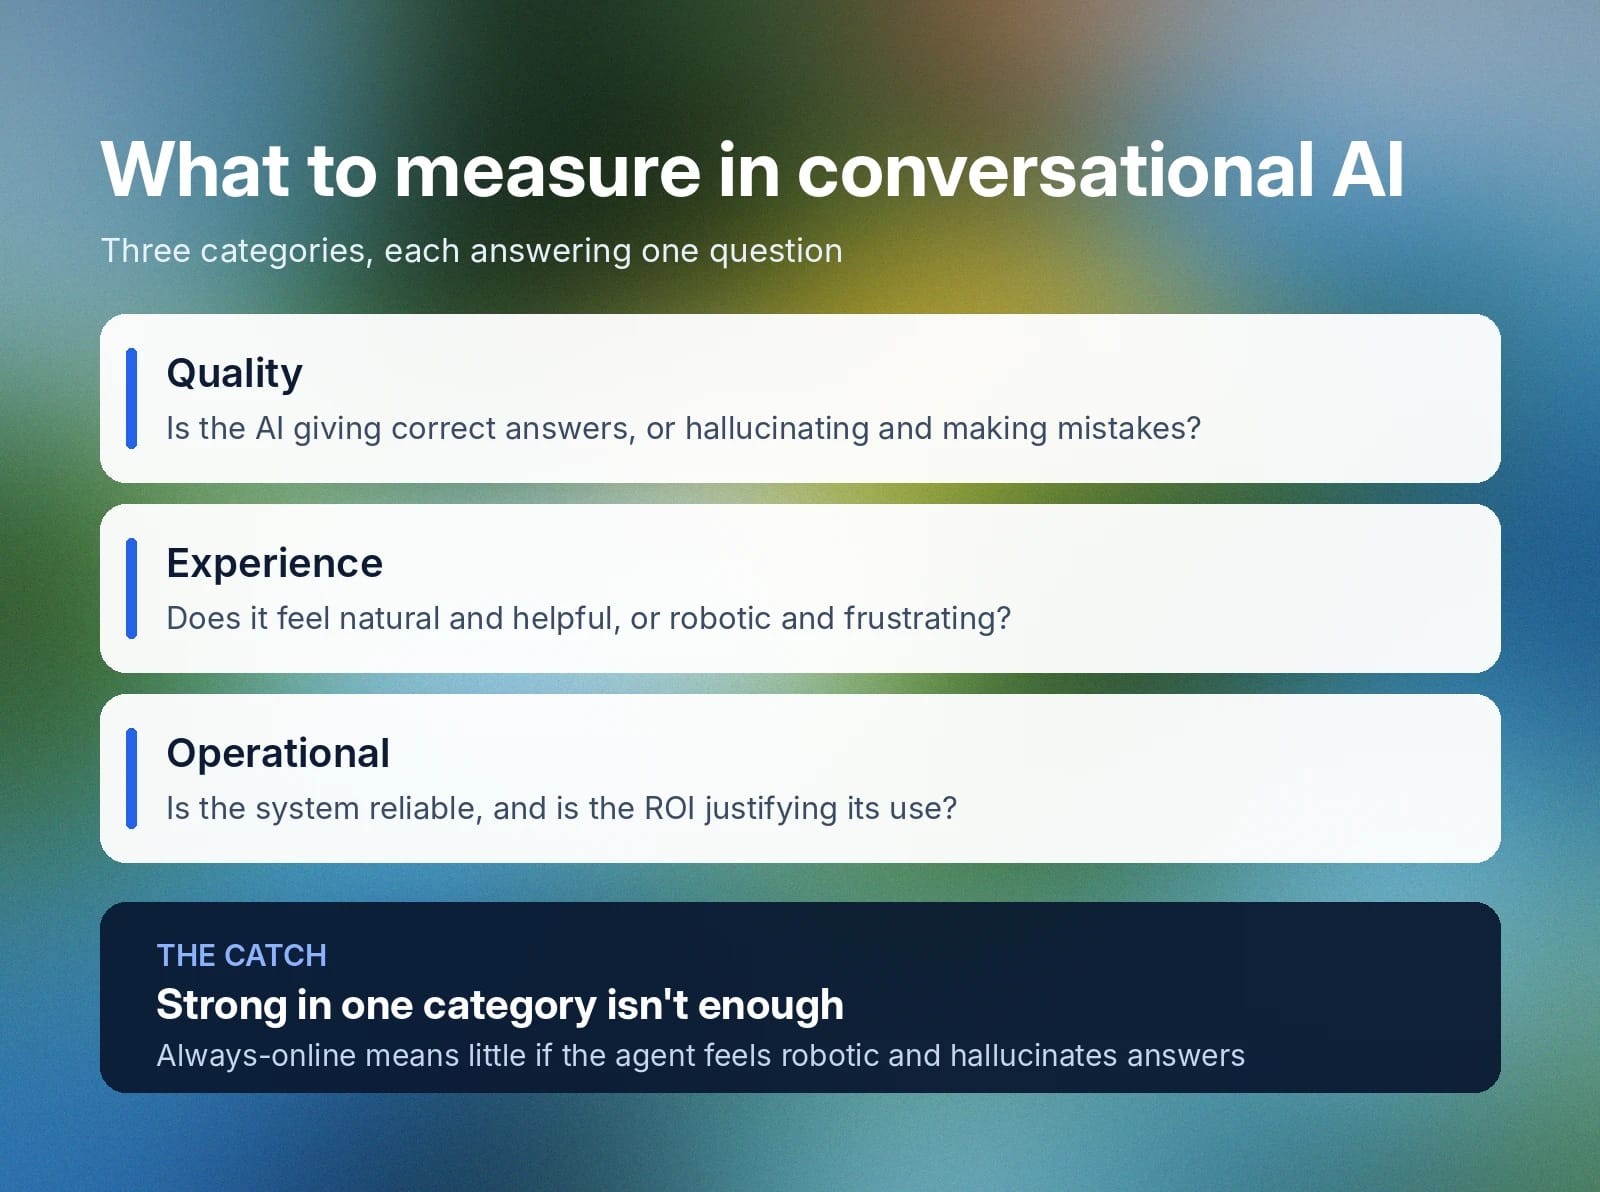
Una medición exhaustiva requiere analizar el modelo en tres categorías principales:
- Calidad: Evalúa la precisión, coherencia y relevancia de las respuestas de una IA según la solicitud inicial del usuario. La pregunta principal es: ¿la IA acierta y ofrece a usuarios las respuestas correctas, o alucina y comete errores?
- Experiencia: Evalúa la experiencia del cliente; por ejemplo, si la IA respondió con rapidez y cuántos turnos necesitó para dar una respuesta satisfactoria. La pregunta principal es: ¿la experiencia resulta natural y útil para el usuario, o parece robótica y frustrante?
- Operaciones: Determina si el sistema funciona de forma fiable y sigue siendo una solución rentable para tus necesidades de atención al cliente. Entre las dudas habituales están: ¿el sistema tiene una alta disponibilidad y ofrece el retorno de la inversión necesario para justificar su uso?
El éxito es distinto para cada equipo, y los problemas iniciales antes de automatizar la atención tienen un gran peso en ello. Por ejemplo, si al principio tu equipo tenía dificultades para mantener una atención al cliente disponible 24/7 atención al cliente, la disponibilidad ininterrumpida de los agentes de IA mejora fácilmente el rendimiento de la atención al cliente. Sin embargo, todas estas categorías son importantes para el éxito general, por lo que un sistema que siempre está en línea y rara vez falla no ayudará mucho a clientes si parece robótico y alucina respuestas.
Métricas clave de IA conversacional que debes seguir
Haz seguimiento de cifras claras y accionables para valorar el rendimiento de los agentes con clientes y si tu implementación actual genera un valor empresarial real. La evaluación continua también facilita la mejora periódica. Cuando identificas con precisión dónde hay cuellos de botella en tu workflow o dónde debes hacer ajustes, tienes los datos para abordar eficazmente la causa raíz.
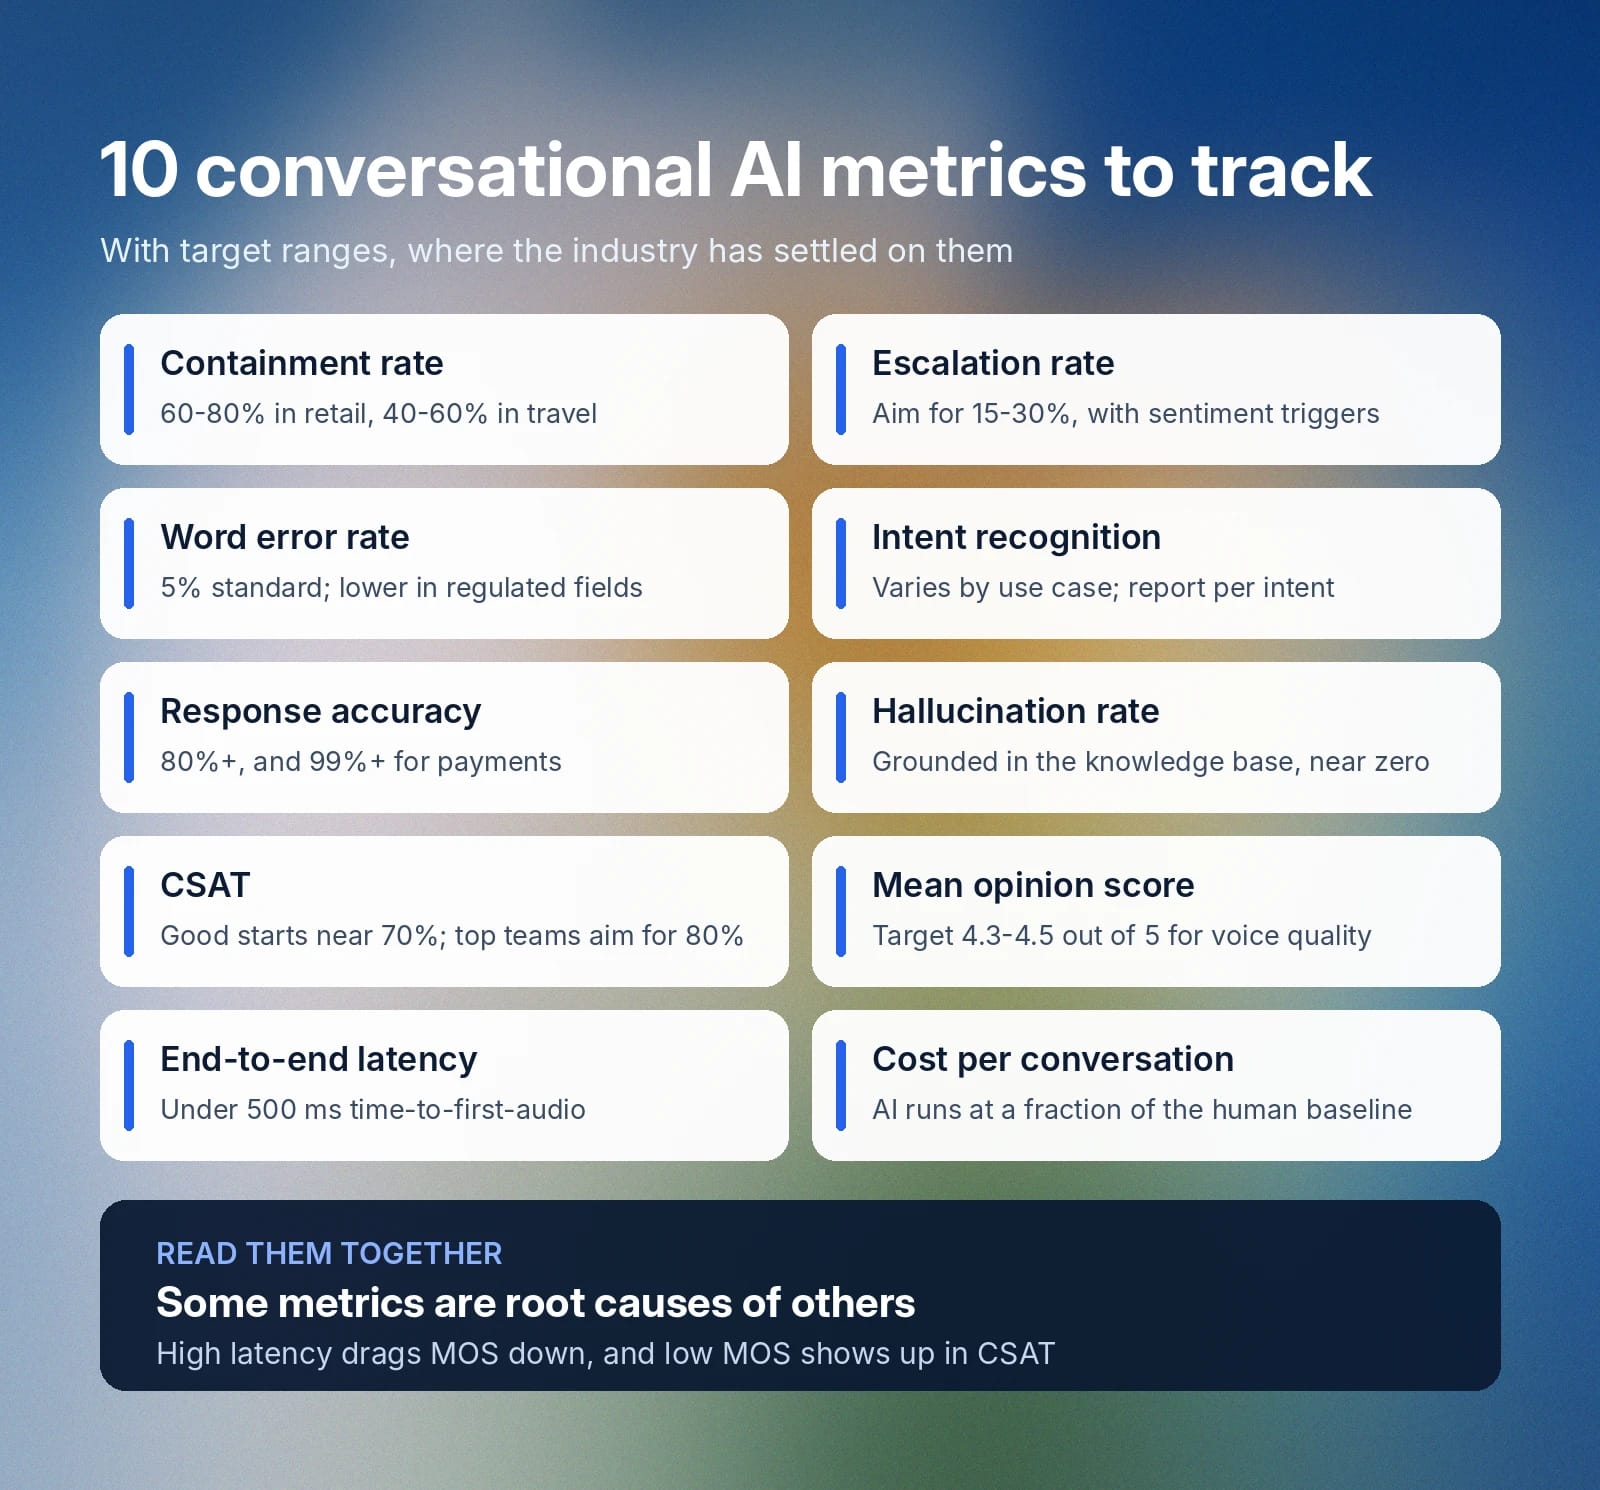
Utiliza estas métricas de IA conversacional como punto de partida al evaluar llamadas de voz y el rendimiento de chatbots:
- Tasa de contención: Haz seguimiento del porcentaje de consultas resueltas por completo dentro del canal automatizado. Los objetivos varían según el sector, el contexto, los casos de uso y el tipo de bot. Por ejemplo, un 60–80 % es bastante habitual en retail, mientras que las cifras se sitúan entre el 40–60 % en sitios de viajes.
- Tasa de escalado: Mide con qué frecuencia los agentes de IA gestionan llamadas sin escalarlas a una persona. Las empresas proactivas establecen umbrales automáticos para transferir llamadas a personas en cuanto el sentimiento se vuelve negativo. Las buenas tasas de escalado varían según el sector y la complejidad de la tarea, pero aspira al 15–30 %.
- Tasa de error de palabras (WER): Haz seguimiento de hasta qué punto la IA «oye» las palabras con precisión durante una llamada o transcripción. Un buen estándar del sector es el 5 %, pero necesitas una WER menor para casos de uso en ámbitos regulados o que manejan información sensible, como sanidad, finanzas y derecho.
- Precisión del reconocimiento de intenciones: Más allá de las palabras, el buen rendimiento de un agente de IA empieza por comprender con precisión el problema del usuario y lo que necesita. Los objetivos de precisión varían según el caso de uso y las categorías de cada intención.
- Precisión de las respuestas: Determina con qué fiabilidad el modelo ofrece respuestas veraces y relevantes. Esto es crucial para garantizar que clientes resuelvan sus problemas. Las consultas generales de atención al cliente requieren un 80 % o más, pero los casos de uso sensibles, como los pagos, requieren un 99 % o más.
- Tasa de alucinaciones: Aunque está estrechamente relacionada con la precisión de las respuestas, la alucinación determina específicamente la exactitud factual de las respuestas basándose en la base de conocimiento. Unas tasas bajas de alucinaciones son cruciales para ser útil y garantizar que los modelos no hagan promesas que la empresa no puede cumplir.
- Satisfacción del cliente (CSAT): Recoge el sentimiento de clientes mediante encuestas posteriores a la llamada para determinar su satisfacción. Las empresas recopilan estos datos en una escala de cinco puntos, pero suelen expresar los resultados en porcentajes. Según SurveyMonkey, las buenas puntuaciones de CSAT suelen empezar en torno al 70 %, y algunas empresas aspiran a un 80 % o más.
- Puntuación media de opinión (MOS): Esta métrica centrada en personas también utiliza una escala de cinco puntos, pero busca medir lo natural que suena la respuesta de la IA y la claridad de la voz sintética. Aspira a una MOS de alrededor de 4,3-4,5.
- Latencia de voz de extremo a extremo: Calcula el retraso total entre el momento en que un usuario completa su solicitud y el inicio de la respuesta del agente. Los agentes listos para producción aspiran a un tiempo de extremo a extremo hasta el primer audio (TTFA) inferior a 500 milisegundos. El modelo ElevenLabs Flash v2.5 logra actualmente una latencia interna de inferencia del modelo de unos 75 ms. La latencia real de extremo a extremo variará según factores como tu ubicación y el tipo de ruta de API que utilices.
- Coste por conversación: Mide el coste operativo total de cada interacción automatizada con clientes en comparación con las sesiones humanas. Las conversaciones de ElevenLabs empiezan en 10 céntimos por minuto, mientras que el salario medio por hora de representantes de atención al cliente indica que las conversaciones humanas cuestan alrededor de 32 céntimos por minuto. Esto supone un ahorro de costes aproximado del 70 %, aunque los precios pueden variar según el plan y el uso. Consulta la página de precios de ElevenLabs para conocer los precios actuales.
Al elegir las métricas que utilizarás para medir el rendimiento de tu modelo, considera las áreas más importantes para tu sector y modelo de negocio. Por ejemplo, la precisión y la exactitud factual son especialmente importantes en ámbitos como la banca y la información de pacientes, mientras que la latencia, la MOS y las tasas de escalado son más importantes para empresas que priorizan la experiencia del cliente.
Ten en cuenta que algunas métricas explican la causa raíz de otras. Por ejemplo, una latencia alta probablemente conlleve una puntuación MOS baja y la consiguiente baja satisfacción del cliente expresada como CSAT.
Cómo medir la precisión de la IA conversacional
Mide la precisión del modelo creando un conjunto de pruebas con datos reales a partir de entre 500 y 1000 conversaciones históricas reales. Los registros reales reflejan las expresiones naturales e imperfectas que los datos sintéticos a menudo no incluyen, como erratas, jerga y errores de usuarios. A continuación, evalúa tu sistema con estos registros reales en reconocimiento de intenciones, precisión de las respuestas y tasa de alucinaciones.
Realiza evaluaciones automatizadas de estas interacciones utilizando un método de puntuación de LLM como juez. Sin embargo, valida siempre las puntuaciones automatizadas con sistemas etiquetados por personas para asegurarte de que coinciden. Después, revisores humanos realizan comprobaciones puntuales semanales para evaluar el rendimiento del chatbot mediante una sencilla rúbrica de tres puntos:
- Correcta: La respuesta es factual, relevante para el contexto y satisface directamente la intención principal del usuario.
- Aceptable: La respuesta es técnicamente correcta y útil, pero presenta algunos problemas menores de estilo, frases poco naturales o un formato que no encaja con la marca.
- Incorrecta: La respuesta requiere una corrección inmediata porque contiene errores factuales, alucinaciones graves o malinterpreta por completo la intención del usuario.
Lo ideal es utilizar un método por intención para evaluar el modelo, ya que los agentes de IA funcionan bien en algunos contextos y fallan estrepitosamente en otros. Usar cifras agregadas hace que las áreas de alto rendimiento oculten puntos débiles críticos.
Hemos simplificado este workflow integrando las pruebas de Next Reply (escenario) directamente en las pruebas de ElevenAgents. La función Next Reply evalúa el mensaje de seguimiento que envía un agente en lugar de toda la conversación de varios turnos. Sin embargo, proporcionas el historial de chat previo al punto de evaluación y puntúas la respuesta según los estándares de política, tono y calidad.
Cómo realizar pruebas A/B de respuestas de IA conversacional
Las pruebas A/B recopilan feedback del mundo real para evitar adivinar qué prefieren clientes. Después utilizas estos datos empíricos para ajustar el rendimiento del modelo de IA. Tras hacer seguimiento de las métricas, es probable que tu equipo tenga una lista de cambios que quiere hacer o experimentos que quiere realizar. Sin embargo, cambiar varias cosas a la vez dificulta saber qué ha funcionado y qué no.
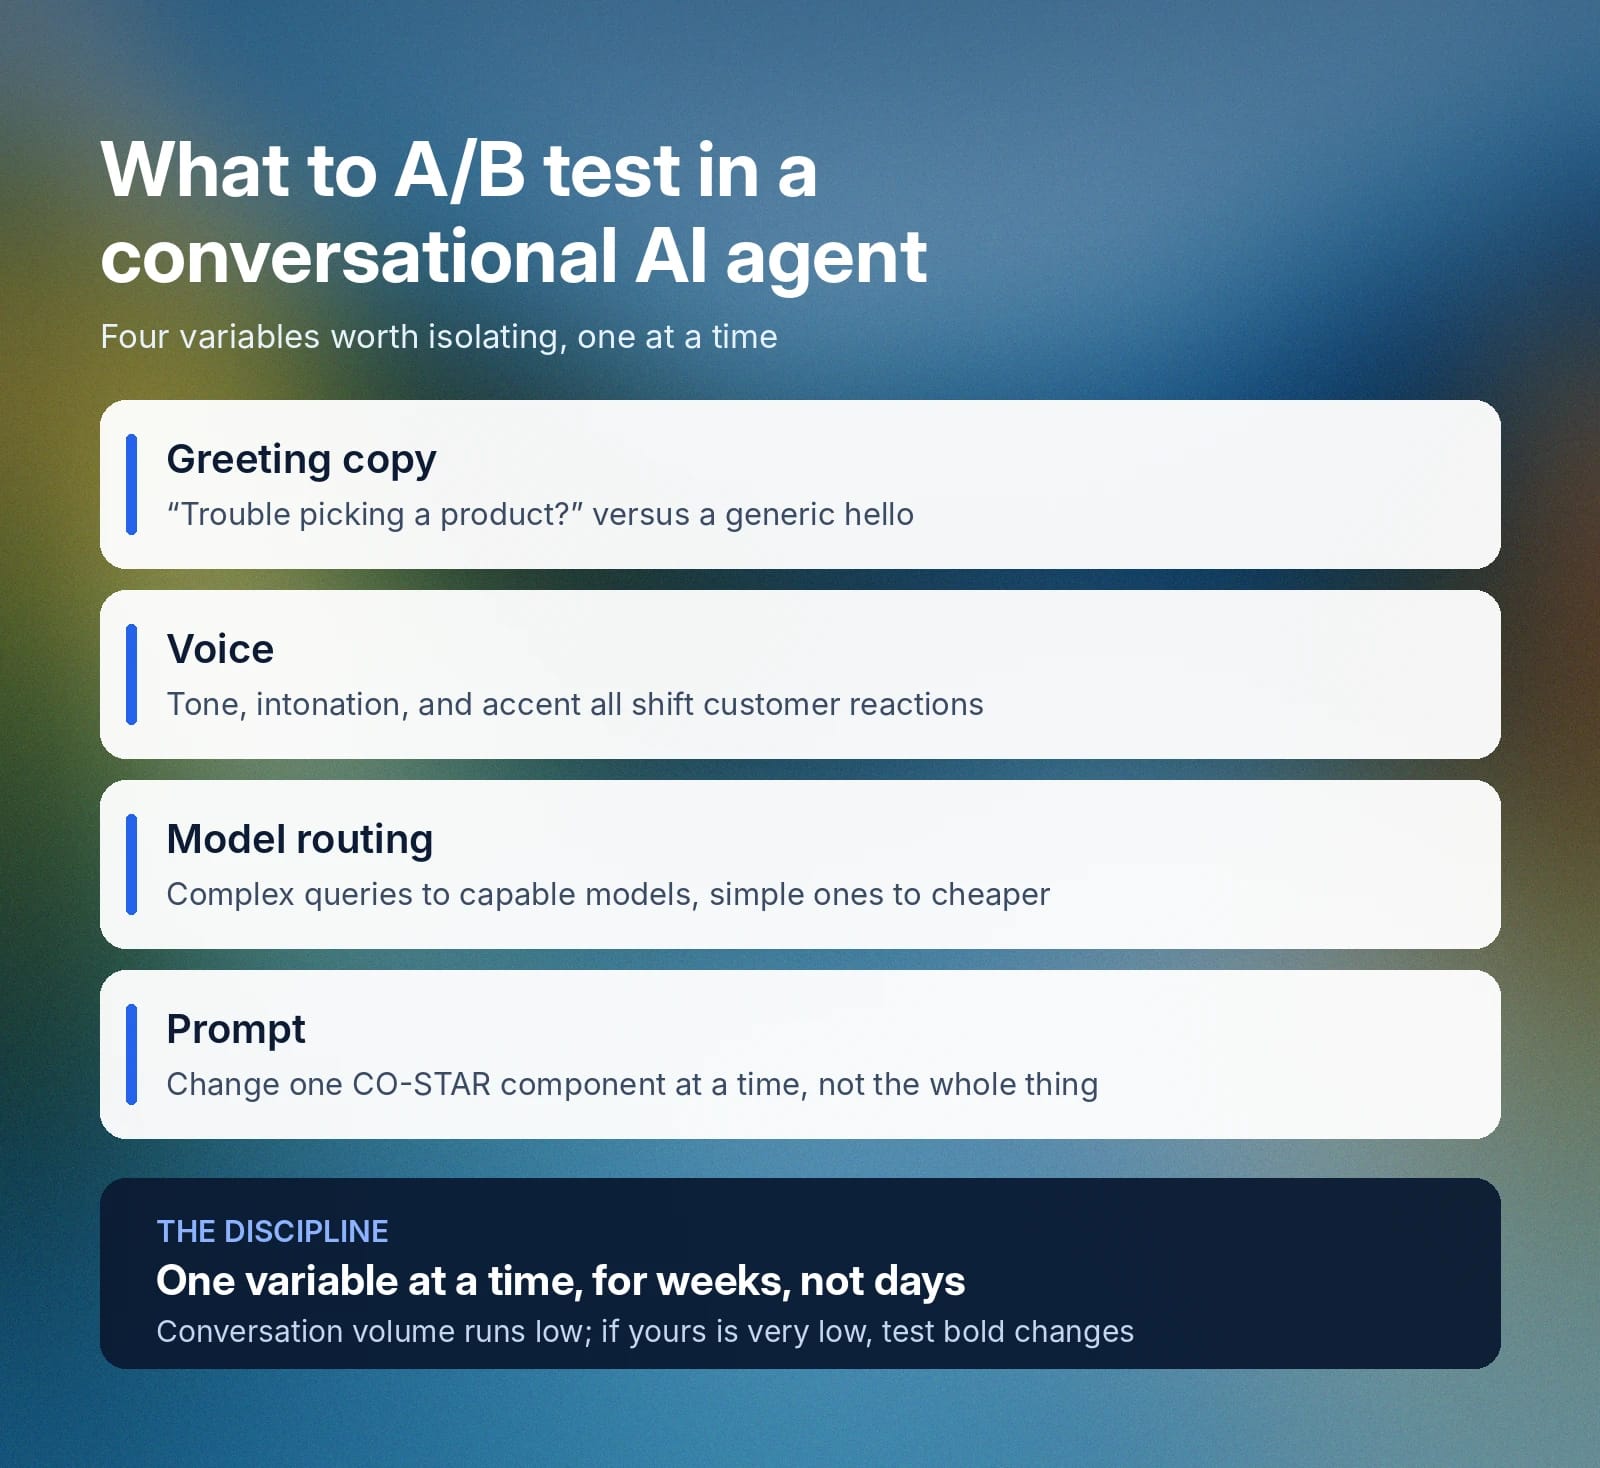
Por tanto, realizar una prueba válida exige aislar una variable concreta cada vez y mantener constante el resto de la base de conocimiento subyacente. Algunos elementos que puedes variar son:
- Texto del saludo: Ajustar el mensaje de saludo inicial a algo específico, como «Hola. ¿Tienes problemas para elegir un producto?», en lugar de limitarte a decir: «Hola, ¿en qué puedo ayudarte?».
- Voz: Clientes pueden reaccionar más favorablemente a unas voces que a otras en circunstancias concretas según la masculinidad o feminidad, el tono, la entonación e incluso el acento.
- Enrutamiento de modelos: Los modelos con mayor capacidad suelen costar más, por lo que la opción eficiente y rentable consiste en enrutar las consultas complejas y sencillas según corresponda.
- Prompt: Los prompts tienen varios componentes, así que cambia solo un aspecto cada vez, como el contexto, el objetivo, el estilo, el tono, la audiencia o la plantilla de respuesta (CO-STAR).
Los equipos también deben ajustar el plazo de las pruebas. El tráfico conversacional suele ser mucho menor que las visualizaciones de páginas web, así que tendrás que realizar la prueba durante semanas en lugar de días para lograr significación estadística. Si tienes un volumen extremadamente bajo, prueba cambios grandes y audaces en vez de pequeños ajustes.
Un workflow práctico también requiere control de versiones de agentes, herramientas de comparación y reversión. Hemos integrado todo ello directamente en ElevenAgents.
Cómo probar un agente de IA conversacional antes del despliegue
La atención al cliente es un punto de contacto directo con las personas que afectan a tus resultados, y la IA a veces reacciona de maneras impredecibles ante pequeños cambios. Por tanto, prueba siempre un agente de IA conversacional nuevo o revisado antes de lanzarlo a producción. Limitarse a «probar sensaciones» no es suficiente.
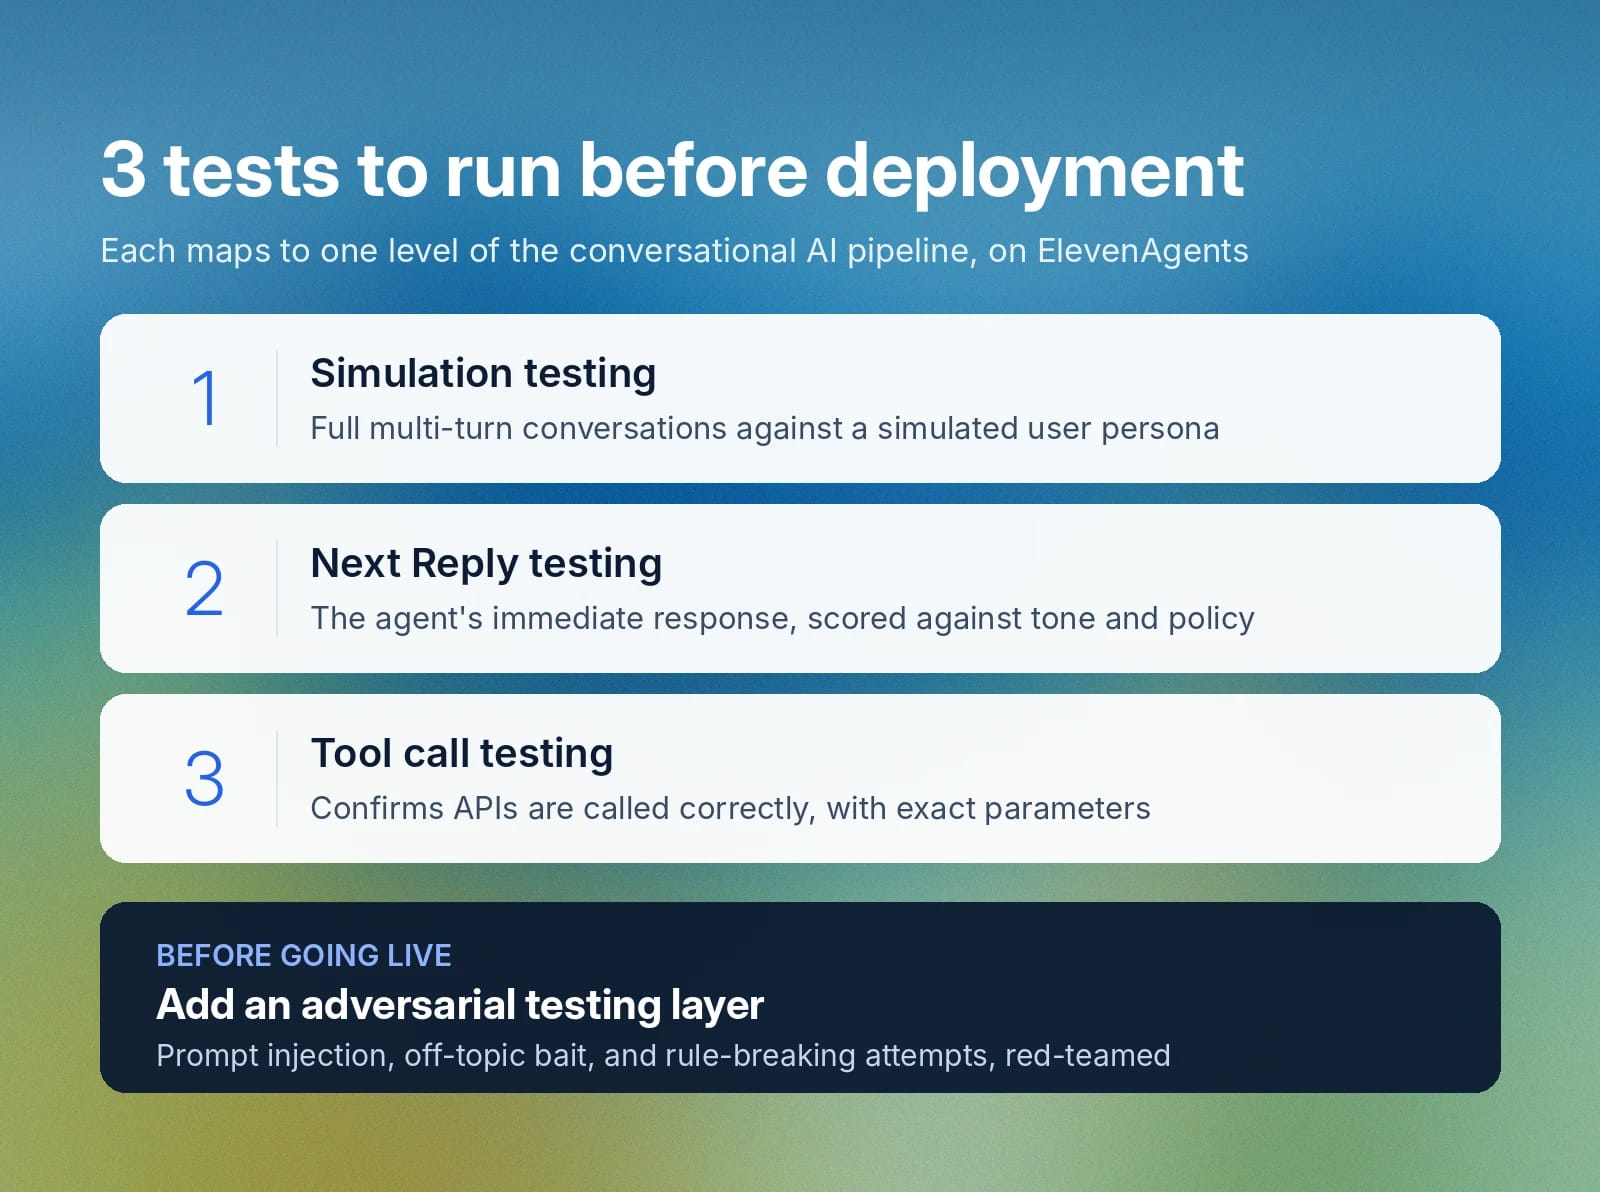
Hemos diseñado nuestro marco de pruebas de ElevenAgents en torno a tres tipos principales de pruebas orientados a niveles concretos de tu pipeline de IA conversacional:
- Pruebas de simulación: Ejecutan una conversación de varios turnos con un usuario simulado para confirmar si el diálogo alcanza los niveles de rendimiento deseados.
- Pruebas de Next Reply: Prueban solo las respuestas inmediatas del agente respecto a restricciones específicas de tono, políticas u otros criterios para confirmar que las respuestas son adecuadas y precisas.
- Pruebas de llamadas a herramientas: Garantizan que los agentes llamen correctamente a las API conectadas y pasen los parámetros exactos necesarios para consultas o transferencias de alto riesgo en bases de datos.
Con tantos atacantes intentando vulnerar los modelos con fines maliciosos, también necesitarás una capa de pruebas adversariales antes de salir a producción. Trabaja con equipos de QA, ingenieros de prompts y profesionales de ciberseguridad de red team para probar inyecciones de prompts, señuelos fuera de tema e intentos de incumplir las reglas.
Por último, utiliza un lanzamiento gradual mediante versiones piloto para un grupo reducido de usuarios y supervisa su comportamiento en el mundo real. Establece criterios estrictos que el modelo debe superar antes de lanzarlo a un grupo mayor o a toda tu base de clientes. Recuerda asignar a una única persona responsable para supervisar el lanzamiento y crear una vía de reversión por si un ajuste provoca una caída en las métricas de rendimiento.
Evaluar el rendimiento de un chatbot en producción
Antes de lanzar tu modelo de IA conversacional, define qué significa el éxito para cada caso de uso. Esto es especialmente importante para aplicaciones en ámbitos altamente regulados, donde la precisión y la privacidad de los datos tienen estándares más altos y requisitos más estrictos.
Las respuestas automatizadas facilitan realizar pruebas A/B de modelos a gran escala, pero las pruebas objetivas requieren combinarlas con la lectura puntual de transcripciones y el feedback de evaluadores humanos. Las personas en el circuito detectan matices conversacionales que los modelos de IA pasan por alto y particularidades de los datos que, de otro modo, se pierden en las cifras agregadas. Una estrategia de evaluación exhaustiva también incluye análisis de sentimiento y feedback directo de usuarios.
La mejora continua diferencia aún más a los sistemas maduros que ofrecen un alto retorno de la inversión. Mientras los competidores tratan las pruebas y la supervisión como tareas separadas, un pipeline maduro las combina en una sola. En este caso, los fallos en producción alimentan directamente tu conjunto de pruebas para entrenar al siguiente agente optimizado.
También es necesario realizar ajustes periódicos cuando las empresas de IA actualizan los modelos base sobre los que funciona tu agente. Este cambio suele hacer que un prompt antes eficaz contribuya de repente a respuestas poco fiables o incluso inapropiadas.
Hemos integrado este ciclo de feedback directamente en nuestra plataforma. Utiliza nuestras herramientas de análisis de conversaciones para automatizar la recopilación de datos estructurados y evaluar fácilmente el sentimiento. Las grandes organizaciones también utilizan nuestra infraestructura empresarial de IA conversacional para supervisar y escalar con confianza sus agentes en todo el mundo.
Empieza a usar ElevenAgents para las métricas de atención al cliente
Lanzar con éxito IA conversacional a gran escala requiere más que voces de alta calidad y modelos de baja latencia. Necesitas un ecosistema integrado para diseñar, crear, probar, desplegar y ajustar workflows multiagente.
ElevenAgents te ofrece la infraestructura escalable que necesitas. Tu equipo tiene acceso a herramientas como la verificación de Next Reply, el seguimiento de sentimiento y la recopilación automática de datos para supervisar y optimizar continuamente los modelos y obtener los mejores resultados. Y aún mejor: detectas regresiones antes de que lleguen a clientes.
¿Quieres simplificar el proceso de medir la IA conversacional? Explora nuestras funciones de pruebas de agentes y descubre cómo nuestros equipos empresariales despliegan agentes fiables que mejoran tus métricas de atención al cliente.
Más información sobre ElevenAgents o regístrate para empezar hoy.
Preguntas frecuentes sobre cómo medir la IA conversacional

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.



