Infrastruktura głosowa AI: architektura 2026 wyjaśniona
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Infrastruktura głosowa AI to zestaw modeli, połączeń, narzędzi i usług, dzięki którym agent AI może słuchać rozmowy, zdecydować, co zrobić, wykonywać działania w innych systemach i odpowiadać głosem. U czołowych dostawców, takich jak ElevenLabs, wszystko dzieje się w ułamku sekundy.
Produkcyjny agent głosowy działa na stosie warstw obejmujących rozpoznawanie mowy, zarządzanie turami rozmowy, duży model językowy, orkiestrację, narzędzia, pobieranie wiedzy, syntezę mowy, telefonię i monitoring.
Ten przewodnik wyjaśnia architekturę agenta AI stojącą za działającym agentem głosowym. Każda sekcja opisuje działanie warstwy, jej znaczenie w szerszej infrastrukturze i sposób jej wdrożenia w ElevenAgents, z Eleven v4 jako przykładem warstwy głosowej.
Jak łączą się elementy infrastruktury głosowej AI
Agent głosowy zamienia audio na tekst, analizuje te dane, generuje odpowiedź, a następnie zamienia ją z powrotem na audio słyszane przez klienta. Ten ciąg działań tworzy solidny stos architektury agenta AI.
Oto główne warstwy infrastruktury głosowej AI w 2026 roku:
- Rozpoznawanie mowy: Technologia Automatic Speech Recognition (ASR) zamienia audio rozmówcy na tekst do przetworzenia.
- Zarządzanie turami rozmowy: Turn taking określa, kiedy rozmówca skończył mówić i kiedy agent ma przestać mówić, co zapewnia płynniejszą, bardziej responsywną rozmowę.
- Model(e) językowe: Interpretują transkrybowane żądanie i generują odpowiedź po pobraniu potrzebnego kontekstu.
- Orkiestracja: Warstwa orkiestracji AI kieruje rozmowę między promptami, subagentami, narzędziami i ludźmi.
- Narzędzia i MCP: Łączą agenta z zewnętrznymi systemami, takimi jak platformy CRM czy centra kontaktowe, aby wykonywać zadania.
- Wiedza i pamięć: Dostarczają fakty i kontekst rozmówcy przez Retrieval Augmented Generation.
- Synteza mowy: Używa Text to Speech, by zamienić tekstową odpowiedź na audio.
- Transport i telefonia: Przesyłają audio między agentem a rozmówcą.
- Guardraile, testowanie i monitoring: Utrzymują agenta na właściwym torze i umożliwiają pomiar jego działania.
Razem te komponenty tworzą rozmowy w czasie rzeczywistym między agentami AI a dzwoniącymi klientami.
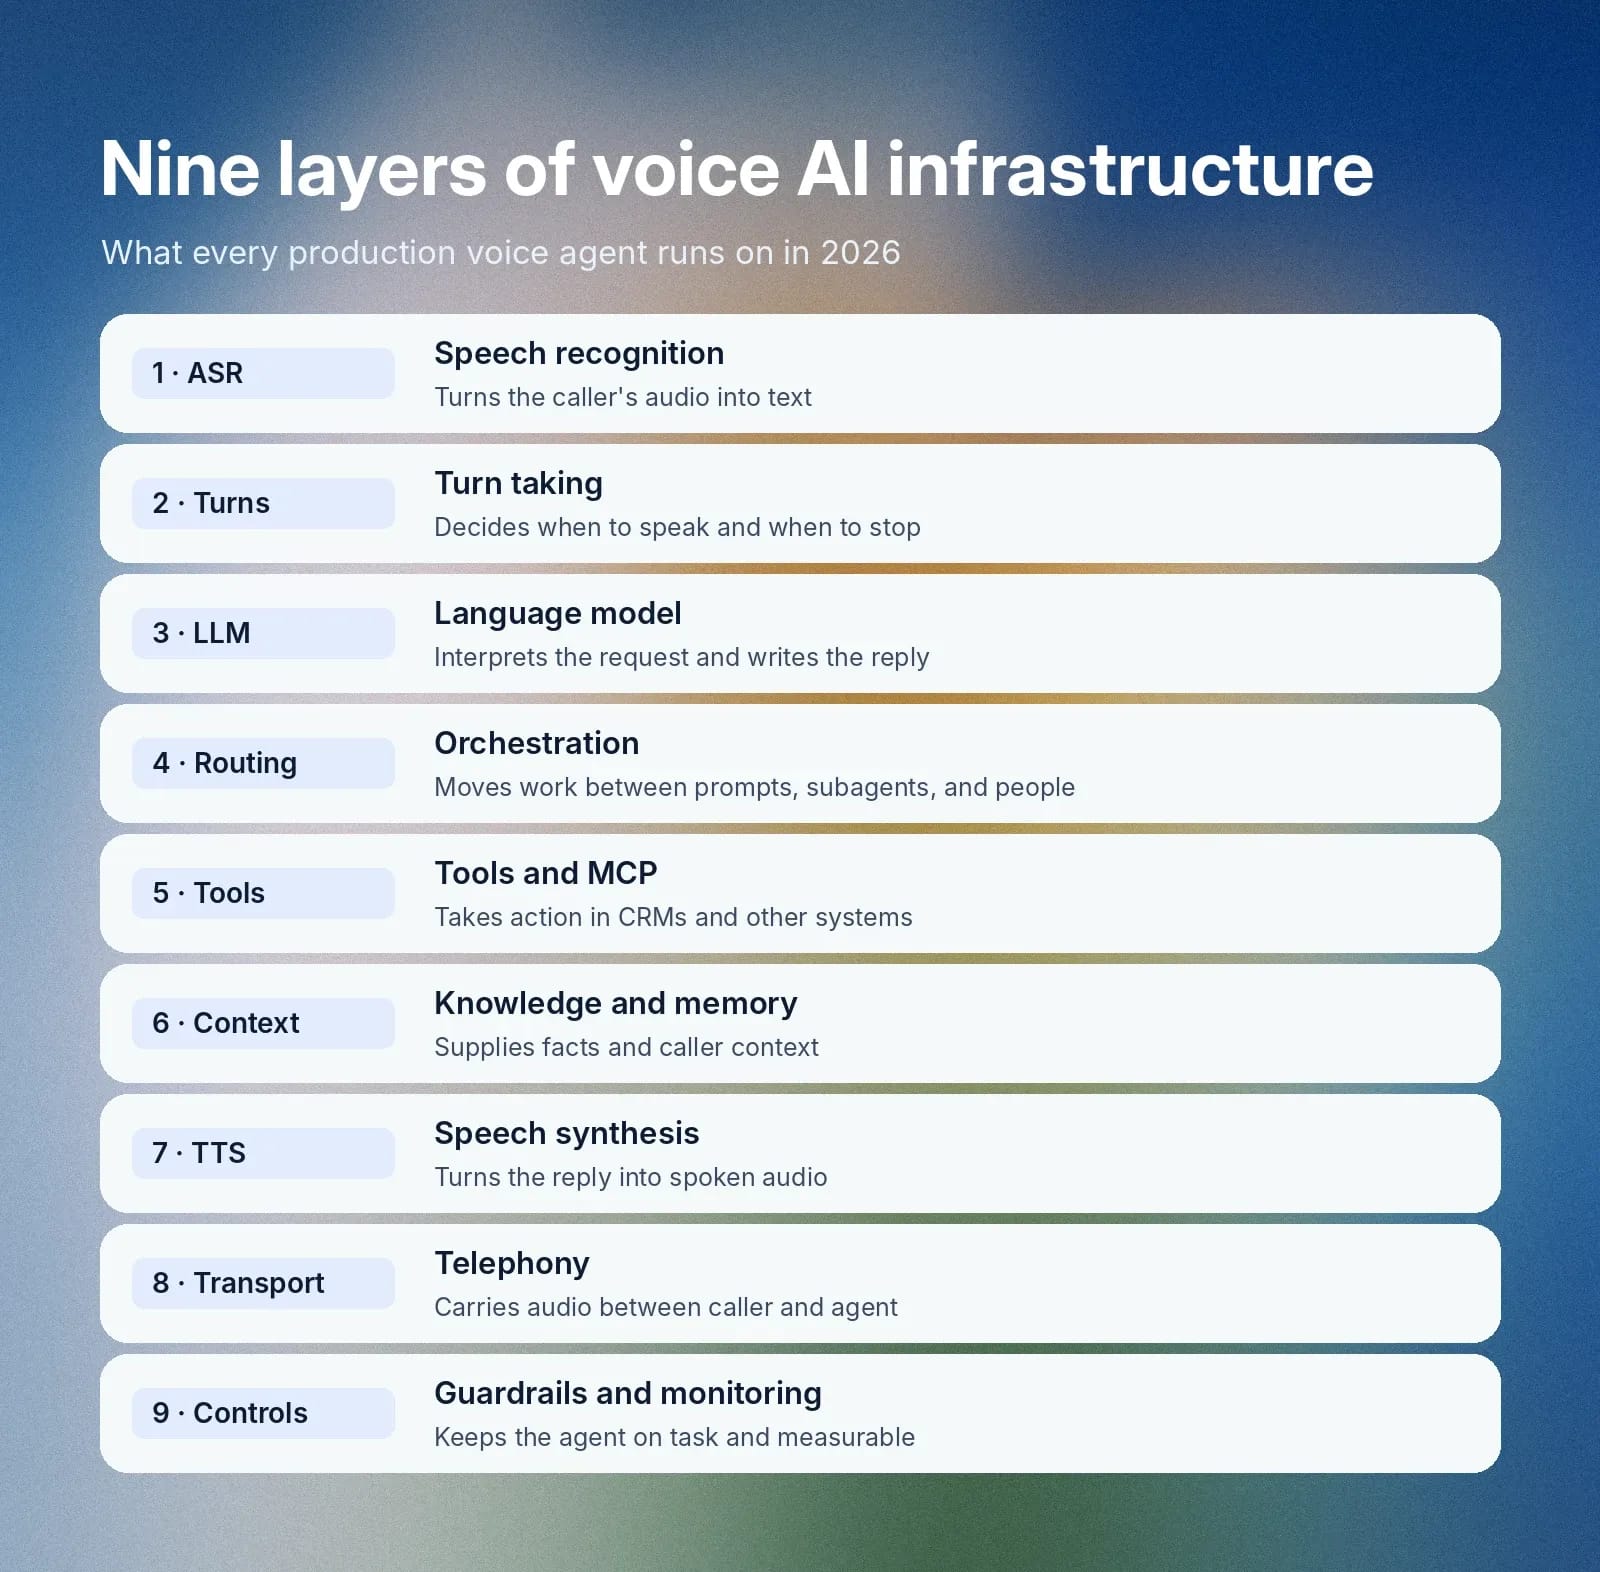
Diagram architektury głosowej AI
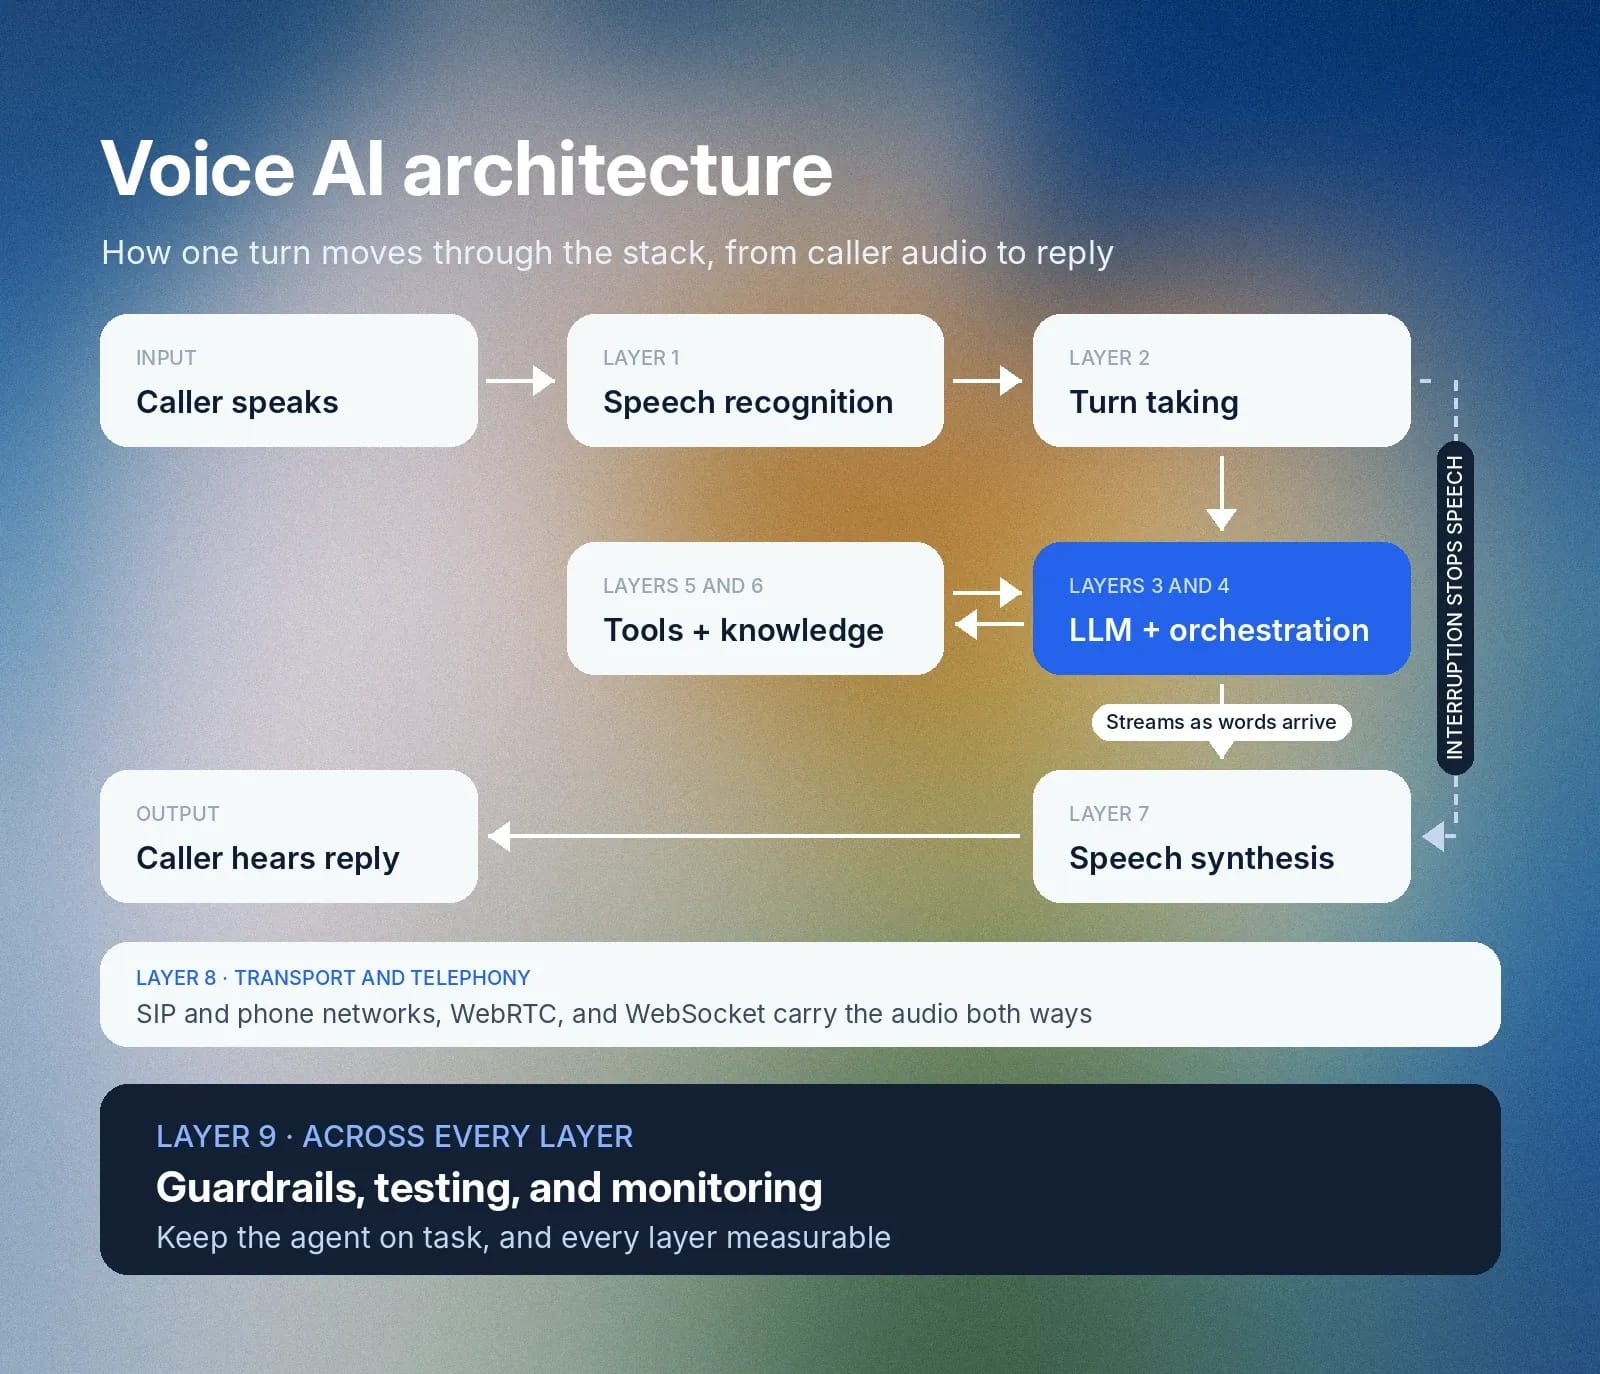
Przepływ nie jest liniowy. ElevenAgents zaczyna mówić po otrzymaniu od modelu językowego „wystarczającej liczby słów i przecinka”, więc audio zaczyna się odtwarzać, zanim powstanie cała odpowiedź. Wywołania narzędzi i pobieranie wiedzy odbywają się w trakcie tury. Przerwania mogą nadejść w każdej chwili, a agent obsługuje je naturalnie podczas generowania mowy.
Dwa sposoby budowania architektury głosowej AI
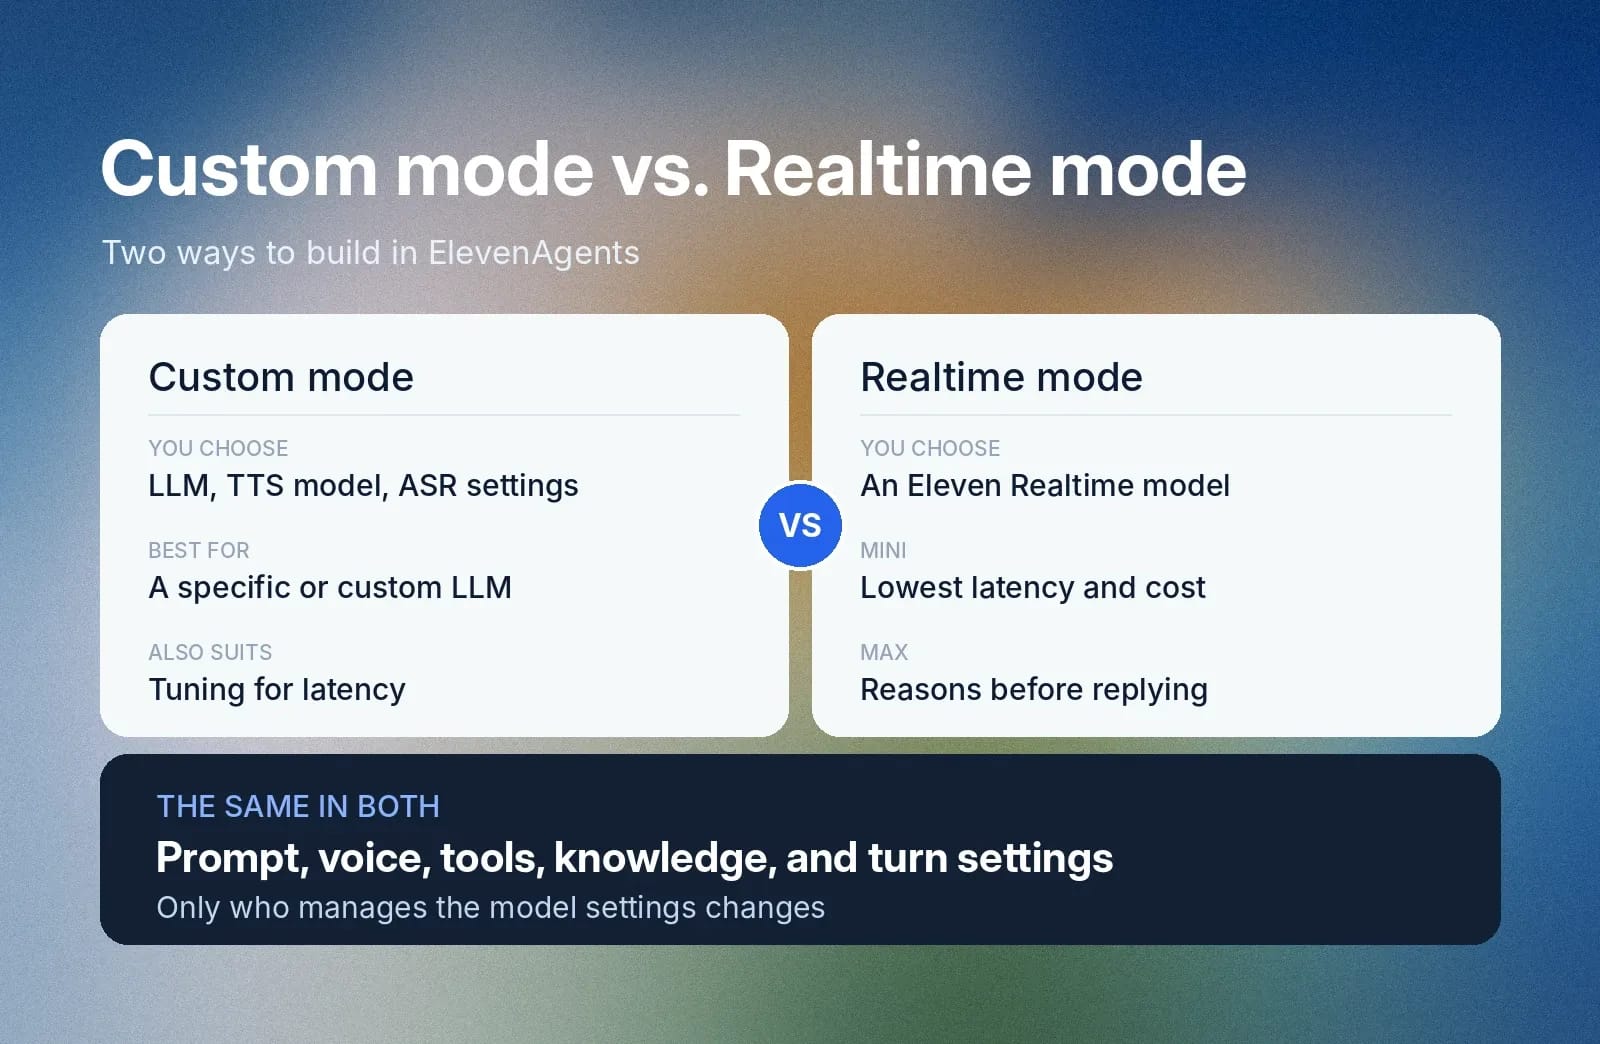
ElevenAgents obsługuje dwa tryby głosowe. W trybie Custom sam wybierasz model językowy, model Text to Speech i ustawienia rozpoznawania mowy.
W trybie Realtime wybierasz model Eleven Realtime, a ElevenLabs zarządza tymi ustawieniami za ciebie. Eleven Realtime v1 Mini to model domyślny o najniższym opóźnieniu i koszcie. Eleven Realtime v1 Max analizuje problem przed odpowiedzią, więc sprawdza się przy bardziej złożonych instrukcjach i zadaniach wymagających wieloetapowego użycia narzędzi.
Prompt systemowy, wybrany głos, narzędzia, dołączona baza wiedzy i ustawienia tur działają tak samo w obu trybach. Tryb Custom jest lepszy, gdy potrzebujesz konkretnego modelu językowego, własnego LLM lub określonego modelu TTS (ze względu na wydajność albo optymalizację opóźnień.)
Rozpoznawanie mowy: zamiana audio na tekst
Rozpoznawanie mowy, zwane też ASR lub speech to text, to pierwsza warstwa stosu.
Co robi
Model stale transkrybuje audio rozmówcy w trakcie mówienia. Dzięki temu reszta procesu może zacząć działać przed końcem zdania, co zmniejsza opóźnienie. Zaawansowane modele radzą sobie z silnymi akcentami, różnym tempem mówienia i hałasem w tle.
Dlaczego ma znaczenie dla infrastruktury głosowej AI
Transkrypcja jest prawdopodobnie jedną z najważniejszych warstw stosu, ponieważ błędy na tym etapie przenikają do kolejnych. Źle usłyszany numer rezerwacji? Działanie na niewłaściwym koncie klienta. Błędna nazwa leku? Potencjalna katastrofa.
W Trust Framework for Healthcare ElevenLabs pokazuje, jak wiele może zależeć od jednej źle usłyszanej sylaby: hydroksyzyna kontra hydralazyna.
Jak robi to ElevenAgents
ElevenAgents używa Scribe v2 Realtime, który transkrybuje mowę w około 150 ms. ElevenLabs wytrenowało go pod kątem hałasu, różnorodnych akcentów i identyfikatorów, takich jak imiona, e-maile i identyfikatory. W wielojęzycznym benchmarku FLEURS dla 30 języków ElevenLabs zgłosiło najniższy współczynnik błędów słownych spośród wszystkich niskolatencyjnych modeli ASR.
Włączysz go w sekcji Advanced konfiguracji agenta. W tym samym wspomnianym wcześniej whitepaperze ElevenLabs podaje, że Scribe v2 Medical przewyższa wszystkie modele w publicznym benchmarku Eka Medical ASR, osiągając 7,0% współczynnika błędów słownych na dzień publikacji.
Dokładna i szybka transkrypcja daje kolejnym warstwom czyste dane wejściowe bez istotnego zwiększania opóźnienia.
Zarządzanie turami rozmowy: kiedy mówić, a kiedy przestać
Zarządzanie turami rozmowy to zestaw zasad określających, kiedy agent odpowiada, a kiedy słucha. Umiejętność skutecznego rozumienia tur w rozmowie i reagowania na nie odróżnia rozmowę od tradycyjnego menu telefonicznego IVR.
Co robi
Komponent zarządzania turami rozmowy zapewnia infrastrukturze głosowej AI kilka funkcji:
- Wykrywanie aktywności głosowej (VAD): VAD klasyfikuje przychodzące audio jako mowę lub ciszę, kilkadziesiąt razy na sekundę.
- Wykrywanie końca tury: Ocena, czy rozmówca skończył, na podstawie tonu, rytmu i kontekstu słów.
- Barge-in: Pozwala rozmówcy przerwać agentowi, który wtedy przestaje mówić, aby użytkownik mógł kontynuować.
- Sygnały podtrzymujące: Krótkie potwierdzenia, np. „tak”, które nie przejmują tury.
Dlaczego ma znaczenie
W ludzkiej rozmowie typowa przerwa między mówcami wynosi około 200 ms. Agent, który odpowiada za wcześnie, przerywa rozmówcom, a taki, który czeka zbyt długo, tworzy ciszę sprawiającą wrażenie zerwanego lub niereagującego połączenia.
Weźmy rozmówcę, który mówi: „Chcę zarezerwować piątkowe popołudnie, ale...” i robi pauzę. Timer ciszy odpowie podczas pauzy i pominie doprecyzowanie. Model, który analizuje słowa i rytm, poczeka, aż użytkownik dokończy: „Nie może to być między 15:00 a 17:00, bo będę zajęty.”
Jeden agent błędnie interpretuje intencję rozmówcy i planuje spotkanie o złej porze. Drugi, dzięki skutecznemu zarządzaniu turami, unika wskazanego przedziału czasu.
Jak robi to ElevenAgents
ElevenAgents używa własnego modelu zarządzania turami, który analizuje ton, rytm i kontekst słów, zamiast polegać wyłącznie na timerach ciszy. Gdy rozmówca przerwie, sygnał zatrzymujący agenta dociera w mniej niż 200 ms.
ElevenLabs mierzy medianę około 150 ms od żądania do słyszalnej mowy w Eleven v4 Turbo w ElevenAgents.
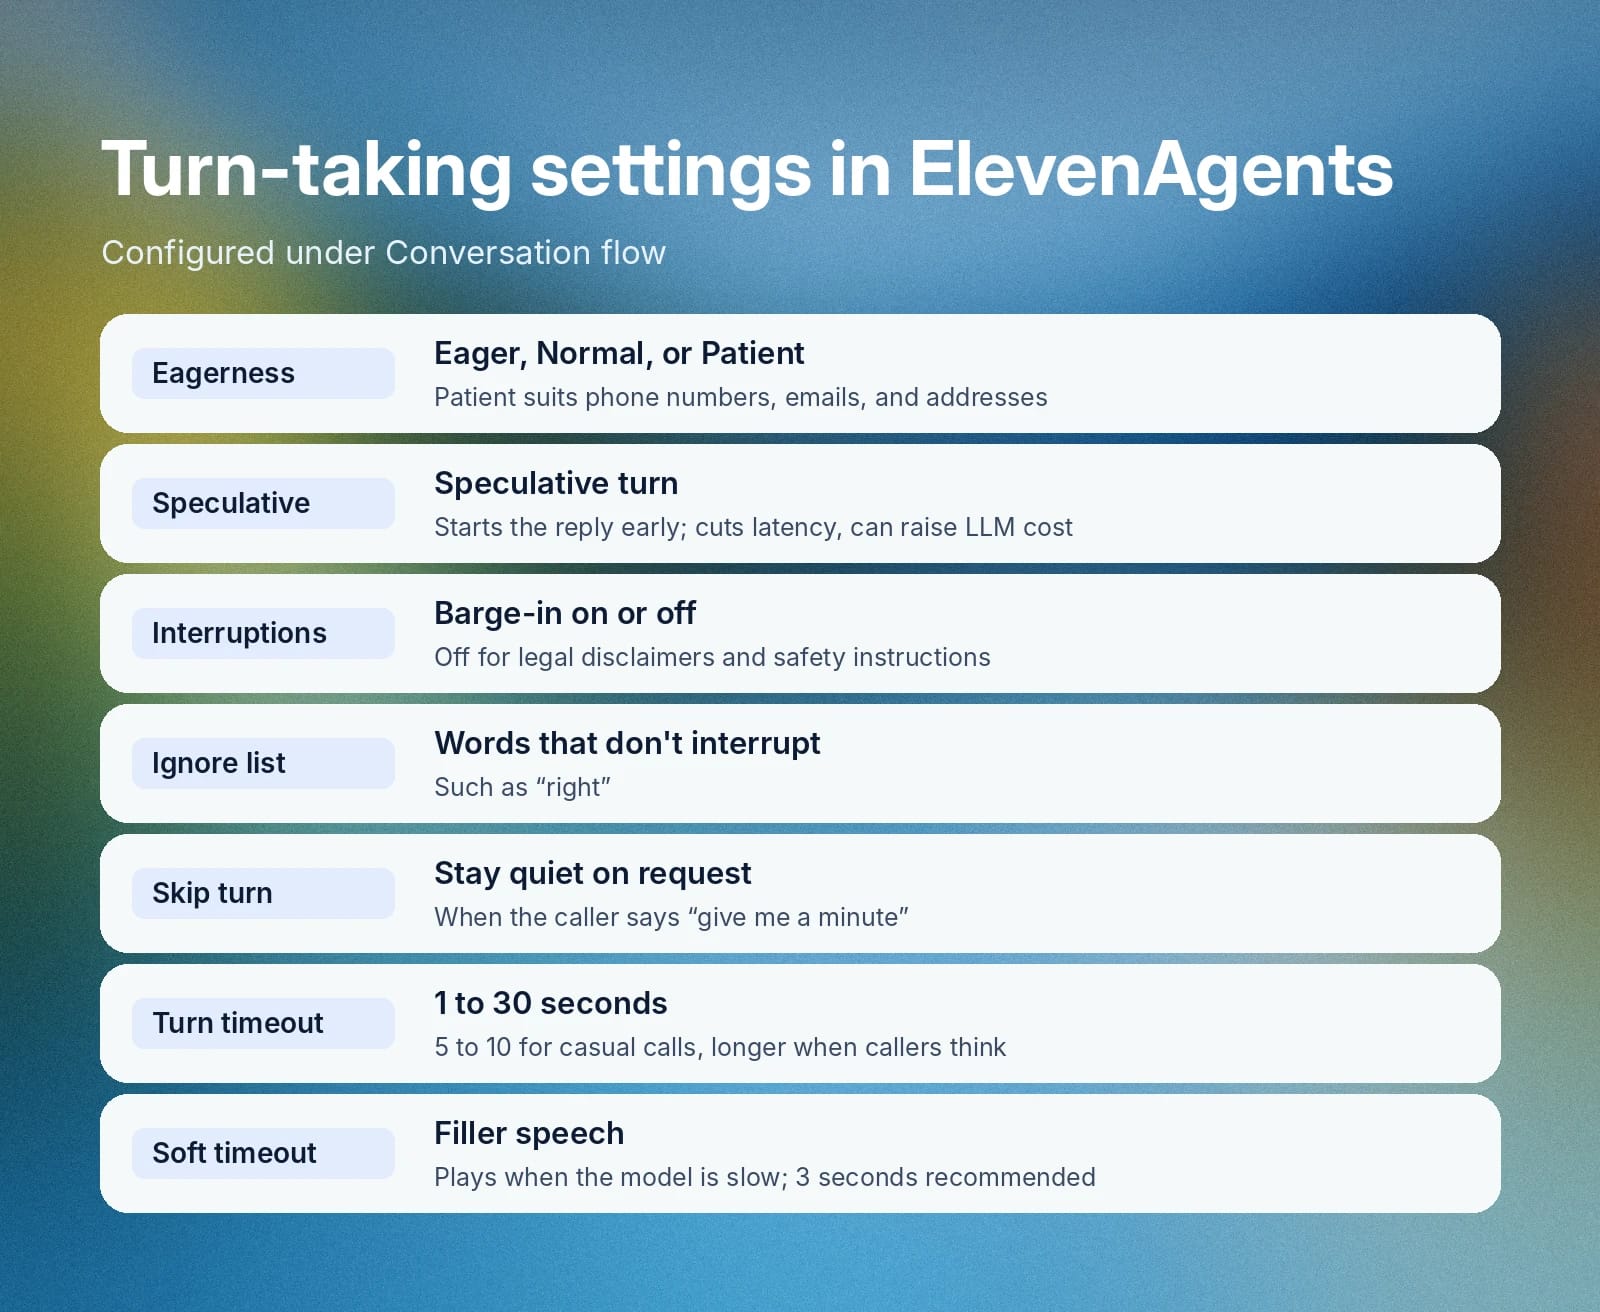
To zachowanie można konfigurować w Conversation flow:
Ustawienie
Co kontroluje
Gotowość do przejęcia tury
Eager odpowiada przy pierwszej okazji. Normal to zrównoważona opcja domyślna. Patient czeka dłużej i sprawdza się przy numerach telefonów, adresach i e-mailach.
Spekulatywna tura
Uruchamia odpowiedź modelu językowego, zanim zostanie potwierdzone, że rozmówca skończył. Skraca opóźnienie, ale może zwiększyć koszt LLM.
Przerwania
Wyłącz je, gdy trzeba usłyszeć każde słowo, np. w zastrzeżeniach prawnych i instrukcjach bezpieczeństwa.
Lista ignorowanych słów
Słowa takie jak „dobrze”, które nie powinny przerywać agentowi.
Narzędzie pomijania tury
Utrzymuje agenta w ciszy, gdy rozmówca mówi: „daj mi chwilę”.
Limit czasu tury
Przejmuje turę po 1–30 sekundach ciszy. Użyj 5–10 sekund dla luźnych rozmów i 10–30 sekund, gdy rozmówcy potrzebują czasu do namysłu.
Miękki limit czasu
Odtwarza wypełniacz, np. „Hhmmmm... tak.”, gdy model działa wolno. Zakres wynosi 0,5–8 sekund, zalecane są 3 sekundy.
Wykrywanie hałaśliwego otoczenia
Ustawienie Enterprise, które wykrywa głosy w tle i prosi rozmówcę o przejście w cichsze miejsce, najwyżej raz na rozmowę.
Workflow może zmienić gotowość do przejęcia tury w trakcie rozmowy. Twój klient otrzymuje też zdarzenie vad_score — prawdopodobieństwo od 0 do 1, że użytkownik mówi.
Dobrze dostrojone zarządzanie turami decyduje, czy rozmówcy odbierają agenta jako uważnego, czy gwałtownego. Więcej informacji znajdziesz w naszym pełnym przewodniku po zarządzaniu turami rozmowy.
Model językowy: rozumowanie i generowanie odpowiedzi
Duży model językowy (LLM) to warstwa rozumowania. Czyta transkrypcję, instrukcje i dotychczasową rozmowę, a potem tworzy odpowiedź lub decyduje o wywołaniu narzędzia.
Co robi
Skryptowy bot głosowy rozpoznaje kilka poleceń. LLM interpretuje prośby sformułowane na wiele sposobów, zachowuje kontekst między turami i decyduje, kiedy pobrać informacje lub przekazać sprawę dalej.
Dlaczego ma znaczenie
Modele różnią się głębokością rozumowania, szybkością i kosztem. W rozmowie głosowej na żywo czas odpowiedzi jest równie ważny jak jej jakość, więc wybór modelu to decyzja o opóźnieniu i kosztach.
Jak robi to ElevenAgents
ElevenAgents zapewnia jeden interfejs do modeli Google, OpenAI i Anthropic oraz otwartych modeli hostowanych przez ElevenLabs. Możesz też podłączyć własny LLM, określając endpoint i zapisując dane uwierzytelniające jako sekrety. ElevenLabs rozlicza koszty zewnętrznych LLM według stawek opublikowanych przez dostawcę, bez marży.
Model możesz wybrać dla każdego subagenta. The Enterprise Conversational Agent Playbook, tom 2, zaleca rezerwowanie modeli o wyższej wydajności do złożonego rozumowania oraz używanie tańszych, niskolatencyjnych modeli do zadań takich jak klasyfikacja intencji i FAQ.
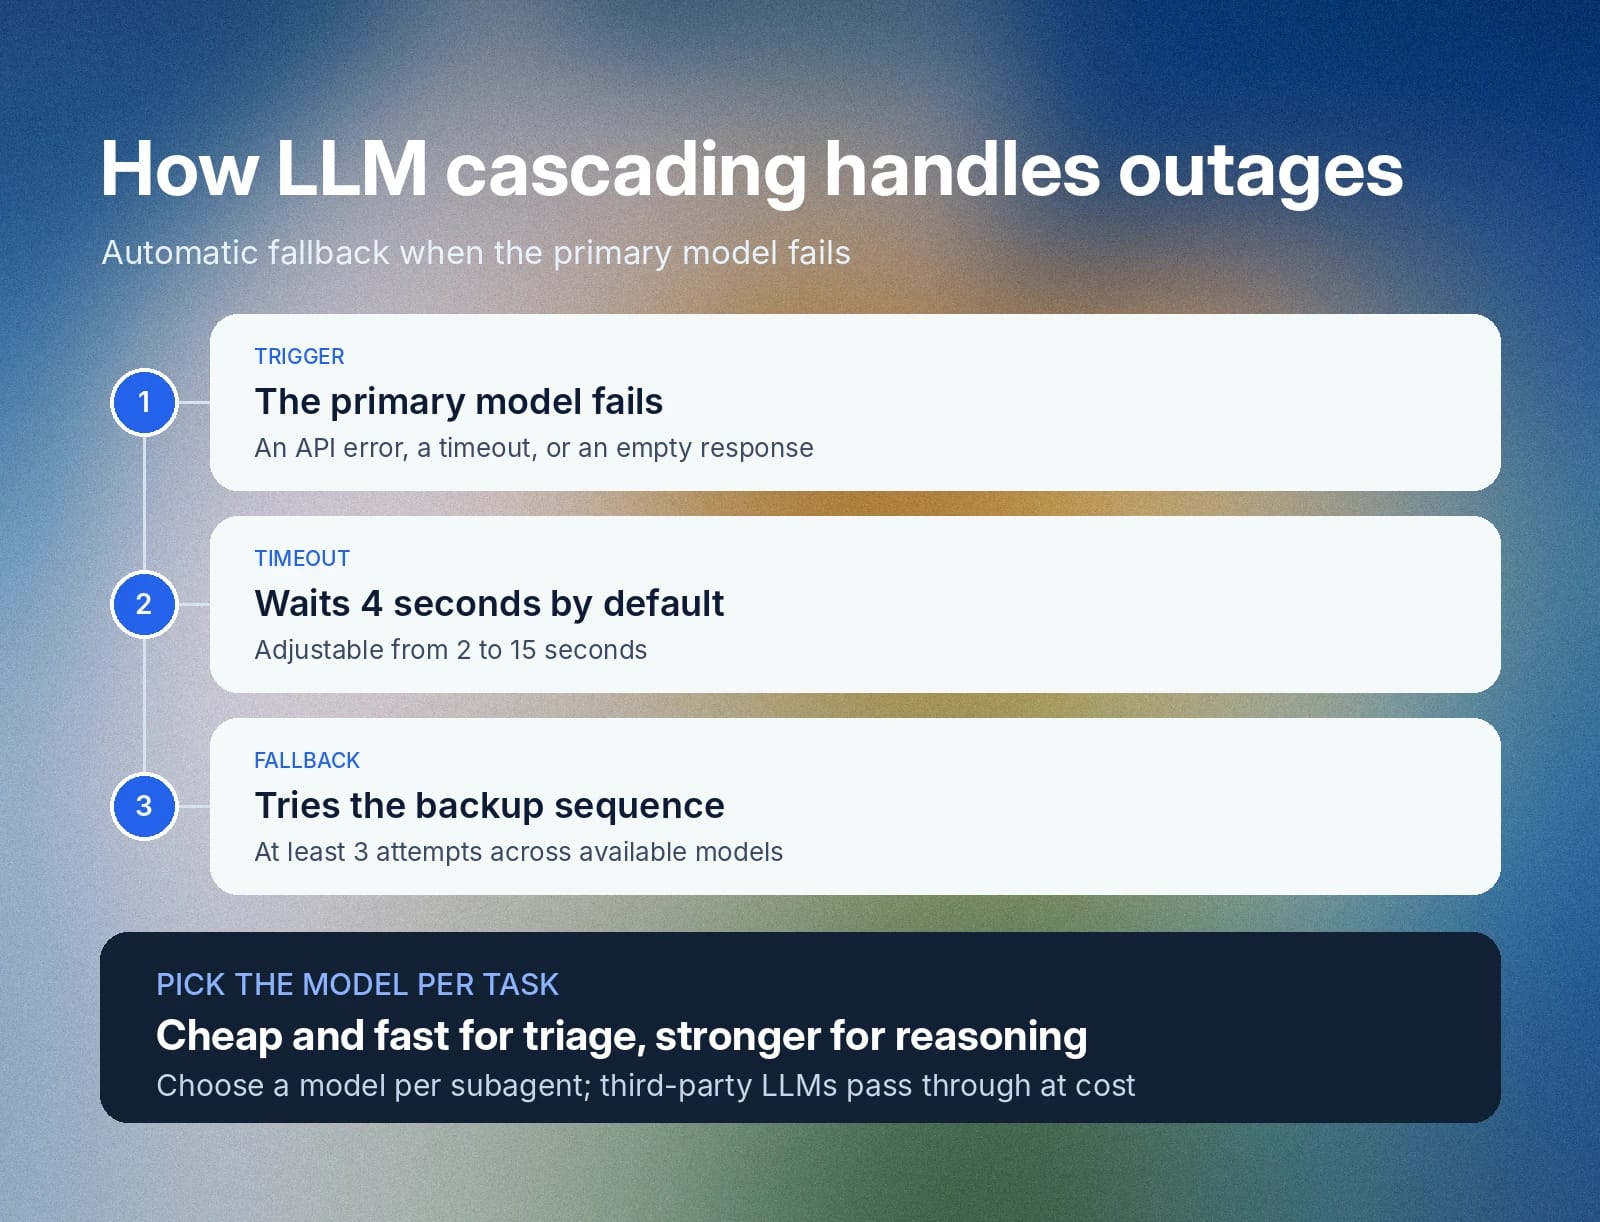
Dostawcy miewają awarie. Kaskadowanie LLM sobie z nimi radzi: jeśli model podstawowy zwróci błąd API, przekroczy limit czasu lub wyśle pustą odpowiedź, ElevenAgents wypróbuje sekwencję zapasową. Domyślny limit czasu przejścia z modelu podstawowego na zapasowy wynosi 4 sekundy, można go ustawić od 2 do 15 sekund, a system podejmuje co najmniej 3 próby na dostępnych modelach.
Własny LLM używany jako model podstawowy ponawia próbę co najmniej 3 razy, chyba że określisz własną kolejność modeli zapasowych. Właściwy model do zadania sprawia, że agent jest szybki i przystępny cenowo.
Orkiestracja: kierowanie pracą między agentami i ludźmi
Orkiestracja agentów koordynuje prompty, subagentów, narzędzia i osoby zaangażowane w realizację zadania. Decyduje o kolejnym kroku w każdym punkcie rozmowy.
Co robi
Zarządzanie jednym agentem z jednym długim promptem staje się trudne, gdy przybywa obowiązków. Orkiestracja dzieli pracę na etapy z własnymi instrukcjami, modelami i narzędziami oraz przenosi między nimi rozmówcę.
Dlaczego ma znaczenie
Mniejsze prompty łatwiej testować i taniej uruchamiać, bo każda interakcja ładuje mniej tekstu. Podział przepływu pozwala taniemu modelowi obsłużyć wstępną selekcję i FAQ, a mocniejszy model włącza się tylko wtedy, gdy prośba tego wymaga.
Jak robi to ElevenAgents
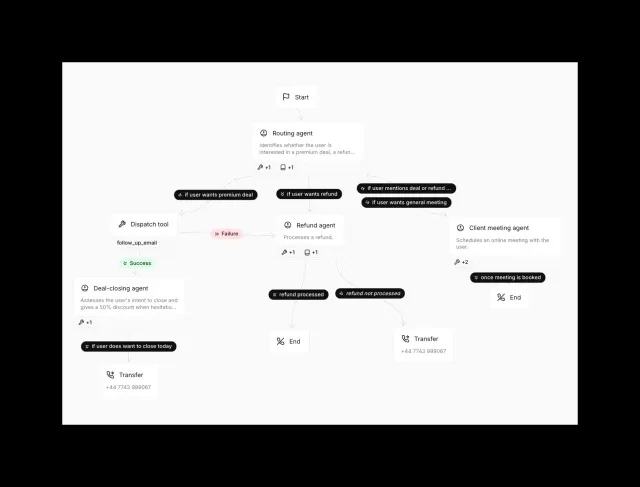
Workflows w ElevenAgents to wizualny kreator rozgałęzionych grafów rozmów.
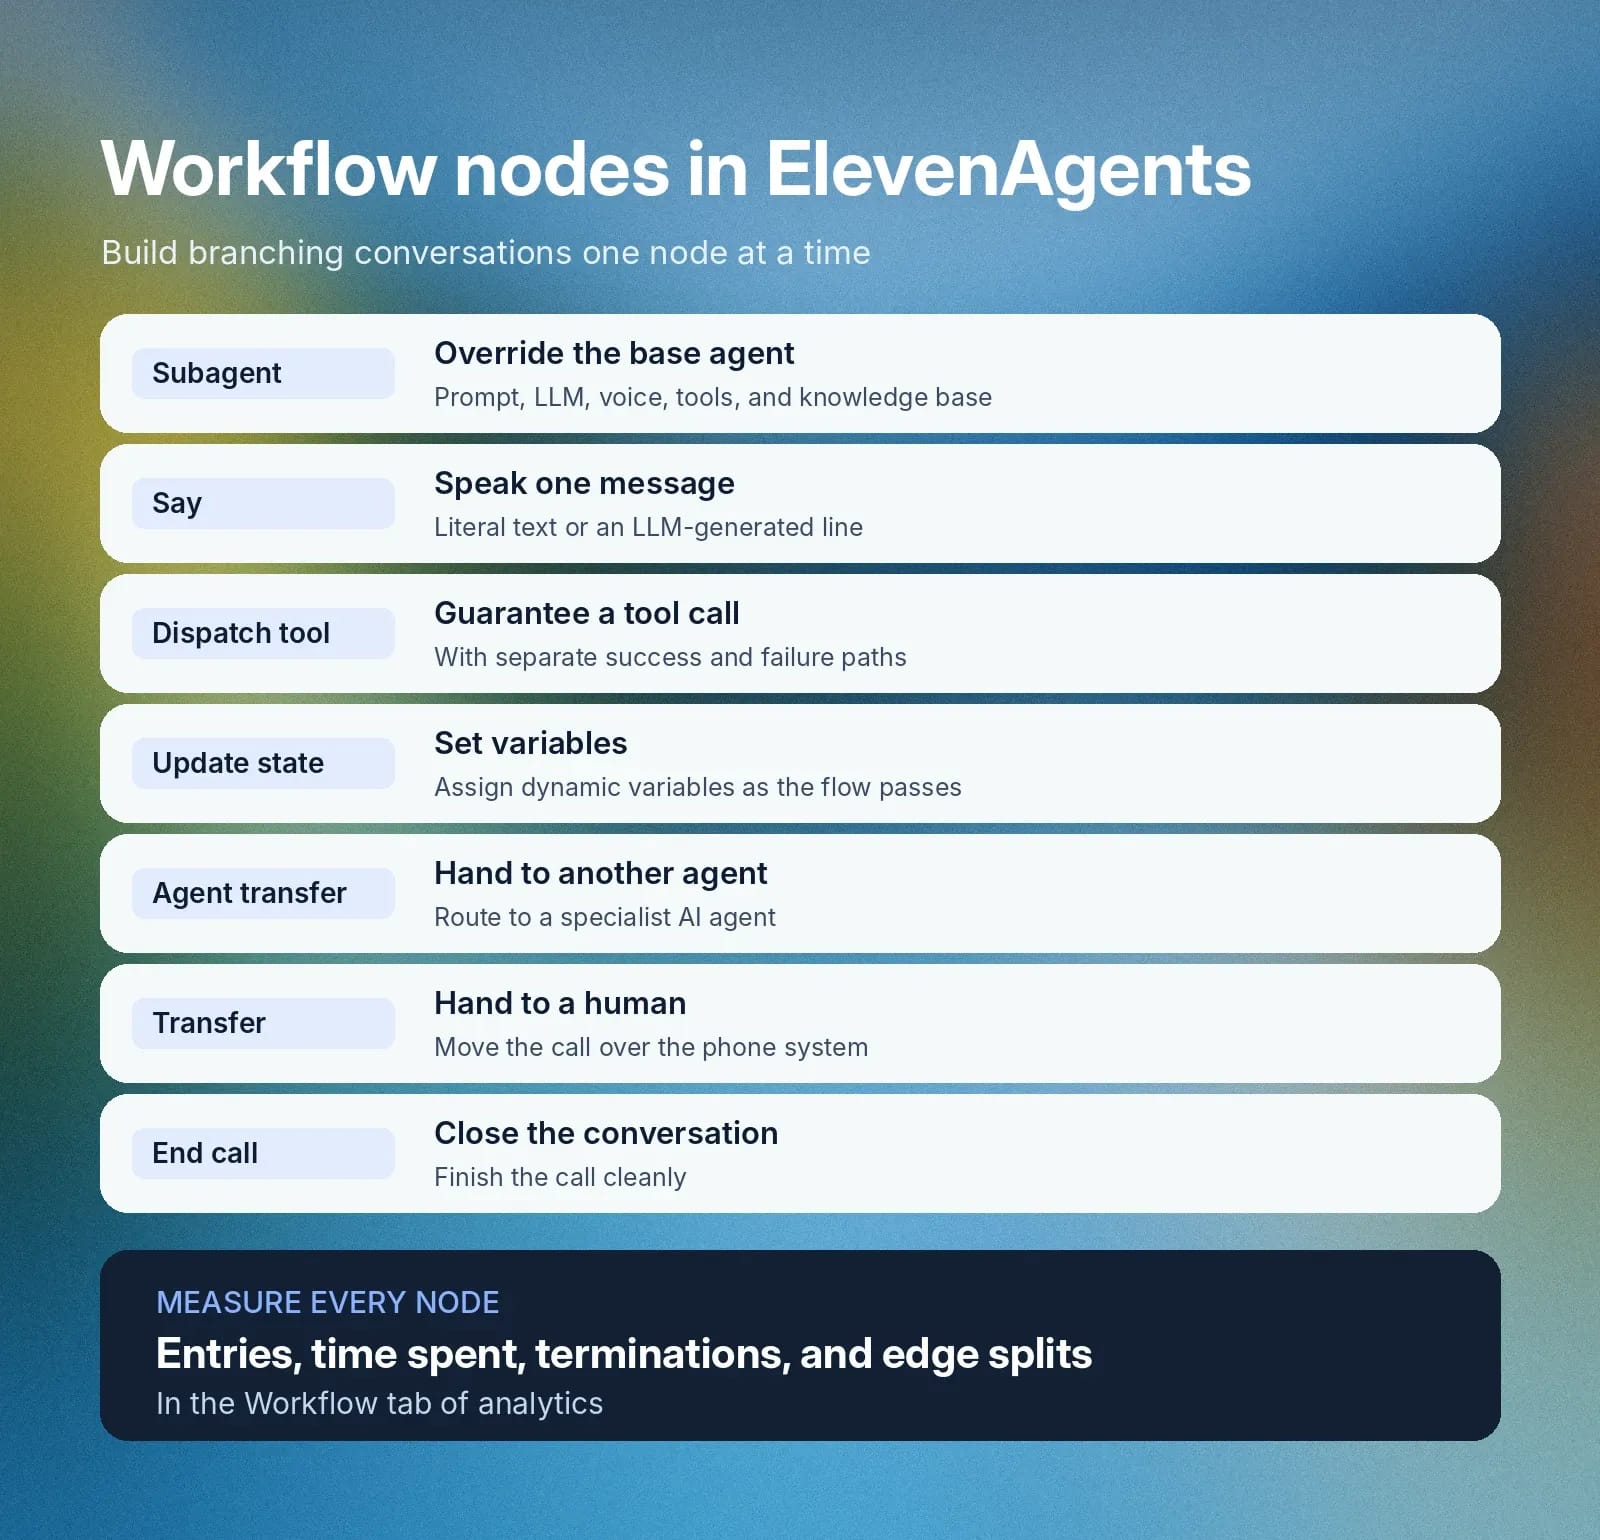
Węzły to:
- Subagent: Zmienia lub zastępuje agenta bazowego, w tym jego prompt, LLM, głos, narzędzia i bazę wiedzy.
- Say: Wypowiada jedną wiadomość — dosłowny tekst lub linijkę wygenerowaną przez LLM.
- Dispatch tool: Dedykowany krok gwarantujący wywołanie narzędzia, z osobnymi ścieżkami powodzenia i błędu.
- Update state: Przypisuje zmienne dynamiczne w miarę przechodzenia przez przepływ.
- Agent transfer: Przekazuje rozmowę innemu agentowi.
- Transfer to number: Przekazuje rozmowę z agenta AI do człowieka przez system telefoniczny.
- End call: Kończy rozmowę.
Krawędzie między węzłami zawierają warunki w języku naturalnym, które LLM ocenia w czasie rzeczywistym. Przepływ wsparcia może zacząć się od subagenta routującego na szybkim modelu, kierować pytania rozliczeniowe do subagenta rozliczeń na mocniejszym modelu i zakończyć węzłem transfer-to-number, gdy rozmówca prosi o człowieka. Po uruchomieniu karta Workflow w analityce pokazuje wejścia, średni czas, zakończenia i rozkład krawędzi dla każdego węzła.
Orkiestracja przekształca pojedynczego agenta w system, który możesz projektować, mierzyć i ulepszać po jednym węźle naraz.
Narzędzia i MCP: umożliwianie agentowi działania
Wywoływanie funkcji, zwane też wywoływaniem narzędzi, pozwala agentowi żądać działań od zewnętrznego oprogramowania podłączonego do twojego stosu technologicznego.
Zmienia interfejs pytań i odpowiedzi w system agentowej AI, który potrafi wykonywać pracę i wchodzić w interakcje z innymi narzędziami w twoim imieniu.
Co robi
Wyobraź sobie rozmówcę, który chce przełożyć jutrzejszą wizytę na piątek. Agent pobiera rezerwację, sprawdza dostępność w piątek, aktualizuje system planowania i potwierdza zmianę. Każdy krok to wywołanie narzędzia wykonujące działanie.
Dlaczego ma znaczenie
To narzędzia sprawiają, że rozmowy przynoszą rezultaty. Każde narzędzie potrzebuje jasnych danych wejściowych i wyjściowych, a agent musi wiedzieć, czy wywołanie się powiodło, zanim poinformuje o tym rozmówcę.
Jak robi to ElevenAgents
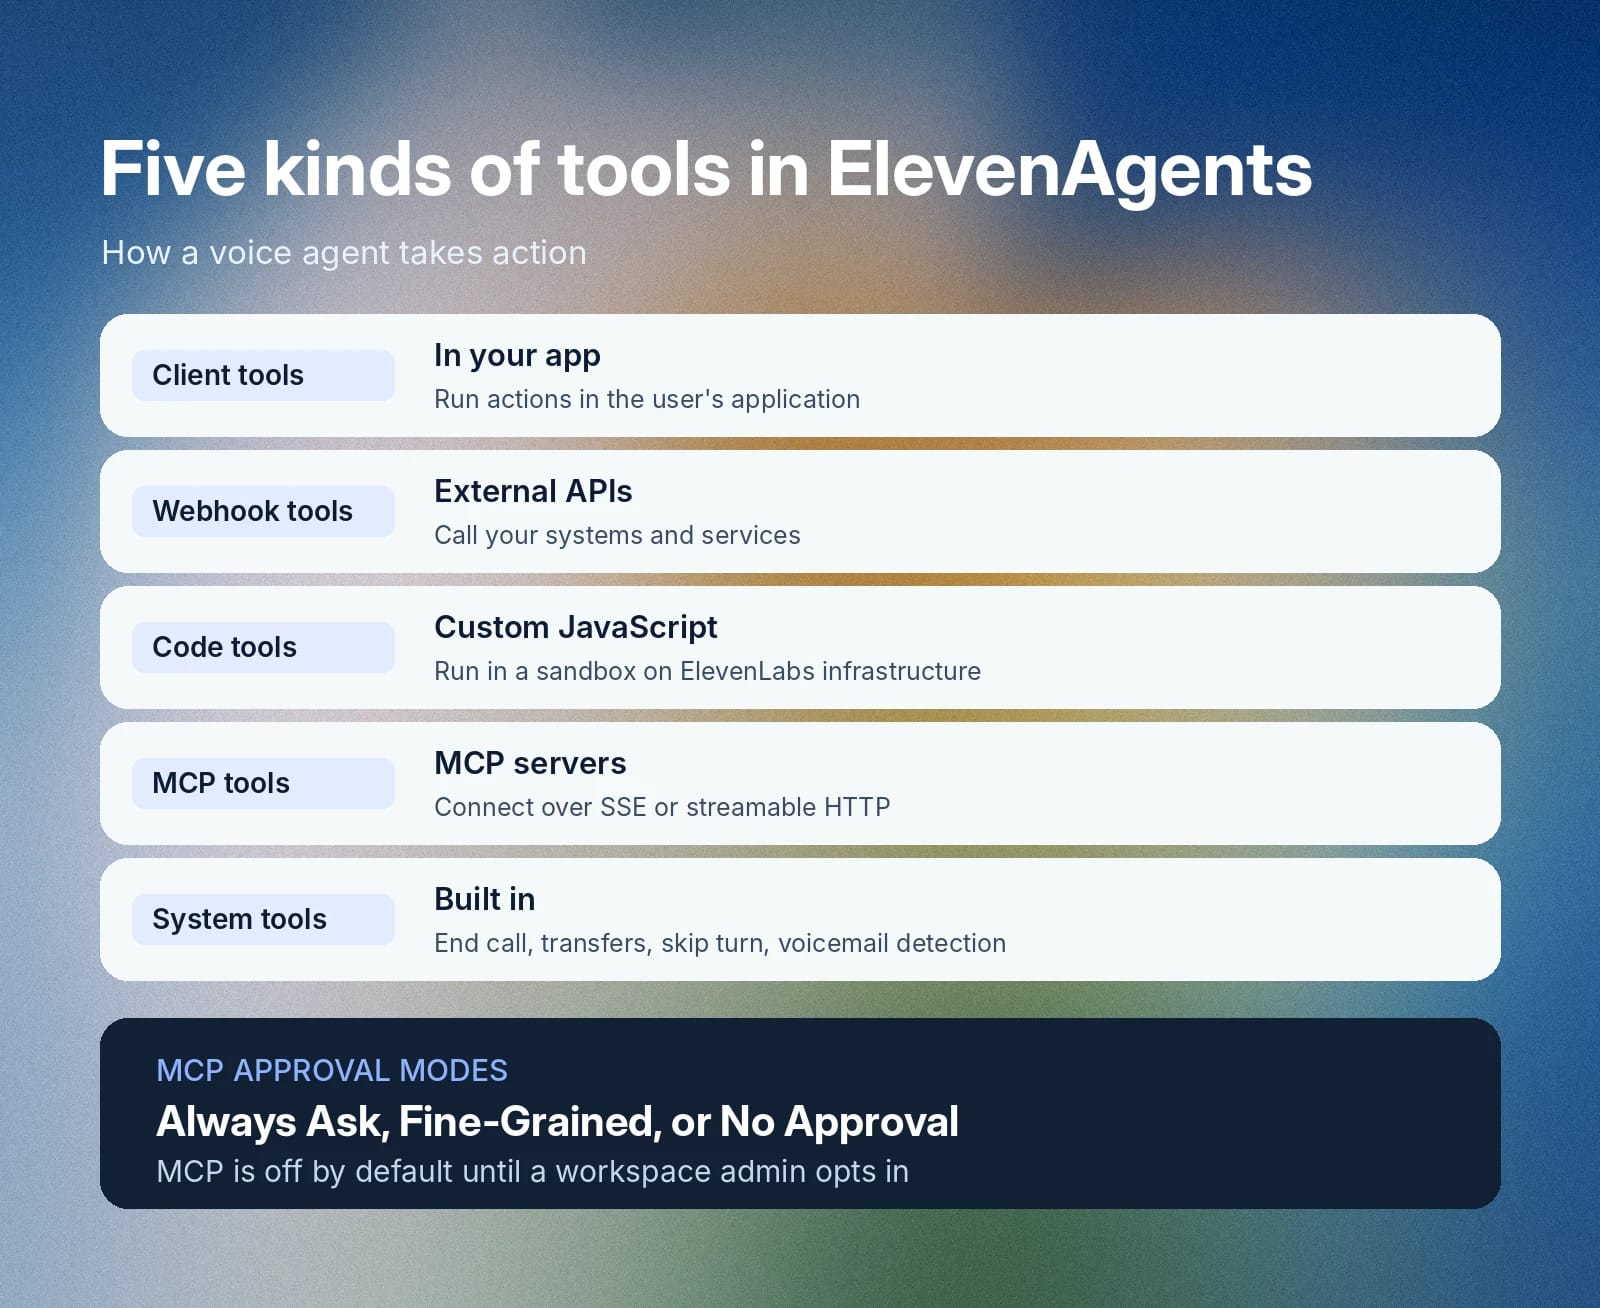
ElevenAgents obsługuje narzędzia klienckie działające w aplikacji użytkownika, narzędzia webhook wywołujące zewnętrzne API, narzędzia kodowe uruchamiające własny JavaScript w sandboxie na infrastrukturze ElevenLabs, narzędzia MCP oraz wbudowane narzędzia systemowe.
Narzędzia systemowe obejmują zakończenie rozmowy, wykrywanie języka, transfer agenta, transfer na numer, pominięcie tury, odtworzenie tonu klawiatury i wykrywanie poczty głosowej. Możesz dodać dźwięk tła podczas działania narzędzia oraz kontrolować, czy rozmówcy mogą przerywać w trakcie wykonania.
Model Context Protocol (MCP) to otwarty standard określający, jak aplikacje przekazują kontekst i narzędzia modelom językowym. ElevenAgents łączy się z serwerami MCP przez SSE i streamowalne HTTP. Administratorzy workspace'u najpierw muszą wyrazić zgodę, ponieważ MCP jest domyślnie wyłączony w każdym workspace'ie. Następnie wybierasz tryb zatwierdzania dla każdego serwera: Always Ask, Fine-Grained Tool Approval lub No Approval.
Zdarzenia klienta, takie jak client_tool_call i mcp_tool_call, raportują aktywność narzędzi, a raporty zdarzeń MCP obejmują cztery stany: ładowanie, oczekiwanie na zatwierdzenie, sukces i błąd. Niezawodne narzędzia dają agentowi możliwość działania w świecie rzeczywistym, a jasne zasady zatwierdzania pozwalają to kontrolować.
Wiedza i pamięć: fakty i kontekst rozmówcy
Generowanie wspomagane pobieraniem (RAG) dostarcza agentowi fakty z twoich treści, np. wewnętrznej bazy faktów lub szerszego rejestru historii klienta. Pamięć i personalizacja dają mu kontekst o rozmówcy, dzięki czemu agent może lepiej personalizować obsługę i zwiększać jej użyteczność dla firmy.
Co robi
Model językowy ma datę graniczną danych treningowych i nie ma dostępu do twojej dokumentacji ani rejestrów. RAG przeszukuje bazę wiedzy dla każdego zapytania, pobiera najtrafniejsze fragmenty i przekazuje je modelowi, by zapewnić dodatkowy kontekst potrzebny do użytecznej odpowiedzi.
Dane do personalizacji informują agenta, kto dzwoni i co jest dla tej osoby istotne.
Dlaczego ma znaczenie
Oparcie odpowiedzi na zatwierdzonych treściach zapewnia ich dokładność. Szybkość pobierania też ma znaczenie, bo każda dodana milisekunda to kolejna milisekunda oczekiwania klientów. Personalizacja sprawia też, że rozmówcy nie muszą powtarzać informacji w kolejnych rozmowach, ponieważ agenci mają pod ręką dane CRM na początku każdej sesji.
Jak robi to ElevenAgents
Dokumenty dodajesz do bazy wiedzy jako pliki (PDF, DOCX, TXT, MD, HTML lub EPUB, do 20 MB każdy), adresy URL albo wklejony tekst. Dokument korzysta z pełnego kontekstu, gdy wyodrębniony tekst mieści się w prompcie — do około 300 000 znaków. Większe dokumenty używają RAG. Pobieranie może działać w każdej turze lub na żądanie, a domyślny tryb użycia to Auto, który stosuje RAG, gdy jest włączony, a dokument zindeksowany.
ElevenLabs bezpośrednio pracuje nad szybkością pobierania. Artykuł techniczny How we reduced RAG latency opisuje spadek mediany opóźnienia RAG z 326 ms do 155 ms dzięki modelom hostowanym samodzielnie na infrastrukturze już obsługiwanej przez ElevenLabs.
Do przekazywania kontekstu rozmówcy ElevenAgents używa zmiennych dynamicznych zapisywanych jako {{ var_name }}, które wypełniają wiadomości, prompty systemowe i narzędzia. Przy połączeniach przychodzących przez Twilio, trunk SIP, WhatsApp i SMS ElevenAgents może pobrać dane inicjujące z twojego serwera przed rozpoczęciem rozmowy. Serwer wyszukuje rozmówcę według caller_id i zwraca zmienne, np. z CRM, w odpowiedzi do 256 KB. Po rozmowie webhooki post-call przekazują wyniki oceny i wyodrębnione dane do systemów zewnętrznych.
Pobieranie i personalizacja dają agentowi jednocześnie właściwe fakty i właściwy kontekst rozmówcy.
Synteza mowy: nadawanie agentowi głosu
Text to Speech (TTS) zamienia odpowiedź modelu językowego na mówione audio. To warstwa, którą faktycznie słyszy rozmówca.
Co robi
Model zamienia tekst na audio z naturalnym tempem i emocjonalną interpretacją. W rozmowie na żywo przesyła audio strumieniowo w częściach, więc odtwarzanie zaczyna się przed wygenerowaniem całej odpowiedzi.
Dlaczego ma znaczenie
Opóźnienie i sposób wypowiedzi wpływają na ocenę rozmowy przez rozmówców. W pracy w czasie rzeczywistym liczą się dwie wartości: czas generowania audio i czas do usłyszenia pierwszego dźwięku. Imiona, nazwy leków i terminy techniczne też wymagają poprawnej wymowy, inaczej rozmówcy tracą zaufanie do agenta.
Jak Eleven v4 napędza warstwę głosową
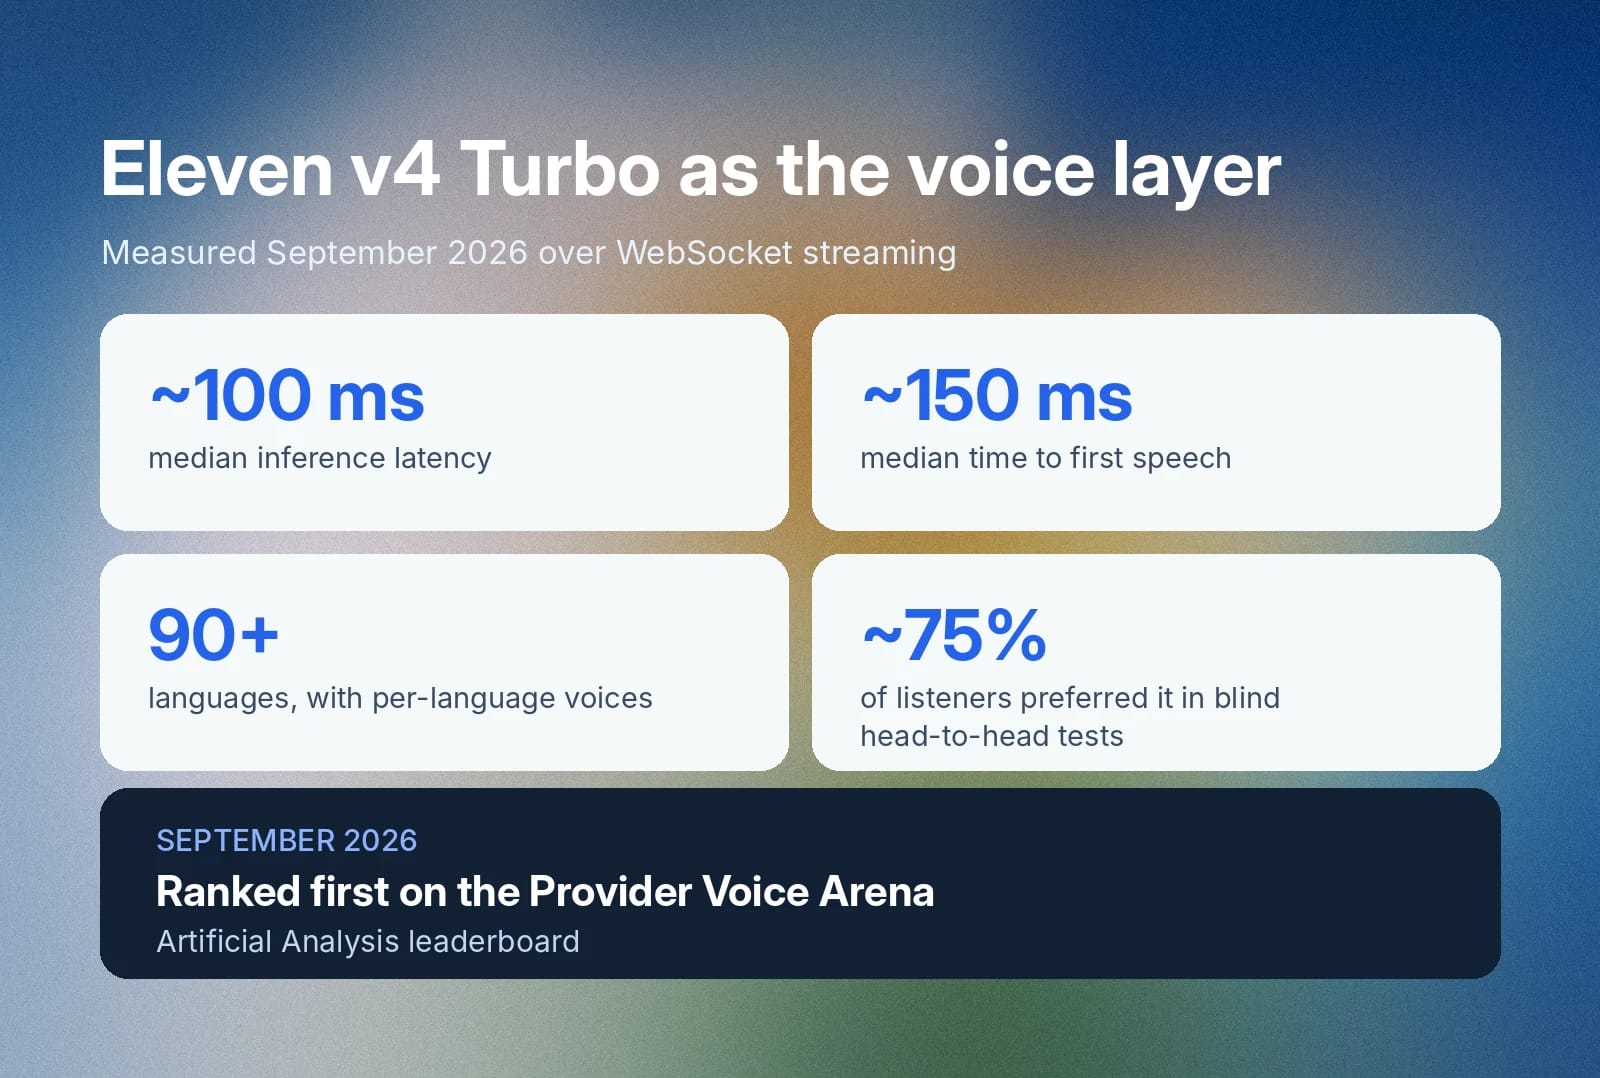
Eleven v4 to najbardziej ekspresyjny dotąd model Text to Speech od ElevenLabs, zbudowany na całkowicie nowej architekturze. Eleven v4 Turbo to wariant o niskim opóźnieniu do zastosowań w czasie rzeczywistym, takich jak agenci, zoptymalizowany wraz z ElevenAgents jako jeden system.
Eleven v4 Turbo
Wartość
Mediana opóźnienia inferencji
Około 100 ms
Mediana czasu do pierwszej mowy
Około 150 ms
Języki
90+
ElevenLabs zmierzyło te opóźnienia we wrześniu 2026 roku podczas streamingu przez WebSocket, z wyłączeniem opóźnienia sieciowego. Eleven v4 zajął pierwsze miejsce w Artificial Analysis Provider Voice Arena Leaderboard we wrześniu 2026*, a około 75% słuchaczy preferowało go w ślepych testach**.
* Artificial Analysis, Provider Voice Arena Leaderboard, wrzesień 2026
** Na podstawie bezpośrednich testów preferencji użytkowników względem Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS i Google Gemini 3.8 Flash TTS.
Eleven v4 obsługuje wbudowane tagi audio, takie jak [laughs] do sterowania sposobem wypowiedzi, oraz obsługę fonemów IPA dla wymowy. W agentach medycznych ta kontrola wymowy obejmuje terminy medyczne. ElevenAgents dodaje do tego kontrolę na poziomie agenta. Obsługa wielu głosów pozwala jednemu agentowi przełączać głosy w rozmowach wielu postaci. Prędkość wynosi od 0,7x do 1,2x. Każdy dodatkowy język może używać własnego głosu. Słowniki wymowy przyjmują zapis IPA lub CMU dla konkretnych słów.
Szybki pierwszy dźwięk oraz dokładny, ekspresyjny głos sprawiają, że agent brzmi jak partner do rozmowy.
Telefonia i transport: łączenie agenta z rozmówcami
Warstwa transportowa przesyła audio między rozmówcą a agentem. Zależnie od używanego kanału telefonii różnią się integracje, które dodasz tu do infrastruktury głosowej AI.
Co robi
Rozmowy telefoniczne biegną przez sieć telefoniczną i SIP, a rozmowy w przeglądarce i aplikacji — przez WebRTC lub WebSocket. Widżet strony internetowej opakowuje połączenie przeglądarkowe w gotowy interfejs.
Dlaczego ma znaczenie
Każdy kanał ma inne wymagania wdrożeniowe i ograniczenia audio, dlatego wybierz kanały odpowiednio wcześnie. Wdrożenie oparte na telefonie wymaga trunkingu i zarządzania numerami. Wdrożenie w produkcie wymaga SDK.
Jak robi to ElevenAgents
- Trunking SIP: Łączy system telefoniczny bezpośrednio z ElevenLabs, dla połączeń przychodzących i wychodzących. Działa z Twilio, Vonage, Sinch, Infobip, Telnyx i innymi standardowymi dostawcami. Sygnalizacja działa przez TCP na porcie 5060 albo TLS 1.2 lub nowszy na porcie 5061, a audio używa G.711 lub G.722. Zaplanuj co najmniej 100 Kbps na rozmowę. Limity jednoczesnych rozmów zależą od planu subskrypcji, a rozmówcy czekają, gdy włączone jest kolejkowanie.
- Natywna integracja z Twilio: Zaimportuj zakupiony numer Twilio dla połączeń przychodzących i wychodzących. Zweryfikowane identyfikatory dzwoniącego działają tylko dla połączeń wychodzących.
- Rozmowy wsadowe: Prześlij listę odbiorców CSV lub XLS, a każda dodatkowa kolumna stanie się zmienną dynamiczną. Możesz uruchomić je od razu lub zaplanować start. Partie używają niższej z wartości: 50% limitu współbieżności workspace'u lub 70% limitu współbieżności agenta, co zostawia miejsce na połączenia przychodzące.
- WebRTC i WebSocket: SDK domyślnie używają WebRTC dla głosu i WebSocket dla rozmów wyłącznie tekstowych. Prywatni agenci uwierzytelniają się podpisanym URL-em lub tokenem rozmowy utworzonym na serwerze. Endpoint WebSocket to wss://api.elevenlabs.io/v1/convai/conversation.
- SDK: Python, JavaScript, React, React Native, Swift, Kotlin i Unity.
- Widżet: Dodaj element <elevenlabs-convai> do strony. Obsługuje tryby tylko głosowy, głos z tekstem i czat, a agent może wyświetlać szybkie odpowiedzi i karuzele.
Jeden agent może obsługiwać telefon, internet, WhatsApp, SMS i e-mail, dzięki czemu zespoły tworzą raz i wdrażają na wielu kanałach.
Guardraile: utrzymywanie agenta na właściwym torze
Guardraile to mechanizmy kontroli utrzymujące zachowanie agenta w określonych granicach. Działają obok oparcia na źródłach, ponieważ guardrail ogranicza to, co agent mówi, ale nie zapewnia poprawności stojących za tym faktów. Guardraile działają równolegle do rozmów agenta, pomagając utrzymać zgodność i dokładność rozmów z agentem AI.
Co robi
ElevenAgents stosuje guardraile na trzech poziomach. Prompt systemowy określa dozwolone i niedozwolone zachowania, najlepiej pod nagłówkiem # Guardrails. Walidacja danych użytkownika sprawdza wiadomości pod kątem prompt injection. Walidacja odpowiedzi sprawdza każdą odpowiedź przed wysłaniem.
Dlaczego ma znaczenie
Agent, który schodzi z tematu lub wymyśla zasady, szybko podważa zaufanie. Agent obsługi klienta powinien przed odpowiedzią pobrać zasady zwrotów z zatwierdzonego źródła, a guardrail egzekwuje tę granicę.
Jak robi to ElevenAgents
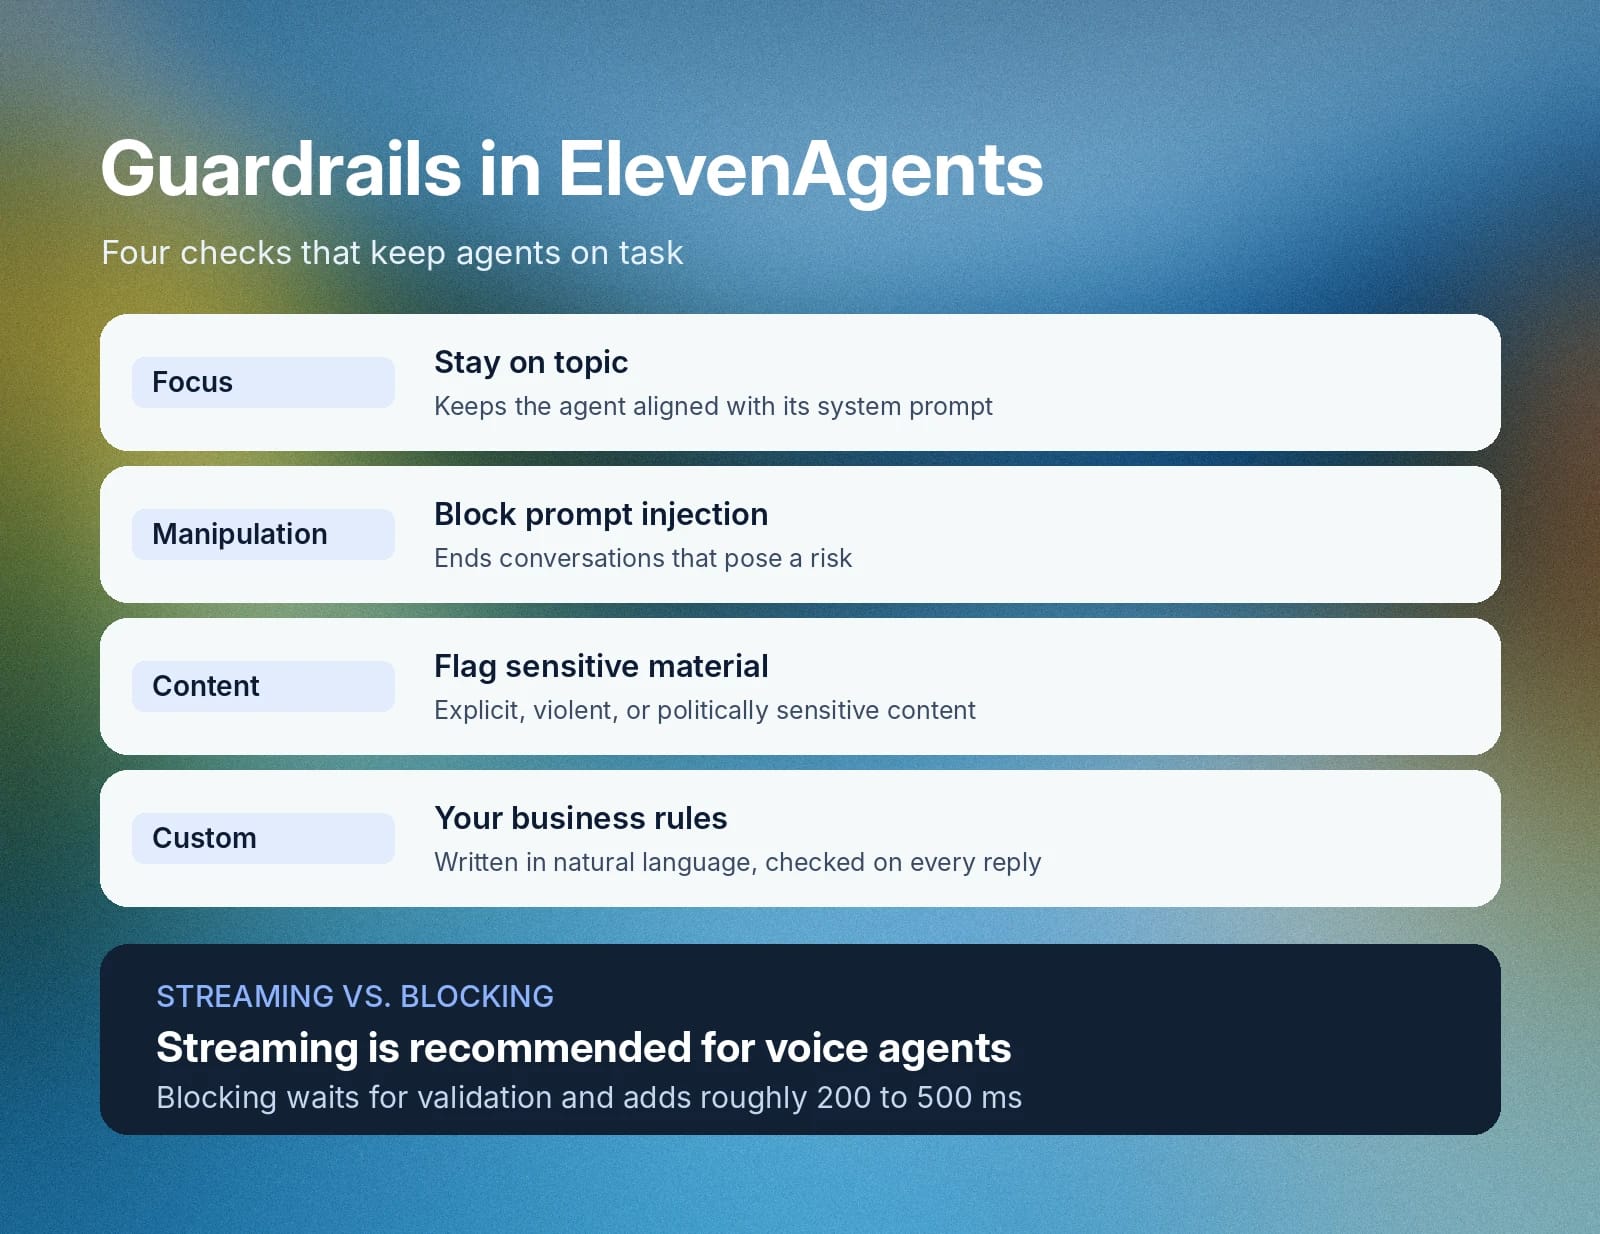
ElevenAgents wprowadziło Guardrails 2.0 we wrześniu 2026 roku. Oto konfiguracje, które pomagają guardrailom działać skutecznie:
- Focus: Utrzymuje agenta w temacie i zgodnie z promptem systemowym.
- Manipulation: Wykrywa prompt injection i kończy rozmowy stanowiące ryzyko.
- Content: Oznacza kategorie takie jak treści seksualne, brutalne lub wrażliwe politycznie.
- Custom: Reguły biznesowe zapisane przez ciebie językiem naturalnym, oceniane przy każdej odpowiedzi.
Tryb wykonania określa kompromis dotyczący opóźnienia. Tryb streaming pozwala zacząć odpowiedź przed zakończeniem kontroli, więc mniej niż 500 ms audio może zostać odtworzone, zanim blokada zakończy rozmowę; ElevenLabs zaleca go dla agentów głosowych. Tryb blocking czeka na walidację i dodaje około 200–500 ms.
Gdy uruchomi się niestandardowy guardrail, działanie może zakończyć rozmowę albo ponowić odpowiedź maksymalnie trzy razy z napisanym przez ciebie feedbackiem. Klient może nasłuchiwać zdarzenia guardrail_triggered.
Wielowarstwowe guardraile z wybranym profilem opóźnienia zapewniają przewidywalne zachowanie bez spowalniania każdej odpowiedzi.
Testowanie i eksperymenty: potwierdzanie, że agent działa
Testowanie sprawdza agenta przed uruchomieniem. Eksperymenty sprawdzają zmiany na ruchu na żywo po uruchomieniu.
Co robi
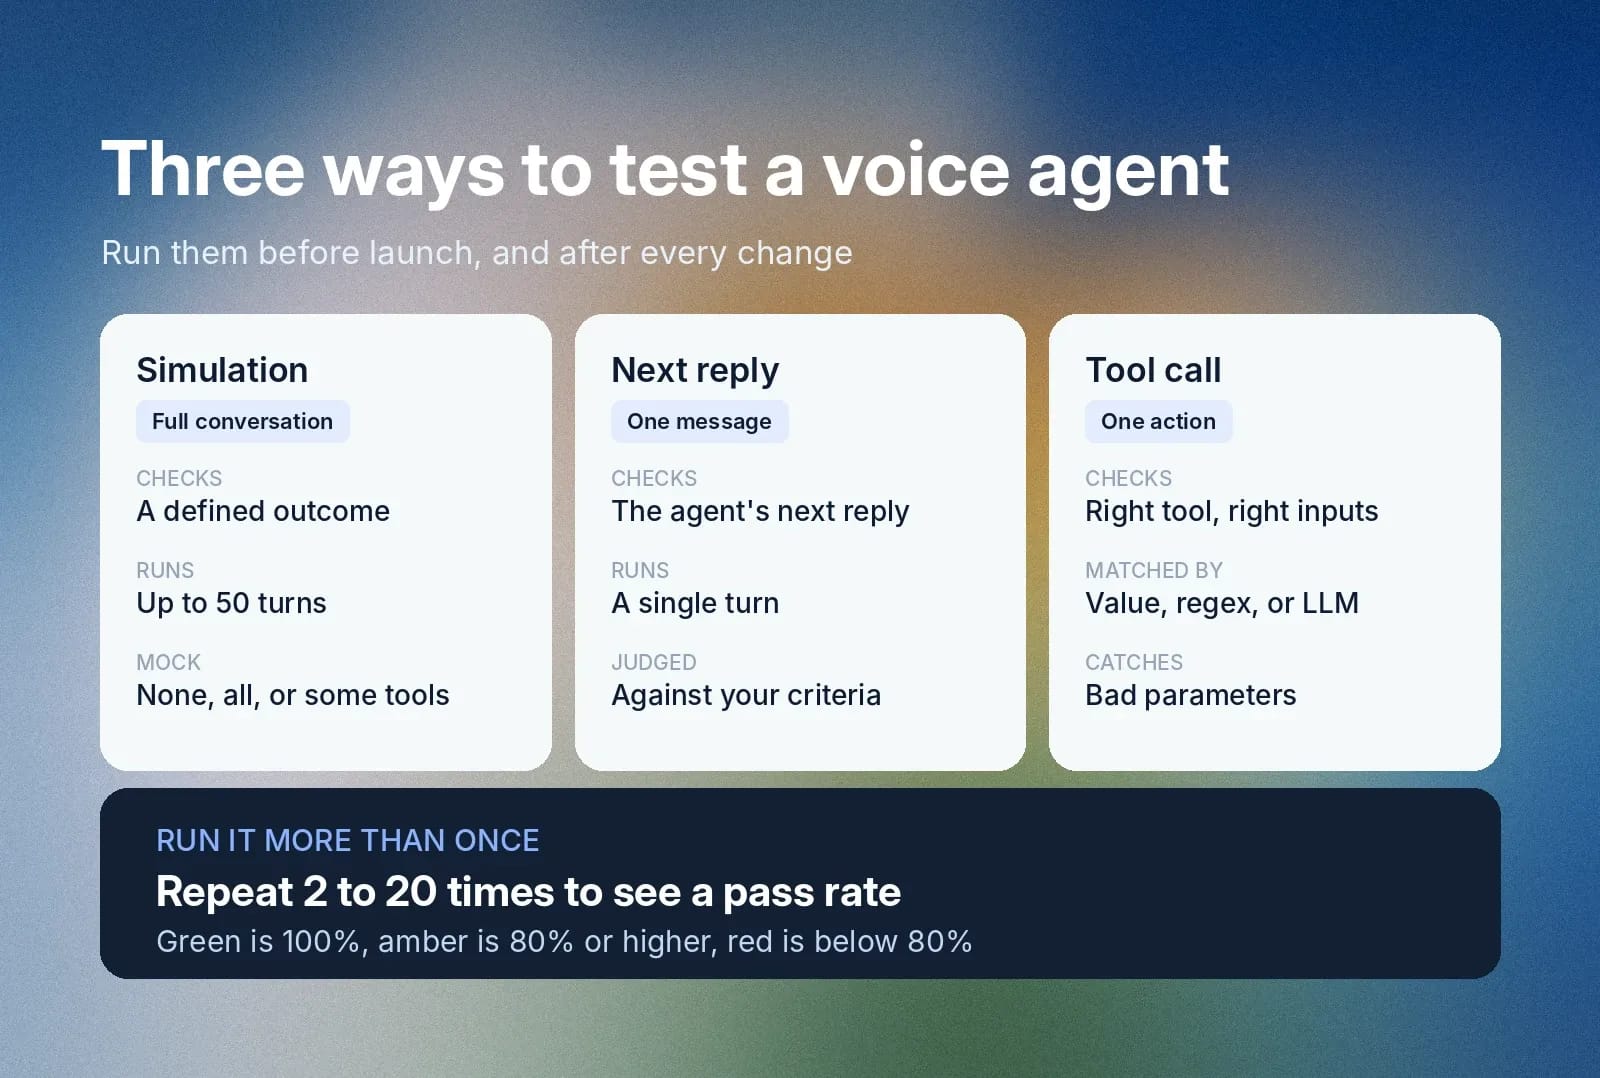
ElevenAgents ma trzy typy testów agentów. Simulation prowadzi pełną rozmowę z symulowanym użytkownikiem i sprawdza, czy osiąga określony wynik, w maksymalnie 50 turach (domyślnie 5). Testy Next Reply oceniają tylko kolejną wiadomość agenta według twoich kryteriów. Testy Tool Call weryfikują, czy agent używa właściwego narzędzia z prawidłowymi parametrami, dopasowanymi według dokładnej wartości, regexu lub oceny LLM. W symulacjach możesz mockować brak narzędzi, wszystkie narzędzia lub wybrane.
Dlaczego ma znaczenie
Pojedynczy zaliczony test pokazuje, że agent może odnieść sukces. Wielokrotne uruchamianie testów pokazuje, jak często mu się to uda. API przyjmuje repeat_count od 2 do 20, a wyniki pokazują wskaźnik zaliczeń. Zielony oznacza 100%, bursztynowy 80% lub więcej, a czerwony mniej niż 80%. Błędy są grupowane według przyczyny. Prompty, modele, workflow i integracje zmieniają zachowanie, więc testowanie trwa także po uruchomieniu.
Jak działają eksperymenty
Eksperymenty to testy A/B oparte na wersjonowaniu agentów. Tworzysz gałąź konfiguracji, zmieniasz jedną zmienną, np. prompt systemowy, workflow, głos, narzędzia, bazę wiedzy lub ustawienia LLM, i kierujesz część ruchu na żywo do wariantu. ElevenLabs zaleca zacząć od 5–10%.
Routing jest deterministyczny według identyfikatora rozmowy, więc dany użytkownik pozostaje na tej samej gałęzi, a wartości procentowe muszą dawać łącznie 100%. CARS24, klient ElevenLabs, zwiększał ruch przez 5%, 10%, 20%, 50% i 100%, z dwudniowym okresem na każdym etapie, jak opisano w raporcie.
Testy przed uruchomieniem i eksperymenty na żywo razem przekształcają zmiany w mierzalne ulepszenia.
Obserwowalność: mierzenie tego, co dzieje się na produkcji
Obserwowalność to możliwość sprawdzenia, co zrobił agent, jak działał i — w razie potrzeby — gdzie zawiódł. Agent działający w teście może zachowywać się inaczej z prawdziwymi rozmówcami, dlatego pełna obserwowalność i audytowalna dokumentacja są niezbędne.
Co robi
Analiza rozmów ocenia każdą rozmowę. Ocena sukcesu stosuje zdefiniowane przez ciebie kryteria osiągnięcia celu i jakości, a zbieranie danych wyodrębnia uporządkowane pola, takie jak dane kontaktowe i typ problemu. Panel analityczny dodaje liczbę rozmów, czas trwania, koszt, wskaźniki błędów i opóźnienie. Aktywne rozmowy aktualizują się w czasie rzeczywistym, a alerty uruchamiają się, gdy wzrasta wskaźnik błędów.
Dlaczego ma znaczenie
Bez monitoringu słaba rozmowa jest tylko anegdotą. Dzięki niemu zobaczysz, który węzeł, narzędzie lub model spowodował problem.
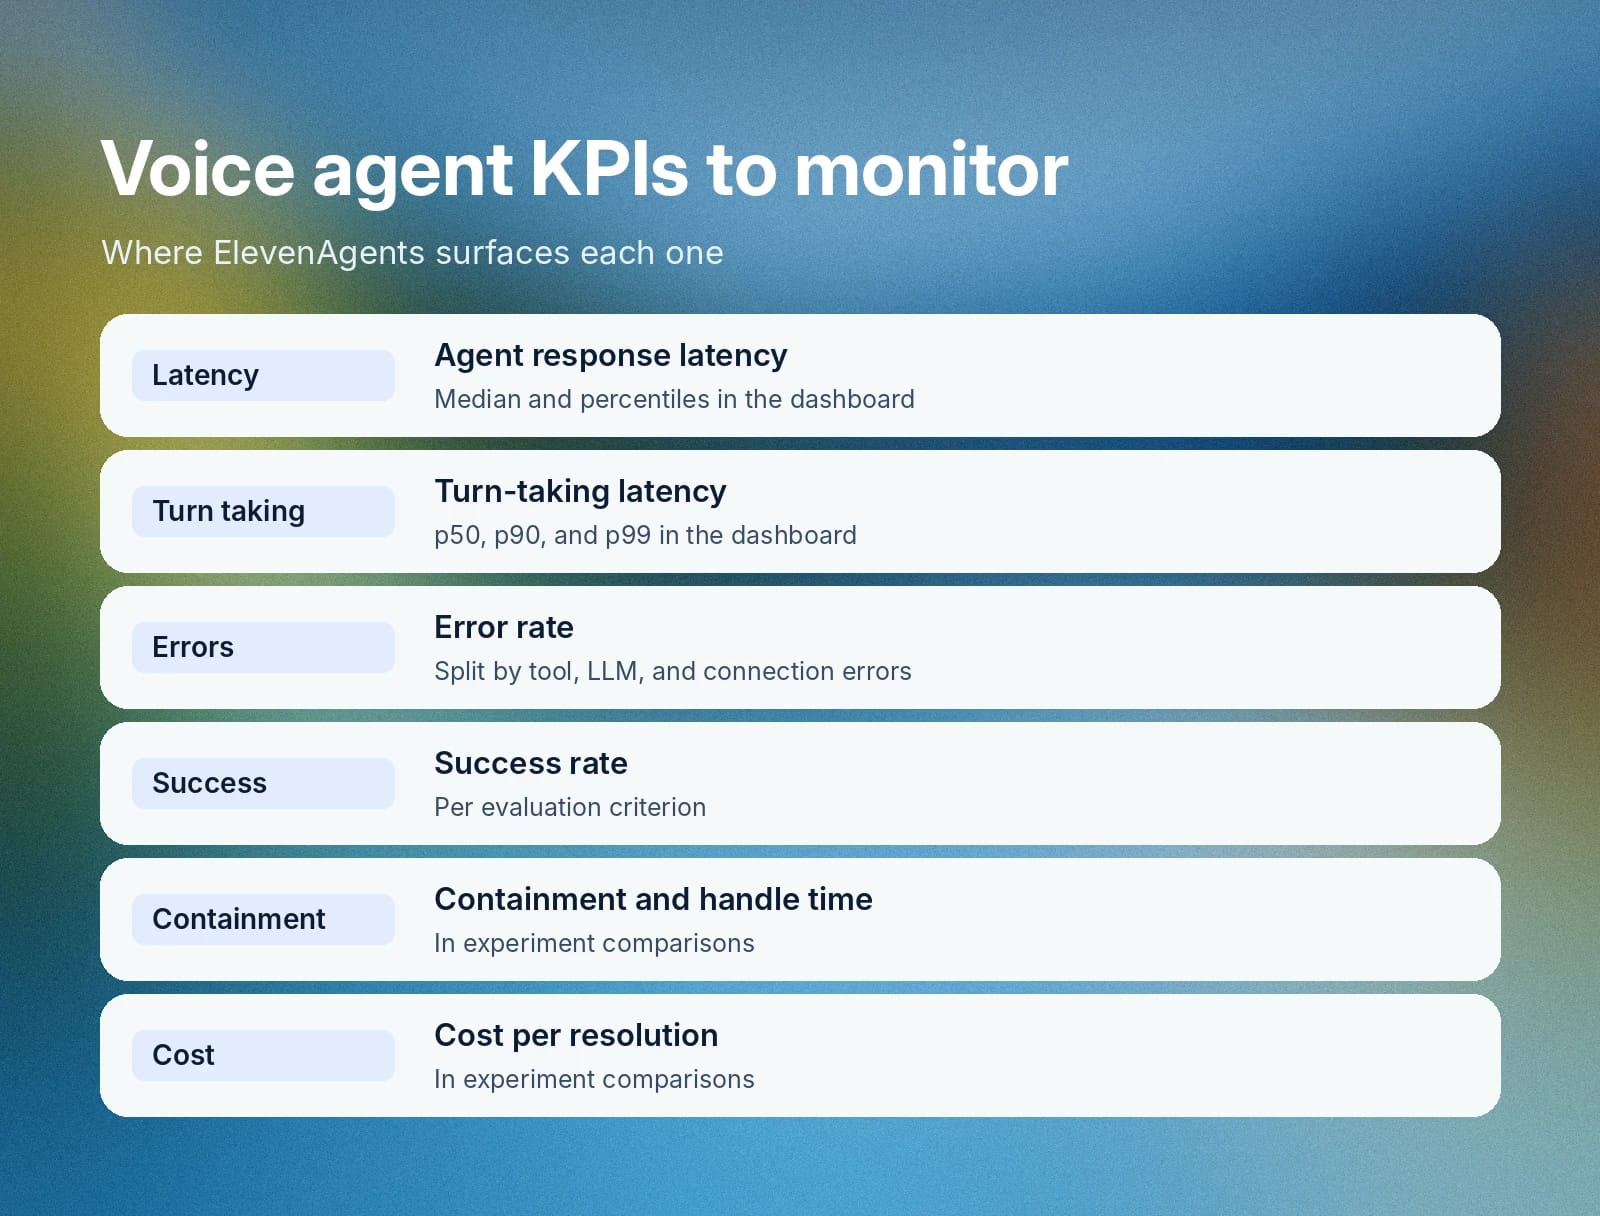
KPI
Co mówi
Gdzie pokazuje to ElevenAgents
Opóźnienie odpowiedzi agenta
Jak długo rozmówcy czekają na odpowiedź
Panel analityczny, mediana i percentyle
Opóźnienie przejęcia tury
Jak szybko agent przejmuje turę
Panel analityczny, p50, p90 i p99
Wskaźnik błędów
Udział rozmów z błędami
Panel z podziałem na błędy narzędzi, LLM i połączeń
Wskaźnik sukcesu
Osiągnięcie celu dla każdego kryterium
Kryteria oceny ze wskaźnikami sukcesu, błędu i braku rozstrzygnięcia
Wskaźnik obsługi bez przekazania i czas obsługi
Rozmowy rozwiązane bez udziału człowieka oraz czas trwania rozmowy
Porównania eksperymentów
Koszt rozwiązania
Ile kosztuje każda rozwiązana rozmowa
Porównania eksperymentów
Wybierz wskaźniki najbardziej przydatne dla konkretnego zadania. Agent wsparcia skupia się na rozwiązaniu sprawy i eskalacji, podczas gdy agent outboundowy przede wszystkim na połączeniu i ukończeniu rozmowy.
Skala, niezawodność i przekazanie rozmowy człowiekowi
Infrastruktura głosowa AI musi działać równie dobrze, gdy rozmawiasz z 5 klientami, jak i z 500 000. Nawet przy dużej skali komponenty te muszą być odporne i umożliwiać eskalację do ludzi, gdy jest potrzebna.
Co robi
Skala oznacza obsługę wielu jednoczesnych rozmów w obszarach rozpoznawania mowy, inferencji LLM, syntezy mowy, integracji i telefonii. Niezawodność oznacza, że każda z tych zależności ma zdefiniowaną ścieżkę awarii. Przekazanie oznacza jasną drogę do człowieka.
Choć nie są to ściśle komponenty infrastruktury głosowej AI, w praktyce wszystkie są kluczowe dla dobrego systemu.
Dlaczego ma znaczenie
System obsługujący dziesięć rozmów testowych może zachowywać się inaczej przy dziesięciu tysiącach. Narzędzie rezerwacji, które przekracza limit czasu, nie może skłonić agenta do potwierdzenia rezerwacji, która nigdy nie powstała. Rozmówca proszący o człowieka musi do niego trafić z zachowaniem kontekstu, zwykle przez ciepły transfer.
Jak robi to ElevenAgents
Limity współbieżności zależą od planu subskrypcji, a kolejkowanie połączeń zatrzymuje rozmówców po osiągnięciu limitu. Kaskadowanie LLM zabezpiecza przed awariami modeli. Węzły transfer-to-number, narzędzie systemowe transfer-to-number i transfer agenta obsługują przekazanie, a kryteria oceny mogą decydować o eskalacji. Okresy ciszy są rozliczane według 5% zwykłej stawki minutowej.
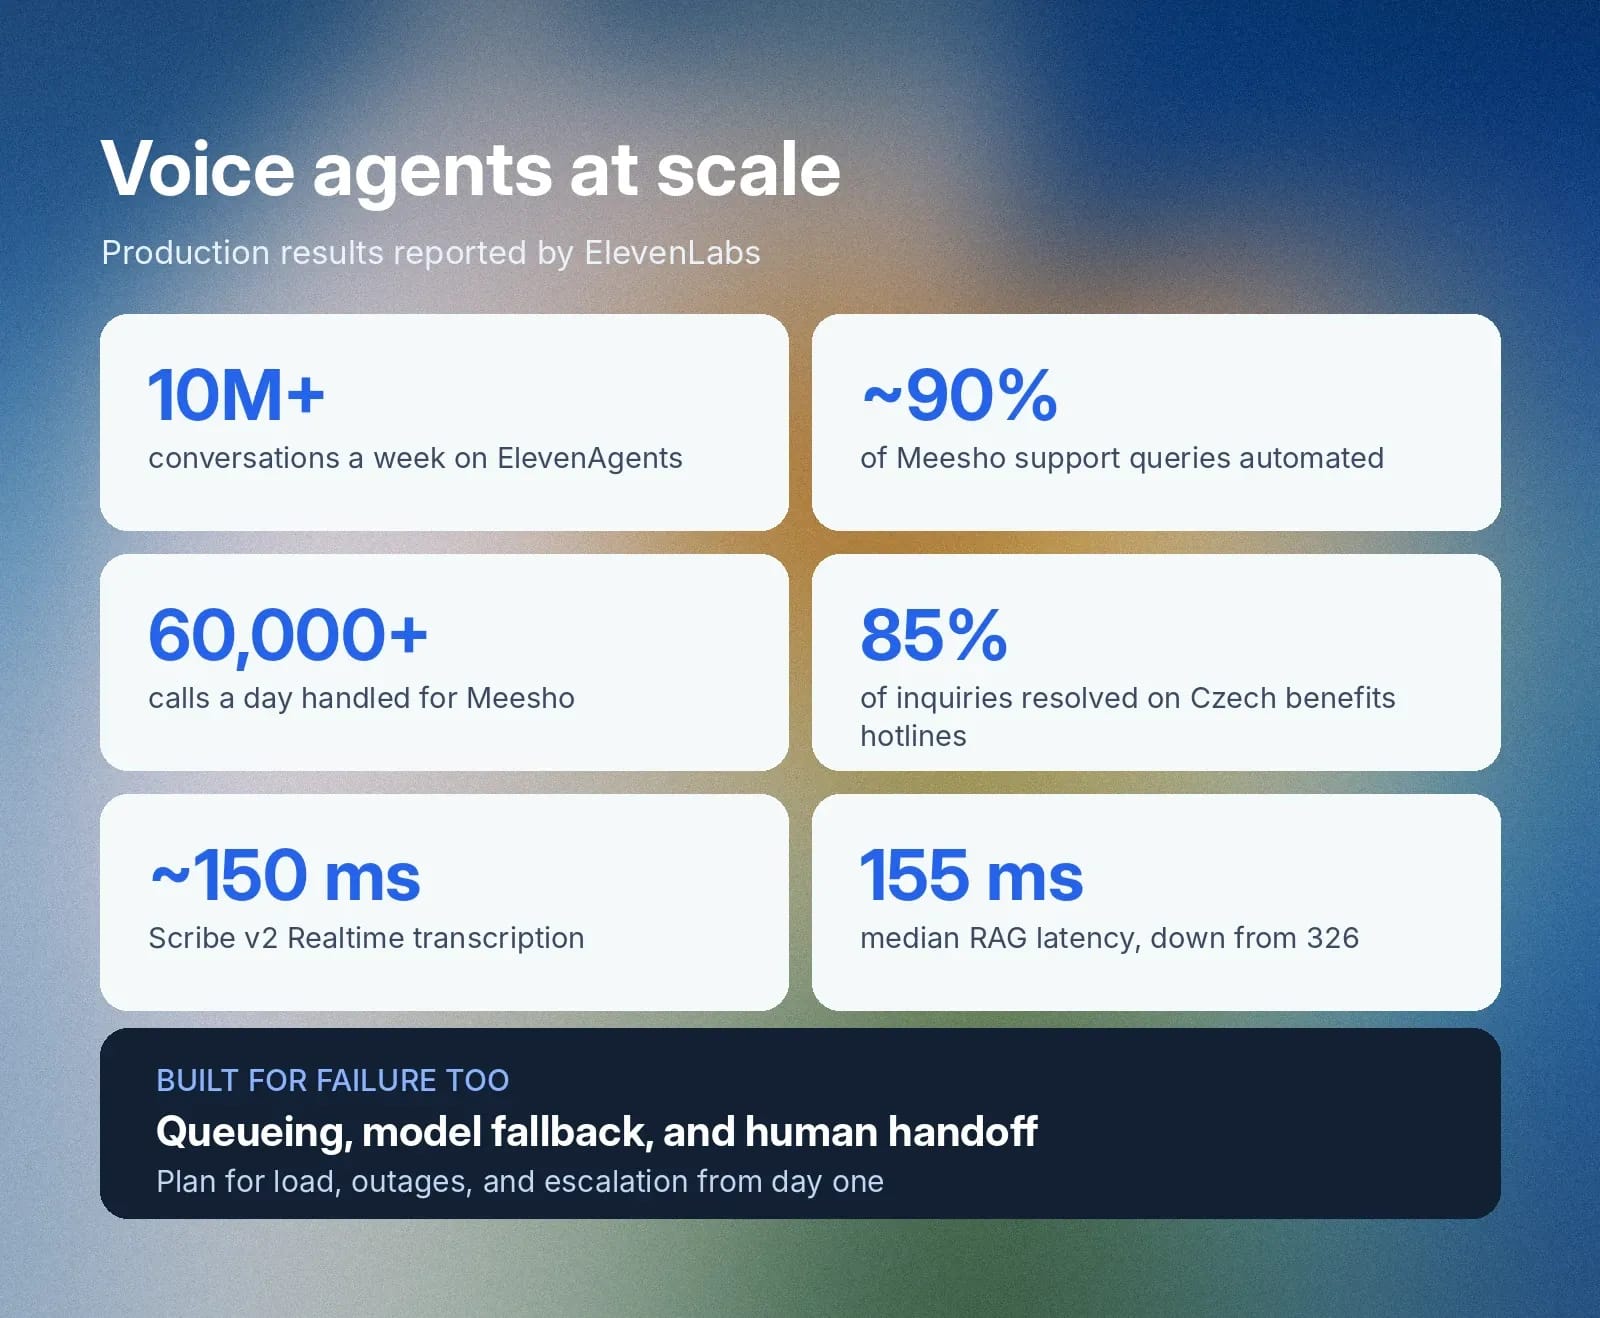
ElevenLabs raportuje wyniki produkcyjne na dużą skalę. ElevenAgents obsługuje ponad 10 milionów rozmów tygodniowo. Według raportu Building Enterprise-grade Voice Agents Meesho automatyzuje około 90% zapytań do wsparcia w ponad 60 000 rozmów dziennie. W Czechach agenci zasilani przez ElevenLabs obsługują około 5 000 rozmów dziennie na krajowych infoliniach świadczeń i samodzielnie rozwiązują 85% zapytań, według raportu State of Conversational Agents in Government.
Planowanie obciążenia, awarii i przekazania od początku odróżnia demo od wdrożenia.
Czego szukać w gotowej do produkcji infrastrukturze głosowej AI w 2026 roku
Użyj tej listy kontrolnej, by ocenić dowolną platformę głosowej AI względem swoich wymagań.
- Rozpoznawanie mowy: dokładne transkrypcje dla twoich języków, akcentów i jakości audio, w tym imion i identyfikatorów.
- Zarządzanie turami: konfigurowalne zachowanie na końcu tury, barge-in i zmierzony czas reakcji na przerwanie.
- Wybór modelu: LLM wybierany dla każdego agenta lub subagenta, opcja własnego LLM i automatyczny fallback.
- Orkiestracja: wieloetapowe workflow i routing między wyspecjalizowanymi agentami.
- Narzędzia: webhooki, narzędzia klienckie, obsługa MCP i kontrola zatwierdzania.
- Wiedza: własne dokumenty z mierzalnym opóźnieniem pobierania.
- Personalizacja: dane rozmówcy dostępne przed wypowiedzeniem pierwszego słowa.
- Głos: krótki czas do pierwszej mowy oraz kontrola wymowy i ekspresji.
- Kanały: telefon, web, urządzenia mobilne i komunikatory, z SDK i API.
- Guardraile: konfigurowalne ograniczenia zachowania o znanym koszcie opóźnienia.
- Testowanie: symulowane rozmowy, sprawdzanie wywołań narzędzi i powtarzane uruchomienia.
- Eksperymenty i analityka: testy A/B, opóźnienie percentylowe i podział błędów.
- Skala i przekazanie: udokumentowana współbieżność, kolejkowanie i eskalacja do ludzi.
Wiodące systemy agentów głosowych AI, takie jak ElevenAgents, oferują wszystkie te komponenty na jednej platformie.
Zacznij już dziś, kontaktując się z zespołem, albo twórz własne systemy agentów AI po założeniu konta.
Najczęściej zadawane pytania o infrastrukturę głosowej AI

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.