
Czym jest wykrywanie aktywności głosowej i jak działa?
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Wykrywanie aktywności głosowej określa, czy krótkie, milisekundowe ramki audio zawierają ludzką mowę. Stosuje się je w wielu aplikacjach do cyfrowego przetwarzania audio, w tym w transkrypcji, telefonii i agentach głosowych.
W tym artykule wyjaśniamy, co robi wykrywanie aktywności głosowej, czego nie robi oraz jak sprawdza się w kluczowych zastosowaniach biznesowych.
Podsumowanie
- Wykrywanie aktywności głosowej (VAD) to podstawowy element nowoczesnych workflow audio. Nieustannie analizuje strumień audio i w każdej milisekundowej ramce określa, czy występuje ludzka mowa.
- VAD informuje kolejne narzędzia audio, kiedy mają działać, a kiedy czekać. Korzystają z niego LLM-y, usługi transkrypcji i inne biznesowe pipeline’y audio.
- Algorytmy wykrywania aktywności głosowej działają w ciągłej pętli pięciu etapów: przechwytują audio, dzielą je na ramki, wyodrębniają cechy głosu, oceniają prawdopodobieństwo obecności mowy i przekazują decyzję kolejnym usługom.
- Początkowo VAD opierał się wyłącznie na matematycznym przetwarzaniu sygnału, aby określić obecność mowy. Współczesne systemy oparte na AI używają sieci neuronowych do tego samego, ale lepiej rozumieją kontekst szumu tła i sygnały semantyczne.
- Systemy VAD klasyfikują tylko to, czy ramka audio zawiera mowę. Nie mówią, kiedy ktoś skończył mówić. Systemy endpointingu wykorzystują VAD i inne narzędzia analizy heurystycznej, aby określić, czy mówca dokończył wypowiedź.
- W firmach VAD pomaga agentom głosowym naturalnie rozmawiać z klientami bez przerywania im, optymalizuje wykorzystanie pasma VoIP, obniża koszty transkrypcji AI z mowy na tekst (STT) i ma wiele innych zastosowań.
- Testuj systemy VAD w rzeczywistych warunkach. Czyste nagrania studyjne nie pozwalają skutecznie ocenić ich możliwości.
Czym jest wykrywanie aktywności głosowej (VAD)?
Wykrywanie aktywności głosowej (VAD) to proces programowy, który klasyfikuje, czy małe fragmenty audio, zwane ramkami, zawierają mowę. Algorytmy VAD działają na strumieniu audio od kilkudziesięciu do setek razy na sekundę i zwracają binarną odpowiedź „tak” lub „nie”, zależnie od tego, czy wykryją mowę.
Stosuje się je w szerszych pipeline’ach cyfrowego audio, takich jak telekomunikacja lub transkrypcja mowy. Informują inne systemy działające dalej w pipeline’ie, takie jak ASR/STT, LLM-y i systemy planowania tur rozmowy, czy mają aktywnie nasłuchiwać strumienia audio, czy czekać.
VAD to nie to samo co automatyczne rozpoznawanie mowy (ASR). System VAD jedynie zwraca probabilistyczną odpowiedź tak/nie na pytanie, czy wykrywa mowę. Nie zwraca konkretnych słów. Jego głównym zadaniem jest informowanie kolejnych systemów, czy mają przetwarzać daną ramkę audio.
Jak działają algorytmy wykrywania aktywności głosowej?
Algorytm VAD analizuje strumień audio i podejmuje decyzję tak/nie, czy dana ramka audio, zwykle trwająca 10–30 milisekund, zawiera mowę.
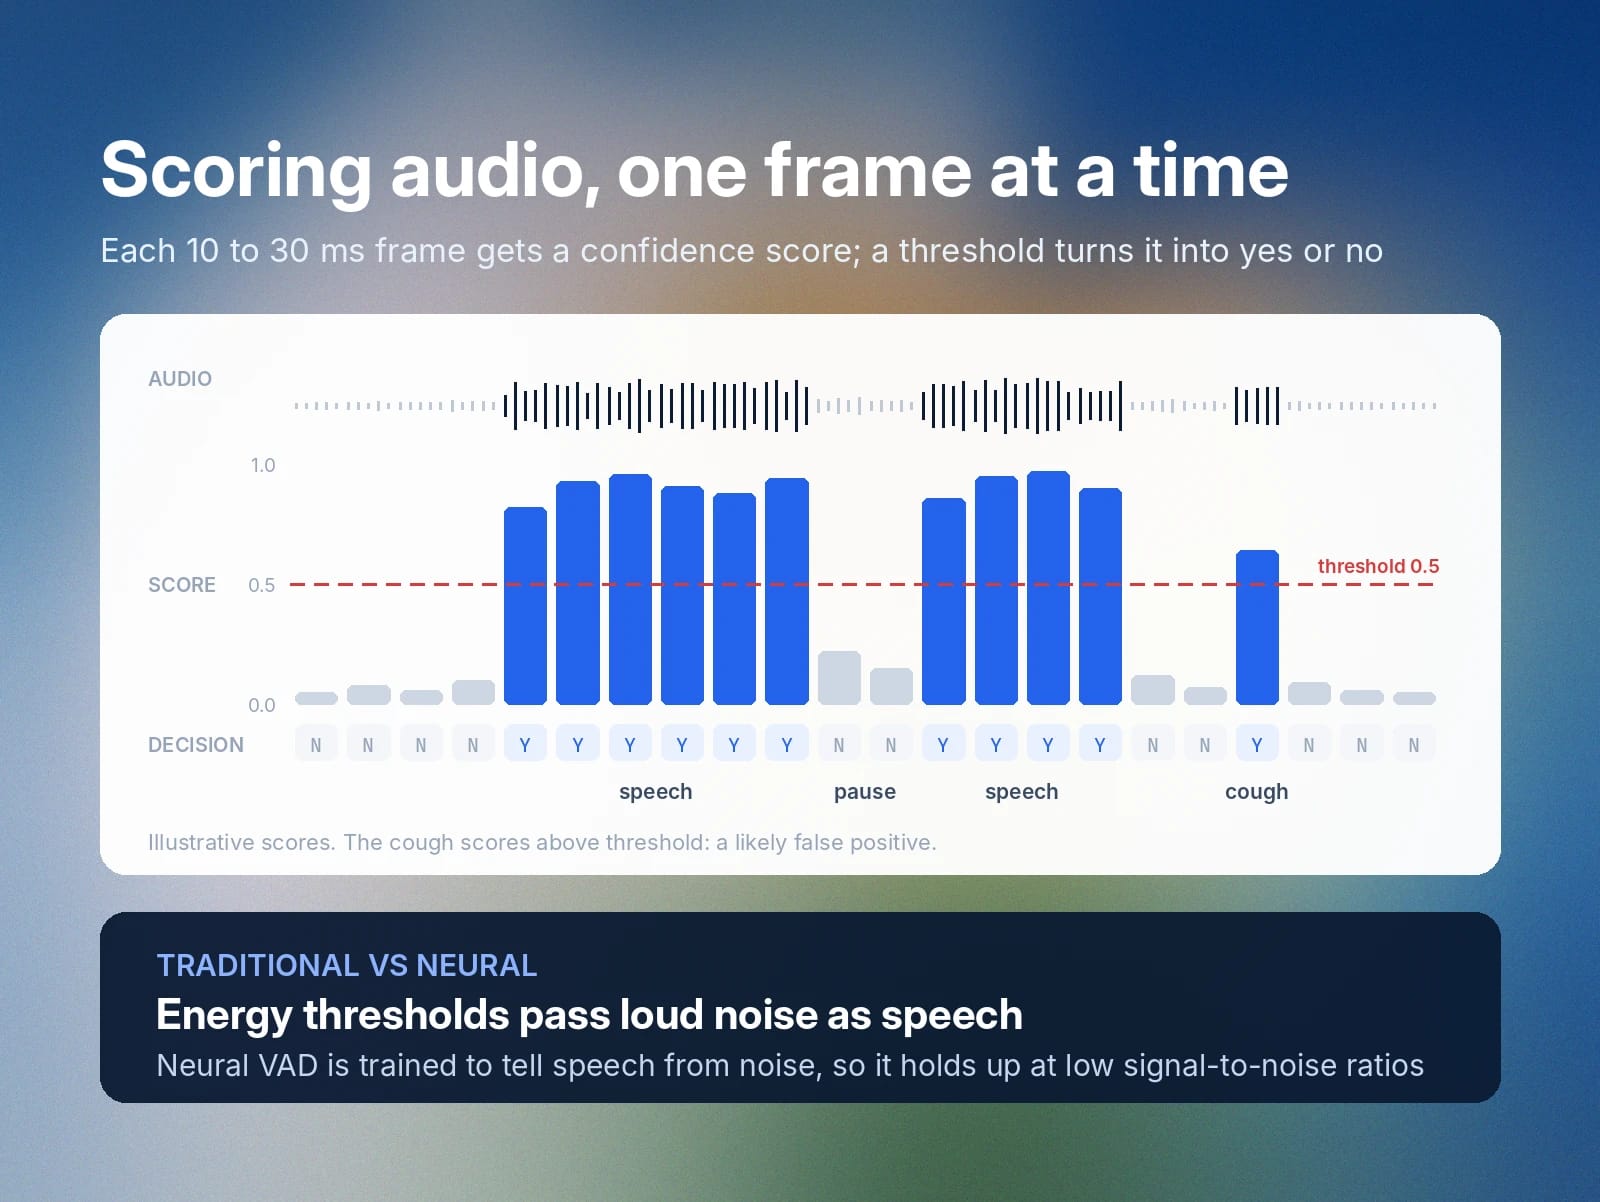
Działają nieprzerwanie w pętli pięciu etapów:
- Przechwytywanie głosu: System korzystający z VAD odbiera strumień audio przez WebRTC lub telefonię i stosuje podstawowe filtrowanie szumów.
- Dzielenie na ramki: Algorytm dzieli surowy strumień audio na jednolite ramki.
- Ekstrakcja cech: Algorytm wyodrębnia ze strumienia cechy akustyczne, które może zapisać matematycznie jako dane cyfrowe.
- Ocena: System przekazuje wyodrębnione cechy ramki do algorytmu VAD, aby wygenerować ocenę pewności od 0 do 1, określającą, czy zawiera mowę (0 = „brak mowy”, 1 = „mowa”).
- Decyzja o stanie: System VAD przekazuje ocenę pewności do pipeline’u audio, w którym działa, aby ten mógł zdecydować, jak ją obsłużyć.
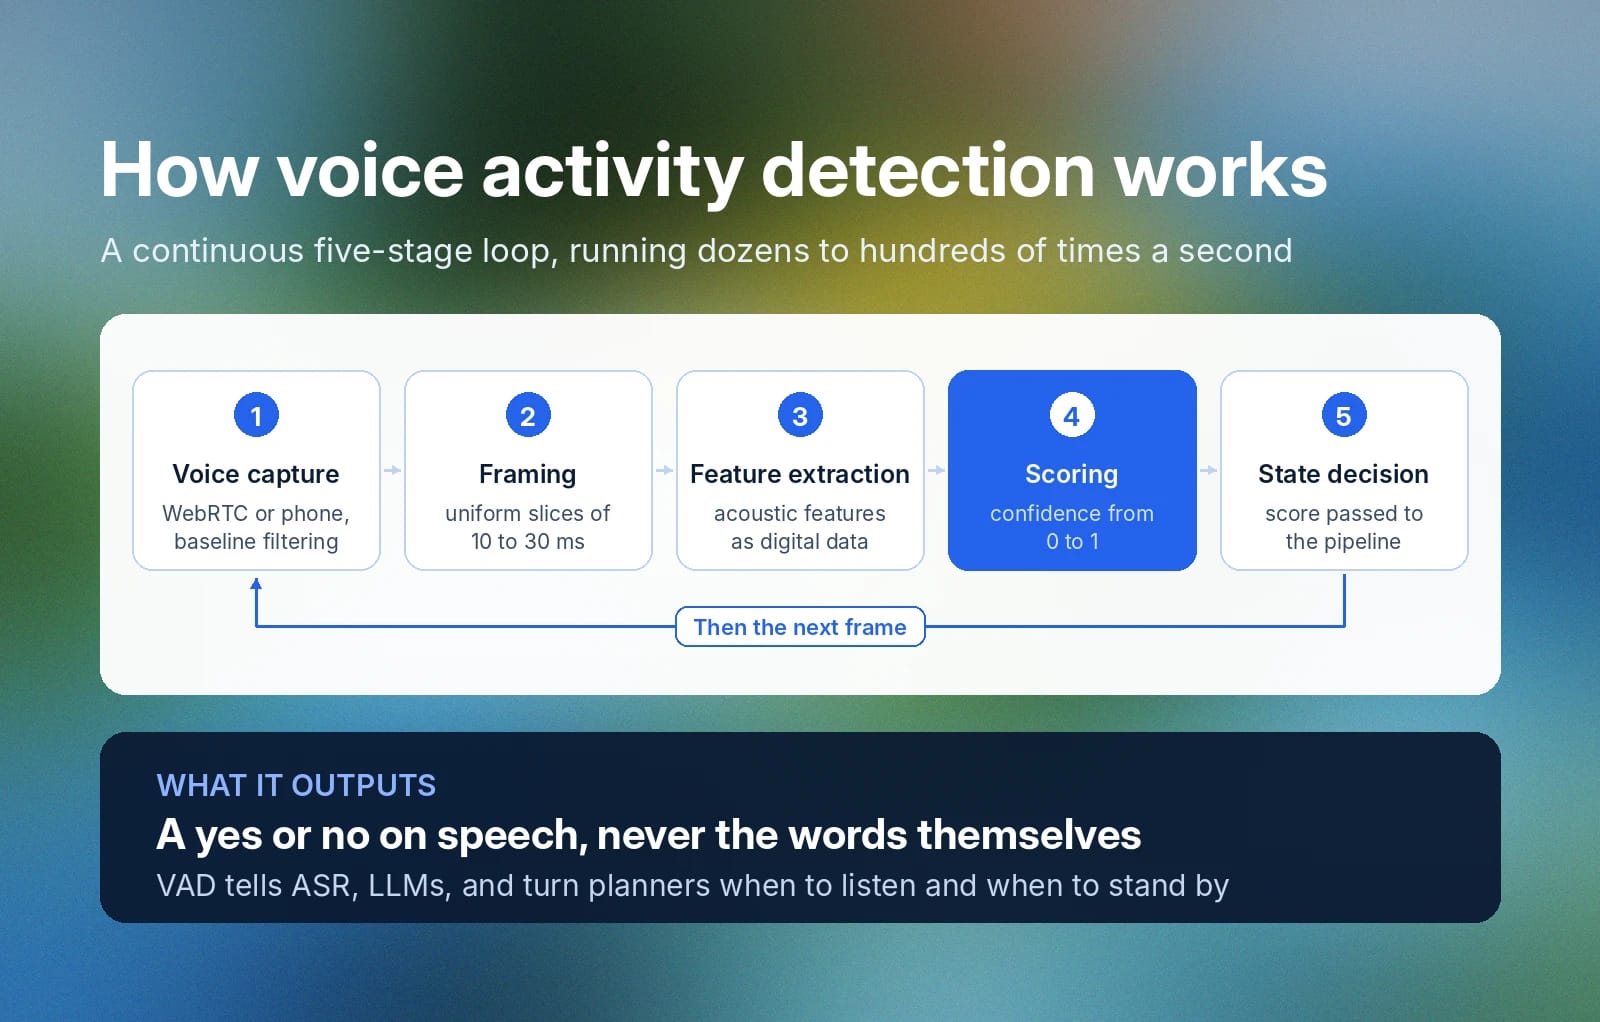
Tradycyjne wykrywanie aktywności głosowej a VAD oparty na AI
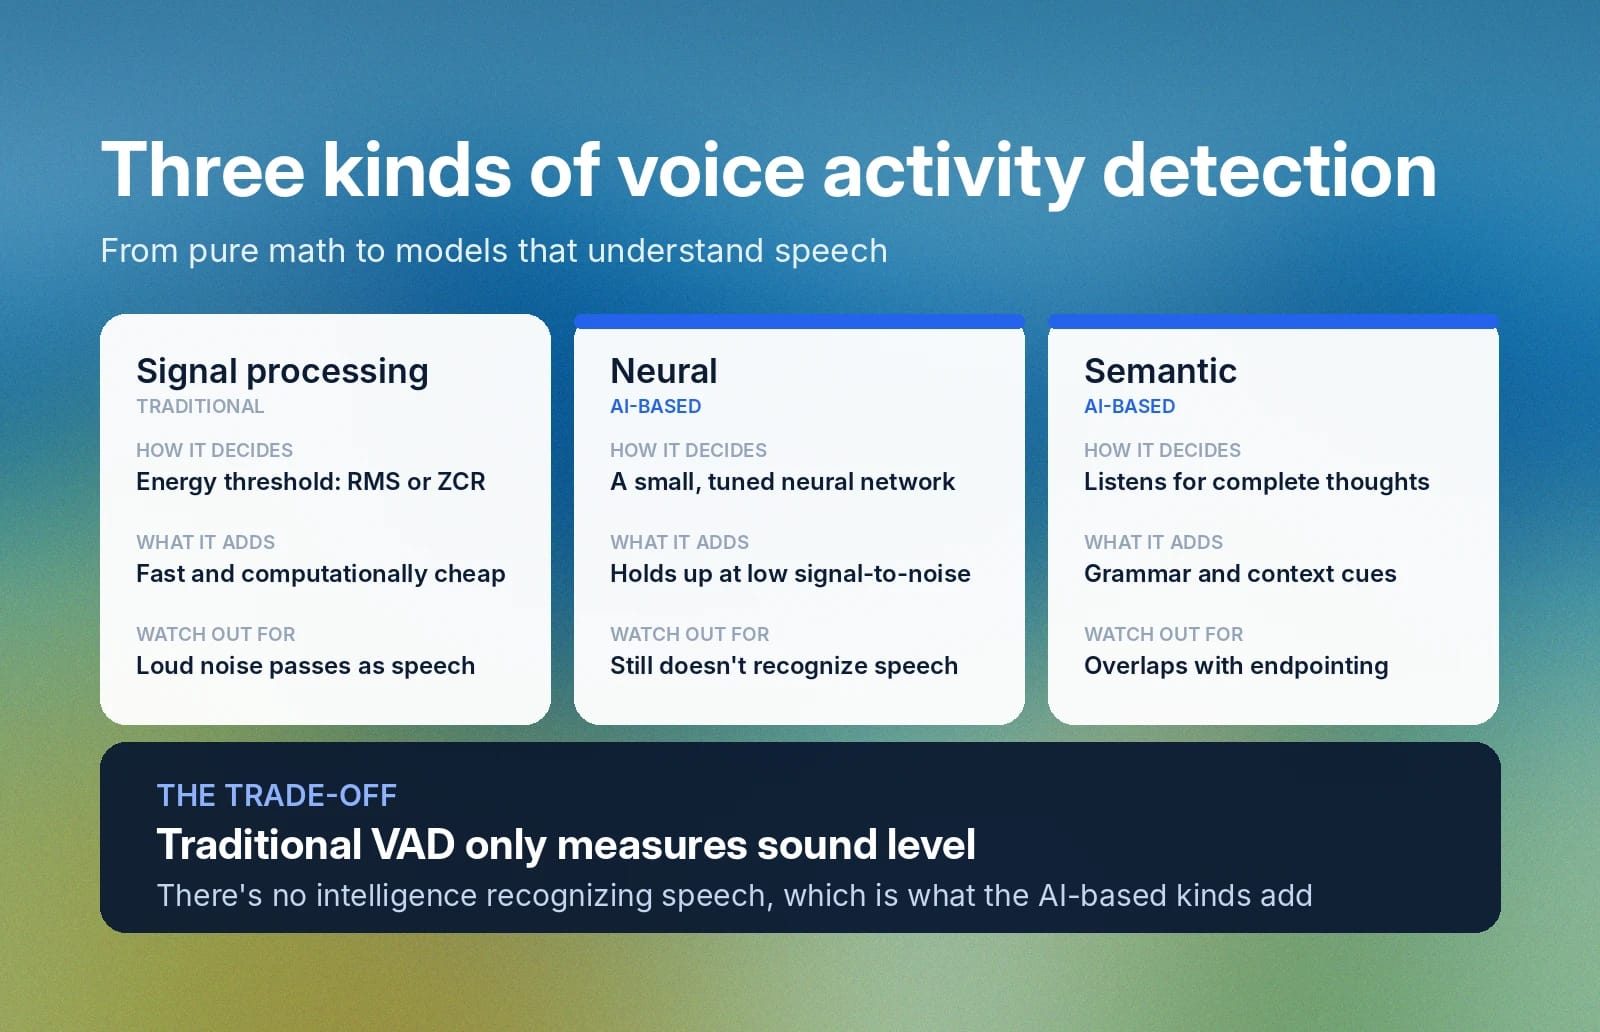
VAD dzieli się na dwie główne kategorie: przetwarzanie sygnału i AI.
W VAD opartym na AI są dwa odrębne podejścia, co łącznie daje trzy rodzaje wykrywania aktywności głosowej.
Przyjrzyjmy się im bliżej.
Tradycyjny VAD (przetwarzanie sygnału)
Tradycyjna technologia VAD mierzy poziom energii strumienia audio i potwierdza obecność mowy, jeśli przekroczy on określony próg. Opiera się wyłącznie na matematyce — często na obliczeniu średniej kwadratowej (RMS) lub współczynnika przejść przez zero (ZCR). Jeśli wartość ramki przekracza próg, uznaje się ją za mowę. Jeśli nie — nie.
Tradycyjny VAD jest szybki i tani obliczeniowo, ale mierzy tylko poziom dźwięku w audio. Głośny szum tła może powodować fałszywe alarmy. System faktycznie nie rozpoznaje mowy.
VAD oparty na AI
Istnieją dwa nowsze typy VAD opartego na AI: neuronowy i semantyczny. Zamiast czysto matematycznego progu, neuronowy VAD używa małej, precyzyjnie dostrojonej sieci neuronowej, aby określić, czy ramka audio zawiera mowę czy ciszę. Dzięki treningowi rozumie różnicę między mową a szumem, więc działa lepiej niż tradycyjny VAD, gdy strumień audio ma niski stosunek sygnału do szumu (SNR), czyli występuje w nim dużo szumu tła.
Wadą neuronowego VAD jest to, że nadal nie rozpoznaje samej mowy. Semantyczny VAD oparty na AI to inny wariant, który to potrafi. Częściowo pokrywa się z endpointingiem, ponieważ sprawdza, czy wypowiadana myśl jest kompletna. Potrafi rozpoznać na podstawie gramatyki i kontekstu, czy mówca może jeszcze coś powiedzieć.
VAD a endpointing
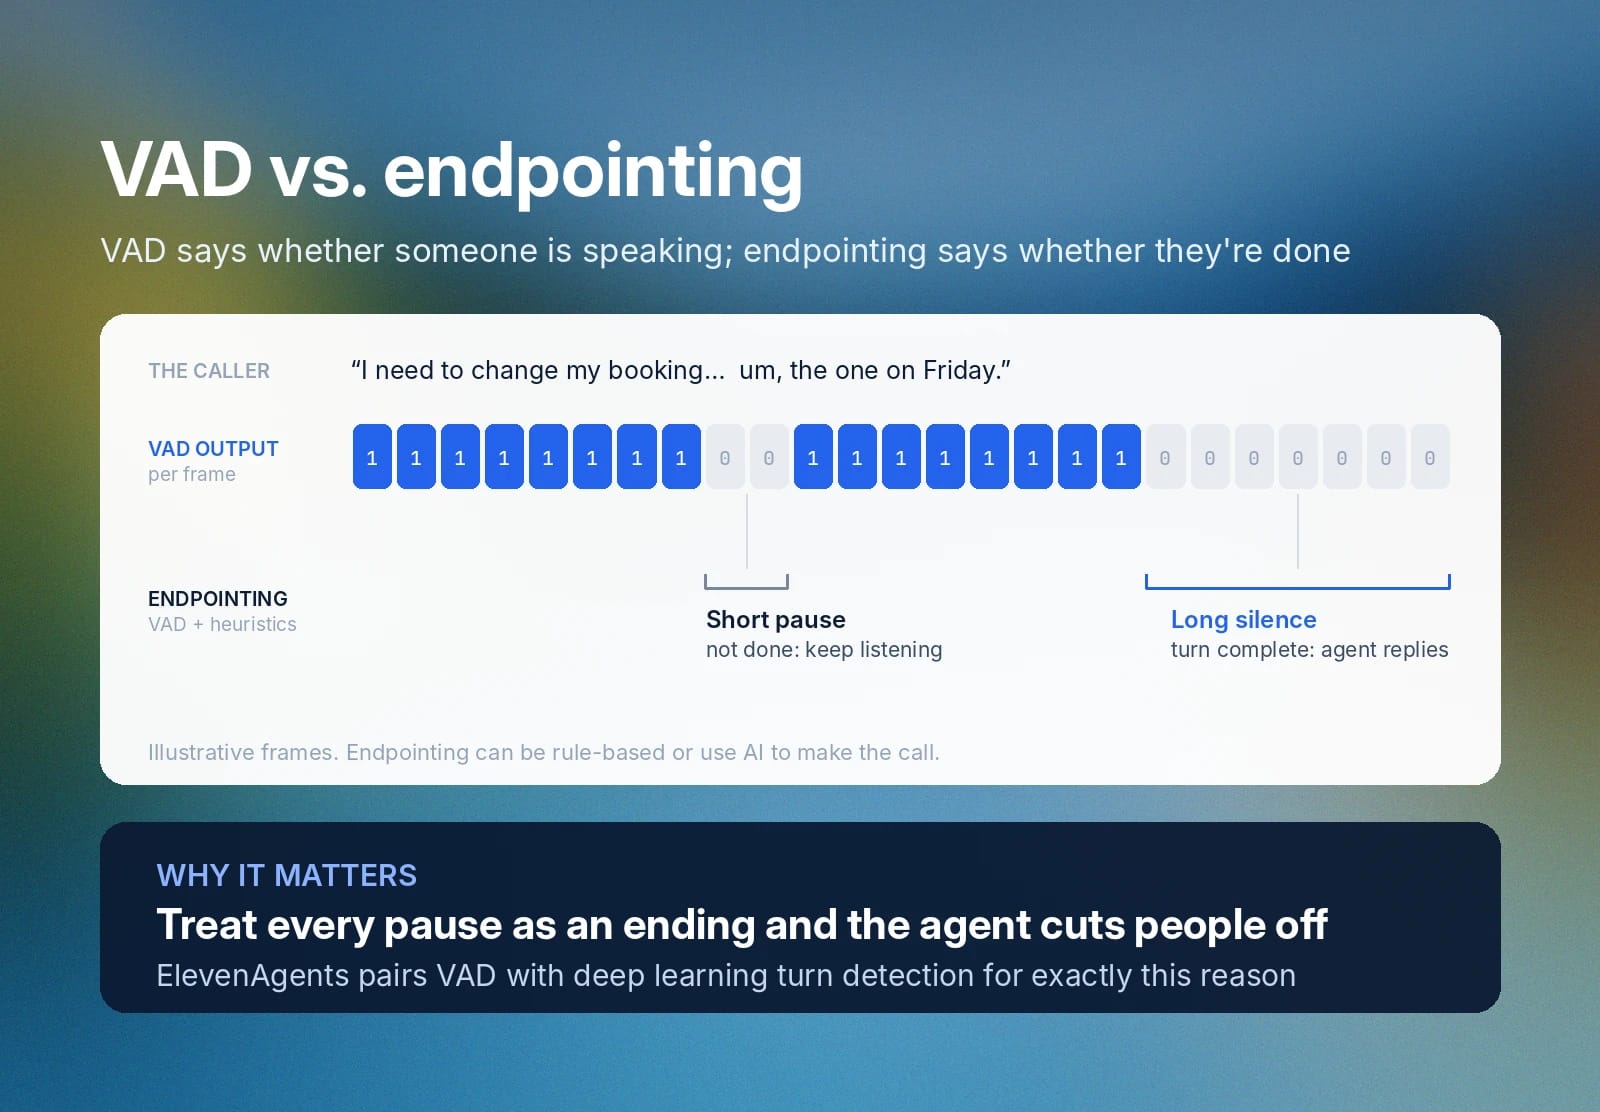
VAD i endpointing to uzupełniające się technologie. System wykrywania aktywności głosowej po prostu określa, czy ktoś mówi w każdej przetwarzanej ramce audio. Podejmuje binarną decyzję tak/nie i przekazuje ją do dalszej części pipeline’u przetwarzania audio.
System endpointingu wykorzystuje dane wyjściowe VAD w połączeniu z analizą heurystyczną, aby ustalić, czy mówca skończył wypowiedź. Może używać do tego opartego na regułach przetwarzania sygnału lub AI.
Zastosowania wykrywania aktywności głosowej w AI czasu rzeczywistego
Wykrywanie aktywności głosowej jest ważne w wielu zastosowaniach.
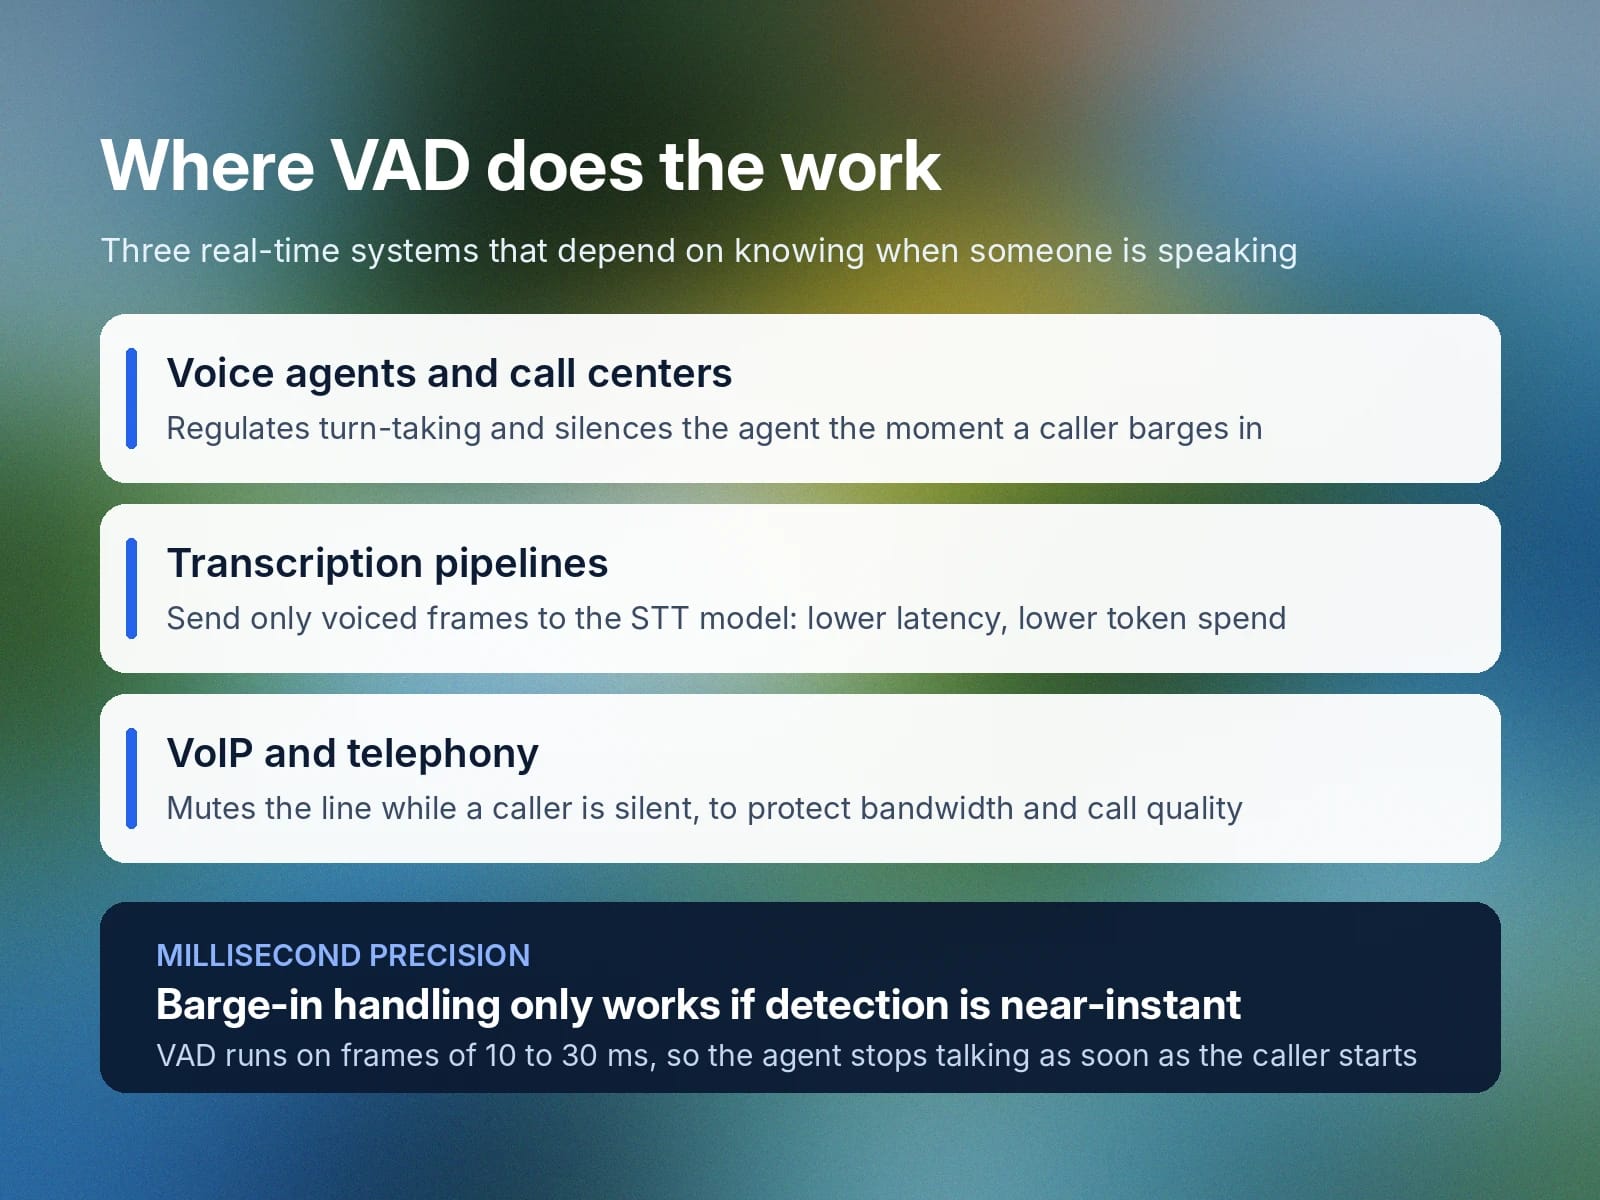
Autonomiczni agenci głosowi i call center
Autonomiczny agent obsługujący rozmowy klientów musi wiedzieć, kiedy powinien odpowiedzieć. Nie chcesz, aby agent przerywał klientowi w połowie zdania ani mówił dalej, gdy klient odezwie się wcześniej. VAD pomaga zarządzać kolejnością wypowiedzi w rozmowie i utrzymać naturalny przebieg interakcji. Ponieważ działa z dokładnością do milisekundy, skutecznie obsługuje też sytuacje, gdy klient przerywa agentowi, wyciszając go, gdy klient mu przerwie.
Pipeline’y transkrypcji
Jeśli korzystasz z Text to Speech usługi transkrypcji API, takiej jak ElevenAPI, możesz filtrować wysyłane do niej audio za pomocą wykrywania aktywności głosowej, aby model przetwarzał tylko ramki z mową. Zmniejsza to opóźnienia sieciowe, a co ważniejsze — zużycie tokenów przez model transkrypcji. Nie wydasz budżetu na AI na szum tła.
Optymalizacja VoIP i telefonii
Opóźnienia mogą też wpływać na jakość rozmów w firmowych sieciach VoIP. Aby zoptymalizować działanie, te cyfrowe systemy audio tymczasowo wyciszają linię z użyciem VAD, gdy rozmówca nie mówi.
Co utrudnia wykrywanie aktywności głosowej?
Tradycyjne wykrywanie aktywności głosowej opiera się na algorytmach matematycznych, które określają, czy występuje mowa. Jednak ludzkie wzorce mówienia są nieuporządkowane. Rozmowy często są nieregularne, przerywane i odbywają się w rzeczywistych warunkach — przy szumie tła, a nawet równoległych rozmowach. Główne wyzwanie VAD to rozpoznanie istotnej ciszy w zaszumionym audio.
W praktyce oznacza to kilka konkretnych wyzwań.
Pauzy w środku zdania
Ludzie nie mówią w stałym rytmie przez całą rozmowę. Robią przerwy, zbierają myśli, zmieniają zdanie podczas mówienia i tracą wątek. Żadna z tych pauz nie oznacza, że mówca skończył. Dla ludzi zwykle jest to łatwe do zrozumienia, ale dla oprogramowania — nawet nowszych modeli AI — może być trudne.
Systemy VAD, które mylą te pauzy z końcem wypowiedzi, mogą przyciąć zdanie w trakcie transakcji lub sprawić, że agent głosowy przerwie ludzkiemu rozmówcy.
Dźwięki głosowe
Cicha mowa, słabnące końcowe spółgłoski (częste na końcu zdania) oraz cechy takie jak fry vocal mogą sprawić, że systemy VAD pominą prawidłową mowę.
Nieprzewidywalna akustyka
Ciągły biały szum tła, np. wentylator lub bieżąca woda, systemy VAD stosunkowo łatwo odfiltrowują. Sporadyczny hałas, np. szczekanie psa, może jednak zostać oznaczony jako pozorna mowa.
Silna kompresja audio ogranicza zakres dynamiczny i może utrudnić VAD odróżnianie ramek ciszy od ramek mowy.
Jak oceniać działanie VAD
Ludzka mowa jest nieuporządkowana, zwłaszcza gdy nagrywa się ją w dynamicznych, rzeczywistych warunkach. Czyste nagrania audio nie są dobrym sposobem na testowanie działania VAD. Sama dokładność zamiany mowy na tekst też nie mierzy bezpośrednio skuteczności VAD, bo dotyczy etapu następującego po wykrywaniu przez VAD.
Fałszywe alarmy a fałszywe pominięcia
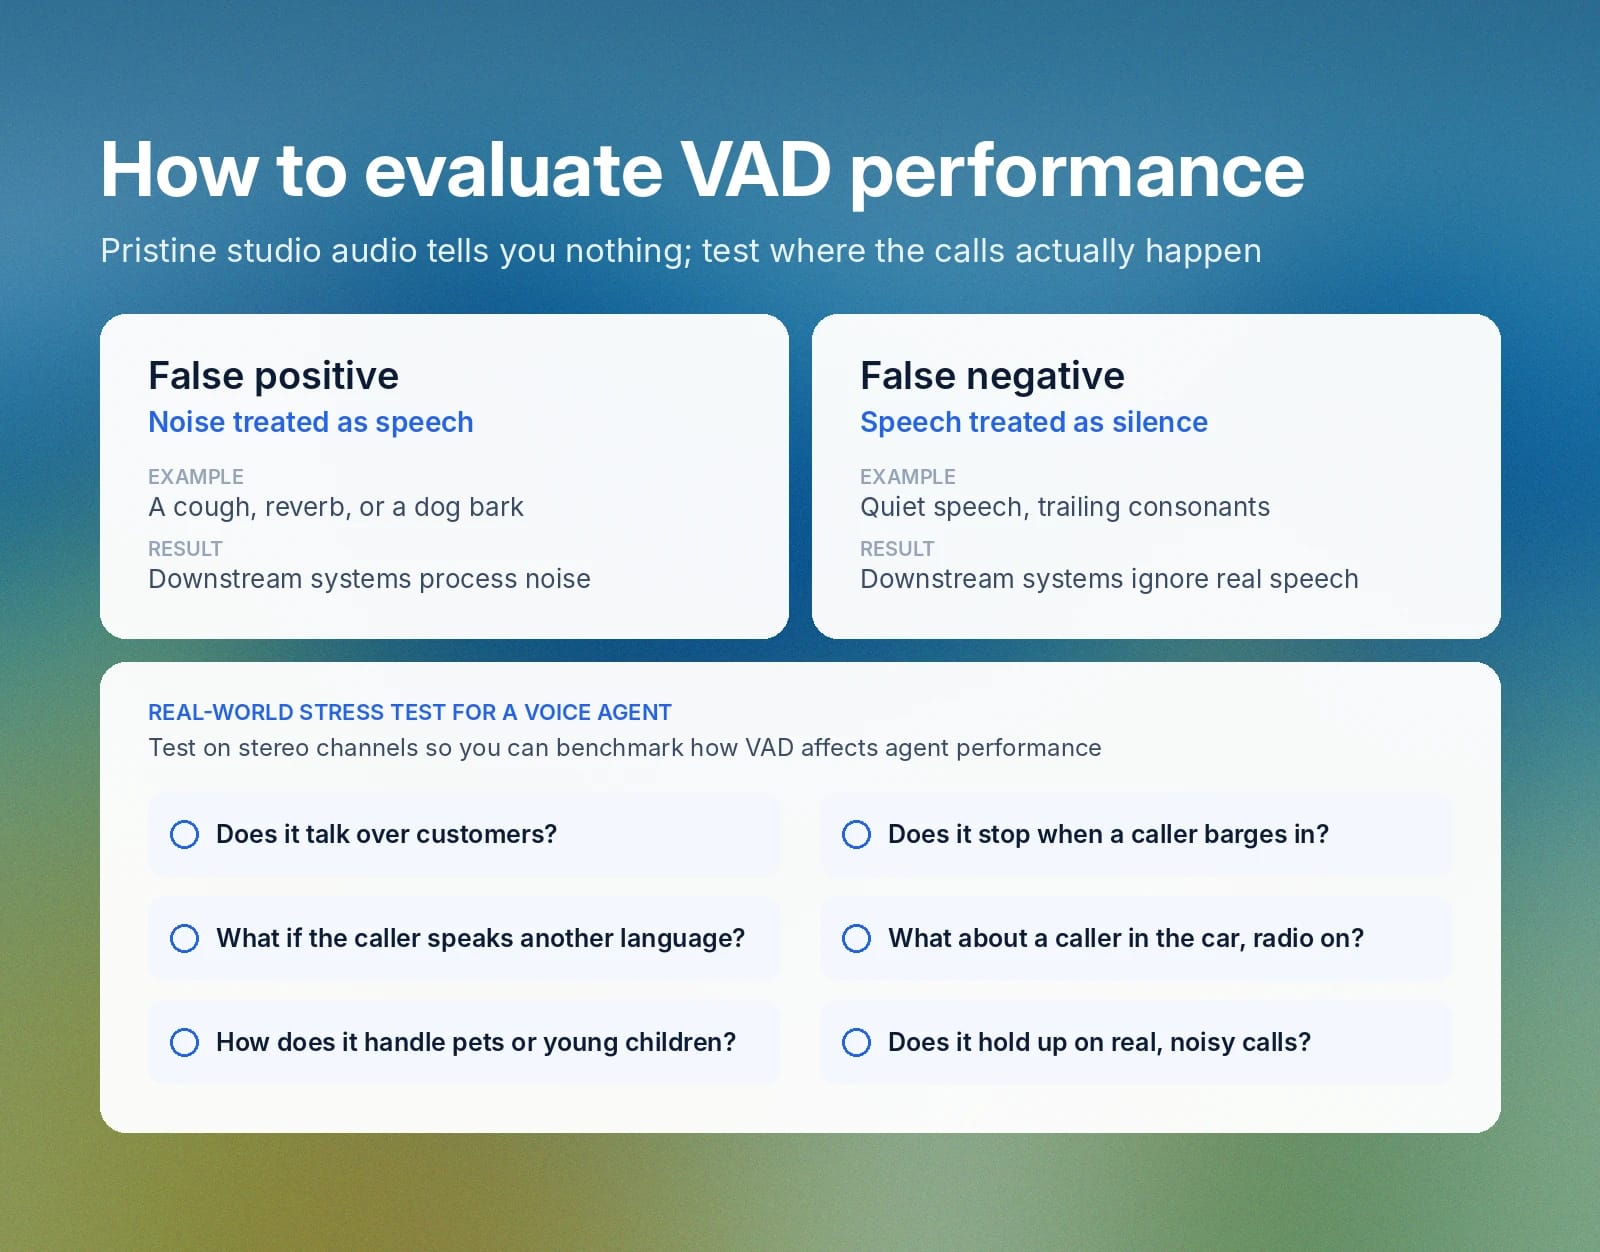
Fałszywe alarmy VAD to szum uznany za mowę. Kaszel, pogłos, szczekanie psa i każdy inny nagły hałas w tle mogą je wywołać, przez co zostaną przypadkowo przekazane jako ramki mowy.
Fałszywe pominięcia to mowa uznana za ciszę. VAD omyłkowo informuje kolejne usługi, aby ignorowały ramki audio.
Testy obciążeniowe w rzeczywistych warunkach
Aby ocenić usługę VAD, sprawdź, jak działa w środowiskach, w których audio będzie nagrywane, oraz w rzeczywistych warunkach.
Na przykład jeśli zamierzasz używać VAD w agencie głosowym, przetestuj go na kanałach stereo, aby porównać jego wpływ na działanie agenta. Mogą pojawić się pytania takie jak:
- Czy fałszywe pominięcia sprawiają, że agent mówi jednocześnie z klientami?
- Czy system zatrzymuje agenta, gdy użytkownik mu przerwie?
- Co się dzieje, jeśli rozmówca mówi w obcym języku?
- Jak system działa podczas nasłuchiwania rozmówców dzwoniących z rzeczywistych środowisk?
- Co się dzieje, gdy klient dzwoni z samochodu, ale nie ściszy radia?
- Jak radzi sobie z hałasem w tle powodowanym przez zwierzęta lub małe dzieci?
Wszystkie te sytuacje mogą wystąpić podczas rozmów z klientami. VAD musi je rozpoznawać i dobrze działać pod obciążeniem.
Zacznij korzystać z ElevenAgents w obsłudze klienta
ElevenAgents używa hybrydowego systemu VAD i wykrywania tur rozmowy z wykorzystaniem deep learningu, aby rozmowy z agentami przebiegały płynnie i naturalnie.
Zacznij tworzyć nowego agenta obsługi klienta z ElevenAgents już dziś. Zarejestruj się i zacznij.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.



