Czym jest automatyczne rozpoznawanie mowy (ASR)?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
W 1952 roku najbardziej zaawansowany system rozpoznawania mowy na świecie rozumiał dokładnie 9 słów.
Około 75 lat później automatyczne rozpoznawanie mowy (ASR) transkrybuje dziesiątki języków w czasie rzeczywistym — od asystentów głosowych w telefonie po napisy pojawiające się w transmisjach na żywo.
Ten przewodnik omawia technologię, która wypełniła lukę między rozwiązaniami z 1952 roku a współczesnymi. Wyjaśnia, czym jest ASR, jak zamienia mowę na tekst i jak nadal się rozwija.
Podsumowanie:
- ASR to automatyczne rozpoznawanie mowy — technologia, która zamienia nagraną mowę na tekst.
- Pierwsza forma ASR powstała w 1952 roku, a systemy deep learning osiągnęły wyniki porównywalne z ludzkimi pod koniec lat 2010.
- Nowoczesne ASR wykorzystuje kompleksowe sieci neuronowe trenowane na milionach godzin audio.
- Wskaźnik błędów słów (WER) to standardowa miara dokładności, ale w produkcyjnym ASR liczą się też opóźnienie, jakość diarizacji i rozumienie kontekstu.
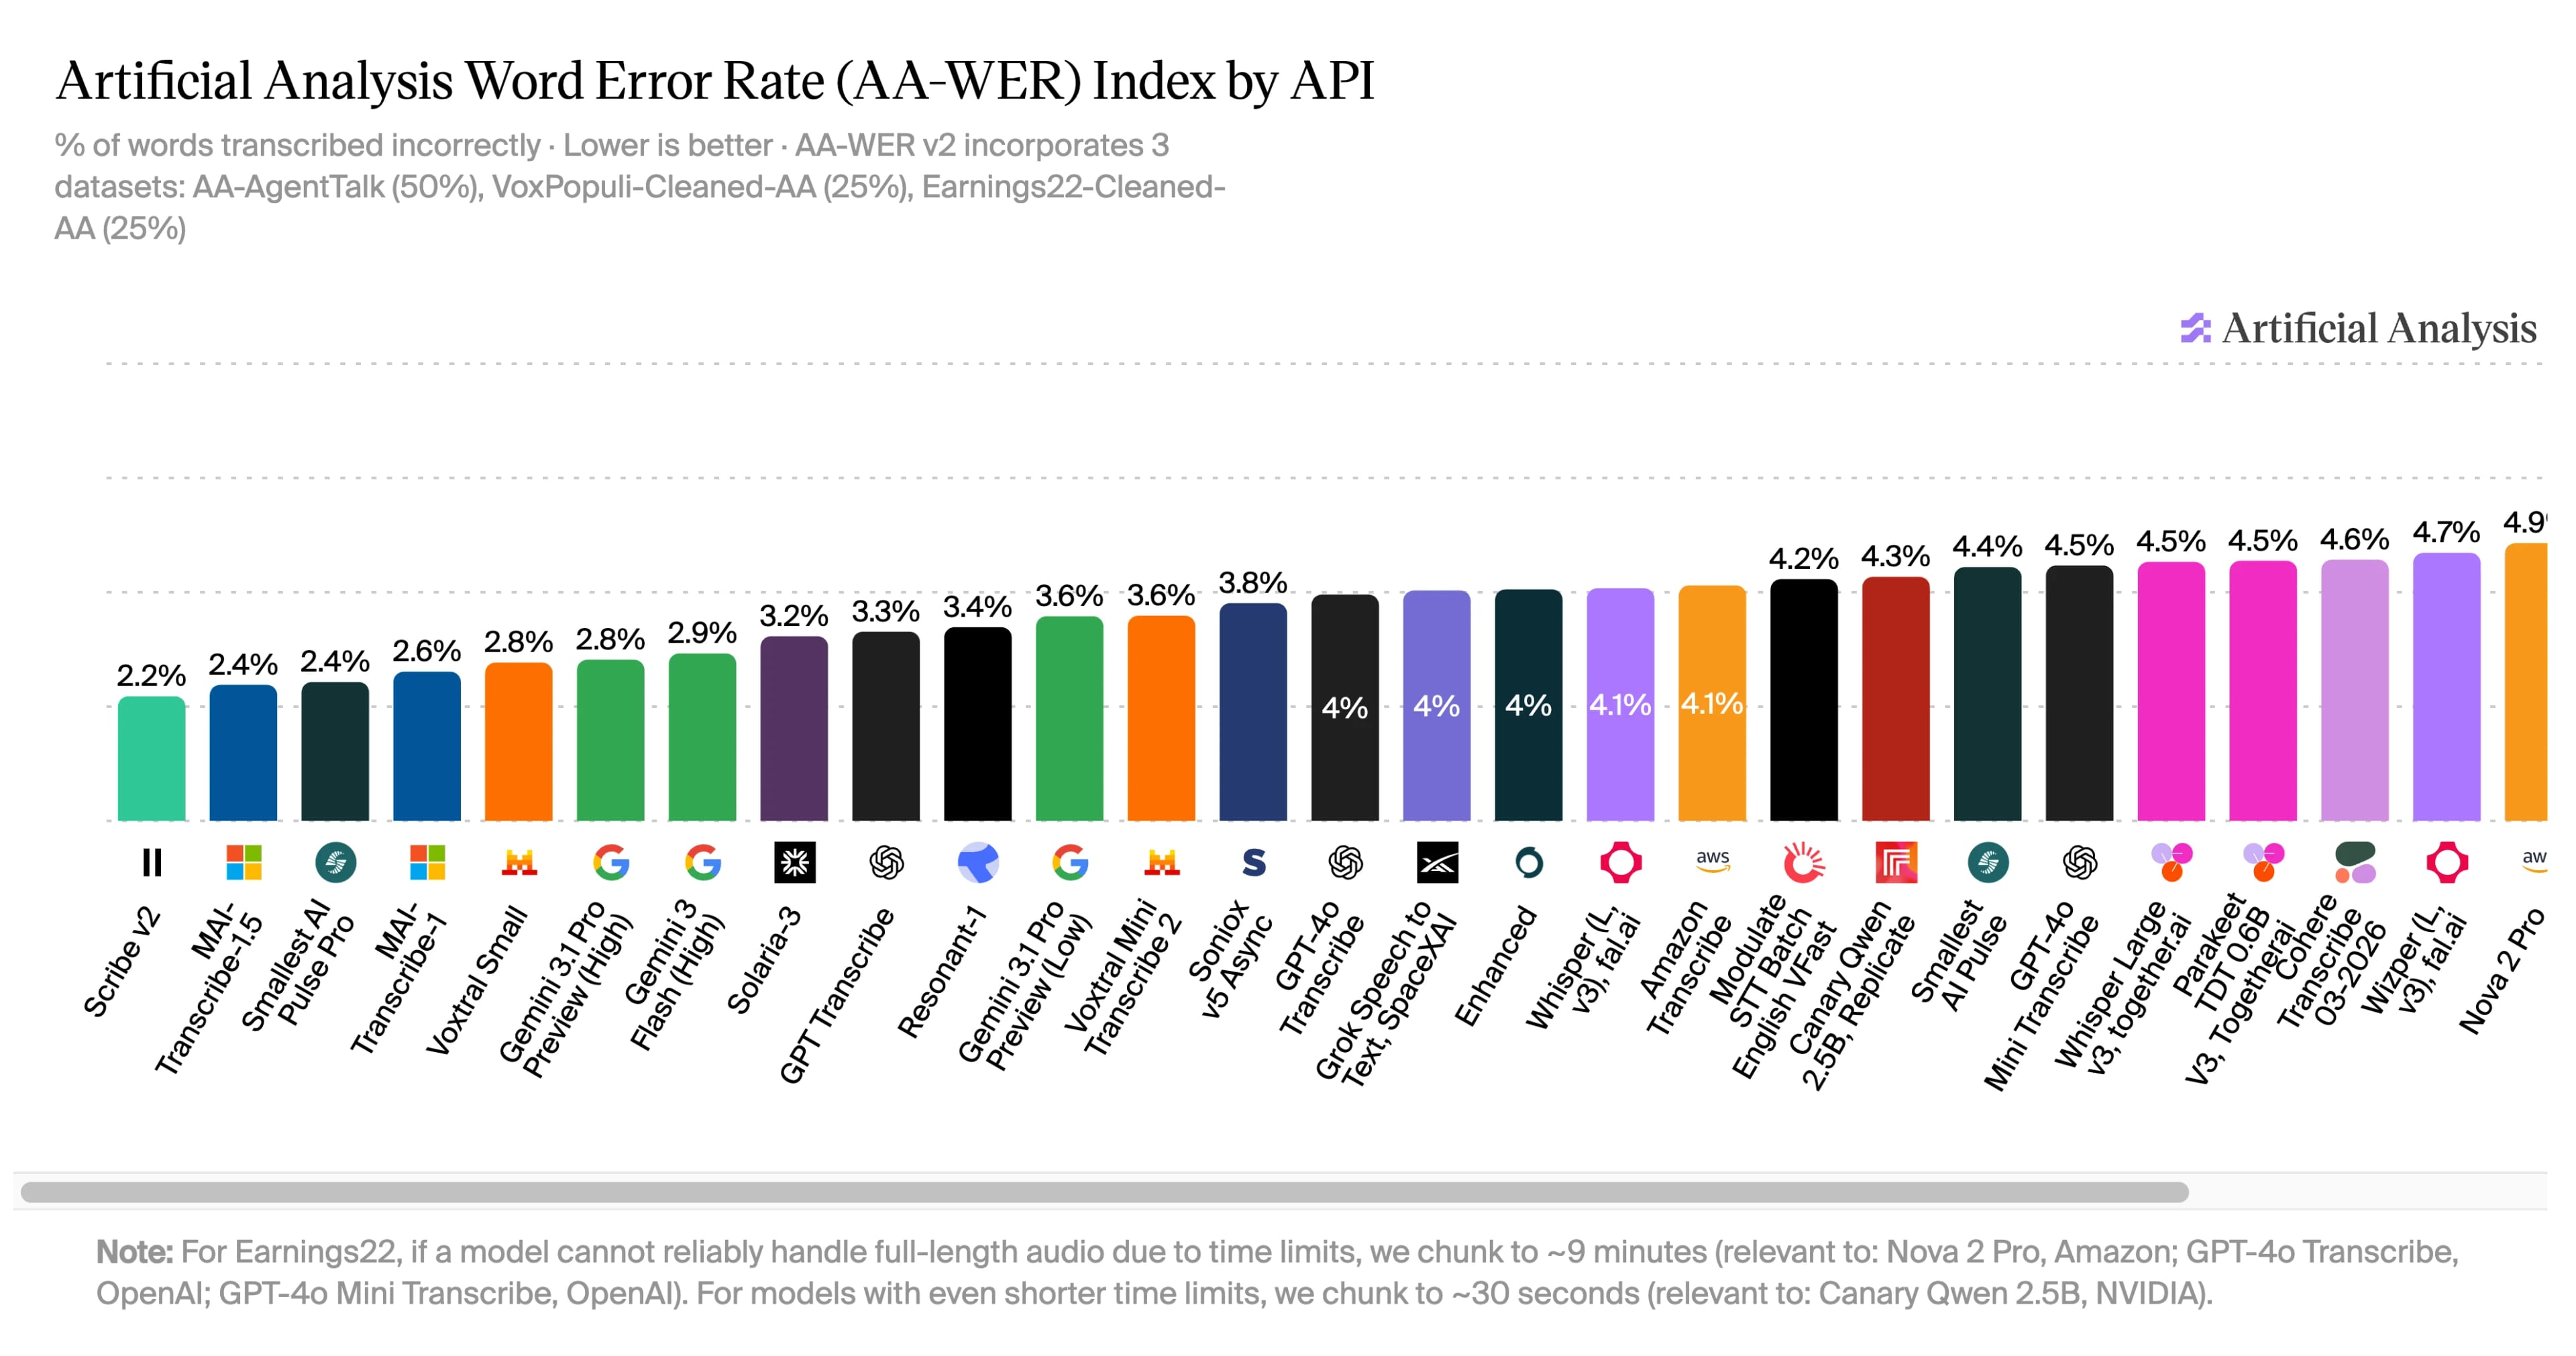
- ElevenAPI zapewnia deweloperom ASR klasy produkcyjnej, niezależnie ocenione przez Artificial Analysis na poziomie 2,2% wskaźnika błędów słów — najniższym wyniku w jego indeksie (lipiec 2026).
Czym jest automatyczne rozpoznawanie mowy (ASR)?
Automatyczne rozpoznawanie mowy, często określane skrótem ASR, to oprogramowanie, które słucha ludzkiej mowy i zamienia ją na dokładny tekst odczytywalny przez maszyny. Często mówi się o nim też jako o zamianie mowy na tekst i rozpoznawaniu mowy, a czasem także o komputerowym rozpoznawaniu mowy.
ASR jest tak powszechne, że możesz korzystać z niego codziennie, nawet tego nie zauważając. Gdy dyktujesz wiadomość, pytasz asystenta głosowego, czytasz napisy podczas transmisji na żywo lub poruszasz się po systemie interaktywnej obsługi telefonicznej, korzystasz z ASR.
Choć zamiana mowy na tekst i ASR są często używane jako synonimy (i są ze sobą ściśle związane), nie oznaczają dokładnie tego samego. ASR to technologia, która rozpoznaje, co zostało powiedziane, a STT to praktyczne zastosowanie tej technologii. Oprogramowanie do rozpoznawania głosu działa na bazie ASR i określa, kto wypowiedział dane słowo, co stanowi podstawę funkcji diaryzacji mówców.
To drobne różnice, ale warto je znać, jeśli chcesz zintegrować systemy ASR/STT/rozpoznawania głosu ze swoją aplikacją lub stroną internetową.
Krótka historia technologii automatycznego rozpoznawania mowy
Technologia automatycznego rozpoznawania mowy jest znacznie starsza, niż większość osób sądzi — jej pierwsze wersje powstały w latach 50. XX wieku. W ciągu ponad 70 lat istnienia ASR przeszło przez kilka ważnych etapów, które w dużej mierze ukształtowały jego rozwój.
Oto najważniejsze etapy rozwoju technologii ASR:
- 1952 i pierwsze ASR: W 1952 roku Bell Laboratories stworzyło Automatic Digit Recognizer, znany jako AUDREY, który rozumiał cyfry od jednego do dziewięciu. Narzędzie było dokładne tylko w około 90% i działało wyłącznie, gdy korzystał z niego jego twórca, więc miało bardzo ograniczone zastosowanie. Mimo że dzieli je przepaść od dzisiejszych możliwości, samo rozpoznawanie cyfr 1–9 było imponującym osiągnięciem.
- Lata 60. i 70. oraz rosnący zasób słów ASR: W kolejnych dekadach laboratoria na całym świecie, m.in. IBM, University College London i japońskie NEC, tworzyły modele podobne do AUDREY w różnych zastosowaniach. Raj Reddy, doktorant ze Stanfordu pochodzący z Indii, stworzył rozpoznawanie samogłosek na potrzeby doktoratu, kładąc podwaliny pod ciągłe rozpoznawanie mowy bez przerw między słowami. DARPA (Defense Advanced Research Projects Agency) finansowała w tym okresie badania, które doprowadziły do powstania Beam Search — metody tworzenia i dekodowania zdań, kluczowej dla rozpoznawania ponad 1000 słów do 1976 roku.
- Lata 80. do początku lat 2010 — postępy statystyczne: W 1987 roku doktorant Raja Reddy’ego, wówczas już profesora, połączył ukryte modele Markowa z Beam Search, umożliwiając działanie systemów ASR bez trenowania na głosie konkretnej osoby. Ten przełom radykalnie skrócił czas trenowania systemów rozpoznawania mowy. W 1997 roku Dragon Systems wydało pierwszy komercyjnie dostępny system ASR, NaturallySpeaking Preferred. Rozpoznawał 100 słów na minutę i dobrze się sprzedawał.
- Współczesność i deep learning: W latach 2010 badacze wykazali, że pojedyncza sieć neuronowa trenowana kompleksowo na audio i transkrypcjach przewyższa czysto statystyczny proces. Dzięki głębokim sieciom neuronowym ASR osiągnęło wyniki zbliżone do ludzkich, ze wskaźnikiem błędów od 5% do 10%. Wtedy na rynek trafiły asystenty głosowe, takie jak Alexa i Siri.
Od tego czasu ASR staje się coraz dokładniejsze i powszechniejsze. W lipcu 2026 roku niezależne badanie Artificial Analysis wskazało ElevenLabs Scribe v2 jako lidera branży ze wskaźnikiem błędów słów (WER) wynoszącym zaledwie 2,2%.
Jak działa ASR? Podstawy technologii zamiany mowy na tekst
ASR przechwytuje próbkę audio, przekształca ją w reprezentację liczbową, a następnie używa wytrenowanego modelu, aby przewidzieć najbardziej prawdopodobną sekwencję słów reprezentowaną przez te dane. Nowoczesne ASR wykonuje cały ten proces end-to-end w czasie rzeczywistym, w mniej niż sekundę.
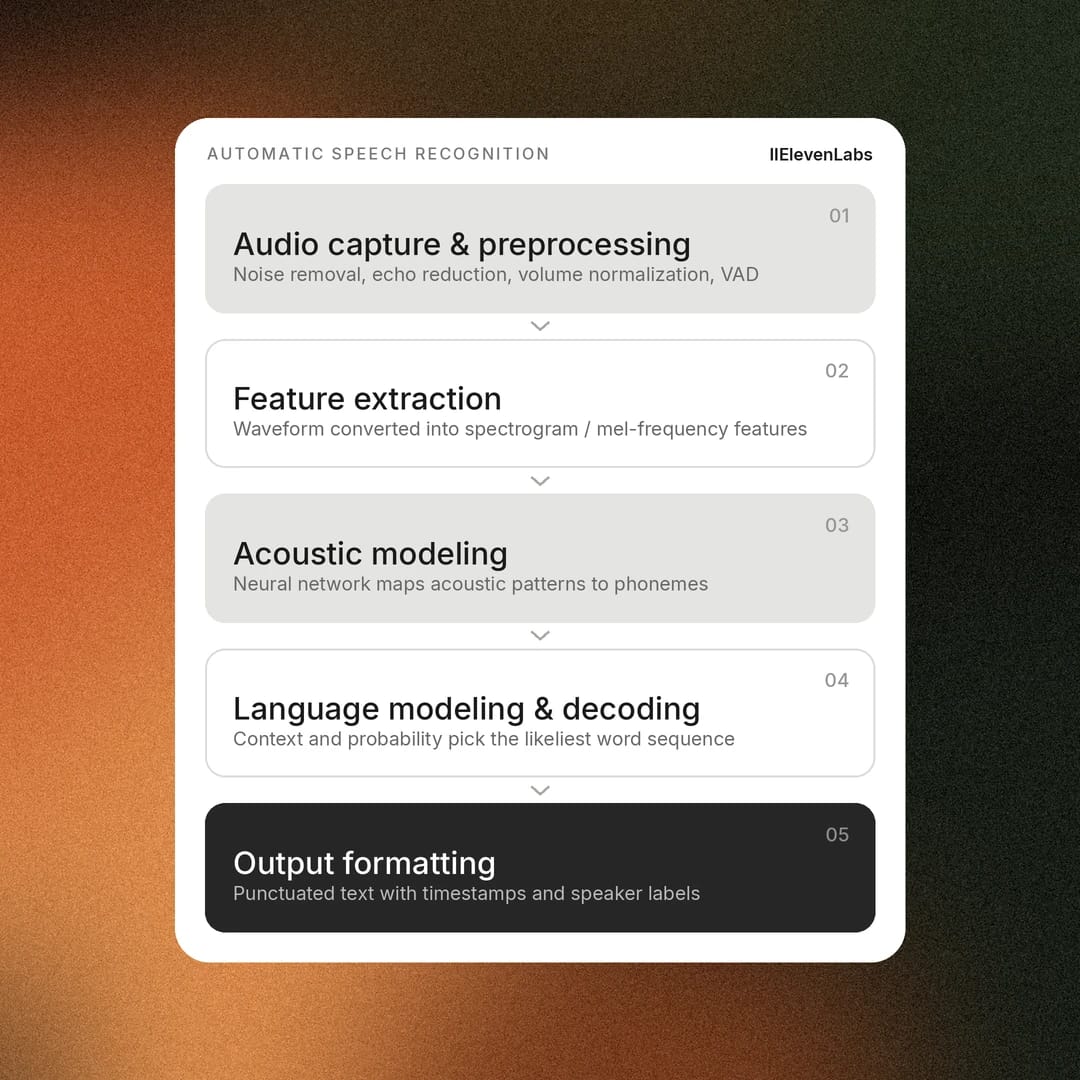
Proces ASR obejmuje pięć głównych etapów:
- Przechwytywanie i wstępne przetwarzanie audio: System nagrywa sygnał audio, usuwa szum tła, redukuje echo i normalizuje poziom głośności, aby zwiększyć spójność. Zależnie od modelu może wykorzystywać wykrywanie aktywności głosowej (VAD), by odróżnić mowę od ciszy lub dźwięków tła przed rozpoczęciem transkrypcji.
- Ekstrakcja cech: Audio jest zamieniane na reprezentację liczbową, zwykle spektrogram lub cechy mel-częstotliwościowe, które dokładnie uwidaczniają częstotliwości i wzorce obecne w ludzkiej mowie. Ten krok zamienia surowy przebieg fali w dane, które model uczenia maszynowego może skutecznie przetwarzać.
- Modelowanie akustyczne: Sieć neuronowa analizuje cechy z poprzedniego kroku i przewiduje fonemy lub inne jednostki mowy, ucząc się relacji między wzorcami akustycznymi a językiem mówionym. Nowoczesne modele end-to-end często wykonują ten krok wraz z rozumieniem języka, zamiast traktować go jako osobny etap.
- Modelowanie języka i dekodowanie: System ocenia następnie, które sekwencje słów są najbardziej prawdopodobne, na podstawie gramatyki, kontekstu i prawdopodobieństwa matematycznego. Dwa ostatnie czynniki są tu kluczowe, ponieważ transkrypcja IPA (Międzynarodowego Alfabetu Fonetycznego) dwóch zdań może być podobna, choć ich kontekst jest zupełnie inny. Na przykład „Recognize Speech” i „Wreck a nice peach” mogą brzmieć tak samo, ale znaczą coś całkiem innego. Kontekst pomaga systemowi zdecydować, która wersja jest poprawna, jeśli sama dokładność nie wystarcza.
- Formatowanie wyników: Po ustaleniu treści wypowiedzi powstaje końcowa transkrypcja z interpunkcją i wielkimi literami. Dodatkowe metadane, takie jak znaczniki czasu na poziomie słów znaczniki czasu i etykiety mówców, tworzą bardziej szczegółowe transkrypcje.
W tych etapach model zamienia przychodzące dane audio na pisaną transkrypcję.
Tradycyjne systemy hybrydowe a ASR end-to-end oparte na deep learning
Powyższy proces pokazuje, jak działa ASR, ale środkową jego część można realizować na dwa sposoby technologiczne.
Starsze systemy łączą kilka komponentów: model leksykonu kodujący wymowę słów, model akustyczny mapujący audio na fonemy oraz model językowy przewidujący prawdopodobne sekwencje słów. Każdy z nich wymaga pracy specjalistów — od językoznawców ręcznie tworzących słowniki wymowy po anotatorów przypisujących każde słowo do dokładnej pozycji w audio.
Deep learning end-to-end łączy wszystkie te komponenty w jedną sieć neuronową. Sieć mapuje audio bezpośrednio na tekst, ucząc się wymowy, akustyki i statystyk prawdopodobieństwa językowego na milionach godzin sparowanych nagrań i transkrypcji.
Przyjrzyjmy się różnicom między tradycyjnym a nowoczesnym podejściem do technologii ASR.
Jak mierzy się dokładność ASR: wskaźniki błędów słów (WER)
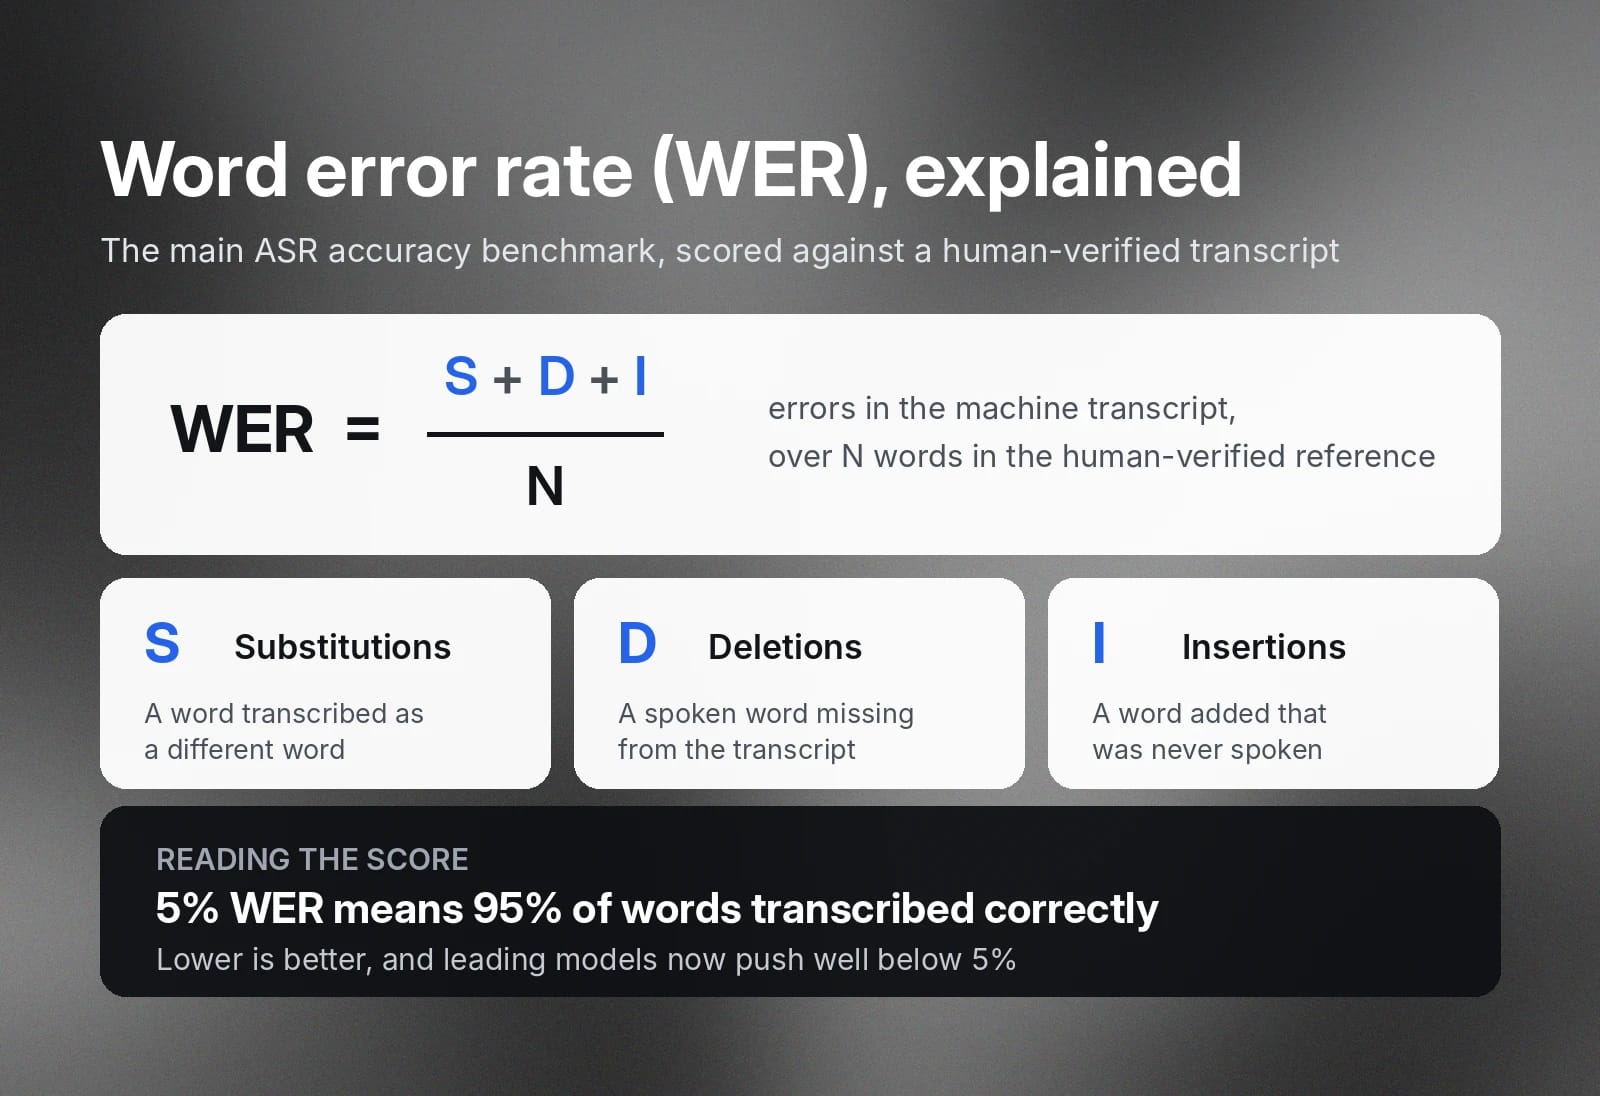
We wszystkich workflow zamiany mowy na tekst i ASR wskaźnik błędów słów (WER) jest główną miarą dokładności używaną przez firmy. Porównuje maszynową transkrypcję wygenerowaną przez ASR z wersją zweryfikowaną przez człowieka. Uwzględnia trzy główne rodzaje błędów: zamiany, pominięcia i wstawienia.
Wzór WER dzieli liczbę wszystkich błędów przez liczbę słów w transkrypcji referencyjnej. WER na poziomie 5% oznacza, że system poprawnie transkrybuje 95% tekstu, a większość czołowych modeli schodzi dziś znacznie poniżej 5%, zbliżając się do perfekcji.
Choć WER to przydatny punkt odniesienia, przy ocenie skuteczności narzędzia ASR warto uwzględnić też inne czynniki:
- Dokładność formatowania: Czy system poprawnie formatuje nietypowe ciągi? Na przykład, czy kwota $1,225 jest wyświetlana w tej formie, czy zapisana słownie jako „tysiąc dwieście dwadzieścia pięć dolarów”?
- Opóźnienie: Dokładność jest ważna, ale jeśli wygenerowanie prostej transkrypcji zajmuje kilka minut, narzędzie staje się bezużyteczne. Nawet bardzo dokładne rozwiązanie musi zapewniać niskie opóźnienie, aby było użyteczne.
- Odporność: Nawet w przypadkach użycia takich jak silne akcenty czy głośne tło dokładność modelu nie powinna znacząco spadać.
- Jakość diarizacji: Zastosowania z wieloma mówcami zależą od poprawnego przypisania każdego słowa właściwej osobie. Rozpoznawanie różnych mówców i prawidłowe ich oznaczanie wspiera ASR, zwłaszcza w branżach z dużą liczbą uczestników rozmów, takich jak sądy.
Więcej informacji znajdziesz w naszym szczegółowym przewodniku po wskaźniku błędów słów.
Najważniejsze korzyści ASR dla nowoczesnych firm
Globalny rynek rozpoznawania mowy i głosu ma wzrosnąć do ponad 23,11 mld USD do 2030 roku. Średni roczny wzrost rynku na poziomie 19,1% pokazuje, jak powszechna stała się ta technologia w urządzeniach komercyjnych. Każdy nowoczesny telefon ma klawiaturę do dyktowania i asystenta głosowego, większość nowych samochodów reaguje na polecenia głosowe, a inteligentne głośniki i asystenci są dziś obecni w domach na całym świecie.
Interakcja z technologią głosem stała się standardową opcją dla klientów. Firmom ASR oferuje wszystko — od transkrypcji rozmów z klientami po wsparcie agentów głosowych — integrując się z procesami i zwiększając produktywność.
Oto kilka głównych korzyści ASR dla nowoczesnych firm:
- Szybsze wprowadzanie danych i dokumentacja: Ponad 10 lat temu Stanford opublikował badanie pokazujące, że technologia rozpoznawania mowy była niemal trzy razy szybsza niż pisanie na klawiaturze, przy niższym wskaźniku błędów. Dla większości osób ASR oznacza szybsze tworzenie dokumentacji w workflow transkrypcji i robienie notatek głosem.
- Niższe koszty operacyjne: W wielu zastosowaniach, które wcześniej wymagały godzin ręcznego notowania, ASR radykalnie obniża koszt wysokiej jakości transkrypcji. Sprawy sądowe, contact center, placówki medyczne i spotkania biznesowe mogą dziś korzystać z dokładnych systemów ASR, które tworzą szczegółowe notatki i pełne transkrypcje rozmów z diarizacją.
- Większa dostępność: Światowa Organizacja Zdrowia przewiduje, że 2,5 miliarda osób będzie żyło z jakąś formą ubytku słuchu do 2050 roku. Napisy w czasie rzeczywistym tworzone przez zaawansowane narzędzia ASR mogą sprawić, że spotkania cyfrowe i media będą dostępne dla użytkowników.
- Przeszukiwalne dane głosowe: Gdy automatycznie transkrybujesz mowę za pomocą ASR, każda interakcja klienta z firmą zostaje w pełni zarejestrowana. Każda rozmowa sprzedażowa, zgłoszenie do wsparcia, rozmowa z potencjalnym klientem czy spotkanie stają się tekstem, który można przeszukiwać i audytować. Zwłaszcza w erze AI możliwość wydobywania kontekstu z formatu odczytywalnego przez maszyny pomaga budować rozbudowane bazy wiedzy. To ułatwia dostęp do informacji zarówno w celach operacyjnych, jak i zgodności z przepisami.
- Dostępność obsługi przez całą dobę: ASR zapewnia jedną z podstawowych technologii dla agentów głosowych, umożliwiając automatyczne wsparcie, które rozwiązuje sprawy klientów przez całą dobę, 365 dni w roku.
Automatyczne rozpoznawanie mowy jest tak powszechne w technologii ze względu na liczne korzyści i szeroki zakres zastosowań, które obsługuje. Niezależnie od tego, czy pracujesz w medycynie, czy chcesz transkrybować rozmowy z klientami do analizy sentymentu, ASR to podstawowa technologia, z której będziesz korzystać.
Popularne zastosowania ASR w różnych branżach
Automatyczne rozpoznawanie mowy to kluczowa technologia w niezliczonych workflow i produktach. Jest tak powszechne, że użytkownicy często nawet nie myślą o tym, jak działa w technologiach, z których korzystają.
Oto krótki przegląd popularnych zastosowań ASR na świecie.
Obsługa klienta i contact center
Contact center wcześnie zaczęły wykorzystywać ASR do transkrypcji rozmów na potrzeby kontroli jakości i zgodności z przepisami. Dziś ASR może działać w czasie rzeczywistym, podpowiadając agentom w trakcie rozmowy i zamieniając tysiące interakcji z klientami w dane do analizy przez zespoły.
Media i rozrywka
Nadawcy i platformy streamingowe mogą używać ASR do generowania napisów i podpisów do rozmów na skalę nieosiągalną dla ludzkich transkrybentów. Umożliwia to transkrypcję w czasie rzeczywistym i sprawia, że biblioteki wideo oraz audio można w pełni przeszukiwać.
Opieka zdrowotna
Personel kliniczny poświęca zaskakująco dużą część dnia na dokumentację i prowadzenie kart pacjentów. ASR pomaga odzyskać ten czas, dając lekarzom platformę medycznego STT, do której mogą dyktować notatki w czasie rzeczywistym.
Wirtualne spotkania
Platformy do spotkań często oferują cyfrowe notatki, które transkrybują rozmowy na bieżąco, więc nikt nie musi wybierać między udziałem a notowaniem. Usługi takie jak Google Meet wysyłają nawet po każdym spotkaniu transkrypcje z wyróżnionymi zadaniami, pomagając tworzyć przeszukiwalny indeks informacji.
Prawo i zgodność z przepisami
W środowisku prawnym dokładne rejestrowanie tego, co zostało powiedziane i przez kogo, jest podstawowym wymogiem w sądzie. Kancelarie prawne wykorzystują platformy ASR do transkrypcji spotkań, rozpraw, rozmów z klientami i posiedzeń sądowych z dokładnymi znacznikami czasu na potrzeby późniejszego wykorzystania.
Edukacja
Wykładowcy akademiccy mogą udostępniać nagrane transkrypcje wykładów, aby pomóc studentom budować zapis zajęć, w których uczestniczyli. Przy rozumieniu i zapamiętywaniu informacji studenci mają wtedy do dyspozycji kompleksowe źródło wiedzy.
Miejsce ASR w procesie działania agenta głosowego
ASR to standardowy element wielu wdrożeń technologicznych. W technologii agentów głosowych jest pierwszym z trzech etapów działających w ciągłej pętli.
- Słuchanie (ASR): Agent przechwytuje przychodzące strumienie audio i zamienia mowę na tekst w czasie rzeczywistym. Nowoczesne ASR stale przetwarza napływające audio, filtruje szum tła, obsługuje przerwania, tworzy częściowe transkrypcje i rozpoznaje, kiedy mówi dana osoba.
- Myślenie (model językowy): Duży model językowy interpretuje transkrypcję, rozumie intencję użytkownika, pobiera informacje z połączonych narzędzi i baz wiedzy, zachowuje kontekst rozmowy oraz określa najtrafniejszą odpowiedź lub działanie.
- Mówienie (zamiana tekstu na mowę): Model zamiany tekstu na mowę przekształca wygenerowaną odpowiedź LLM w naturalne, ekspresyjne audio. Nowoczesne systemy TTS mogą następnie dostosowywać tempo, intonację, emocje i akcentowanie, przesyłając dźwięk do rozmówcy podczas jego generowania, bez czekania na całą odpowiedź.
Opóźnienie konwersacyjne kumuluje się na każdym z tych etapów. Strumieniowe ASR zaczyna emitować słowa, gdy tylko zostaną wypowiedziane, zamiast czekać na zakończenie wypowiedzi, aby zmniejszyć opóźnienie. ElevenAgents wykorzystuje to jako standard dla agentów głosowych działających w czasie rzeczywistym, zapewniając sprawną obsługę.
Wyzwania ASR i rozwój technologii
Choć technologia ASR przeszła długą drogę od 1952 roku, nadal istnieje wiele wyzwań, które mogą obniżać jej dokładność.
Oto kilka problemów, z którymi narzędzia ASR wciąż mierzą się dziś:
- Akcenty i dialekty: Dostępne dane treningowe zwykle koncentrują się na kilku językach i akcentach, co utrudnia narzędziom ASR obsługę rzadszych akcentów lub języków używanych przez mniej osób. Rozwiązaniem są bogate i zróżnicowane zbiory danych treningowych.
- Szum tła i nakładające się głosy: Środowiska o zmiennej głośności lub z głośnym szumem tła utrudniają rozpoznanie pojedynczych słów z nagrania. Nakładające się głosy mogą mieć podobny efekt, obniżając dokładność transkrypcji ASR.
- Słownictwo branżowe: Dziedziny ze specjalistycznym żargonem lub skrótami potrzebują słowników i materiałów branżowych, by zwiększyć dokładność. Medycyna i prawo to dwie dziedziny, w których narzędzia ASR wymagają dodatkowego wsparcia lub specjalistycznego treningu.
- Prywatność i bezpieczeństwo: W wielu jurysdykcjach dane głosowe są uznawane za dane osobowe. Firmy potrzebują jasnych zasad retencji danych i zabezpieczeń chroniących przetwarzanie danych głosowych oraz zapewniających zgodność z obowiązującymi przepisami.
Przy pracy z technologią ASR warto też rozważyć kompromis między opóźnieniem a dokładnością. Niektóre zastosowania wymagają równowagi między nimi, podczas gdy dziedziny takie jak medycyna prawdopodobnie przedkładają dokładność ponad wszystko inne.
Zacznij korzystać z ElevenAPI, aby zintegrować ASR klasy produkcyjnej
ElevenAPI zapewnia Twojemu produktowi automatyczne rozpoznawanie mowy klasy produkcyjnej dzięki Scribe v2, modelowi ElevenLabs Speech to Text. Scribe v2 oferuje znaczniki czasu na poziomie słów, diarizację mówców, tagowanie zdarzeń audio oraz dokładność i niezawodność potrzebne w aplikacjach czasu rzeczywistego.
Odwiedź stronę ElevenLabs Speech to Text , aby dowiedzieć się więcej, lub utwórz bezpłatne konto i uruchom API w kilka minut.
Najczęstsze pytania o ASR

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.