
API zamiany mowy na tekst
Transkrybuj mowę z ElevenLabs Scribe v3
Nasz najdokładniejszy model Speech to Text. Transkrybuj spotkania, rozmowy i wywiady z etykietami rozmówców oraz kontrolą nad słowami, które są ważne.
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
Najdokładniejsze Speech to Text API do dużych zadań
Twórz napisy, transkrypcje do podcastów, wideo, wywiadów i innych nagrań – wszystko z najwyższą dokładnością przez API.
Bezprecedensowa dokładność transkrypcji
Scribe v3 popełnia o 27% mniej błędów w słowach niż Scribe v2 w 102 językach — i mniej niż każdy inny testowany przez nas model wsadowy.
Do każdego scenariusza
Transkrypcja działająca w hałasie, z muzyką w tle, mocnymi akcentami i niską jakością audio.
Precyzyjna kontrola czasu, mówców i zdarzeń pozamownych.
ElevenLabs Transcription API wykrywa śmiech, emocje i efekty dźwiękowe. Użyj keyterm promptingu, aby kierować transkrypcją za pomocą terminów z danej dziedziny.
Transkrybuj audio i wideo
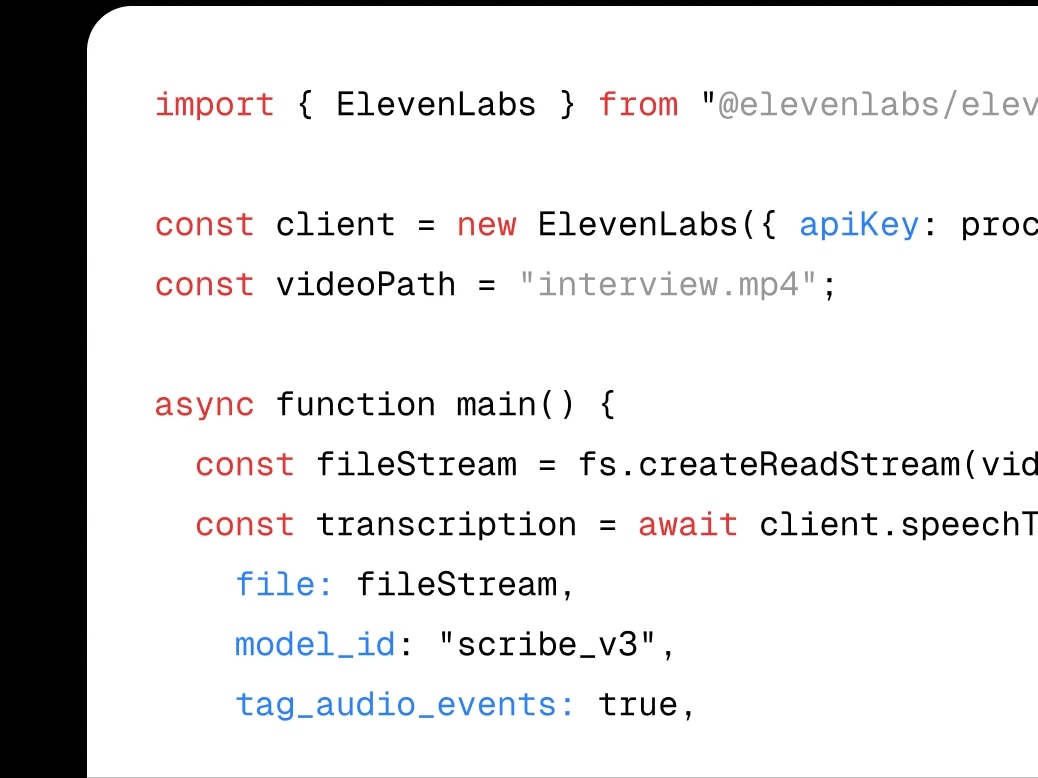
Czyste, edytowalne transkrypcje

Podpowiedzi słów kluczowych

Dynamiczne tagowanie audio
Wykrywaj zdarzenia pozamowne, takie jak śmiech, oklaski, muzyka i szum w tle. Transkrypcje zawierają pełny kontekst audio, nie tylko słowa.
Inteligentne rozpoznawanie mówców
Automatycznie rozpoznawaj i oznaczaj nawet 32 rozmówców. Jasno pokazuj, kto co powiedział, w czytelnych transkrypcjach.
Wykrywanie encji
Automatycznie wykrywaj i oznaczaj 56 typów encji, w tym imiona, daty, lokalizacje i organizacje w transkrypcjach.
Transkrybuj audio kliniczne z Scribe v2 Medical
Model Speech to Text zoptymalizowany pod transkrypcję medyczną i workflow kliniczne, z lepszym rozpoznawaniem nazw leków oraz terminów anatomicznych i patologicznych.
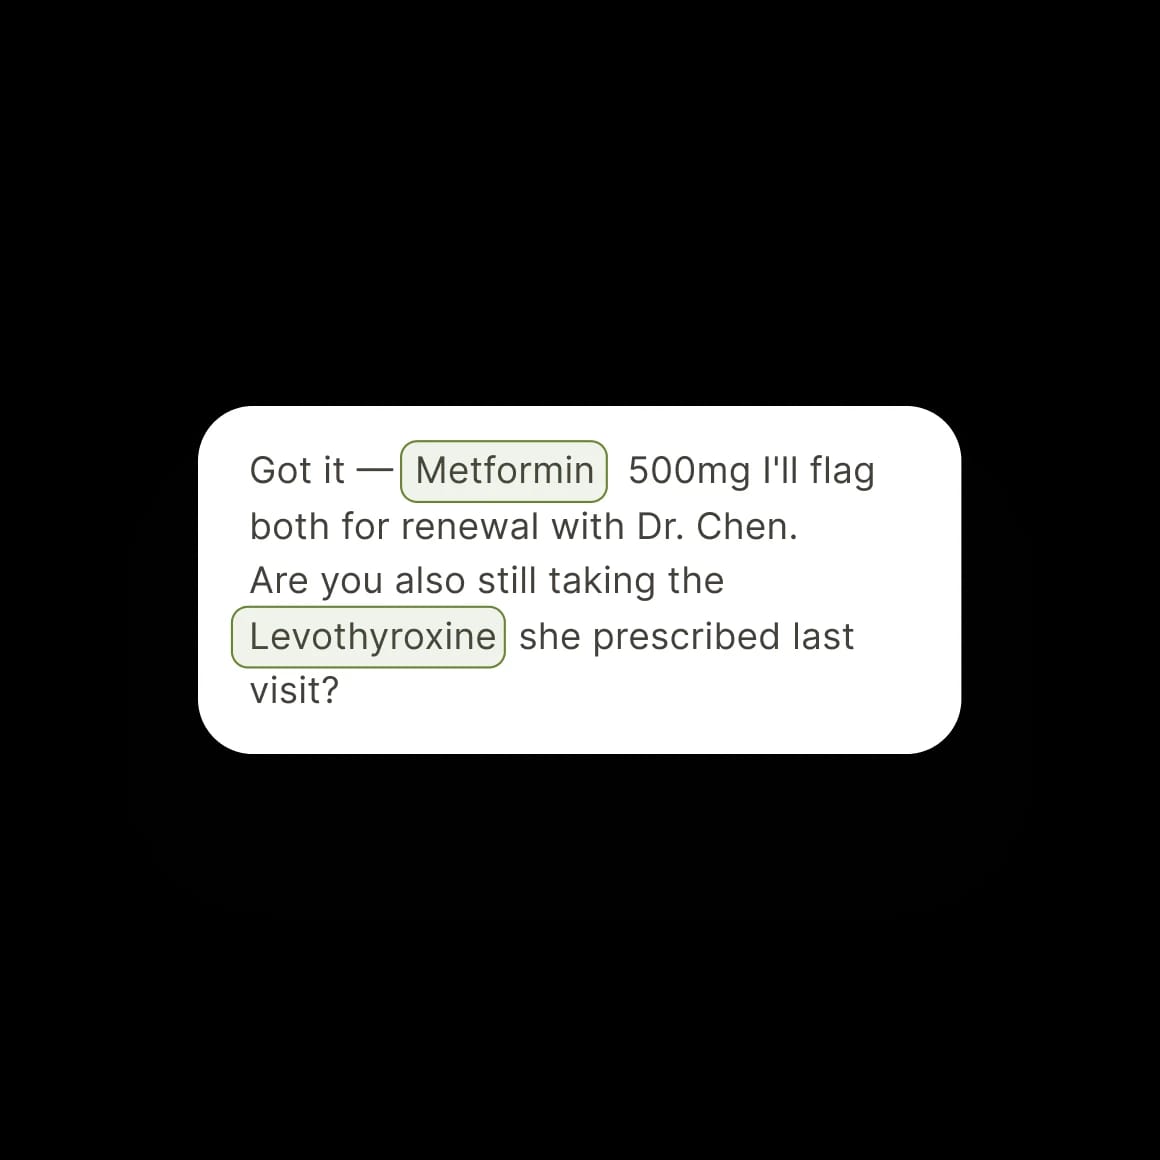
Transkrypcja mowy klinicznej
Zamieniaj rozmowy lekarzy z pacjentami, dyktowanie lekarza i wywiady z pacjentami na precyzyjny tekst gotowy do sprawdzenia i użycia w notatkach, kodowaniu oraz dalszych procesach dokumentacyjnych.
Mniej błędów w terminach medycznych
W teście term-WER Scribe v2 Medical popełnia o 15% mniej błędów niż Scribe v2 w zestawie testowym Eka Medical ASR, lepiej rozpoznając terminy z zakresu słownictwa klinicznego.
Scribe v3
Najwyższa dokładność, do przetwarzania zbiorczego.
- O 27% mniej błędów niż Scribe v2
- Najniższy testowany przez nas błąd diarizacji
- Formatowanie liczb i podpowiedzi językowe
- Wykrywanie encji i prompting kluczowych terminów
- Obsługa ponad 90 języków
Scribe v3 Live
Najniższe opóźnienie, do zadań realtime.
- Opóźnienie poniżej 150 ms
- O 43% mniej błędów niż v2 Realtime
- Biblioteka kluczowych terminów i tryb wielojęzyczny
- Lepsze wykrywanie zmian rozmówcy
- Obsługa ponad 90 języków
Scribe v2 Medical
Fine-tune medyczny, do transkrypcji klinicznej.
- Dostosowanie słownictwa medycznego
- Transkrypcja w ponad 90 językach
- Taka sama skuteczność jak Scribe v2 dla zwykłej mowy
- Lepsze rozpoznawanie nazw leków
- Dostępne dla klientów Enterprise objętych HIPAA
Transkrybuj mowę w ponad 90 językach i wielu akcentach
Wyjątkowa dokładność dla akcentów, dialektów i różnych warunków nagrania.
Zmień languageCode, aby odsłuchać języki
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // Ustaw język
diarize: true
});
console.log(transcription);


Wspieramy czołowe firmy i marki na świecie
“Od dubbingu Reels w lokalnych językach po generowanie muzyki i głosów postaci w Horizon — platforma ElevenLabs pozwala twórcom, firmom i przedsiębiorstwom z całego świata tworzyć na dużą skalę z wykorzystaniem głosu, muzyki i dźwięku.”

“Niezrównana dokładność Scribe w tak wielu językach pozwala Fieldy rozumieć każdą codzienną rozmowę i łatwo skalować działalność na innych kontynentach. Po przejściu na ElevenLabs Scribe Fieldy zwiększyło retencję użytkowników o 50%.”

“ElevenLabs ułatwiło nam szybkie dodanie zaawansowanej funkcji zamiany tekstu na mowę do naszego SDK, dzięki czemu Agenci mogą odpowiadać w czasie rzeczywistym ekspresyjnymi głosami na pytania użytkowników lub przekazywać informacje o tym, co widzą.”
“Twilio zintegrowało technologię generatywnego głosu AI od ElevenLabs ze swoją platformą CPaaS, ulepszając ConversationRelay. Dzięki tej integracji firmy i deweloperzy mogą tworzyć konwersacyjne interakcje głosowe AI, które brzmią naturalnie, są ekspresyjne i odpowiadają w czasie rzeczywistym bezpośrednio z platformy Twilio CPaaS. W ElevenLabs cieszymy się, że Twilio wybrało ElevenLabs, by wzbogacić ConversationRelay o najbardziej ekspresyjne i naturalnie brzmiące głosy. ”

API gotowe do produkcji

Dane są szyfrowane podczas przesyłania i przechowywania, z obsługą zgodności z SOC 2, HIPAA i RODO. Tryby EU Data Residency i Zero Retention zapewniają ściślejszą kontrolę nad danymi.
Dane są szyfrowane podczas przesyłania i przechowywania, z obsługą zgodności z SOC 2, HIPAA i RODO. Tryby EU Data Residency i Zero Retention zapewniają ściślejszą kontrolę nad danymi.
Oficjalne SDK dla Pythona i TypeScript z bezpieczeństwem typów, obsługą streamingu i jasnymi przykładami.
Nasz zespół zapewnia sprawne uruchomienie i niezawodne działanie, dając stałą wydajność i spokój.
