Czym jest opóźnienie Conversational AI i co na nie wpływa?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
W przypadku Conversational AI opóźnienia odróżniają dobre aplikacje od świetnych.
Conversational AI z natury dąży do ideału. Ma naśladować wrażenie rozmowy z człowiekiem, odwzorowując ten sam zakres emocji, ton i rytm. Gdy dodasz do tego „naturalną” przerwę między końcem wypowiedzi a początkiem odpowiedzi agenta AI, otrzymasz docelowe opóźnienie oparte na tym, jak ludzie naprawdę się komunikują.
Firmy, które chcą wdrażać agentów Conversational AI na dużą skalę, muszą maksymalnie ograniczyć opóźnienia, jeśli chcą osiągnąć tę naturalność. W tym artykule wyjaśniamy, czym jest opóźnienie Conversational AI, co powoduje opóźnienia w całym pipeline i jak je ograniczać.
Podsumowanie
- Opóźnienie Conversational AI to całkowity czas od momentu, gdy użytkownik przestaje mówić, do chwili, gdy słyszy pierwsze słowo agenta.
- Agenci z opóźnieniem powyżej 700 ms mogą wydawać się nienaturalni, a przy ponad 1200 ms użytkownicy często rezygnują z rozmowy.
- Opóźnienia kumulują się na każdym etapie pipeline Conversational AI.
- ElevenAgents obsługuje cały pipeline w jednej spójnej architekturze, dzięki czemu Conversational AI o niskich opóźnieniach jest dostępne dla twojej firmy.
Czym jest opóźnienie Conversational AI?
Opóźnienie Conversational AI to całkowity czas, jakiego system potrzebuje, by odpowiedzieć po tym, jak coś powiesz. W nowoczesnych modelach AI opóźnienie mierzy się w ms. W praktyce składa się ono z kilku oddzielnych procesów, z których każdy odpowiada za część pipeline end-to-end.
Typowy pipeline Conversational AI wygląda tak:
- Użytkownik mówi
- Model zamiany mowy na tekst transkrybuje audio
- Transkrypcja trafia do modelu LLM, który tworzy odpowiedź
- Tekst z LLM jest następnie syntezowany do audio przez model zamiany tekstu na mowę
- Audio jest odtwarzane użytkownikowi
Każdy z tych etapów zwiększa opóźnienie systemu Conversational AI. Dlatego warto wyjaśnić kilka skrótów używanych przy omawianiu opóźnień.
Opóźnienie inferencji modelu
Opóźnienie inferencji modelu to czas, który model poświęca na generowanie wyniku, mierzony wewnętrznie i bez czynników zewnętrznych. To miara specyficzna dla modelu, pokazująca szybkość działania silnika przy typowych danych wejściowych. Na przykład Flash v2.5 ma opóźnienie inferencji około 75 ms. Dzięki temu możesz porównywać szybkość modeli różnych dostawców.
Pamiętaj jednak, że nie jest to opóźnienie, którego faktycznie doświadcza użytkownik. Dotyczy wyłącznie całkowitego czasu generowania wyniku przez model.
Czas LLM do pierwszego tokenu
Czas do pierwszego tokenu (TTFT) dużego modelu językowego (LLM) to całkowity czas potrzebny modelowi na przetworzenie promptu i wygenerowanie pierwszego użytecznego tokenu wyniku.
Generowanie TTS zaczyna się, gdy z LLM nadejdzie pierwszy token, więc ta miara pokazuje, jak długo LLM potrzebuje, by uruchomić model TTS. W większości systemów Conversational AI end-to-end TTFT LLM stanowi istotną część całkowitego opóźnienia.
Czas TTS do pierwszego audio (TTFA)
Czas TTS do pierwszego audio (TTFA) mierzy czas od pierwszego żądania TTS do chwili, gdy pierwszy fragment audio faktycznie opuszcza model. To sposób opisu opóźnienia inferencji modelu, ale konkretnie dla silników TTS.
Czas end-to-end do pierwszego audio (TTFA)
TTFA end-to-end to całkowite opóźnienie Conversational AI. To suma wszystkich elementów pipeline — od rozpoznawania mowy, przez TTFT LLM, TTS i TTFA, po wszystkie transmisje sieciowe między etapami. Gdy mówimy o opóźnieniu Conversational AI jako całości, użytkownik odczuwa właśnie tę metrykę.
Gdy użytkownik mówi, czeka na TTFA end-to-end, zanim usłyszy odpowiedź od twojego agenta. To całościowa miara, więc poprawa dowolnej części pipeline ją zmniejszy.
Dlaczego opóźnienie Conversational AI ma znaczenie
Gdy użytkownik rozmawia z twoim agentem AI, opóźnienie staje się kluczowym czynnikiem wpływającym na odbiór tego doświadczenia. Niskie opóźnienia skracają czas oczekiwania na odpowiedź, dzięki czemu rozmowa wydaje się naturalna, a agent — kompetentny.
Agenci z dużym opóźnieniem wydają się sztuczni i mniej kompetentni, nawet jeśli jakość ich odpowiedzi jest taka sama. Dla firm różnica zaledwie kilkuset ms może wydawać się wiecznością i sprawić, że twój agent wsparcia klienta będzie sprawiał wrażenie niezgrabnego i nieskutecznego.
Oto kilka scenariuszy pokazujących, dlaczego opóźnienie Conversational AI ma znaczenie w praktyce:
- Poniżej 500 ms: Agent konwersacyjny działa szybko i płynnie. Użytkownicy mogą nawet nie zauważyć opóźnienia między końcem wypowiedzi a pierwszą odpowiedzią, więc rozmowa toczy się bez zakłóceń.
- Od 500 ms do 1000 ms: Opóźnienie między końcem wypowiedzi użytkownika a odpowiedzią może stać się zauważalne. Jest odrobinę za długie, więc użytkownicy mogą próbować się dostosować — powtarzać się lub robić pauzę, by sprawdzić, czy agent rzeczywiście ich zrozumiał.
- Powyżej 1000 ms: Opóźnienia zaczynają wydawać się długie, a przerwy mogą sprawić, że użytkownik uzna, iż agent AI nie nadąża za rozmową. Transkrypcje mogą pokazywać sporadyczne przerwania lub prośby o rozmowę z człowiekiem. W niektórych przypadkach użytkownik może przerwać połączenie.
Każdy z tych progów przekłada się na realne wyniki biznesowe.
Przy niższych opóźnieniach agent obsługi klienta może naturalnie odpowiadać na pytania i pomagać użytkownikom rozwiązywać problemy bez dodatkowego wsparcia. Odciąża to twoich konsultantów i utrzymuje wysokie zadowolenie klientów. Przy wyższych opóźnieniach sfrustrujesz klientów agentem, który zdaje się zbyt długo wahać.
W innym artykule określiliśmy benchmarki budżetu opóźnień agentów głosowych, aby pokazać, jak wyglądają dobre opóźnienia dla wartości P50 i P95.
Co powoduje opóźnienie Conversational AI?
Opóźnienie Conversational AI to zbiorcze określenie kilku procesów, z których każdy wpływa na całość. Dlatego ograniczanie opóźnień jest raczej problemem na poziomie systemu niż kwestią prostego wyboru lepszego modelu. W końcu w pipeline współpracuje kilka modeli.
Dla deweloperów przygotowaliśmy szczegółowy przewodnik techniczny o optymalizacji opóźnień agentów głosowych, który pomoże ci usprawnić każdy etap czasu end-to-end do pierwszego audio (TTFA).
Poza głównym pipeline opóźnienia zwiększają też inne czynniki, takie jak telefonia i wywołania funkcji, choć nie należą do infrastruktury modelu.
Oto przegląd wszystkich czynników wpływających na opóźnienie Conversational AI.
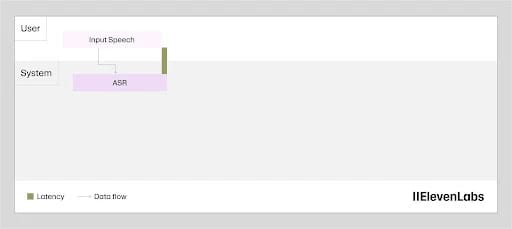
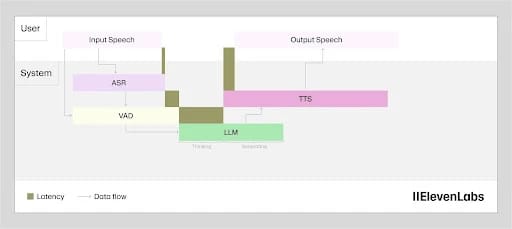
Automatyczne rozpoznawanie mowy
Opóźnienie rozpoznawania mowy to nie czas potrzebny na wygenerowanie transkrypcji. Transkrypcja działa w tle, gdy użytkownik mówi, więc po zakończeniu wypowiedzi tekst jest w dużej mierze gotowy.
Opóźnienie to w rzeczywistości przerwa między końcem wypowiedzi a sfinalizowaniem i przekazaniem transkrypcji do następnego etapu. Scribe v2 Realtime skraca ją do około 150 ms, stale przesyłając dane strumieniowo, dzięki czemu wynik jest gotowy w chwili zakończenia tury.
Zarządzanie turami i wykrywanie końca wypowiedzi
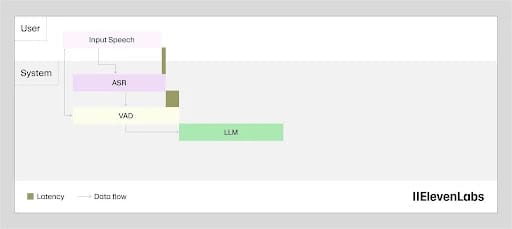
Detektor aktywności głosowej (VAD) działa między rozpoznawaniem mowy a modelem językowym. Jego zadaniem jest określenie, kiedy użytkownik rzeczywiście skończył mówić.
Aby uniknąć błędów, VAD czeka na określony czas ciągłej ciszy, zanim uzna turę za zakończoną. To dodatkowe opóźnienie, zanim model językowy przetworzy choć jedno słowo. Wydłuża ono czas, ale zapobiega rozpoczęciu odpowiedzi przez system, gdy użytkownik nadal mówi.
Technicznie rzecz biorąc, gdyby wszystkie pozostałe komponenty Conversational AI nie generowały opóźnień, opóźnienie przypisane zarządzaniu turami byłoby korzystne. Ludzie robią krótką pauzę, zanim odpowiedzą. Podobna pauza maszyny nadaje interakcji realizmu. Ponieważ jednak inne komponenty Conversational AI już wprowadzają opóźnienia, najlepiej, by było ono minimalne.
Przetwarzanie przez model językowy
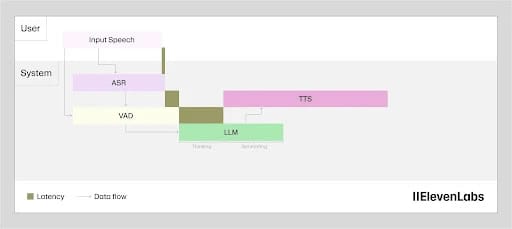
Gdy transkrypcja z silnika zamiany mowy na tekst (STT) jest gotowa, model językowy generuje odpowiedź. Opóźnienie to czas potrzebny na rozpoczęcie generowania tokenów, a nie na wygenerowanie całej odpowiedzi. Tokeny trafiają bezpośrednio strumieniowo do etapu TTS, więc najważniejsze jest TTFT.
Na ten etap wpływają nie tylko wybór modelu, lecz także długość promptu i wielkość bazy wiedzy. Im więcej kontekstu LLM musi rozważyć, tym więcej czasu potrzebuje. Projektując takie systemy na dużą skalę, zachowaj równowagę między użyteczną bazą wiedzy a zwięzłym promptem, aby utrzymać szybkość działania.
Synteza mowy
Opóźnienie TTS to czas między otrzymaniem pierwszych tokenów z modelu językowego a rozpoczęciem audio. Ponieważ tokeny docierają szybciej, niż odtwarzana jest ludzka mowa, model syntezy nie czeka na całą odpowiedź. Opóźnienie TTS to wyłącznie czas do pierwszego fragmentu audio.
Ten etap był kiedyś największym pojedynczym źródłem opóźnień Conversational AI — starsze modele potrzebowały 2–3 sekund, by zacząć generować mowę. Flash v2.5 od ElevenLabs bezpośrednio rozwiązuje ten problem, oferując syntezę mowy z opóźnieniem ~75 ms i skracając to wąskie gardło z sekund do ułamka sekundy.
Opóźnienie sieciowe
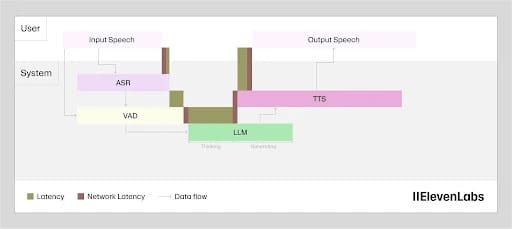
Przesyłanie danych z jednego miejsca do drugiego zawsze zwiększa opóźnienie, a odległość geograficzna tylko pogarsza opóźnienie sieciowe w obie strony.
Ponieważ nad odpowiedzią end-to-end współpracuje kilka komponentów, znaczne opóźnienia mogą kumulować się podczas wielu przeskoków sieciowych.
Wywołania funkcji
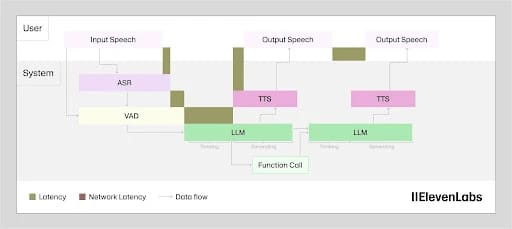
Wywołania funkcji dodają obiegi API na etapie LLM. Szybkie wewnętrzne wyszukanie zajmuje dziesiątki milisekund, ale system płatności lub system magazynowy może dodać sekundy. Wysokość opóźnienia zależy całkowicie od wywoływanej usługi, co sprawia, że ten etap najtrudniej bezpośrednio zoptymalizować.
Najskuteczniej jest polecić LLM, by odpowiedział, zanim zakończy się wywołanie narzędzia. Zwrot typu „Już to sprawdzam” angażuje użytkownika, gdy trwa zewnętrzne wywołanie, zamiast pozostawiać ciszę. Odpowiedź głosowa zaczyna się, gdy narzędzie działa równolegle.
Jak ograniczyć opóźnienie Conversational AI
Ograniczenie opóźnienia Conversational AI wymaga zajęcia się każdym etapem pipeline według jego wpływu. Pojedyncze usprawnienia pomagają, ale największą zmianę zobaczysz, gdy całościowo zoptymalizujesz cały pipeline.
Oto kilka zasad, które pomogą ci ogólnie ograniczyć opóźnienie Conversational AI:
- Wybór modelu TTS: Modele TTS zoptymalizowane pod kątem szybkości, takie jak Flash v2.5, używają innych architektur niż modele zoptymalizowane pod kątem jakości, takie jak Eleven v3 i Eleven v4. W przypadku działających w czasie rzeczywistym agentów głosowych właściwy wybór to model o najwyższej jakości, który spełnia twój docelowy poziom opóźnienia — niemal zawsze model zoptymalizowany pod kątem szybkości.
- Wybór modelu LLM: Mniejsze, szybsze modele LLM zwykle osiągają krótszy czas do pierwszego tokenu niż większe. Wybór najszybszego LLM, który nadal spełnia twoje wymagania jakościowe dla danego zadania, jest równie ważny jak wybór modelu TTS.
- Streaming: Strumieniowe TTS zwraca audio we fragmentach podczas syntezy, więc użytkownik słyszy pierwsze słowo, gdy model nadal generuje resztę. Ta zasada dotyczy też wyniku LLM: rozpoczęcie syntezy TTS od pierwszego zdania, gdy model językowy generuje kolejne, pozwala odzyskać czas w pipeline.
- Prompt systemowy: Użytkownicy mogą uprościć prompty systemowe, przenosząc instrukcje do procedur lub workflow zamiast uwzględniać je w każdym kroku decyzyjnym. Zmniejsza to ilość kontekstu, który model musi analizować w każdej turze.
- Zabezpieczenia: Uruchamianie zabezpieczeń w modelu strumieniowym pozwala zacząć odtwarzanie wyniku przed zakończeniem kontroli, zamiast blokować odtwarzanie do jej ukończenia.
- Kolokacja modeli: Korzystanie, gdy to możliwe, z modeli umieszczonych w tym samym miejscu — takich jak stos ElevenLabs Agents — utrzymuje komponenty blisko siebie, więc opóźnienie nie rośnie przez przeskoki między modelami hostowanymi osobno.
- Lokalizacja: Bliskość twoich serwerów i użytkowników może znacząco zmniejszyć opóźnienie, ponieważ bezpośrednio ogranicza udział sieci w TTFA end-to-end.
Więcej szczegółów znajdziesz w tym przewodniku technicznym o optymalizacji opóźnień.
Zacznij korzystać z Conversational AI o niskich opóźnieniach z ElevenAgents
Opóźnienie Conversational AI to bardzo ważna kwestia przy tworzeniu i wdrażaniu agentów. W ElevenAgents optymalizacja opóźnień jest wbudowana w cały proces. Od technik nakładania wypowiedzi, które odzyskują czas, po niskie opóźnienie inferencji poszczególnych komponentów — ElevenAgents tworzy dla twojej firmy stosy Conversational AI o niskich opóźnieniach.
Ostatecznie celem jest realizm. Użytkownik powinien odczuwać swobodę rozmowy z człowiekiem, a jednocześnie korzystać z zalet programu komputerowego. Dzięki usprawnieniu podprocesów jest to teraz możliwe.
Dowiedz się więcej o ElevenAgents lub skontaktuj się z działem sprzedaży i zacznij już dziś.
FAQ: opóźnienie Conversational AI

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.