
Word error rate (WER): Kluczowe pojęcia, wzór i zastosowania
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Teoretycznie współczynnik błędów słów (WER) to miara określająca dokładność narzędzia Automatic Speech Recognition (ASR). Niski WER oznacza dokładniejszą końcową transkrypcję, a wyższy — więcej błędnie zapisanych informacji.
W praktyce WER może decydować o tym, czy oprogramowanie do transkrypcji medycznej zapisze, że pacjent potrzebuje „piętnaście miligramów”, czy „pięćdziesiąt miligramów” leku. To różnica między narzędziem wsparcia, które dokładnie zapisuje potrzeby klienta, a takim, które frustruje użytkownika.
W tym artykule wyjaśniamy, czym jest WER, jak go obliczać i jak użyć go do porównania dostawców ASR.
Podsumowanie
- Współczynnik błędów słów uwzględnia trzy rodzaje błędów: zamiany, usunięcia i wstawienia, a następnie dzieli je przez liczbę słów w transkrypcji referencyjnej.
- Wzór na WER to WER = (S + D + I) / N.
- Niższy WER oznacza dokładniejszy wynik końcowy.
- WER poniżej 5% to dobry punkt odniesienia, choć transkrypcje prawne i medyczne mogą wymagać jeszcze niższego WER.
- WER traktuje wszystkie błędy jednakowo, więc nie jest idealną miarą w ocenie kontekstu. Nowe miary, takie jak Semantic Word Error Rate (SWER), próbują to rozwiązać, mierząc, czy zachowano znaczenie wypowiedzi.
Czym jest współczynnik błędów słów?
Współczynnik błędów słów (WER) to standardowa miara dokładności rozpoznawania mowy w modelach zamiany tekstu na mowę. Przedstawia w skali od 0 do 1 (0,8 oznacza 80% błędów), co system STT zapisuje niepoprawnie, uwzględniając zamiany, usunięcia i wstawienia.
Zamiana występuje, gdy słowo zostaje zastąpione niewłaściwym. Usunięcie oznacza, że słowo całkowicie pominięto. Wstawienie to z kolei słowo dodane do transkrypcji, choć nigdy nie zostało wypowiedziane. WER uwzględnia wszystkie te trzy elementy i dzieli je przez liczbę słów w poprawnej transkrypcji, dając wynik, który można porównać z wynikami innych dostawców.
Oto wzór na WER:
WER = (S + D + I) / N
Gdzie:
- S: Zamiany (słowo jest nieprawidłowe)
- D: Usunięcia (brakuje słowa)
- I: Wstawienia (występuje dodatkowe słowo)
- N: Łączna liczba słów w transkrypcji referencyjnej
WER można wyrazić jako liczbę dziesiętną lub procent. Im niższy WER, tym lepszy wynik, ponieważ model popełnił mniej błędów podczas transkrypcji.
W praktyce WER na poziomie 10% oznacza, że około 1 na 10 słów w transkrypcji spotkania wymaga ponownego sprawdzenia.
Dlaczego współczynnik błędów słów jest ważny w systemach rozpoznawania mowy?
Współczynnik błędów słów daje obiektywną miarę, której zespoły mogą używać do porównywania dostawców. Pozwala przebić się przez deklaracje marketingowe i jasno ocenić dokładność modelu rozpoznawania mowy. Dzięki danym każda firma analizująca dostępne opcje widzi, które modele obecnie prowadzą w tej dziedzinie.
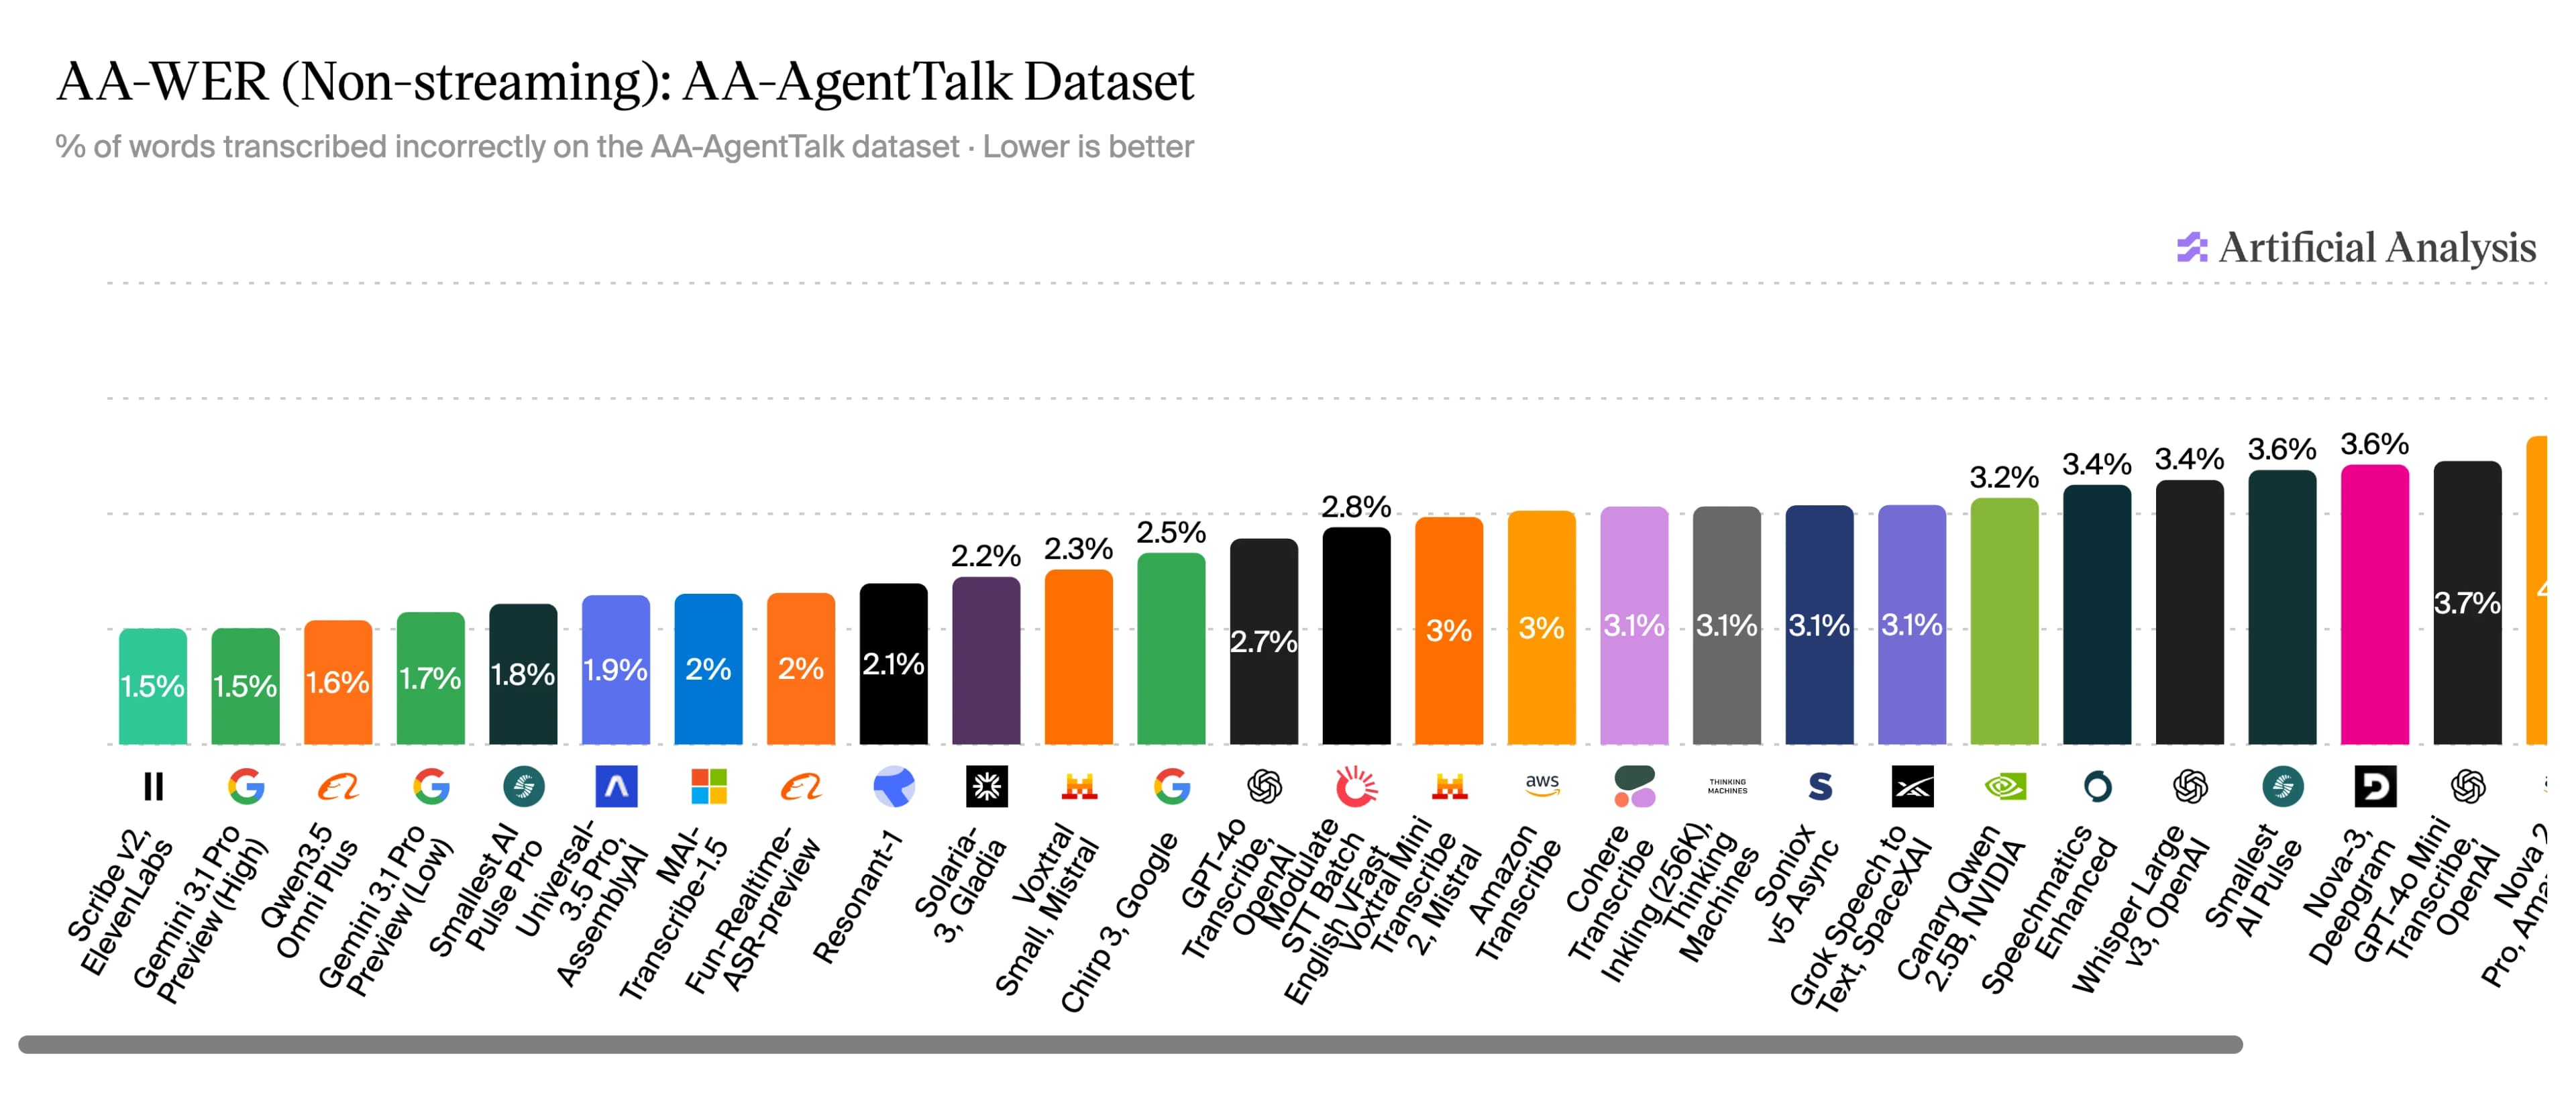
Źródło: Artificial Analysis, dostęp: 10 lipca 2026 r.
Według niezależnego badania Artificial Analysis z lipca 2026 r. ElevenLabs Scribe v2 ma najniższy WER w branży w zbiorze AA-AgentTalk wśród niestreamingowych modeli transkrypcji — 1,5% WER.
Poza oceną dostawców WER ma realny wpływ na produkt. Oprogramowanie do transkrypcji medycznej z WER na poziomie 12% może wprowadzać krytyczne błędy w dokumentacji pacjenta. Błędna transkrypcja rozmowy z obsługą klienta może prowadzić do dalszych problemów, takich jak niedokładna analiza sentymentu lub słaba kategoryzacja.
Poza problemami właściwymi dla konkretnych zastosowań, gdy systemy ASR zawodzą, najbardziej cierpią często osoby, dla których transkrypcja jest jedynym sposobem dostępu do treści mówionych. World Wide Web Consortium udostępnia obszerną dokumentację minimalnych standardów oczekiwanych w inicjatywach dostępności.
Jak obliczyć współczynnik błędów słów: wzór i przykład
Obliczanie współczynnika błędów słów jest proste, gdy znasz kolejne kroki. Jak opisano wyżej, użyjesz wzoru WER = (S + D + I) / N. Wszystkie terminy wyjaśniliśmy wcześniej: to zamiany, usunięcia, wstawienia oraz N, czyli łączna liczba słów w transkrypcji.
Tak obliczysz WER:
- Utwórz transkrypcję referencyjną: Skorzystaj z ludzkiej transkrypcji i weryfikacji, aby stworzyć dokładną transkrypcję nagrania audio.
- Użyj narzędzia STT: Użyj platformy ASR do transkrypcji nagrania audio, tworząc transkrypcję AI, której użyjesz jako testu.
- Wyrównaj obie wersje: Użyj programowania dynamicznego (konkretnie algorytmu Levenshteina), aby znaleźć minimalną liczbę edycji. Omówimy ten algorytm szerzej w dalszej części.
- Zastosuj wzór: Policz wszystkie błędy w wersji wygenerowanej przez AI względem kopii zweryfikowanej przez człowieka, a następnie użyj WER = (S + D + I) / N, aby obliczyć dokładny WER.
Na papierze brzmi to dość technicznie, ale w praktyce jest znacznie prostsze. Oto przykład, który pokaże, co mamy na myśli.
Transkrypcja referencyjna: Pani Dalloway powiedziała, że sama kupi kwiaty.
Wynik ASR: Panna Dalloway powiedziała, że sama kupi kwiaty.
Łącznie mamy 1 S i 1 D na 9 słów.
Według wzoru otrzymujemy: WER = 2 / 9 = 0,222 = 22,2%.
Obliczanie współczynnika błędów słów w Pythonie
Metoda ręczna sprawdza się świetnie, ale możesz zaoszczędzić czas, obliczając WER w Pythonie. Biblioteka jiwer robi to wszystko automatycznie.
Zgodnie z dokumentacją jiwer możesz zainstalować ten pakiet, stworzony specjalnie do oceny systemów ASR i generowania kluczowych miar, takich jak WER. Po pobraniu użyj poniższego kodu, aby szybko obliczyć WER w Pythonie:
Zauważ, że w tym przykładzie wynik ASR różni się od oryginału w dwóch miejscach. Słowo „jumps” błędnie zapisano jako „leaps” (zamiana), a przed „lazy” wstawiono „last” (wstawienie). Przy dwóch błędach w dziewięciu słowach transkrypcji referencyjnej współczynnik błędów słów (WER) wynosi 0,222, czyli 22,2%.
Porównanie współczynnika błędów słów z innymi miarami rozpoznawania
Choć WER jest standardową miarą dokładności ASR, możesz użyć też innych narzędzi. Na przykład:
- Character Error Rate (CER): Podobnie jak WER mierzy dokładność transkrypcji na poziomie znaków, a nie słów. Najlepiej sprawdza się w językach bez wyraźnych granic między słowami (scriptio continua) lub w zadaniach wrażliwych na pisownię.
- Match Error Rate (MER): Mierzy udział błędów transkrypcji, traktując zamiany, wstawienia i usunięcia nieco inaczej niż WER. Koncentruje się na proporcji błędów w zdaniu.
- Word Information Lost (WIL): Szacuje, jaka część pierwotnej informacji została utracona podczas transkrypcji, mierząc zrozumiałość zamiast bezpośredniej liczby błędów jak WER.
- Embedding Error Rate (EmbER): Oferuje analizę semantyczną między transkrypcjami. Wykracza poza WER, pokazując semantyczny dystans między poprawnym słowem a błędną transkrypcją.
Każda z tych miar najlepiej sprawdza się w innym scenariuszu. Oto tabela pomocnicza:
Przykłady odległości Levenshteina: matematyka stojąca za WER
Współczynnik błędów słów to w istocie miara odległości między oryginałem a wynikiem hipotezy. Aby zrozumieć tę różnicę matematycznie, używamy odległości Levenshteina.
Odległość Levenshteina liczy minimalną liczbę jednokrokowych edycji potrzebnych do przekształcenia jednej sekwencji w drugą. W przypadku WER chodzi konkretnie o zamiany, wstawienia i usunięcia. Na przykład, aby zmienić Cat w Mat, trzeba zmienić literę „C” na „M”, więc odległość Levenshteina wynosi 1.
Choć częściej spotkasz to w obliczeniach CER, WER przenosi odległość Levenshteina na poziom słów. Każdą jednostką jest całe słowo, a rzeczywista odległość mierzy, ile edycji słów potrzeba, by przekształcić wynik ASR w dokładny oryginał.
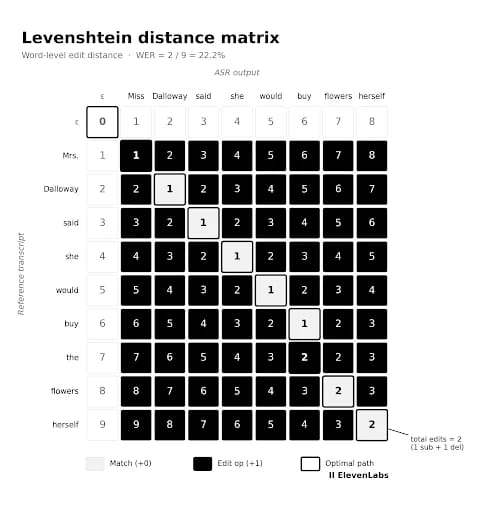
Tworzymy macierz, w której każda komórka reprezentuje całkowitą odległość między oryginalną transkrypcją a transkrypcją ASR. Odległość Levenshteina wypełnia macierz od lewego górnego do prawego dolnego rogu, a ostatnia komórka podaje łączną liczbę edycji na poziomie słów. Podzielenie tej liczby przez N daje WER.
Tę macierz zwykle oblicza się dla pojedynczych znaków, ale dla uproszczenia przedstawiamy powiększoną wersję poprzedniego przykładu.
Typowe pułapki i błędne przekonania dotyczące współczynnika błędów słów
Zwłaszcza że API STT stają się coraz bardziej dostępne, a oprogramowanie ASR jest częstą częścią szerszych stosów agentów, będziemy widzieć wiele porównań różnych narzędzi.
Zanim obliczysz własny współczynnik błędów słów, warto poznać kilka typowych problemów i błędnych przekonań.
- Wszystkie błędy są równe: WER uznaje każdy błąd za równie istotny. W wielu kontekstach to wystarcza, ale w niektórych zastosowaniach jest nie do przyjęcia. Na przykład w szpitalu 5% błędów, uznawane za dobry WER, nadal może być nieakceptowalne, ponieważ nawet jeden lub dwa błędy mogą zagrozić pacjentowi. To ograniczenie doprowadziło do rozwoju nowszych miar, takich jak Semantic Word Error Rate (SWER), która próbuje mierzyć, czy zachowano znaczenie zdania, a nie czy każde słowo dokładnie się zgadza.
- WER może przekraczać 100%: Chociaż wcześniej wskazaliśmy, że WER mieści się między 0 a 1, może on przekroczyć 100%. Dzieje się tak, ponieważ błędy wstawienia mogą dodać więcej słów niż zawiera oryginalna transkrypcja. Typowy przykład to zapisanie „I'm” jako „I am”, gdzie jedno słowo staje się dwoma.
- Niższy WER nie zawsze jest technicznie lepszy: Na papierze WER 5% jest lepszy niż 10%. Ale jeśli błędy składające się na te 5% znacząco zmieniły kontekst zdania, a błędy w 10% nie, wynik nie pokazuje pełnego obrazu. Kontekst nadal ma duże znaczenie, dlatego rozwijane są miary takie jak SWER, które mają uchwycić ten wpływ semantyczny.
W 2024 roku Apple opublikował ciekawe badanie dotyczące ostatniego z tych punktów. Gdy ludzie oceniali wynik WER 9,4% pod kątem tego, czy transkrypcja ASR jest czytelna, przypisali temu samemu fragmentowi WER wynoszący zaledwie 2,2%. W badanym przykładzie ludzie w wielu przypadkach uznali „błędy” za nieistotne, co dało Human WER ponad czterokrotnie bardziej wyrozumiały niż maszyny.
Branżowe punkty odniesienia dla WER
Idealny WER mocno zależy od branży lub zastosowania technologii ASR. Choć <5% to branżowy punkt odniesienia dla WER, w branżach takich jak transkrypcja medyczna czy prawna potrzebny jest znacznie niższy wynik.
W badaniu Artificial Analysis z lipca 2026 r. ElevenLabs Scribe v2 uzyskał WER na poziomie 1,5%. Warto jednak pamiętać, że statystyki te dotyczą zwykle przede wszystkim języka angielskiego. Technologia STT w innych językach może nie być równie skuteczna.
Dokumentacja ElevenLabs omawia ogólne przedziały WER dla wszystkich języków obsługiwanych przez Scribe v1 i Scribe v2.
Zacznij korzystać z ElevenAPI, aby zwiększyć dokładność rozpoznawania
Gdy tworzysz aplikację lub produkt, w którym liczy się jakość transkrypcji, różnica między dobrze dobranym API ASR a przeciętnym najpierw pojawi się w WER, a potem w doświadczeniach użytkowników.
ElevenLabs Scribe to warstwa Speech to Text dostępna przez ElevenAPI. Oprócz obsługi ponad 90 języków i wiodącego w branży WER oferuje funkcje takie jak diarizacja mówców, znaczniki czasu na poziomie słów, podpowiedzi dotyczące kluczowych terminów i wykrywanie encji.
Zapoznaj się z dokumentacją ElevenLabs, aby dowiedzieć się więcej o ElevenAPI, lub zacznij, rejestrując się już dziś.
FAQ: współczynnik błędów słów

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


