
Poradnik rozpoznawania mowy w Pythonie: od pliku audio do transkrypcji
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Dodanie rozpoznawania mowy do aplikacji Python było kiedyś uciążliwe. Deweloperzy Python musieli sami obsługiwać proces transkrypcji, w tym wstępne przetwarzanie dźwięku, ekstrakcję cech i integrację modelu. Zespoły inżynierskie mierzyły się też z niskopoziomową obsługą audio, słabą jakością transkrypcji i opóźnieniami między wypowiedzią a napisami na żywo.
Postęp w modelach audio i SDK do rozpoznawania mowy to zmienia.
W tym poradniku rozpoznawania mowy w Pythonie dowiesz się, jak zintegrować modele audio ElevenLabs Speech to Text z projektem Python, aby tworzyć aplikacje do transkrypcji gotowe do zastosowań komercyjnych.
Podsumowanie
- Komercyjne modele Speech to Text oferują funkcje takie jak diarizacja mówców, znaczniki czasu na poziomie słów i podpowiedzi słów kluczowych, których brakuje podstawowym modelom rozpoznawania mowy.
- ElevenAPI wprowadza do kodu Python funkcje rozpoznawania mowy dzięki Scribe v2 i Scribe v2 Realtime.
- Deweloperzy mogą zainstalować umiejętności ElevenLabs na platformie do kodowania AI, aby generować dokładny kod Python na podstawie oficjalnej dokumentacji API.
- Możesz bezpłatnie wypróbować API ElevenLabs, zanim wybierzesz płatny plan do komercyjnego tworzenia aplikacji.
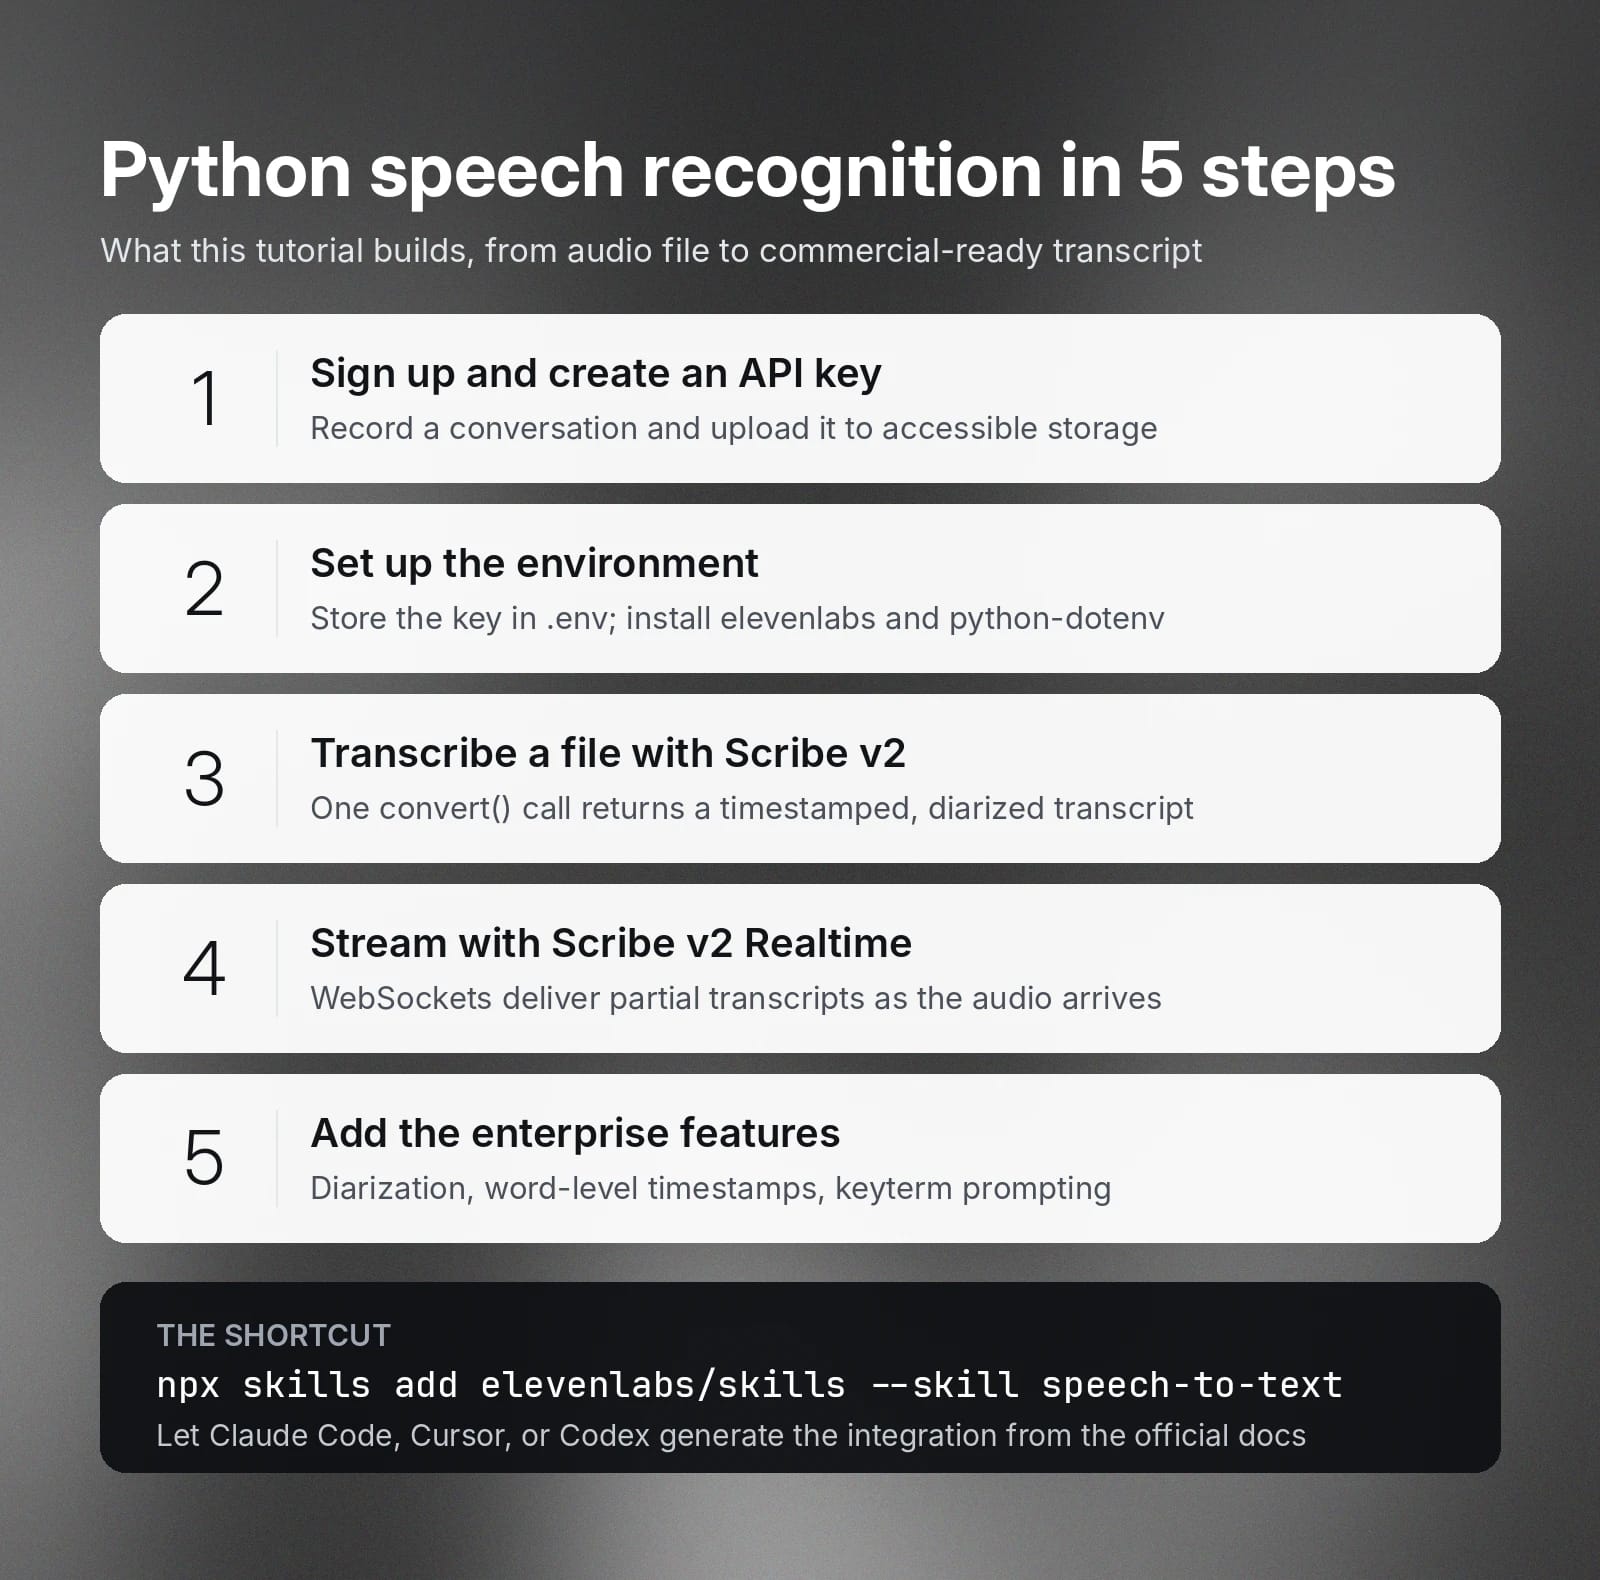
Co obejmuje ten poradnik rozpoznawania mowy w Pythonie
Ten poradnik obejmuje wymagania wstępne, integrację API i zaawansowane funkcje transkrypcji, które pomogą ci stworzyć aplikację Python do rozpoznawania mowy dla firm.
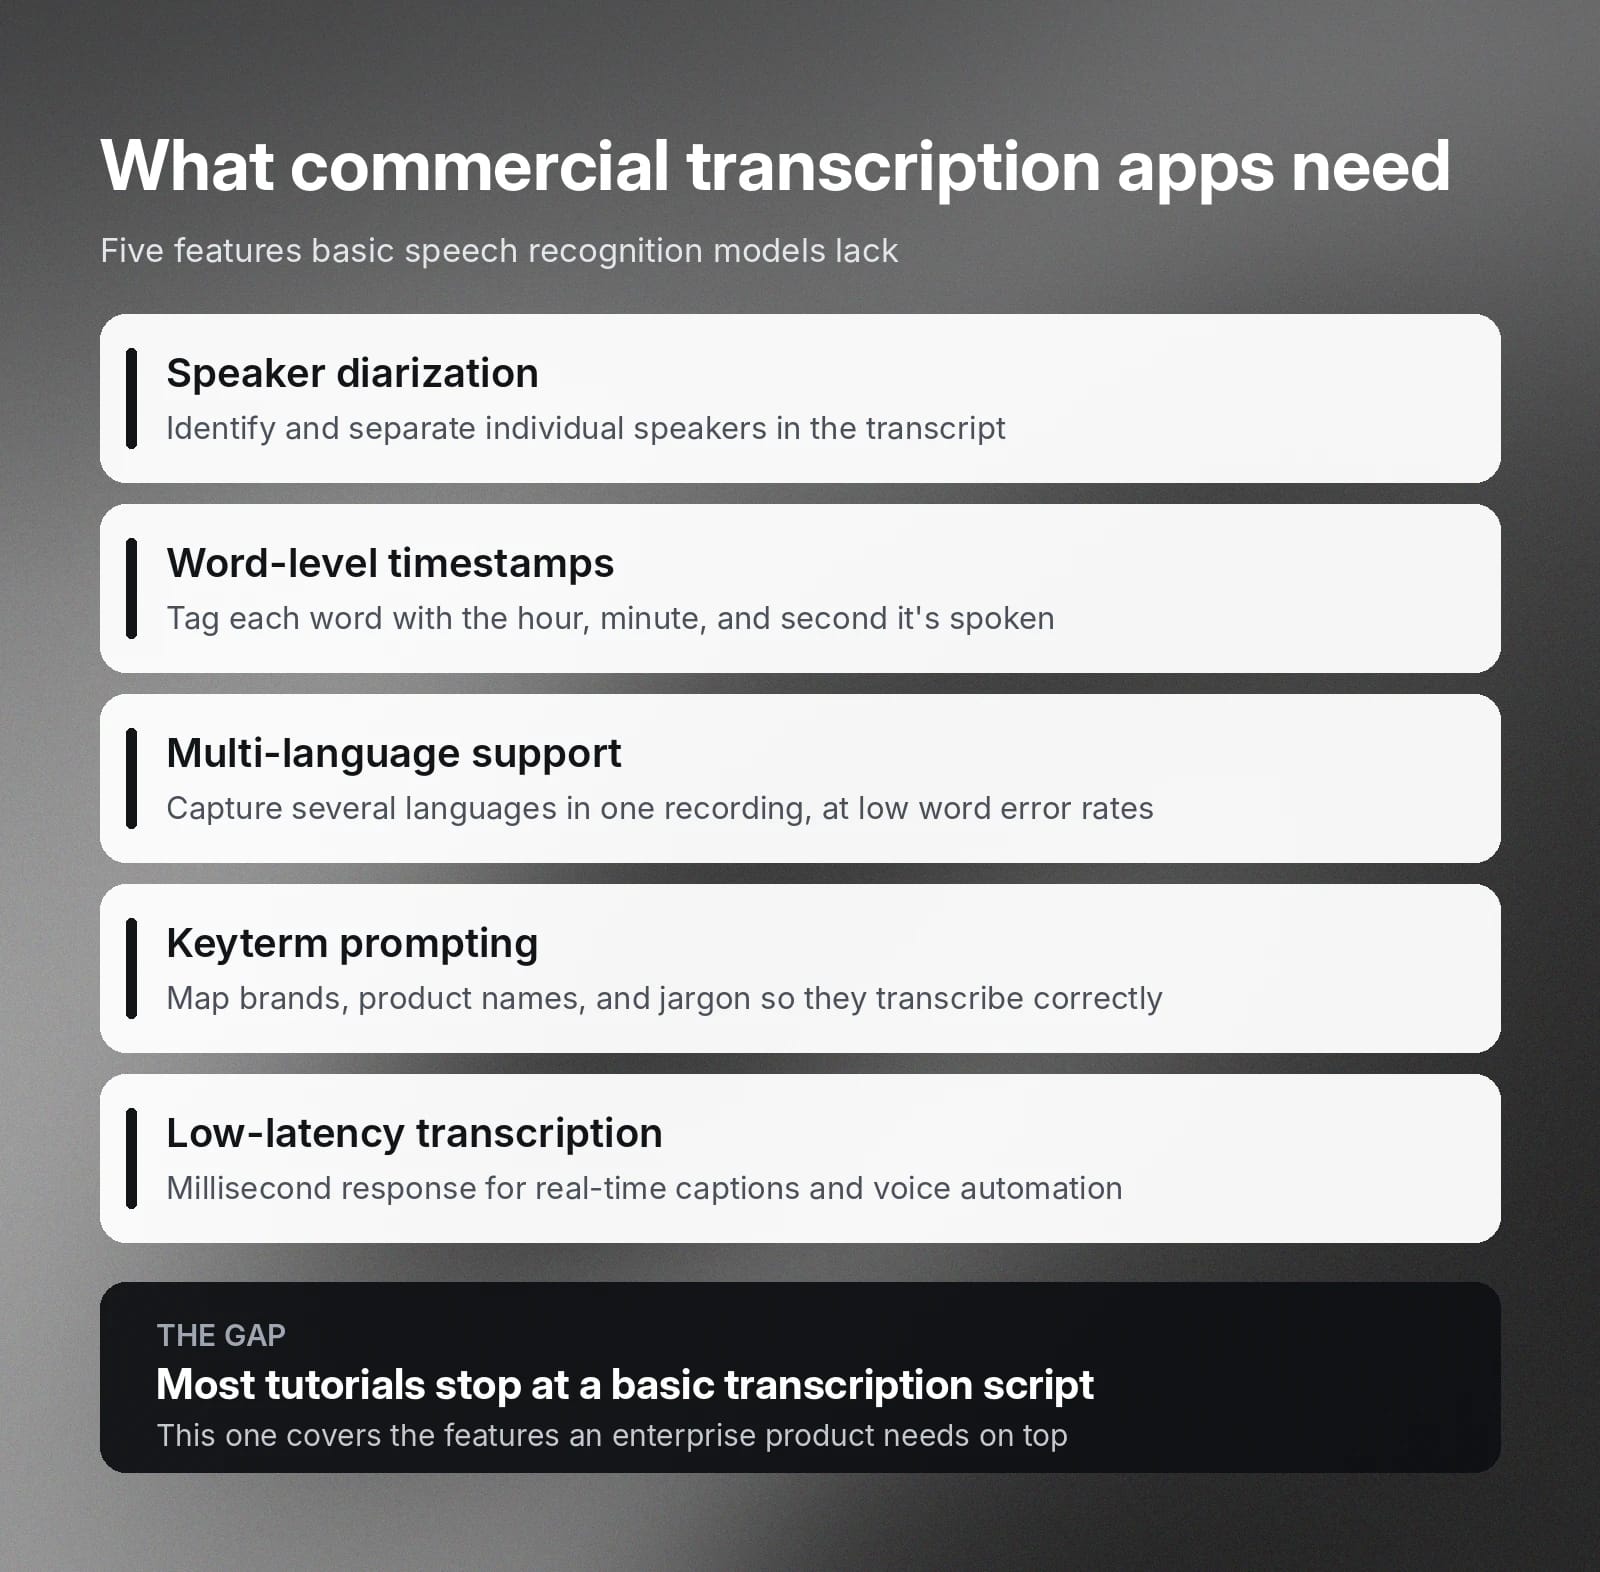
Rozpoznawanie mowy dojrzało w ostatnich latach, zwłaszcza dzięki dużym modelom językowym i sieciom neuronowym głębokiego uczenia, które zmieniły sposób korzystania przez deweloperów Python z SDK do transkrypcji. Wiele poradników pokazuje, jak tworzyć podstawowe aplikacje do transkrypcji, ale niewiele opisuje funkcje potrzebne w produkcie gotowym do zastosowań komercyjnych.
Ten poradnik powstał, by wypełnić tę lukę.
Na przykład wiele firmowych rozwiązań do transkrypcji wymaga tych funkcji:
- Diarizacja mówców: Możliwość rozpoznania i rozdzielenia poszczególnych mówców w transkrypcji.
- Znaczniki czasu: Dokładne oznaczanie każdego słowa godziną, minutą i sekundą, w której zostało wypowiedziane.
- Obsługa wielu języków: Rozpoznawanie wypowiedzi w różnych językach w jednym nagraniu lub strumieniu na żywo przy niskim współczynniku błędów słów.
- Podpowiedzi słów kluczowych: Mapowanie specjalnych słów, takich jak marki, nazwy produktów i terminy techniczne, aby uniknąć błędów w transkrypcji.
- Transkrypcja z niskim opóźnieniem: Reakcja zamiany mowy na tekst w milisekundach, która zasila aplikacje do transkrypcji w czasie rzeczywistym.
Uwaga: Ten poradnik wykracza poza tworzenie prostych, osobistych skryptów do zastosowań hobbystycznych lub prywatnych. Nie obejmuje logiki aplikacji zbudowanej na integracji z API Speech to Text, ponieważ różni się ona zależnie od firmy.
Wymagania wstępne integracji rozpoznawania mowy w Pythonie
Ten poradnik opiera się na ElevenAPI — gotowym do produkcji API od ElevenLabs, które upraszcza interakcję z modelami głosowymi w kodzie. Dzięki ElevenAPI masz dostęp do Scribe v2 i Scribe v2 Realtime — naszych czołowych modeli głosowych do transkrypcji wsadowej i na żywo.
Zamiast korzystać bezpośrednio z modeli ElevenLabs Speech to Text, przekazujesz nagrania audio, transmisje na żywo i argumenty w wywołaniach API. Model audio przekształca następnie dane audio w tekst. Po zakończeniu otrzymujesz transkrypcje w kodzie lub przez webhook.
Aby zacząć, wykonaj te kroki przygotowawcze.
- Załóż konto ElevenLabs.
- Utwórz klucz API.
- Nagraj rozmowę i prześlij ją do publicznie dostępnego magazynu.
Gdy wszystko będzie gotowe, przejdź do następnej sekcji.
Konfiguracja środowiska
Przed integracją z modelami ElevenLabs skonfiguruj środowisko Python, aby zabezpieczyć klucz API ElevenLabs. Jak wszystkie klucze API, zalecamy przechowywać go jako zmienną środowiskową (zarządzany sekret) w pliku .env.
Podczas wywołania API przekazujesz zmienną środowiskową. Dzięki temu nie ujawnisz przypadkowo klucza API podczas wysyłania żądań API przez publiczną sieć.
Następnie uruchom polecenie Bash, aby zainstalować elevenlabs, SDK ElevenLabs, w środowisku Python. SDK daje dostęp do różnych modeli głosowych. W tym przypadku wybierasz między Scribe v2 a Scribe v2 Realtime.
Musisz też zainstalować python-dotenv, który pozwala kodowi Python uzyskać dostęp do zmiennych środowiskowych zapisanych w pliku .env.
Tworzenie pierwszego skryptu do transkrypcji
Po skonfigurowaniu środowiska Python możesz transkrybować plik audio za pomocą ElevenLabs Scribe v2.
ElevenLabs Scribe v2 to wiodący w branży model rozpoznawania mowy, który pozwala transkrybować pliki audio na dużą skalę. Z wysoką dokładnością wykrywa fonemy nawet wtedy, gdy nagranie zawiera dużo szumu tła. Aby transkrybować audio, wysyłasz nagranie do modelu przez API ElevenLabs i pobierasz gotową transkrypcję.
Poniżej znajdziesz fragment kodu Python, który przekształca plik audio w transkrypcję ze znacznikami czasu i diarizacją.
Kod ładuje potrzebne biblioteki, które udostępniają wymagane funkcje. Ładuje też do środowiska programu zadeklarowane zmienne środowiskowe.
Następnie tworzy klienta ElevenLabs, używając klucza API zapisanego w zmiennej środowiskowej. Potem pobiera plik audio i konwertuje go na dane binarne.
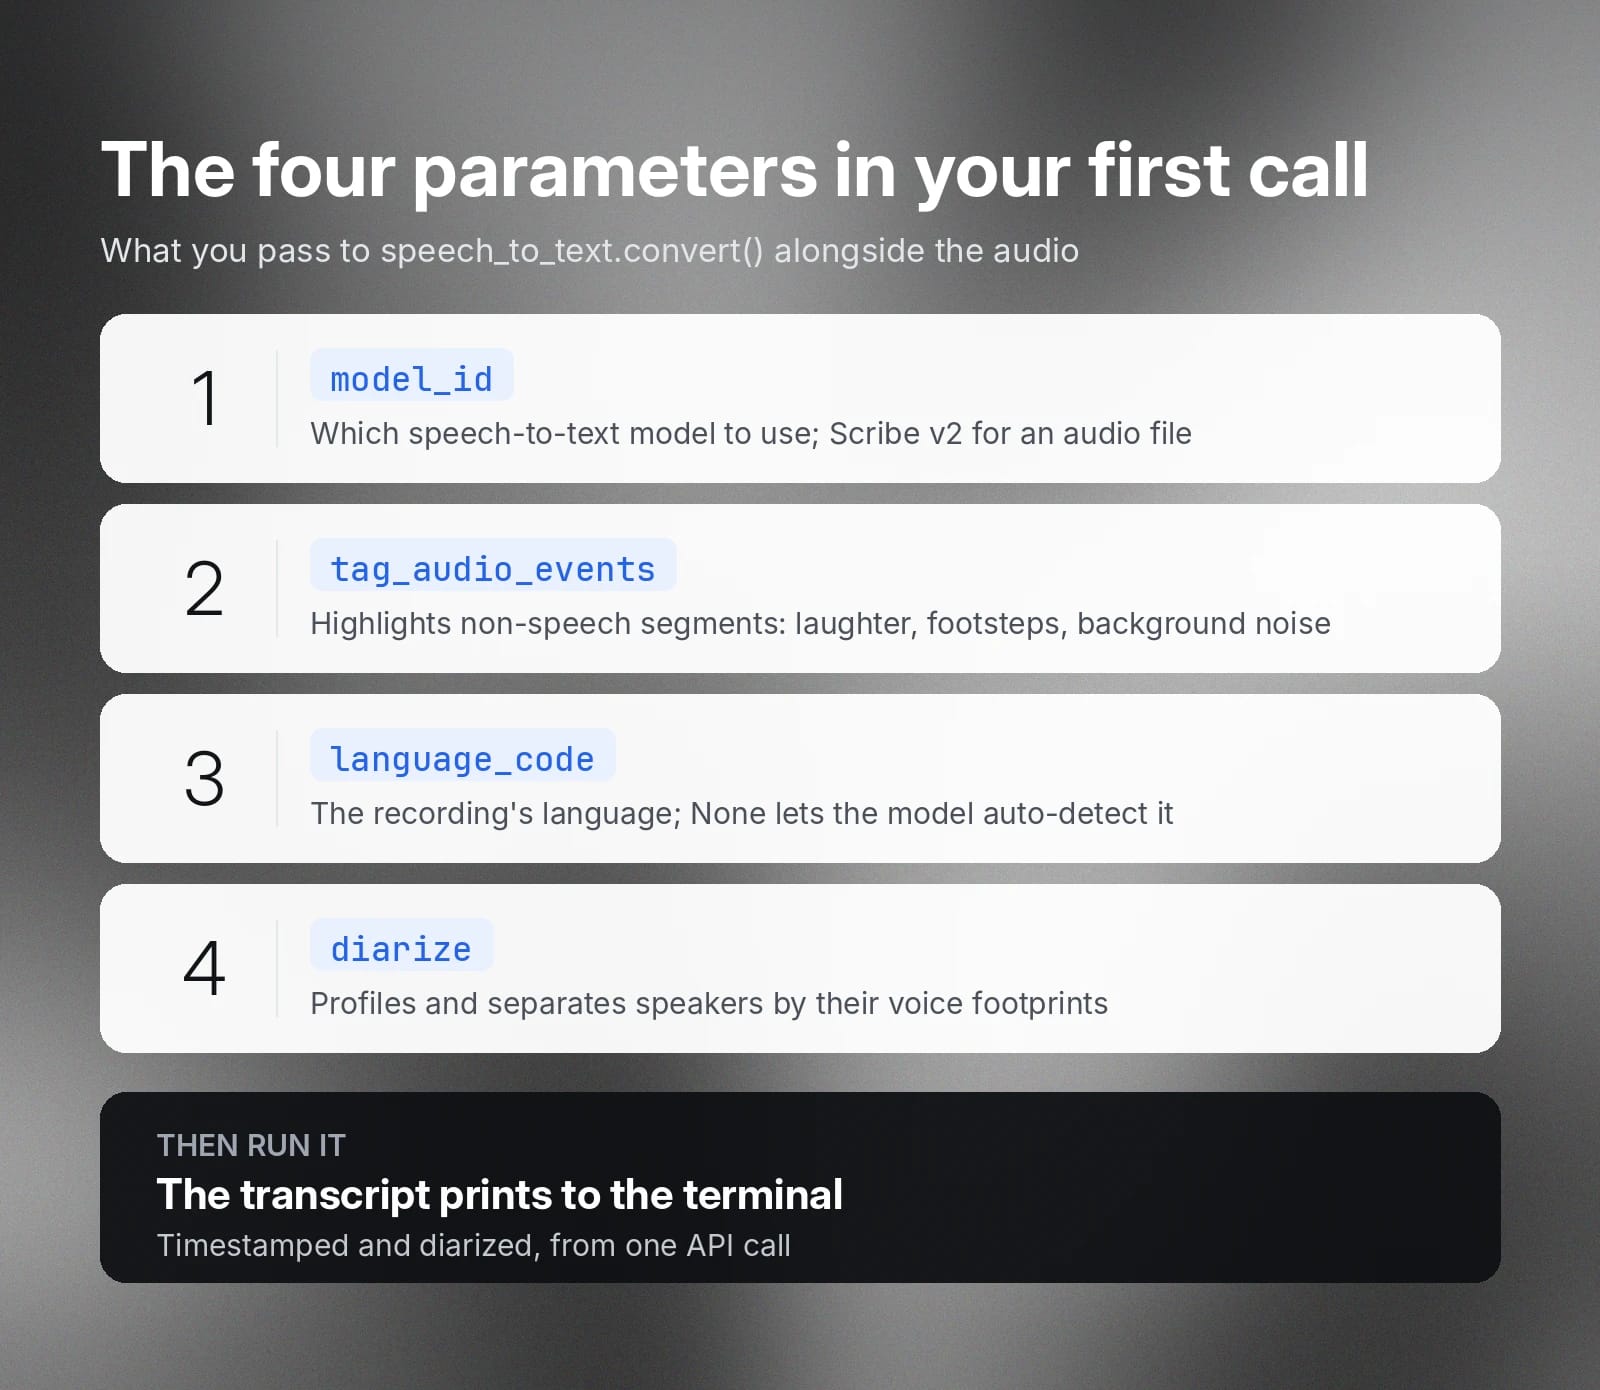
Gdy masz już surowe dane audio, wysyłasz je do API ElevenLabs wraz z kilkoma parametrami.
- model_id wskazuje model zamiany mowy na tekst, którego chcesz użyć. Ponieważ przekazujesz plik audio, Scribe v2 będzie najlepszym wyborem.
- tag_audio_events pozwala oznaczać fragmenty bez mowy, takie jak śmiech, kroki i inne szumy tła.
- language_code określa język rozmów w pliku nagrania. Jeśli ustawisz None, model automatycznie wykryje język.
- diarize wskazuje czy chcesz, aby model rozpoznał i rozdzielił różnych mówców na podstawie cech ich głosu.
Na koniec uruchom kod, a w terminalu zobaczysz transkrypcję audio.
Strumieniowe rozpoznawanie mowy w Pythonie
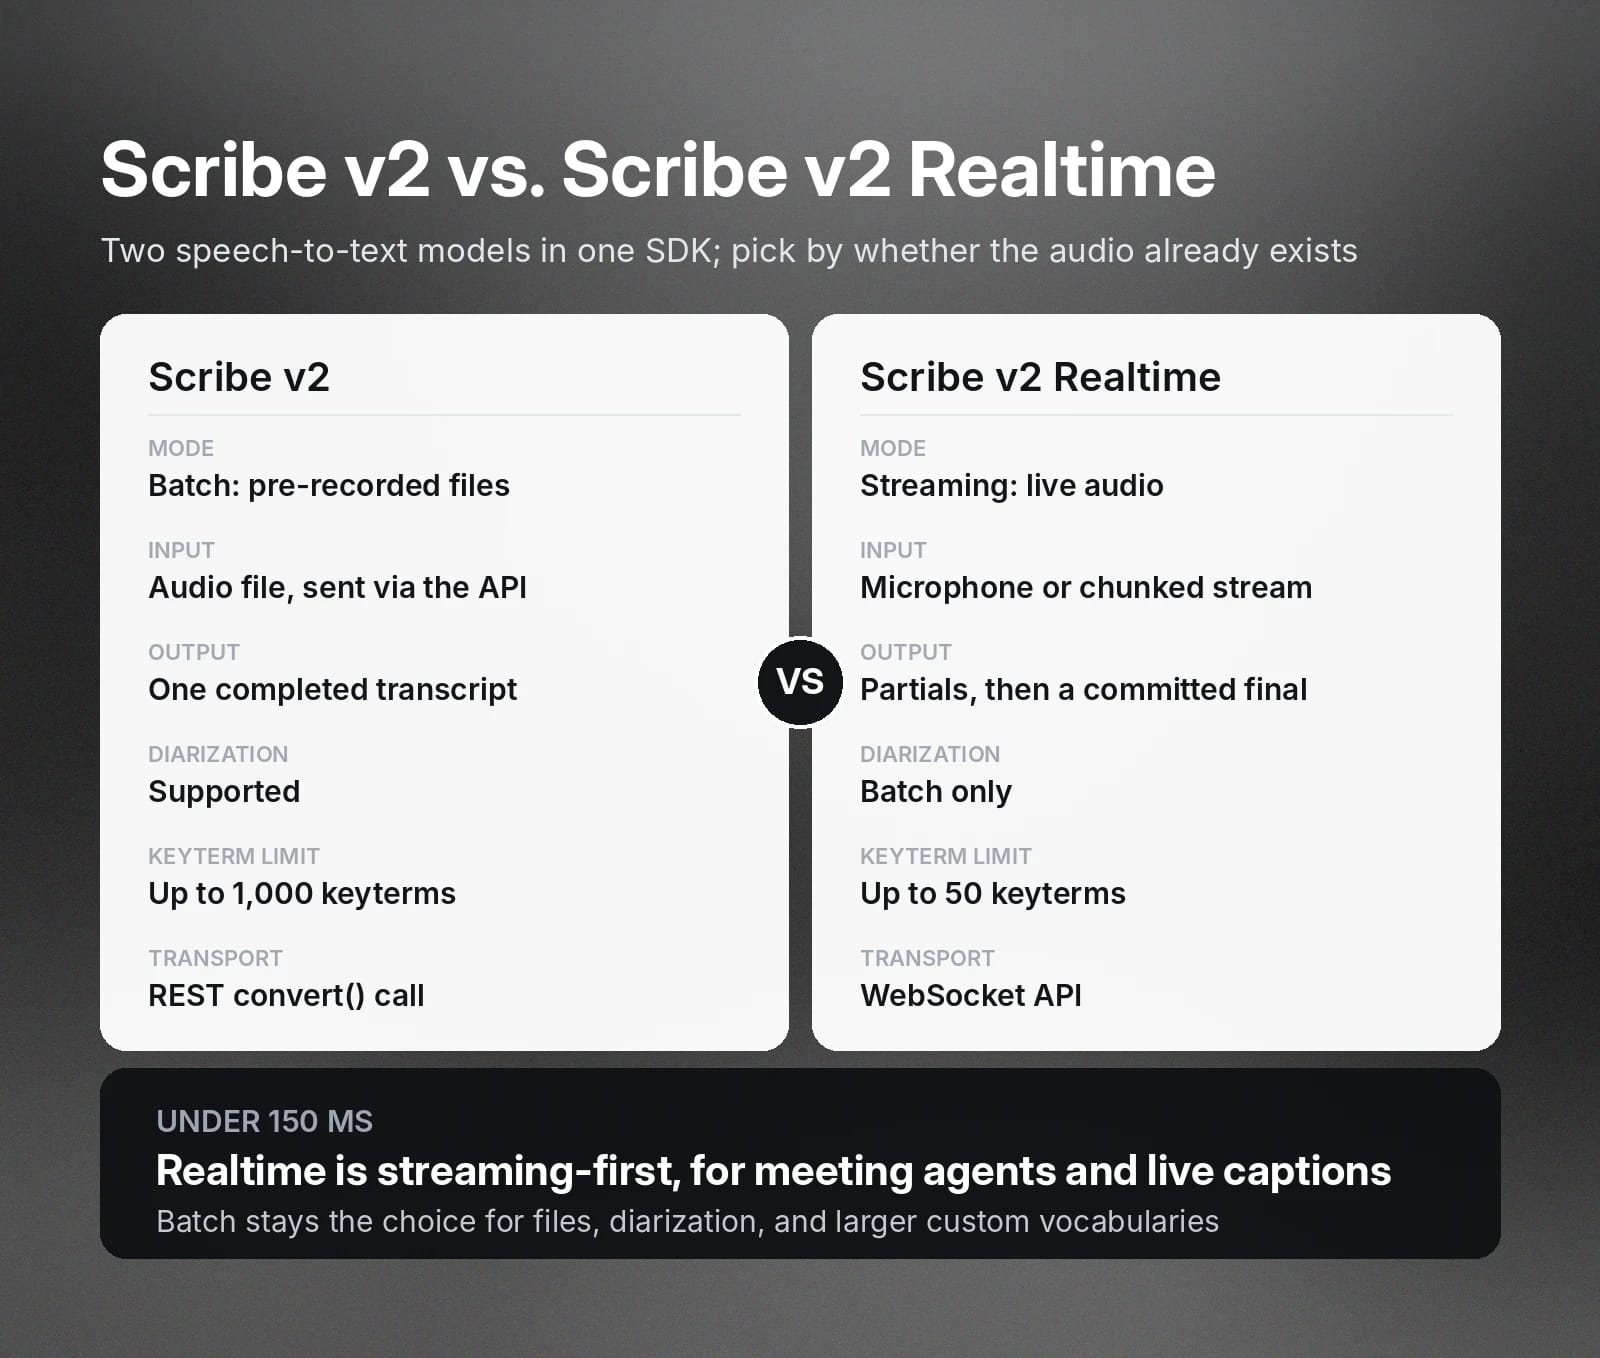
Powyższy przykład dotyczy transkrypcji wsadowej, która sprawdza się w przypadku wcześniej nagranych plików. ElevenLabs oferuje jednak także API do strumieniowego rozpoznawania mowy. W przeciwieństwie do przetwarzania wsadowego ten tryb rozpoznaje mowę w czasie rzeczywistym i tworzy transkrypcje w trakcie rozmowy.
Aby to zrobić, połącz kod Python z modelem Scribe v2 Realtime za pomocą API WebSocket.
Scribe v2 Realtime oferuje architekturę stworzoną z myślą o streamingu i opóźnienie transkrypcji poniżej 150 ms. Scribe v2 Realtime możesz wykorzystać do tworzenia aplikacji, takich jak agenci do spotkań, narzędzia ułatwień dostępu i automatyzacje aktywowane głosem. Model zwraca częściową transkrypcję podczas przetwarzania strumienia audio. Końcową transkrypcję zwraca dopiero, gdy kod zatwierdzi segment audio — automatycznie lub ręcznie.
W zależności od źródła audio i typu aplikacji integrujesz rozpoznawanie mowy z API ElevenLabs po stronie serwera lub klienta.
- Streaming po stronie klienta umożliwia przesyłanie strumienia bezpośrednio z mikrofonu lub przez ręcznie dzielone strumienie audio.
- Streaming po stronie serwera kieruje dane audio z adresu URL lub źródła audio do modelu głosowego.
Streaming po stronie klienta i serwera pozwala korzystać z asynchronicznego workflow. Zamiast stale odpytywać API, użyj WebSocketów do obsługi wyników. W kodzie musisz utworzyć handlery odbierające częściowe i ukończone transkrypcje.
Dalsze możliwości: diarizacja, znaczniki czasu i własne słownictwo
Oprócz automatycznego rozpoznawania mowy, modele ElevenLabs Speech to Text obsługują diarizację, znaczniki czasu i własne słownictwo.
- Diarizacja: Tylko transkrypcja wsadowa obsługuje diaryzację mówców. Włączysz diarizację, ustawiając argument diarize. Transkrypcja wielokanałowa, czyli tryb transkrypcji wsadowej, nie obsługuje jednak diarizacji.
- Znaczniki czasu: W transkrypcji wsadowej możesz wybrać znaczniki czasu na poziomie słów lub znaków. W tym celu ustaw parametr timestamps_granularity podczas używania metody convert.
- Własne słownictwo: Zarówno transkrypcja w czasie rzeczywistym, jak i wsadowa obsługują podpowiedzi słów kluczowych. Ta funkcja kieruje model w stronę transkrypcji określonych słów kluczowych z podanej listy. Scribe v2 Realtime obsługuje do 50 słów kluczowych, a Scribe v2 — 1000.
Korzystanie z umiejętności ElevenLabs w asystentach programowania AI
Asystenci programowania AI przyspieszają tworzenie aplikacji. Jeśli używasz narzędzi takich jak Claude Code, Cursor, Codex czy podobnych narzędzi AI do programowania, możesz dodać umiejętności ElevenLabs w środowisku programistycznym.
Wystarczy uruchomić to polecenie w terminalu platformy:
Agent programowania AI pobierze umiejętność zamiany mowy na tekst z repozytorium ElevenLabs na GitHubie i zainstaluje ją w lokalnym katalogu umiejętności. Dzięki temu możesz automatycznie generować kod Python do rozpoznawania mowy na podstawie oficjalnej dokumentacji ElevenLabs, zamiast pisać całą integrację API od zera.
Po instalacji możesz generować kod Python do rozpoznawania mowy, po prostu opisując w języku naturalnym, co ma robić. Na podstawie opisu asystent programowania automatycznie wygeneruje kod z użyciem umiejętności zamiany mowy na tekst, z odpowiednim modelem i parametrami.
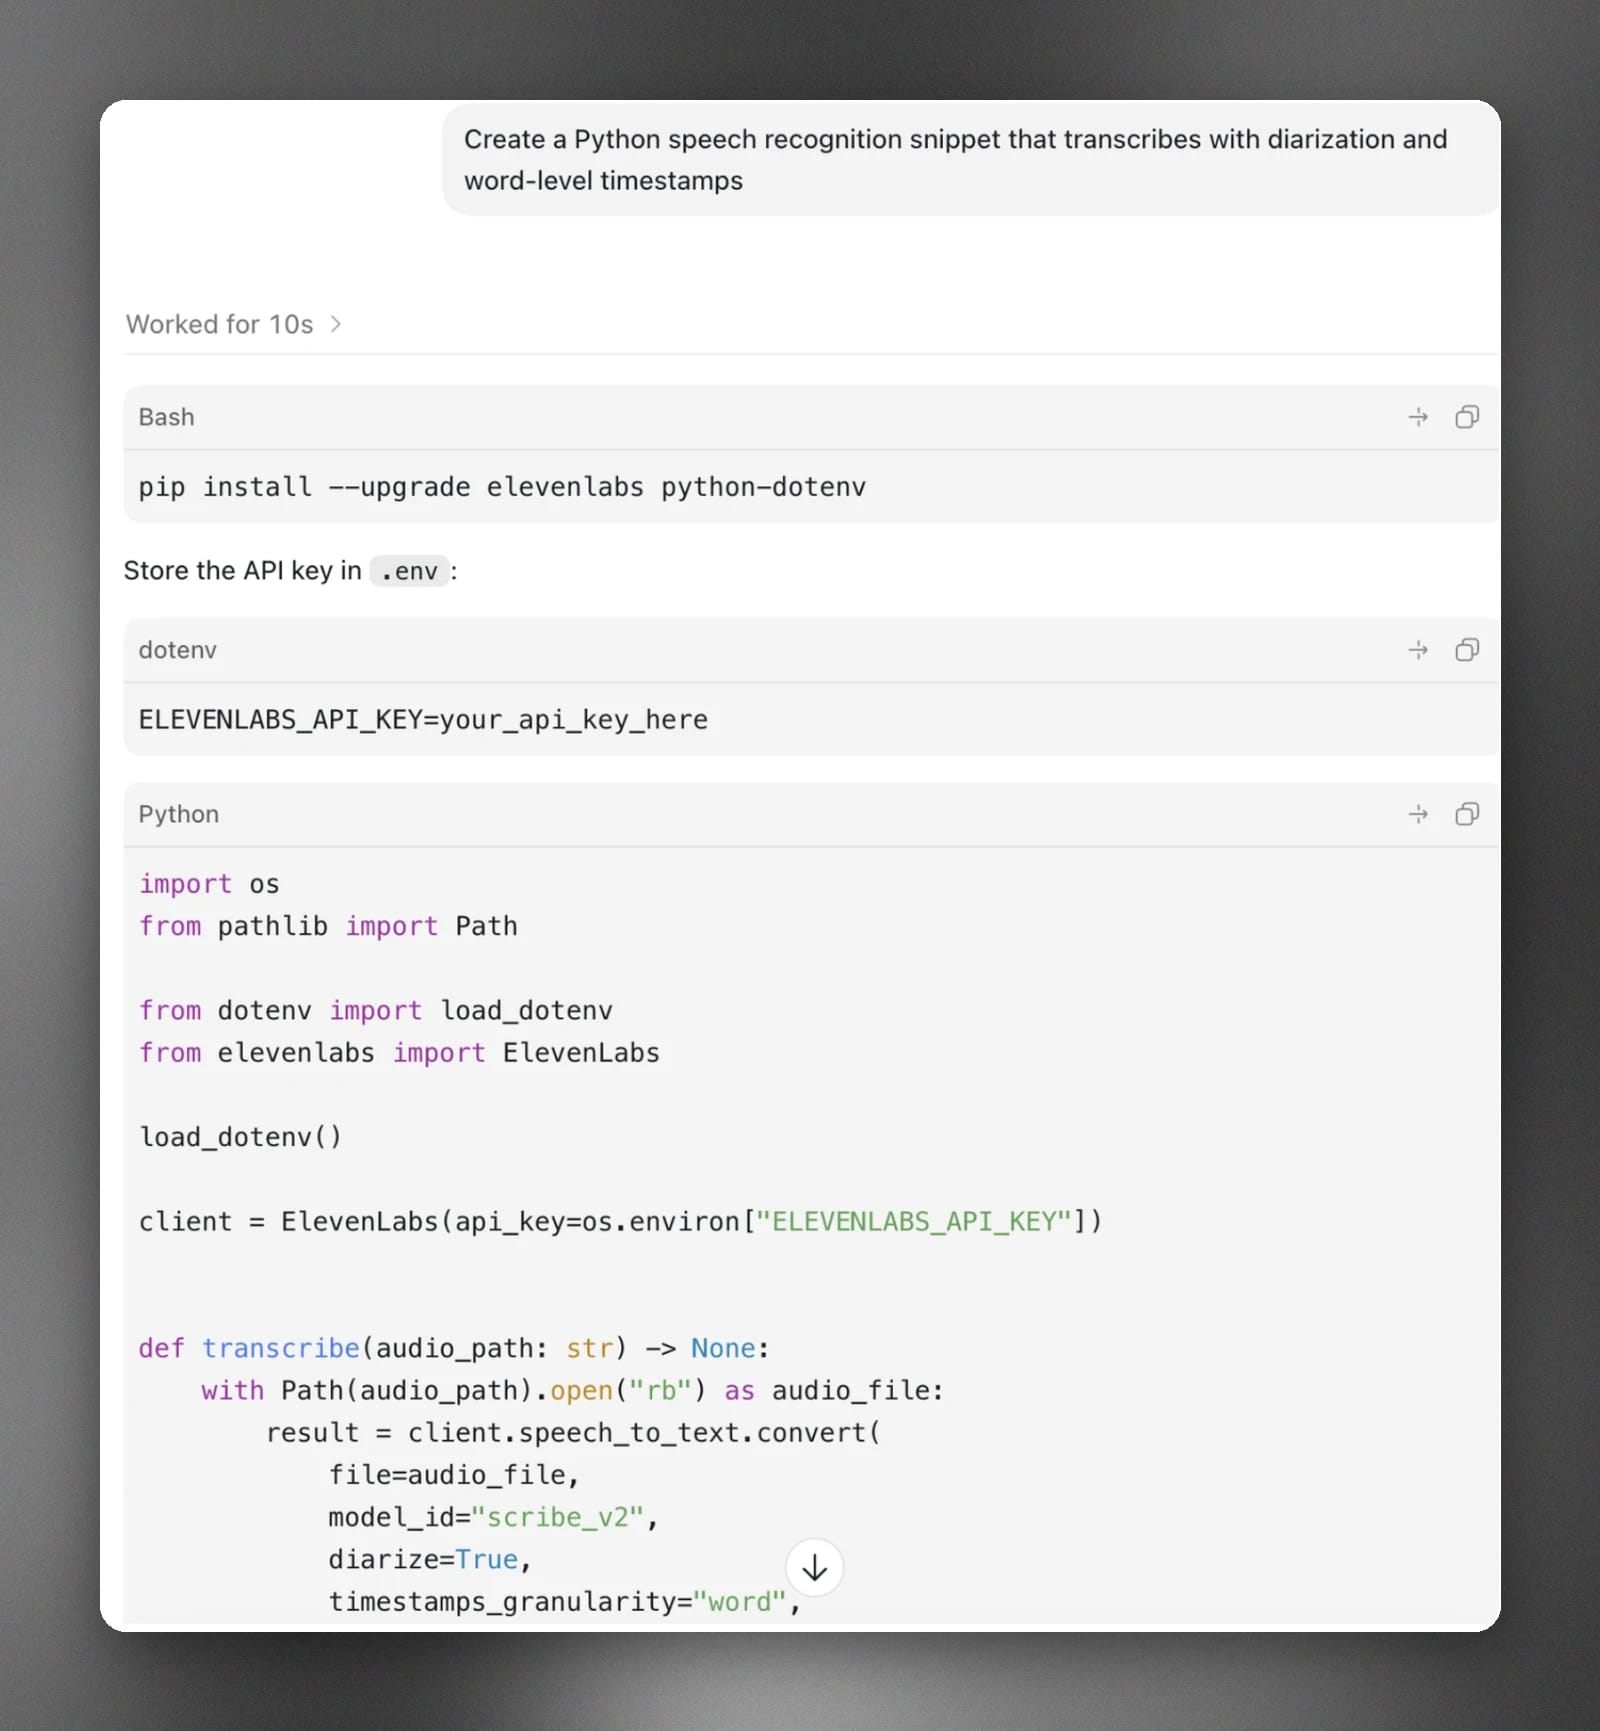
Na przykład jeśli wpiszesz w Codex „Utwórz fragment kodu Python do rozpoznawania mowy, który transkrybuje z diarizacją i znacznikami czasu na poziomie słów”, otrzymasz podobny fragment jak poniżej.
Zacznij korzystać z ElevenAPI do rozpoznawania mowy
ElevenAPI zapewnia dostęp do zaawansowanych modeli Speech to Text do tworzenia aplikacji rozpoznawania mowy w Pythonie.
Korzystając z ElevenAPI, unikasz pisania kodu integracji od zera, co opóźnia rozwój produktu. Zamiast tego używasz SDK, które udostępniają usługi Speech to Text spełniające wymagania komercyjne, takie jak podpowiedzi słów kluczowych, diarizacja i znaczniki czasu.
Uzyskaj teraz klucz API ElevenLabs i sprawdź naszą oficjalną dokumentację, aby dowiedzieć się, jak działa API.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


