Transkrypcja w czasie rzeczywistym a wsadowa: kluczowe różnice
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Przy wyborze modelu transkrypcji opartego na AI masz dwie opcje: transkrypcję w czasie rzeczywistym lub wsadową. Obie zamieniają mowę na tekst, ale działają inaczej.
Transkrypcja w czasie rzeczywistym przetwarza audio na bieżąco, a wsadowa — całe nagranie po jego zakończeniu. Ta pierwsza daje natychmiastowe wyniki, a druga jest zwykle dokładniejsza.
W tym przewodniku porównamy transkrypcję w czasie rzeczywistym i wsadową, aby pomóc ci wybrać model do kolejnego projektu. Wyjaśnimy, jak działa każdy z nich, ich zalety, wady i typowe zastosowania.
Podsumowanie
- Transkrypcja w czasie rzeczywistym przetwarza audio na bieżąco.
- Transkrypcja wsadowa przetwarza cały plik audio jednocześnie.
- Transkrypcja w czasie rzeczywistym jest szybsza, ale wsadowa jest dokładniejsza, ponieważ model ma dwukierunkowy kontekst z całego pliku audio.
- Transkrypcja w czasie rzeczywistym najlepiej sprawdza się w aplikacjach takich jak działający na żywo agenci głosowi, napisy do transmisji wideo czy notatki ze spotkań, gdzie szybkość jest ważniejsza niż dokładność.
- Transkrypcja wsadowa jest dokładniejsza i bardziej opłacalna przy masowej transkrypcji nagrań po ich zarejestrowaniu.
Czym jest transkrypcja w czasie rzeczywistym w STT?
Transkrypcja w czasie rzeczywistym to sytuacja, gdy model zamiany mowy na tekst (STT) zamienia audio na tekst w trakcie mówienia. Nazywa się ją też czasem transkrypcją strumieniową.
W transkrypcji w czasie rzeczywistym model STT przetwarza audio w małych fragmentach. Tekst jest dostępny już milisekundy po wypowiedzeniu słów. W miarę trwania rozmowy model STT zbiera więcej danych i kontekstu, aby dopracować transkrypcję.
Ten rodzaj transkrypcji najlepiej działa tam, gdzie szybkość jest ważniejsza niż dokładność. Na przykład modele te zwiększają dostępność transmisji audio i wideo dzięki napisom na żywo. Innym częstym zastosowaniem są platformy do robienia notatek w czasie rzeczywistym.
Czym jest transkrypcja wsadowa w STT?
Transkrypcja wsadowa zamienia całe nagranie z mowy na tekst jednocześnie, po zakończeniu nagrania. Proces trwa od kilku sekund do ponad 10 minut — zależnie od długości i złożoności nagrania.
Modele transkrypcji wsadowej korzystają podczas pracy z kontekstu całego nagrania. Pełny kontekst pomaga modelowi poprawnie interpretować fragmenty ze złożonym językiem, szumem tła lub przerwami. Modele te dodają też interpunkcję i formatowanie, z czym niektóre modele działające w czasie rzeczywistym mogą sobie nie radzić.
Transkrypcja wsadowa najlepiej sprawdza się, gdy najważniejsza jest dokładność. Wiele organizacji używa modeli wsadowych do transkrypcji długich wywiadów, spotkań lub podcastów do swoich archiwów.
Jak architektury wsadowe i strumieniowe wpływają na transkrypcję
Porównując przetwarzanie wsadowe i strumieniowe w transkrypcji, warto pamiętać, że oba modele działają na zupełnie innych zasadach, co wpływa na wynik końcowy.
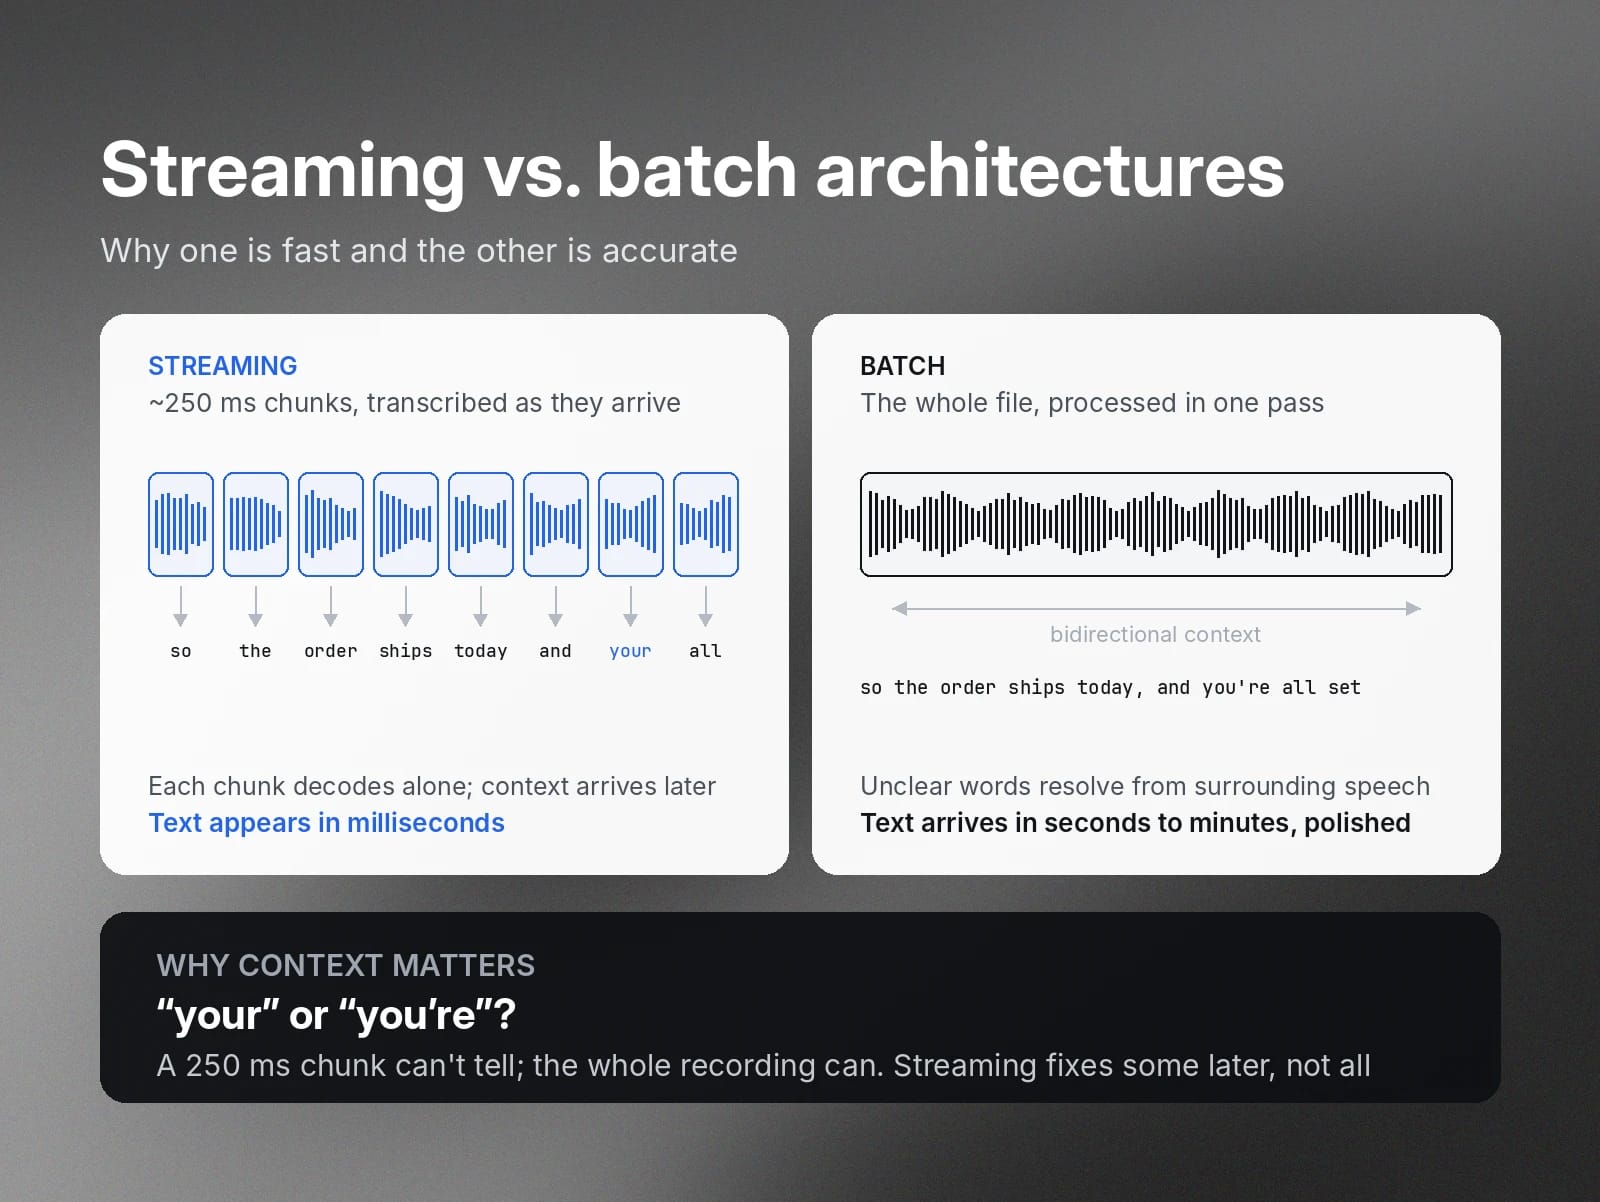
Modele transkrypcji strumieniowej dzielą audio na fragmenty i transkrybują każdy z nich na bieżąco. Te fragmenty są bardzo krótkie, zwykle mają około 250 milisekund lub mniej. Dzięki temu model może działać szybko, a tekst pojawia się zaledwie kilka sekund po dźwięku.
Ponieważ te fragmenty audio są tak krótkie, model Speech to Text nie ma pełnego kontekstu rozmowy, co może prowadzić do błędów. Na przykład model transkrypcji może użyć „your” zamiast „you're”.
Model transkrypcji w czasie rzeczywistym poprawi część tych błędów w miarę trwania rozmowy i wyjaśniania się kontekstu. Zwykle jednak nie ma dość czasu ani kontekstu, by poprawić każdy błąd, więc końcowa transkrypcja nie zawsze jest w 100% dokładna.
Z kolei modele transkrypcji wsadowej przetwarzają cały plik audio naraz. Dzięki temu model ma dwukierunkowy kontekst rozmowy, którego używa do wyjaśniania niejasnych słów i fraz. Gdy coś w pliku audio jest niejasne, analizuje słowa przed i po danym fragmencie, aby ustalić, co zostało powiedziane, i dokładnie to zapisać.
Ten dodatkowy kontekst sprawia, że modele wsadowe działają wolniej niż modele w czasie rzeczywistym. Końcowy efekt jest jednak znacznie dokładniejszy i lepiej dopracowany.
Kluczowe cechy modeli transkrypcji w czasie rzeczywistym i wsadowej: opóźnienie, dokładność i koszt
Modele działające w czasie rzeczywistym i wsadowe skutecznie transkrybują audio — wszystko zależy od rodzaju projektu. Niektóre wymagają natychmiastowych wyników, a inne wysokiej dokładności.
Oto czynniki, które warto uwzględnić przy wyborze między transkrypcją w czasie rzeczywistym a wsadową:
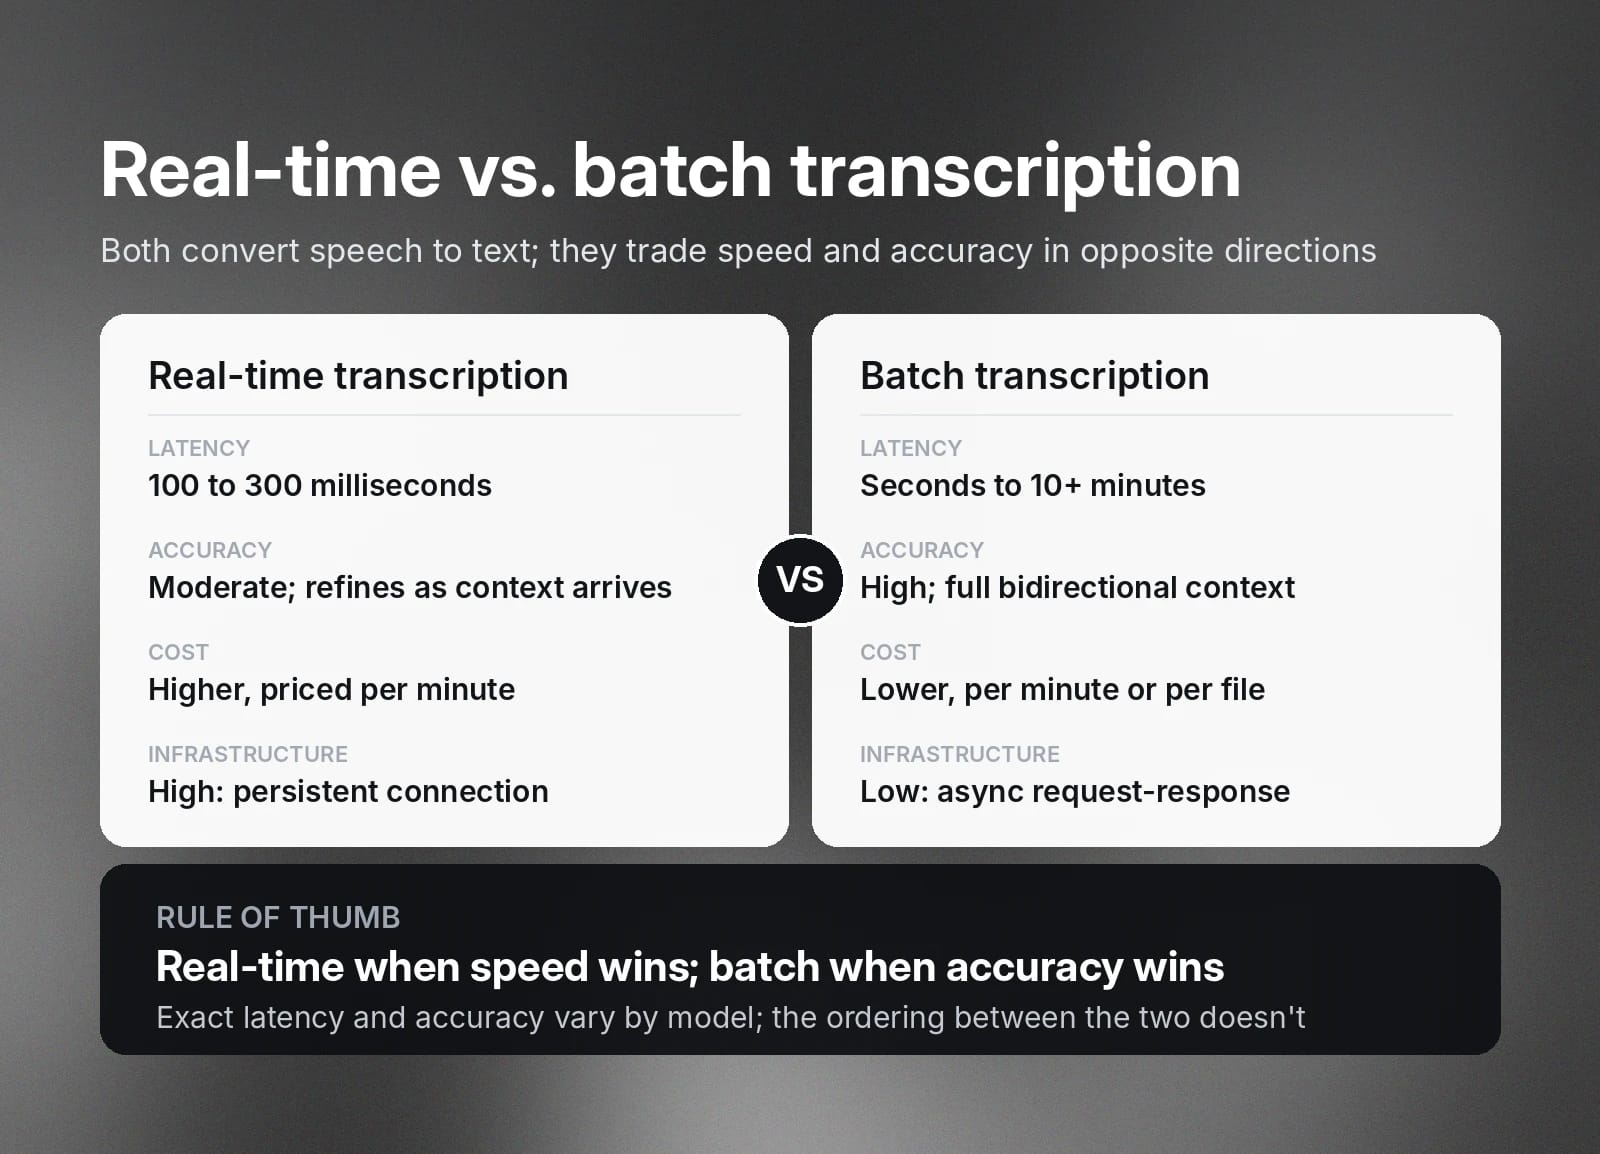
Transkrypcja w czasie rzeczywistym | Transkrypcja wsadowa | |
Opóźnienie | Od 100 do 300 milisekund | Od kilku sekund do ponad 10 minut, zależnie od długości pliku |
Dokładność | Średnia | Wysoka |
Koszt | Wysoki, cena za minutę | Średni, cena za minutę lub plik |
Złożoność infrastruktury | Wysoka, wymaga stabilnego połączenia i równoważenia obciążenia | Niska, wykorzystuje asynchroniczną strukturę żądań i odpowiedzi |
Dokładne wartości opóźnienia i dokładności zależą od używanego modelu transkrypcji. Transkrypcja w czasie rzeczywistym jest jednak konsekwentnie szybsza, a wsadowa — dokładniejsza.
Transkrypcja w czasie rzeczywistym kosztuje więcej niż wsadowa, ponieważ wymaga bardziej złożonej infrastruktury i generuje większe koszty operacyjne. Modele czasu rzeczywistego potrzebują stabilnego połączenia, by utrzymać szybkość, a ich wdrożenie i utrzymanie zajmuje więcej czasu niż w przypadku modeli wsadowych.
Modele czasu rzeczywistego są warte inwestycji, gdy liczy się dostępność podczas rozmów na żywo. Jeśli szybkość nie jest priorytetem, transkrypcja wsadowa oszczędza pieniądze i czas wdrożenia.
Porównanie API transkrypcji w czasie rzeczywistym i wsadowej: wybierz rozwiązanie do swojego projektu
Przed rozpoczęciem nowego projektu transkrypcji oceń zalety i wady modeli wsadowych oraz działających w czasie rzeczywistym, aby wybrać najlepszy dla swoich celów. Tak wygląda proces decyzyjny w trzech praktycznych scenariuszach.
Agent głosowy na żywo: Transkrypcja w czasie rzeczywistym
Modele Conversational AI działające na żywo wymagają niemal natychmiastowej transkrypcji dla zapewnienia dostępności, szczególnie przy obsłudze złożonych procesów lub spraw klientów.
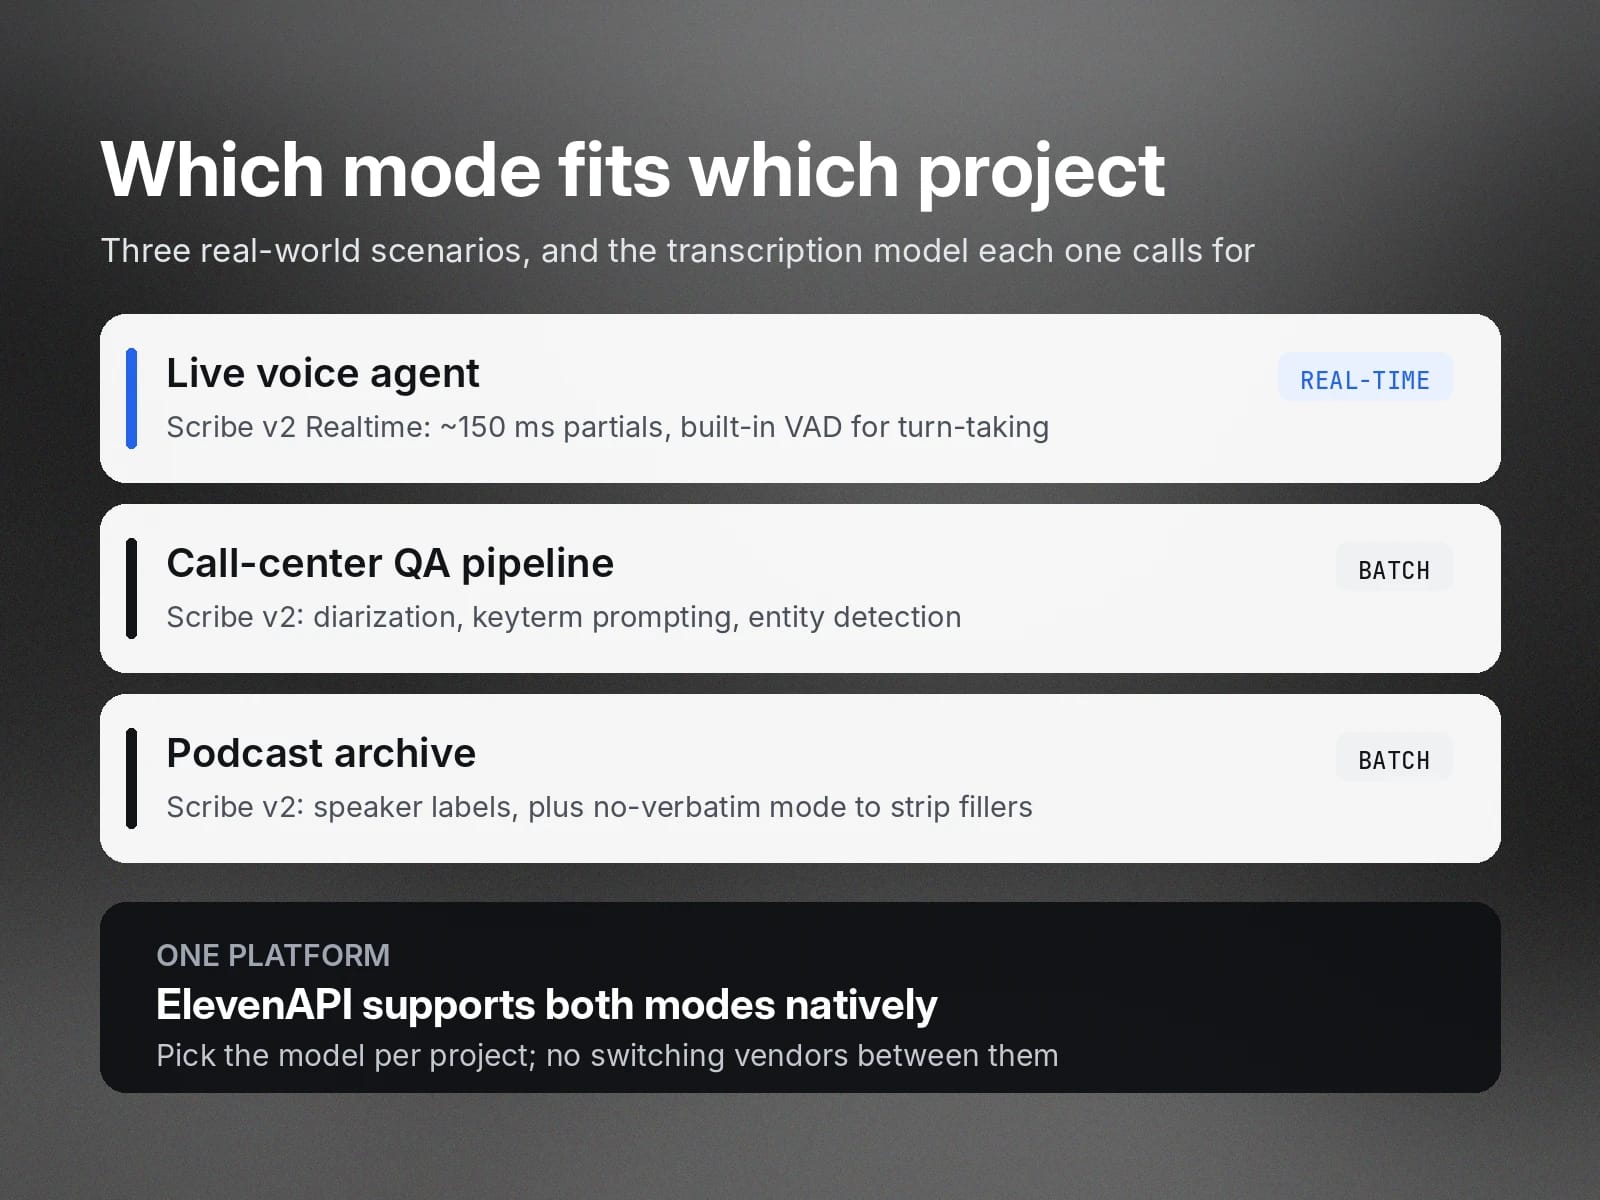
Model działający w czasie rzeczywistym, taki jak Scribe v2 Realtime, zapewnia niskie opóźnienie potrzebne do płynnych, naturalnych rozmów. Scribe v2 Realtime dostarcza częściowe transkrypcje w około 150 milisekund.
Modele transkrypcji dla agentów głosowych na żywo muszą też dobrze rozpoznawać kolejność wypowiedzi. Oznacza to, że powinny umieć wykrywać, kiedy użytkownik zaczyna lub kończy mówić i natychmiast reagować. Skuteczne zarządzanie kolejnością wypowiedzi i przerwami pomaga uniknąć opóźnienia transkrypcji względem rozmowy.
Modele transkrypcji w czasie rzeczywistym stawiają na dokładne rozpoznawanie kolejności wypowiedzi, aby szybko dostarczać wyniki. Na przykład Scribe v2 Realtime ma wbudowane Voice Activity Detection, więc automatycznie dzieli transkrypcję, gdy wykryje ciszę między rozmówcami.
Pipeline QA dla call center: Transkrypcja wsadowa
Dokładność jest kluczowa w kontroli jakości, więc w tym scenariuszu najlepiej sprawdzi się model transkrypcji wsadowej, taki jak Scribe v2.
Transkrypcje rozmów z call center często zawierają nietypowe nazwy i szczegóły charakterystyczne dla danej branży. Jeśli nie zostaną poprawnie zapisane, analitykom trudno ocenić, czy rozmowa rzeczywiście zakończyła się sukcesem. Ponieważ modele wsadowe przetwarzają całe nagranie naraz, mają kontekst potrzebny do dokładnej transkrypcji i formatowania.
Scribe v2 oferuje kilka funkcji zwiększających dokładność transkrypcji. Diarizacja mówców zapewnia prawidłowe oznaczenie agentów i klientów, nawet gdy mówią jednocześnie. Podpowiedzi dotyczące kluczowych terminów przekazują modelowi z góry nazwy marek i terminy branżowe, aby poprawnie je zapisał.
Transkrypcje rozmów z call center mogą też zawierać dane wrażliwe, które trzeba zredagować, na przykład numery ubezpieczenia społecznego czy kart kredytowych. Scribe v2 wykrywa encje, aby znaleźć te wrażliwe dane, oznaczyć je czasem i umożliwić ich usunięcie.
Archiwum podcastów: Transkrypcja wsadowa
Budując archiwum podcastów, potrzebujesz dopracowanych transkrypcji, do których twój zespół i odbiorcy mogą sięgać w każdej chwili. Kluczowe są tu dokładność i czytelne formatowanie, więc najlepszym wyborem jest transkrypcja wsadowa.
Dzięki transkrypcji wsadowej otrzymujesz dokładne transkrypcje z oznaczeniami mówców i diarizacją dla wszystkich plików podcastów. Scribe v2 ma też tryb no-verbatim, który automatycznie usuwa wypełniacze, jąkanie i powtórzenia. Dzięki temu poświęcisz mniej czasu na ręczną edycję i szybciej zbudujesz archiwum podcastów.
ElevenAPI natywnie obsługuje tryb czasu rzeczywistego i wsadowy. Jeśli prowadzisz jednocześnie kilka projektów transkrypcji, możesz zarządzać nimi wszystkimi w ElevenAPI, na jednej platformie. Po prostu wybierz odpowiedni model dla każdego projektu, bez uciążliwego przełączania się między dostawcami usług.
Hybrydowe modele transkrypcji: połączenie czasu rzeczywistego i trybu wsadowego
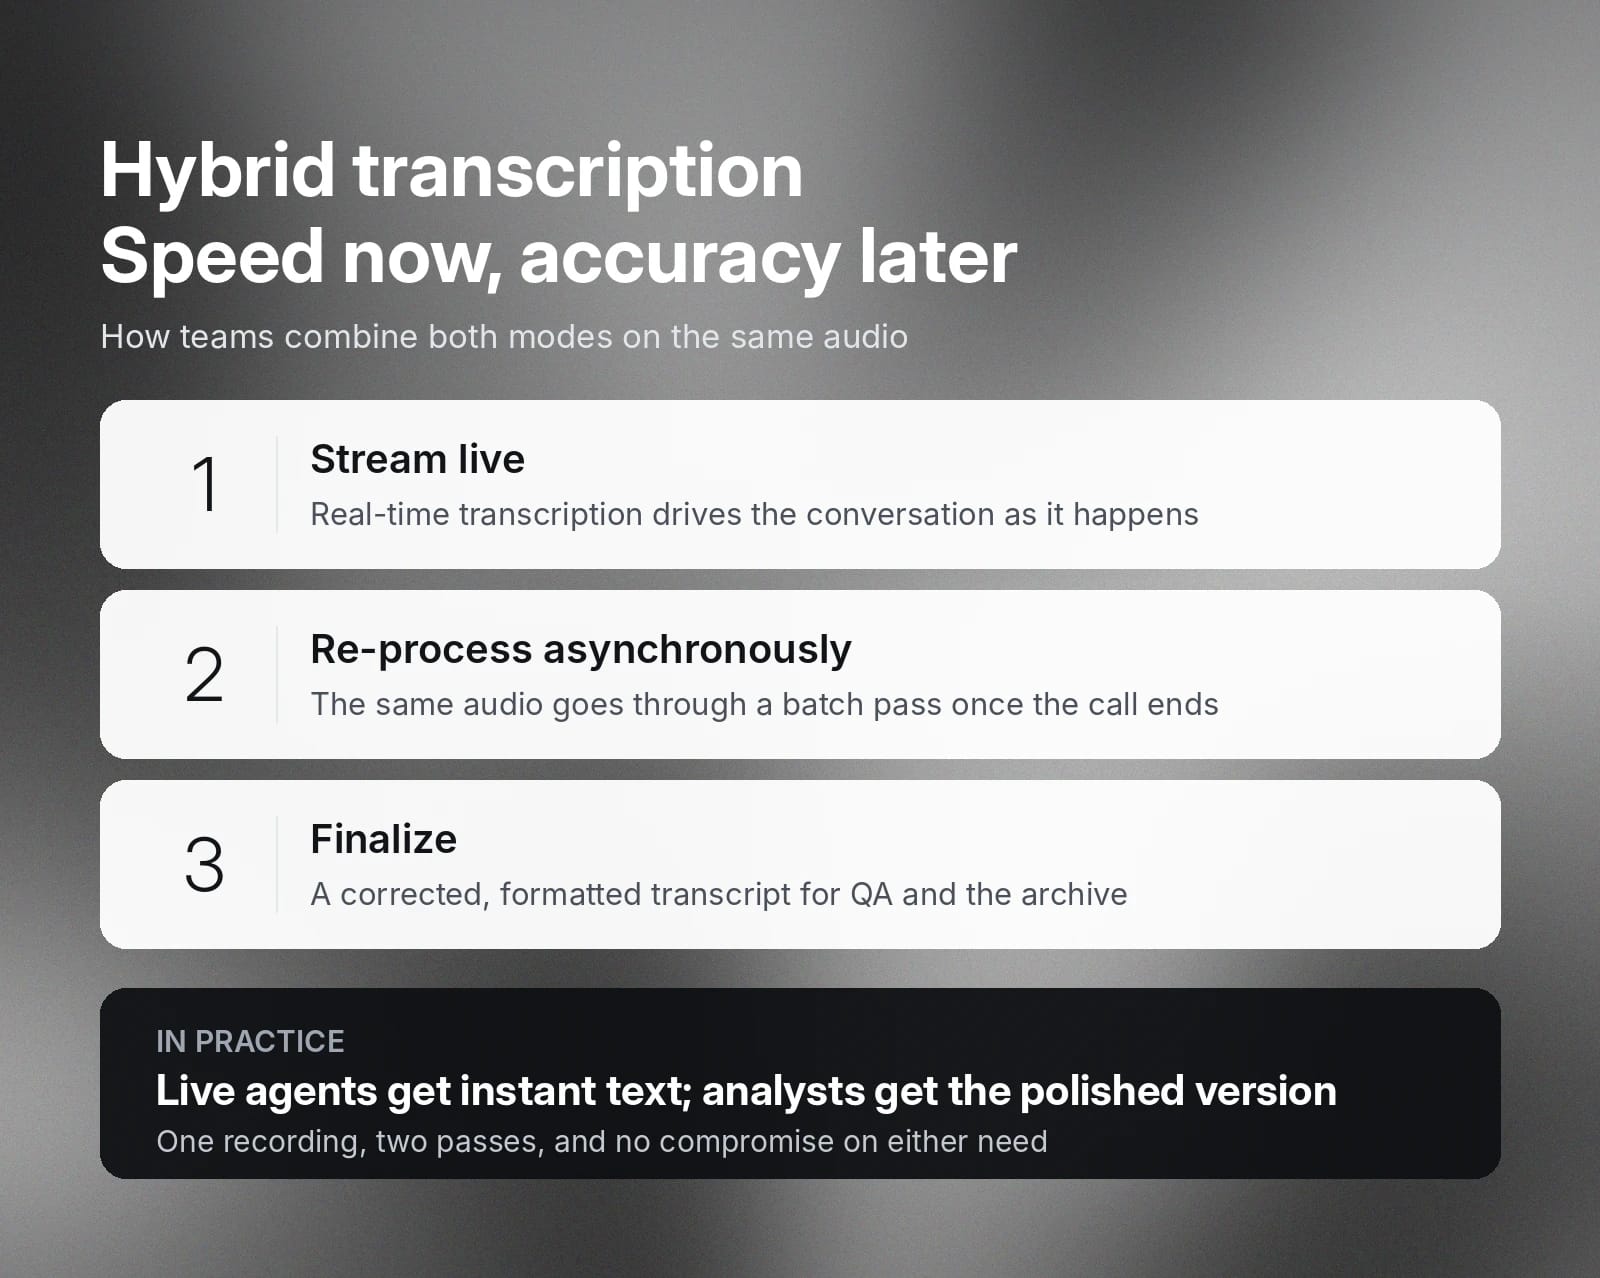
Hybrydowe architektury transkrypcji łączą modele czasu rzeczywistego i wsadowe, zapewniając równowagę między szybkością a dokładnością.
Na przykład zespół obsługi klienta może użyć modelu hybrydowego, by uzyskać natychmiastowy wynik podczas rozmów na żywo, a następnie dopracować transkrypcję na potrzeby kontroli jakości i archiwizacji. Działający na żywo agenci używają transkrypcji w czasie rzeczywistym, a potem wysyłają wstępną transkrypcję do modelu wsadowego, aby przetworzyć ją asynchronicznie.
Tak działa ten proces:
Zacznij z ElevenAPI i elastyczną transkrypcją
ElevenAPI oferuje modele czasu rzeczywistego i wsadowe do szybkiej, dokładnej transkrypcji w ponad 90 językach. Wiodące w branży modele transkrypcji ElevenAPI zapewniają dokładne wyniki nawet przy nagraniach niskiej jakości, szumie tła lub silnym akcencie.
ElevenAPI oferuje modele czasu rzeczywistego i wsadowe do szybkiej, dokładnej transkrypcji w ponad 90 językach. Scribe v2 zapewnia wiodącą w branży dokładność transkrypcji, a Scribe v2 Realtime — wyjątkową dokładność w zastosowaniach na żywo. Oba zapewniają niezawodne wyniki nawet przy nagraniach niskiej jakości, szumie tła lub silnym akcencie.
Oba modele są dostępne na jednej wygodnej platformie, aby pomóc ci zbudować architekturę transkrypcji dopasowaną do twoich potrzeb. Poznaj ElevenLabs Speech to Text API w praktyce lub utwórz klucz API i zacznij.



