Modele interakcji: Naturalny dialog człowiek-AI
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Każdy, kto próbował przerwać agentowi głosowemu AI agent głosowy w połowie zdania, wie, jak to jest, gdy system nie został stworzony do ludzkiej rozmowy. Rytm jest niewłaściwy, głos oderwany od treści, a nawet gdy informacje są poprawne, interakcja wydaje się nienaturalna: nie jak rozmowa z kompetentną osobą, lecz jak obsługa oprogramowania, które akurat używa słów.
Przyczyna tego nienaturalnego wrażenia tkwi w samej strukturze. Wiele systemów głosowych AI stworzono do obsługi pojedynczych tur, a nie prawdziwego toku rozmowy. Słuchają, przetwarzają i odpowiadają na jedną wypowiedź naraz. To działa w prostych demach, ale zawodzi, gdy rozmowa staje się emocjonalna i nieprzewidywalna.
Modele interakcji to systemy AI zaprojektowane do komunikacji w czasie rzeczywistym przez audio i tekst. Rozumieją nie tylko co zostało powiedziane, ale też kiedy oraz jakiej emocjonalnej reakcji wymaga dana chwila. Ten artykuł wyjaśnia, czym różni się model interakcji, dlaczego ma znaczenie dla firm wdrażających głosowe AI oraz jak ElevenLabs go rozwija.
Podsumowanie
- Większość głosowych AI zawodzi w prawdziwych rozmowach, bo nie radzi sobie z przerwaniem, ciszą ani kontekstem między turami.
- Stos interakcyjny ElevenLabs obsługuje przerwania, pauzy i nakładającą się mowę bez utraty kontekstu ani zakłócania toku rozmowy.
- ElevenLabs rozwija prawdziwe modele interakcji dzięki zaawansowanej architekturze kaskadowej oraz własnym Speech to Text (STT) i Text to Speech (TTS), a także stosowi zoptymalizowanemu pod kątem niskich opóźnień i naturalnej rozmowy.
Dlaczego większość komunikacji głosowej człowiek–AI nie brzmi naturalnie
Większość głosowych AI traktuje rozmowę jako serię osobnych wejść i wyjść: system czeka na fragment mowy, zamienia go na tekst, przetwarza tekst i odpowiada. To działa w interakcjach typu polecenie–odpowiedź, ale prawdziwa rozmowa nie jest czystą sekwencją wymian tekstowych. To ciągła wymiana pełna pauz i wtrąceń.
Usunięcie płynności między turami i kontekstu, który je łączy, prowadzi do trzech konkretnych problemów:
- Przerywa ci lub każe czekać: System nie odróżnia pauzy na zastanowienie od zakończonej tury, więc albo wchodzi ci w słowo, albo milczy, gdy już skończysz. Zbierasz myśli w połowie zdania — zostajesz przerwany; kończysz wypowiedź — czekasz w niezręcznej ciszy.
- Nie potrafi zareagować, gdy zacznie mówić: Gdy system zaczyna odpowiadać, przestaje słuchać. Jeśli przerwiesz, by zmienić kierunek rozmowy, nadal odpowiada na pytanie, od którego już odszedłeś, bo nie zauważa zmiany.
- Zapomina w trakcie rozmowy: Każda tura jest przetwarzana osobno, więc kontekst sprzed pięciu wymian nie jest zachowywany. Musisz się powtarzać albo system odpowiada, jakby rozmowa dopiero się zaczęła.
W efekcie rozmowa może być poprawna funkcjonalnie, a mimo to wydawać się niewłaściwa.
Czego modele interakcji potrafią, a tradycyjne głosowe AI nie
Tradycyjna AI głosowa obsługuje rozmowę po jednej turze, a model interakcyjny prowadzi całą rozmowę, jednocześnie śledząc to, co jest mówione, i to, co powinno wydarzyć się dalej. Różnica w działaniu polega na tym, że model interakcyjny reaguje na faktyczny stan rozmowy.
Modele interakcji oferują:
- Reakcję w czasie rzeczywistym: System odpowiada w tempie rozmowy, a pełny cykl może trwać poniżej sekundy, zależnie od konfiguracji.
- Naturalną obsługę przerwań, ciszy i nakładania się mowy: Rozróżnia pauzę na zastanowienie od zakończonej tury, więc nie przerywa rozmówcom ani nie zostawia niezręcznej ciszy. Gdy klient wchodzi mu w słowo, by zmienić kierunek rozmowy, radzi sobie z nakładaniem się wypowiedzi bez utraty kontekstu czy zerwania rozmowy.
- Ciągłość przez całą rozmowę: Zamiast resetować kontekst przy każdej turze, system zachowuje historię rozmowy, więc to, co mówi w dziesiątej turze, uwzględnia wszystko, co wydarzyło się od pierwszej.
- Adaptacyjny sposób mówienia: Głos można zaprogramować tak, by zmieniał sposób mówienia — na spokojniejszy, bardziej bezpośredni lub uspokajający — zależnie od wykonywanego zadania.
- Równoległe wykonywanie zadań: System jednocześnie pobiera informacje, wywołuje narzędzia i mówi, zamiast milczeć podczas wyszukiwania danych.
Prawdziwym testem modelu interakcji jest rozmowa, która nie przebiega dobrze. W nagraniu poniżej klient dzwoni w sprawie odwołanego lotu. Jest zdenerwowany i potrzebuje szybkiego rozwiązania problemu.
Agent natychmiast rozpoznaje pilność i frustrację klienta po używanych przez niego słowach. Dostosowuje ton, radzi sobie z przerwaniem bez utraty wątku i używa połączonych narzędzi, by zaproponować realne rozwiązania dotyczące odwołanego lotu. Ostatecznie klient otrzymuje rozwiązanie bez pomocy ludzkiego agenta.
Porównaj to z typowymi agentami działającymi turami, używanymi obecnie. Takie systemy czekałyby na każdą pauzę, odpowiadały neutralnym tonem i całkowicie nie dostrzegły frustracji klienta. Po kilku wymianach, które nie odnoszą się do tego, co naprawdę czuje rozmówca, połączenie prawdopodobnie trzeba byłoby przekazać człowiekowi — a klient byłby jeszcze bardziej sfrustrowany niż na początku.
Jak ElevenLabs rozwija modele interakcji
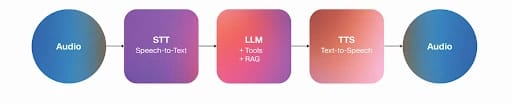
Nasz potok rozmowy wykorzystuje zaawansowaną architekturę kaskadową zamiast architektury scalonej. Zamiast jednego modelu obsługującego wszystko, każdy etap jest osobnym, wyspecjalizowanym komponentem.
Zaletą tego podejścia jest to, że możemy niezależnie optymalizować każdy etap pipeline'u i podmieniać model dla dowolnego komponentu bez przebudowy całego systemu. Ponieważ tworzymy te komponenty wewnętrznie, są wspólnie optymalizowane, by przekazywać sobie bogaty kontekst. Dzięki temu pipeline nadal działa jak jedna spójna rozmowa, a nie łańcuch osobnych narzędzi.
Struktura modelu kaskadowego
Struktura modelu scalonego
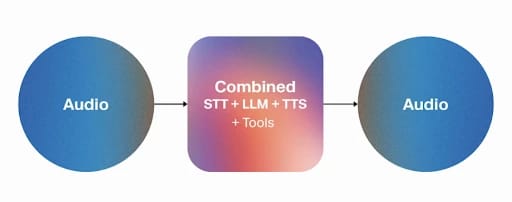
Grafiki: modele kaskadowe a scalone
Oto technologie, które obecnie tworzą ten potok:
- Scribe v2 Realtime: Nasz wewnętrzny model STT transkrybuje mowę w około 150 ms w ponad 90 językach i dobrze radzi sobie z hałasem w tle, akcentami, przerwaniami oraz zdarzeniami niewerbalnymi, takimi jak śmiech i pauzy. Obsługuje też słownictwo branżowe — od terminów medycznych po żargon finansowy.
- Spekulacyjne zarządzanie turami: Ten system decyduje, kiedy mówić, zrobić pauzę lub czekać, analizując tok rozmowy zamiast opierać się na sztywnym progu ciszy. Ulepszenia naszego modelu wykrywania aktywności głosowej pomagają lepiej filtrować mowę w tle i krótkie odpowiedzi, dzięki czemu wymiana tur wydaje się bardziej naturalna.
- Eleven v3 Conversational: Jeden z naszych najbardziej ekspresyjnych modeli TTS, stworzony do dialogów na żywo, w których rozmówcy wymieniają się wypowiedziami. Przenosi emocjonalny ton rozmowy między turami, więc sposób wypowiedzi agenta w 10. turze uwzględnia wszystko, co wydarzyło się wcześniej.
- Expressive Mode: Oparty na Eleven v3 Conversational i systemie zarządzania turami, Expressive Mode kontroluje, jak agent brzmi w danej chwili. Łagodzi sytuację, gdy klienci są sfrustrowani, uspokaja ich, gdy są zdezorientowani, i mówi bezpośrednio, gdy potrzebna jest jasność. Odczytuje też tagi ekspresji, dzięki czemu model może wykorzystać wskazówki takie jak [laughs], [whispers] lub [sighs], by kształtować konkretne momenty wypowiedzi.
- Flash v2.5: Nasz niskolatencyjny model TTS obsługuje 32 języki i generuje mowę w mniej niż 75 ms. Gdy priorytetem są niskie opóźnienia, utrzymuje czas odpowiedzi w granicach naturalnego ludzkiego rytmu.
- Speech Engine: Warstwa łącząca cały stos, która łączy twój serwer z naszym ElevenAPI przez WebSocket — jedno połączenie na rozmowę. Obsługujemy STT i TTS, a twój serwer uruchamia LLM, więc zespoły techniczne mogą korzystać z własnego modelu i zachować logikę rozmowy we własnej infrastrukturze.
Te modele są stale ulepszane, a nowe wersje publikujemy regularnie. Każda kolejna wersja zmniejsza różnicę między rozmową z oprogramowaniem a rozmową z człowiekiem: oferuje szybsze odpowiedzi, lepsze rozpoznawanie emocji, więcej języków i płynniejszą wypowiedź.
Mówienie podczas myślenia
Nie każda część modelu interakcji musi działać w ścisłej kolejności. ElevenAgents może pracować w tle podczas rozmowy, zamiast domyślnie milczeć między pytaniem a odpowiedzią.
Kilka kluczowych systemów współpracuje, by umożliwić jednoczesne mówienie i myślenie:
- Równoległe wywołania narzędzi: Agent może przeszukać bazę danych, uruchomić narzędzie, lub sprawdzić status zamówienia, gdy nadal mówi, więc pobieranie informacji nigdy nie przypomina martwej pauzy w rozmowie.
- Miękki limit czasu: Jeśli LLM potrzebuje więcej czasu niż oczekiwano na wygenerowanie odpowiedzi, agent wypowiada krótkie wypełnienie, np. „Muszę się zastanowić” lub „hmmm”, zamiast zostawiać niezręczną ciszę. Miękki limit czasu pomaga zachować naturalny tok rozmowy i zmniejsza ryzyko przerwań.
- Wyrażenia ignorowane przy przerwaniach: Zamiast używać stałego progu ciszy, system stara się odczytać znaczenie wypowiedzi, by rozpoznać, kiedy tura faktycznie się zakończyła. Podobnie krótkie potwierdzenia, takie jak „okej” czy „mhm”, można skonfigurować tak, aby przechodziły bez wywoływania pełnego przerwania, dzięki czemu agent nie traci wątku przy każdym wtrąceniu rozmówcy.
Razem te systemy sprawiają, że agent nie sprawia wrażenia, jakby buforował lub ładował odpowiedź. Tworzą sprawny silnik rozmowy, który naturalnie wypełnia przerwy tak jak człowiek, a jednocześnie przetwarza informacje i zbiera myśli w tle.
Jak faktycznie działa rozmowa z ElevenLabs
Powyższe komponenty nie działają kolejno w uporządkowanej linii. Nakładają się na siebie. Oto jak agent ElevenLabs obsłużyłby rozmówcę, który w trakcie rozmowy z pomocą techniczną pyta: „Czy moje zamówienie zostało już wysłane, czy nadal jest przetwarzane?”
- Rozmówca mówi: Audio jest przesyłane do ElevenLabs przez połączenie WebSocket, a Scribe zaczyna transkrypcję w czasie rzeczywistym, z opóźnieniem około 150 ms względem głosu.
- System odczytuje tok rozmowy: Gdy Scribe nadal transkrybuje, spekulacyjne zarządzanie turami już ocenia, czy rozmówca skończył, czy jest w trakcie myśli. Końcowe „czy nadal jest przetwarzane?” jest odczytywane jako przekazanie głosu, a nie pauza, więc uruchamia kolejny krok zamiast czekać w ciszy.
- LLM zbiera kontekst i odpowiada: Transkrybowane pytanie trafia do LLM wraz z historią rozmowy, rekordem zamówienia pobranym z własnych systemów firmy przez RAG, wynikami narzędzi z wcześniejszej części rozmowy i promptem systemowym. Analizuje to wszystko i generuje odpowiedź opartą na zamówieniu dzwoniącego.
- Model TTS syntezuje odpowiedź: Tekst zmienia się w naturalnie brzmiące audio. Jeśli aktywny jest Expressive Mode, odpowiedź zawiera wskazówki dotyczące sposobu wypowiedzi dopasowane do chwili, więc rutynowa aktualizacja brzmi swobodnie i bez pośpiechu, a nie płasko. Gdy priorytetem są opóźnienia, Flash syntezuje mowę w mniej niż 75 ms.
- Odpowiedź jest przesyłana strumieniowo: Audio zaczyna się odtwarzać, zanim synteza się zakończy, więc rozmówca słyszy początek odpowiedzi, gdy reszta jest jeszcze generowana.
- Cykl się powtarza: Każda nowa tura przenosi dalej ton, kontekst i historię rozmowy.
W trakcie tego szybkiego procesu rozmowa wydaje się naturalna. Rozmówca przestaje dostosowywać się do maszyny: nie zwalnia, nie wymawia przesadnie wyraźnie i nie czeka na sygnał. Po prostu rozmawia, tak jak z człowiekiem.
Wdróż naturalnie brzmiących agentów głosowych w całej firmie
Wszystko, co opisujemy tutaj, działa dziś na produkcji. Od architektury kaskadowej po pipeline działający w czasie krótszym niż sekunda — firmy na całym świecie już korzystają z ElevenAgents do obsługi rzeczywistych rozmów z klientami na dużą skalę.
Dotyczy to także regulowanych środowisk o wysokiej stawce, ponieważ architektura naszych agentów obsługuje zabezpieczenia, dzienniki audytu i mechanizmy zgodności. ElevenLabs ma certyfikaty SOC 2 Type II, ISO 27001, HIPAA i PCI DSS Level 1 oraz oferuje Zero Retention Mode i regionalną rezydencję danych dla zespołów, które muszą przechowywać dane w określonych granicach.
Chcesz wdrożyć agenta? Możesz utworzyć agenta i zacząć tworzyć w konsoli albo porozmawiać z naszym zespołem sprzedaży o wdrożeniu dopasowanym do twojego środowiska.
FAQ: modele interakcji

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.