Modele kaskadowe vs fuzjowane: Jak architektura decyduje, czy twój agent głosowy jest gotowy na firmę
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Większość osób uważa, że agenci głosowi powstają w architekturze kaskadowej lub scalonej. W praktyce agenci są projektowani na spektrum między nimi, a najczęściej stosuje się pięć architektur — zależnie od zastosowania.
Architektura agenta decyduje o tym, czy działa niezawodnie na produkcji, dostosowuje się do konkretnych wymagań biznesowych i brzmi naturalnie w rozmowie. Architektura oparta na fuzji, taka jak model Realtime od OpenAI, może brzmieć imponująco realistycznie w krótkich wymianach. Jednak gdy zespoły muszą egzekwować zabezpieczenia zgodności, diagnozować nieudaną odpowiedź lub podmienić LLM na mocniejszy, gdy pojawi się w przyszłym miesiącu, pojedyncza scalona sieć daje niewiele możliwości.
W ElevenLabs korzystamy z zaawansowanej architektury kaskadowej. Używamy wyspecjalizowanych komponentów do rozpoznawania mowy, rozumowania i generowania mowy, by zapewnić wysoki poziom inteligencji i niezawodności. Dodajemy prozodię kontekstową, optymalizację pod kątem niskich opóźnień i inteligentne zarządzanie turami, aby rozmowy przebiegały naturalnie. Wybraliśmy to podejście, ponieważ firmy i instytucje publiczne, z którymi pracujemy, potrzebują agentów brzmiących realistycznie i godnych zaufania przy złożonych zadaniach produkcyjnych.
W tym artykule omawiamy pięć głównych architektur: ich mocne strony, ograniczenia oraz to, jak postrzegamy fundament agentów wdrażanych w krytycznych workflow.
Co zespoły oceniają przy wyborze architektury
Pytania zespołów zwykle mieszczą się w trzech kategoriach.
Czy poradzi sobie ze złożonymi zadaniami?
- Rozumowanie i elastyczność modeli: Czy możesz wybrać najlepsze modele do swojego zastosowania, w tym najmocniejsze dostępne LLM-y, i aktualizować je, gdy pojawiają się lepsze opcje?
- Logika agenta: Czy możesz określić i kontrolować przebieg rozmowy, reguły decyzyjne oraz ścieżki eskalacji, którymi podąża agent?
- Użycie narzędzi: Czy architektura obsługuje wieloetapowe wywoływanie narzędzi i integracje z systemami zewnętrznymi?
Czy będzie brzmieć i zachowywać się jak człowiek?
- Prozodia: Czy agent przekazuje naturalny rytm, intonację i ton emocjonalny?
- Opóźnienie: Czy odpowiedzi są na tyle szybkie, by rozmowa była naturalna?
- Zarządzanie turami: Czy agent wie, kiedy mówić, zrobić pauzę lub oddać głos?
Czy mogę mu zaufać na produkcji?
- Niezawodność: Czy agent działa przewidywalnie i konsekwentnie, czy z czasem zaczyna odbiegać od oczekiwań?
- Zabezpieczenia: Czy architektura może chronić przed niezamierzonymi odpowiedziami lub atakującymi użytkownikami?
- Przejrzystość: Czy architektura tworzy wyniki pośrednie, czy jest czarną skrzynką?
Kompromisy między architekturami kaskadowymi i scalonymi
Architektury kaskadowe powstają przez połączenie wyspecjalizowanych komponentów: Speech to Text (STT), dużego modelu językowego i Text to Speech (TTS). Każdy etap można optymalizować, testować i aktualizować niezależnie.
Architektura kaskadowa
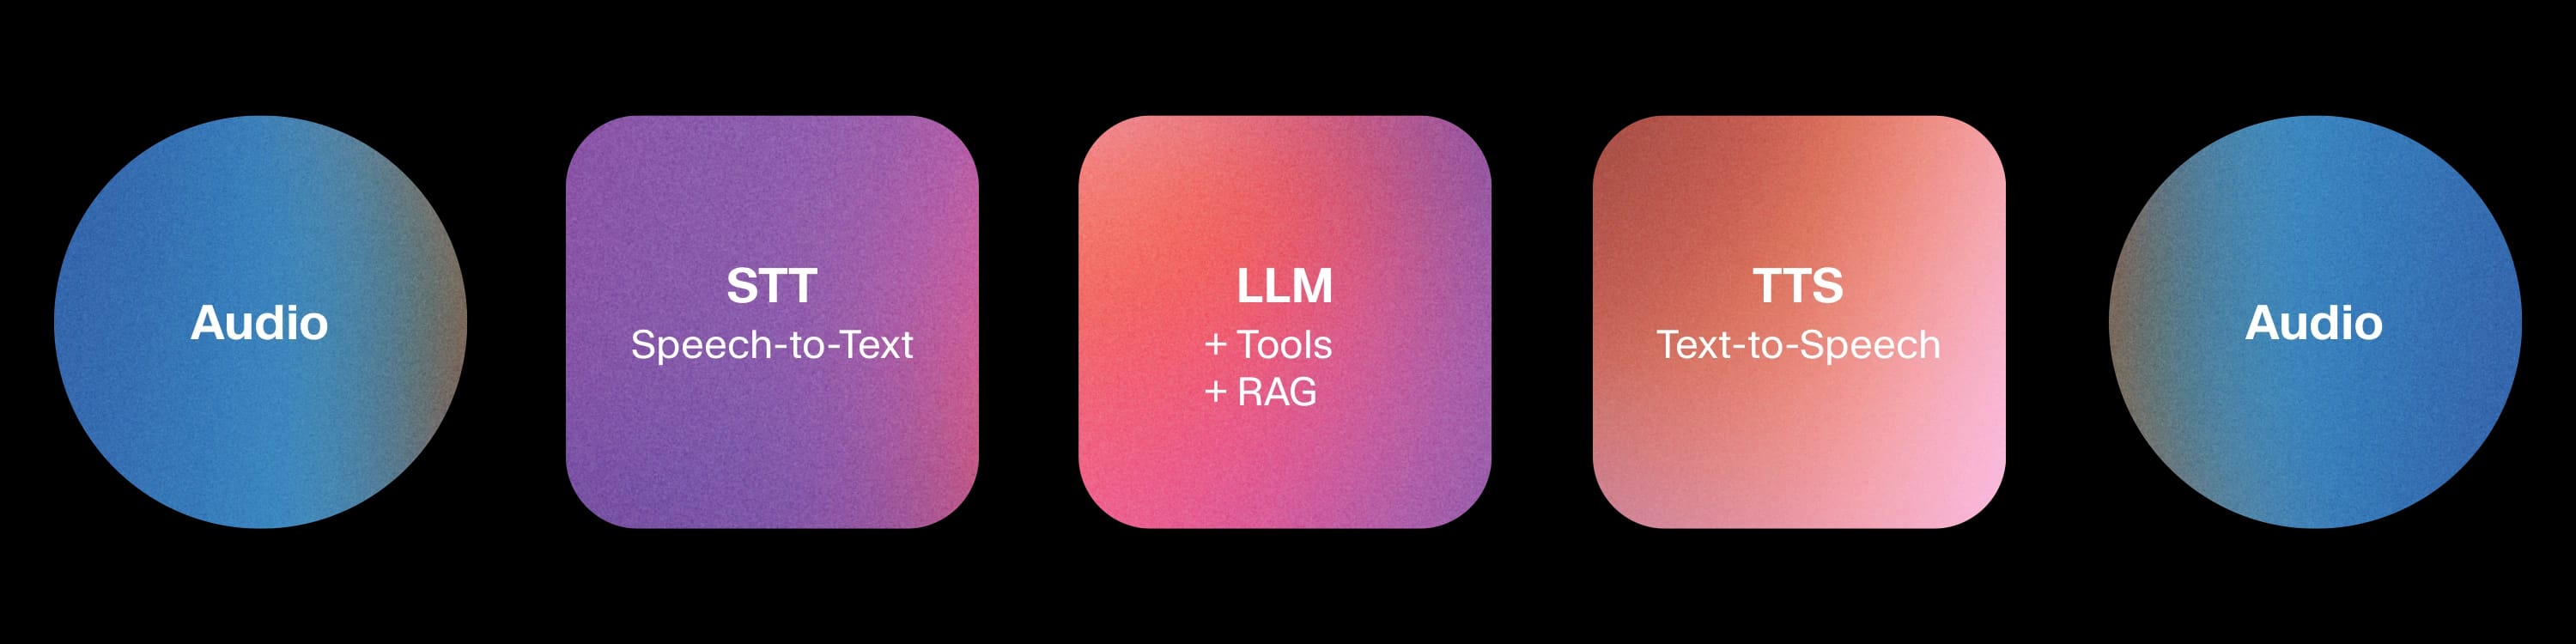
Ta modułowość sprawia, że architektury kaskadowe są podstawą większości agentów klasy enterprise. Każdy etap tworzy wyniki, które można sprawdzić: czytelny tekst między STT a LLM oraz między LLM a TTS. Zabezpieczenia można egzekwować na warstwie tekstowej, najnowszy wiodący LLM można zintegrować bez zmiany modeli mowy, a gdy coś zawiedzie, zwykle da się ustalić źródło problemu.
Od dawna krytykuje się architektury kaskadowe za utratę sygnałów prozodycznych. Mowa zostaje sprowadzona do tekstu, a intonację, rytm i emocje trzeba odtworzyć po stronie wyjścia. Te sygnały można częściowo odzyskać dzięki jawnemu modelowaniu, ale nie są uchwycone tak naturalnie jak w podejściach scalonych. Inne aspekty, takie jak opóźnienie i zarządzanie turami, zwykle można zoptymalizować do porównywalnego poziomu w obu podejściach.
Model scalony
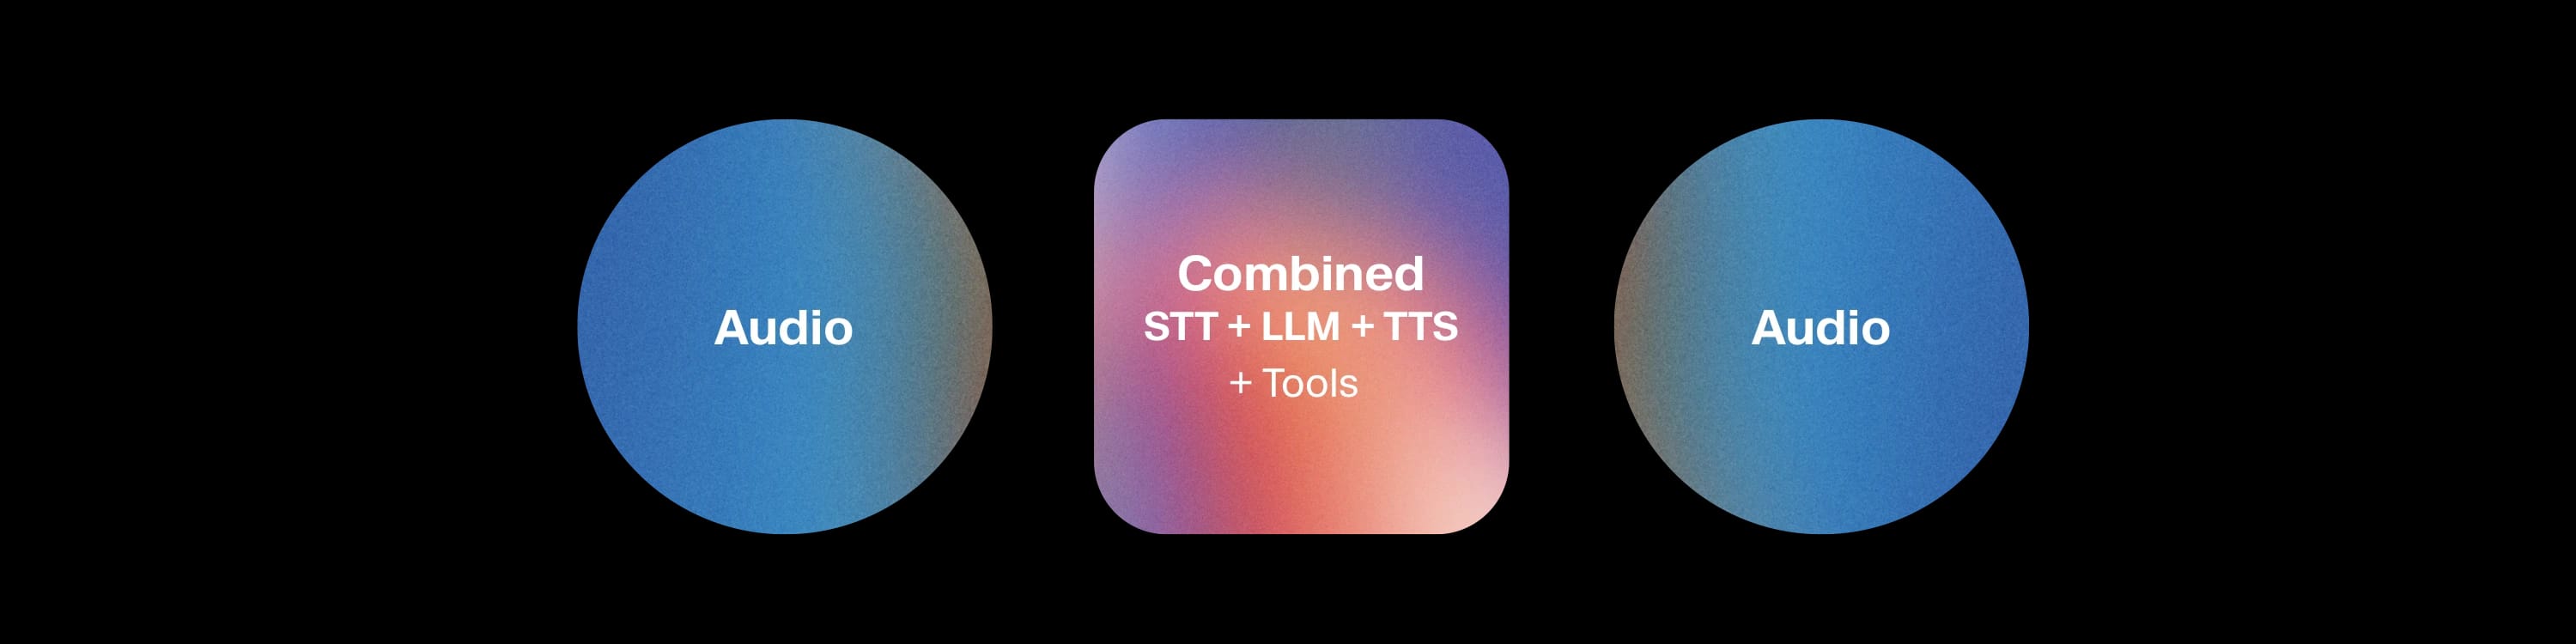
Architektury scalone stosują zupełnie inne podejście. Rozpoznawanie, rozumowanie i generowanie zachodzą w jednej sieci multimodalnej. Audio trafia do środka i audio wychodzi — bez warstwy pośredniej, którą można sprawdzić.
Brak etapów pośrednich jest jednocześnie zaletą i ograniczeniem. Architektura scalona może naturalnie zachować sygnały prozodyczne, ponieważ mowa nigdy nie jest rozkładana na tekst. Ogranicza jednak możliwość egzekwowania zabezpieczeń, podmiany pojedynczych komponentów czy sprawdzania wyników pośrednich podczas debugowania. Są też ograniczenia w dostrajaniu STT do terminologii branżowej lub integracji innego LLM-a dla lepszego rozumowania i wywoływania narzędzi. System jest jedną siecią, więc zespoły są ograniczone do możliwości rozumowania, z jakimi został dostarczony. Dziś oznacza to lżejsze rdzenie, które nie dorównują wiodącym LLM-om w złożonych zadaniach.
Pięć architektur
1. Podstawowa architektura kaskadowa
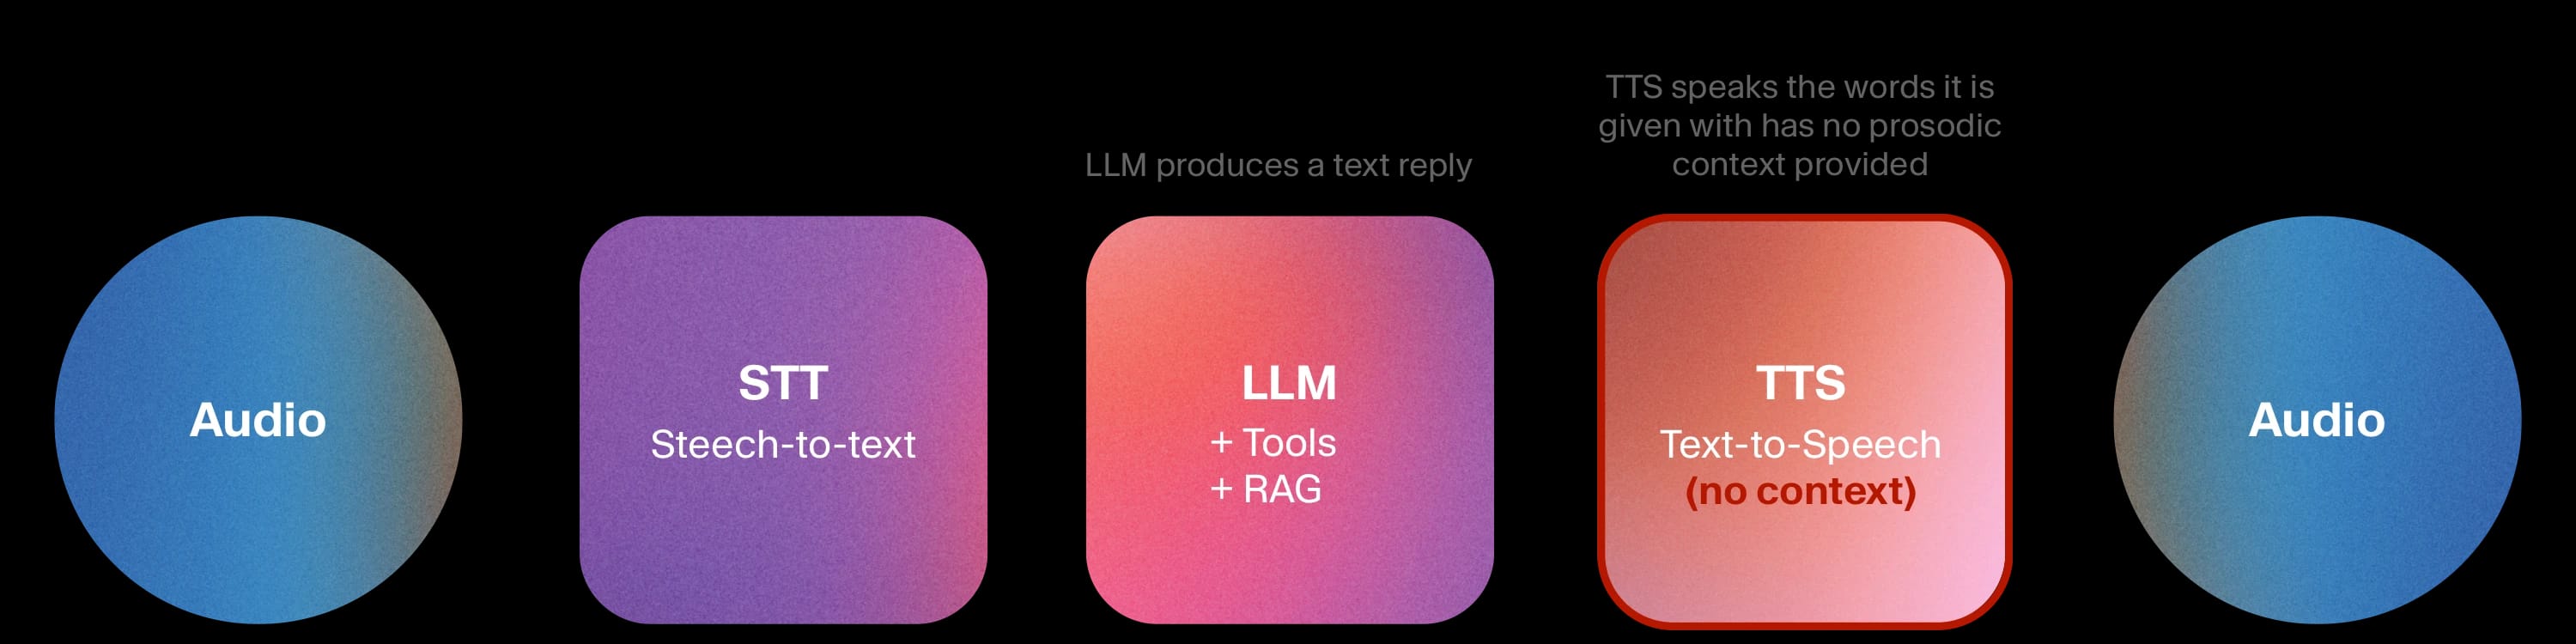
Audio jest transkrybowane, LLM generuje odpowiedź tekstową, a TTS ją wypowiada. Każdy etap działa na zwykłym tekście, więc możesz wszystko zobaczyć, testować i kontrolować.
Zalety pod względem zaufania są oczywiste: zabezpieczenia na warstwie tekstowej, deterministyczny przebieg rozmów, pełne ślady audytowe. Ponieważ LLM jest samodzielnym komponentem, możesz połączyć agenta z dowolnym wiodącym modelem oferującym najlepsze rozumowanie lub wywoływanie narzędzi oraz zaktualizować go, gdy tylko pojawi się lepszy. Słabością jest jakość rozmowy: bez kontekstowego TTS agent brzmi poprawnie, ale płasko. Nie dostosowuje emocji ani prozodii, co wystarczy do odczytania salda konta, ale nie do obsługi sfrustrowanego klienta.
Przykładowe zastosowania:
- Zamienniki IVR w telekomunikacji i usługach komunalnych
- Obsługa FAQ podczas wdrażania użytkowników SaaS
- Powiadomienia wychodzące, np. potwierdzenia wizyt, przypomnienia o receptach i alerty o dostawie, gdzie spójność jest ważniejsza niż ciepły ton
2. Zaawansowana architektura kaskadowa
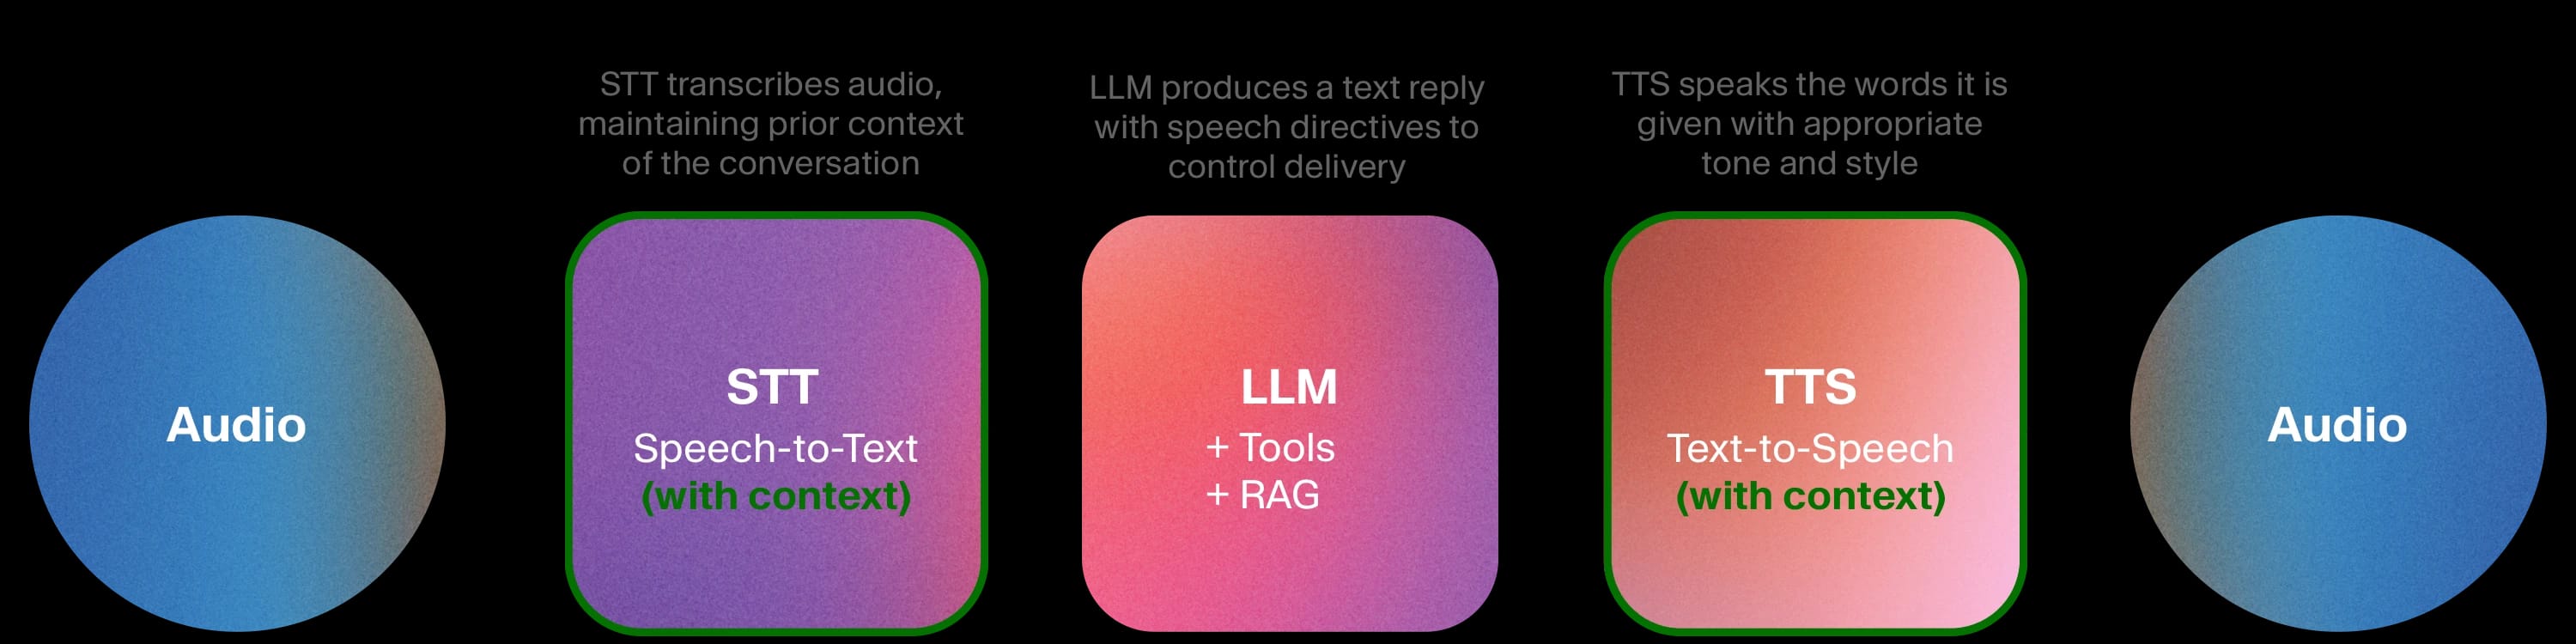
Ta sama modułowa architektura, ale teraz wiele komponentów działa z bogatszym kontekstem. To właśnie stworzyliśmy dzięki Expressive Mode w ElevenAgents.
Model STT Scribe v2 Realtime tworzy szybką, dokładną transkrypcję, wykorzystując wcześniejszy kontekst rozmowy. Na podstawie tekstu LLM instruuje TTS, jak wypowiadać treść — nie tylko co powiedzieć — na przykład „uspokajająco”, „z naciskiem”, „pilnie”, dynamicznie dostosowując ton w trakcie rozmowy. System zarządzania turami korzysta z tych samych sygnałów, dzięki czemu agent wie, kiedy odpowiedzieć, a kiedy oddać głos. Modele mowy są umieszczone razem w jednym stosie, bez połączeń sieciowych między komponentami, więc opóźnienie pozostaje niskie.
Architektura zachowuje wszystko z podstawowej wersji kaskadowej: pełną przejrzystość, zabezpieczenia na warstwie tekstowej, możliwość podmiany komponentów, dostrajanie do domeny oraz dostęp do najmocniejszych dostępnych modeli do wywoływania narzędzi i rozumowania. Zapewnia też znacznie lepszą prozodię, niższe opóźnienie i lepsze zarządzanie turami. Zespoły mogą zintegrować nowy wiodący LLM w tygodniu jego premiery albo dostroić STT dla ochrony zdrowia do specjalistycznego słownictwa, bez przebudowy pozostałych komponentów.
Przykładowe zastosowania:
- Obsługa klienta w usługach finansowych, gdzie empatyczny ton podczas rozmowy o zakwestionowanej transakcji łączy się z rygorystycznymi zabezpieczeniami zgodności i pełnym logowaniem interakcji
- Recepcjoniści w ochronie zdrowia, którzy odpowiednio pilnie kierują rozmowy pacjentów, korzystają z procesów zgodnych z HIPAA i rozpoznawania mowy dostrojonego do terminologii medycznej
- Asystenci sprzedaży, którzy utrzymują ciepły, przekonujący ton, trzymając się ustrukturyzowanego scenariusza i przesyłając aktualizacje do CRM
3. Hybrydowa architektura kaskadowa i scalona
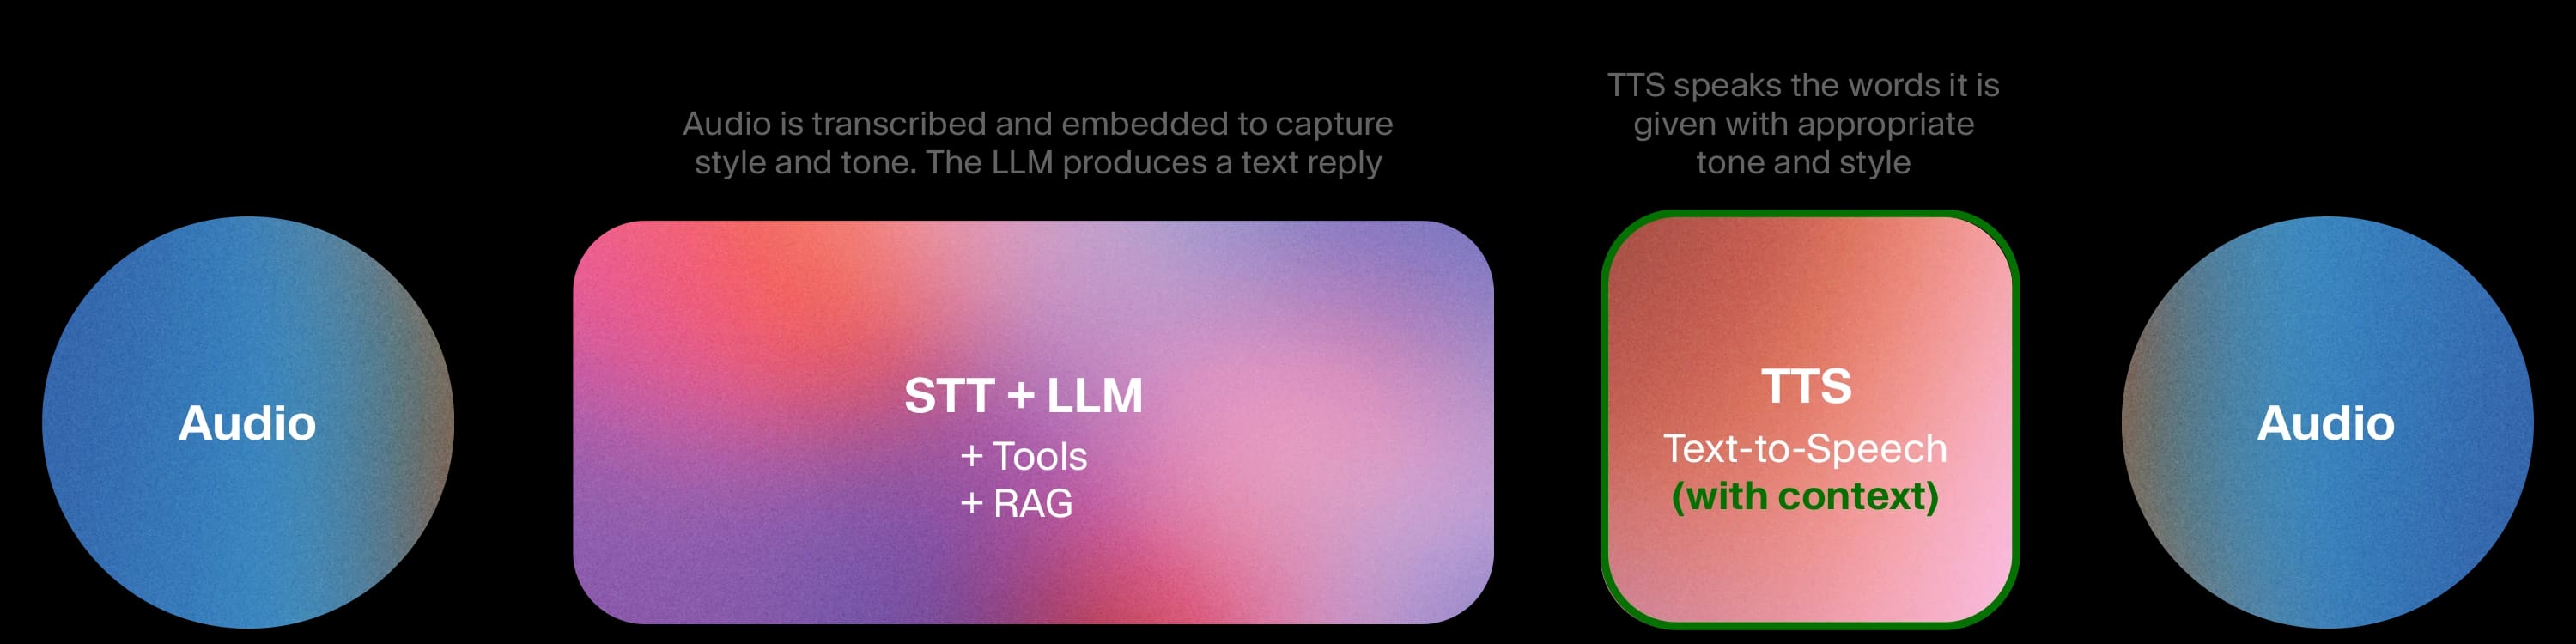
Niektóre architektury przekazują cechy akustyczne (wymowę, emocje, ton) z mowy wejściowej bezpośrednio do LLM-a jako embeddingi, zamiast najpierw przekształcać je w tekst. TTS pozostaje modułowy.
Daje to LLM-owi bogatszą informację o tym, jak coś zostało powiedziane, a nie tylko co zostało powiedziane, co jest cenne w konkretnych zastosowaniach. Scalony blok ASR+LLM trudniej audytować niż przejrzyste przekazanie tekstu, ponieważ reprezentacją pośrednią jest embedding, a nie coś, co człowiek może przeczytać. LLM-a także nie da się już łatwo podmienić, co ogranicza możliwości rozumowania i wywoływania narzędzi do modelu, na którym zbudowano scalony blok.
Przykładowe zastosowania:
- Nauka języków i ćwiczenie wymowy, gdzie to, jak mówi uczeń, ma takie samo znaczenie jak to, co mówi
- Wsparcie wrażliwe na ton przy niskim poziomie złożoności, gdzie ważne jest wykrycie frustracji, ale samo zadanie jest proste.
4. Sekwencyjna architektura scalona
Jeden model multimodalny obsługuje rozpoznawanie, rozumowanie i generowanie w jednym przebiegu, po jednej turze naraz.
Prozodia może być bardzo dobra. Ponieważ mowa nigdy nie jest rozkładana na tekst, model naturalnie zachowuje tempo, intonację i sygnały emocjonalne. Krótkie rozmowy mogą brzmieć wyjątkowo płynnie.
Bez warstwy tekstowej możliwości egzekwowania zabezpieczeń są jednak ograniczone, podobnie jak dostęp do wyników pośrednich potrzebnych do debugowania oraz elastyczność podmiany na lepszy LLM lub dostrojenia STT do swojej domeny. Rdzenie rozumowania są zwykle lżejsze niż wiodące LLM-y, więc złożone wywoływanie narzędzi i zadania wieloetapowe wypadają gorzej. Gdy zadanie wymaga rozwiązania złożonego problemu, sama prozodia nie wystarczy.
Przykładowe zastosowania:
- Osobiści towarzysze, chatboty rozrywkowe i aplikacje, w których ekspresyjność zwiększa zaangażowanie, a wymagania zgodności są minimalne.
5. Dwukierunkowa architektura scalona
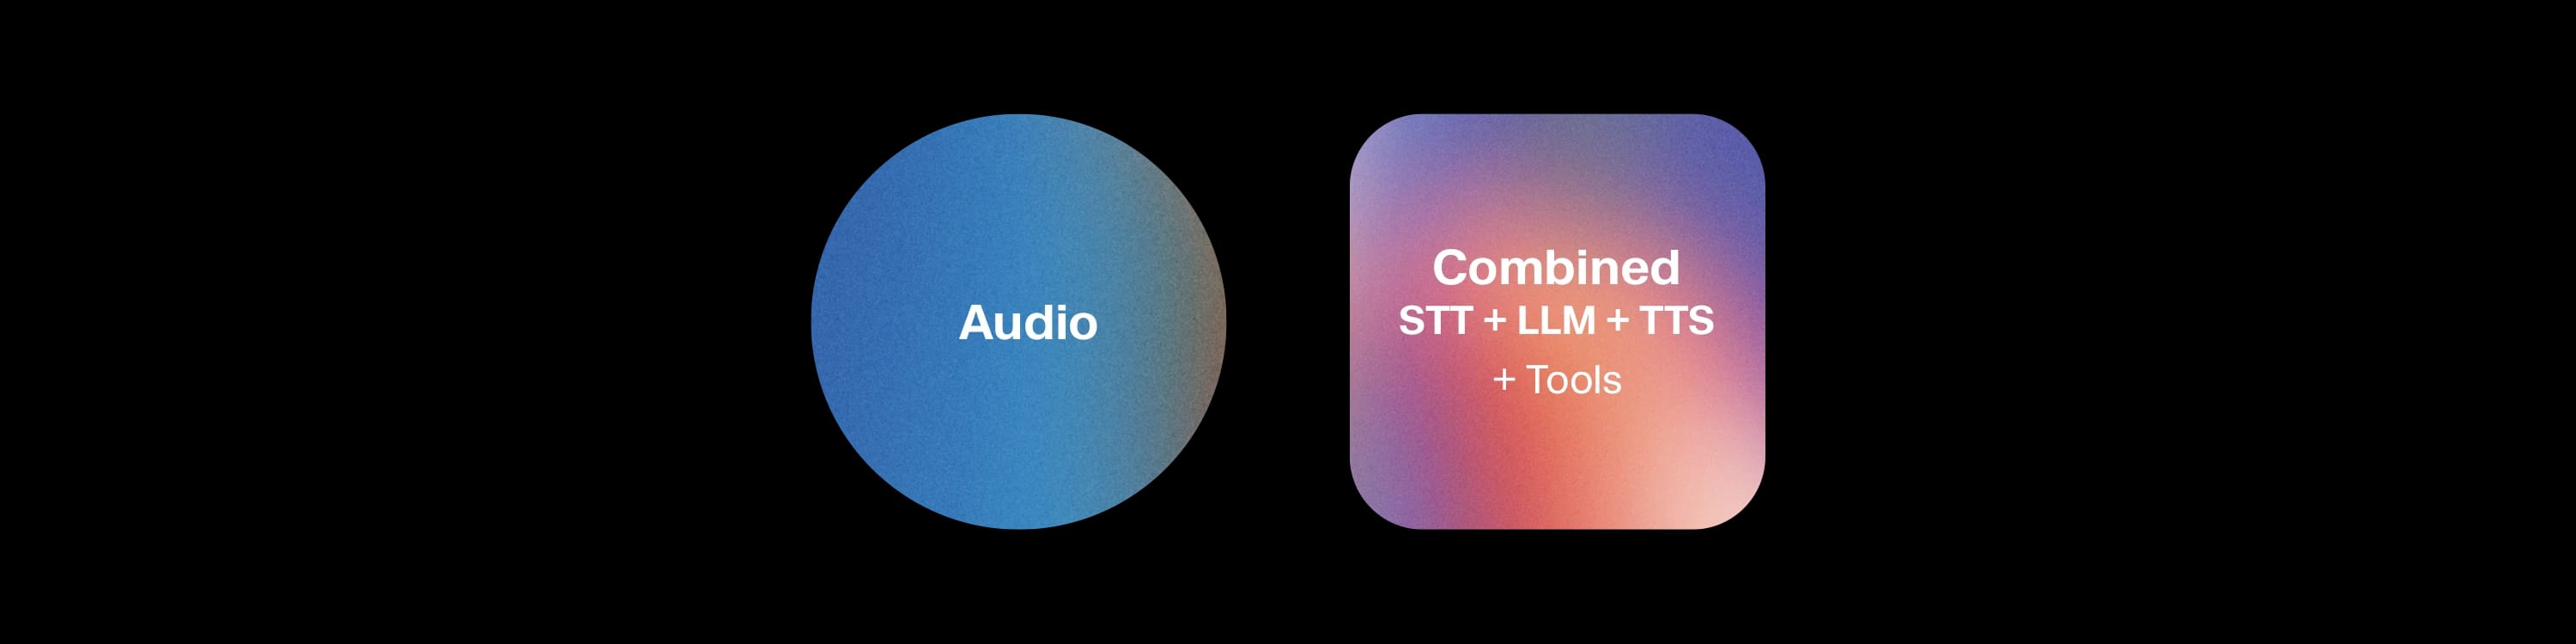
Wejście i wyjście są przetwarzane jednocześnie — model słucha i mówi w tym samym czasie. Dzięki temu krótkie wymiany mogą wydawać się wyjątkowo naturalne, z prawdziwym nakładaniem się wypowiedzi i płynnym przechodzeniem między turami.
To także architektura najtrudniejsza do kontrolowania: zabezpieczenia bardzo trudno egzekwować, a przesłuchy wprowadzają nieprzewidywalne błędy. Sprawdzanie, logowanie i debugowanie są niezwykle trudne, a system jest w dużej mierze zamknięty, z minimalnymi możliwościami podmiany komponentów, dostrajania do domeny lub personalizacji. Rozumowanie i użycie narzędzi są jeszcze bardziej ograniczone niż w sekwencyjnych modelach scalonych, ponieważ jednoczesne przetwarzanie zostawia mniej mocy na złożoną logikę. To samo jednoczesne przetwarzanie, które sprawia, że krótkie wymiany brzmią naturalnie, destabilizuje dłuższe rozmowy.
Przykładowe zastosowania:
- Eksperymentalne aplikacje towarzyszące, społecznościowe platformy głosowe i dema badawcze, gdzie nieprzewidywalne zachowanie jest akceptowalne.
Wybór odpowiedniej architektury do swojego zastosowania
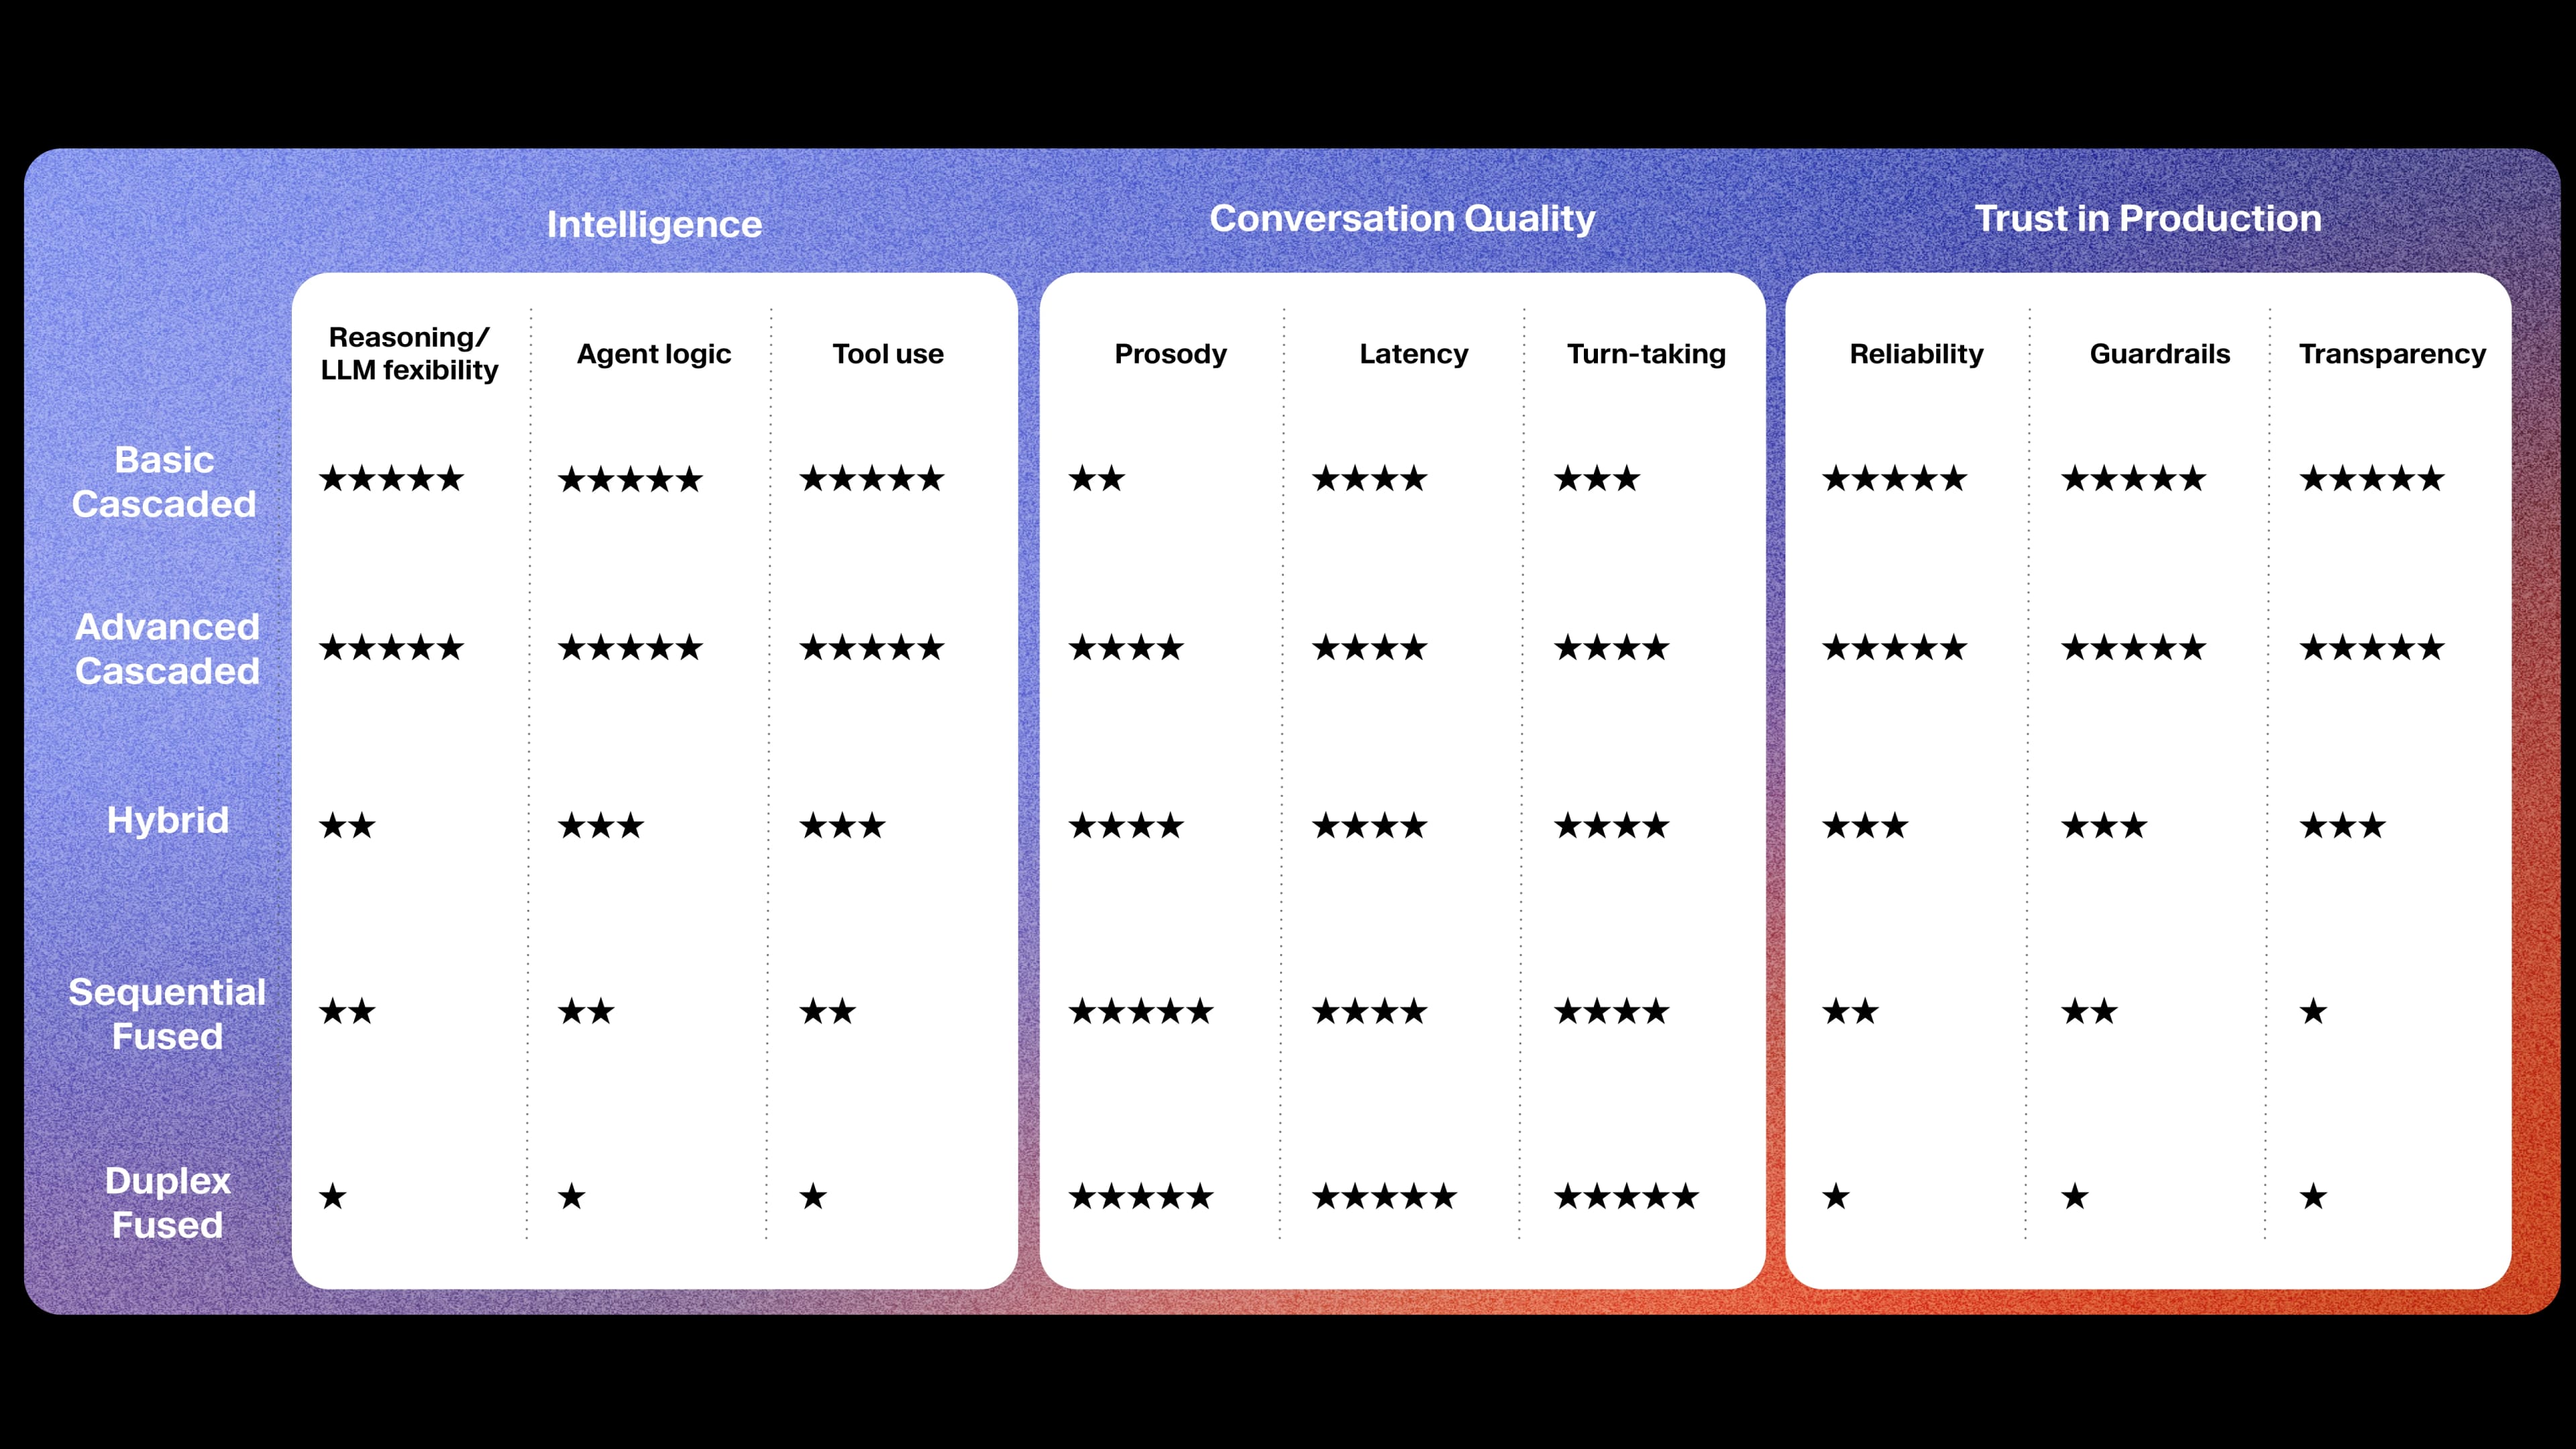
Właściwa architektura zależy od wymagań danego zastosowania. Jeśli tworzysz doświadczenie, w którym najważniejsza jest naturalnie brzmiąca mowa, architektury scalone mają realne zalety — jeśli możesz pójść na kompromis w kwestii wiodącego rozumowania, zabezpieczeń i przejrzystości. Choć modele scalone przodują w prozodii, zaawansowane systemy kaskadowe zbliżają się do nich z każdym kwartałem. Modele scalone nie poczyniły natomiast znaczących postępów w złożonym rozumowaniu ani zaufaniu ze względu na ograniczenia architektoniczne.
Dla większości firm i instytucji publicznych najlepsza architektura brzmi świetnie, a jednocześnie jest wydajna, konfigurowalna, godna zaufania i gotowa do wdrożenia na dużą skalę. Dlatego zdecydowaliśmy się stworzyć ElevenAgents w zaawansowanej architekturze kaskadowej, inwestując w Expressive Mode oraz najlepsze w swojej klasie, wspólnie zoptymalizowane modele Speech to Text i Text to Speech. Dzięki temu zespoły mogą tworzyć agentów o wysokim poziomie inteligencji, niezawodności i kontroli, którzy jednocześnie mówią naturalnie, jak ludzie.
Wraz z rozwojem agentów AI w obsłudze klienta, edukacji, asystentach osobistych i innych obszarach, sukces odniosą ci zbudowani na architekturach dopasowanych do konkretnych zastosowań.