
Jak działa silnik orkiestracji ElevenAgent
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
ElevenAgents korzystają z silnika orkiestracji o niskich opóźnieniach, stworzonego do rozmów w czasie rzeczywistym, który dodaje mniej niż 100 ms narzutu. Ta architektura łączy najlepsze wyniki badań ElevenLabs z czołowymi LLM-ami od dostawców takich jak OpenAI, Google i Anthropic oraz wybranymi modelami open source hostowanymi przez ElevenLabs. Dzięki użyciu wielu modeli na różnych etapach generowania odpowiedzi agent zapewnia rozmowy, które są zarówno bardzo responsywne, jak i świadome kontekstu. Dynamicznie wykorzystując jednocześnie mocne strony każdego modelu, osiągamy niezawodne i skalowalne działanie w wielu zadaniach firmowych i scenariuszach rozmów, optymalizując równowagę między inteligencją, szybkością i kosztem.
W tym artykule wyjaśniamy, jak te modele współpracują, by zapewnić agentom kluczowe możliwości potrzebne do działania w złożonych środowiskach — a dokładniej: który model widzi jakie tokeny i kiedy. Kluczowe znaczenie ma tu zarządzanie historią rozmowy na różnych etapach interakcji. Pokażemy ponownie, jak i gdzie historia rozmowy jest udostępniana, aby wyjaśnić jej rolę w orkiestracji zarówno dla niezależnych agentów, jak i workflowów wieloagentowych.
Niezależny agent
Zaczniemy od niezależnego agenta i jego głównych elementów. Można założyć, że minimalnie użyteczny agent ma prompt systemowy, dostęp do kilku narzędzi oraz bazy wiedzy. Klienci powinni wybierać niezależnych agentów zamiast workflowów, gdy ich przypadek użycia w ograniczonym stopniu wymaga weryfikacji ścisłej kolejności kroków albo gdy ważne jest uniknięcie silosów wiedzy między agentami. Silosy wiedzy powstają, gdy określone narzędzia, dokumenty lub kontekst historyczny są dostępne dla części podagentów, ale nie dla innych. Są nieodłączną cechą workflowów wieloagentowych i oznaczają kompromis między elastycznością a deterministycznością.
W przypadku niezależnych agentów ElevenLabs warto zrozumieć, jak:
- Tworzą skuteczne żądania generowania
- Wyszukują i uwzględniają odpowiednie dokumenty
- Generują i wykonują wywołania narzędzi, które pomagają tworzyć odpowiedzi
- Zwracają wyniki do oceny i zbierania danych
Tworzenie kontekstu rozmowy
Rozmowa między klientem a agentem ElevenLabs to seria tur, z których każda obejmuje wymianę wiadomości między obiema stronami. Ta naprzemienna lista wiadomości agenta i użytkownika jest punktem wyjścia do zbudowania kontekstu rozmowy. W każdej turze bazowy LLM otrzymuje żądanie generowania zawierające serię naprzemiennych wiadomości agenta i użytkownika, o jedną wiadomość dłuższą niż w poprzedniej turze. Oczywiście serię tych wiadomości poprzedza pojedyncza wiadomość systemowa zawierająca prompt systemowy agenta.
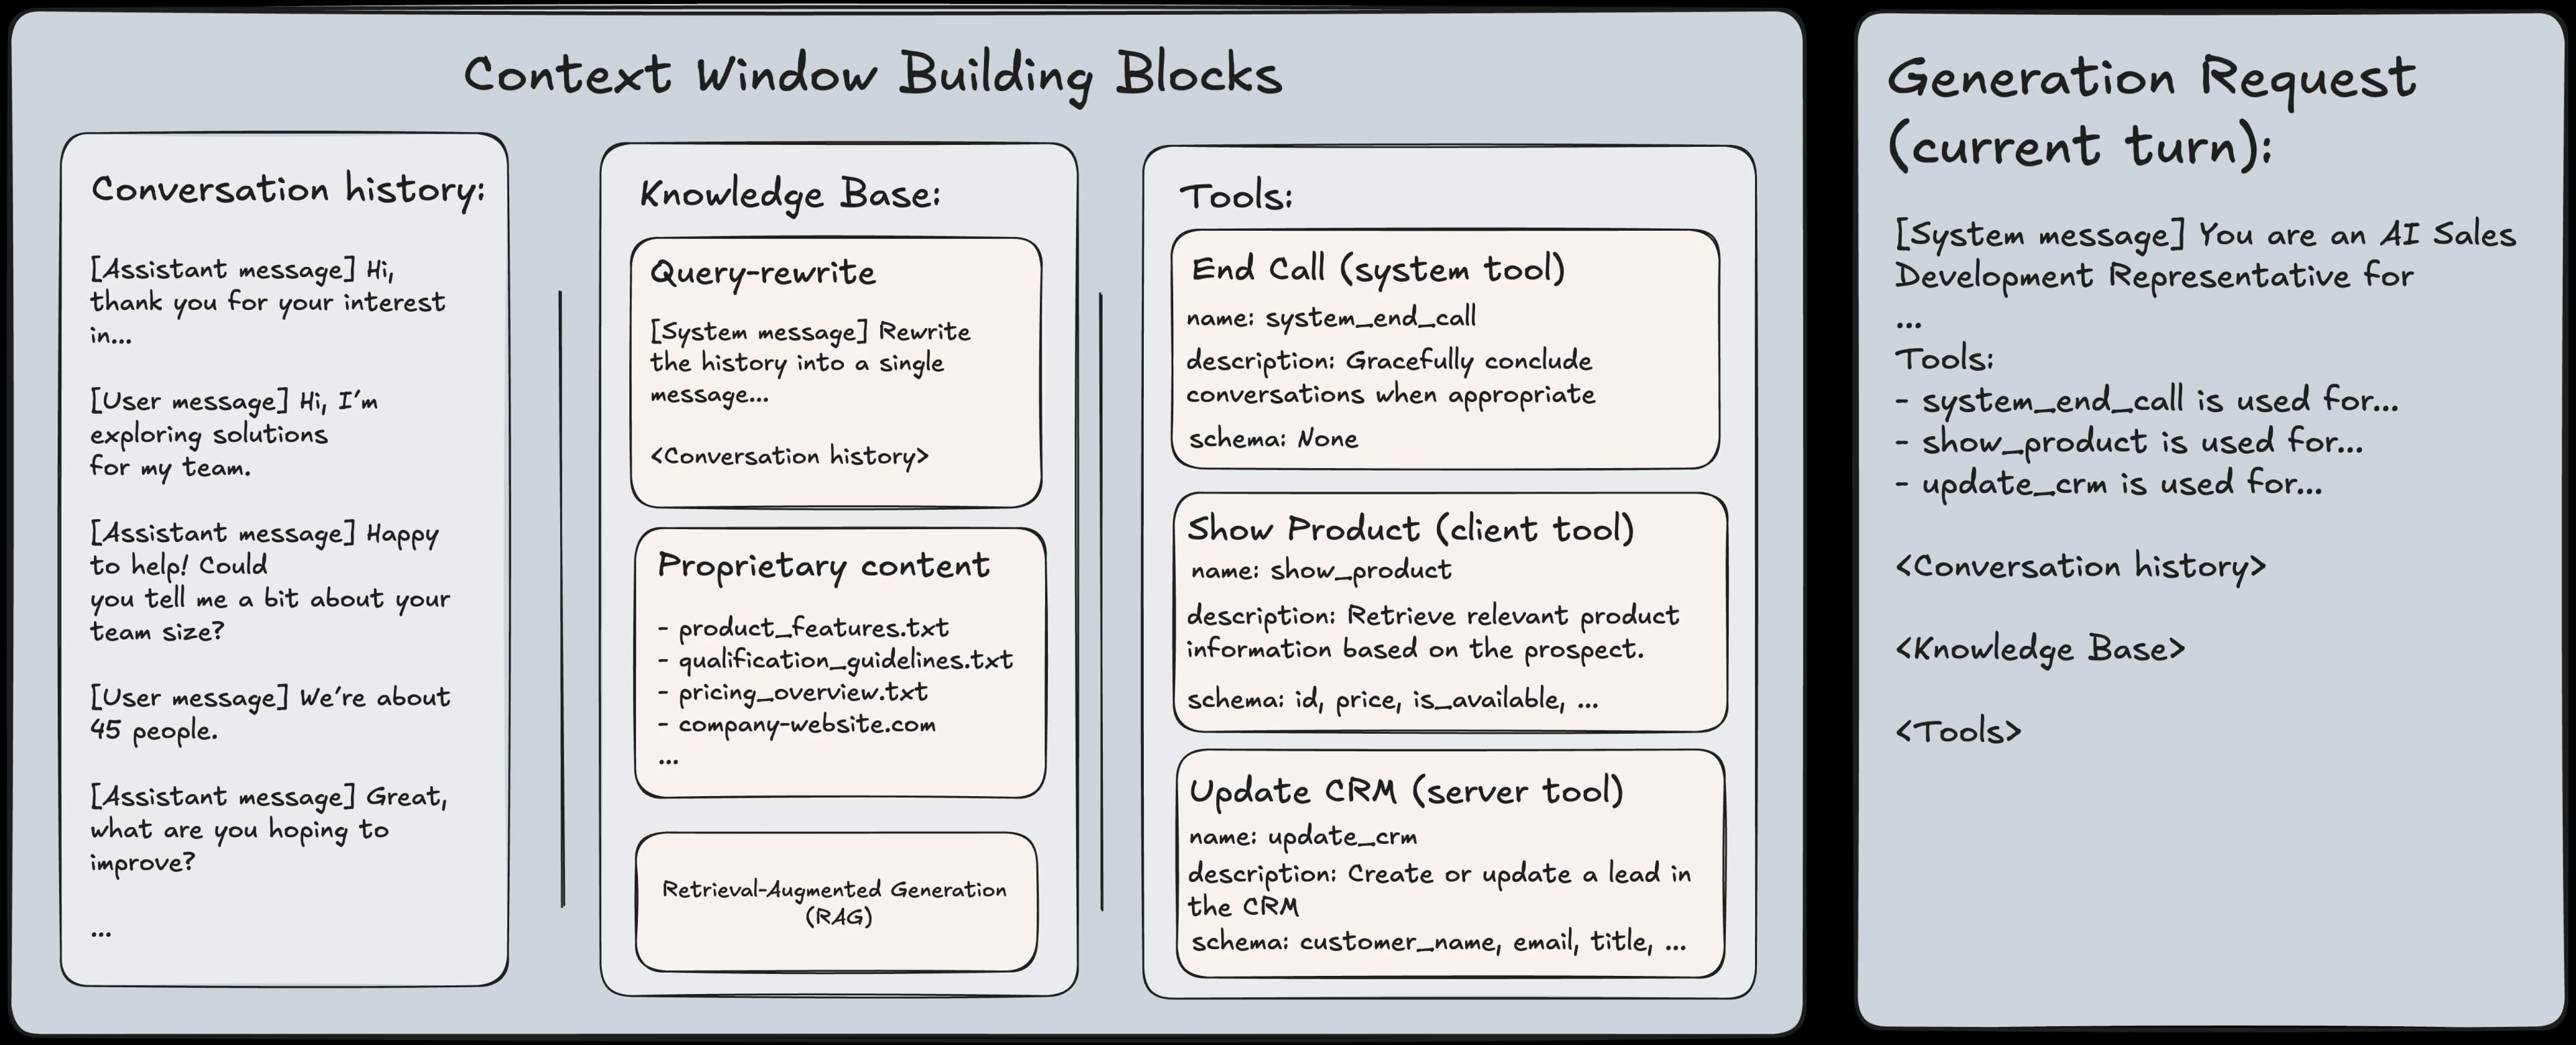
Orkiestrator ElevenLabs zmniejsza odczuwalne opóźnienie LLM, przewidując, kiedy użytkownik skończył mówić. W niektórych przypadkach może to skutkować wieloma żądaniami generowania LLM z tym samym kontekstem rozmowy w jednej turze. Chociaż orkiestracja optymalizuje szybkość odpowiedzi agentów, jakość odpowiedzi w równym stopniu zależy od sposobu dostępu do wiedzy. W miarę rozwoju klienci zwykle zaczynają opierać odpowiedzi agentów na połączeniu własnej dokumentacji i treści publicznych. Od kilku lat standardowym podejściem jest w tym celu retrieval-augmented generation (RAG). Bazy wiedzy ElevenAgents rozwijają RAG dzięki zoptymalizowanej architekturze wielomodelowej, którą opisaliśmy w poprzednim artykule. Pozwala to niezawodnie wyszukiwać dokumenty, nawet gdy ostatnia wiadomość użytkownika jest doprecyzowaniem, potwierdzeniem wyjaśnienia lub po prostu nie zawiera wyraźnego pytania.
Wyszukiwanie to jednak tylko jeden ze sposobów, w jakie agenci komunikują się z systemami zewnętrznymi.
Podejmowanie działań i pobieranie informacji za pomocą narzędzi
Agenci ElevenLabs mogą wykonywać działania w świecie rzeczywistym i pobierać aktualne informacje w trakcie rozmowy dzięki elastycznemu systemowi narzędzi. Wiąże się z tym ważna kwestia projektowa: każde włączone narzędzie zwiększa rozmiar serializowanego promptu, ponieważ jego nazwa, opis i schemat parametrów są dołączane do promptu systemowego oraz historii rozmowy. Wraz z dodawaniem kolejnych narzędzi rośnie też obciążenie modelu koniecznością ustalenia właściwej sekwencji ich wywołań. W Agent Builder opis narzędzia określa, co robi i jakie pola zwraca. To informacje, których model językowy używa, by zrozumieć kontekst użycia narzędzia. Po zdefiniowaniu narzędzia konkretne warunki jego wywołania należy umieścić w prompcie systemowym agenta. Na przykład:
- Opis narzędzia lookup_order: „Pobiera szczegóły zamówienia klienta na podstawie identyfikatora zamówienia. Zwraca status zamówienia, kupione produkty, adres dostawy i numer śledzenia.”
- Instrukcja promptu systemowego: „Po zweryfikowaniu tożsamości klienta wywołaj narzędzie lookup_order , aby pobrać szczegóły jego zamówienia.”
Taki podział odpowiedzialności sprawia, że definicje narzędzi można ponownie wykorzystywać w różnych agentach, a prompt systemowy każdego agenta może kontrolować dokładny moment wywołania narzędzia. Aby pomóc klientom skutecznie projektować takie prompty systemowe, udostępniamy szczegółowe wskazówki w naszym Przewodniku po promptowaniu. W tym modelu można definiować głównie następujące typy narzędzi:
- Narzędzia webhook, które wywołują zewnętrzne API.
- Narzędzia klienckie, które wysyłają żądania narzędzi jako zdarzenia przez websocket rozmowy.
- Narzędzia systemowe do wbudowanych działań, takich jak przekazywanie połączeń.
- Narzędzia MCP, które łączą się z serwerami Model Context Protocol.
Gdy agent zdecyduje się użyć narzędzia, pobiera z rozmowy potrzebne informacje i wysyła żądanie jego uruchomienia. Gdy narzędzie zwróci wynik, jest on dodawany do rozmowy, aby model mógł naturalnie odwołać się do niego w kolejnej odpowiedzi. W razie potrzeby wynik narzędzia może też aktualizować zapisane informacje agenta jako zmienna dynamiczna. Informacje te są przechowywane jako proste pary klucz-wartość, wyodrębnione z odpowiedzi narzędzia za pomocą zdefiniowanych mapowań. Po ustawieniu zmienne te mogą wracać do agenta przez prompt systemowy, parametry przyszłych narzędzi i warunki workflowu. Ta pętla informacji zwrotnej daje agentom rodzaj pamięci roboczej, która rozwija się wraz z interakcjami.
Opisaliśmy już, jak narzędzia integrują się z rozumowaniem agenta, ale można też skonfigurować moment ich wykonania. Narzędzia mogą działać w jednym z trzech trybów, dostosowanych do różnych potrzeb rozmowy. W trybie Immediate Mode narzędzie uruchamia się, gdy tylko LLM o nie poprosi. To ustawienie domyślne dla szybkiego wyszukiwania, gdy użytkownik oczekuje niemal natychmiastowej odpowiedzi, na przykład przy sprawdzaniu statusu zamówienia. W połączeniu z komunikatem przed użyciem narzędzia agent najpierw generuje krótkie potwierdzenie, takie jak „Już to sprawdzam”, i zwraca je użytkownikowi, podczas gdy narzędzie działa równolegle, minimalizując ciszę. W przypadku wolniejszych narzędzi platforma automatycznie wydłuża te komunikaty wypełniające, aby odpowiadały oczekiwanemu czasowi oczekiwania. Tryb Post-Tool Speech Mode z kolei opóźnia wykonanie do chwili, gdy agent skończy mówić. Jest to niezbędne przy działaniach mających skutki w świecie rzeczywistym, takich jak przekazanie połączenia, zakończenie sesji czy przesłanie płatności. Użytkownik słyszy pełen kontekst, np. „Teraz przekieruję cię do działu rozliczeń”, i może przerwać, zanim działanie zostanie wykonane. Tryb Async Mode uruchamia narzędzie całkowicie w tle, bez wstrzymywania rozmowy. Najlepiej sprawdza się przy operacjach typu fire-and-forget, takich jak wysłanie e-maila, uruchomienie zewnętrznego workflowu lub zapis danych, gdy agent nie musi odwoływać się do wyniku w odpowiedzi.
Po wdrożeniu wykonania i orkiestracji kolejnym krokiem jest zrozumienie, jak mierzyć wydajność.
Pomiar wydajności
Po zakończeniu rozmowy z Agentem klienci mogą chcieć wyodrębnić z niej wybrane informacje do dalszej analizy i przechowywania albo ustalić, czy rozmowa zakończyła się sukcesem. Tu przydają się Zbieranie danych i Kryteria oceny. Zbieranie danych pozwala wyodrębniać uporządkowane informacje z transkrypcji rozmowy do dalszej analizy i agregacji. Klienci często eksportują je do firmowego lakehouse danych na potrzeby raportowania lub workflowów wzbogacania danych. Na przykład agent rozwoju sprzedaży może automatycznie wyodrębnić z rozmowy dane potencjalnego klienta, aby utworzyć lub zaktualizować lead w systemie Customer Relationship Management (CRM). Kryteria oceny z kolei określają, czy rozmowa jest uznawana za udaną. Jeśli wszystkie skonfigurowane kryteria są spełnione, rozmowa zostaje oznaczona jako udana; w przeciwnym razie jako nieudana. Dzięki temu rozmowy stale spełniają określone standardy jakości i rzetelności, a ty szybko otrzymujesz informacje zwrotne. Po zakończeniu rozmowy i uruchomieniu webhooka po rozmowie agent przetwarza finalną transkrypcję, w tym wykonania narzędzi i metadane, przez LLM wraz ze wszystkimi skonfigurowanymi punktami zbierania danych i kryteriami oceny. Model używa tego połączonego promptu, aby ustalić, czy każde kryterium oceny zostało spełnione, oraz wyodrębnić wskazane dane do dalszej analizy. Ponieważ LLM interpretuje te konfiguracje bezpośrednio jako część promptu wejściowego, ważne jest ich jasne i spójne formatowanie, aby model mógł je poprawnie zrozumieć i stosować. Dlatego zalecamy poniższe dobre praktyki przy tworzeniu opisów Kryteriów oceny i Zbierania danych.
Kryteria oceny
- Jeden jasny cel na kryterium: jedno zdanie lub krótki punkt jest lepszy niż kilka celów w jednym kryterium.
- Obserwowalność i oparcie na transkrypcji: sformułuj cel tak, aby sukces lub porażkę można było ocenić na podstawie transkrypcji (co zostało powiedziane, co zrobił agent, o co poprosił użytkownik). Unikaj celów wymagających zewnętrznego kontekstu, którego LLM nie ma.
- Jednoznaczne wyniki: sukces/porażka/brak danych: LLM ma już kontekst, że aby oznaczyć wynik jako sukces, cel musi zostać spełniony; aby oznaczyć porażkę, nie może zostać spełniony; a aby oznaczyć brak danych, nie może dać się tego ustalić na podstawie transkrypcji. Dlatego cel należy zapisać tak, aby „spełniony” i „niespełniony” były jednoznaczne; przy niejasnym zapisie model może częściej wybierać brak danych lub błędną klasyfikację
- Zwięzłość: czasem wiele kryteriów oceny jest wysyłanych razem. Długie kryteria mogą więc wprowadzać szum i potencjalnie powodować halucynacje
- Język ma znaczenie: uzasadnienie podane przez LLM, czy kryterium oceny zostało spełnione, będzie w tym samym języku co opis kryterium, więc warto o tym pamiętać
Zbieranie danych
- Opisz dokładnie, co wyodrębnić: opis jest główną wskazówką dla LLM. Wyjaśnij, co oznacza pole, w jakiej sytuacji należy je ustawić i co zrobić, gdy informacja jest niejasna (np. „Pozostaw null, jeśli klient nie podał preferowanej daty”).
- Dopasuj do oczekiwanego typu: wartość zwracana przez LLM zawsze będzie zgodna z typem danych przypisanym do punktu zbierania danych (np. boolean, string, integer). Opis powinien być z nim zgodny. Na przykład dla integer możesz użyć „Wyodrębnij liczbę zamówionych produktów”, a dla boolean: „Tak/nie, czy klient zaakceptował ofertę”.
- Używaj enumów, gdy to możliwe: dla typu string, jeśli zbiór wartości jest stały, użyj enum w schemacie; ogranicza to model i zmniejsza liczbę nieprawidłowych wyników.
- Jeden cel wyodrębniania na element: nie łącz w opisie jednego elementu wielu niepowiązanych faktów; podziel je na osobne elementy, aby każde wywołanie miało jeden jasny cel wyodrębniania.
- Opisy powinny być krótkie: opisy mogą mieć kilka zdań — nie potrzeba długich akapitów. Transkrypcja znajduje się już w wiadomości użytkownika, więc wystarczy schemat i krótki opis.
Obecnie LLM używany do oceny i wyodrębniania danych jest na stałe ustawiony na model o niskich opóźnieniach, aby zapewnić szybkie przetwarzanie. W niedalekiej przyszłości planujemy wprowadzić opcje dające klientom większą elastyczność.
Teraz przejdziemy do przypadków użycia wymagających uporządkowanej orkiestracji, deterministyczności lub specjalizacji w wielu rolach konwersacyjnych, w których klienci mogą zamiast tego użyć Workflowów.
Workflows
Workflows oferują wizualny interfejs do projektowania złożonych przebiegów rozmów. Tworzą obiekt logiczny używany przez orkiestrator do zarządzania wieloma podagentami, narzędziami i przekazaniami w ramach identyfikatora niezależnego agenta. Workflows wprowadzają dodatkowe elementy, które warto rozważyć poza omówionymi już dla niezależnych agentów, w tym sposób, w jaki:
- Prompty systemowe i cele rozmów podagentów współdziałają.
- Ustalane jest przechodzenie przez różne punkty przejścia na grafie.
Wyspecjalizowane cele rozmów
Workflows wykorzystują funkcje niezależnych agentów, aby wymuszać zachowanie spójne przez całą interakcję. Obejmuje to wspólne elementy, takie jak bazowy prompt systemowy, główne narzędzia i globalne bazy wiedzy, które powinny być zawsze dostępne niezależnie od aktywnej części workflowu. Nadrzędny prompt systemowy zwykle określa globalny kontekst rozmowy, oczekiwany ton, ograniczenia bezpieczeństwa oraz instrukcje dotyczące marki lub produktu.
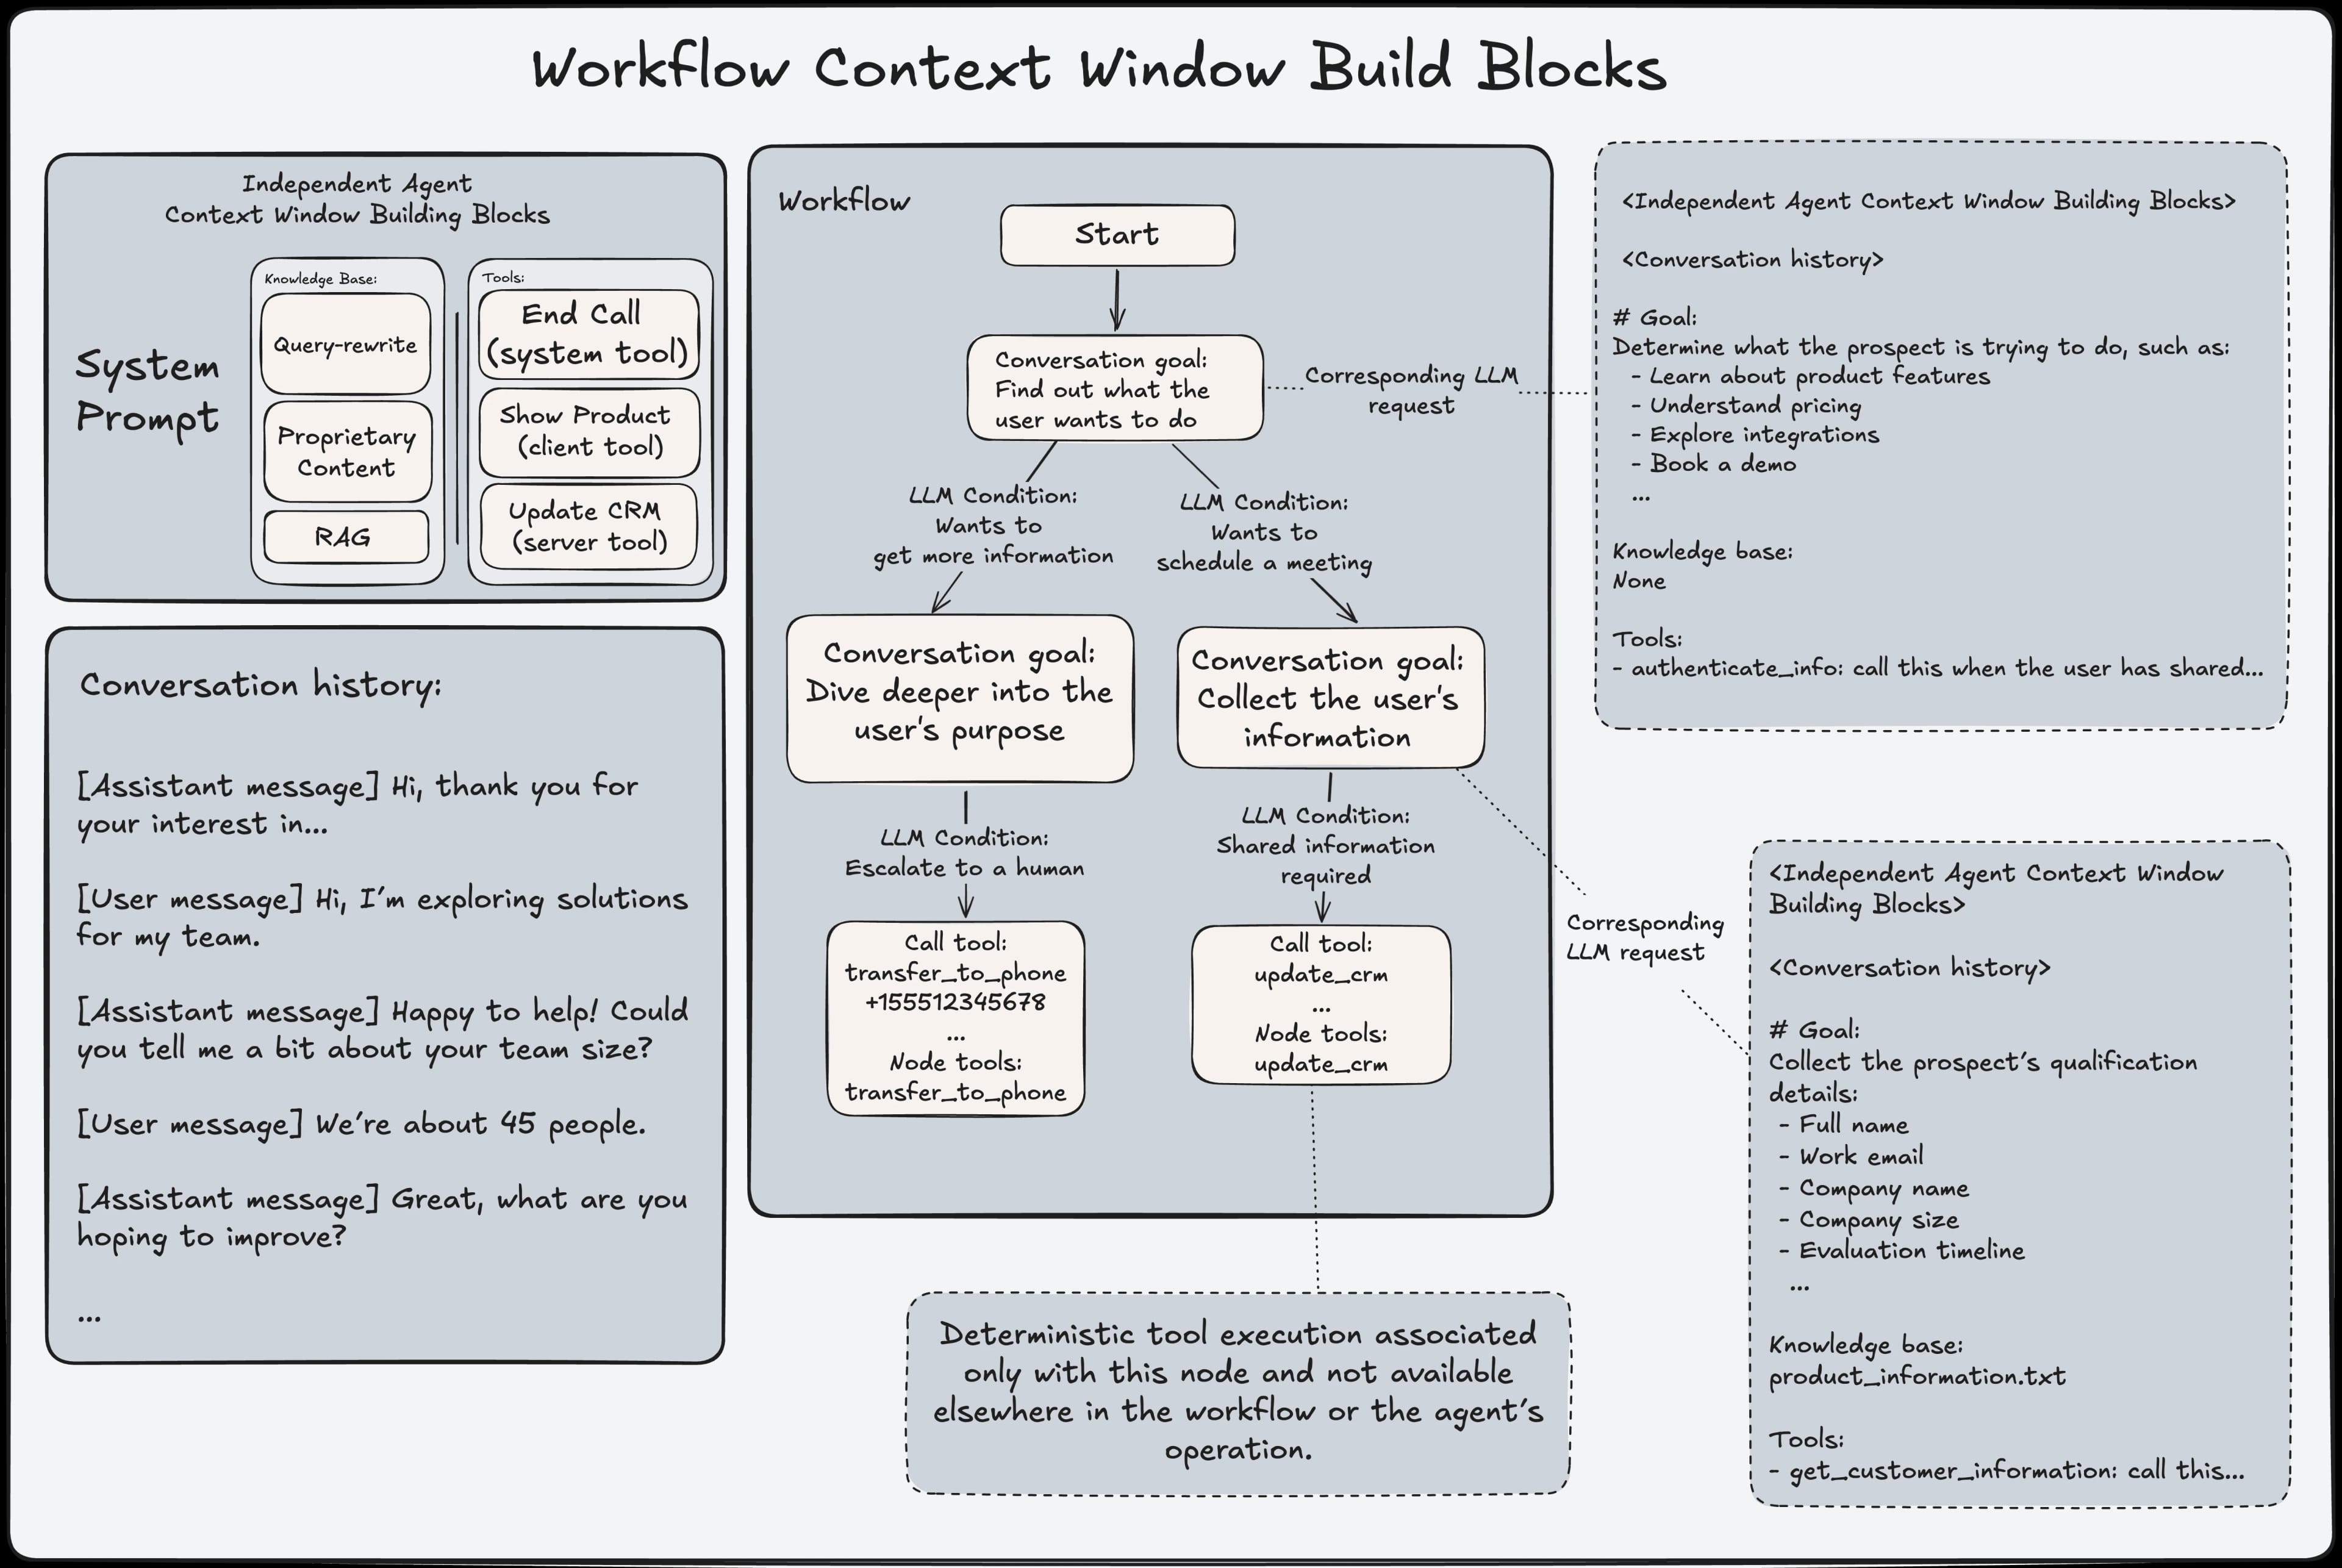
Na tej wspólnej podstawie Workflows wprowadzają wyspecjalizowanych podagentów działających w grafie skierowanym. Każdy podagent otrzymuje wąsko określony cel i rozszerza bazową konfigurację o dodatkowe instrukcje promptu, narzędzia oraz źródła wiedzy istotne tylko dla jego roli. Zamiast na nowo definiować całą konfigurację rozmowy, podagenci nakładają swoje intencje na agenta bazowego przez łączenie promptów i selektywne rozszerzanie kontekstu. Historia rozmowy jest zachowywana przy przejściach między podagentami, aby utrzymać ciągłość, ale każdy podagent działa z celowo ograniczonym widokiem systemu. Bazy wiedzy i narzędzia są udostępniane selektywnie, tworząc wyraźne silosy, które zapobiegają przenikaniu informacji między obowiązkami. Aby wzmocnić tę izolację, obiekt orkiestratora jest przebudowywany przy każdym przejściu tak, jak dla niezależnego agenta. Dzięki temu stan promptu, konfiguracja i dostępne możliwości aktywnego podagenta pozostają w pełni deterministyczne. Taka konstrukcja pozwala Workflowom zachować globalną spójność przy lokalnej specjalizacji, zapewniając przewidywalne zachowanie, wyraźny podział odpowiedzialności i precyzyjną kontrolę nad stosowaniem kontekstu, wiedzy i działań na każdym etapie interakcji.
Jednym z kluczowych mechanizmów umożliwiających tę kontrolę jest sposób zarządzania przejściami między podagentami.
Sterowanie przejściami workflowu za pomocą warunków LLM
Workflows przechodzą przez graf skierowany podagentów, gdzie przejścia między węzłami są kontrolowane przez jawne warunki. Warunki te określają, kiedy kontrola ma przejść z jednego podagenta do drugiego, i pozwalają workflowom reagować na dane wejściowe użytkownika, wyniki narzędzi oraz zmienne dynamiczne. Warunki grafu mogą być deterministyczne lub oceniane przez LLM. Warunki deterministyczne, takie jak przejścia bezwarunkowe, sprawdzenia oparte na wyrażeniach zmiennych dynamicznych czy warunki wyników narzędzi, dają silne gwarancje dotyczące przepływu sterowania i dobrze sprawdzają się przy wymuszaniu ścisłego postępu w workflowie. Warunki oparte na LLM pozwalają natomiast semantycznie oceniać kryteria w języku naturalnym, na przykład wykrywać intencję użytkownika lub rozpoznawać, że podano konkretną informację.
Co ważne, warunki LLM są oceniane poza promptem systemowym aktywnego agenta i nie wpływają na zachowanie agenta podczas generowania. Zamiast tego orkiestrator ocenia je równolegle względem bieżącego stanu rozmowy. Ten podział sprawia, że logika przejść nie zanieczyszcza promptu agenta ani nie wpływa na generowanie odpowiedzi, a jednocześnie pozwala workflowom korzystać z rozumowania LLM przy elastycznym przechodzeniu przez graf. Łącząc warunki deterministyczne i oceniane przez LLM, workflows mogą zapewniać zarówno przewidywalność, jak i adaptacyjność: używać przejść deterministycznych tam, gdzie poprawność jest kluczowa, a przejść opartych na LLM tam, gdzie potrzebna jest interpretacja semantyczna.
Gdy rozmowa przechodzi do nowego etapu, system aktywuje wersję agenta dostosowaną do tego kroku. Każdy etap działa według własnych, precyzyjnych instrukcji i ma dostęp wyłącznie do wiedzy i narzędzi związanych z jego zadaniem. Na przykład etap obsługi zwrotów może odwoływać się do zasad zwrotów bez dziedziczenia niepowiązanego kontekstu z wdrożenia lub wstępnej kwalifikacji. Przejścia między etapami regulują jawne warunki przejścia. Określają one, kiedy odpowiedzialność powinna się zmienić, i umożliwiają naturalne decyzje o przekierowaniu w miarę rozwoju rozmowy. Aby zachować ciągłość, doświadczenie użytkownika pozostaje płynne między przejściami, a każdy etap dziedziczy odpowiedni kontekst rozmowy bez ujawniania mechaniki przekazania. Zabezpieczenia monitorują też przejścia, aby zapobiegać nieproduktywnym cyklom przekierowań i utrzymywać stabilność oraz ukierunkowanie workflowu na cel.
Bezpieczeństwo i ochrona
W przypadkach wymagających większej kontroli bezpieczeństwa i ochrony klienci mogą korzystać z dodatkowych części orkiestratora.
Mechanizmy ochronne
ElevenLabs Agents wdrażają mechanizmy ochronne przez konfigurowalny system moderacji i wyrównania, który w czasie rzeczywistym ocenia wiadomości użytkownika i agenta. Treści przychodzące są klasyfikowane w wielu kategoriach ryzyka, w tym treści seksualne, przemoc, nękanie, mowa nienawiści i samookaleczenie, a progi dla każdej z nich można konfigurować niezależnie. Gdy mechanizm ochronny zostanie uruchomiony, rozmowa jest natychmiast kończona, a klient otrzymuje jasny powód niepowodzenia. Zapewnia to wczesne i spójne blokowanie niebezpiecznych interakcji bez polegania wyłącznie na zabezpieczeniach opartych na promptach. Mechanizmy ochronne działają poza logiką promptu agenta, zapewniając niezawodną warstwę egzekwowania zasad, której nie można obejść zachowaniem modelu ani danymi wejściowymi użytkownika. Takie podejście pozwala klientom dostosować czułość zabezpieczeń do swojej dziedziny, zachowując deterministyczne egzekwowanie zasad w czasie działania.
Zgodne z wymogami zarządzanie danymi
Rozmówcy mogą czasem udostępniać agentowi wrażliwe informacje podlegające ścisłym wymogom przechowywania i przetwarzania, na przykład dane medyczne wymagające obsługi zgodnej z HIPAA. Aby obsługiwać takie przypadki użycia, oferujemy Zero Retention Mode (ZRM) na poziomie Agenta lub Workspace. Po włączeniu wszystkie dane z rozmów są przetwarzane wyłącznie w pamięci i nigdy nie są zapisywane w trwałym magazynie. Po zakończeniu rozmowy i przetwarzania ElevenLabs nie zachowuje żadnych informacji. W rezultacie transkrypcje, nagrania audio i wyniki analiz nie są dostępne w panelu Agents Dashboard; zasada ta dotyczy zarówno systemów dla klientów, jak i wewnętrznych logów. Dane nie są zachowywane, ale są przetwarzane w trakcie rozmowy, a wszystkie skonfigurowane webhooki po rozmowie otrzymają wyniki. Pozwala to klientom zapisywać transkrypcje lub wyniki analiz we własnych systemach, jeśli tego potrzebują.
Gdy ZRM jest aktywny, zapewniamy też, że podmioty przetwarzające dane nie zachowują danych, ograniczając dostępne LLM-y do dostawców, którzy w umowach zobowiązują się nie trenować na danych klientów ani ich nie przechowywać. Obecnie obejmuje to modele Google Gemini i Anthropic Claude. Klienci, którzy chcą używać innego LLM w ramach ZRM, mogą podpisać własną umowę z danym dostawcą i skonfigurować go jako niestandardowy LLM, korzystając z kluczy API objętych tą umową. Ponieważ rozszerza to przetwarzanie danych poza naszą standardową granicę zaufania, nasz zespół Safety musi ręcznie sprawdzić i zatwierdzić taki przypadek użycia przed jego włączeniem. ZRM zapewnia, że ElevenLabs i podmioty przetwarzające dane nie zachowują danych z rozmów, ale klienci nadal odpowiadają za zgodność wszystkich zewnętrznych narzędzi lub webhooków używanych przez ich Agenta z obowiązującymi wymogami dotyczącymi retencji danych i przepisami.
Co dalej
W tym artykule pokazaliśmy, jak ElevenLabs Agents zarządzają kontekstem rozmowy, narzędziami, oceną i uporządkowanymi workflowami, aby zapewniać niezawodne doświadczenia w czasie rzeczywistym na dużą skalę. W miarę jak klienci wdrażają agentów w coraz bardziej złożonych środowiskach, stale zwiększamy elastyczność naszego silnika orkiestracji — od konfigurowalnych modeli oceny i bogatszej kontroli przejść po lepszy wgląd w skład promptów i wykorzystanie tokenów na kolejnych etapach.
Nasz zespół Forward Deployed Engineering ściśle współpracuje z klientami, aby te możliwości rozwijały się w parze z wdrożeniami w rzeczywistych warunkach. Kolejna generacja Agents zapewni jeszcze większą przejrzystość, deterministyczność i adaptacyjność bez pogarszania działania z niskimi opóźnieniami, które umożliwia rozmowy w czasie rzeczywistym.


