Text to Speech a Speech to Text: czym się różnią?
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Wyobraź sobie: jedziesz do pracy, a smartfon odczytuje nieprzeczytane e-maile za pomocą zamiany tekstu na mowę (TTS). Co więcej, możesz wysłać odpowiedzi bez dotykania telefonu i odrywania wzroku od drogi — wszystko dzięki Speech to Text (STT).
Te technologie to nie tylko ciekawe, futurystyczne pomysły. Szybko stają się częścią codzienności, ułatwiają zadania i zwiększają dostępność.
Przyjrzyjmy się TTS i STT opartym na sztucznej inteligencji: czym są, czym się różnią, jak działają, na co zwracać uwagę przy wyborze dostawcy oraz jak wykorzystują je różne branże.
Różnice między TTS a mową na tekst
Istnieje kilka kluczowych różnic między TTS a technologią mowy na tekst. Oto najważniejsze z nich.
Funkcjonalność
TTS (Text to Speech) zamienia tekst pisany na mowę, a Speech to Text (STT) działa odwrotnie — przekształca wypowiedziane słowa w tekst. TTS sprawia, że treści pisane stają się dostępne w formie dźwiękowej, działając jak asystent głosowy dla osób z wadami wzroku lub trudnościami w nauce. STT z kolei wychwytuje mowę i tworzy z niej pisemną transkrypcję, co przydaje się przy dyktowaniu i komendach głosowych.
Kontekst użycia
TTS często stosuje się w czytnikach e-booków, systemach komunikatów publicznych i wirtualnych asystentach, aby przekazywać informacje głosowo. STT wykorzystuje się w usługach transkrypcji, aplikacjach sterowanych głosem i napisach na żywo dla osób z ubytkiem słuchu. TTS skupia się przede wszystkim na przekazywaniu informacji w formie dźwięku. STT koncentruje się natomiast na przechwytywaniu i przetwarzaniu mowy.
Podejście technologiczne
TTS obejmuje analizę tekstu, przetwarzanie języka i syntezę mowy. Musi precyzyjnie oddawać niuanse języka mówionego, w tym intonację i rytm. STT wymaga zaawansowanego rozpoznawania głosu, aby dokładnie transkrybować różne akcenty, dialekty i style mówienia — często w czasie rzeczywistym.
Czym jest TTS (Text to Speech)?
TTS (Text to Speech) to technologia, która zamienia tekst pisany na mowę. W swojej istocie TTS pozwala komputerom czytać na głos, przekształcając dowolny tekst w syntetyczny głos. Technologia ta znajduje szerokie zastosowanie — od wirtualnych asystentów po narzędzia ułatwiające dostęp osobom z trudnościami w czytaniu.
Dobrym przykładem zaawansowanej technologii TTS są możliwości TTS od ElevenLabs. TTS od ElevenLabs wyróżnia się zdolnością do tworzenia wyjątkowo naturalnie brzmiących, ludzkich głosów. Jest to możliwe dzięki zaawansowanym algorytmom AI, które nie tylko naśladują brzmienie ludzkiej mowy, lecz także rozumieją i odtwarzają jej niuanse oraz intonację.
Ten poziom realizmu sprawia, że TTS od ElevenLabs świetnie nadaje się do tworzenia angażujących treści audio dla różnych mediów, wzbogacania interfejsów o komunikaty głosowe oraz zapewniania osobom z wadami wzroku dostępnej alternatywy dla czytania.
Czym jest mowa na tekst (Speech to Text, STT)?
Mowa na tekst, znana też jako Speech to Text (STT), to proces zamiany języka mówionego na tekst pisany. Ta technologia rozpoznawania mowy jest kluczowa przy tworzeniu transkrypcji nagrań audio, obsłudze komend głosowych i generowaniu napisów na żywo dla większej dostępności.
ElevenLabs poczyniło duże postępy w technologii STT. Nasz model Scribe sprawnie zamienia audio i wideo na tekst w 99 językach. Oferuje prosty interfejs, dzięki czemu świetnie nadaje się do zapisywania spotkań, wykładów i wywiadów z plików audio i wideo.
Jak działa TTS?
Technologia TTS (Text to Speech) zamienia tekst pisany w słyszalną mowę w procesie obejmującym kilka złożonych etapów.
Najpierw system TTS analizuje tekst, dzieląc go na fonemy — najmniejsze jednostki dźwiękowe w języku. Ten podział jest kluczowy, aby system mógł poprawnie wymawiać różne słowa.
Po podziale na fonemy system zamienia te dźwięki w cyfrową mowę. Kluczową rolę odgrywa tu sztuczna inteligencja (AI). Dzięki algorytmom AI trenowanym na rozległych zbiorach danych języka mówionego system może generować mowę o ludzkim tonie i rytmie. Wygenerowana mowa zostaje następnie dopasowana do rozpoznanych fonemów, co daje naturalnie brzmiący rezultat.
Dzięki postępom w AI i uczeniu maszynowym współczesne technologie TTS znacznie się rozwinęły. Potrafią rozumieć niuanse kontekstu, obsługiwać wiele języków i częściowo naśladować emocjonalną intonację. Dzięki temu generowana mowa brzmi bardziej po ludzku, a interakcje z urządzeniami cyfrowymi są naturalniejsze i ciekawsze.
Jacy dostawcy TTS są najlepsi?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Jak działa Speech to Text?
Technologia Speech to Text (STT) zamienia język mówiony na tekst pisany w złożonym, wieloetapowym procesie.
Najpierw przechwytuje wypowiadane słowa, zwykle przez mikrofon. Następnie wejściowy dźwięk zostaje przekształcony do formatu cyfrowego, który system może przetwarzać. Istotą STT jest analiza tego cyfrowego audio. Zaawansowane algorytmy dzielą mowę na mniejsze, rozpoznawalne segmenty.
Segmenty te to fonemy, czyli najmniejsze jednostki dźwiękowe mowy. System STT porównuje je z wcześniej zdefiniowanym modelem językowym, aby rozpoznać słowa i frazy. Ten etap jest kluczowy dla rozumienia różnych akcentów, dialektów i wariantów mowy.
Następnie system wykorzystuje techniki przetwarzania języka naturalnego (NLP). NLP pomaga zrozumieć kontekst i składnię wypowiedzi, co umożliwia dokładniejszą transkrypcję. Pozwala też systemowi radzić sobie ze złożonymi strukturami zdań i branżowym żargonem.
Zaawansowane systemy STT korzystają z algorytmów uczenia maszynowego i głębokiego uczenia, które doskonalą się wraz z ilością danych i użyciem. Dzięki tym technologiom system z czasem uczy się nowych sposobów mówienia, akcentów, a nawet języków, zwiększając swoją dokładność i wydajność.
Podsumowując, technologia STT obejmuje przechwytywanie audio, analizę fonemów, modelowanie językowe i NLP, wspierane przez uczenie maszynowe, aby skutecznie zamieniać mowę na tekst.
Jacy dostawcy Speech to Text są najlepsi?
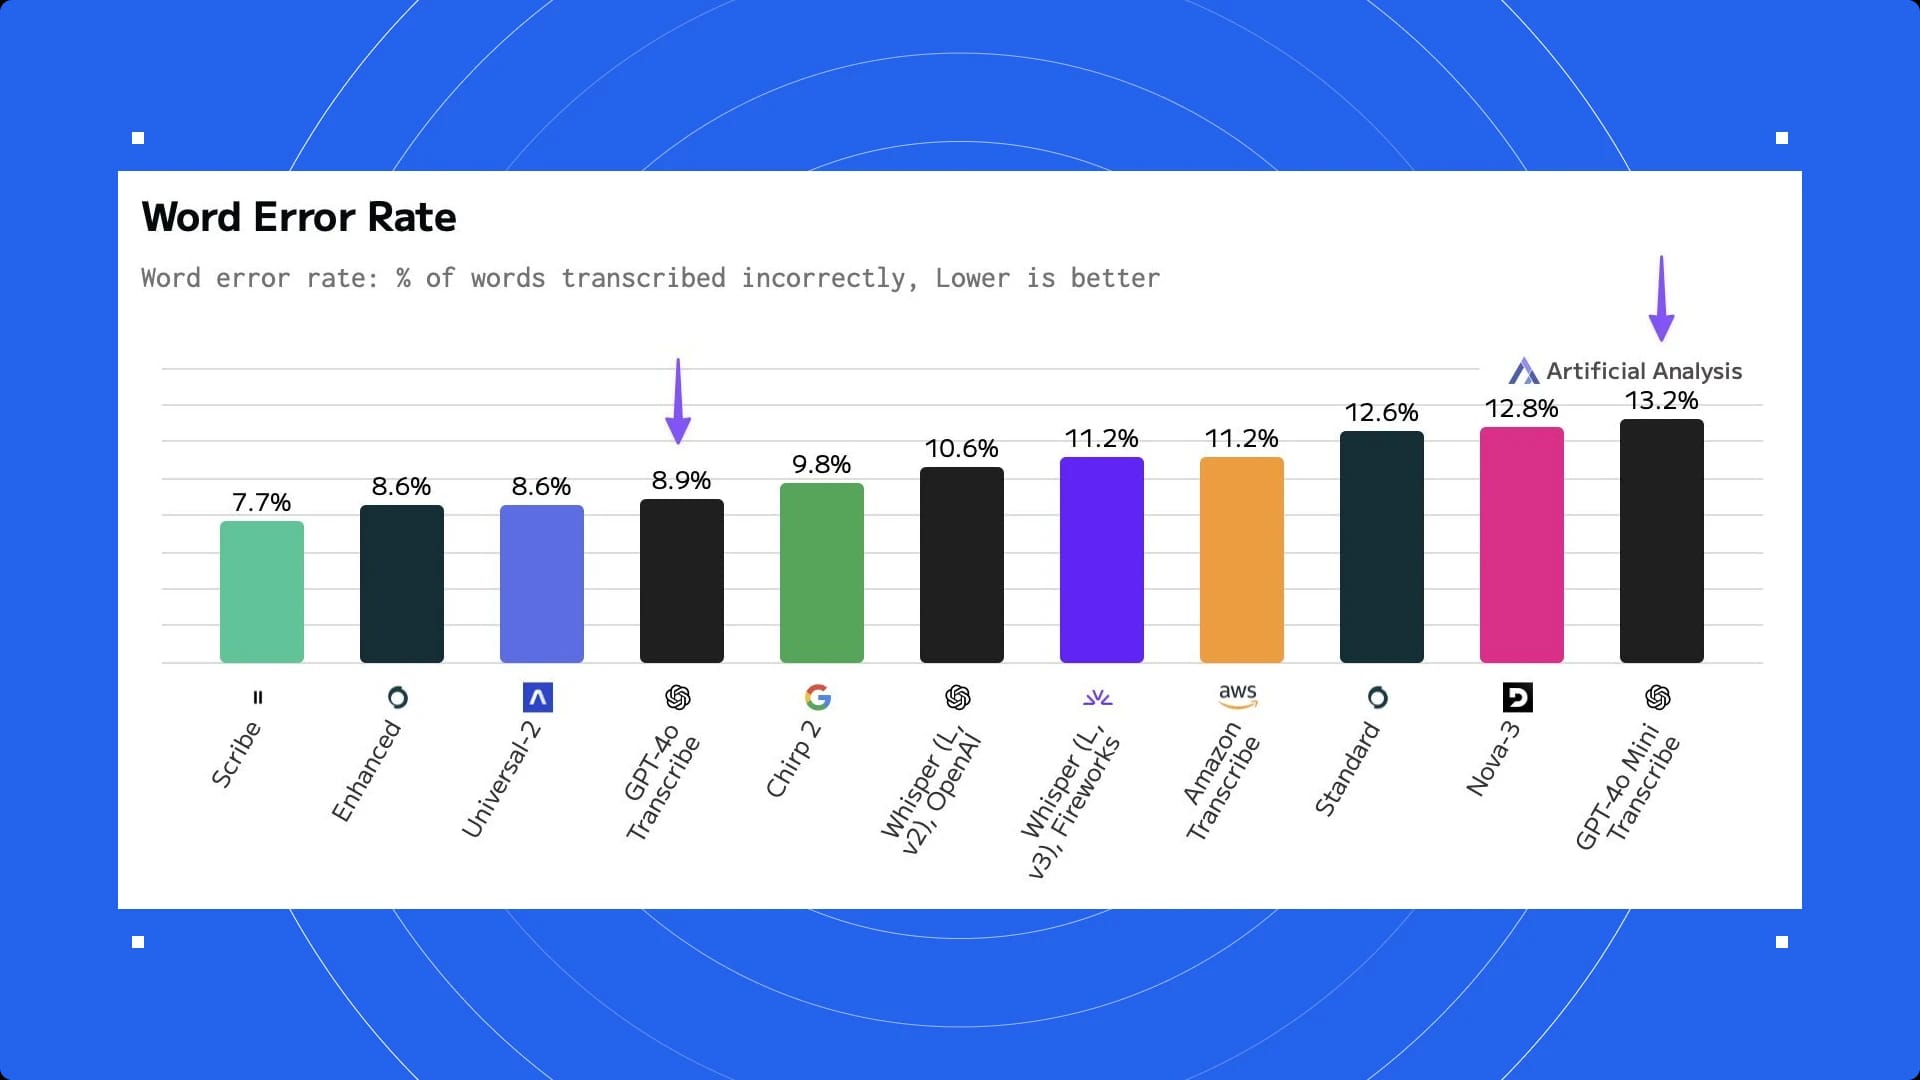
Najlepszym dostawcą Speech to Text jest Scribe od ElevenLabs, a kolejne miejsca zajmują OpenAI i inni dostawcy, tacy jak Google.
TTS i STT: dokładność i wyzwania
Technologie TTS i Speech to Text dążą do ludzkiej precyzji. Ich dokładność stale rośnie, ale wciąż nie jest idealna. Oto czego możesz oczekiwać pod względem dokładności i wyzwań w obu tych technologiach.
Dokładność i wyzwania TTS (Text to Speech)
Technologia TTS z głosami AI znacznie się rozwinęła, ale nadal mierzy się z wyzwaniami. Najważniejszym jest uzyskanie naturalnie brzmiących ludzkich głosów. Choć nowoczesne systemy TTS potrafią tworzyć wyraźne i zrozumiałe audio, dodanie ludzkiej intonacji i emocji wciąż jest trudne. TTS ma też problemy z interpretacją kontekstu, przez co czasem błędnie wymawia słowa. Kolejnym wyzwaniem jest dostosowanie głosów do różnych potrzeb, na przykład akcentów i sposobów mówienia, co jest niezbędne dla globalnej dostępności.
Dokładność i wyzwania mowy na tekst/Speech to Text (STT)
Technologia STT poczyniła duże postępy w dokładności, zwłaszcza wraz z rozwojem głębokiego uczenia. Wciąż jednak ma trudności w hałaśliwym otoczeniu, gdzie dźwięki w tle mogą zakłócać rozpoznawanie głosu. Dużym wyzwaniem jest też dokładne rozpoznawanie i transkrypcja różnych akcentów oraz dialektów. Ponadto systemy STT często mają problem z homofonami, czyli słowami brzmiącymi tak samo, ale o różnych znaczeniach, oraz ze zrozumieniem złożonej składni czy slangu. Wpływa to na ich skuteczność w rzeczywistych zastosowaniach.
Zastosowania w różnych branżach
TTS i Speech to Text znajdują innowacyjne zastosowania w wielu branżach, zmieniając sposób, w jaki korzystamy z informacji, i zwiększając dostępność.
Zastosowania TTS w branżach
Technologia TTS znajduje zastosowanie w różnych sektorach. W edukacji pomaga tworzyć dostępne materiały dla uczniów z trudnościami w czytaniu lub wadami wzroku, na przykład przez zamianę podręczników w audiobooki.
W branży motoryzacyjnej TTS generuje komunikaty głosowe w systemach nawigacji. Obsługa klienta wykorzystuje TTS do automatycznych odpowiedzi w call center, co zwiększa wydajność. TTS odgrywa też ważną rolę w rozrywce, zwłaszcza w grach i wirtualnych asystentach, zapewniając interaktywne doświadczenia.
Zastosowania STT w branżach
Technologia STT ma różnorodne zastosowania w wielu branżach. W ochronie zdrowia pomaga transkrybować rozmowy lekarzy z pacjentami i dyktować dokumentację kliniczną, zwiększając wydajność. W prawie STT służy do transkrypcji rozpraw i dokumentacji prawnej. Technologia odgrywa też kluczową rolę w mediach, wspierając tworzenie napisów na żywo w transmisjach dla osób z ubytkiem słuchu. W firmach STT ułatwia sprawną transkrypcję spotkań, poprawiając archiwizację i dostęp do informacji.
Podsumowanie
Technologie TTS (Text to Speech) i Speech to Text (STT), choć z pozoru podobne, pełnią różne funkcje. TTS zamienia tekst pisany na mowę, ożywiając treści za pomocą głosów brzmiących jak ludzkie. STT działa odwrotnie — zmienia wypowiedziane słowa w tekst, zapisując niuanse języka mówionego.
Obie technologie wykorzystują zaawansowaną AI, ale odpowiadają na różne potrzeby: TTS umożliwia słuchanie tekstów pisanych, a STT tworzenie pisemnych zapisów wypowiedzi.
Chcesz zacząć? Wypróbuj Eleven v4, nasz najbardziej emocjonalny model Text to Speech.
Jeśli chcesz wypróbować najnowocześniejszą technologię TTS, zarejestruj się w ElevenLabs już dziś. Nie zawiedziesz się.