
Jak działa transkrypcja audio ze znacznikami czasu i tagami zdarzeń?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Natywny model transkrypcji na poziomie słów przyjmuje nagranie audio lub strumień w czasie rzeczywistym i zwraca uporządkowaną tablicę oznaczonych tagami oraz sygnaturami czasowymi obiektów tokenów reprezentujących mowę i dźwięki pozawerbalne. Każdy token należy do jednego z trzech typów: word, spacing lub audio_event. Zdarzeniami audio mogą być śmiech, oklaski lub inne dźwięki tła.
W tym artykule wyjaśniamy, jak działa transkrypcja audio ze znacznikami czasu i dlaczego jest bardziej elastyczna oraz wydajniejsza niż tradycyjna transkrypcja oparta na wymuszonym dopasowaniu.
Podsumowanie
- Transkrypcja na poziomie słów bezpośrednio zwraca uporządkowane tablice danych mowy i pozawerbalnych zdarzeń audio ze znacznikami czasu.
- W przeciwieństwie do tradycyjnych modeli automatycznego rozpoznawania mowy, które zwracają całe bloki tekstu. Aby dodać do nich znaczniki czasu względem surowego audio, musisz wykonać drugi proces wymuszonego dopasowania, co trwa dłużej i zwiększa zużycie mocy obliczeniowej.
- Tagi zdarzeń pomagają uchwycić treści pozawerbalne, takie jak śmiech czy oklaski. Ponieważ te dane można przeszukiwać, możesz użyć ich do znajdowania najważniejszych lub viralowych momentów na podstawie reakcji odbiorców.
- Uporządkowane dane wyjściowe możesz przekazać do aplikacji w wielu zastosowaniach, m.in. do bardzo dokładnych napisów, przeszukiwalnych archiwów audio i automatycznego tworzenia klipów do social mediów.
- Transkrypcja Scribe na poziomie słów obsługuje do 5 kanałów, z których każdy jest transkrybowany niezależnie.
Czym jest transkrypcja audio ze znacznikami czasu i tagami zdarzeń?
Transkrypcja ze znacznikami czasu to forma automatycznego rozpoznawania mowy (ASR), która podczas transkrypcji śledzi dokładne momenty rozpoczęcia i zakończenia słów oraz innych zdarzeń audio, takich jak oklaski. Jej wynikiem są w pełni uporządkowane dane, po których można swobodnie nawigować.
Tradycyjna transkrypcja ASR przetwarza audio na duże bloki czytelnego dla człowieka tekstu. Daje napisy i transkrypcję dla czytelników, ale jako dane nie jest zbyt użyteczna.
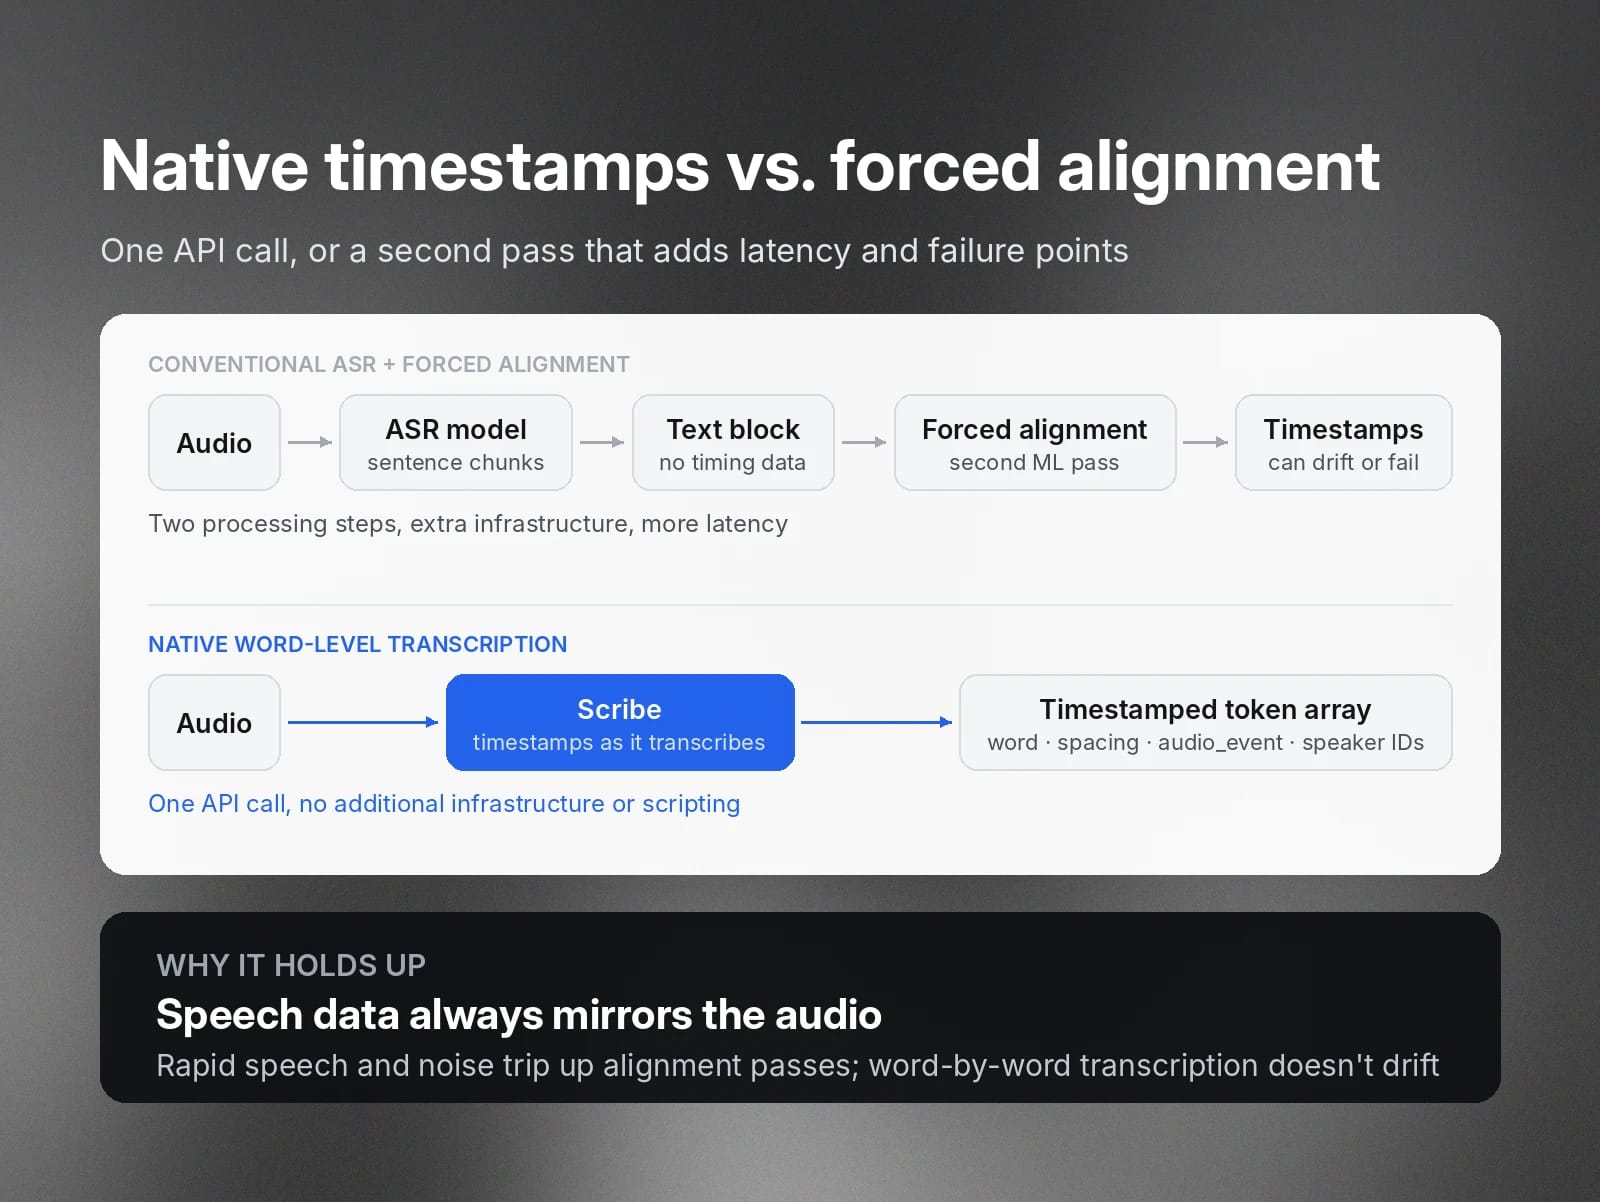
Jeśli chcesz uporządkować ją za pomocą znaczników czasu, musisz ponownie przepuścić ją przez dodatkową usługę uczenia maszynowego, aby dopasować tekst do audio. Możesz w końcu uzyskać podobny wynik, ale wymaga to wielu etapów przetwarzania zamiast natywnego zwrócenia danych przez API, co zwiększa opóźnienia i zużycie mocy obliczeniowej.
Nawigacja po audio
Główna zaleta transkrypcji ze znacznikami czasu i tagami zdarzeń polega na tym, że jest czytelna zarówno dla ludzi, jak i maszyn. Ma to kilka ważnych zastosowań biznesowych:
- Audyt zgodności: Możesz przeszukiwać transkrypcję według słów kluczowych i uzyskiwać dokładne znaczniki czasu dla każdej wzmianki o danych wrażliwych.
- Produkcja i montaż wideo: Oprogramowanie do produkcji wideo może synchronizować napisy z wypowiedziami na ekranie co do milisekundy. Może też odpowiednio oznaczać reakcje publiczności.
- Przeszukiwalne archiwa: Zespoły PR, sprzedaży i szkoleń mogą transkrybować duże ilości wywiadów z klientami, wystąpień na targach, webinarów czy spotkań otwartych, tworząc rozległe, przeszukiwalne archiwa.
- Analityka marketingowa i nastroje klientów: Tagi zdarzeń mogą oznaczać reakcje odbiorców, które mogłyby zniknąć w podstawowej transkrypcji tekstowej.
Jakie są zalety natywnych znaczników czasu na poziomie słów?
Standardowe modele zamiany mowy na tekst przetwarzają mowę partiami, zwykle całymi zdaniami lub akapitami. Jeśli potrzebujesz znaczników czasu dla każdego słowa, musisz stworzyć dodatkową warstwę przetwarzania, która w drugim przebiegu wykona tzw. wymuszone dopasowanie. To zwiększa wymagania infrastrukturalne i opóźnienia, a także liczbę potencjalnych punktów awarii. Na przykład znaczniki mogą się przesuwać lub całkowicie zawieść przy szybkiej mowie albo mowie zagłuszonej przez głośny hałas w tle.
Transkrypcja ze znacznikami czasu, którą oferuje Scribe, rozwiązuje ten problem dzięki transkrypcji na bardziej szczegółowym poziomie, słowo po słowie. Robi to w jednym wywołaniu API. Nie potrzebujesz dodatkowej infrastruktury ani skryptów. Model oblicza znaczniki czasu podczas transkrypcji, więc dane mowy zawsze dokładnie odpowiadają audio.
Jak działa transkrypcja ze znacznikami czasu i tagami zdarzeń?
Weźmy Scribe jako przykład.
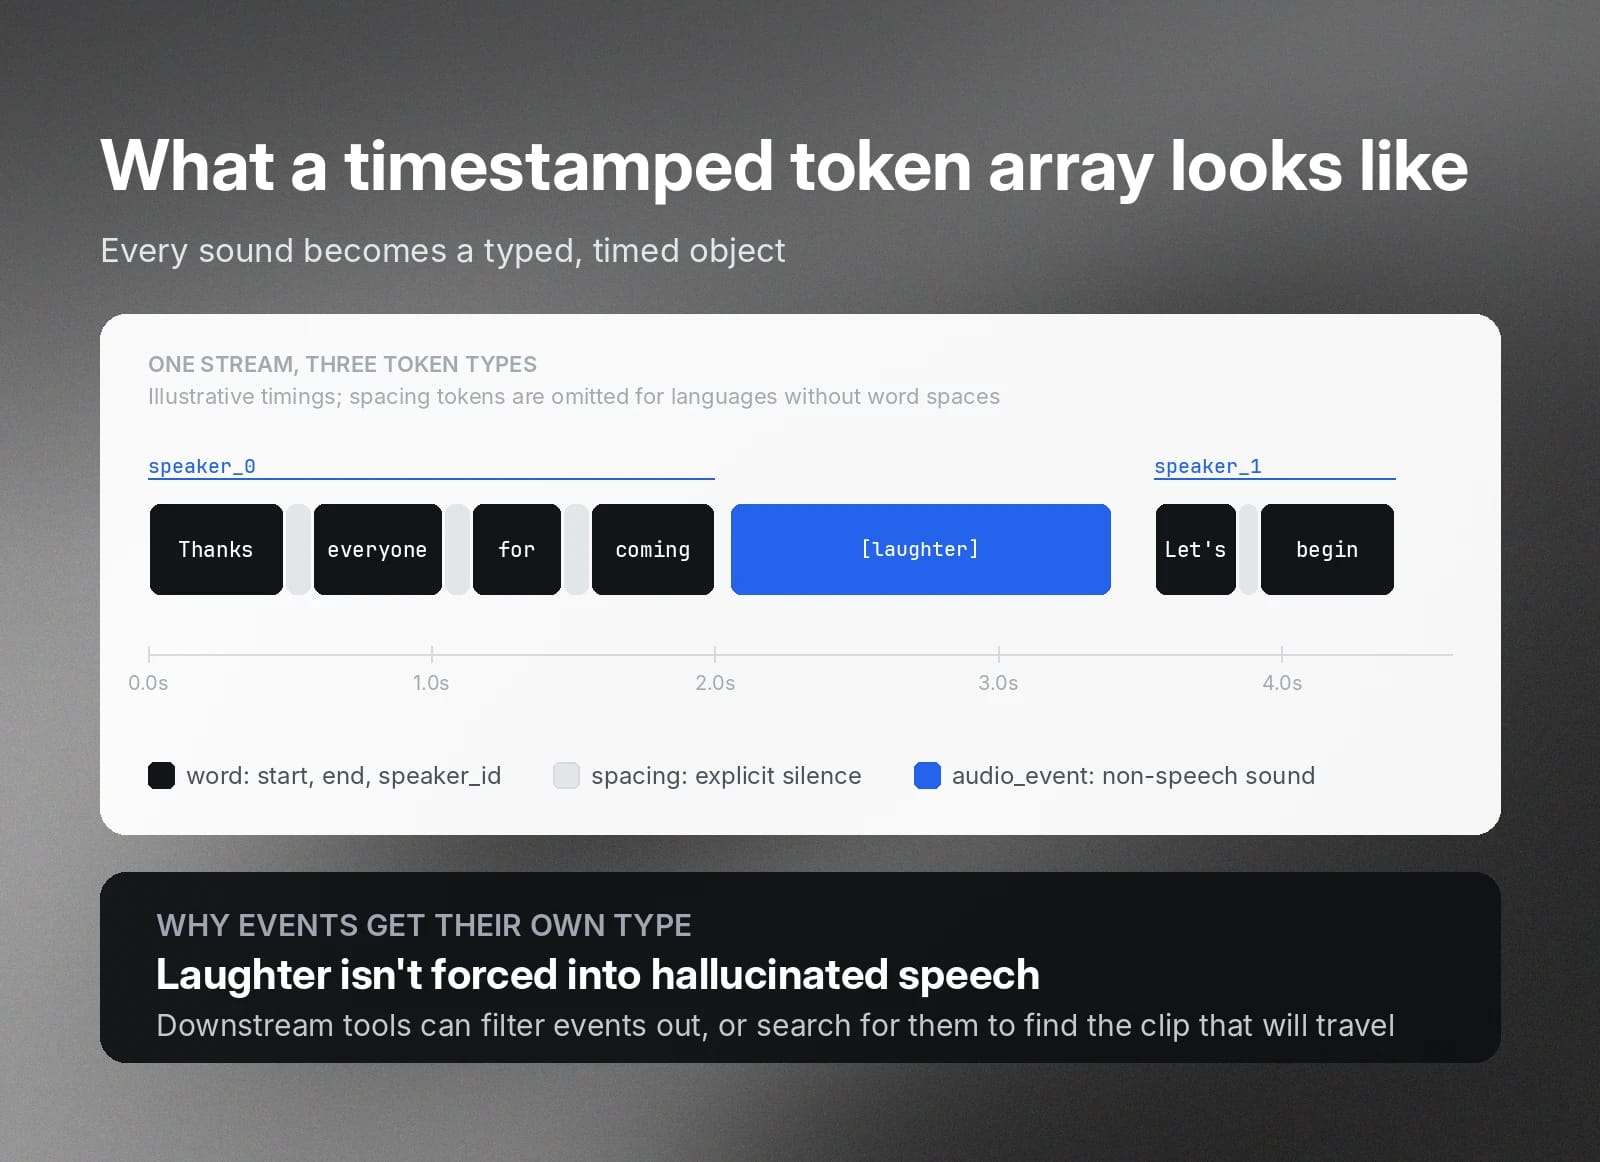
Natywny model transkrypcji na poziomie słów mapuje dźwięki mowy w strumieniu audio na uporządkowaną tablicę obiektów tokenów. Każdy token oznacza jako jeden z trzech typów: word, spacing lub audio_event.
- word: Rozpoznane pojedyncze słowo mówione z określonym czasem rozpoczęcia i zakończenia oraz tagiem speaker_id.
- spacing: Jawnie oznaczona cisza lub pauzy w trakcie mowy. Pomaga usługom generowania napisów zachować właściwe tempo. Nie jest używany w rozpoznanych językach, które nie stosują spacji między słowami, takich jak japoński, mandaryński, tajski, lao, birmański i kantoński.
- audio_event: Istotne dźwięki pozawerbalne, takie jak śmiech lub oklaski. Model traktuje je jako osobny typ zdarzenia i nie zamienia audio w zmyśloną mowę.
Parametry strumieniowania w czasie rzeczywistym
Modele transkrypcji na poziomie słów mogą też mieć specjalne funkcje obsługujące transkrypcję audio WebSocket na żywo. Na przykład:
- include_timestamps=true: Ten parametr sprawia, że połączenie uwzględnia znaczniki czasu na poziomie słów w wiadomościach JSON committed_transcript_with_timestamps wysyłanych na końcu każdego sfinalizowanego fragmentu audio. Dzięki temu otrzymujesz znaczniki czasu, gdy strumień nadal trwa. Tagi zdarzeń audio są uwzględniane tylko wtedy, gdy włączysz też tag_audio_events.
- include_language_detection=true: Ten parametr nakazuje połączeniu oznaczać różne wykryte języki mówione wraz z oceną pewności modelu. Pomaga to tworzyć napisy w wielu językach na żywo.
Jak model Speech to Text oznacza zdarzenia pozamowne?
Scribe będzie oznaczać zdarzenia audio, gdy włączysz parametr tag_audio_events. W takim przypadku oznaczy tagami i znacznikami czasu konkretne momenty rozpoczęcia i zakończenia, tak jak robi to ze słowami. Może oznaczać różne reakcje, najczęściej śmiech i oklaski, ale też inne potencjalnie istotne dźwięki otoczenia, w tym kroki lub muzykę w tle muzyka.
Przede wszystkim wzbogaca to transkrypcje i napisy o ważny kontekst. Czytelnikowi może być trudniej wychwycić sarkazm w prostym, neutralnym tekście. Tag [laughter] wzbogaca transkrypcję i nadaje jej większy ładunek emocjonalny.
Lepsza analityka
Tagowanie zdarzeń porządkuje też dalszą analitykę, ponieważ narzędzia nie muszą analizować jednego bloku nieuporządkowanego tekstu. Natywna transkrypcja na poziomie słów oddziela zdarzenia audio jako uporządkowane dane, więc narzędzia mogą je po prostu odfiltrować, gdy jest to potrzebne, i analizować wyłącznie treści słowne.
Ponieważ tokeny spacing uwidaczniają pauzy, możesz je analizować. To przydatne w analizie nastrojów i zastosowaniach QA, np. przy mierzeniu, jak długo konsultant obsługi klienta milczał podczas rozmowy.
Łatwiejsze wyszukiwanie według znaczników czasu
Możesz też wyszukiwać je bezpośrednio. Jeśli analizujesz nastroje w wywiadzie dotyczącym testów produktu, możesz wyodrębniać istotne reakcje emocjonalne. A jeśli prowadzisz konto w social mediach, szybko wyszukasz śmiech w godzinnym wystąpieniu, aby znaleźć klipy, które mają największą szansę stać się viralem.
Jakie są praktyczne zastosowania uporządkowanych transkrypcji ze znacznikami czasu?
Natywne uporządkowane dane w transkrypcjach mają kilka ważnych zastosowań.
Tworzenie napisów i podpisów
Możesz eksportować transkrypcje ze znacznikami czasu bezpośrednio do formatów napisów produkcyjnych, w tym SRT i VTT, bez pośredniego przetwarzania. Narzędzie do montażu wideo może używać czasu słów, aby podświetlać je w napisach w chwili ich wypowiedzenia.
Model transkrypcji łatwo analizuje szybką mowę, ponieważ przetwarza ją słowo po słowie. Tam, gdzie tradycyjny model może mieć problem z bardzo szybką mową lub nakładającymi się głosami, model na poziomie słów, taki jak Scribe, zwróci czystą, uporządkowaną transkrypcję.
Wyszukiwanie audio i wideo
Tradycyjna transkrypcja pozwala dopasować słowa kluczowe w bloku tekstu, ale bez wymuszonego dopasowania nie możesz przejść do momentu, w którym padła dana fraza. Wyszukiwanie słów kluczowych w transkrypcji na poziomie słów jest w pełni indeksowane i przenosi cię dokładnie do sekundy, w której fraza została wypowiedziana. Dzięki temu archiwum audio staje się w pełni przeszukiwalnym katalogiem referencyjnym. Jest to szczególnie przydatne przy zarządzaniu dużymi bibliotekami mediów, sieciami podcastów i archiwami firmowymi.
Audyt zgodności i ryzyka
Często zechcesz nagrywać audio zawierające wrażliwe informacje, na przykład rozmowy z obsługą klienta do celów QA. To właśnie takie rozmowy najczęściej zawierają wrażliwe lub regulowane dane osobowe.
Aby zachować zgodność i jednocześnie mieć dane audio do analityki, potrzebujesz sposobu na redagowanie wrażliwych danych z transkrypcji w czasie rzeczywistym. Natywne znaczniki czasu na poziomie słów pozwalają korzystać z funkcji takich jak Entity Detection od ElevenLabs, która oznacza wrażliwe elementy (takie jak numery kart kredytowych lub nazwiska) i zwraca ich przesunięcia oraz znaczniki czasu, aby móc ukrywać je w napływających transkrypcjach.
Możesz na przykład wykrywać i redagować numer karty kredytowej, nazwisko panieńskie matki, datę urodzenia oraz nazwisko klienta, gdy są wypowiadane podczas rozmowy weryfikującej tożsamość.
Automatyczne tworzenie klipów do social mediów
Możesz też programowo zautomatyzować wyszukiwanie słów kluczowych, aby znajdować najważniejsze fragmenty dłuższych treści. Możesz na przykład wyróżnić ważne momenty z wystąpienia kampanijnego lub firmowego seminarium. Pomaga to zamieniać najnowsze treści w profesjonalnie zmontowane materiały na YouTube, LinkedIn lub TikTok.
Czas dla wielu kanałów i mówców
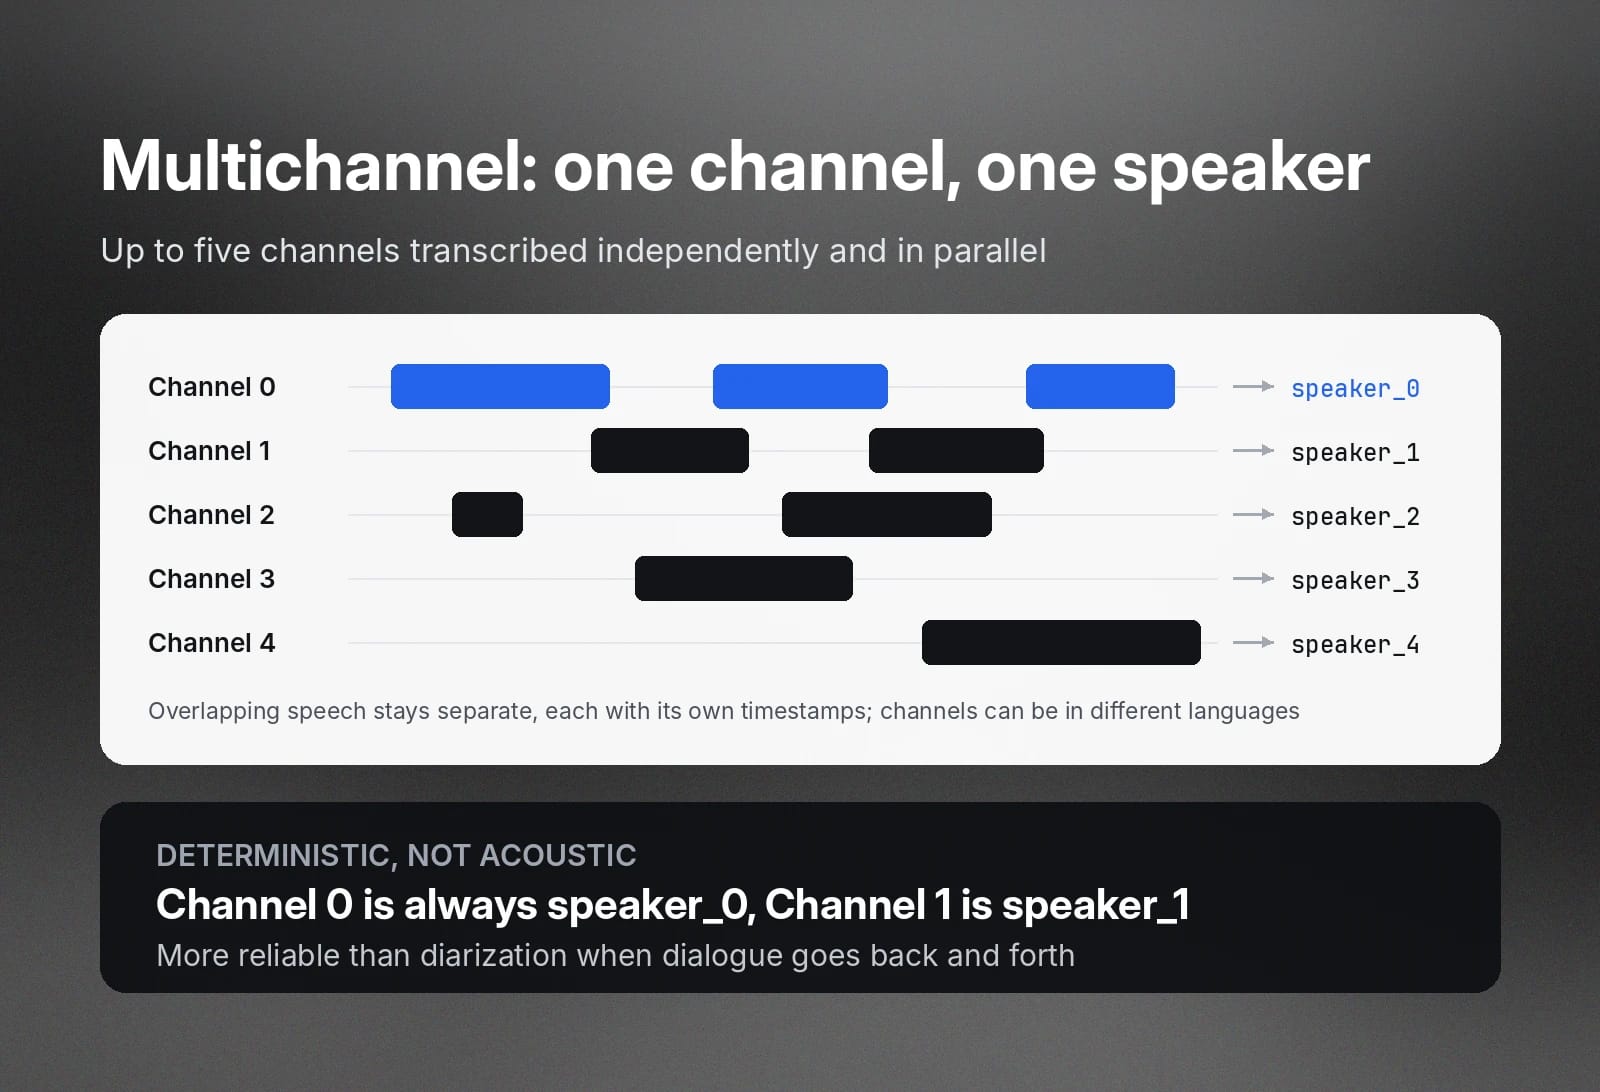
Scribe może transkrybować niezależnie i równolegle do pięciu kanałów. Każdy otrzymuje przypisany identyfikator mówcy i znaczniki czasu. To bardziej niezawodne niż standardowa akustyczna diaryzacja mówców, która często nie radzi sobie z dialogiem tam i z powrotem. W nagraniach wielokanałowych przypisanie mówców przez Scribe jest w pełni deterministyczne. Oznacza to, że kanał 0 jest przypisywany do speaker_0, kanał 1 do speaker_1 i tak dalej.
Potrafi rozpoznać mówców próbujących mówić jednocześnie i nadal generować niezależne znaczniki czasu dla ich wypowiedzi. Mogą też mówić w różnych językach.
Eksport danych ze znacznikami czasu w potrzebnym formacie
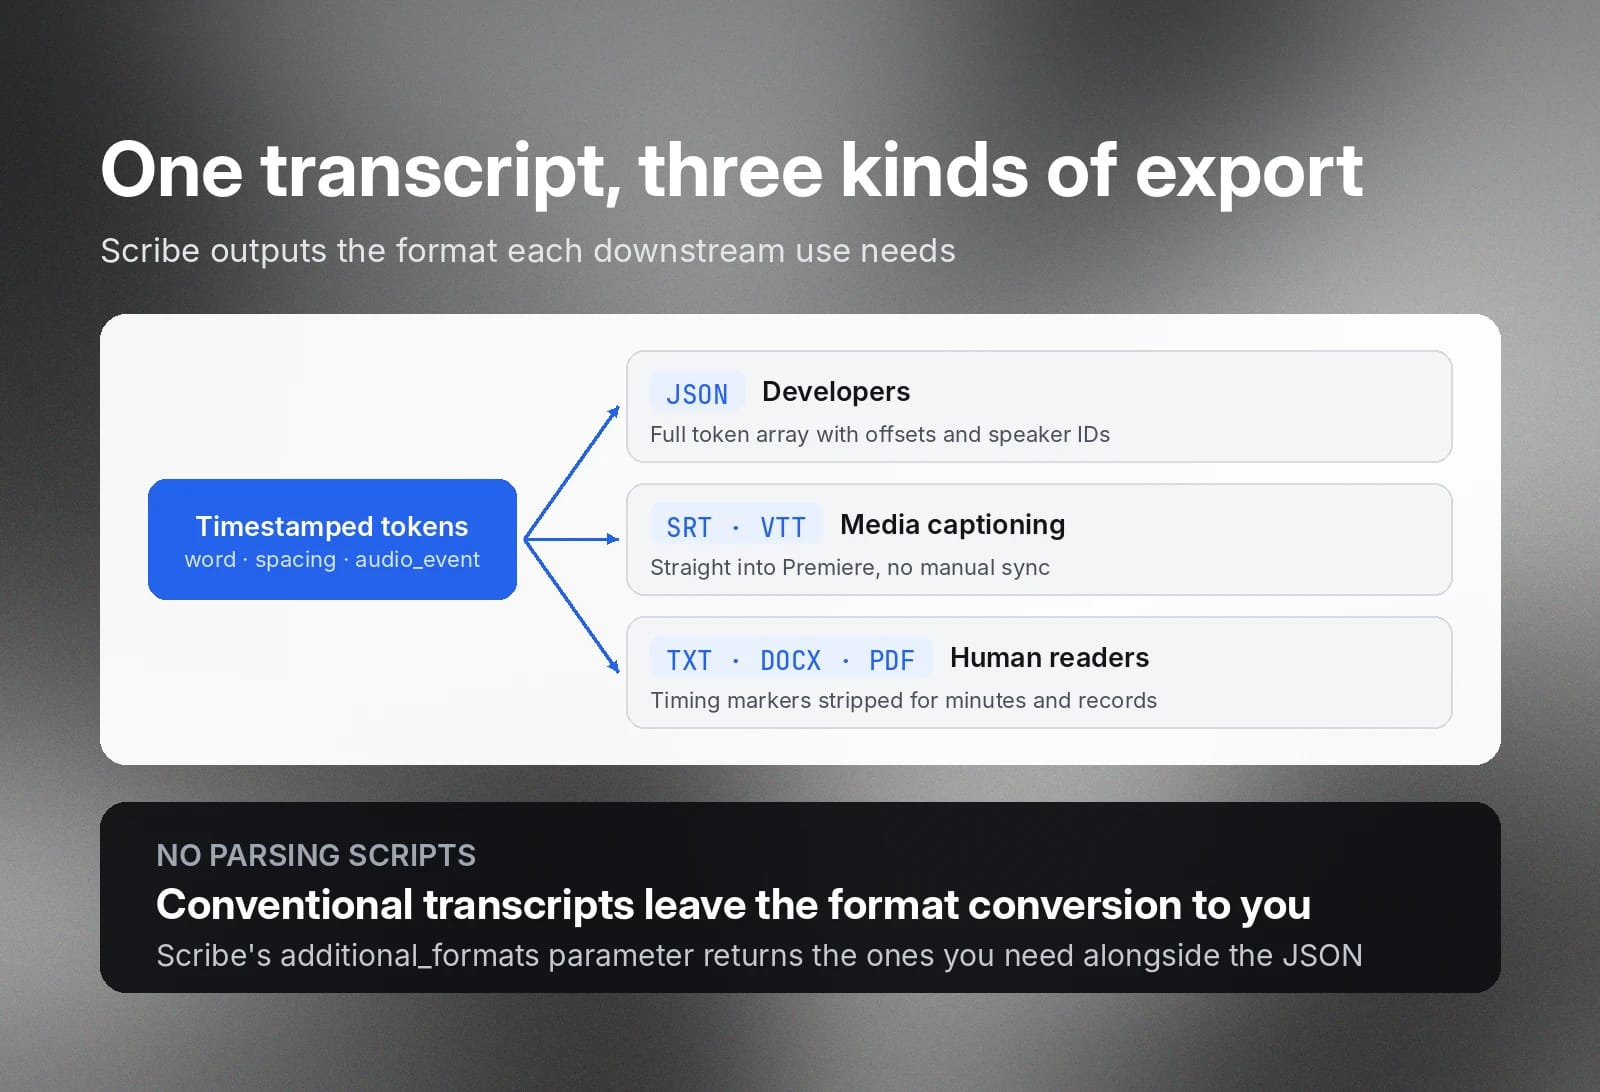
Jeśli chcesz udostępniać tradycyjne transkrypcje w wielu formatach, prawdopodobnie musisz samodzielnie napisać skrypty do ich przetwarzania. Scribe może eksportować transkrypcje w wielu formatach, zależnie od sposobu ich użycia. Pełne definicje schematów znajdziesz w dokumentacji API ElevenLabs Create Transcript.
Uporządkowane dane dla deweloperów: JSON
Scribe obsługuje eksport do JSON dla deweloperów, którzy chcą przekazywać dane w określonym schemacie do dalszych aplikacji. Deweloperzy mogą na przykład użyć tych danych JSON do budowy interaktywnych mediów lub bazy wyszukiwania semantycznego dla swojej organizacji. Pełna tablica tokenów word, spacing i audio_event zawiera przesunięcia początku i końca oraz identyfikatory mówców.
Napisy do mediów: SRT i VTT
Scribe może zwracać transkrypcje SRT i VTT, które możesz przekazać bezpośrednio do Adobe Premiere lub innych aplikacji produkcyjnych bez ręcznej synchronizacji.
Czytelne dla człowieka: TXT, DOCX i PDF
Może też zwracać transkrypcje w formatach przyjaznych dla czytelnika. W tych formatach Scribe usuwa szczegółowe znaczniki czasu, aby tekst był czytelniejszy i odpowiedni do dokumentacji prawnej lub audytowej. Jest to przydatne np. wtedy, gdy chcesz sprawnie rozesłać protokół posiedzenia zarządu zaraz po spotkaniu, opublikować transkrypcje podcastów dla SEO lub archiwizować dokumentację prawną.
Zacznij korzystać z transkrypcji ElevenLabs ze znacznikami czasu i tagami zdarzeń
Natywna transkrypcja na poziomie słów szybko i sprawnie zapewnia uporządkowane dane potrzebne w twoich workflow.
Zacznij już dziś transkrybować audio za pomocą Scribe w ElevenAPI albo dowiedz się więcej o transkrypcji na poziomie słów.
FAQ: znaczniki czasu i transkrypcja z tagami zdarzeń

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


