
Poradnik rozpoznawania mowy w JavaScript: twórz głosowy UX
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Dodanie rozpoznawania mowy do stron i aplikacji działających w przeglądarce jest dziś łatwiejsze dzięki natywnym dla przeglądarek API zamiany mowy na tekst (STT), takim jak Web Speech API. Deweloperzy mogą łatwo przesyłać strumieniowo dane z mikrofonu, analizować audio i przetwarzać transkrypcje przez wywołania API — bez budowania lokalnego serwera automatycznego rozpoznawania mowy.
Web Speech API to popularne API rozpoznawania mowy do wdrażania poleceń głosowych w JavaScript. Udostępnia metody, argumenty i właściwości, które pozwalają uruchomić transkrypcję w czasie rzeczywistym w przeglądarce. Jednak w przypadku złożonych klientów webowych jego możliwości mogą być ograniczone.
W tym przewodniku pokazujemy, jak stworzyć prostą aplikację webową do rozpoznawania mowy w JavaScript z Web Speech API, omawiamy jego ograniczenia oraz alternatywy do budowania bardziej niezawodnych klientów transkrypcji w czasie rzeczywistym.
Podsumowanie
- Web Speech API to natywne dla przeglądarek API zamiany mowy na tekst, które wysyła audio z mikrofonu do chmurowej usługi backendowej w celu przetworzenia.
- Deweloperzy używają klasy SpeechRecognition API do tworzenia aplikacji JavaScript z poleceniami głosowymi.
- Tworząc aplikację do rozpoznawania mowy, dbaj o prywatność użytkownika i informuj, że trwa nagrywanie audio.
- Web Speech API ma kilka ograniczeń, w tym niespójność transkrypcji, zależność od przeglądarki i brak rozumienia intencji.
- ElevenLabs oferuje bardzo dokładne API zamiany mowy na tekst klasy produkcyjnej, obsługujące streaming po stronie klienta i serwera.
Jak działa Web Speech API
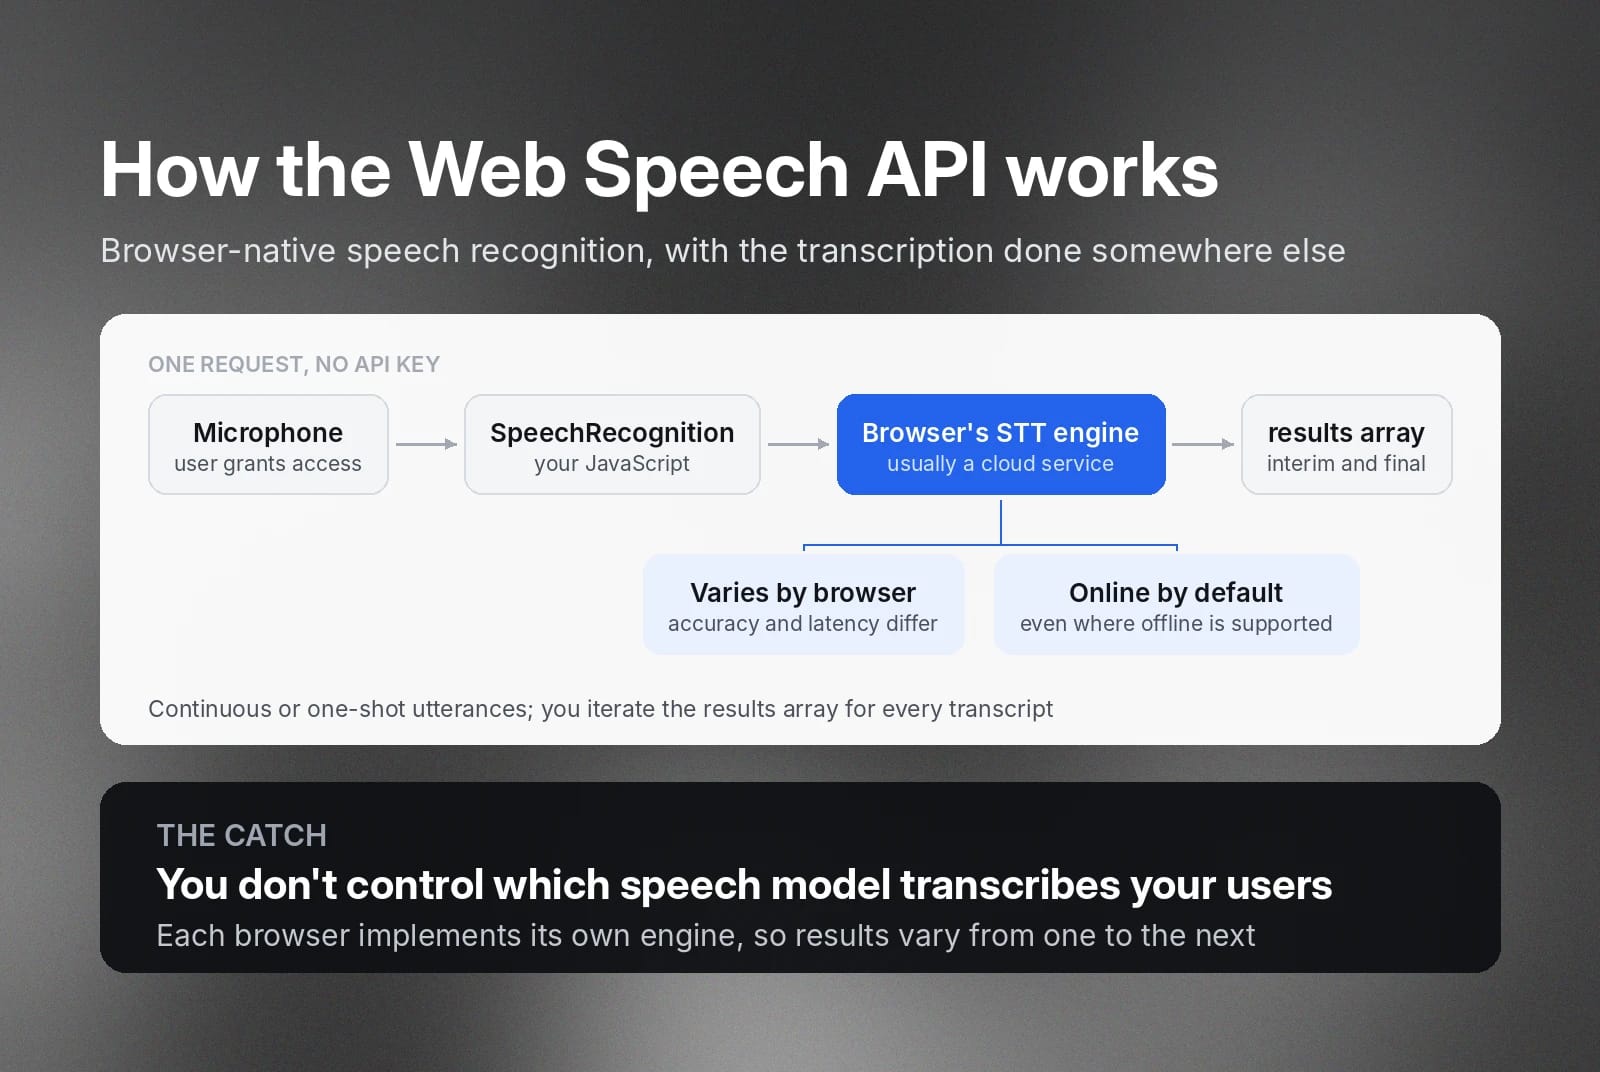
Web Speech API zapewnia deweloperom stron natywne dla przeglądarek rozpoznawanie mowy bez lokalnego serwera. W skrócie: Web Speech API wysyła strumień audio z przeglądarki do chmurowej usługi backendowej, aby przetworzyć i przeanalizować dźwięk oraz zamienić go na transkrypcję. Ponieważ transkrypcja opiera się na silniku backendowym przeglądarki, wyniki mogą różnić się między przeglądarkami.
Zwykle Web Speech API wymaga aktywnego połączenia z internetem, aby transkrybować strumienie audio — szczególnie w aplikacjach dla Chrome i Safari. Niektóre przeglądarki obsługują jednak już transkrypcję offline. W tym trybie przeglądarka działa jako silnik zamiany mowy na tekst, rozpoznaje fonemy i przekształca je w spójny tekst.
Niezależnie od używanej przeglądarki podstawy API są takie same.
- Nie potrzebujesz klucza API, aby wysłać żądanie API.
- Web Speech API obsługuje wypowiedzi ciągłe i jednorazowe.
- Zwraca zarówno tymczasowe, jak i końcowe transkrypcje.
Ponieważ każda przeglądarka może inaczej implementować silnik STT, dokładność i opóźnienia mogą się różnić.
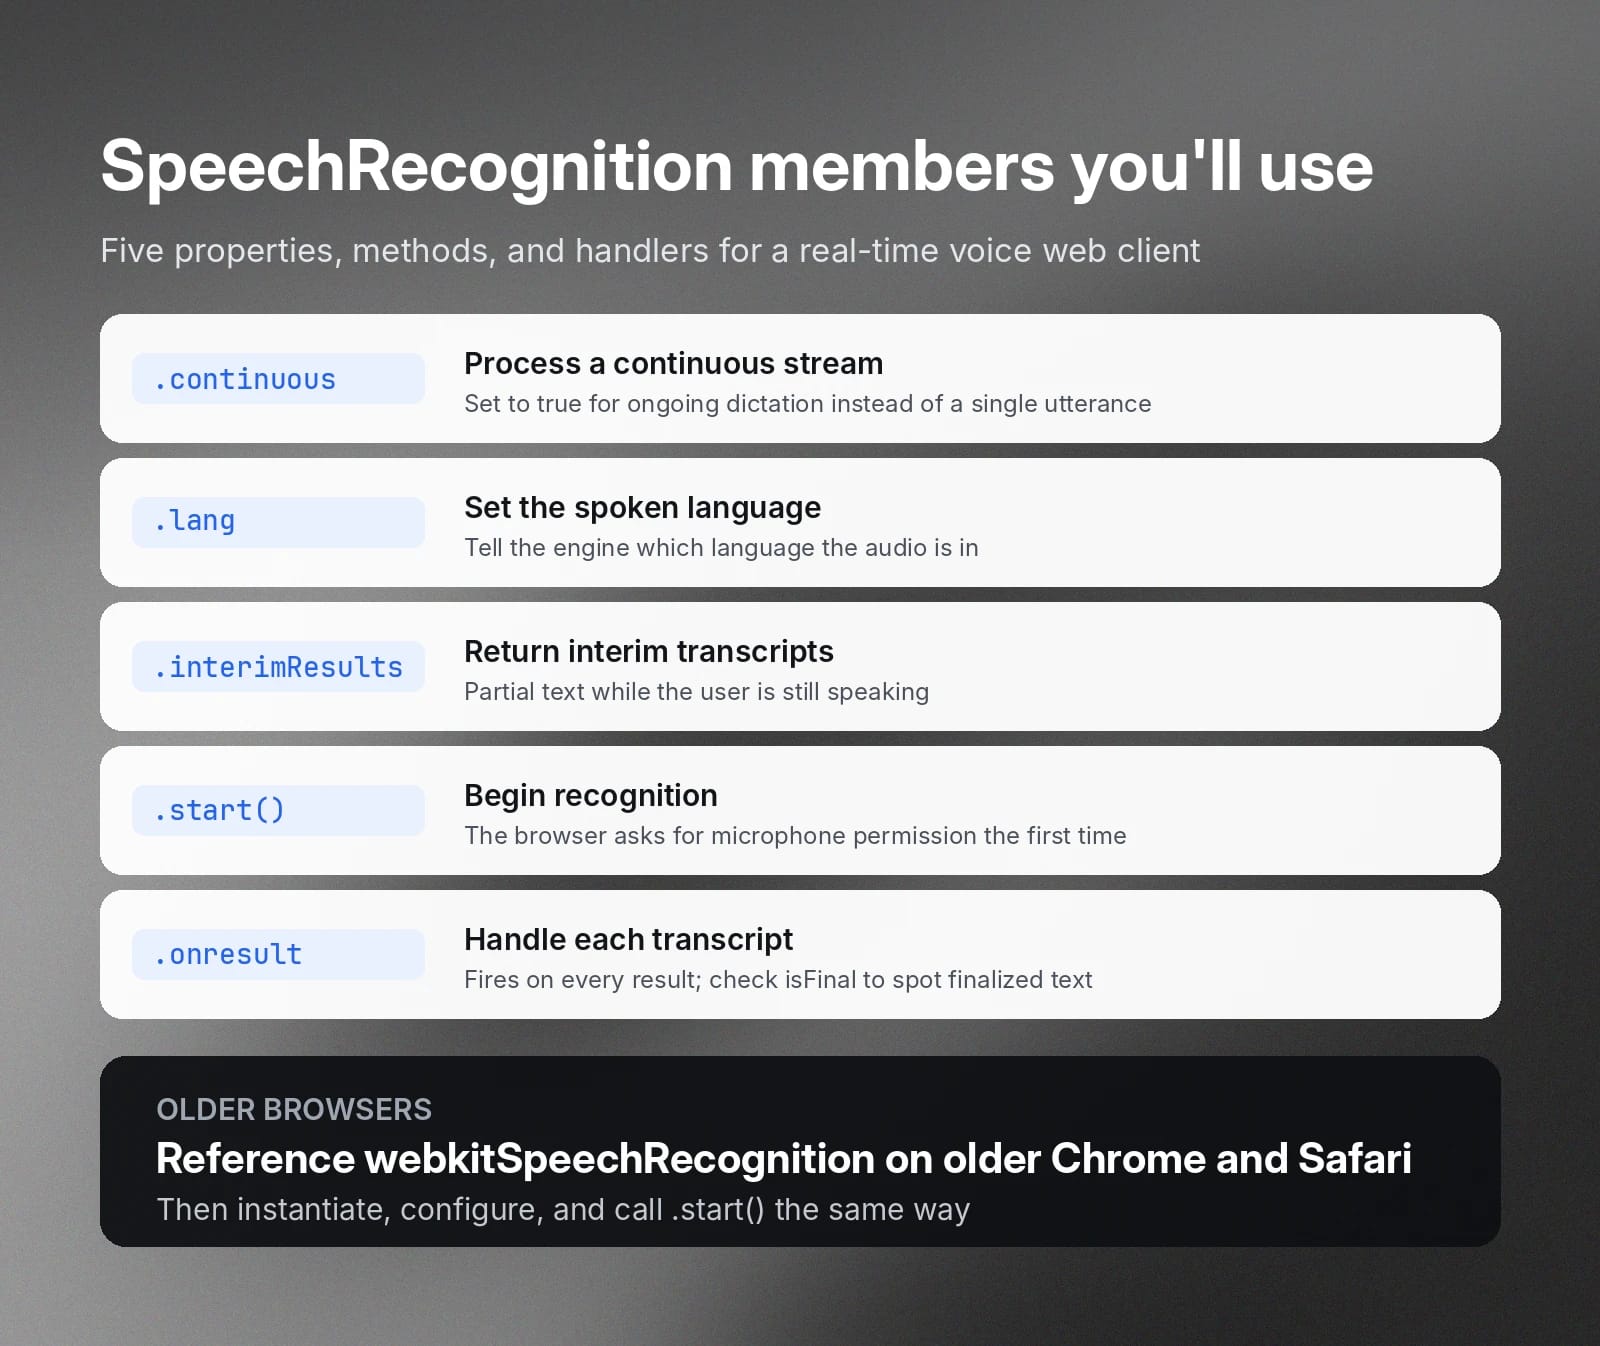
Aby użyć Web Speech API, inicjujesz interfejs SpeechRecognition w kodzie JavaScript. Następnie korzystasz z metod, atrybutów i procedur obsługi zdarzeń. Oto niektóre z nich, które przydadzą się do stworzenia klienta webowego wyszukiwania głosowego.
- SpeechRecognition.continuous: Umożliwia silnikowi mowy przetwarzanie ciągłego strumienia, gdy ustawisz wartość true.
- SpeechRecognition.lang: Ustawia język audio.
- SpeechRecognition.interimResults: Nakazuje silnikowi zwracać tymczasowe transkrypcje.
- SpeechRecognition.start(): Rozpoczyna proces rozpoznawania mowy.
- SpeechRecognition.onresult: Przyjmuje procedurę obsługi zdarzenia, którą API wywołuje po zakończeniu transkrypcji.
Web Speech API zwraca transkrypcję w tablicy ciągów. Gdy silnik STT zwróci transkrypcję — tymczasową lub końcową — znajdziesz ją w tablicy results. Może ona zawierać jeden lub więcej ciągów. Dlatego musisz iterować po ciągach wynikowych, aby pobrać cały transkrybowany tekst.
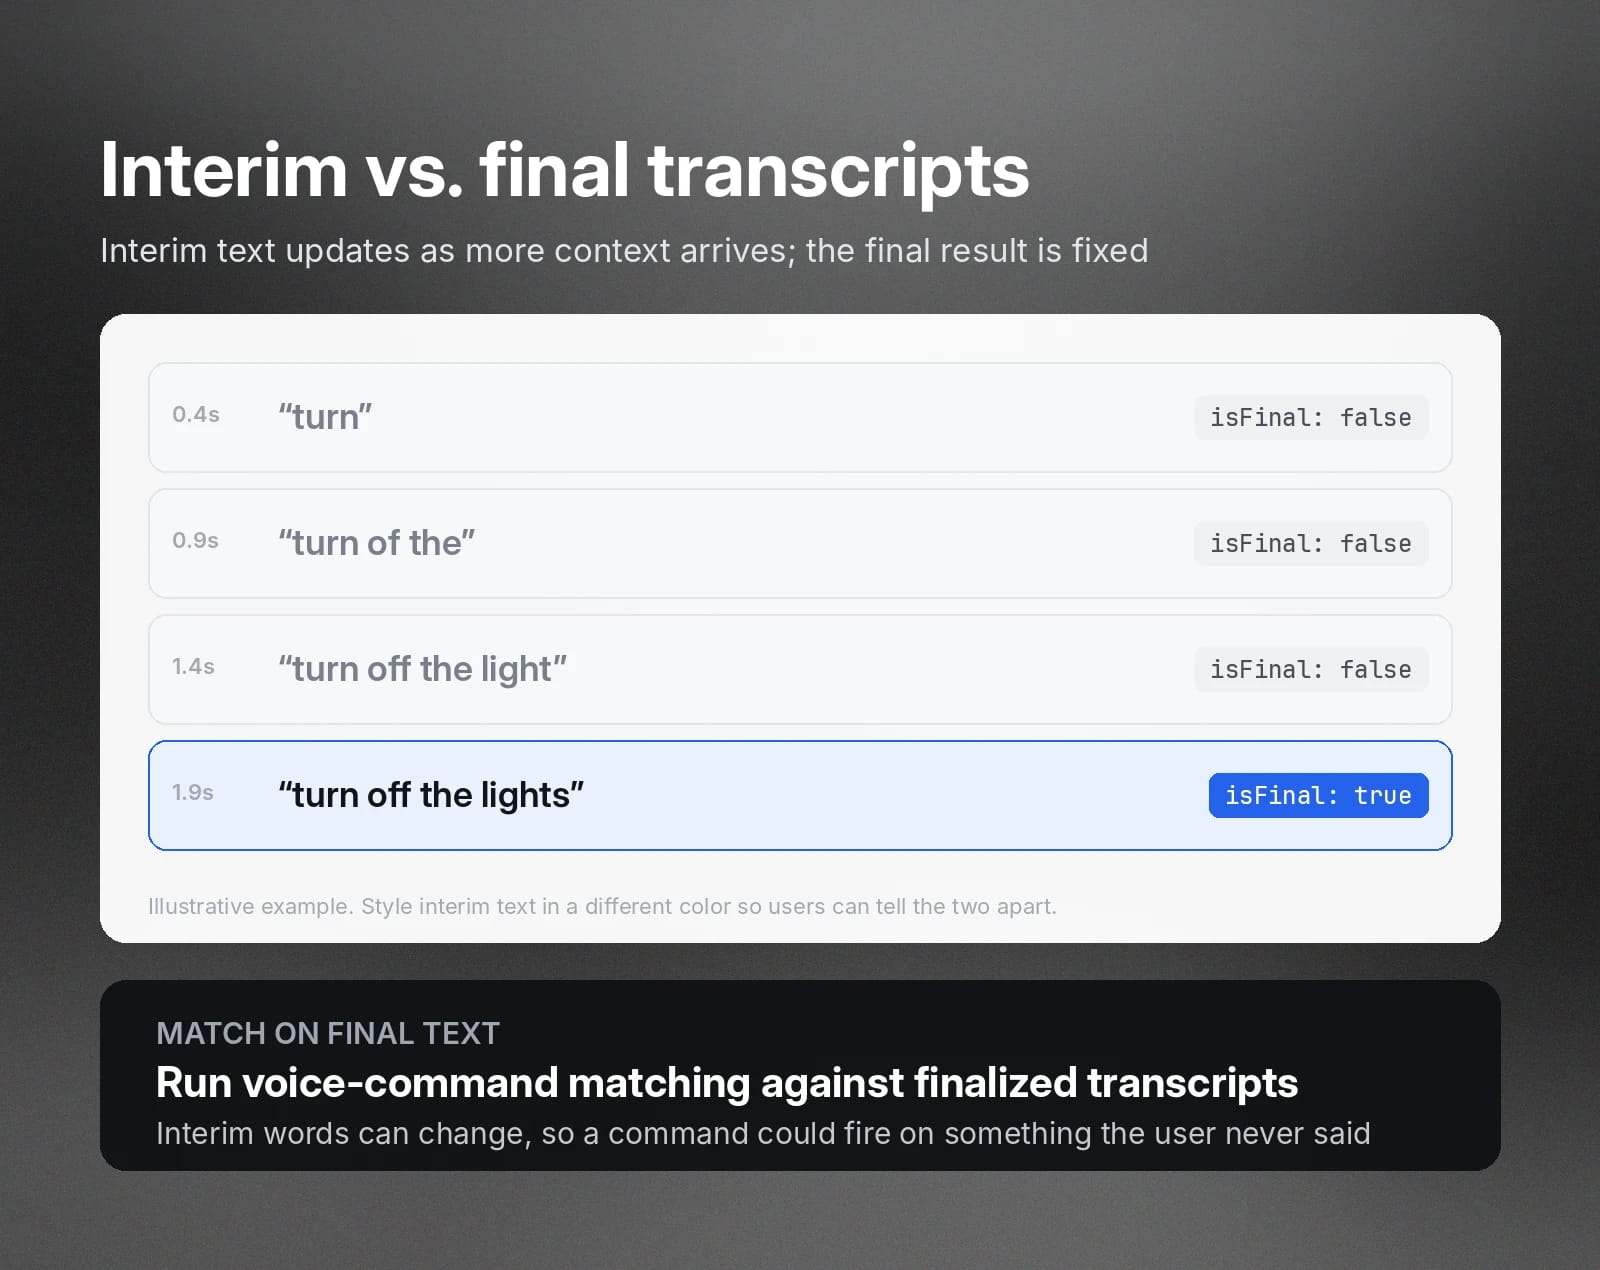
Uwaga: Jeśli włączysz transkrypcję tymczasową, sprawdź właściwość isFinal, aby ustalić, czy tekst jest końcową transkrypcją.
Stwórz przykład rozpoznawania mowy w JavaScript
W tym przykładzie używamy interfejsu JavaScript SpeechRecognition do stworzenia aplikacji webowej z transkrypcją w czasie rzeczywistym. Zrzut ekranu poniżej pokazuje gotową stronę.
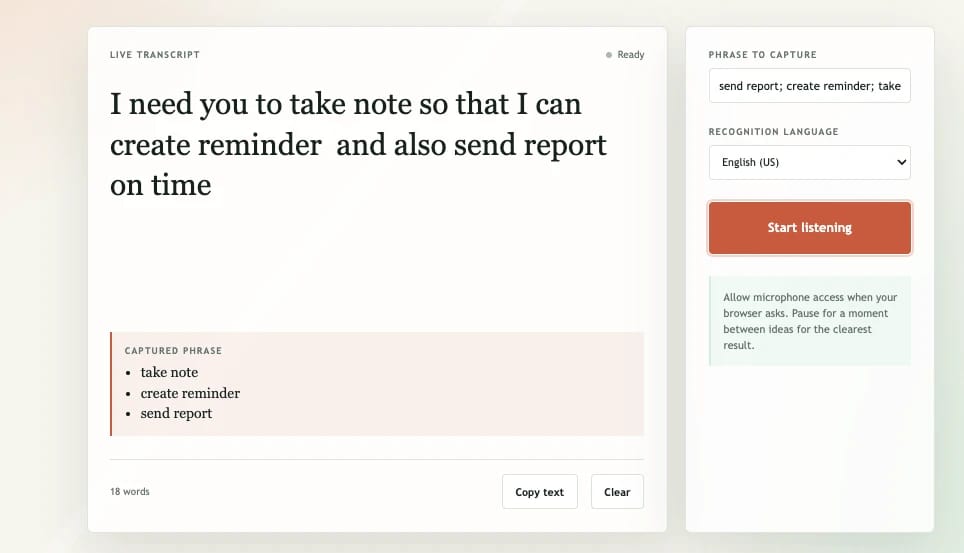
Na przykładowej stronie przycisk Start listening rozpoczyna nagrywanie. Gdy użytkownik mówi, przeglądarka wysyła audio do silnika STT, czeka na transkrypcję i wyświetla tekst tymczasowy oraz końcowy.
Przykład zawiera też funkcję poleceń głosowych, która wychwytuje określone wyrażenia zdefiniowane przez użytkownika. Porównuje transkrypcję z ustaloną w kodzie listą fraz, co różni się od wskazywania kluczowych terminów w API zamiany mowy na tekst.
Poniższe fragmenty pokazują kluczowe części tego przykładu.
Skonfiguruj SpeechRecognition API i poproś o dostęp do mikrofonu
Aby użyć go w kodzie, najpierw musisz utworzyć instancję klasy SpeechRecognition. W starszych wersjach Chrome lub Safari odwołujesz się do webkitSpeechRecognition.
Następnie utwórz instancję SpeechRecognition i skonfiguruj tryb streamingu, obsługę transkrypcji tymczasowej oraz język wypowiedzi.
Potem możesz rozpocząć transkrypcję, wywołując metodę .start().
Przy pierwszym uruchomieniu rozpoznawania mowy przeglądarka poprosi użytkownika o zgodę. Użytkownik musi kliknąć Zezwól, aby rozpocząć transkrypcję. W przeciwnym razie API zwróci wartość „not-allowed” w procedurze obsługi SpeechRecognitionErrorEvent .
Wyświetlaj transkrypcje na żywo i końcowe wyniki
W tym przykładzie wyświetlamy transkrypcję, gdy użytkownik mówi do mikrofonu. Aby to zrobić, przypisujemy funkcję do zdarzenia onresult.
Tymczasowe transkrypcje nie są ostateczne. Wyświetlany tekst może więc nie odpowiadać dokładnie wypowiedzianym słowom. Gdy silnik STT otrzyma więcej kontekstu z kolejnych słów, poprawi transkrypcję i zwróci ją jako ciąg.
Możesz też nadać tekstowi tymczasowemu inny kolor, aby odróżniał się od końcowej transkrypcji. Ten CSS to robi:
Dodaj polecenia głosowe w JavaScript
Dodaj pole tekstowe, w którym użytkownicy wpiszą frazy do wykrycia, oddzielone średnikami. (Możesz też przechowywać frazy w pliku JSON i wczytać je do kodu.)
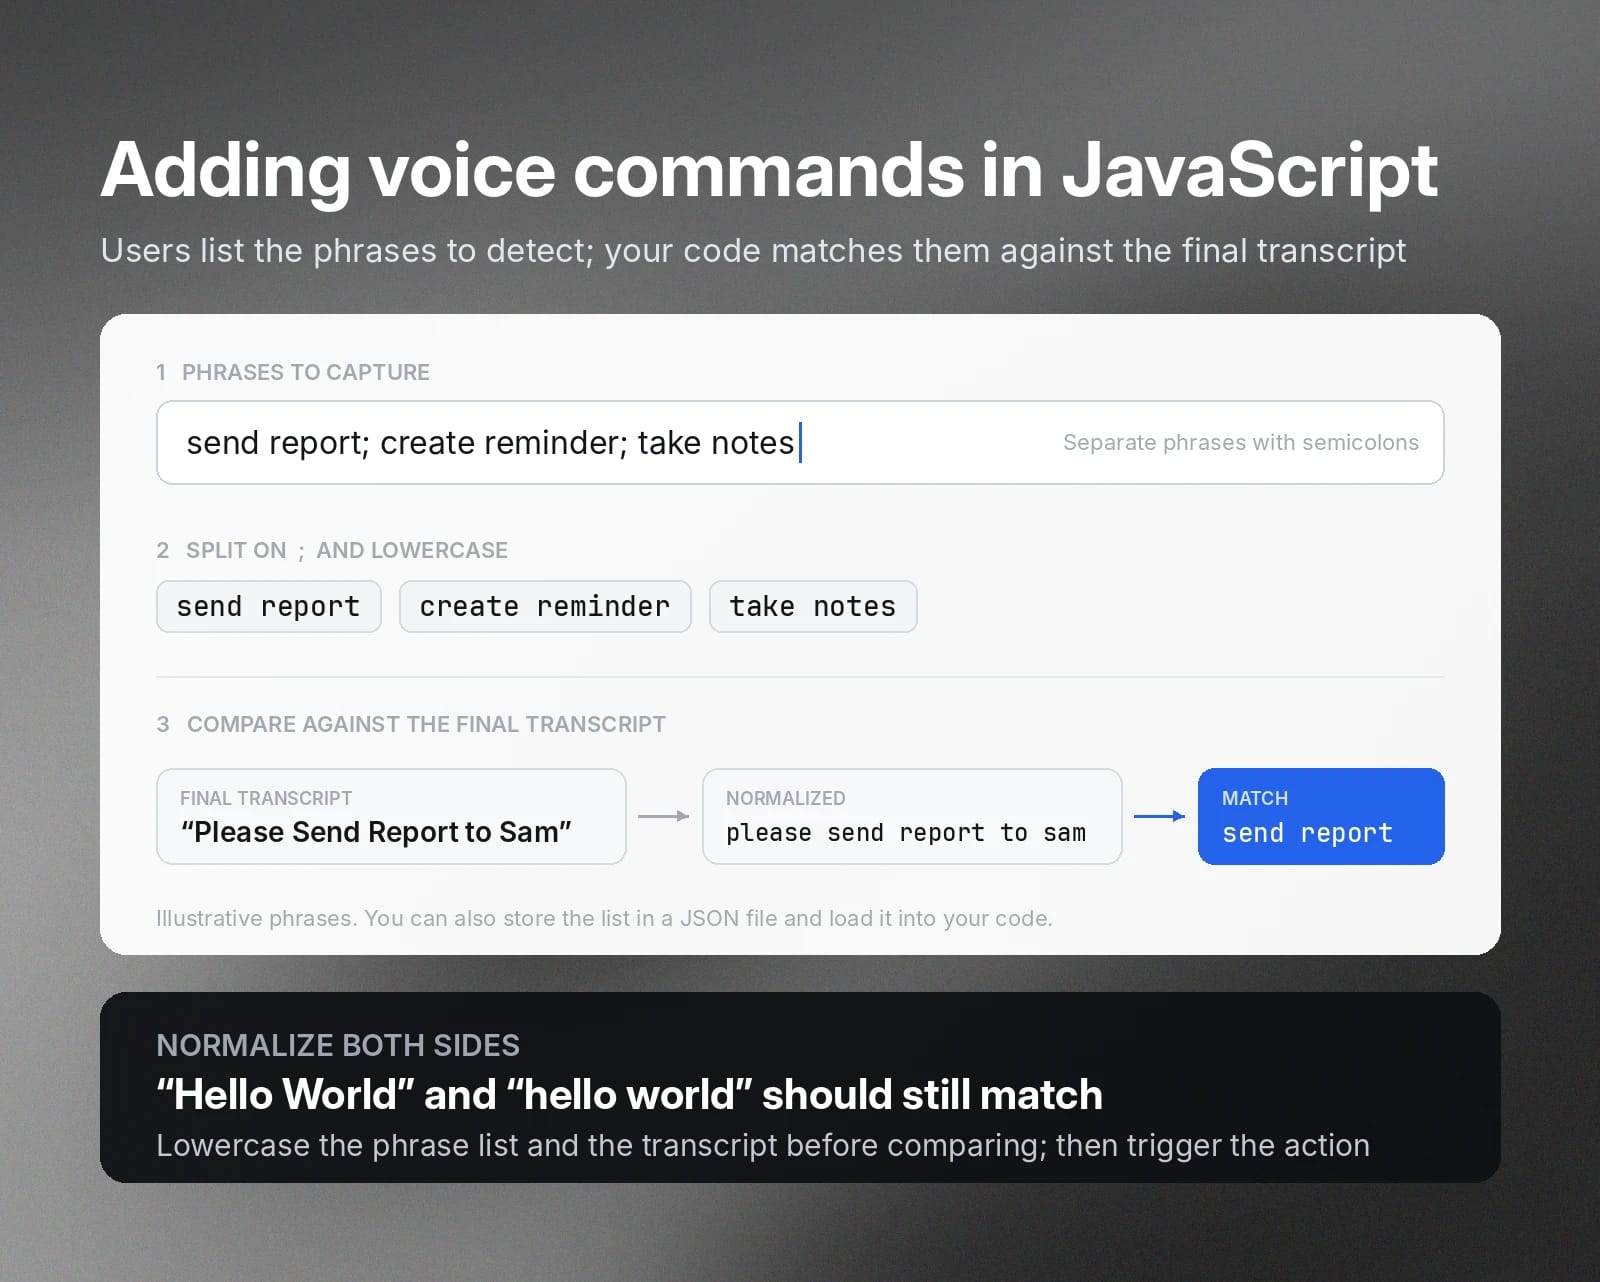
Następnie utwórz funkcję porównującą końcową transkrypcję z listą fraz. Podczas dopasowywania tekstu ujednolić obie listy, zamieniając tekst na małe litery. Użytkownicy mogą używać wielkich liter, co powoduje brak dopasowania mimo identycznych słów. Na przykład „Hello World” i „hello world” powinny zostać dopasowane, nawet jeśli jedna fraza zawiera wielkie litery.
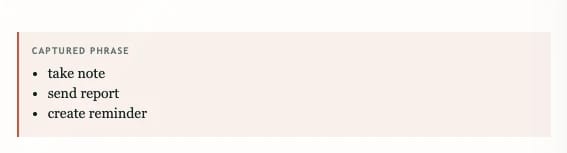
Za każdym razem, gdy kod otrzyma transkrypcję, iteruje po liście fraz. Jeśli znajdzie dopasowanie, uruchamiasz działanie, na przykład otwarcie aplikacji lub — jak tutaj — wyświetlenie dopasowanej frazy w osobnym panelu.
Obsłuż wsparcie przeglądarek, uprawnienia i błędy rozpoznawania
Web Speech API ułatwia uruchamianie rozpoznawania mowy na tekst w JavaScript, ale nie zawsze działa bez problemów. Użytkownicy mogą korzystać z przeglądarki, która ma ograniczone wsparcie backendowe dla SpeechRecognition API lub nie ma go wcale. W niektórych przypadkach problemy z siecią spowodują niepowodzenie transkrypcji.
Dlatego kod powinien obsługiwać te sytuacje i odpowiednio informować użytkowników.
Możesz na przykład poinformować użytkowników, aby korzystali z Chrome lub Edge, gdzie SpeechRecognition API działa sprawdzalnie.
Aby obsłużyć błędy, przypisz funkcję obsługi błędów do procedury obsługi zdarzenia onerror i przetwarzaj odpowiedni kod błędu.
Na przykład:
Kod błędu | Działanie |
not-allowed | Wyświetl tekst z prośbą o sprawdzenie ustawień przeglądarki. |
no-speech | Poproś użytkownika, aby mówił bliżej mikrofonu |
network | Poproś użytkownika o sprawdzenie połączenia z internetem |
aborted | Poinformuj użytkownika, że proces rozpoznawania mowy został zatrzymany. |
Zadbaj o dostępność i prywatność w rozpoznawaniu głosu w JavaScript
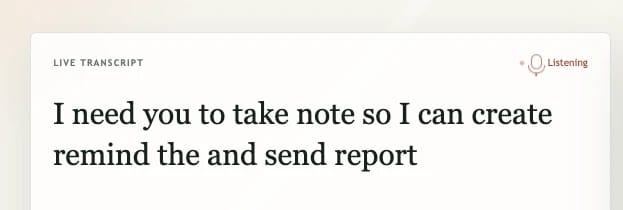
Podczas integracji Web Speech API pamiętaj o prywatności. Zawsze wyświetl wskaźnik wizualny lub słowny, zanim klient webowy zacznie nagrywać. Na przykład pokaż ikonę nasłuchiwania, gdy kod rozpoznawania głosu w JavaScript aktywnie wysyła sygnał z mikrofonu do silnika zamiany mowy na tekst.
Kolejnym obszarem, na który deweloperzy powinni zwrócić uwagę, jest prywatność danych. Gdy transkrybujesz za pomocą SpeechRecognition API, API domyślnie wykonuje transkrypcję online. Nawet jeśli przeglądarka obsługuje zamianę mowy na tekst offline, API najpierw spróbuje wykonać transkrypcję online.
Te kwestie techniczne są kluczowe przy tworzeniu usług transkrypcji, w których lokalizacja danych, nadzór nad nimi i zgodność z przepisami są ściśle regulowane.
Dowiedz się, kiedy rozpoznawanie mowy w przeglądarce nie wystarcza w produkcji
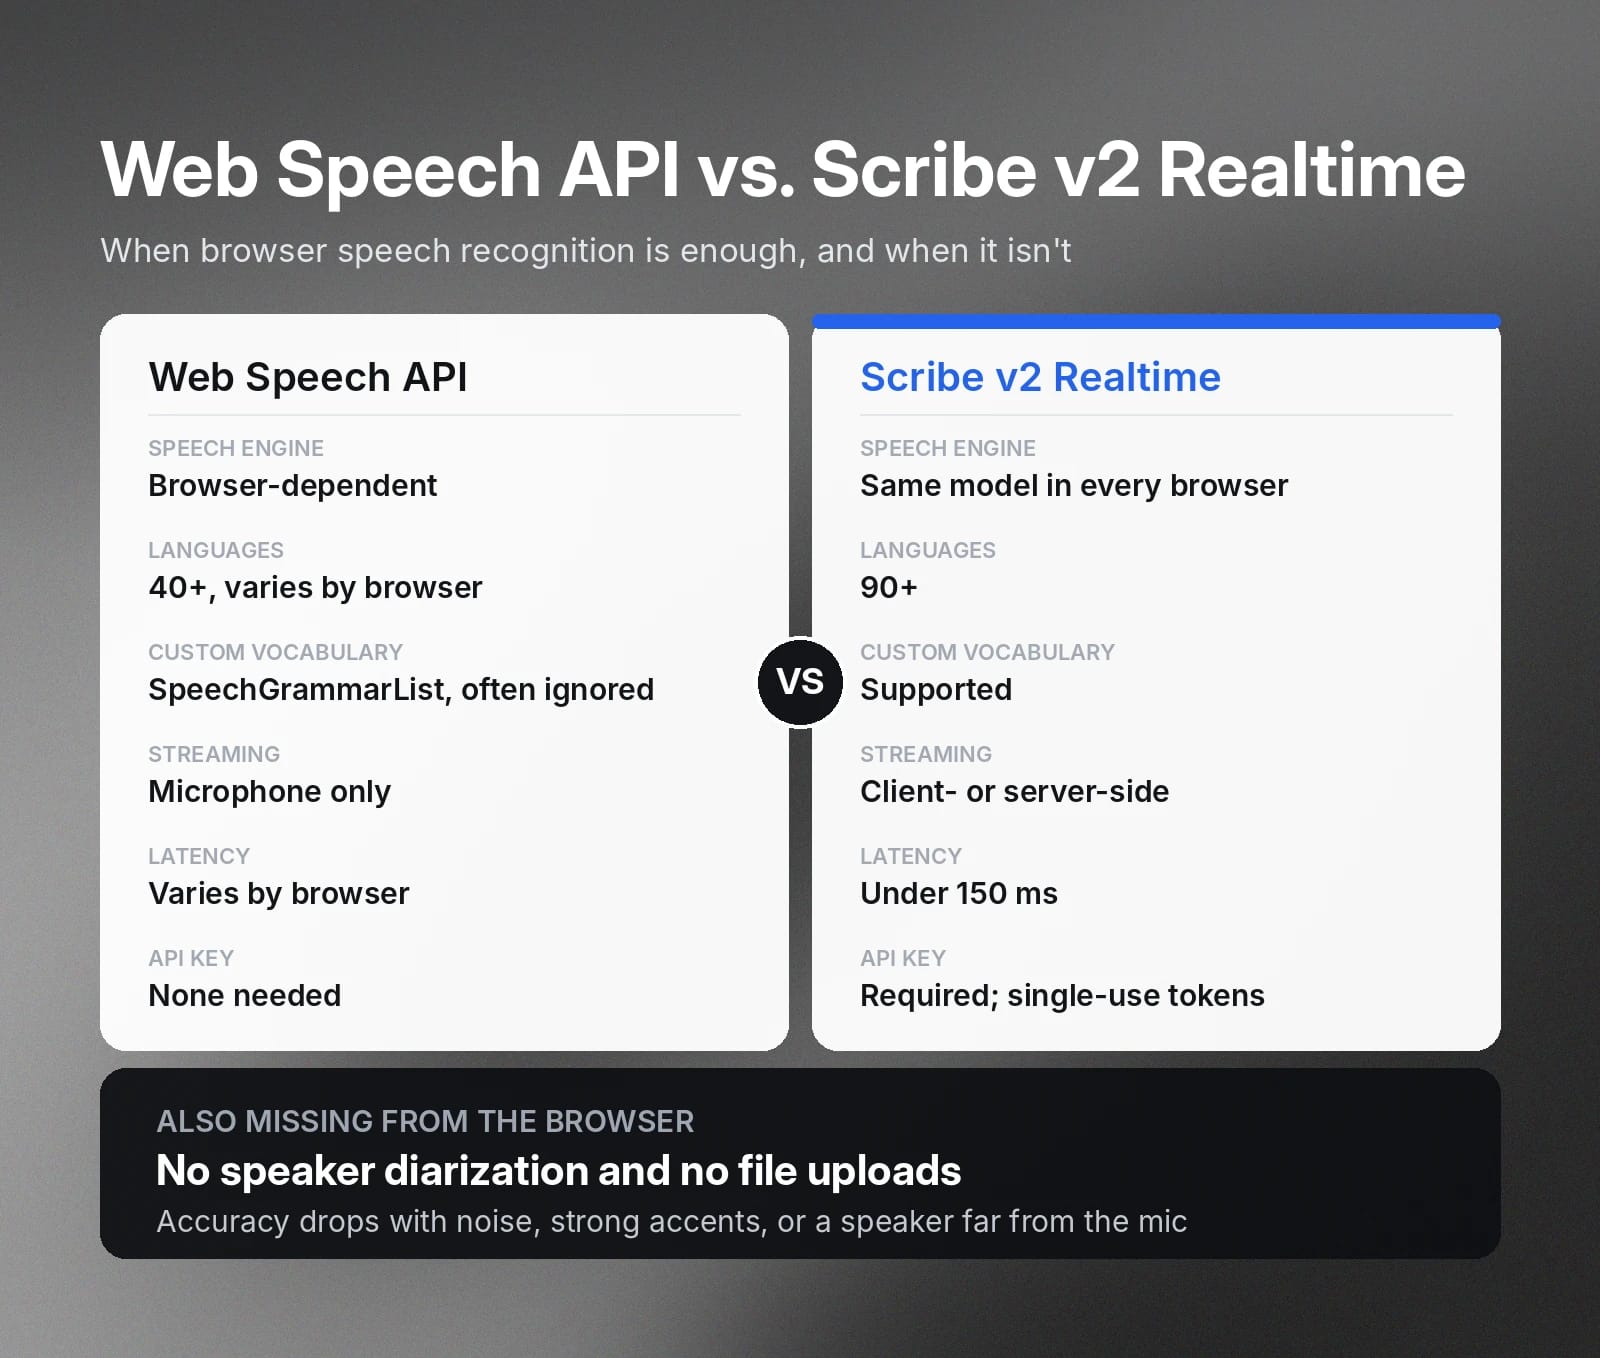
Pokazaliśmy, jak stworzyć automatyczne rozpoznawanie mowy dla aplikacji głosowych działających w przeglądarce za pomocą Web Speech API. API udostępnia funkcje zamiany mowy na tekst deweloperom JavaScript. Kilka ograniczeń zawęża jednak możliwe zastosowania, zwłaszcza w komercyjnych produktach webowych.
- Zależność od przeglądarki: Transkrypcja w dużej mierze zależy od przeglądarki użytkownika. Deweloperzy nie mają kontroli nad konkretnymi modelami głosowymi, których ona używa, co prowadzi do niespójnej jakości transkrypcji.
- Ograniczona obsługa języków: API obsługuje ponad 40 języków, ale dokładna liczba może różnić się między przeglądarkami.
- Diarizacja mówców: Nie możesz wykryć, kto mówi, ani uwzględnić poszczególnych mówców w transkrypcji.
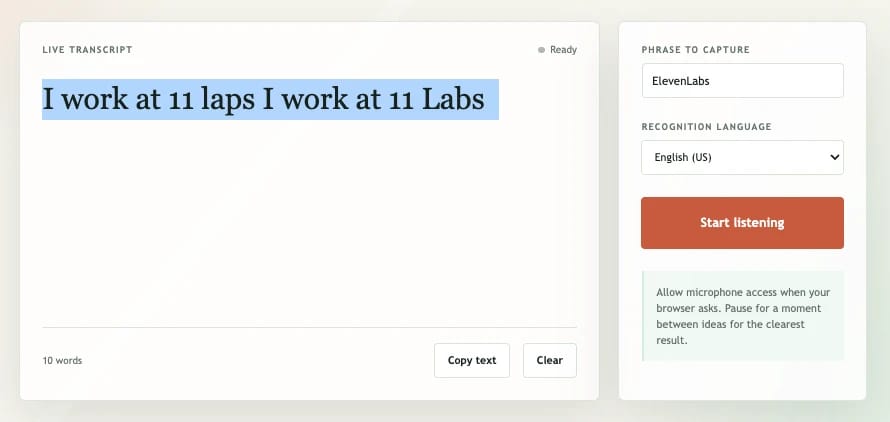
- Niestandardowe słowniki: SpeechRecognition API nie zapewnia niezawodnej obsługi niestandardowych słowników. Na przykład nie potrafi dokładnie transkrybować słowa „ElevenLabs”. (Oficjalne SpeechRecognition API udostępnia interfejs niestandardowego słownika przez SpeechGrammarList, ale nowoczesne przeglądarki często go ignorują.)
- Dokładność: Dokładność transkrypcji spada, gdy mówca znajduje się w hałaśliwym otoczeniu, ma silny akcent lub jest daleko od mikrofonu.
- Streaming po stronie serwera: Możesz przesyłać strumieniowo tylko z mikrofonu, ponieważ Web Speech API nie obsługuje streamingu po stronie serwera ani ręcznego przesyłania plików audio.
Jeśli te ograniczenia uniemożliwiają komercjalizację produktu do rozpoznawania głosu, polecamy ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime to model rozpoznawania mowy oferujący bardzo dokładną transkrypcję w czasie rzeczywistym z opóźnieniem poniżej 150 ms. Obsługuje ponad 90 języków, zapewnia spójność niezależną od przeglądarki oraz niestandardowe słowniki. Dzięki ElevenLabs Scribe v2 Realtime możesz uruchomić streaming po stronie klienta lub serwera, aby dopasować go do architektury aplikacji webowej.
Poradnik rozpoznawania głosu w JavaScript z ElevenLabs Scribe v2 Realtime
Tworzenie poleceń głosowych w JavaScript z ElevenLabs przebiega podobnie. Musisz jednak utworzyć klucz ElevenLabs API, aby autoryzować żądania API. Poniżej znajdziesz szybkie kroki tworzenia klienta webowego streamującego audio z mikrofonu.
- Zainstaluj SDK ElevenLabs
- Utwórz token jednorazowy, aby przekazać klucz API bez jego ujawniania
- Skonfiguruj i połącz się z modelem Scribe v2 Realtime, używając wybranych parametrów
- Utwórz procedury obsługi zdarzeń do przetwarzania transkrypcji i obsługi wyjątków
Szczegółowe informacje o Scribe v2 Realtime znajdziesz w naszej oficjalnej dokumentacji.
Zacznij korzystać z ElevenAPI do produkcyjnej zamiany mowy na tekst
ElevenAPI zapewnia modele zamiany mowy na tekst klasy produkcyjnej do tworzenia klientów webowych i serwerów. Poza rozpoznawaniem mowy w czasie rzeczywistym deweloperzy używają modeli zamiany mowy na tekst ElevenAPI do transkrypcji wsadowej z diarizacją mówców, znacznikami czasu na poziomie słów i przetwarzaniem asynchronicznym.
Zamiast stale odpytywać silnik zamiany mowy na tekst, możesz utworzyć webhook w panelu ElevenLabs i podać adres URL callbacku, na który API dostarczy gotową transkrypcję.
Niezależnie od tego, czy chcesz stworzyć klienta webowego, czy aplikację serwerową z automatycznym rozpoznawaniem mowy, ElevenAPI oferuje modele audio, które łatwo zintegrujesz z kodem.
Pobierz klucz ElevenLabs API i poznaj dokumentację API, aby zacząć tworzyć.
Najczęstsze pytania

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.


